
Programma
Runway ha introdotto Gen-4, un modello image-to-video progettato per affrontare un problema persistente nei video generati dall’IA: mantenere la coerenza di personaggi e scene su più inquadrature.
I cortometraggi mostrati nella demo di lancio sono molto validi e il modello promette bene. In questo articolo, però, lo proveremo in prima persona per capire se Runway Gen-4 è davvero all’altezza delle aspettative.
Che cos’è Runway Gen-4?
Runway ha rilasciato Gen-4, il suo modello più recente per generare brevi clip video a partire da testo o immagini. Il modello è il successore di Gen-3 Alpha, lanciato a inizio 2024, ed è parte di una serie di sforzi per rendere i video generati dall’IA più coerenti e utili dal punto di vista narrativo.
A differenza dei modelli precedenti, Gen-4 punta maggiormente sulla coerenza temporale, assicurando che personaggi e oggetti persistano tra fotogrammi e inquadrature senza deformarsi o scomparire. Per esempio, guarda questo cortometraggio intitolato The Herd:
Come accedere a Runway Gen-4
Per usare Runway Gen-4 serve un abbonamento. Tieni presente che il rilascio è ancora in corso, quindi a seconda della tua posizione potrebbe non essere ancora disponibile o essere accessibile solo con piani di livello superiore. Negli Stati Uniti, un abbonamento da 12 $ offre 625 crediti per usare Gen-4.
Inoltre, anche dopo la sottoscrizione, ho dovuto aspettare un giorno prima che diventasse disponibile sul mio account.
Come generare un video con Runway Gen-4
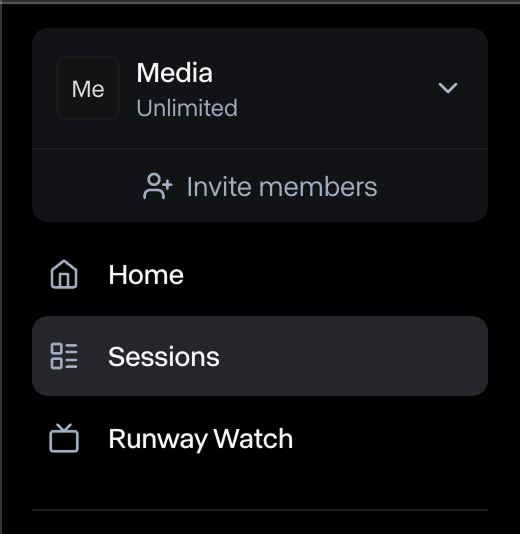
I video in Runway ML vengono generati all’interno di sessioni. Per creare un video, prima dobbiamo creare una nuova sessione selezionando la voce “Sessions” nel menu a sinistra:

Poi clicchiamo sul pulsante “New Session” a destra per creare una sessione:

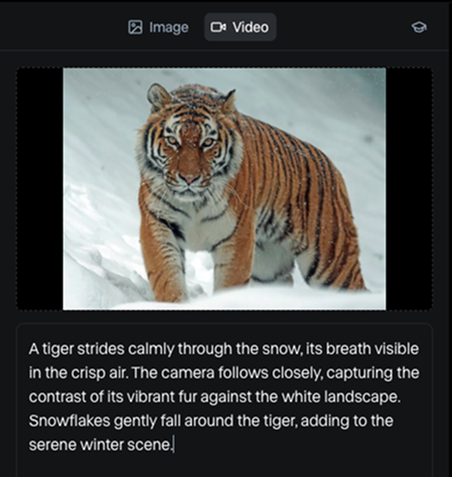
Aprendo la sessione, troviamo un’interfaccia semplice in cui possiamo combinare un’immagine e un prompt testuale per generare un video:
Fonte immagine: Pexels
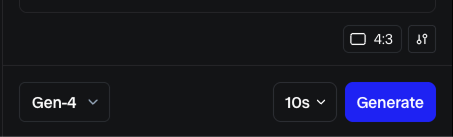
Assicurati di selezionare il modello Gen-4 in basso:

Ecco il risultato:
Secondo me il video è piuttosto buono.
Se ti serve una guida per creare un prompt, mettono a disposizione questa pagina di linee guida. Io ho usato le linee guida creando un bot IA pensato per trasformare le mie idee ad alto livello in prompt utilizzabili su Runway.
Nota che, a differenza di altri modelli di generazione video, non possiamo generare un video solo da testo: il modello richiede sempre un’immagine.
Come creare un’immagine in Runway
In questo primo esempio ho usato un’immagine gratuita trovata online. Possono essere una grande risorsa per creare video.
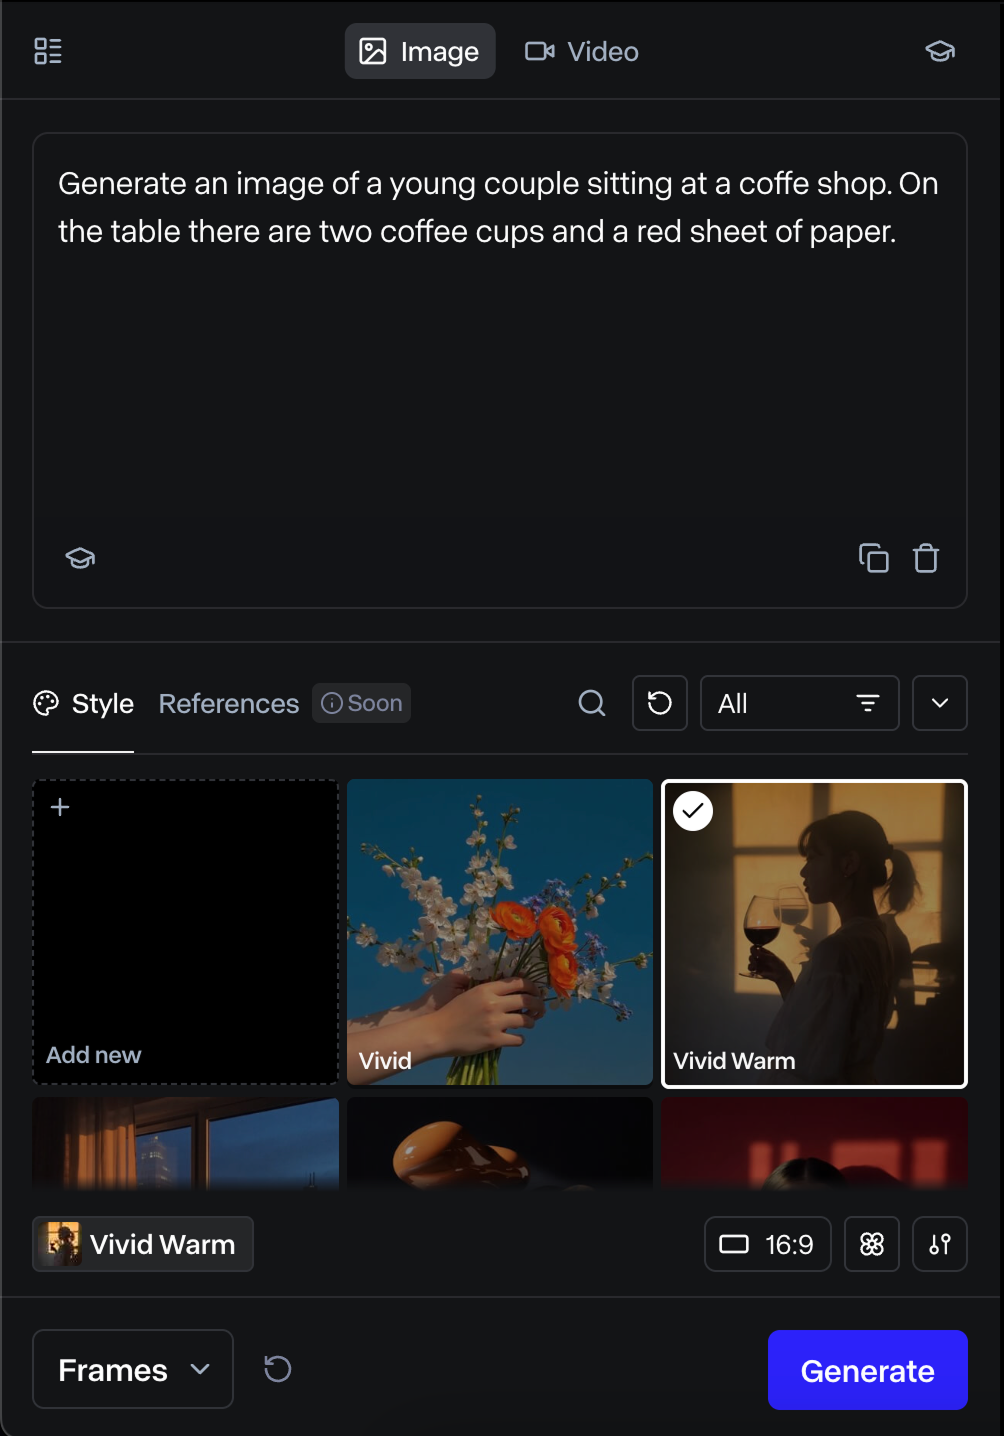
Runway offre anche un modello per la generazione di immagini. Tuttavia, per qualche ragione, non era disponibile con il piano base e ho dovuto sottoscrivere il piano più costoso per accedervi.
Per generare un’immagine:
- Seleziona la modalità “Image”.
- Scrivi un prompt che descriva l’immagine.
- Seleziona lo stile dell’immagine (può essere generato da un’immagine esistente o da un preset fornito da Runway).

Il modello ha generato queste quattro immagini:
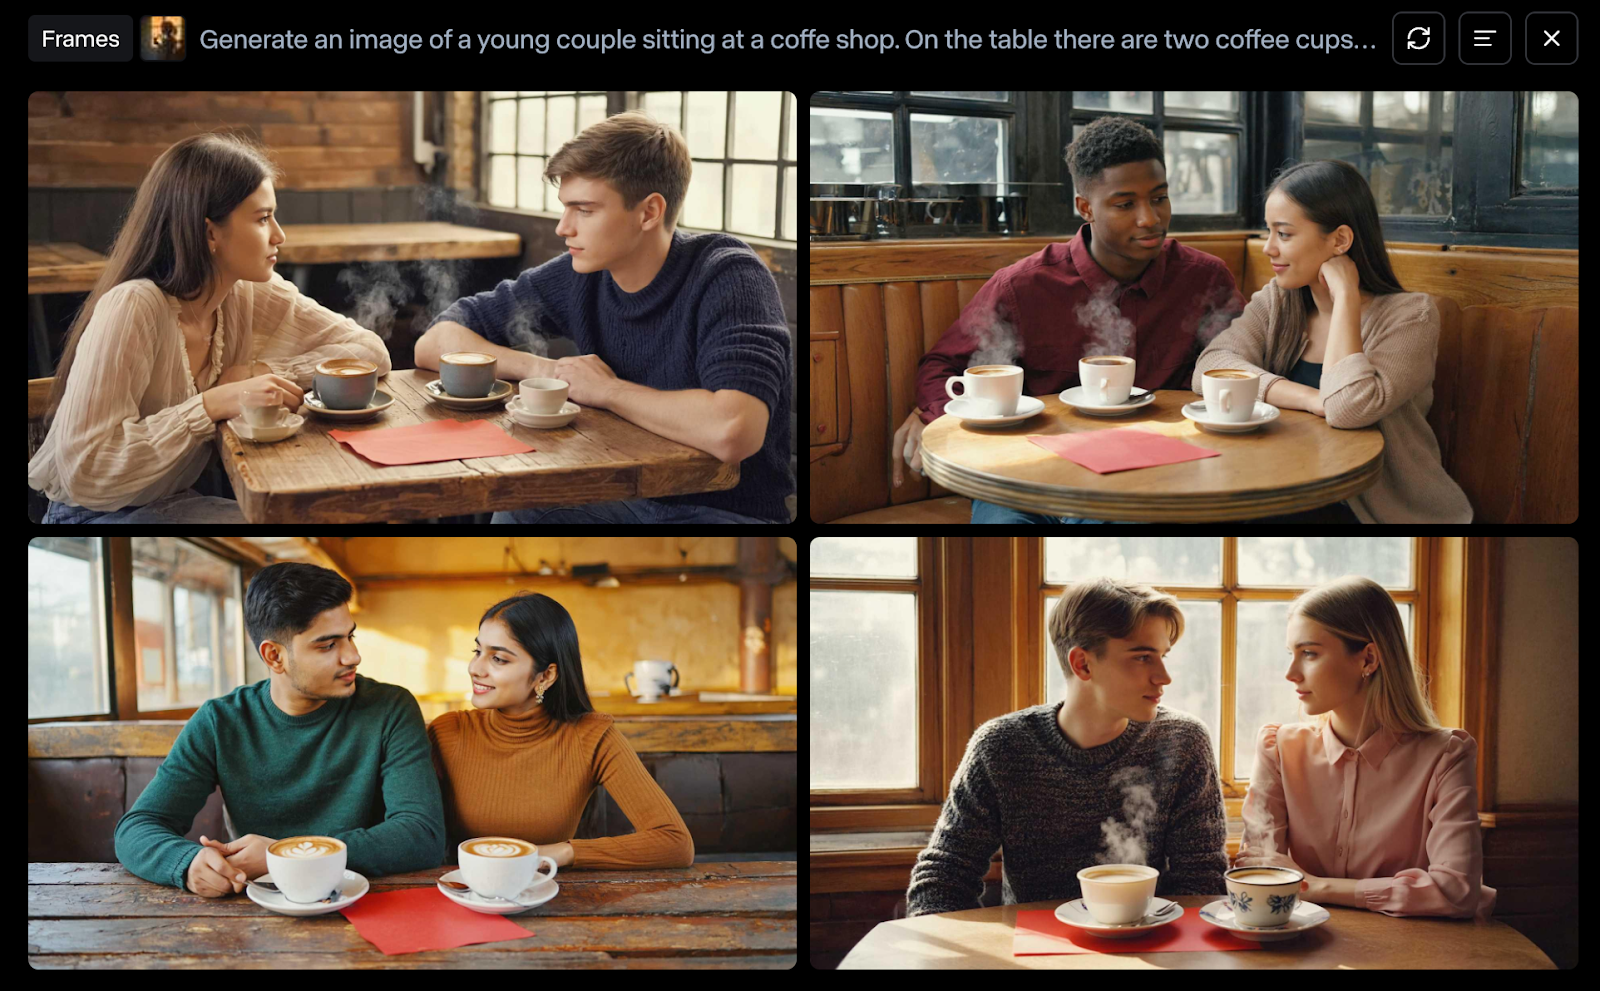
Solo le due in basso rispettano il prompt. Entrambe le immagini in alto mostrano più di due tazze di caffè e la prima ha persino strani artefatti.
Ho chiesto un foglio rosso sul tavolo perché volevo generare un video in cui l’uomo crea un fiore di carta origami da regalare alla ragazza.
Per farlo, possiamo passare il mouse sull’immagine che vogliamo usare e cliccare sul pulsante “Use”:
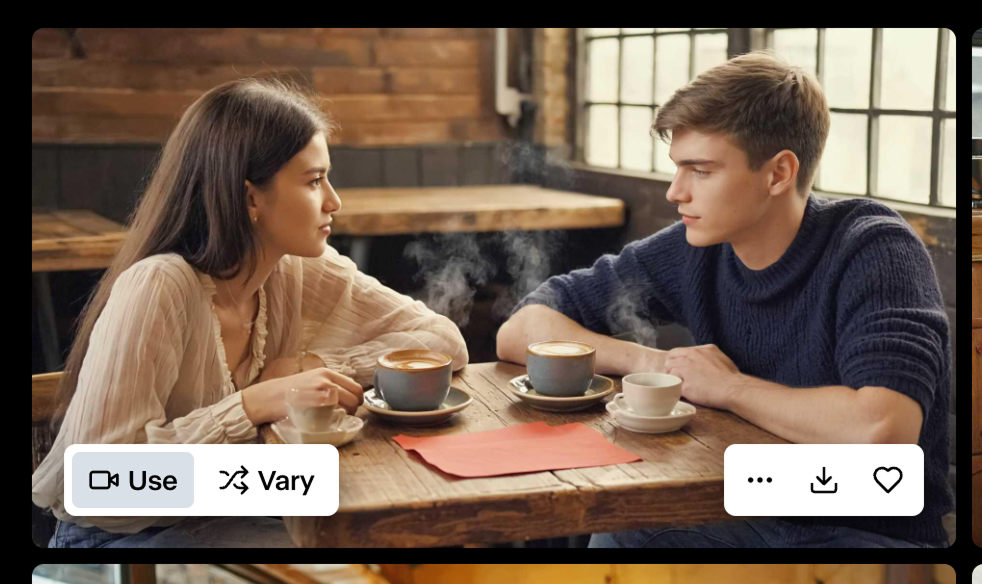
Ho creato un prompt chiedendo di generare un video con camera fissa in cui l’uomo realizza un fiore di origami e lo porge alla ragazza. L’ho provato due volte, prima generando un video di 5 secondi e poi uno di 10. I risultati, stavolta, sono stati piuttosto deludenti (qui ho usato Gen-4):
Funzionalità mancanti per la coerenza dei personaggi
Nelle ultime settimane ho testato molti strumenti di generazione video con l’IA. Uno dei principali problemi nella creazione di contenuti più lunghi è la possibilità di mantenere lo stesso personaggio in più scene. Questi strumenti in genere consentono di generare video della durata di pochi secondi. È sufficiente per creare un video lungo combinando più scene, ma serve la possibilità di far apparire lo stesso personaggio in scene diverse.
Nel loro articolo di presentazione di Gen-4, fanno sembrare molto semplice usare la nuova modalità per generare video più lunghi:
Mi aspettavo di poter fornire un’immagine del mio personaggio, generare le immagini delle scene con quel personaggio e infine generare ciascuna scena usando Gen-4. Tuttavia, questo non è supportato, almeno per ora.

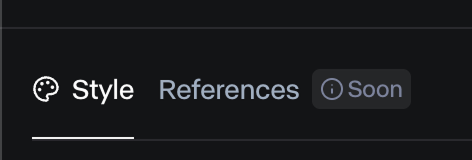
Nella scheda di generazione immagini vediamo una funzionalità “References” che non è ancora disponibile.
Trovo ciò fuorviante perché, senza quella funzione, i video del loro annuncio semplicemente non sono realizzabili.
Come aggirare i limiti di Runway
Per fortuna, sia Google che OpenAI hanno rilasciato di recente questa funzionalità nei loro modelli di generazione immagini. Lo storytelling mode di Gemini 2.0 di Google genera una serie di immagini per una data storia, mentre il generatore di immagini di GPT-4o di OpenAI può prendere un’immagine di riferimento e trasformarla in ciò che vogliamo. Se vuoi saperne di più su questi due strumenti, li ho trattati qui:
- Generazione di immagini con GPT-4o: guida con 8 esempi pratici
- Modifica di immagini con Gemini: guida con 10 esempi pratici
Generare un video con lo storytelling di Gemini
Ecco un video che ho creato chiedendo a Gemini di raccontare una storia visiva su una fiamma e una goccia d’acqua che si innamorano ma scoprono di non potersi toccare.
Nello storytelling mode, Gemini genera una sequenza di immagini per raccontare una storia visiva. Poi ho usato uno strumento di IA per generare prompt basati sulle linee guida di Runway per animare ciascun frame. Ecco il risultato:
Le clip sono state montate con un software di editing video. Ho fatto qualche taglio e semplici transizioni. Inoltre, ho dovuto iterare parecchio sia con Gemini che con Runway per ottenere i frame che volevo.
Sono abbastanza soddisfatto del risultato. Ci sono alcuni glitch qua e là, ma nel complesso sono riuscito a raccontare la storia che volevo. Mi sono persino sentito un po’ triste: questa storia dimostra che anche i contenuti generati dall’IA possono trasmettere vere emozioni umane, perché dietro c’è comunque una persona che cerca di esprimere un messaggio.
Generare un video con la generazione di immagini di GPT-4o
Penso che GPT-4o sia molto più potente e versatile di Gemini nella generazione di immagini. Il video precedente ha richiesto molte iterazioni per avvicinarsi a ciò che volevo e ho persino dovuto usare GPT-4o per generare uno dei frame.
Voglio provare una storia su un avventuriero che si arrampica dentro un quadro e viene teletrasportato nel mondo del dipinto.
Ho iniziato chiedendo a GPT-4o di generare il personaggio. Quando il risultato mi ha convinto, ho pensato ai frame che volevo:
- Il personaggio osserva il quadro.
- Un primo piano del volto del personaggio mentre contempla il quadro.
- Il personaggio sta entrando nel quadro.
- Il personaggio è ora nel mondo del dipinto.
- Un’inquadratura aerea mostra questo nuovo mondo vastissimo.
Una volta soddisfatto dei frame, ho usato Gen-4 per generare un video per ciascuno e li ho montati con un software di editing video:
Per essere un primo tentativo non è male. La scena in cui l’uomo entra nel quadro va rivista. Ho provato più generazioni, ma nessuna è uscita come volevo.
Runway Gen-4 vs altri strumenti
Poiché gli strumenti fondamentali per mantenere la coerenza dei personaggi non sono ancora disponibili su Runway, al momento della stesura Gen-4 è solo un modello image-to-video. Ho quindi voluto confrontarlo con altri modelli per vedere come si comporta.
Ho scelto di animare la prima scena del video Fiamma e Goccia d’Acqua, in cui la fiamma cammina verso destra ed esce dall’inquadratura.
Si vede che solo Runway riesce a svolgere il compito. Questo mostra l’enorme potenziale del modello una volta che tutte le funzionalità saranno disponibili.
Altri esempi di Runway Gen-4
In questa sezione mostro alcuni altri video che ho provato a generare per darti un’idea più precisa di cosa può fare Runway Gen-4 in questa fase.
Aereo di carta
Avevo l’idea di realizzare un video di qualcuno che costruisce un aeroplanino di carta e poi lo fa volare. Ho creato quattro frame:
- La persona sta costruendo l’aereo.
- La persona è in un campo e corre per lanciare l’aereo.
- La persona salta dentro l’aereo.
- La persona vola nell’aereo.
In questo esempio vediamo di nuovo che il modello ha faticato con la carta. Immagino sia troppo dettagliata. Inoltre, la scena del salto dentro l’aereo è molto strana.
Animare oggetti
Ero curioso di vedere come il modello gestisse l’animazione di oggetti del mondo reale, quindi ho scattato una foto e ho chiesto a Gen-4 di farli ballare. Il risultato è piuttosto divertente, secondo me:
Semaforo
Sul loro sito c’è un esempio di un omino del semaforo che prende vita e salta fuori dal semaforo. Questo mi ha ispirato a provare a creare un piccolo video di un omino del semaforo che scappa dalla polizia e poi salta in un semaforo pedonale inattivo per nascondersi.
Ecco le tre immagini che ho generato con GPT-4o, insieme ai video:
Purtroppo Gen-4 non è riuscito a realizzare la mia idea. Ho provato numerose iterazioni, ma era sempre lontano dal risultato desiderato.
Conclusione
Nel complesso, ritengo che Gen-4 sia un buon modello image-to-video, soprattutto con scene familiari. Tuttavia, ho provato molta frizione e frustrazione nel fargli fare ciò che volevo.
Ho anche trovato il loro annuncio un po’ fuorviante, perché alcune funzionalità necessarie per video lunghi e coerenti non sono ancora disponibili, e questo non era affatto chiaro prima di acquistare l’abbonamento. Vorrei che le aziende di IA aspettassero che i loro prodotti fossero pronti invece di cavalcare l’hype. Se non fosse stato per i recenti rilasci di Google e OpenAI, non sarei riuscito a realizzare nessuno dei video che ho fatto qui.
Penso che Runway sia promettente, ma è ancora lontana dal fornire un prodotto che chiunque abbia una storia da raccontare possa usare facilmente. Siamo ancora lontani anni luce dal poter immaginare qualcosa, metterlo in parole e vederlo prendere vita.
I loro esempi sono molto belli e credo siano stati realizzati con Gen-4, ma penso anche che ci sia stato un enorme lavoro dietro le quinte per dar loro vita.



