跳至内容

自组织映射(SOM):直观指南与 Python 示例

理解自组织映射的核心概念,并学习如何使用 MiniSom 在 Python 中实现。
已更新 2026年10月6日  · 15分钟 阅读

使用 AI 探索

ChatGPTClaudePerplexity

自组织映射(SOM)是一种用于无监督学习任务(如聚类)的人工神经网络。给定一组数据点,模型会学习将数据划分为若干簇。SOM 将复杂的多维数据投影到低维(通常为二维)网格上,从而便于可视化。因此,SOM 也常用于高维数据的可视化。 

在本教程中,我们将探讨 SOM 的核心概念、其学习过程及典型用例。我们将讲解如何使用 MiniSom 库在 Python 中实现 SOM,并如何以可视化方式呈现结果。最后,我们将讨论训练 SOM 模型时的重要超参数以及如何微调它们。 

理解自组织映射(SOM)

本节介绍 SOM 的核心概念、学习过程以及使用场景。 

SOM 的核心概念

理解自组织映射需要掌握以下几个重要概念。

神经元

SOM 本质上是一个神经元网格。在训练过程中,与某个输入数据点最接近的权重向量对应的神经元会调整自身及其邻居的权重,使其更贴近该输入数据点。经过多次迭代,相邻神经元群会映射到相互关联的数据点上,从而对输入数据集形成聚类。 

网格结构

SOM 中的神经元以网格形式组织。相邻神经元会映射到相似的数据点。更大的数据集需要更大的网格。通常,该网格为二维。该网格结构是将高维数据映射到的低维空间,有助于可视化数据模式和聚类。 

数据点映射

每个数据点都会通过某种距离度量与所有神经元进行比较。权重向量与输入数据点距离最近的神经元称为该数据点的最佳匹配单元(BMU)。 

识别出 BMU 后,会更新该 BMU 及其邻居神经元的权重,使它们更接近输入数据点。该映射会保留数据的拓扑结构,确保相似的数据点被映射到相邻的神经元上。 

SOM 的学习过程

SOM 的训练被视为无监督,因为它并不基于带标签的数据集。训练 SOM 的目标是迭代地调整神经元的权重向量,使相似的数据点映射到相邻的神经元上。 

竞争学习

SOM 使用竞争学习(而非梯度下降和反向传播)。神经元相互竞争,争当每个输入数据点的最佳匹配单元(BMU)。与数据点距离最近的神经元即为其 BMU。BMU 及其邻居会被更新,以进一步缩短与该数据点的距离。邻近神经元会映射到相关的数据点,这会促使神经元之间的分工与输入数据点的聚类。 

距离函数 

SOM 使用距离函数度量神经元与数据点之间的距离,并据此确定每个数据点的 BMU。MiniSom 提供四种可选的距离函数: 

邻域函数

确定某个数据点的 BMU 后,会沿着该数据点的方向更新 BMU 及其邻域内的神经元。邻域函数确保 SOM 维护输入数据的拓扑关系。邻域函数决定:

  • 哪些神经元被视为 BMU 的邻居
  • 邻居神经元被更新的幅度。通常,越接近 BMU 的神经元调整幅度越大,越远的则越小

MiniSom 提供三种邻域函数: 

  • 高斯(默认)。 
  • 气泡(Bubble) 
  • 墨西哥帽(Mexican hat)
  • 三角形(Triangle)

迭代过程

SOM 的学习过程在多次迭代中完成。在每次迭代中,SOM 会处理大量输入数据点。学习过程可概括为以下步骤:

  • 训练开始时,所有神经元的权重会(随机)初始化。 
  • 给定一个输入数据点,每个神经元都会计算其与输入的距离。
    • 距离最小的神经元被确定为 BMU。 
  • 调整 BMU 及其邻居的权重,使之更接近输入向量。调整幅度由以下因素决定:
    • 邻域函数:距离 BMU 越远的神经元更新幅度越小,这有助于保持数据的拓扑结构。 
    • 学习率:学习率越高,更新幅度越大。 

以上步骤会在多次迭代中反复进行、遍历多个输入数据点。权重将逐步更新,使得映射自组织并捕捉数据结构。 

学习率与邻域半径通常会随时间递减,使 SOM 能逐步微调权重。稍后我们将使用 Python 代码实现这一迭代训练过程的步骤。 

SOM 的典型用例

凭借其独特的架构,SOM 在机器学习、分析与可视化方面有多种典型应用。

聚类

SOM 用于将高维数据聚类为相似数据点的集合,帮助识别数据中的内在结构。每个神经元映射到密切相关的数据点,相似的数据点会映射到同一或相邻神经元,从而形成明确的簇。 

例如,在营销场景中,SOM 可根据购买行为对客户进行分群,使品牌能够针对不同客户分群(簇)制定营销策略。

降维

SOM 能将拥有众多特征向量的高维数据映射到更低维的网格(通常为二维)。由于该映射保留了数据点之间的关系,降维后可以更容易地可视化复杂数据集,同时不会显著丢失信息。

除了便于可视化与分析外,SOM 还可以作为其他机器学习算法之前的降维步骤。在图像处理领域,SOM 可通过对具有相似特征的像素或区域进行聚类来减少特征数量,从而更高效地完成图像识别与分类任务。 

异常检测

在训练过程中,大多数数据点会被映射到特定神经元。异常值(不易归入任何簇的数据点)通常会映射到距离较远或不太密集的神经元上。这些离群点难以融入已学得的簇,往往位于与正常数据 BMU 相距较远的神经元。

例如,将金融交易映射到 SOM 网格上,可以识别异常活动(离群点),用于提示潜在的欺诈行为。 

数据可视化

数据可视化是 SOM 最常见的用例之一。高维数据难以直接可视化,SOM 通过降维并将数据投影到二维网格上,使可视化变得更容易。这也有助于检测数据中的簇以及在原始数据中难以发现的异常点。 

例如,可视化有助于分析高维的人口数据。将数据映射到二维网格,有助于发现不同人群之间的相似与差异。  

在讨论了 SOM 的核心概念与用例后,接下来我们将展示如何使用 Python 包 MiniSom 来实现。 

您可以在此 DataLab 笔记本访问并运行完整代码。

为 SOM 搭建环境

在构建 SOM 之前,我们需要准备必要的软件包。 

安装 Python 库 

我们需要以下包: 

  • MiniSom 是一个基于 NumPy 的 Python 工具,用于创建和训练 SOM。 
  • NumPy 用于访问数组拆分、获取唯一值等数学函数。 
  • matplotlib 用于绘制各种图表以可视化数据。 
  • 来自 sklearn 的 datasets 包用于导入要应用 SOM 的数据集。 
  • 来自 sklearn 的 MinMaxScaler 用于对数据集进行归一化。 

以下代码片段用于导入这些包: 

from minisom import MiniSom
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.preprocessing import MinMaxScaler

准备数据集

在本教程中,我们使用 MiniSom 构建 SOM,并在经典的 IRIS 数据集上进行训练。该数据集包含 3 个鸢尾花类别,每类 50 个样本。我们按以下步骤准备数据: 

  • 从 sklearn 导入 Iris 数据集, 
  • 提取数据向量与目标标量。 
  • 对数据向量进行归一化。在本教程中,我们使用scikit-learn 的 MinMaxScaler。 
  • 为三类鸢尾花分别声明一组标签。 

以下代码实现了上述步骤: 

dataset_iris = datasets.load_iris()
data_iris = dataset_iris.data
target_iris = dataset_iris.target
data_iris_normalized = MinMaxScaler().fit_transform(data_iris)
labels_iris = {1:'1', 2:'2', 3:'3'}
data = data_iris_normalized
target = target_iris

在 Python 中实现自组织映射(SOM)

要在 Python 中实现 SOM,我们需在训练数据集之前先定义并初始化网格。随后可以对训练好的神经元和聚类结果进行可视化。 

定义 SOM 网格

如前所述,SOM 是一个神经元网格。使用 MiniSom,我们可以创建二维网格。网格的 X、Y 维度分别是沿各轴的神经元数量。定义 SOM 网格时,还需指定:

  • 网格的 X 与 Y 维度
  • 输入变量的数量——即数据的列数。 

将这些参数声明为 Python 常量:

SOM_X_AXIS_NODES  = 8
SOM_Y_AXIS_NODES  = 8
SOM_N_VARIABLES  = data.shape[1]

下面的示例代码演示如何使用 MiniSom 声明网格:

som = MiniSom(SOM_X_AXIS_NODES, SOM_Y_AXIS_NODES, SOM_N_VARIABLES)

前两个参数是 X、Y 轴的神经元数量,第三个参数是变量(特征)数量。 

在创建 SOM 网格时,我们还会声明其他参数和超参数。我们稍后再解释其含义。此处先按如下方式声明: 

ALPHA = 0.5
DECAY_FUNC = 'linear_decay_to_zero'
SIGMA0 = 1.5
SIGMA_DECAY_FUNC = 'linear_decay_to_one'
NEIGHBORHOOD_FUNC = 'triangle'
DISTANCE_FUNC = 'euclidean'
TOPOLOGY = 'rectangular'
RANDOM_SEED = 123

使用这些参数创建 SOM:

som = MiniSom(
        SOM_X_AXIS_NODES,
        SOM_Y_AXIS_NODES,
        SOM_N_VARIABLES,
        sigma=SIGMA0,
        learning_rate=ALPHA,
        neighborhood_function=NEIGHBORHOOD_FUNC,
        activation_distance=DISTANCE_FUNC,
        topology=TOPOLOGY,
        sigma_decay_function = SIGMA_DECAY_FUNC,
        decay_function = DECAY_FUNC,
        random_seed=RANDOM_SEED,
        )

初始化神经元

上述命令会创建一个所有神经元权重均为随机值的 SOM。用从数据中抽取的权重(而非纯随机数)来初始化神经元,可以让训练更高效。 

在使用 MiniSom 创建自组织映射(SOM)时,有两种基于数据初始化神经元权重的方法:

  • 随机初始化:神经元的初始权重从输入数据中随机抽取。可通过对 SOM 调用 .random_weights_init() 实现。 
  • PCA 初始化:主成分分析(PCA)初始化使用主成分来初始化权重。神经元的初始权重跨越前两个主成分,通常能加快收敛。 

本指南使用 PCA 初始化。要将 PCA 初始化应用于 SOM 权重,按如下方式调用 .pca_weights_init():

som.pca_weights_init(data)

训练 SOM

训练过程会更新 SOM 的权重,以最小化神经元与数据点之间的距离。 

下面解释迭代训练过程:

  • 初始化:通常以随机值初始化所有神经元的权重向量,也可以通过从输入数据分布中采样来初始化。
  • 选择输入:从训练数据集中(随机)选取一个输入向量。
  • BMU 识别:找出与输入向量最接近的权重向量对应的神经元,作为 BMU。 
  • 邻域更新:BMU 及其邻域内的神经元更新其权重向量。学习率与邻域函数决定更新哪些神经元以及更新幅度。在第 t 次迭代、给定输入向量 x,神经元 i 的权重向量为 wi,学习率 (t),邻域函数 hbi(该函数量化在给定 BMU 神经元 b 的情况下对神经元 i 的更新幅度),则神经元 i 的权重更新公式表达为:
  • 学习率与邻域半径的衰减:学习率与邻域半径都会随时间递减。早期迭代会在更大的邻域内进行较大的调整;后期迭代通过对相邻神经元的权重进行小幅调整来微调权重,从而使映射趋于稳定并收敛。 

为训练 SOM,我们需要将输入数据馈送给模型。可选择以下两种方式: 

  • 从输入数据中随机抽取样本。使用 .train_random() 函数实现。 
  • 按顺序遍历输入数据中的向量。使用 .train_batch() 函数实现。 

这些函数都接收输入数据与迭代次数作为参数。本文使用 .train_random() 函数。将迭代次数声明为常量并传给训练函数: 

N_ITERATIONS = 5000
som.train_random(data, N_ITERATIONS, verbose=True)  

脚本执行完训练后,会显示量化误差信息:

quantization error: 0.05357240680504421 

量化误差表示 SOM 对数据进行量化(降维)时的信息损失程度。量化误差越大,说明神经元与数据点之间的距离越大,聚类的可靠性也越低。 

可视化 SOM 神经元 

我们已经训练好了 SOM 模型。为进行可视化,我们使用距离图(也称为U-matrix)。距离图将 SOM 的神经元显示为一个由单元格组成的网格,每个单元格的颜色表示其与邻居神经元的距离。 

距离图与 SOM 具有相同的维度。距离图中的每个单元格,是该神经元与其邻居之间(欧氏)距离的归一化和。 

通过 .distance_map() 函数访问SOM 距离图。要生成 U-matrix,我们执行以下步骤:

  • 使用 pyplot 创建与 SOM 维度一致的图形。在本示例中为 8x8。 
  • 使用 matplotlib 的 .pcolor() 绘制距离图。本例使用 gist_yarg作为配色方案。 
  • 显示 colorbar,即颜色与标量值的对应索引。此处由于距离已归一化,数值范围为 0 到 1。 

以下代码实现上述步骤: 

# create the grid
plt.figure(figsize=(8, 8))
#plot the distance map
plt.pcolor(som.distance_map().T, cmap='gist_yarg') 
# show the color bar
plt.colorbar()
plt.show()

在本例中,U-matrix 采用单色配色方案,可按以下方式理解:
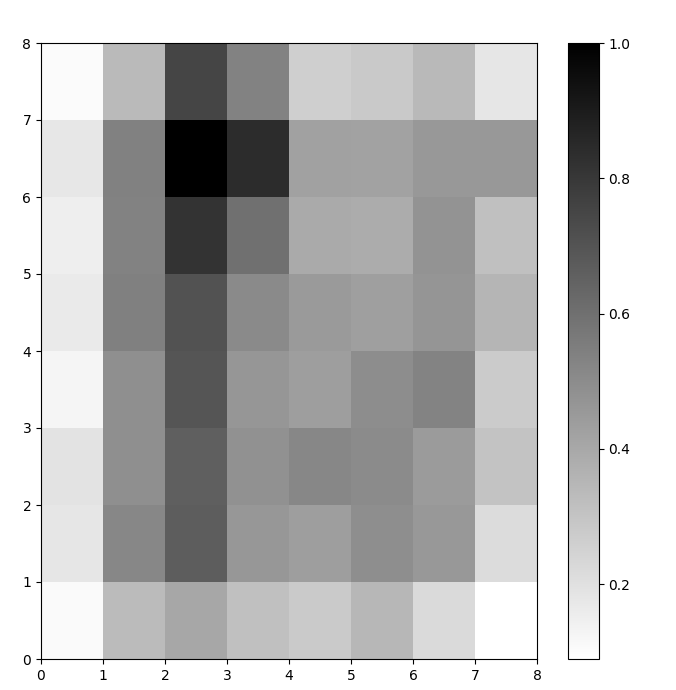
  • 颜色越浅表示神经元之间越接近,颜色越深表示与其他神经元距离越远。 
  • 浅色区域的成组出现可解释为簇,而簇之间的深色节点可解释为簇间边界。 

图 1:Iris 数据集的 U-matrix

图 1:在 Iris 数据集上训练的 SOM 的 U-matrix(作者制图)

评估 SOM 的聚类结果

上图以图形方式展示了 SOM 的神经元。本节将展示如何可视化 SOM 对数据的聚类情况。 

识别簇

我们在上述 U-matrix 上叠加标记,以表示每个单元(神经元)对应的鸢尾花类别。操作步骤:

  • 与之前相同,使用 pyplot 创建 8x8 图形,绘制距离图并显示色条。 
  • 指定一个包含三种matplotlib 标记的数组,每种对应一个鸢尾花类别。 
  • 为每个鸢尾花类别指定一个由三种matplotlib 颜色代码组成的数组。 
  • 逐个绘制每个数据点的获胜神经元:
    • 使用 .winner() 函数确定每个数据点的获胜神经元(坐标)。 
    • 将每个获胜神经元的位置绘制在网格每个单元格的中间。w[0] 与 w[1] 分别给出神经元的 X 与 Y 坐标。在每个坐标上加 0.5 以将其绘制在单元格中心。 

如下代码展示了具体实现:

# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg') 
plt.colorbar()
# create the markers and colors for each class
markers = ['o', 'x', '^']
colors = ['C0', 'C1', 'C2']
# plot the winning neuron for each data point
for count, datapoint in enumerate(data):
    # get the winner
    w = som.winner(datapoint)  
    # place a marker on the winning position for the sample data point
    plt.plot(w[0]+.5, w[1]+.5, markers[target[count]-1], markerfacecolor='None',
             markeredgecolor=colors[target[count]-1], markersize=12, markeredgewidth=2)
plt.show()

生成的图像如下: 
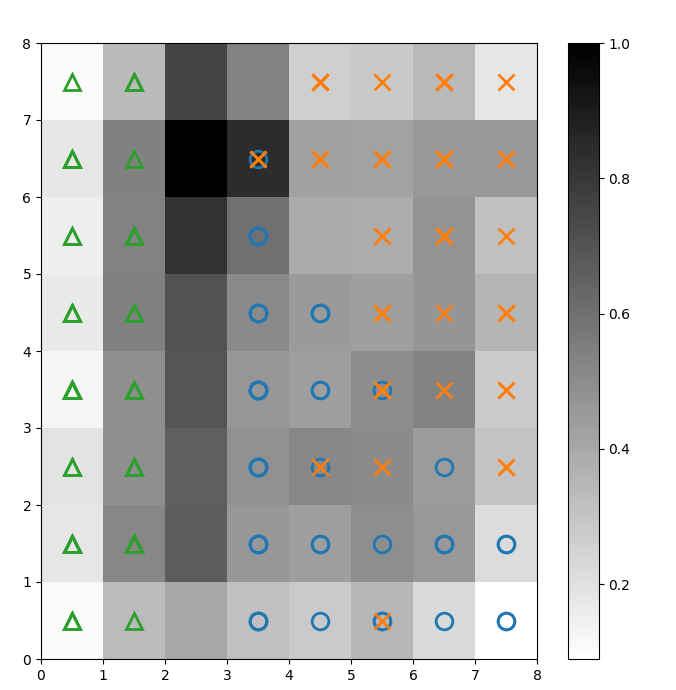
叠加类别标记的 U-matrix

图 2:叠加类别标记的 U-matrix(作者制图)

根据Iris 数据集文档,“其中一类可线性分离于另外两类;后两类之间并非线性可分”。在上图 U-matrix 中,这三类分别由三角形、圆形与叉号标记表示。 

请注意,蓝色圆点与橙色叉号之间并没有清晰的边界。此外,许多单元格中两个类别叠加在同一神经元上,说明该神经元与这两个类别的距离相近。 

可视化聚类结果

SOM 是一种聚类模型。相似的数据点会映射到同一神经元;同一类别的数据点会映射到相邻神经元构成的簇。我们将所有数据点绘制在 SOM 网格上,以更好地观察聚类行为。 

以下步骤描述了如何创建该散点图:

  • 获取每个数据点的获胜神经元的 X、Y 坐标。 
  • 像图 1一样绘制距离图。 
  • 使用 plt.scatter() 将每个数据点对应的获胜神经元全部绘制为散点。为避免同一单元格内的数据点重叠,给每个点添加一个随机偏移。

以下代码实现上述步骤: 

# get the X and Y coordinates of the winning neuron for each data pointw_x, w_y = zip(*[som.winner(d) for d in data])
w_x = np.array(w_x)
w_y = np.array(w_y)
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg', alpha=.2)
plt.colorbar()
# make a scatter plot of all the winning neurons for each data point
# add a random offset to each point to avoid overlaps
for c in np.unique(target):
    idx_target = target==c
    plt.scatter(w_x[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
                w_y[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
                s=50, 
                c=colors[c-1], 
                label=labels_iris[c+1]
                )
plt.legend(loc='upper right')
plt.grid()
plt.show()

下图展示了输出的散点图:
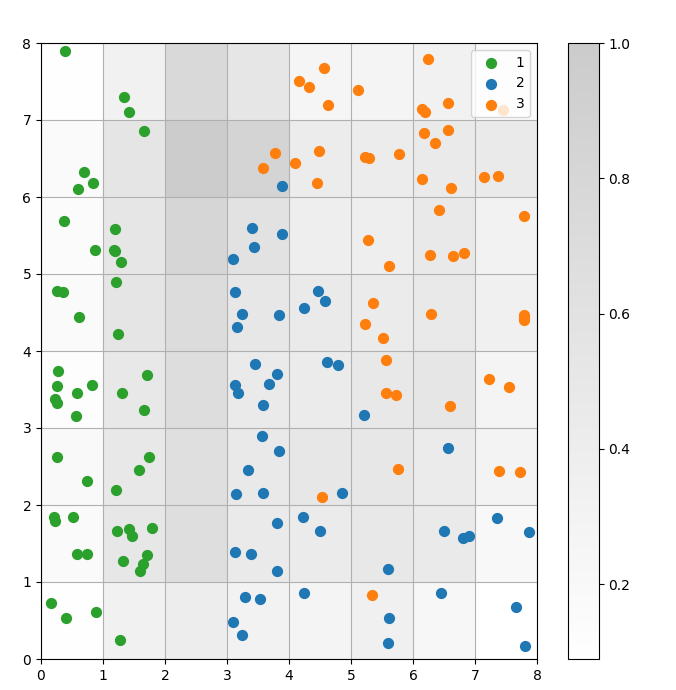
单元格内数据点的散点图 图 3:单元格内数据点的散点图(作者制图)

从上述散点图可以观察到: 

  • 部分单元格同时包含蓝色与橙色点。 
  • 绿色点与其余数据明显分离,但蓝色与橙色点并未干净地分离。 
  • 上述现象与 Iris 数据集中仅有一个簇具备清晰边界的事实相吻合。 
  • 图 1 中簇之间的深色节点(可解释为簇间边界)与散点图中的空单元格相对应。 

您可以在此 DataLab 笔记本访问并运行完整代码。 

调优 SOM 模型

前文展示了如何创建和训练 SOM 模型,以及如何以可视化方式研究结果。本节将讨论如何调优 SOM 模型的性能。 

需调优的关键超参数

与任何机器学习模型一样,超参数会显著影响模型性能。 

在训练 SOM 时,一些重要的超参数包括:

  • 网格大小决定映射的尺寸。网格大小为 A×B 的映射包含 A*B 个神经元。 
  • 初始学习率决定每次迭代中权重的更新幅度。我们设置初始学习率,并根据衰减函数随时间递减。 
  • 学习率衰减函数决定后续每次迭代中学习率的递减幅度。 
  • 邻域函数是一类数学函数,用于指定哪些神经元被视为 BMU 的邻居。 
  • 邻域函数的标准差指定其扩散范围。例如,标准差较大的高斯邻域函数会比标准差较小的覆盖更大的邻域。我们设置初始标准差,并根据 sigma 衰减函数随时间递减。 
  • sigma衰减函数控制后续每次迭代中标准差的递减幅度。 
  • 训练迭代次数决定权重被更新的次数。每次训练迭代中,神经元权重会更新一次。 
  • 距离函数是一类数学函数,用于计算神经元与数据点之间的距离。 
  • 拓扑结构决定网格的布局。网格中的神经元可以按矩形或六边形排列。 

下一节我们将讨论设置这些超参数取值的指南。 

超参数调优的影响

超参数的取值应基于模型与数据集来确定。在一定程度上,这一过程需要试验与迭代。本节为每个超参数提供调优指南,并在括号中标注示例代码中相应的 Python 常量。

  • 网格大小 (SOM_X_AXIS_NODES 与 SOM_Y_AXIS_NODES):网格大小取决于数据集规模。经验法则是给定规模为 N 的数据集,网格应包含约5*sqrt(N) 个神经元。例如,若数据集有 150 个样本,网格应包含 5*sqrt(150) ≈ 61 个神经元。本文中,Iris 数据集有 150 行,我们使用 8x8 网格。 
  • 初始学习率 (ALPHA):学习率较高可加快收敛,而较低学习率适用于早期迭代后的精细调整。初始学习率应足够大以便快速适应,但不至于过冲最优权重值。本文初始学习率为 0.5。 
  • 初始标准差 (SIGMA0):决定邻域的初始大小或扩散范围。较大取值更注重全局模式。本文使用 1.5 作为起始标准差。 
  • 对于学习率衰减 (DECAY_FUNC)与 sigma 衰减 (SIGMA_DECAY_FUNC),可从以下三类衰减函数中选择: 
    • 反比衰减:适用于同时存在全局与局部模式的数据。在此情形下,需要更长的广域学习阶段,随后再聚焦局部模式。 
    • 线性衰减:适用于希望以稳定、均匀的方式缩小邻域大小或学习率的数据集。若数据不需要大量微调,该方法较为合适。
    • 渐近衰减:适用于复杂且高维的数据。在这种情况下,先花更多时间进行全局探索,再逐步转向细节更为合适。 
  • 邻域函数(NEIGHBORHOOD_FUNC):默认选择为高斯函数。其他函数如下所述,也有其适用场景。 
    • 高斯(默认):呈钟形曲线。神经元的更新幅度会随其与获胜神经元的距离平滑递减。该函数提供平滑连续的过渡并保留数据拓扑,因其稳定可预期的行为,适用于大多数通用目的。
    • 气泡(Bubble):形成固定宽度的邻域。邻域内的所有神经元等量更新,邻域外则不更新(对给定数据点而言)。计算开销较小、实现更简单。适用于较小的映射,且明确的邻域边界不会影响有效聚类的情形。 
    • 墨西哥帽:中心为正值区域,周围为负值区域。靠近 BMU 的神经元被更新为更接近数据点,更远的神经元则被更新为远离数据点。该技术可增强对比度、突出映射中的特征。由于强调清晰的簇分离,适用于需要明确簇分界的模式识别任务。
    • 三角形(Triangle):邻域影响呈三角形分布,BMU 影响最大,影响随距离线性递减。适用于簇或特征之间过渡渐进的数据,如图像、语音或时间序列数据,这些数据中邻近点通常具有相似特征。 
  • 距离函数(DISTANCE_FUNC):用于度量神经元与数据点之间的距离,可从以下 4 种方法中选择:
    • 欧氏距离(默认):适用于连续数据、希望度量直线距离的场景。适合大多数通用任务,尤其当数据点分布均匀且具有空间关联时。
    • 余弦距离:适用于文本或高维稀疏数据,此时向量间的夹角比幅值更重要。可用于比较数据的方向性。
    • 曼哈顿距离:当数据点位于网格或格点(如城市街区)时更理想。相比欧氏距离,对离群点不那么敏感。
    • 切比雪夫距离:适用于可在任意方向移动的场景(如棋盘距离)。对离散空间中希望强调最大轴向差异的情况很有用。
  • 拓扑结构(TOPOLOGY):在网格中,神经元可按六边形或矩形结构排列: 
    • 矩形(默认):每个神经元有 4 个紧邻邻居。当数据不具有明显空间关系时,这是合适的选择,且计算更简单。 
    • 六边形:每个神经元有 6 个邻居。若数据的空间关系用六边形网格表示更恰当(如环形或角度分布数据),该选项更优。
  • 训练迭代次数(N_ITERATIONS):原则上更长的训练能带来更低误差、使权重更好地贴合输入数据。但模型性能随迭代次数的提升呈渐近趋势,超过某一阈值后,新增迭代带来的提升仅是边际的。确定合适的迭代次数需要一定试验。本文将模型训练 5000 次迭代。 

为确定合适的超参数配置,建议先在较小的数据子集上尝试多种选项。

结论

自组织映射是一种稳健的无监督学习工具。它被用于聚类、降维、异常检测与数据可视化。由于能保留高维数据的拓扑特性并将其表示在低维网格上,SOM 便于可视化与解释复杂数据集。 

本教程讨论了 SOM 的基本原理,并展示了如何使用 MiniSom Python 库实现 SOM。同时演示了如何对结果进行可视化分析,并解释了训练 SOM 及微调其性能所用的重要超参数。

FAQs

SOM 的训练会涉及反向传播吗?

SOM 是一种人工神经网络,但其训练不基于误差校正,因此不使用带有梯度下降的反向传播。SOM 采用的是竞争学习。

为什么需要衰减函数?

在训练早期,模型需要探索数据的全局格局,因此学习率应较高,邻域函数的扩散也应较广。到了训练后期,会基于相邻神经元对权重做更细微的调整。随着训练推进,衰减函数会降低学习率与邻域半径。

默认(随机)初始化与基于输入数据的随机初始化有何区别?

在默认初始化中,权重会被初始化为任意随机数。

在基于输入数据的随机初始化中,权重被初始化为从输入数据中随机选择的样本。

SOM 能捕捉数据中的非线性关系吗?

可以。SOM 通过多种邻域函数来捕捉数据中的非线性模式。单个数据点可以影响(其邻域内的)多个神经元的取值,这使得 SOM 能够刻画数据中的复杂关系。

SOM 与传统聚类方法有何不同?

SOM 将高维数据映射到低维网格,同时保留空间关系。传统的聚类方法(如 K-Means)则基于距离度量创建分组,不一定考虑数据的拓扑或空间关系。 

注意,在数据分析中,拓扑或空间关系是指数据点在多维空间中的相对位置关系。


Arun Nanda's photo
Author
Arun Nanda
LinkedIn

Arun 曾是一位初创公司创始人,喜欢构建新事物。他目前正探索人工智能的技术与数学基础。他乐于分享自己的所学,因此会写作记录。

除了 DataCamp,您还可以在 Medium、Airbyte 和 Vultr 阅读他的文章。

主题
机器学习
Python

通过以下课程深入学习机器学习与 Python!

课程

Python 树模型机器学习

5 小时
119.8K
在本课程中,你将学习如何使用 scikit-learn 中的基于树的模型和集成方法进行回归和分类。
查看详情Right Arrow
开始课程
查看更多Right Arrow