

Configurare l’ambiente per le SOM
Prima di costruire la SOM, dobbiamo preparare l’ambiente con i pacchetti necessari.
Installare le librerie Python
Ci servono questi pacchetti:
- MiniSom è uno strumento Python basato su NumPy che crea e addestra SOM.
- NumPy viene utilizzato per accedere a funzioni matematiche come divisione di array, ottenimento di valori unici, ecc.
matplotlibè utilizzato per tracciare vari grafici e chart per visualizzare i dati.- Il pacchetto
datasetsdisklearnserve per importare i dataset su cui applicare la SOM. - Il pacchetto
MinMaxScalerdisklearnnormalizza il dataset.
Il seguente snippet importa questi pacchetti:
from minisom import MiniSom
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.preprocessing import MinMaxScalerPreparare il dataset
In questo tutorial usiamo MiniSom per costruire una SOM e poi addestrarla sul canonico dataset IRIS. Questo dataset consiste in 3 classi di piante di iris. Ogni classe ha 50 istanze. Per preparare i dati, seguiamo questi passaggi:
- Importa il dataset Iris da
sklearn, - Estrai i vettori dei dati e gli obiettivi scalari.
- Normalizza i vettori dei dati. In questo tutorial usiamo il MinMaxScaler di scikit-learn.
- Dichiara un set di etichette per ciascuna delle tre classi di piante di Iris.
Il seguente codice implementa questi passaggi:
dataset_iris = datasets.load_iris()
data_iris = dataset_iris.data
target_iris = dataset_iris.target
data_iris_normalized = MinMaxScaler().fit_transform(data_iris)
labels_iris = {1:'1', 2:'2', 3:'3'}
data = data_iris_normalized
target = target_irisImplementare le Self-Organizing Maps (SOM) in Python
Per implementare una SOM in Python, definiamo e inizializziamo la griglia prima di addestrarla sul dataset. Possiamo poi visualizzare i neuroni addestrati e il dataset clusterizzato.
Definire la griglia della SOM
Come spiegato in precedenza, una SOM è una griglia di neuroni. Con MiniSom possiamo creare griglie bidimensionali. Le dimensioni X e Y della griglia sono il numero di neuroni lungo ciascun asse. Per definire la griglia SOM, dobbiamo anche specificare:
- Le dimensioni X e Y della griglia
- Il numero di variabili di input - cioè il numero di righe dei dati.
Dichiara questi parametri come costanti Python:
SOM_X_AXIS_NODES = 8
SOM_Y_AXIS_NODES = 8
SOM_N_VARIABLES = data.shape[1]Il codice di esempio sotto illustra come dichiarare la griglia con MiniSom:
som = MiniSom(SOM_X_AXIS_NODES, SOM_Y_AXIS_NODES, SOM_N_VARIABLES)I primi due parametri sono il numero di neuroni lungo gli assi X e Y, e il terzo è il numero di variabili.
Dichiariamo altri parametri e iperparametri durante la creazione della griglia SOM. Li spiegheremo più avanti nel tutorial. Per ora, dichiara questi parametri come mostrato di seguito:
ALPHA = 0.5
DECAY_FUNC = 'linear_decay_to_zero'
SIGMA0 = 1.5
SIGMA_DECAY_FUNC = 'linear_decay_to_one'
NEIGHBORHOOD_FUNC = 'triangle'
DISTANCE_FUNC = 'euclidean'
TOPOLOGY = 'rectangular'
RANDOM_SEED = 123Crea una SOM usando questi parametri:
som = MiniSom(
SOM_X_AXIS_NODES,
SOM_Y_AXIS_NODES,
SOM_N_VARIABLES,
sigma=SIGMA0,
learning_rate=ALPHA,
neighborhood_function=NEIGHBORHOOD_FUNC,
activation_distance=DISTANCE_FUNC,
topology=TOPOLOGY,
sigma_decay_function = SIGMA_DECAY_FUNC,
decay_function = DECAY_FUNC,
random_seed=RANDOM_SEED,
)Inizializzare i neuroni
Il comando sopra crea una SOM con pesi casuali per tutti i neuroni. Inizializzare i neuroni con pesi campionati dai dati (invece che numeri casuali) può rendere il processo di addestramento più efficiente.
Usando MiniSom per creare una Self-Organizing Map (SOM), ci sono due modi per inizializzare i pesi dei neuroni basandosi sui dati:
- Inizializzazione casuale: i pesi iniziali dei neuroni sono estratti casualmente dai dati di input. Lo facciamo applicando la funzione
.random_weights_init()alla SOM. - Inizializzazione PCA: la Principal Component Analysis (PCA) utilizza the componenti principali dei dati di input per inizializzare i pesi. I pesi iniziali dei neuroni si estendono lungo le prime due componenti principali. Questo spesso porta a una convergenza più rapida.
In questa guida usiamo l’inizializzazione PCA. Per applicarla ai pesi della SOM, usa la funzione .pca_weights_init() come mostrato sotto:
som.pca_weights_init(data)Addestrare la SOM
Il processo di addestramento aggiorna i pesi della SOM per minimizzare la distanza tra neuroni e punti dati.
Di seguito spieghiamo il processo di addestramento iterativo:
- Inizializzazione: i vettori dei pesi di tutti i neuroni sono inizializzati, tipicamente con valori casuali. È anche possibile inizializzare i pesi campionando dalla distribuzione dei dati di input.
- Selezione dell’input: un vettore di input viene selezionato (casualmente) dal dataset di addestramento.
- Identificazione della BMU: il neurone con il vettore dei pesi più vicino al vettore di input è identificato come BMU.
- Aggiornamento del vicinato: la BMU e i neuroni vicini aggiornano i loro vettori dei pesi. Il tasso di apprendimento e la funzione di vicinato decidono quali neuroni vengono aggiornati e di quanto. All’iterazione t, dato il vettore di input x, il vettore dei pesi del neurone i come wi, il tasso di apprendimento (t) e la funzione di vicinato hbi (questa funzione quantifica l’entità dell’aggiornamento per il neurone i data la BMU b), la formula di aggiornamento dei pesi per il neurone i è espressa come:
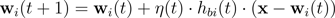
- Decadimento del tasso di apprendimento e del raggio di vicinato: sia il tasso di apprendimento sia il raggio di vicinato diminuiscono nel tempo. Nelle prime iterazioni, il processo fa aggiustamenti più grandi su un vicinato più ampio. Le iterazioni successive aiutano a rifinire i pesi con modifiche più piccole ai neuroni adiacenti. Questo permette alla mappa di stabilizzarsi e convergere.
Per addestrare la SOM, presentiamo al modello i dati di input. Possiamo scegliere tra due approcci:
- Selezionare campioni a caso dai dati di input. La funzione
.train_random()implementa questa tecnica. - Scorrere sequenzialmente i vettori nei dati di input. Si fa con la funzione
.train_batch().
Queste funzioni accettano i dati di input e il numero di iterazioni come parametri. In questa guida usiamo la funzione .train_random() . Dichiara il numero di iterazioni come costante e passalo alla funzione di training:
N_ITERATIONS = 5000
som.train_random(data, N_ITERATIONS, verbose=True) Dopo aver eseguito lo script e completato l’addestramento, viene mostrato un messaggio con l’errore di quantizzazione:
quantization error: 0.05357240680504421 L’errore di quantizzazione indica la quantità di informazione persa quando la SOM quantizza (riduce la dimensionalità di) i dati. Un errore elevato indica una maggiore distanza tra neuroni e punti dati. Significa anche che il clustering è meno affidabile.
Visualizzare i neuroni della SOM
Ora abbiamo un modello SOM addestrato. Per visualizzarlo, usiamo una mappa delle distanze (nota anche come U-matrix). La mappa delle distanze mostra i neuroni della SOM come una griglia di celle. Il colore di ogni cella rappresenta la sua distanza dai neuroni adiacenti.
La mappa delle distanze è una griglia con le stesse dimensioni della SOM. Ogni cella della mappa delle distanze è la somma normalizzata delle distanze (euclidee) tra un neurone e i suoi vicini.
Accedi alla mappa delle distanze della SOM usando la funzione .distance_map(). Per generare la U-matrix, seguiamo questi passaggi:
- Usa
pyplotper creare una figura con le stesse dimensioni della SOM. In questo esempio, le dimensioni sono 8x8. - Traccia la mappa delle distanze con matplotlib usando la funzione
.pcolor(). In questo esempio usiamogist_yargcome schema di colori. - Mostra la
colorbar, un indice che mappa colori diversi a valori scalari diversi. In questo caso, dato che le distanze sono normalizzate, i valori scalari vanno da 0 a 1.
Il codice seguente implementa questi passaggi:
# create the grid
plt.figure(figsize=(8, 8))
#plot the distance map
plt.pcolor(som.distance_map().T, cmap='gist_yarg')
# show the color bar
plt.colorbar()
plt.show()In questo esempio, la U-matrix usa una scala di colori monotona. Può essere interpretata con queste linee guida:
- Le tonalità più chiare rappresentano neuroni vicini tra loro, quelle più scure neuroni più distanti dagli altri.
- Gruppi di tonalità chiare possono essere interpretati come cluster. I nodi scuri tra i cluster possono essere interpretati come confini tra cluster.
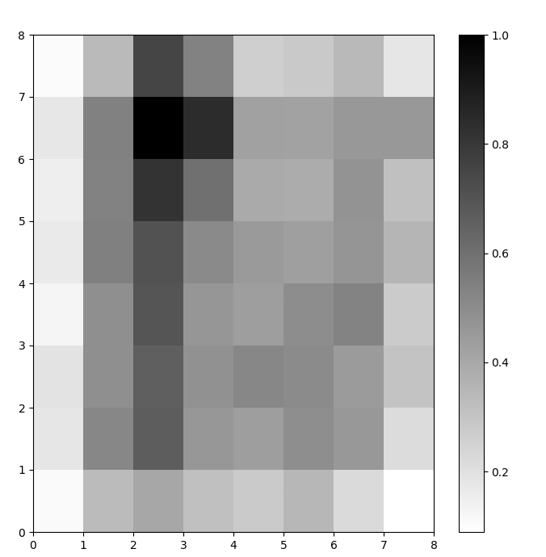
Figura 1: U-matrix della SOM addestrata sul dataset Iris (immagine dell’autore)
Valutare i risultati di clustering della SOM
La figura precedente illustrava graficamente i neuroni della SOM. In questa sezione mostriamo come visualizzare come la SOM ha clusterizzato i dati.
Identificare i cluster
Sovrapponiamo dei marker alla U-matrix per indicare quale classe di pianta di Iris rappresenta ciascuna cella (neurone). Per farlo:
- Come prima, crea una figura 8x8 con
pyplot, traccia la mappa delle distanze e mostra la color bar. - Specifica un array di tre marker di matplotlib, uno per ogni classe di Iris.
- Specifica un array di tre codici colore di matplotlib, uno per ogni classe di Iris.
- Traccia iterativamente il neurone vincitore per ciascun punto dati:
- Determina le (coordinate del) neurone vincitore per ciascun punto dati con la funzione
.winner() . - Traccia la posizione di ogni neurone vincitore al centro di ciascuna cella della griglia.
w[0]ew[1]forniscono rispettivamente le coordinate X e Y del neurone. Si aggiunge 0,5 a ciascuna coordinata per posizionarlo al centro della cella.
Il codice seguente mostra come fare:
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg')
plt.colorbar()
# create the markers and colors for each class
markers = ['o', 'x', '^']
colors = ['C0', 'C1', 'C2']
# plot the winning neuron for each data point
for count, datapoint in enumerate(data):
# get the winner
w = som.winner(datapoint)
# place a marker on the winning position for the sample data point
plt.plot(w[0]+.5, w[1]+.5, markers[target[count]-1], markerfacecolor='None',
markeredgecolor=colors[target[count]-1], markersize=12, markeredgewidth=2)
plt.show()L’immagine risultante è mostrata sotto:
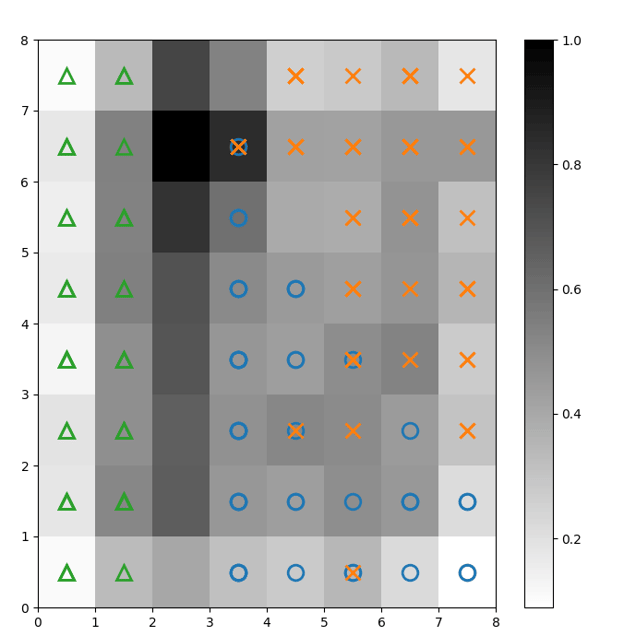
Figura 2: U-matrix con marker di classe sovrapposti (immagine dell’autore)
In base alla documentazione del dataset Iris, “una classe è linearmente separabile dalle altre 2; queste ultime non sono linearmente separabili tra loro”. Nella U-matrix sopra, queste tre classi sono rappresentate da tre marker: triangolo, cerchio e croce.
Nota che non c’è un confine netto tra i cerchi blu e le croci arancioni. Inoltre, in molte celle due classi sono sovrapposte sullo stesso neurone. Questo significa che il neurone è equidistante da entrambe le classi.
Visualizzare l’esito del clustering
Una SOM è un modello di clustering. Punti dati simili mappano allo stesso neurone. I punti della stessa classe mappano a un cluster di neuroni adiacenti. Tracciamo tutti i punti dati sulla griglia SOM per studiare meglio il comportamento di clustering.
I passaggi seguenti descrivono come creare questo scatter plot:
- Ottieni le coordinate X e Y del neurone vincitore per ciascun punto dati.
- Traccia la mappa delle distanze come fatto per la Figura 1.
- Usa
plt.scatter()per realizzare uno scatter plot di tutti i neuroni vincitori per ciascun punto. Aggiungi un offset casuale a ogni punto per evitare sovrapposizioni tra punti all’interno della stessa cella.
Implementiamo questi passaggi nel codice qui sotto:
# get the X and Y coordinates of the winning neuron for each data pointw_x, w_y = zip(*[som.winner(d) for d in data])
w_x = np.array(w_x)
w_y = np.array(w_y)
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg', alpha=.2)
plt.colorbar()
# make a scatter plot of all the winning neurons for each data point
# add a random offset to each point to avoid overlaps
for c in np.unique(target):
idx_target = target==c
plt.scatter(w_x[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
w_y[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
s=50,
c=colors[c-1],
label=labels_iris[c+1]
)
plt.legend(loc='upper right')
plt.grid()
plt.show()Il seguente grafico mostra lo scatter plot di output:
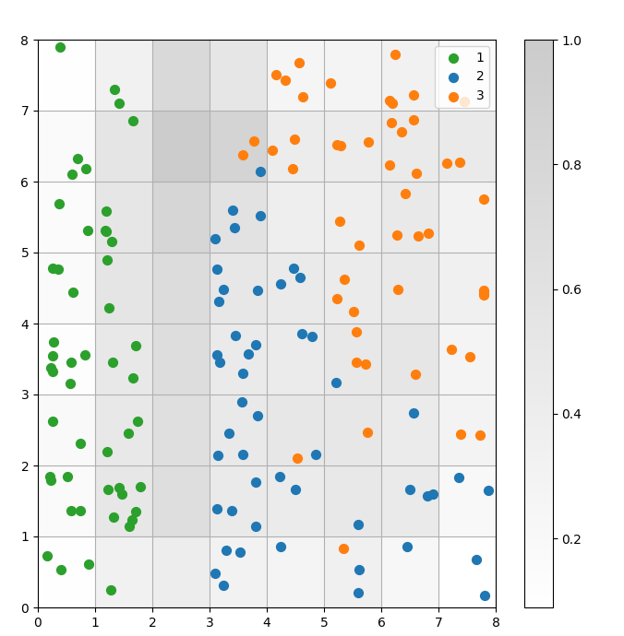 Figura 3: Scatter plot dei punti dati all’interno delle celle (immagine dell’autore)
Nello scatter plot sopra, osserva che:
- Alcune celle contengono sia punti blu sia arancioni.
- I punti verdi sono chiaramente separati dal resto, ma quelli blu e arancioni non sono separati in modo netto.
- Queste osservazioni sono coerenti con il fatto che solo uno dei tre cluster nel dataset Iris ha un confine netto.
- Nella Figura 1, i nodi scuri tra i cluster (che possono essere interpretati come confini tra cluster) corrispondono a celle vuote nello scatter plot.
Puoi accedere ed eseguire il codice completo in questo notebook DataLab.
Ottimizzare il modello SOM
Le sezioni precedenti hanno mostrato come creare e addestrare un modello SOM e come studiarne visivamente i risultati. In questa sezione discutiamo come ottimizzare le prestazioni dei modelli SOM.
Iperparametri chiave da ottimizzare
Come per qualsiasi modello di machine learning, gli iperparametri influiscono notevolmente sulle prestazioni del modello.
Alcuni degli iperparametri importanti nell’addestramento delle SOM sono:
- La dimensione della griglia determina la dimensione della mappa. Il numero di neuroni in una mappa con griglia AxB è A*B.
- Il tasso di apprendimento determina quanto vengono modificati i pesi a ogni iterazione. Impostiamo il tasso iniziale, che poi diminuisce nel tempo secondo la funzione di decadimento.
- La funzione di decadimento stabilisce di quanto si riduce il tasso di apprendimento a ogni iterazione successiva.
- La funzione di vicinato è una funzione matematica che specifica quali neuroni sono considerati vicini della BMU.
- La deviazione standard specifica l’ampiezza della funzione di vicinato. Per esempio, una funzione gaussiana con alta deviazione standard avrà un vicinato più ampio rispetto alla stessa funzione con deviazione standard minore. Impostiamo la deviazione standard iniziale, che poi diminuisce nel tempo secondo la funzione di decadimento di sigma.
- La funzione di decadimento di sigma controlla di quanto si riduce la deviazione standard a ogni iterazione successiva.
- Il numero di iterazioni di addestramento determina quante volte i pesi vengono aggiornati. In ogni iterazione di training, i pesi dei neuroni sono aggiornati una volta.
- La funzione di distanza è una funzione matematica che calcola la distanza tra neuroni e punti dati.
- La topologia determina il layout della struttura della griglia. I neuroni possono essere disposti in uno schema rettangolare o esagonale.
Nella prossima sezione, discutiamo linee guida per impostare i valori di questi iperparametri.
Impatto dell’ottimizzazione degli iperparametri
I valori degli iperparametri dovrebbero essere decisi in base al modello e al dataset. In parte, determinarli è un processo di tentativi ed errori. In questa sezione forniamo linee guida per il tuning di ciascun iperparametro. Accanto a ogni iperparametro indichiamo (tra parentesi) le rispettive costanti Python usate nel codice di esempio.
- Dimensione della griglia (
SOM_X_AXIS_NODESeSOM_Y_AXIS_NODES): la dimensione della griglia dipende dalla dimensione del dataset. Una regola empirica è che, dato un dataset di dimensione N, la griglia dovrebbe contenere circa 5*sqrt(N) neuroni. Per esempio, se il dataset ha 150 campioni, la griglia dovrebbe contenere 5*sqrt(150) = circa 61 neuroni. In questo tutorial, il dataset Iris ha 150 righe e usiamo una griglia 8x8. - Tasso di apprendimento iniziale (
ALPHA): un tasso più alto accelera la convergenza, mentre valori più bassi sono usati per aggiustamenti più fini dopo le prime iterazioni. Il tasso iniziale dovrebbe essere abbastanza grande da consentire un adattamento rapido ma non così alto da oltrepassare valori di peso ottimali. In questo articolo, il tasso iniziale è 0,5. - Deviazione standard iniziale (
SIGMA0): determina la dimensione o l’ampiezza iniziale del vicinato. Un valore maggiore considera pattern più globali. In questo esempio usiamo una deviazione standard iniziale di 1,5. - Per il tasso di decadimento (
DECAY_FUNC) e per il tasso di decadimento di sigma (SIGMA_DECAY_FUNC), possiamo scegliere tra tre tipi di funzioni di decadimento: - Decadimento inverso: adatto se i dati hanno sia pattern globali sia locali. In tali casi serve una fase più lunga di apprendimento ampio prima di concentrarsi sui pattern locali.
- Decadimento lineare: indicato per dataset in cui vogliamo una riduzione costante e uniforme della dimensione del vicinato o del tasso di apprendimento. È utile se i dati non richiedono molto fine-tuning.
- Decadimento asintotico: utile se i dati sono complessi e ad alta dimensionalità. In questi casi, è meglio dedicare più tempo all’esplorazione globale prima di passare gradualmente ai dettagli più fini.
- Funzione di vicinato (
NEIGHBORHOOD_FUNC): la scelta predefinita è la funzione gaussiana. Sono usate anche altre funzioni, come spiegato sotto. - Gaussiana (predefinita): è una curva a campana. L’entità con cui un neurone viene aggiornato diminuisce gradualmente all’aumentare della distanza dal neurone vincitore. Fornisce una transizione fluida e continua e preserva la topologia dei dati. È adatta alla maggior parte degli scopi generali per il suo comportamento stabile e prevedibile.
- Bubble: crea un vicinato di ampiezza fissa. Tutti i neuroni all’interno di questo vicinato sono aggiornati allo stesso modo, e quelli esterni non vengono aggiornati (per un dato punto). È computazionalmente più economica e più semplice da implementare. È utile per mappe più piccole dove confini di vicinato netti non compromettono l’efficacia del clustering.
- Mexican hat: ha una regione centrale positiva circondata da una regione negativa. I neuroni vicini alla BMU vengono aggiornati per avvicinarsi al punto dati, e quelli più lontani per allontanarsene. Questa tecnica esalta il contrasto e affina le caratteristiche nella mappa. Poiché enfatizza cluster distinti, è efficace in compiti di riconoscimento di pattern dove si desidera una chiara separazione dei cluster.
- Triangolo: definisce la dimensione del vicinato come un triangolo, con la BMU che ha la maggiore influenza. L’influenza diminuisce linearmente con la distanza dalla BMU. È usata per clusterizzare dati con transizioni graduali tra cluster o feature, come immagini, parlato o serie temporali, dove ci si aspetta che i punti adiacenti condividano caratteristiche simili.
- Funzione di distanza (
DISTANCE_FUNC): per misurare la distanza tra neuroni e punti dati, possiamo scegliere tra 4 metodi: - Distanza euclidea (scelta predefinita): utile quando i dati sono continui e vogliamo misurare la distanza in linea retta. Si adatta alla maggior parte dei compiti generali, specialmente quando i punti dati sono distribuiti uniformemente e relazionati spazialmente.
- Distanza coseno: una buona scelta per testo o dati sparsi ad alta dimensionalità in cui l’angolo tra vettori è più importante della magnitudine. È utile per confrontare la direzionalità nei dati.
- Distanza Manhattan: ideale quando i punti dati sono su una griglia o reticolo (ad es., isolati cittadini). È meno sensibile agli outlier rispetto alla distanza euclidea.
- Distanza di Čebyšëv: adatta a situazioni in cui il movimento può avvenire in qualsiasi direzione (ad es., distanze su una scacchiera). È utile per spazi discreti in cui si vuole dare priorità alla massima differenza su un asse.
- Topologia (
TOPOLOGY): in una griglia, i neuroni possono essere disposti in una struttura esagonale o rettangolare: - Rettangolare (predefinita): ogni neurone ha 4 vicini immediati. È la scelta giusta quando i dati non hanno una chiara relazione spaziale. È anche più semplice dal punto di vista computazionale.
- Esagonale: ogni neurone ha 6 vicini. È l’opzione preferita se i dati hanno relazioni spaziali meglio rappresentate con una griglia esagonale, come nel caso di distribuzioni circolari o angolari.
- Numero di iterazioni di addestramento (
N_ITERATIONS): in linea di principio, tempi di addestramento più lunghi portano a errori più bassi e a un migliore allineamento dei pesi con i dati di input. Tuttavia, le prestazioni del modello aumentano asintoticamente con il numero di iterazioni. Dunque, oltre una certa soglia, il miglioramento derivante da ulteriori iterazioni è solo marginale. Decidere il numero corretto di iterazioni richiede un po’ di sperimentazione. In questo tutorial alleniamo il modello per 5000 iterazioni.
Per determinare la configurazione corretta degli iperparametri, consigliamo di sperimentare varie opzioni su un sottoinsieme più piccolo dei dati.
Conclusione
Le Self-Organizing Maps sono uno strumento robusto per l’apprendimento non supervisionato. Sono utilizzate per clustering, riduzione della dimensionalità, rilevamento di anomalie e visualizzazione dei dati. Poiché preservano le proprietà topologiche dei dati ad alta dimensionalità e li rappresentano su una griglia a dimensionalità inferiore, le SOM rendono semplice visualizzare e interpretare dataset complessi.
Questo tutorial ha discusso i principi alla base delle SOM e mostrato come implementare una SOM usando la libreria Python MiniSom. Ha inoltre illustrato come analizzare visivamente i risultati e spiegato gli iperparametri importanti per addestrare le SOM e ottimizzarne le prestazioni.
FAQ
L’addestramento di una SOM prevede la backpropagation?
Una SOM è una rete neurale artificiale, ma il suo addestramento non si basa sulla correzione dell’errore. Dunque non usa la backpropagation con discesa del gradiente. Le SOM, invece, sono addestrate tramite apprendimento competitivo.
Perché servono le funzioni di decadimento?
Nelle fasi iniziali dell’addestramento, il modello deve esplorare il panorama globale dei dati. Quindi, il tasso di apprendimento deve essere elevato e la funzione di vicinato deve avere un’ampia estensione. Le iterazioni successive apportano aggiustamenti più fini ai pesi in base ai neuroni adiacenti. Con il progredire dell’addestramento, le funzioni di decadimento riducono il tasso di apprendimento e il raggio di vicinato.
Qual è la differenza tra l’inizializzazione predefinita (casuale) e l’inizializzazione casuale basata sui dati di input?
Nell’inizializzazione predefinita, i pesi sono inizializzati a numeri casuali arbitrari.
Nell’inizializzazione casuale basata sui dati di input, i pesi sono inizializzati a campioni scelti casualmente dai dati di input.
Le SOM possono catturare relazioni non lineari nei dati?
Sì, le SOM catturano pattern non lineari nei dati usando varie funzioni di vicinato. Un singolo punto dati può influenzare i valori di molti neuroni (nel vicinato). Questo permette alle SOM di cogliere relazioni complesse nei dati.
Qual è la differenza tra SOM e metodi di clustering tradizionali?
Le SOM mappano dati ad alta dimensionalità su una griglia a dimensionalità inferiore, preservando le relazioni spaziali. Le tecniche di clustering tradizionali come K-Means, invece, creano gruppi in base a metriche di distanza senza necessariamente considerare la topologia dei dati o le relazioni spaziali.
Nota che nell’analisi dei dati, le relazioni topologiche o spaziali si riferiscono a come i punti dati sono posizionati l’uno rispetto all’altro in uno spazio multidimensionale.






Le Self-Organizing Maps (SOM) sono un tipo di rete neurale artificiale utilizzata per attività di apprendimento non supervisionato come il clustering. Dato un insieme di punti dati, il modello impara a dividere i dati in cluster. Le SOM proiettano dati complessi multidimensionali su una griglia a dimensionalità inferiore (tipicamente bidimensionale). Questo ne facilita la visualizzazione. Per questo motivo, le SOM vengono usate anche per visualizzare dati ad alta dimensionalità.
In questo tutorial esploriamo i concetti di base delle SOM, il loro processo di apprendimento e i casi d’uso tipici. Spieghiamo come implementare una SOM in Python con la libreria MiniSom e come rappresentare visivamente i risultati. Infine, trattiamo gli iperparametri più importanti nell’addestramento dei modelli SOM e come ottimizzarli.
Comprendere le Self-Organizing Maps (SOM)
In questa sezione presentiamo i concetti fondamentali delle SOM, il loro processo di apprendimento e i casi d’uso.
Concetti chiave delle SOM
Le Self-Organizing Maps implicano un insieme di concetti importanti da comprendere.
Neuroni
Una SOM è essenzialmente una griglia di neuroni. Durante l’addestramento, il neurone il cui vettore dei pesi è più vicino a un punto dati di input regola i propri pesi e quelli dei neuroni vicini per avvicinarsi ancora di più al punto dati di input. Dopo molte iterazioni, gruppi di neuroni adiacenti mappano punti dati correlati. Questo porta al clustering del dataset di input.
Struttura della griglia
I neuroni in una SOM sono organizzati come una griglia. I neuroni vicini mappano punti dati simili. Dataset più grandi richiedono una griglia più ampia. Tipicamente la griglia è bidimensionale. La struttura della griglia funge da spazio a bassa dimensionalità su cui vengono mappati i dati ad alta dimensionalità. La griglia aiuta a visualizzare pattern e cluster nei dati.
Mappatura dei punti dati
Ogni punto dati viene confrontato con tutti i neuroni usando una metrica di distanza. Il neurone il cui vettore dei pesi è più vicino al punto dati di input è la Best Matching Unit (BMU) per quel punto dati.
Una volta identificata la BMU, i pesi della BMU e dei neuroni vicini vengono aggiornati. Questo aggiornamento avvicina ulteriormente la BMU e i neuroni adiacenti al punto dati di input. Questa mappatura preserva la topologia dei dati, assicurando che punti dati simili siano mappati a neuroni vicini.
Processo di apprendimento delle SOM
L’addestramento delle SOM è considerato non supervisionato perché non si basa su dataset etichettati. L’obiettivo è regolare iterativamente i vettori dei pesi dei neuroni in modo che punti dati simili vengano mappati a neuroni vicini.
Apprendimento competitivo
Le SOM usano l’apprendimento competitivo (invece di discesa del gradiente e backpropagation). I neuroni competono per diventare la Best Matching Unit (BMU) per ogni punto dati di input. Il neurone più vicino a un punto dati viene determinato come sua BMU. La BMU e i neuroni vicini vengono aggiornati per ridurre ulteriormente la distanza dal punto dati. I neuroni adiacenti mappano punti dati correlati. Ciò porta alla specializzazione tra i neuroni e al clustering dei punti dati di input.
Funzioni di distanza
Le SOM utilizzano una funzione di distanza per misurare la distanza tra neuroni e punti dati. Questa distanza serve a determinare la BMU di ciascun punto dati. MiniSom offre quattro funzioni di distanza tra cui scegliere:
Funzione di vicinato
Dopo aver identificato la BMU di un punto dati, la BMU e i neuroni vicini vengono aggiornati nella direzione di quel punto dati. La funzione di vicinato fa sì che la SOM mantenga le relazioni topologiche dei dati di input. La funzione di vicinato decide:
MiniSom include tre funzioni di vicinato:
Processo iterativo
Il processo di apprendimento nelle SOM avviene in più iterazioni. In ciascuna iterazione, la SOM elabora molti punti dati di input. Di seguito riassumiamo i passaggi del processo di apprendimento:
Questi passaggi si ripetono per molte iterazioni, passando in rassegna numerosi punti dati di input. I pesi vengono aggiornati gradualmente così che la mappa si auto-organizzi e catturi la struttura dei dati.
Il tasso di apprendimento e il raggio di vicinato in genere diminuiscono nel tempo, permettendo alla SOM di affinare gradualmente i pesi. Più avanti nel tutorial, implementeremo i passaggi dell’addestramento iterativo con codice Python.
Casi d’uso tipici delle SOM
Data la loro architettura peculiare, le SOM hanno diverse applicazioni tipiche in ambito di machine learning, analisi e visualizzazione.
Clustering
Le SOM vengono impiegate per raggruppare dati ad alta dimensionalità in cluster di punti simili. Questo aiuta a identificare strutture intrinseche nei dati. Ogni neurone mappa punti dati strettamente correlati e punti simili vengono mappati allo stesso neurone o a neuroni vicini, formando così cluster distinti.
Per esempio, nel marketing, le SOM possono raggruppare i clienti in base al comportamento di acquisto. Ciò permette a un brand di adattare le strategie di marketing ai diversi segmenti di clientela (cluster).
Riduzione della dimensionalità
Le SOM possono mappare dati ad alta dimensionalità con molti vettori di feature su una griglia con meno dimensioni (tipicamente una griglia 2D). Poiché questa mappatura preserva le relazioni tra i punti dati, la riduzione della dimensionalità facilita la visualizzazione di dataset complessi senza perdite significative di informazione.
Oltre a semplificare attività di visualizzazione e analisi, le SOM possono anche ridurre la dimensionalità dei dati prima di applicare altri algoritmi di machine learning. Le SOM sono usate anche nell’elaborazione di immagini per ridurre il numero di feature raggruppando pixel o regioni con caratteristiche simili, rendendo più efficienti i compiti di riconoscimento e classificazione.
Rilevamento di anomalie
Durante l’addestramento, la maggior parte dei punti dati viene mappata su neuroni specifici. Le anomalie (punti dati che non si adattano bene a nessun cluster) sono tipicamente mappate su neuroni distanti o poco popolati. Questi outlier non si adattano bene ai cluster appresi e vengono mappati su neuroni lontani dalla BMU dei punti dati normali.
Ad esempio, mappare transazioni finanziarie su una griglia SOM consente di individuare attività insolite (outlier) che possono indicare potenziali frodi.
Visualizzazione dei dati
La visualizzazione dei dati è uno dei casi d’uso più comuni delle SOM. I dati ad alta dimensionalità sono difficili da visualizzare. Le SOM facilitano la visualizzazione riducendo la dimensionalità dei dati e proiettandoli su una griglia bidimensionale. Questo può anche aiutare a individuare cluster nei dati e punti anomali che sarebbero complicati da scoprire nei dati originali.
Per esempio, la visualizzazione dei dati rende più semplice analizzare dati demografici ad alta dimensionalità. Mappare i dati su una griglia 2D aiuterebbe a individuare somiglianze e differenze tra diversi gruppi di popolazione.
Dopo aver discusso concetti fondamentali e casi d’uso delle SOM, mostreremo come implementarle usando il pacchetto Python MiniSom nelle sezioni seguenti.
Puoi accedere ed eseguire il codice completo in questo notebook DataLab.