मुख्य सामग्री पर जाएं

सेल्फ-ऑर्गनाइज़िंग मैप्स: पायथन उदाहरणों के साथ सहज मार्गदर्शिका

सेल्फ ऑर्गनाइज़िंग मैप्स की मूल अवधारणाएँ समझें और MiniSom का उपयोग करके पायथन में उन्हें लागू करना सीखें।
अपडेट किया गया 6 अक्टू॰ 2026  · 15 मि॰ पढ़ें

AI के साथ खोजें

ChatGPTClaudePerplexity

सेल्फ-ऑर्गनाइज़िंग मैप्स (SOMs) एक प्रकार का कृत्रिम न्यूरल नेटवर्क है, जिसका उपयोग अनसुपर्वाइज्ड लर्निंग कार्यों जैसे क्लस्टरिंग के लिए किया जाता है। दिए गए डेटा बिंदुओं के सेट पर, मॉडल डेटा को क्लस्टर्स में बाँटना सीखता है। SOMs जटिल बहुआयामी डेटा को एक निम्न-आयामी (आम तौर पर 2-आयामी) ग्रिड पर प्रोजेक्ट करते हैं। इससे विज़ुअलाइज़ेशन आसान होता है। इसलिए, SOMs का उपयोग उच्च-आयामी डेटा को विज़ुअलाइज़ करने के लिए भी किया जाता है। 

इस ट्यूटोरियल में, हम SOMs की मुख्य अवधारणाएँ, उनका लर्निंग प्रोसेस, और उनके सामान्य उपयोग मामलों का अन्वेषण करेंगे। हम MiniSom लाइब्रेरी का उपयोग करके पायथन में SOM को कैसे लागू करें और परिणामों को विज़ुअल रूप में कैसे प्रस्तुत करें, यह समझाएँगे। अंत में, हम SOM मॉडल के प्रशिक्षण में महत्त्वपूर्ण हाइपरपैरामीटर्स और उन्हें फाइन-ट्यून कैसे करें, इस पर चर्चा करेंगे। 

सेल्फ-ऑर्गनाइज़िंग मैप्स (SOM) को समझना

इस खंड में, हम SOMs की मुख्य अवधारणाएँ, उनका लर्निंग प्रोसेस, और उनके उपयोग मामलों को प्रस्तुत करते हैं। 

SOMs की मुख्य अवधारणाएँ

सेल्फ-ऑर्गनाइज़िंग मैप्स में कुछ ऐसी अवधारणाएँ शामिल हैं जिन्हें समझना महत्त्वपूर्ण है।

न्यूरॉन्स

SOM मूल रूप से न्यूरॉन्स का एक ग्रिड है। प्रशिक्षण के दौरान, वह न्यूरॉन जिसका वेट वेक्टर किसी इनपुट डेटा बिंदु के सबसे निकट होता है, अपने वेट्स और अपने पड़ोसी न्यूरॉन्स के वेट्स को समायोजित करता है ताकि वे इनपुट डेटा बिंदु के और भी करीब आ जाएँ। कई इटरेशंस के बाद, आस-पास के न्यूरॉन्स के समूह संबंधित डेटा बिंदुओं पर मैप होते हैं। इससे इनपुट डेटासेट का क्लस्टरिंग होता है। 

ग्रिड संरचना

SOM में न्यूरॉन्स एक ग्रिड के रूप में व्यवस्थित होते हैं। पड़ोसी न्यूरॉन्स समान डेटा बिंदुओं पर मैप होते हैं। बड़े डेटासेट के लिए बड़े ग्रिड की आवश्यकता होती है। आम तौर पर, यह ग्रिड दो-आयामी होता है। ग्रिड संरचना वह निम्न-आयामी स्पेस प्रदान करती है जिस पर उच्च-आयामी डेटा मैप किया जाता है। ग्रिड डेटा पैटर्न और क्लस्टर्स को विज़ुअलाइज़ करने में मदद करता है। 

डेटा बिंदुओं का मैपिंग

प्रत्येक डेटा बिंदु की तुलना सभी न्यूरॉन्स से एक दूरी मीट्रिक के माध्यम से की जाती है। जिसका वेट वेक्टर इनपुट डेटा बिंदु के सबसे निकट होता है, वह उस डेटा बिंदु के लिए बेस्ट मैचिंग यूनिट (BMU) होता है। 

एक बार BMU पहचान लेने पर, BMU और इसके पड़ोसी न्यूरॉन्स के वेट्स अपडेट किए जाते हैं। यह अपडेट BMU और पड़ोसी न्यूरॉन्स को इनपुट डेटा बिंदु के और भी पास ले आता है। यह मैपिंग डेटा की टोपोलॉजी को संरक्षित करती है, जिससे सुनिश्चित होता है कि समान डेटा बिंदु आस-पास के न्यूरॉन्स पर मैप हों। 

SOMs का लर्निंग प्रोसेस

SOM प्रशिक्षण को अनसुपर्वाइज्ड माना जाता है क्योंकि यह लेबल्ड डेटासेट पर आधारित नहीं है। SOMs के प्रशिक्षण का लक्ष्य न्यूरॉन्स के वेट वेक्टर्स को क्रमिक रूप से समायोजित करना है ताकि समान डेटा बिंदु आस-पास के न्यूरॉन्स पर मैप हों। 

प्रतिस्पर्धी लर्निंग

SOMs ग्रेडिएंट डिसेंट और बैकप्रोपेगेशन की जगह प्रतिस्पर्धी लर्निंग का उपयोग करते हैं। न्यूरॉन्स प्रत्येक इनपुट डेटा बिंदु के लिए बेस्ट मैचिंग यूनिट (BMU) बनने के लिए प्रतिस्पर्धा करते हैं। जो न्यूरॉन डेटा बिंदु के सबसे निकट होता है, वही उसका BMU होता है। BMU और इसके पड़ोसी न्यूरॉन्स को अपडेट किया जाता है ताकि वे डेटा बिंदु से अपनी दूरी और कम करें। पड़ोसी न्यूरॉन्स संबंधित डेटा बिंदुओं पर मैप होते हैं। इससे न्यूरॉन्स में विशेषज्ञता आती है और इनपुट डेटा बिंदुओं का क्लस्टरिंग होता है। 

डिस्टेंस फंक्शंस 

SOMs दूरी मापने के लिए एक फंक्शन का उपयोग करते हैं, जो न्यूरॉन्स और डेटा बिंदुओं के बीच की दूरी बताता है। इसी दूरी के आधार पर प्रत्येक डेटा बिंदु का BMU तय होता है। MiniSom चार दूरी फंक्शंस प्रदान करता है: 

नेबरहुड फंक्शन

किसी डेटा बिंदु का BMU मिलने के बाद, BMU और उसके पड़ोसी न्यूरॉन्स को उस डेटा बिंदु की दिशा में अपडेट किया जाता है। नेबरहुड फंक्शन यह सुनिश्चित करता है कि SOM इनपुट डेटा के टोपोलॉजिकल संबंध बनाए रखे। नेबरहुड फंक्शन तय करता है:

  • कौन-से न्यूरॉन्स BMU के पड़ोस में माने जाएँगे
  • पड़ोसी न्यूरॉन्स को कितनी मात्रा में अपडेट किया जाएगा। सामान्यतः, BMU के अधिक निकट न्यूरॉन्स को दूरस्थ न्यूरॉन्स की तुलना में बड़ा समायोजन मिलता है

MiniSom तीन नेबरहुड फंक्शंस के साथ आता है: 

  • गौसियन (यह डिफ़ॉल्ट है)। 
  • बबल 
  • मैक्सिकन हैट
  • ट्राएंगल

इटरेटिव प्रोसेस

SOMs में लर्निंग कई इटरेशंस में होती है। प्रत्येक इटरेशन में, SOM अनेक इनपुट डेटा बिंदुओं को प्रोसेस करता है। हम नीचे दिए चरणों में लर्निंग प्रोसेस का सार प्रस्तुत करते हैं:

  • ट्रेनिंग शुरू होने पर, सभी न्यूरॉन्स के वेट्स (रैंडम रूप से) इनिशियलाइज़ किए जाते हैं। 
  • किसी इनपुट डेटा बिंदु के लिए, प्रत्येक न्यूरॉन अपनी दूरी की गणना करता है।
    • सबसे कम दूरी वाला न्यूरॉन BMU घोषित होता है। 
  • BMU और उसके पड़ोसियों के वेट्स को इनपुट वेक्टर के और निकट लाने हेतु समायोजित किया जाता है। समायोजन की मात्रा तय होती है:
    • नेबरहुड फंक्शन से: BMU से दूर न्यूरॉन्स को, निकट न्यूरॉन्स की तुलना में, कम अपडेट मिलता है। इससे डेटा की टोपोलॉजिकल संरचना संरक्षित रहती है। 
    • लर्निंग रेट से: अधिक लर्निंग रेट बड़े अपडेट की ओर ले जाता है। 

ये चरण अनेक इटरेशंस में कई इनपुट डेटा बिंदुओं पर दोहराए जाते हैं। वेट्स क्रमशः अपडेट होते हैं ताकि मैप स्वयं-संगठित हो और डेटा की संरचना को पकड़ सके। 

लर्निंग रेट और नेबरहुड रेडियस सामान्यतः समय के साथ घटते हैं, जिससे SOM धीरे-धीरे वेट्स को फाइन-ट्यून कर सके। ट्यूटोरियल के आगे, हम पायथन कोड से इटरेटिव ट्रेनिंग प्रोसेस के चरणों को लागू करेंगे। 

SOMs के सामान्य उपयोग मामले

अपनी विशिष्ट संरचना के कारण, SOMs के मशीन लर्निंग, विश्लेषण, और विज़ुअलाइज़ेशन में कई सामान्य अनुप्रयोग हैं।

क्लस्टरिंग

SOMs का उपयोग उच्च-आयामी डेटा को समान डेटा बिंदुओं के क्लस्टर्स में बाँटने के लिए किया जाता है। इससे डेटा में अंतर्निहित संरचनाएँ पहचानने में मदद मिलती है। प्रत्येक न्यूरॉन निकट से संबंधित डेटा बिंदुओं पर मैप होता है और समान डेटा बिंदु एक ही या पड़ोसी न्यूरॉन्स पर मैप होते हैं, जिससे स्पष्ट क्लस्टर्स बनते हैं। 

उदाहरण के लिए, मार्केटिंग में, SOMs ग्राहकों को उनकी खरीदारी व्यवहार के आधार पर समूहित कर सकते हैं। इससे कोई ब्रांड विभिन्न ग्राहक सेगमेंट्स (क्लस्टर्स) के लिए मार्केटिंग रणनीतियाँ अनुकूलित कर सकता है।

आयाम में कमी

SOMs अनेक फीचर वेक्टर्स वाले उच्च-आयामी डेटा को कम आयामों (आमतौर पर 2-आयामी ग्रिड) के ग्रिड पर मैप कर सकते हैं। चूँकि यह मैपिंग डेटा बिंदुओं के बीच के संबंधों को सुरक्षित रखती है, इसलिए आयामों में कमी से जटिल डेटासेट्स को बिना जानकारियों के बड़े नुकसान के विज़ुअलाइज़ करना आसान हो जाता है।

विज़ुअलाइज़ेशन और विश्लेषण कार्यों को आसान बनाने के अलावा, SOMs अन्य मशीन लर्निंग एल्गोरिद्म लगाने से पहले डेटा के आयामों को भी कम कर सकते हैं। SOMs का उपयोग इमेज प्रोसेसिंग में भी होता है, जहाँ समान विशेषताओं वाले पिक्सल्स या क्षेत्रों को क्लस्टर करके फीचर्स की संख्या घटाई जाती है, जिससे इमेज रिकॉग्निशन और वर्गीकरण अधिक कुशल हो जाता है। 

एनॉमली डिटेक्शन

प्रशिक्षण प्रक्रिया के दौरान, अधिकांश डेटा बिंदु विशिष्ट न्यूरॉन्स पर मैप होते हैं। एनॉमली (जो किसी क्लस्टर में ठीक से फिट नहीं बैठते) आम तौर पर दूरस्थ या कम आबादी वाले न्यूरॉन्स पर मैप होते हैं। ये आउटलायर्स सीखे गए क्लस्टर्स में ठीक से फिट नहीं होते और सामान्य डेटा बिंदुओं के BMU से दूर न्यूरॉन्स पर मैप होते हैं।

उदाहरण के लिए, वित्तीय लेन-देन को SOM ग्रिड पर मैप करने से असामान्य गतिविधियों (आउटलायर्स) की पहचान की जा सकती है, जो संभावित धोखाधड़ी का संकेत हो सकती हैं। 

डेटा विज़ुअलाइज़ेशन

डेटा विज़ुअलाइज़ेशन SOMs के सबसे आम उपयोग मामलों में से एक है। उच्च-आयामी डेटा का विज़ुअलाइज़ेशन कठिन होता है। SOMs डेटा के आयामों को कम करके और उसे दो-आयामी ग्रिड पर प्रोजेक्ट करके विज़ुअलाइज़ करना आसान बनाते हैं। इससे डेटा में क्लस्टर्स और ऐसे एनॉमलस डेटा बिंदु भी पहचानने में मदद मिलती है, जिन्हें मूल डेटा में ढूँढना जटिल होता। 

उदाहरण के लिए, डेटा विज़ुअलाइज़ेशन उच्च-आयामी जनसंख्या डेटा के विश्लेषण को आसान बनाता है। डेटा को 2D ग्रिड पर मैप करने से विभिन्न जनसमूहों के बीच समानताएँ और भिन्नताएँ पहचानी जा सकती हैं।  

SOMs की मुख्य अवधारणाओं और उपयोग मामलों पर चर्चा के बाद, हम आगे के खंडों में पायथन पैकेज MiniSom का उपयोग करके उन्हें कैसे लागू करें, यह दिखाएँगे। 

आप इस DataLab नोटबुक में पूरा कोड एक्सेस कर सकते हैं और चला सकते हैं।

SOM के लिए वातावरण सेट करना

SOM बनाने से पहले, आवश्यक पैकेजों के साथ वातावरण तैयार करना होगा। 

पायथन लाइब्रेरियाँ इंस्टॉल करना 

हमें ये पैकेज चाहिए: 

  • MiniSom एक NumPy-आधारित पायथन टूल है जो SOMs बनाता और प्रशिक्षित करता है। 
  • NumPy का उपयोग ऐरे स्प्लिट करना, यूनिक वैल्यूज़ पाना आदि जैसे गणितीय फंक्शंस के लिए होता है। 
  • matplotlib डेटा को विज़ुअलाइज़ करने हेतु विभिन्न ग्राफ़ और चार्ट प्लॉट करने में उपयोग होता है। 
  • sklearn का datasets पैकेज उन डेटासेट्स को इम्पोर्ट करने के लिए इस्तेमाल होता है, जिन पर SOM लागू किया जाएगा। 
  • sklearn का MinMaxScaler डेटासेट को नॉर्मलाइज़ करता है। 

निम्न कोड स्निपेट इन पैकेजों को इम्पोर्ट करता है: 

from minisom import MiniSom
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.preprocessing import MinMaxScaler

डेटासेट तैयार करना

इस ट्यूटोरियल में, हम MiniSom का उपयोग करके एक SOM बनाएँगे और फिर उसे क्लासिक IRIS डेटासेट पर प्रशिक्षित करेंगे। यह डैटासेट 3 क्लास के आईरिस पौधों से बना है। प्रत्येक क्लास में 50 इंस्टैंसेज़ हैं। डेटा तैयार करने के लिए, हम ये चरण अपनाते हैं: 

  • sklearn से Iris डेटासेट इम्पोर्ट करें, 
  • डेटा वेक्टर्स और टार्गेट स्कैलर्स निकालें। 
  • डेटा वेक्टर्स को नॉर्मलाइज़ करें। इस ट्यूटोरियल में, हम scikit-learn के MinMaxScaler का उपयोग करते हैं। 
  • Iris पौधों की तीनों क्लास के लिए एक-एक लेबल का सेट घोषित करें। 

निम्न कोड इन चरणों को लागू करता है: 

dataset_iris = datasets.load_iris()
data_iris = dataset_iris.data
target_iris = dataset_iris.target
data_iris_normalized = MinMaxScaler().fit_transform(data_iris)
labels_iris = {1:'1', 2:'2', 3:'3'}
data = data_iris_normalized
target = target_iris

पायथन में सेल्फ-ऑर्गनाइज़िंग मैप्स (SOM) लागू करना

पायथन में SOM लागू करने के लिए, हम प्रशिक्षण से पहले ग्रिड को परिभाषित और इनिशियलाइज़ करते हैं। इसके बाद प्रशिक्षित न्यूरॉन्स और क्लस्टर्ड डेटासेट को विज़ुअलाइज़ कर सकते हैं। 

SOM ग्रिड परिभाषित करना

जैसा कि पहले समझाया गया, SOM न्यूरॉन्स का एक ग्रिड है। MiniSom के माध्यम से हम 2-आयामी ग्रिड बना सकते हैं। ग्रिड के X और Y आयाम प्रत्येक अक्ष पर न्यूरॉन्स की संख्या होते हैं। SOM ग्रिड परिभाषित करने के लिए, हमें यह भी निर्दिष्ट करना होगा:

  • ग्रिड के X और Y आयाम
  • इनपुट वेरिएबल्स की संख्या - यानी डेटा की पंक्तियों की संख्या। 

इन पैरामीटर्स को पायथन कॉन्स्टेंट्स के रूप में घोषित करें:

SOM_X_AXIS_NODES  = 8
SOM_Y_AXIS_NODES  = 8
SOM_N_VARIABLES  = data.shape[1]

नीचे का सैंपल कोड MiniSom का उपयोग करके ग्रिड घोषित करने का तरीका दिखाता है:

som = MiniSom(SOM_X_AXIS_NODES, SOM_Y_AXIS_NODES, SOM_N_VARIABLES)

पहले दो पैरामीटर X और Y अक्षों के साथ न्यूरॉन्स की संख्या हैं, और तीसरा पैरामीटर वेरिएबल्स की संख्या है। 

SOM ग्रिड बनाते समय हम अन्य पैरामीटर्स और हाइपरपैरामीटर्स भी घोषित करते हैं। हम इन्हें आगे ट्यूटोरियल में समझाएँगे। फिलहाल, इन पैरामीटर्स को नीचे दिखाए अनुसार घोषित करें: 

ALPHA = 0.5
DECAY_FUNC = 'linear_decay_to_zero'
SIGMA0 = 1.5
SIGMA_DECAY_FUNC = 'linear_decay_to_one'
NEIGHBORHOOD_FUNC = 'triangle'
DISTANCE_FUNC = 'euclidean'
TOPOLOGY = 'rectangular'
RANDOM_SEED = 123

इन पैरामीटर्स का उपयोग करके SOM बनाएँ:

som = MiniSom(
        SOM_X_AXIS_NODES,
        SOM_Y_AXIS_NODES,
        SOM_N_VARIABLES,
        sigma=SIGMA0,
        learning_rate=ALPHA,
        neighborhood_function=NEIGHBORHOOD_FUNC,
        activation_distance=DISTANCE_FUNC,
        topology=TOPOLOGY,
        sigma_decay_function = SIGMA_DECAY_FUNC,
        decay_function = DECAY_FUNC,
        random_seed=RANDOM_SEED,
        )

न्यूरॉन्स इनिशियलाइज़ करना

उपरोक्त कमांड सभी न्यूरॉन्स के लिए रैंडम वेट्स के साथ एक SOM बनाता है। डेटा से लिए गए वेट्स (रैंडम नंबर्स के बजाय) से न्यूरॉन्स इनिशियलाइज़ करना प्रशिक्षण प्रक्रिया को अधिक कुशल बना सकता है। 

MiniSom का उपयोग करके सेल्फ-ऑर्गनाइज़िंग मैप (SOM) बनाते समय, डेटा के आधार पर न्यूरॉन्स के वेट्स इनिशियलाइज़ करने के दो तरीके हैं:

  • रैंडम इनिशियलाइज़ेशन: न्यूरॉन्स के प्रारंभिक वेट्स इनपुट डेटा से रैंडम रूप से चुने जाते हैं। हम यह SOM पर .random_weights_init() फंक्शन लागू करके करते हैं। 
  • PCA इनिशियलाइज़ेशन: प्रिंसिपल कंपोनेंट एनालिसिस (PCA) इनिशियलाइज़ेशन, इनपुट डेटा के प्रिंसिपल कंपोनेंट्स का उपयोग वेट्स इनिशियलाइज़ करने के लिए करता है। प्रारंभिक वेट्स पहले दो प्रिंसिपल कंपोनेंट्स में फैलते हैं। इससे अकसर तेज़ कनवर्जेन्स मिलता है। 

इस गाइड में हम PCA इनिशियलाइज़ेशन का उपयोग करते हैं। SOM वेट्स पर PCA इनिशियलाइज़ेशन लागू करने के लिए, नीचे दिखाए अनुसार .pca_weights_init() फंक्शन का उपयोग करें:

som.pca_weights_init(data)

SOM का प्रशिक्षण

प्रशिक्षण प्रक्रिया SOM वेट्स को अपडेट करती है ताकि न्यूरॉन्स और डेटा बिंदुओं के बीच की दूरी न्यूनतम हो सके। 

नीचे, हम इटरेटिव ट्रेनिंग प्रोसेस समझाते हैं:

  • इनिशियलाइज़ेशन: सभी न्यूरॉन्स के वेट वेक्टर्स इनिशियलाइज़ किए जाते हैं, प्रायः रैंडम मानों से। वेट्स को इनपुट डेटा डिस्ट्रीब्यूशन से सैंपल करके भी इनिशियलाइज़ किया जा सकता है।
  • इनपुट चयन: ट्रेनिंग डेटासेट से (रैंडम रूप से) एक इनपुट वेक्टर चुना जाता है।
  • BMU पहचान: जो न्यूरॉन इनपुट वेक्टर के सबसे निकट होता है, वह BMU के रूप में पहचाना जाता है। 
  • नेबरहुड अपडेट: BMU और इसके पड़ोसी न्यूरॉन्स अपने वेट वेक्टर्स अपडेट करते हैं। किन न्यूरॉन्स को, और कितनी मात्रा में, अपडेट किया जाएगा, यह लर्निंग रेट और नेबरहुड फंक्शन तय करते हैं। इटरेशन स्टेप t पर, दिए गए इनपुट वेक्टर x, न्यूरॉन i का वेट वेक्टर wi, लर्निंग रेट (t), और नेबरहुड फंक्शन hbi (यह फंक्शन BMU न्यूरॉन b के सापेक्ष न्यूरॉन i के अपडेट की मात्रा को परिमाणित करता है), न्यूरॉन i के लिए वेट अपडेट का सूत्र इस प्रकार है:
  • लर्निंग रेट और नेबरहुड रेडियस की क्षय दर: लर्निंग रेट और नेबरहुड रेडियस दोनों समय के साथ घटते हैं। शुरुआती इटरेशंस में, प्रशिक्षण प्रक्रिया बड़े नेबरहुड पर बड़े समायोजन करती है। बाद की इटरेशंस में आस-पास के न्यूरॉन्स के वेट्स में छोटे बदलाव कर वेट्स को फाइन-ट्यून किया जाता है। इससे मैप स्थिर होता है और कन्वर्ज होता है। 

SOM को प्रशिक्षित करने के लिए, हम मॉडल को इनपुट डेटा प्रस्तुत करते हैं। इसके लिए हम दो तरीकों में से एक चुन सकते हैं: 

  • इनपुट डेटा से रैंडम रूप से सैंपल चुनें। .train_random() फंक्शन यह तकनीक लागू करता है। 
  • इनपुट डेटा के वेक्टर्स को क्रमिक रूप से चलाएँ। यह .train_batch() फंक्शन से किया जाता है। 

ये फंक्शंस इनपुट डेटा और इटरेशंस की संख्या को पैरामीटर के रूप में स्वीकार करते हैं। इस गाइड में, हम .train_random() फंक्शन का उपयोग करते हैं। इटरेशंस की संख्या को एक कॉन्स्टेंट के रूप में घोषित करें और उसे ट्रेनिंग फंक्शन में पास करें: 

N_ITERATIONS = 5000
som.train_random(data, N_ITERATIONS, verbose=True)  

स्क्रिप्ट निष्पादित करने और प्रशिक्षण पूरा होने के बाद, क्वांटाइज़ेशन एरर के साथ एक संदेश दिखता है:

quantization error: 0.05357240680504421 

क्वांटाइज़ेशन एरर यह दर्शाता है कि जब SOM डेटा को क्वांटाइज़ (आयाम घटाता) करता है, तो कितनी जानकारी खो जाती है। बड़ा क्वांटाइज़ेशन एरर न्यूरॉन्स और डेटा बिंदुओं के बीच अधिक दूरी को इंगित करता है। इसका अर्थ यह भी है कि क्लस्टरिंग कम विश्वसनीय है। 

SOM न्यूरॉन्स का विज़ुअलाइज़ेशन 

अब हमारे पास प्रशिक्षित SOM मॉडल है। इसे विज़ुअलाइज़ करने के लिए, हम एक डिस्टेंस मैप (जिसे U-मैट्रिक्स भी कहते हैं) का उपयोग करते हैं। डिस्टेंस मैप SOM के न्यूरॉन्स को कोशिकाओं (सेल्स) के ग्रिड के रूप में दर्शाता है। प्रत्येक सेल का रंग उसके पड़ोसी न्यूरॉन्स से उसकी दूरी को दर्शाता है। 

डिस्टेंस मैप की ग्रिड का आयाम SOM के समान होता है। डिस्टेंस मैप में प्रत्येक सेल, किसी न्यूरॉन और उसके पड़ोसियों के बीच (यूक्लिडियन) दूरियों के नॉर्मलाइज़्ड योग के बराबर होता है। 

SOM distance map तक .distance_map() फंक्शन से पहुँचें। U-मैट्रिक्स बनाने के लिए हम ये चरण अपनाते हैं:

  • pyplot का उपयोग करके SOM के समान आयामों वाला फ़िगर बनाएँ। इस उदाहरण में, आयाम 8x8 हैं। 
  • matplotlib में .pcolor() फंक्शन का उपयोग करके डिस्टेंस मैप प्लॉट करें। इस उदाहरण में, हम gist_yarg को कलर स्कीम के रूप में उपयोग करते हैं। 
  • colorbar दिखाएँ, जो विभिन्न रंगों को अलग-अलग स्कैलर वैल्यूज़ से मैप करता है। इस मामले में, चूँकि दूरियाँ नॉर्मलाइज़्ड हैं, स्कैलर दूरी मान 0 से 1 के बीच होते हैं। 

नीचे का कोड इन चरणों को लागू करता है: 

# create the grid
plt.figure(figsize=(8, 8))
#plot the distance map
plt.pcolor(som.distance_map().T, cmap='gist_yarg') 
# show the color bar
plt.colorbar()
plt.show()

इस उदाहरण में, U-मैट्रिक्स मोनोक्रोम कलर स्कीम का उपयोग करता है। इसे इन दिशानिर्देशों से समझा जा सकता है:
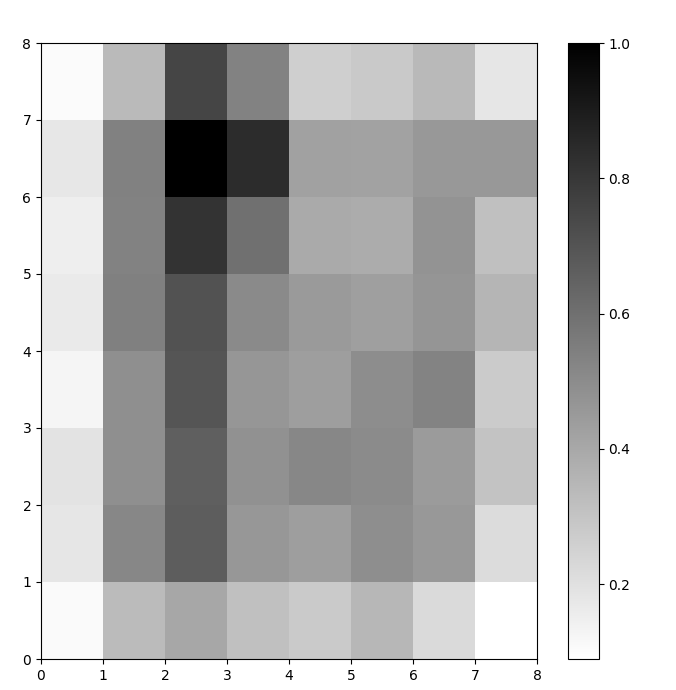
  • हल्के शेड्स निकटवर्ती न्यूरॉन्स का प्रतिनिधित्व करते हैं, और गहरे शेड्स ऐसे न्यूरॉन्स को दर्शाते हैं जो अन्य से अधिक दूर हैं। 
  • हल्के शेड्स के समूहों को क्लस्टर्स के रूप में समझा जा सकता है। क्लस्टर्स के बीच गहरे नोड्स को क्लस्टर्स के बीच की सीमाओं के रूप में समझा जा सकता है। 

Figure 1: U-matrix of the Iris dataset

चित्र 1: Iris डेटासेट पर प्रशिक्षित SOM का U-मैट्रिक्स (चित्र: लेखक)

SOM क्लस्टरिंग परिणामों का मूल्यांकन

पिछले चित्र ने SOM के न्यूरॉन्स को ग्राफ़िक रूप में दर्शाया। इस खंड में, हम दिखाते हैं कि SOM ने डेटा को कैसे क्लस्टर किया है, इसे कैसे विज़ुअलाइज़ करें। 

क्लस्टर्स की पहचान करना

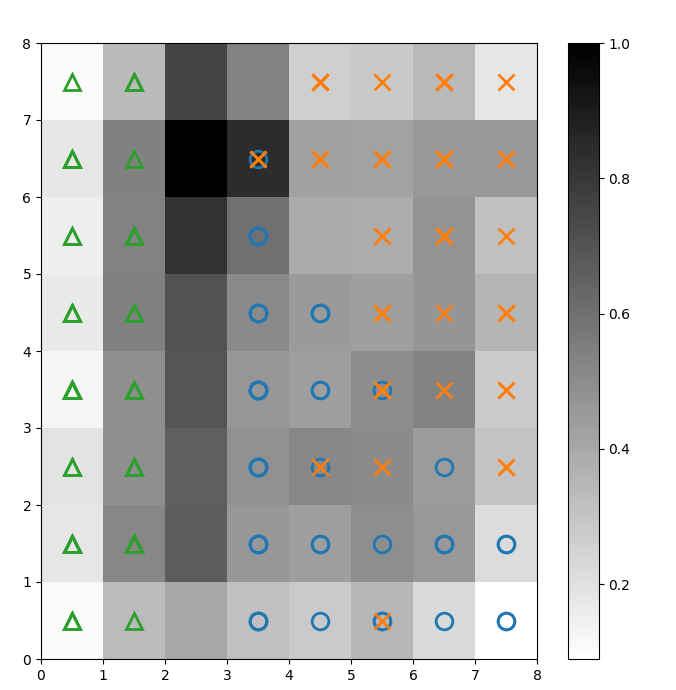
हम ऊपर दिए U-मैट्रिक्स पर मार्कर्स ओवरले करते हैं ताकि दिखा सकें कि प्रत्येक सेल (न्यूरॉन) Iris पौधे की कौन-सी क्लास को दर्शाता है। ऐसा करने के लिए:

  • पहले की तरह, pyplot का उपयोग करके 8x8 फ़िगर बनाएँ, डिस्टेंस मैप प्लॉट करें, और कलर बार दिखाएँ। 
  • Iris पौधों की प्रत्येक क्लास के लिए तीन matplotlib मार्कर्स की एक ऐरे निर्दिष्ट करें। 
  • प्रत्येक क्लास के लिए तीन matplotlib कलर कोड्स की एक ऐरे निर्दिष्ट करें।
  • प्रत्येक डेटा बिंदु के लिए विजेता न्यूरॉन को क्रमिक रूप से प्लॉट करें:
    • प्रत्येक डेटा बिंदु के लिए विजेता न्यूरॉन (के कोऑर्डिनेट्स) .winner() फंक्शन से निर्धारित करें। 
    • प्रत्येक विजेता न्यूरॉन की स्थिति को ग्रिड की प्रत्येक सेल के मध्य में प्लॉट करें। w[0] और w[1] क्रमशः न्यूरॉन के X और Y कोऑर्डिनेट देते हैं। सेल के मध्य में प्लॉट करने हेतु प्रत्येक कोऑर्डिनेट में 0.5 जोड़ा जाता है। 

नीचे का कोड यह कैसे करना है, दिखाता है:

# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg') 
plt.colorbar()
# create the markers and colors for each class
markers = ['o', 'x', '^']
colors = ['C0', 'C1', 'C2']
# plot the winning neuron for each data point
for count, datapoint in enumerate(data):
    # get the winner
    w = som.winner(datapoint)  
    # place a marker on the winning position for the sample data point
    plt.plot(w[0]+.5, w[1]+.5, markers[target[count]-1], markerfacecolor='None',
             markeredgecolor=colors[target[count]-1], markersize=12, markeredgewidth=2)
plt.show()

प्राप्त इमेज नीचे दिखाई गई है: 
U-matrix overlaid with class markers

चित्र 2: क्लास मार्कर्स के साथ ओवरले किया हुआ U-मैट्रिक्स (चित्र: लेखक)

आधारित Iris डेटासेट डाक्यूमेंटेशन पर, “एक क्लास अन्य 2 से रैखिक रूप से पृथक है; बाद की 2 एक-दूसरे से रैखिक रूप से पृथक नहीं हैं।” ऊपर के U-मैट्रिक्स में, इन तीन क्लासों को तीन मार्कर्स—त्रिभुज, वृत्त, और क्रॉस—द्वारा दर्शाया गया है। 

ध्यान दें कि नीले वृत्तों और नारंगी क्रॉसों के बीच स्पष्ट सीमा नहीं है। आगे, कई कोशिकाओं में दो क्लास एक ही न्यूरॉन पर ओवरले हुई हैं। इसका अर्थ है कि वह न्यूरॉन दोनों क्लासों से लगभग समान दूरी पर है। 

क्लस्टरिंग परिणाम का विज़ुअलाइज़ेशन

SOM एक क्लस्टरिंग मॉडल है। समान डेटा बिंदु एक ही न्यूरॉन पर मैप होते हैं। एक ही क्लास के डेटा बिंदु आस-पास के न्यूरॉन्स के क्लस्टर पर मैप होते हैं। क्लस्टरिंग व्यवहार को बेहतर ढंग से अध्ययन करने के लिए हम सभी डेटा बिंदुओं को SOM ग्रिड पर प्लॉट करते हैं। 

निम्न चरण बताते हैं कि यह स्कैटर प्लॉट कैसे बनाएँ:

  • प्रत्येक डेटा बिंदु के लिए विजेता न्यूरॉन के X और Y कोऑर्डिनेट्स प्राप्त करें। 
  • डिस्टेंस मैप को प्लॉट करें, जैसा कि हमने चित्र 1 में किया था। 
  • plt.scatter() का उपयोग करके प्रत्येक डेटा बिंदु के विजेता न्यूरॉन्स का स्कैटर प्लॉट बनाएँ। एक ही सेल में डेटा बिंदुओं के बीच ओवरलैप से बचने हेतु प्रत्येक पॉइंट में रैंडम ऑफ़सेट जोड़ें।

हम नीचे के कोड में इन चरणों को लागू करते हैं: 

# get the X and Y coordinates of the winning neuron for each data pointw_x, w_y = zip(*[som.winner(d) for d in data])
w_x = np.array(w_x)
w_y = np.array(w_y)
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg', alpha=.2)
plt.colorbar()
# make a scatter plot of all the winning neurons for each data point
# add a random offset to each point to avoid overlaps
for c in np.unique(target):
    idx_target = target==c
    plt.scatter(w_x[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
                w_y[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
                s=50, 
                c=colors[c-1], 
                label=labels_iris[c+1]
                )
plt.legend(loc='upper right')
plt.grid()
plt.show()

निम्न ग्राफ़ आउटपुट स्कैटर प्लॉट दिखाता है:
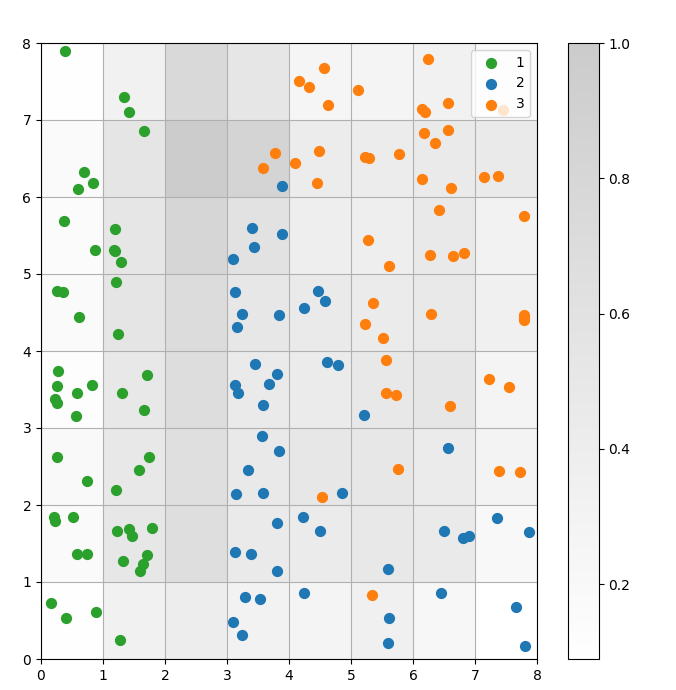
Scatter plot of data points within cells चित्र 3: कोशिकाओं के भीतर डेटा बिंदुओं का स्कैटर प्लॉट (चित्र: लेखक)

ऊपर के स्कैटर प्लॉट में देखें कि: 

  • कुछ कोशिकाओं में नीले और नारंगी दोनों डॉट्स हैं। 
  • हरे डॉट्स शेष डेटा से स्पष्ट रूप से अलग हैं, परंतु नीले और नारंगी डॉट्स साफ़-साफ़ अलग नहीं हैं। 
  • उपरोक्त अवलोकन Iris डेटासेट के तीन में से केवल एक क्लस्टर के स्पष्ट बॉर्डर होने के तथ्य से मेल खाते हैं। 
  • चित्र 1 में क्लस्टर्स के बीच गहरे नोड्स (जिन्हें क्लस्टर्स की सीमाओं के रूप में समझा जा सकता है) स्कैटर प्लॉट में खाली कोशिकाओं से मेल खाते हैं। 

आप इस DataLab नोटबुक में पूरा कोड एक्सेस कर सकते हैं और चला सकते हैं। 

SOM मॉडल को ट्यून करना

पिछले खंडों में हमने SOM मॉडल बनाना और प्रशिक्षित करना, तथा परिणामों का विज़ुअल अध्ययन करना देखा। इस खंड में, हम SOM मॉडलों के प्रदर्शन को कैसे ट्यून करें, इस पर चर्चा करते हैं। 

ट्यून करने के लिए प्रमुख हाइपरपैरामीटर्स

अन्य किसी भी मशीन लर्निंग मॉडल की तरह, हाइपरपैरामीटर्स का मॉडल के प्रदर्शन पर काफी प्रभाव पड़ता है। 

SOMs के प्रशिक्षण में महत्त्वपूर्ण कुछ हाइपरपैरामीटर्स हैं:

  • ग्रिड का आकार मैप के आकार का निर्धारण करता है। AxB ग्रिड आकार वाले मैप में न्यूरॉन्स की संख्या A*B होती है। 
  • लर्निंग रेट तय करता है कि प्रत्येक इटरेशन में वेट्स कितने बदले जाएँ। प्रारंभिक लर्निंग रेट सेट किया जाता है, जो समय के साथ क्षय फंक्शन के अनुसार घटता है। 
  • डिके फंक्शन यह तय करता है कि लर्निंग रेट बाद की प्रत्येक इटरेशन में कितनी घटेगी। 
  • नेबरहुड फंक्शन एक गणितीय फंक्शन है जो यह निर्दिष्ट करता है कि BMU के पड़ोसी किन न्यूरॉन्स को माना जाए। 
  • स्टैंडर्ड डिविएशन नेबरहुड फंक्शन के फैलाव को निर्दिष्ट करता है। उदाहरण के लिए, अधिक स्टैंडर्ड डिविएशन वाला गौसियन नेबरहुड फंक्शन कम स्टैंडर्ड डिविएशन वाले उसी फंक्शन की तुलना में बड़ा नेबरहुड रखेगा। प्रारंभिक स्टैंडर्ड डिविएशन सेट किया जाता है, जो सिग्मा डिके फंक्शन के अनुसार समय के साथ घटता है। 
  • सिग्मा डिके फंक्शन यह नियंत्रित करता है कि बाद की प्रत्येक इटरेशन में स्टैंडर्ड डिविएशन कितनी घटेगी। 
  • ट्रेनिंग इटरेशंस की संख्या तय करती है कि वेट्स कितनी बार अपडेट होंगे। प्रत्येक ट्रेनिंग इटरेशन में न्यूरॉन वेट्स एक बार अपडेट होते हैं। 
  • डिस्टेंस फंक्शन एक गणितीय फंक्शन है जो न्यूरॉन्स और डेटा बिंदुओं के बीच की दूरी की गणना करता है। 
  • टोपोलॉजी ग्रिड संरचना के लेआउट को तय करती है। ग्रिड में न्यूरॉन्स को आयताकार या षट्भुजी पैटर्न में व्यवस्थित किया जा सकता है। 

अगले खंड में, हम इन हाइपरपैरामीटर्स के मान सेट करने के दिशानिर्देशों पर चर्चा करेंगे। 

हाइपरपैरामीटर ट्यूनिंग का प्रभाव

हाइपरपैरामीटर मान मॉडल और डेटासेट के आधार पर तय होने चाहिए। कुछ हद तक, इन मानों का निर्धारण ट्रायल-एंड-एरर की प्रक्रिया है। इस खंड में, हम प्रत्येक हाइपरपैरामीटर को ट्यून करने के दिशानिर्देश देते हैं। प्रत्येक हाइपरपैरामीटर के साथ, हम (कोष्ठकों में) सैंपल कोड में प्रयुक्त संबंधित पायथन कॉन्स्टेंट्स का उल्लेख करते हैं।

  • ग्रिड आकार (SOM_X_AXIS_NODES और SOM_Y_AXIS_NODES): ग्रिड आकार डेटासेट के आकार पर निर्भर करता है। सामान्य नियम है कि N आकार के डेटासेट के लिए, ग्रिड में लगभग 5*sqrt(N) न्यूरॉन्स होने चाहिए। उदाहरण के लिए, यदि डेटासेट में 150 सैंपल हैं, तो ग्रिड में 5*sqrt(150) = लगभग 61 न्यूरॉन्स होने चाहिए। इस ट्यूटोरियल में, Iris डेटासेट में 150 पंक्तियाँ हैं और हम 8x8 ग्रिड का उपयोग करते हैं। 
  • प्रारंभिक लर्निंग रेट (ALPHA): अधिक रेट कन्वर्जेन्स तेज़ करता है, जबकि कम रेट शुरुआती इटरेशंस के बाद सूक्ष्म समायोजन के लिए उपयोग होते हैं। प्रारंभिक लर्निंग रेट इतना बड़ा होना चाहिए कि जल्दी अनुकूलन संभव हो, पर इतना बड़ा नहीं कि वह इष्टतम वेट मानों को पार कर जाए। इस लेख में, प्रारंभिक लर्निंग रेट 0.5 है। 
  • प्रारंभिक स्टैंडर्ड डिविएशन (SIGMA0): यह नेबरहुड के प्रारंभिक आकार या फैलाव को निर्धारित करता है। बड़ा मान अधिक वैश्विक पैटर्न पर विचार करता है। इस उदाहरण में, हम 1.5 का प्रारंभिक स्टैंडर्ड डिविएशन उपयोग करते हैं। 
  • डिके रेट (DECAY_FUNC) और सिग्मा डिके रेट (SIGMA_DECAY_FUNC): हम तीन प्रकार के डिके फंक्शंस में से चुन सकते हैं: 
    • इनवर्स डिके: यह फंक्शन तब उपयुक्त है जब डेटा में वैश्विक और स्थानीय दोनों पैटर्न हों। ऐसे मामलों में, स्थानीय पैटर्न पर ध्यान केंद्रित करने से पहले व्यापक लर्निंग का लंबा चरण चाहिए। 
    • लीनियर डिके: यह उन डेटासेट्स के लिए अच्छा है जहाँ नेबरहुड आकार या लर्निंग रेट का घटाव स्थिर और समान रूप से चाहिए। यह तब उपयोगी है जब डेटा को अधिक फाइन-ट्यूनिंग की आवश्यकता नहीं होती।
    • असिम्प्टोटिक डिके: यह फंक्शन जटिल और उच्च-आयामी डेटा के लिए उपयोगी है। ऐसे मामलों में, सूक्ष्म विवरणों पर धीरे-धीरे जाने से पहले वैश्विक खोज पर अधिक समय बिताना बेहतर होता है। 
  • नेबरहुड फंक्शन (NEIGHBORHOOD_FUNC): नेबरहुड फंक्शन का डिफ़ॉल्ट विकल्प गौसियन फंक्शन है। अन्य फंक्शंस, जैसा कि नीचे समझाया गया है, भी उपयोग होते हैं। 
    • गौसियन (डिफ़ॉल्ट): यह घंटी-आकार का कर्व है। जैसे-जैसे किसी न्यूरॉन की दूरी विजेता न्यूरॉन से बढ़ती है, अपडेट की मात्रा धीरे-धीरे घटती है। यह स्मूथ और सतत बदलाव प्रदान करता है और डेटा की टोपोलॉजी को संरक्षित रखता है। अपने स्थिर और पूर्वानुमेय व्यवहार के कारण अधिकांश सामान्य प्रयोजनों के लिए उपयुक्त है।
    • बबल: यह फंक्शन एक निश्चित-चौड़ाई वाला नेबरहुड बनाता है। इस नेबरहुड के भीतर सभी न्यूरॉन्स समान रूप से अपडेट होते हैं, और इसके बाहर के न्यूरॉन्स (दिए गए डेटा बिंदु के लिए) अपडेट नहीं होते। यह संगणनात्मक रूप से सस्ता और लागू करने में सरल है। यह उन छोटे मैप्स के लिए उपयोगी है जहाँ तीक्ष्ण नेबरहुड सीमाएँ प्रभावी क्लस्टरिंग से समझौता नहीं करतीं। 
    • मैक्सिकन हैट: इसमें एक केंद्रीय पॉज़िटिव क्षेत्र होता है, जिसके चारों ओर नेगेटिव क्षेत्र होता है। BMU के पास के न्यूरॉन्स डेटा बिंदु के समीप लाने हेतु अपडेट होते हैं, जबकि दूर के न्यूरॉन्स डेटा बिंदु से दूर ले जाने हेतु अपडेट होते हैं। यह तकनीक कॉन्ट्रास्ट बढ़ाती है और मैप में विशेषताओं को शार्प करती है। चूँकि यह स्पष्ट क्लस्टर्स पर जोर देती है, इसलिए यह पैटर्न रिकॉग्निशन कार्यों में प्रभावी है जहाँ क्लस्टर्स का स्पष्ट पृथक्करण अपेक्षित है।
    • ट्राएंगल: यह फंक्शन नेबरहुड आकार को त्रिभुज के रूप में परिभाषित करता है, जहाँ BMU का प्रभाव सबसे अधिक होता है और दूरी के साथ यह रैखिक रूप से घटता है। इसका उपयोग उन डेटा के क्लस्टरिंग में होता है जिनमें क्लस्टर्स या विशेषताओं के बीच क्रमिक बदलाव होते हैं, जैसे इमेज, स्पीच, या टाइम-सीरीज़ डेटा, जहाँ पड़ोसी डेटा बिंदुओं के समान विशेषताएँ होने की अपेक्षा होती है। 
  • डिस्टेंस फंक्शन (DISTANCE_FUNC): न्यूरॉन्स और डेटा बिंदुओं के बीच दूरी मापने के लिए, हम 4 तरीकों में से चुन सकते हैं:
    • यूक्लिडियन दूरी (डिफ़ॉल्ट विकल्प): तब उपयोगी जब डेटा निरंतर हो, और हमें सीधी रेखा की दूरी मापनी हो। यह अधिकांश सामान्य कार्यों के लिए उपयुक्त है, विशेषकर जब डेटा बिंदु समान रूप से वितरित हों और स्थानिक रूप से संबंधित हों।
    • कोसाइन दूरी: टेक्स्ट या उच्च-आयामी विरल डेटा के लिए अच्छा विकल्प, जहाँ वेक्टर्स के बीच कोण पर परिमाण से अधिक जोर होता है। यह डेटा में दिशात्मकता की तुलना के लिए उपयोगी है।
    • मैनहैटन दूरी: आदर्श जब डेटा बिंदु ग्रिड या लैटिस (जैसे सिटी ब्लॉक्स) पर हों। यह यूक्लिडियन दूरी की तुलना में आउटलायर्स के प्रति कम संवेदनशील है।
    • चेबिशेव दूरी: उन स्थितियों के लिए उपयुक्त जहाँ किसी भी दिशा में मूवमेंट हो सकता है (जैसे शतरंज-बोर्ड दूरी)। यह डिस्क्रीट स्पेसेज़ में उपयोगी है जहाँ हम अधिकतम अक्षीय अंतर को प्राथमिकता देना चाहते हैं।
  • टोपोलॉजी (TOPOLOGY): ग्रिड में न्यूरॉन्स को षट्भुजी या आयताकार संरचना में व्यवस्थित किया जा सकता है: 
    • आयताकार (डिफ़ॉल्ट): प्रत्येक न्यूरॉन के 4 तात्कालिक पड़ोसी होते हैं। यह तब सही विकल्प है जब डेटा का कोई स्पष्ट स्थानिक संबंध न हो। यह संगणनात्मक रूप से भी सरल है। 
    • षट्भुजी: प्रत्येक न्यूरॉन के 6 पड़ोसी होते हैं। यह तब पसंदीदा विकल्प है जब डेटा में स्थानिक संबंध हों जिन्हें षट्भुजी ग्रिड में बेहतर रूप से दर्शाया जा सके। यह वृत्ताकार या कोणीय डेटा डिस्ट्रीब्यूशंस के मामले में होता है।
  • ट्रेनिंग इटरेशंस की संख्या (N_ITERATIONS): सिद्धांततः, अधिक लंबी ट्रेनिंग से कम एरर और इनपुट डेटा के साथ वेट्स का बेहतर संरेखण मिलता है। हालाँकि, इटरेशंस की संख्या के साथ मॉडल का प्रदर्शन आसन्न रूप से बढ़ता है। अतः, एक निश्चित संख्या के बाद, अतिरिक्त इटरेशंस से प्रदर्शन में बढ़ोतरी केवल मामूली होती है। सही इटरेशंस की संख्या तय करने के लिए कुछ प्रयोग करने पड़ते हैं। इस ट्यूटोरियल में, हम मॉडल को 5000 इटरेशंस तक प्रशिक्षित करते हैं। 

हाइपरपैरामीटर्स का सही संयोजन निर्धारित करने के लिए, हम अनुशंसा करते हैं कि डेटा के छोटे सबसेट पर विभिन्न विकल्पों के साथ प्रयोग करें।

निष्कर्ष

सेल्फ-ऑर्गनाइज़िंग मैप्स अनसुपर्वाइज्ड लर्निंग के लिए एक सशक्त टूल हैं। इनका उपयोग क्लस्टरिंग, आयाम में कमी, एनॉमली डिटेक्शन, और डेटा विज़ुअलाइज़ेशन में होता है। चूँकि वे उच्च-आयामी डेटा के टोपोलॉजिकल गुणों को संरक्षित रखते हुए उसे निम्न-आयामी ग्रिड पर प्रस्तुत करते हैं, SOMs जटिल डेटासेट्स को विज़ुअलाइज़ और इंटरप्रेट करना आसान बनाते हैं। 

इस ट्यूटोरियल में SOMs के मूल सिद्धांतों पर चर्चा की गई और MiniSom पायथन लाइब्रेरी का उपयोग करके SOM को लागू करना दिखाया गया। इसमें परिणामों का विज़ुअल विश्लेषण कैसे करें, यह प्रदर्शित किया गया और SOMs को ट्रेन करने तथा उनके प्रदर्शन को फाइन-ट्यून करने के लिए महत्त्वपूर्ण हाइपरपैरामीटर्स समझाए गए।

FAQs

क्या SOM प्रशिक्षण में बैकप्रोपेगेशन शामिल होता है?

SOM एक कृत्रिम न्यूरल नेटवर्क है, लेकिन इसका प्रशिक्षण त्रुटि सुधार पर आधारित नहीं है। इसलिए, यह ग्रेडिएंट डिसेंट के साथ बैकप्रोपेगेशन का उपयोग नहीं करता। इसके बजाय, SOMs प्रतिस्पर्धी लर्निंग से प्रशिक्षित होते हैं।

डिके फंक्शंस की आवश्यकता क्यों है?

प्रशिक्षण की शुरुआती अवस्था में, मॉडल को डेटा के वैश्विक परिदृश्य का अन्वेषण करना होता है। इसलिए, लर्निंग रेट उच्च होना चाहिए और नेबरहुड फंक्शन का फैलाव व्यापक होना चाहिए। बाद की ट्रेनिंग इटरेशंस में आस-पास के न्यूरॉन्स के आधार पर वेट्स में सूक्ष्म समायोजन किए जाते हैं। प्रशिक्षण के आगे बढ़ने पर, डिके फंक्शंस लर्निंग रेट और नेबरहुड रेडियस को कम करते हैं।

डिफ़ॉल्ट (रैंडम) इनिशियलाइज़ेशन और इनपुट डेटा-आधारित रैंडम इनिशियलाइज़ेशन में क्या अंतर है?

डिफ़ॉल्ट इनिशियलाइज़ेशन में, वेट्स मनमाने रैंडम नंबर्स से इनिशियलाइज़ होते हैं।

इनपुट डेटा पर आधारित रैंडम इनिशियलाइज़ेशन में, वेट्स इनपुट डेटा से रैंडम रूप से चुने गए सैंपल्स पर सेट होते हैं।

क्या SOMs डेटा में नॉन-लीनियर संबंधों को कैप्चर कर सकते हैं?

हाँ, SOMs विभिन्न नेबरहुड फंक्शंस का उपयोग करके डेटा में नॉन-लीनियर पैटर्न को कैप्चर करते हैं। एक अकेला डेटा बिंदु भी (नेबरहुड में) अनेक न्यूरॉन्स के मानों को प्रभावित कर सकता है। इससे SOMs डेटा में जटिल संबंधों को पकड़ पाते हैं।

SOM और पारंपरिक क्लस्टरिंग तरीकों में क्या अंतर है?

SOMs उच्च-आयामी डेटा को निम्न-आयामी ग्रिड पर मैप करते हैं, स्थानिक संबंधों को संरक्षित रखते हुए। दूसरी ओर, K-Means जैसे पारंपरिक क्लस्टरिंग तरीकों में दूरी मीट्रिक्स के आधार पर समूह बनाए जाते हैं, जो आवश्यक रूप से डेटा की टोपोलॉजी या स्थानिक संबंधों का लेखा-जोखा नहीं रखते। 

ध्यान दें कि डेटा विश्लेषण में, टोपोलॉजिकल या स्थानिक संबंध का तात्पर्य बहुआयामी स्पेस में डेटा बिंदुओं की पारस्परिक स्थिति से है।


Arun Nanda's photo
Author
Arun Nanda
LinkedIn

अरुण एक पूर्व स्टार्टअप संस्थापक हैं जो नई चीज़ें बनाना पसंद करते हैं। वे वर्तमान में कृत्रिम बुद्धिमत्ता की तकनीकी और गणितीय नींव का अन्वेषण कर रहे हैं। उन्हें जो सीखा है उसे साझा करना अच्छा लगता है, इसलिए वे इस पर लिखते हैं।

DataCamp के अलावा, आप उनके प्रकाशन Medium, Airbyte, और Vultr पर पढ़ सकते हैं।

विषय
मशीन लर्निंग
Python

इन कोर्सेस के साथ मशीन लर्निंग और पायथन के बारे में और जानें!

कोर्स

Python में Tree-Based Models के साथ Machine Learning

5 घंटा
119.8K
इस पाठ्यक्रम में, आप scikit-learn का उपयोग करके regression और classification के लिए tree-based models और ensembles का उपयोग करना सीखेंगे।
विवरण देखेंRight Arrow
पाठ्यक्रम शुरू करें
और देखेंRight Arrow