

Menyiapkan Lingkungan untuk SOM
Sebelum membangun SOM, kita perlu menyiapkan lingkungan dengan paket yang diperlukan.
Menginstal pustaka Python
Kita memerlukan paket-paket berikut:
- MiniSom adalah alat Python berbasis NumPy yang membuat dan melatih SOM.
- NumPy digunakan untuk mengakses fungsi matematika seperti membagi array, mendapatkan nilai unik, dll.
matplotlibdigunakan untuk memplot berbagai grafik dan bagan guna memvisualisasikan data.- Paket
datasetsdarisklearndigunakan untuk mengimpor dataset yang akan diterapkan SOM. - Paket
MinMaxScalerdarisklearnmenormalkan dataset.
Cuplikan kode berikut mengimpor paket-paket tersebut:
from minisom import MiniSom
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.preprocessing import MinMaxScalerMenyiapkan dataset
Dalam tutorial ini, kita menggunakan MiniSom untuk membangun SOM dan kemudian melatihnya pada dataset IRIS kanonik. Dataset ini terdiri dari 3 kelas tanaman iris. Setiap kelas memiliki 50 instance. Untuk menyiapkan data, kita mengikuti langkah-langkah berikut:
- Impor dataset Iris dari
sklearn, - Ekstrak vektor data dan skalar target.
- Normalisasi vektor data. Dalam tutorial ini, kami menggunakan MinMaxScaler dari scikit-learn.
- Deklarasikan sekumpulan label untuk masing-masing dari tiga kelas tanaman Iris.
Kode berikut mengimplementasikan langkah-langkah tersebut:
dataset_iris = datasets.load_iris()
data_iris = dataset_iris.data
target_iris = dataset_iris.target
data_iris_normalized = MinMaxScaler().fit_transform(data_iris)
labels_iris = {1:'1', 2:'2', 3:'3'}
data = data_iris_normalized
target = target_irisMengimplementasikan Self-Organizing Maps (SOM) di Python
Untuk mengimplementasikan SOM di Python, kita mendefinisikan dan menginisialisasi kisi sebelum melatihnya pada dataset. Kita kemudian dapat memvisualisasikan neuron yang telah dilatih dan dataset yang terklaster.
Mendefinisikan kisi SOM
Seperti dijelaskan sebelumnya, SOM adalah kisi neuron. Dengan MiniSom, kita dapat membuat kisi 2 dimensi. Dimensi X dan Y dari kisi adalah jumlah neuron di sepanjang setiap sumbu. Untuk mendefinisikan kisi SOM, kita juga perlu menentukan:
- Dimensi X dan Y dari kisi
- Jumlah variabel masukan - ini adalah jumlah baris data.
Deklarasikan parameter-parameter ini sebagai konstanta Python:
SOM_X_AXIS_NODES = 8
SOM_Y_AXIS_NODES = 8
SOM_N_VARIABLES = data.shape[1]Contoh kode di bawah ini mengilustrasikan cara mendeklarasikan kisi menggunakan MiniSom:
som = MiniSom(SOM_X_AXIS_NODES, SOM_Y_AXIS_NODES, SOM_N_VARIABLES)Dua parameter pertama adalah jumlah neuron di sepanjang sumbu X dan Y, dan parameter ketiga adalah jumlah variabel.
Kami mendeklarasikan parameter dan hyperparameter lain saat membuat kisi SOM. Kami akan menjelaskannya nanti dalam tutorial. Untuk saat ini, deklarasikan parameter-parameter berikut seperti di bawah ini:
ALPHA = 0.5
DECAY_FUNC = 'linear_decay_to_zero'
SIGMA0 = 1.5
SIGMA_DECAY_FUNC = 'linear_decay_to_one'
NEIGHBORHOOD_FUNC = 'triangle'
DISTANCE_FUNC = 'euclidean'
TOPOLOGY = 'rectangular'
RANDOM_SEED = 123Buat SOM menggunakan parameter-parameter ini:
som = MiniSom(
SOM_X_AXIS_NODES,
SOM_Y_AXIS_NODES,
SOM_N_VARIABLES,
sigma=SIGMA0,
learning_rate=ALPHA,
neighborhood_function=NEIGHBORHOOD_FUNC,
activation_distance=DISTANCE_FUNC,
topology=TOPOLOGY,
sigma_decay_function = SIGMA_DECAY_FUNC,
decay_function = DECAY_FUNC,
random_seed=RANDOM_SEED,
)Menginisialisasi neuron
Perintah di atas membuat SOM dengan bobot acak untuk semua neuron. Menginisialisasi neuron dengan bobot yang diambil dari data (alih-alih angka acak) dapat membuat proses pelatihan lebih efisien.
Saat menggunakan MiniSom untuk membuat Self-Organizing Map (SOM), ada dua cara untuk menginisialisasi bobot neuron berdasarkan data:
- Inisialisasi acak: Bobot awal neuron diambil secara acak dari data masukan. Kita melakukan ini dengan menerapkan fungsi
.random_weights_init()pada SOM. - Inisialisasi PCA: Inisialisasi Principal Component Analysis (PCA) menggunakan komponen utama dari data masukan untuk menginisialisasi bobot. Bobot awal neuron merentang dua komponen utama pertama. Ini sering menghasilkan konvergensi yang lebih cepat.
Dalam panduan ini, kami menggunakan inisialisasi PCA. Untuk menerapkan inisialisasi PCA pada bobot SOM, gunakan fungsi .pca_weights_init() seperti di bawah ini:
som.pca_weights_init(data)Melatih SOM
Proses pelatihan memperbarui bobot SOM untuk meminimalkan jarak antara neuron dan titik data.
Di bawah ini, kami jelaskan proses pelatihan iteratif:
- Inisialisasi: Vektor bobot semua neuron diinisialisasi, biasanya dengan nilai acak. Juga dimungkinkan untuk menginisialisasi bobot dengan mengambil sampel distribusi data masukan.
- Pemilihan masukan: Sebuah vektor masukan dipilih (secara acak) dari dataset pelatihan.
- Identifikasi BMU: Neuron dengan vektor bobot paling dekat dengan vektor masukan diidentifikasi sebagai BMU.
- Pembaruan lingkungan: BMU dan neuron tetangganya memperbarui vektor bobotnya. Laju pembelajaran dan fungsi lingkungan menentukan neuron mana yang diperbarui dan seberapa besar. Pada langkah iterasi t, diberikan vektor masukan x, vektor bobot neuron i sebagai wi, laju pembelajaran (t), dan fungsi lingkungan hbi (fungsi ini mengkuantifikasi besarnya pembaruan untuk neuron i dengan BMU neuron b), rumus pembaruan bobot untuk neuron i dinyatakan sebagai:
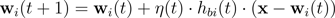
- Laju peluruhan laju pembelajaran dan radius lingkungan: Baik laju pembelajaran maupun radius lingkungan menurun seiring waktu. Pada iterasi awal, proses pelatihan melakukan penyesuaian yang lebih besar pada lingkungan yang lebih luas. Iterasi selanjutnya membantu menyetel bobot dengan membuat perubahan yang lebih kecil pada bobot neuron yang berdekatan. Ini memungkinkan peta menjadi stabil dan konvergen.
Untuk melatih SOM, kita menyajikan model dengan data masukan. Kita dapat memilih dari dua pendekatan berikut:
- Memilih sampel secara acak dari data masukan. Fungsi
.train_random()mengimplementasikan teknik ini. - Menjalankan secara berurutan vektor-vektor dalam data masukan. Ini dilakukan menggunakan fungsi
.train_batch().
Fungsi-fungsi ini menerima data masukan dan jumlah iterasi sebagai parameter. Dalam panduan ini, kami menggunakan fungsi .train_random() . Deklarasikan jumlah iterasi sebagai konstanta dan teruskan ke fungsi pelatihan:
N_ITERATIONS = 5000
som.train_random(data, N_ITERATIONS, verbose=True) Setelah menjalankan skrip dan menyelesaikan pelatihan, pesan dengan galat kuantisasi akan ditampilkan:
quantization error: 0.05357240680504421 Galat kuantisasi menunjukkan jumlah informasi yang hilang saat SOM mengkuantisasi (mengurangi dimensi) data. Galat kuantisasi yang besar menunjukkan jarak yang lebih besar antara neuron dan titik data. Ini juga berarti bahwa pengklasteran kurang andal.
Memvisualisasikan neuron SOM
Sekarang kita memiliki model SOM terlatih. Untuk memvisualisasikannya, kita menggunakan peta jarak (juga dikenal sebagai U-matrix). Peta jarak menampilkan neuron SOM sebagai kisi sel. Warna setiap sel mewakili jaraknya dari neuron tetangga.
Peta jarak adalah kisi dengan dimensi yang sama seperti SOM. Setiap sel dalam peta jarak adalah jumlah ternormalisasi dari jarak (Euclidean) antara sebuah neuron dan para tetangganya.
Akses SOM distance map menggunakan fungsi .distance_map(). Untuk menghasilkan U-matrix, kita mengikuti langkah-langkah berikut:
- Gunakan
pyplotuntuk membuat gambar dengan dimensi yang sama seperti SOM. Pada contoh ini, dimensinya 8x8. - Plot peta jarak menggunakan matplotlib dengan fungsi
.pcolor(). Pada contoh ini, kami menggunakangist_yargsebagai skema warna. - Tampilkan
colorbar, sebuah indeks yang memetakan warna berbeda ke nilai skalar yang berbeda. Dalam hal ini, karena jarak ternormalisasi, nilai jarak skalar berkisar dari 0 hingga 1.
Kode di bawah ini mengimplementasikan langkah-langkah tersebut:
# create the grid
plt.figure(figsize=(8, 8))
#plot the distance map
plt.pcolor(som.distance_map().T, cmap='gist_yarg')
# show the color bar
plt.colorbar()
plt.show()Pada contoh ini, U-matrix menggunakan skema warna monokrom. Ini dapat dipahami dengan pedoman berikut:
- Warna yang lebih terang merepresentasikan neuron yang berjarak dekat, dan warna yang lebih gelap merepresentasikan neuron yang lebih jauh dari yang lain.
- Kelompok rona yang lebih terang dapat diinterpretasikan sebagai klaster. Node gelap di antara klaster dapat diinterpretasikan sebagai batas antar klaster.
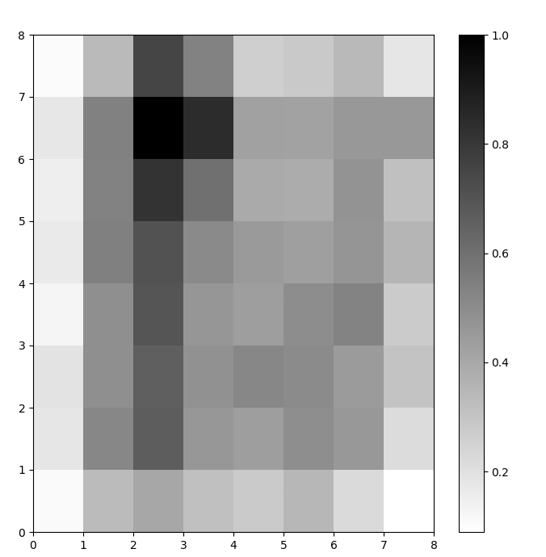
Gambar 1: U-matrix dari SOM yang dilatih pada dataset Iris (gambar oleh penulis)
Mengevaluasi Hasil Klastering SOM
Gambar sebelumnya menggambarkan neuron SOM secara grafis. Pada bagian ini, kami menunjukkan cara memvisualisasikan bagaimana SOM mengklaster data.
Mengidentifikasi klaster
Kami menumpangkan penanda di atas U-matrix untuk menandai kelas tanaman Iris apa yang diwakili setiap sel (neuron). Untuk melakukan ini:
- Seperti sebelumnya, buat gambar 8x8 menggunakan
pyplot, plot peta jarak, dan tampilkan color bar. - Tentukan larik tiga marker matplotlib, masing-masing untuk setiap kelas tanaman Iris.
- Tentukan larik tiga kode warna matplotlib, masing-masing untuk setiap kelas tanaman Iris.
- Plot secara iteratif neuron pemenang untuk setiap titik data:
- Tentukan (koordinat) neuron pemenang untuk setiap titik data menggunakan fungsi
.winner(). - Plot posisi setiap neuron pemenang di tengah setiap sel pada kisi.
w[0]danw[1]memberikan koordinat X dan Y neuron, masing-masing. Nilai 0,5 ditambahkan ke setiap koordinat untuk memplotnya di tengah sel.
Kode di bawah ini menunjukkan caranya:
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg')
plt.colorbar()
# create the markers and colors for each class
markers = ['o', 'x', '^']
colors = ['C0', 'C1', 'C2']
# plot the winning neuron for each data point
for count, datapoint in enumerate(data):
# get the winner
w = som.winner(datapoint)
# place a marker on the winning position for the sample data point
plt.plot(w[0]+.5, w[1]+.5, markers[target[count]-1], markerfacecolor='None',
markeredgecolor=colors[target[count]-1], markersize=12, markeredgewidth=2)
plt.show()Gambar yang dihasilkan ditunjukkan di bawah ini:
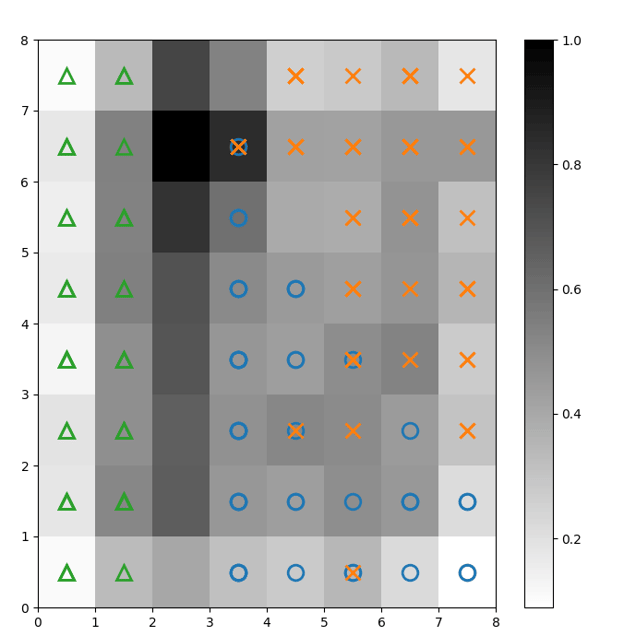
Gambar 2: U-matrix dengan penanda kelas (gambar oleh penulis)
Berdasarkan dokumentasi dataset Iris, “satu kelas dapat dipisahkan secara linear dari 2 lainnya; yang terakhir tidak dapat dipisahkan secara linear satu sama lain”. Pada U-matrix di atas, tiga kelas ini diwakili oleh tiga penanda—segitiga, lingkaran, dan silang.
Perhatikan bahwa tidak ada batas yang jelas antara lingkaran biru dan tanda silang oranye. Selain itu, dua kelas ditumpangkan pada neuron yang sama di banyak sel. Ini berarti neuron tersebut berjarak sama dari kedua kelas.
Memvisualisasikan hasil klastering
SOM adalah model klastering. Titik data yang serupa dipetakan ke neuron yang sama. Titik data dari kelas yang sama dipetakan ke klaster neuron yang berdekatan. Kami memplot semua titik data pada kisi SOM untuk mempelajari perilaku klastering dengan lebih baik.
Langkah-langkah berikut menjelaskan cara membuat scatter plot ini:
- Dapatkan koordinat X dan Y dari neuron pemenang untuk setiap titik data.
- Plot peta jarak, seperti yang kita lakukan untuk Gambar 1.
- Gunakan
plt.scatter()untuk membuat scatter plot dari semua neuron pemenang untuk setiap titik data. Tambahkan offset acak ke setiap titik untuk menghindari tumpang tindih antar titik data dalam sel yang sama.
Kami mengimplementasikan langkah-langkah ini dalam kode di bawah:
# get the X and Y coordinates of the winning neuron for each data pointw_x, w_y = zip(*[som.winner(d) for d in data])
w_x = np.array(w_x)
w_y = np.array(w_y)
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg', alpha=.2)
plt.colorbar()
# make a scatter plot of all the winning neurons for each data point
# add a random offset to each point to avoid overlaps
for c in np.unique(target):
idx_target = target==c
plt.scatter(w_x[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
w_y[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
s=50,
c=colors[c-1],
label=labels_iris[c+1]
)
plt.legend(loc='upper right')
plt.grid()
plt.show()Grafik berikut menunjukkan keluaran scatter plot:
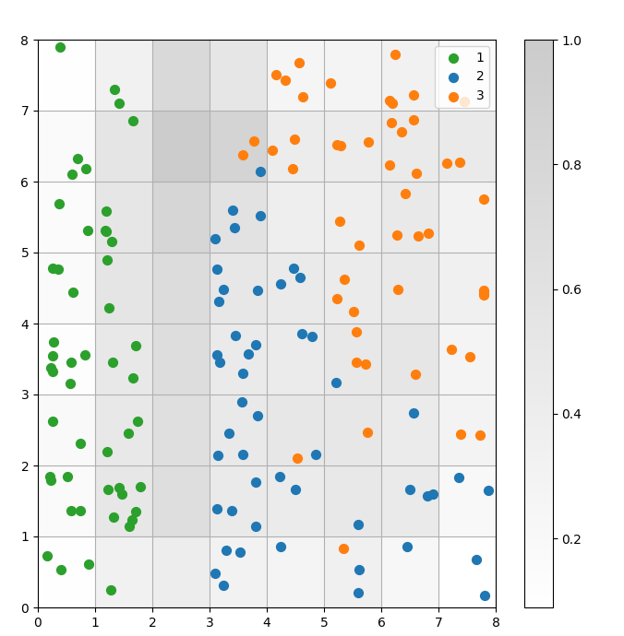 Gambar 3: Scatter plot titik data di dalam sel (gambar oleh penulis)
Pada scatter plot di atas, perhatikan bahwa:
- Beberapa sel berisi titik biru dan oranye sekaligus.
- Titik hijau jelas terpisah dari data lainnya, tetapi titik biru dan oranye tidak terpisah dengan bersih.
- Pengamatan di atas selaras dengan fakta bahwa hanya satu dari tiga klaster pada dataset Iris yang memiliki batas yang jelas.
- Pada Gambar 1, node gelap di antara klaster (yang dapat diinterpretasikan sebagai batas antar klaster) cocok dengan sel kosong pada scatter plot.
Anda dapat mengakses dan menjalankan kode lengkap pada notebook DataLab ini.
Menyetel Model SOM
Bagian sebelumnya menunjukkan cara membuat dan melatih model SOM serta cara mempelajari hasilnya secara visual. Pada bagian ini, kami membahas cara menyetel kinerja model SOM.
Hyperparameter utama untuk disetel
Seperti halnya model pembelajaran mesin lainnya, hyperparameter sangat memengaruhi kinerja model.
Beberapa hyperparameter yang penting dalam melatih SOM adalah:
- Ukuran kisi menentukan ukuran peta. Jumlah neuron dalam peta dengan ukuran kisi AxB adalah A*B.
- Laju pembelajaran menentukan seberapa besar perubahan bobot pada setiap iterasi. Kita menetapkan laju pembelajaran awal, dan nilainya menurun seiring waktu sesuai fungsi peluruhan.
- Fungsi peluruhan menentukan sejauh mana laju pembelajaran dikurangi pada setiap iterasi berikutnya.
- Fungsi lingkungan adalah fungsi matematis yang menentukan neuron mana saja yang dianggap sebagai tetangga BMU.
- Deviasi standar menentukan sebaran fungsi lingkungan. Misalnya, fungsi lingkungan Gaussian dengan deviasi standar tinggi akan memiliki lingkungan yang lebih besar dibandingkan fungsi yang sama dengan deviasi standar lebih kecil. Kita menetapkan deviasi standar awal yang menurun seiring waktu sesuai fungsi peluruhan sigma.
- Fungsi peluruhan sigma mengontrol seberapa banyak deviasi standar dikurangi pada setiap iterasi berikutnya.
- Jumlah iterasi pelatihan menentukan berapa kali bobot diperbarui. Pada setiap iterasi pelatihan, bobot neuron diperbarui sekali.
- Fungsi jarak adalah fungsi matematis yang menghitung jarak antara neuron dan titik data.
- Topologi menentukan tata letak struktur kisi. Neuron dalam kisi dapat diatur dalam pola persegi panjang atau heksagonal.
Pada bagian berikutnya, kami membahas pedoman untuk menetapkan nilai hyperparameter tersebut.
Dampak penyetelan hyperparameter
Nilai hyperparameter harus ditentukan berdasarkan model dan dataset. Sampai batas tertentu, penentuannya adalah proses coba-coba. Pada bagian ini, kami memberikan pedoman untuk menyetel tiap hyperparameter. Di samping setiap hyperparameter, kami mencantumkan (dalam tanda kurung) konstanta Python masing-masing yang digunakan dalam contoh kode.
- Ukuran kisi (
SOM_X_AXIS_NODESdanSOM_Y_AXIS_NODES): Ukuran kisi bergantung pada ukuran dataset. Aturan praktisnya adalah untuk dataset berukuran N, kisi harus berisi kira-kira 5*sqrt(N) neuron. Misalnya, jika dataset memiliki 150 sampel, kisi harus berisi 5*sqrt(150) = sekitar 61 neuron. Dalam tutorial ini, dataset Iris memiliki 150 baris dan kami menggunakan kisi 8x8. - Laju pembelajaran awal (
ALPHA): Laju yang lebih tinggi mempercepat konvergensi, sementara laju yang lebih rendah digunakan untuk penyesuaian yang lebih halus setelah iterasi awal. Laju pembelajaran awal harus cukup besar agar adaptasi cepat namun tidak terlalu besar hingga melampaui nilai bobot optimal. Dalam artikel ini, laju pembelajaran awal adalah 0,5. - Deviasi standar awal (
SIGMA0): Menentukan ukuran atau sebaran lingkungan awal. Nilai yang lebih besar mempertimbangkan pola yang lebih global. Pada contoh ini, kami menggunakan deviasi standar awal 1,5. - Untuk laju peluruhan (
DECAY_FUNC) dan laju peluruhan sigma (SIGMA_DECAY_FUNC), kita dapat memilih dari salah satu dari tiga jenis fungsi peluruhan: - Peluruhan invers: Fungsi ini cocok jika data memiliki pola global dan lokal. Dalam kasus seperti itu, kita memerlukan fase pembelajaran luas yang lebih lama sebelum fokus pada pola lokal.
- Peluruhan linear: Ini bagus untuk dataset di mana kita menginginkan pengurangan ukuran lingkungan atau laju pembelajaran yang stabil dan seragam. Berguna jika data tidak memerlukan banyak fine-tuning.
- Peluruhan asimtotik: Fungsi ini bermanfaat jika data kompleks dan berdimensi tinggi. Dalam kasus seperti itu, lebih baik menghabiskan lebih banyak waktu untuk eksplorasi global sebelum secara bertahap beralih ke detail yang lebih halus.
- Fungsi lingkungan (
NEIGHBORHOOD_FUNC): Pilihan default fungsi lingkungan adalah fungsi Gaussian. Fungsi lain, seperti dijelaskan di bawah, juga digunakan. - Gaussian (default): Ini adalah kurva berbentuk lonceng. Besarnya pembaruan neuron menurun secara mulus seiring meningkatnya jarak dari neuron pemenang. Ini memberikan transisi yang halus dan berkelanjutan serta mempertahankan topologi data. Cocok untuk sebagian besar tujuan umum karena perilakunya yang stabil dan dapat diprediksi.
- Bubble: Fungsi ini membuat lingkungan dengan lebar tetap. Semua neuron dalam lingkungan ini diperbarui secara setara, dan neuron di luar lingkungan ini tidak diperbarui (untuk titik data tertentu). Lebih hemat komputasi dan lebih mudah diimplementasikan. Berguna untuk peta yang lebih kecil di mana batas lingkungan yang tajam tidak mengorbankan klastering yang efektif.
- Mexican hat: Memiliki wilayah positif di tengah yang dikelilingi wilayah negatif. Neuron yang dekat dengan BMU diperbarui agar mendekati titik data, dan neuron yang lebih jauh diperbarui agar menjauh dari titik data. Teknik ini meningkatkan kontras dan menajamkan fitur pada peta. Karena menekankan klaster yang berbeda, ini efektif dalam tugas pengenalan pola di mana pemisahan klaster yang jelas diinginkan.
- Triangle: Fungsi ini mendefinisikan ukuran lingkungan sebagai segitiga, dengan BMU memiliki pengaruh terbesar. Pengaruh menurun secara linear dengan jarak dari BMU. Digunakan untuk mengklaster data dengan transisi bertahap antar klaster atau fitur, seperti data citra, ucapan, atau deret waktu, di mana titik data yang berdekatan diperkirakan memiliki karakteristik serupa.
- Fungsi jarak (
DISTANCE_FUNC): Untuk mengukur jarak antara neuron dan titik data, kita dapat memilih dari 4 metode: - Jarak Euclidean (pilihan default): Berguna saat data bersifat kontinu, dan kita ingin mengukur jarak garis lurus. Cocok untuk sebagian besar tugas umum, khususnya saat titik data terdistribusi merata dan berhubungan secara spasial.
- Jarak cosine: Pilihan yang baik untuk teks atau data jarang berdimensi tinggi di mana sudut antar vektor lebih penting daripada magnitudo. Berguna untuk membandingkan arah dalam data.
- Jarak Manhattan: Ideal saat titik data berada pada kisi atau jaringan (mis., blok kota). Kurang sensitif terhadap outlier dibanding jarak Euclidean.
- Jarak Chebyshev: Cocok untuk situasi di mana pergerakan dapat terjadi ke segala arah (mis., jarak papan catur). Berguna untuk ruang diskret di mana kita ingin memprioritaskan perbedaan sumbu maksimum.
- Topologi (
TOPOLOGY): Dalam sebuah kisi, neuron dapat diatur dalam struktur heksagonal atau persegi panjang: - Persegi panjang (default): setiap neuron memiliki 4 tetangga terdekat. Ini adalah pilihan yang tepat saat data tidak memiliki hubungan spasial yang jelas. Juga lebih sederhana secara komputasi.
- Heksagonal: setiap neuron memiliki 6 tetangga. Ini adalah opsi yang disukai jika data memiliki hubungan spasial yang lebih baik direpresentasikan dengan kisi heksagonal. Ini terjadi pada distribusi data melingkar atau angular.
- Jumlah iterasi pelatihan (
N_ITERATIONS): Secara prinsip, waktu pelatihan yang lebih lama mengarah pada galat yang lebih rendah dan penyelarasan bobot yang lebih baik dengan data masukan. Namun, kinerja model meningkat secara asimtotik dengan jumlah iterasi. Dengan demikian, setelah jumlah iterasi tertentu, peningkatan kinerja dari iterasi selanjutnya hanya bersifat marginal. Menentukan jumlah iterasi yang tepat memerlukan sedikit eksperimen. Dalam tutorial ini, kami melatih model selama 5000 iterasi.
Untuk menentukan konfigurasi hyperparameter yang tepat, kami merekomendasikan bereksperimen dengan berbagai opsi pada subset data yang lebih kecil.
Kesimpulan
Self-organizing maps adalah alat yang tangguh untuk pembelajaran tanpa pengawasan. Alat ini digunakan untuk klastering, reduksi dimensi, deteksi anomali, dan visualisasi data. Karena mempertahankan sifat topologis dari data berdimensi tinggi dan merepresentasikannya pada kisi berdimensi lebih rendah, SOM memudahkan visualisasi dan interpretasi dataset yang kompleks.
Tutorial ini membahas prinsip dasar SOM dan menunjukkan cara mengimplementasikan SOM menggunakan pustaka Python MiniSom. Tutorial ini juga memperlihatkan cara menganalisis hasil secara visual serta menjelaskan hyperparameter penting yang digunakan untuk melatih SOM dan menyetel kinerjanya.
FAQs
Apakah pelatihan SOM melibatkan backpropagation?
SOM adalah jaringan saraf buatan, tetapi pelatihannya tidak berbasis pada koreksi galat. Dengan demikian, SOM tidak menggunakan backpropagation dengan gradient descent. Sebagai gantinya, SOM dilatih menggunakan pembelajaran kompetitif.
Apa perlunya fungsi peluruhan?
Pada awal proses pelatihan, model perlu mengeksplorasi lanskap global data. Karena itu, laju pembelajaran perlu tinggi, dan fungsi lingkungan perlu tersebar luas. Iterasi pelatihan selanjutnya melakukan penyesuaian yang lebih halus pada bobot berdasarkan neuron yang berdekatan. Seiring pelatihan berlangsung, fungsi peluruhan mengurangi laju pembelajaran dan radius lingkungan.
Apa perbedaan antara inisialisasi default (acak) dan inisialisasi acak berbasis data masukan?
Dalam inisialisasi default, bobot diinisialisasi ke angka acak sembarang.
Dalam inisialisasi acak berbasis data masukan, bobot diinisialisasi ke sampel yang dipilih secara acak dari data masukan.
Dapatkah SOM menangkap hubungan non-linear dalam data?
Ya, SOM menangkap pola non-linear dalam data dengan menggunakan berbagai fungsi lingkungan. Satu titik data dapat memengaruhi nilai banyak neuron (dalam lingkungan). Ini memungkinkan SOM menangkap hubungan yang kompleks dalam data.
Apa perbedaan antara SOM dan metode klastering tradisional?
SOM memetakan data berdimensi tinggi ke kisi berdimensi lebih rendah, dengan mempertahankan hubungan spasial. Di sisi lain, teknik klastering tradisional seperti K-Means membuat kelompok berdasarkan metrik jarak tanpa harus mempertimbangkan topologi atau hubungan spasial data.
Perlu dicatat bahwa dalam analisis data, hubungan topologis atau spasial mengacu pada bagaimana titik data diposisikan relatif satu sama lain dalam ruang multi-dimensi.

Arun adalah mantan pendiri startup yang gemar membangun hal-hal baru. Saat ini ia mengeksplorasi landasan teknis dan matematis Kecerdasan Buatan. Ia senang berbagi apa yang dipelajarinya, sehingga ia menulis tentang topik tersebut.
Selain di DataCamp, Anda dapat membaca publikasinya di Medium, Airbyte, dan Vultr.




Self-organizing maps (SOM) adalah jenis jaringan saraf buatan yang digunakan untuk tugas pembelajaran tanpa pengawasan seperti klastering. Diberikan sekumpulan titik data, model belajar membagi data ke dalam klaster. SOM memproyeksikan data multidimensi yang kompleks ke kisi berdimensi lebih rendah (biasanya 2 dimensi). Ini memudahkan visualisasi. Karena itu, SOM juga digunakan untuk memvisualisasikan data berdimensi tinggi.
Dalam tutorial ini, kita membahas konsep inti SOM, proses pembelajarannya, dan kasus penggunaan tipikalnya. Kami menjelaskan cara mengimplementasikan SOM di Python menggunakan pustaka MiniSom dan bagaimana merepresentasikan hasilnya secara visual. Terakhir, kami membahas hyperparameter penting dalam melatih model SOM dan cara menyetelnya.
Memahami Self-Organizing Maps (SOM)
Pada bagian ini, kami menyajikan konsep inti SOM, proses pembelajarannya, dan kasus penggunaannya.
Konsep inti SOM
Self-organizing maps melibatkan serangkaian konsep yang penting untuk dipahami.
Neuron
SOM pada dasarnya adalah sebuah kisi neuron. Selama pelatihan, neuron yang vektor bobotnya paling dekat dengan titik data masukan menyesuaikan bobotnya dan bobot tetangganya agar semakin sesuai dengan titik data masukan. Selama banyak iterasi, kelompok neuron yang berdekatan memetakan ke titik-titik data yang saling terkait. Ini menghasilkan pengklasteran dataset masukan.
Struktur kisi
Neuron dalam SOM diatur sebagai kisi. Neuron yang berdekatan memetakan ke titik data yang serupa. Dataset yang lebih besar membutuhkan kisi yang lebih besar. Biasanya, kisi ini berdimensi dua. Struktur kisi berfungsi sebagai ruang berdimensi rendah tempat data berdimensi tinggi dipetakan. Kisi membantu memvisualisasikan pola dan klaster data.
Memetakan titik data
Setiap titik data dibandingkan dengan semua neuron menggunakan metrik jarak. Neuron yang vektor bobotnya paling dekat dengan titik data masukan adalah Best Matching Unit (BMU) untuk titik data tersebut.
Setelah BMU diidentifikasi, bobot BMU dan neuron tetangganya diperbarui. Pembaruan ini membuat BMU dan neuron tetangga semakin dekat dengan titik data masukan. Pemetaan ini mempertahankan topologi data, memastikan bahwa titik data yang mirip dipetakan ke neuron yang berdekatan.
Proses pembelajaran SOM
Pelatihan SOM dianggap tanpa pengawasan karena tidak berbasis pada dataset berlabel. Tujuan pelatihan SOM adalah menyesuaikan vektor bobot neuron secara iteratif sehingga titik data yang serupa dipetakan ke neuron yang berdekatan.
Pembelajaran kompetitif
SOM menggunakan pembelajaran kompetitif (alih-alih gradient descent dan backpropagation). Neuron bersaing untuk menjadi Best Matching Unit (BMU) untuk setiap titik data masukan. Neuron yang paling dekat dengan suatu titik data ditetapkan sebagai BMU-nya. BMU dan neuron tetangganya diperbarui untuk semakin mengurangi jarak ke titik data tersebut. Neuron yang berdekatan memetakan ke titik data yang terkait. Ini mengarah pada spesialisasi antar neuron dan pengklasteran titik data masukan.
Fungsi jarak
SOM menggunakan fungsi jarak untuk mengukur jarak antara neuron dan titik data. Jarak ini digunakan untuk menentukan BMU dari setiap titik data. MiniSom memiliki empat fungsi jarak untuk dipilih:
Fungsi lingkungan
Setelah mengidentifikasi BMU dari suatu titik data, BMU dan neuron tetangganya diperbarui ke arah titik data tersebut. Fungsi lingkungan memastikan SOM mempertahankan hubungan topologis dari data masukan. Fungsi lingkungan menentukan:
MiniSom dilengkapi dengan tiga fungsi lingkungan:
Proses iteratif
Proses pembelajaran dalam SOM terjadi selama beberapa iterasi. Pada setiap iterasi, SOM memproses banyak titik data masukan. Kami garisbesarkan proses pembelajaran dalam langkah-langkah berikut:
Langkah-langkah ini diulang selama banyak iterasi, melintasi banyak titik data masukan. Bobot diperbarui secara bertahap sehingga peta menyusun dirinya sendiri dan menangkap struktur data.
Laju pembelajaran dan radius lingkungan biasanya menurun seiring waktu, memungkinkan SOM menyetel bobot secara bertahap. Di bagian akhir tutorial, kami mengimplementasikan langkah-langkah proses pelatihan iteratif menggunakan kode Python.
Kasus penggunaan tipikal SOM
Mengingat arsitekturnya yang unik, SOM memiliki beberapa aplikasi khas dalam pembelajaran mesin, analisis, dan visualisasi.
Klastering
SOM digunakan untuk mengelompokkan data berdimensi tinggi ke dalam klaster titik data yang serupa. Ini membantu mengidentifikasi struktur bawaan dalam data. Setiap neuron memetakan ke titik data yang sangat terkait dan titik data yang serupa dipetakan ke neuron yang sama atau berdekatan, sehingga membentuk klaster yang berbeda.
Sebagai contoh, dalam pemasaran, SOM dapat mengelompokkan pelanggan berdasarkan perilaku pembelian. Ini memungkinkan sebuah merek menyesuaikan strategi pemasaran untuk segmen pelanggan (klaster) yang berbeda.
Reduksi dimensi
SOM dapat memetakan data berdimensi tinggi dengan banyak vektor fitur ke kisi dengan dimensi lebih sedikit (biasanya kisi 2 dimensi). Karena pemetaan ini mempertahankan hubungan antar titik data, dimensi yang diperkecil membuat lebih mudah memvisualisasikan himpunan data yang kompleks tanpa kehilangan informasi yang signifikan.
Selain mempermudah tugas visualisasi dan analisis, SOM juga dapat mengurangi dimensi data sebelum menerapkan algoritma pembelajaran mesin lain. SOM juga digunakan dalam pemrosesan citra untuk mengurangi jumlah fitur dengan mengklaster piksel atau wilayah dengan karakteristik serupa, sehingga membuat tugas pengenalan dan klasifikasi citra lebih efisien.
Deteksi anomali
Selama proses pelatihan, sebagian besar titik data dipetakan ke neuron tertentu. Anomali (titik data yang tidak cocok dengan klaster mana pun) biasanya dipetakan ke neuron yang jauh atau kurang terisi. Outlier ini tidak cocok dengan klaster yang dipelajari dan dipetakan ke neuron yang jauh dari BMU titik data normal.
Sebagai contoh, memetakan transaksi keuangan pada kisi SOM memungkinkan kita mengidentifikasi aktivitas tidak biasa (outlier) yang dapat mengindikasikan potensi penipuan.
Visualisasi data
Visualisasi data adalah salah satu kasus penggunaan paling umum dari SOM. Data berdimensi tinggi sulit divisualisasikan. SOM memudahkan visualisasi dengan mengurangi dimensi data dan memproyeksikannya pada kisi dua dimensi. Ini juga dapat membantu mendeteksi klaster dalam data dan titik data anomali yang akan sulit ditemukan pada data asli.
Sebagai contoh, visualisasi data memudahkan analisis data populasi berdimensi tinggi. Memetakan data pada kisi 2D akan membantu melihat kesamaan dan perbedaan antar kelompok populasi.
Setelah membahas konsep inti dan kasus penggunaan SOM, kami akan menunjukkan cara mengimplementasikannya menggunakan paket Python MiniSom pada bagian berikut.
Anda dapat mengakses dan menjalankan kode lengkap pada notebook DataLab ini.