

Thiết lập môi trường cho SOM
Trước khi xây dựng SOM, chúng ta cần chuẩn bị môi trường với các gói cần thiết.
Cài đặt thư viện Python
Chúng ta cần các gói sau:
- MiniSom là công cụ Python dựa trên NumPy để tạo và huấn luyện SOM.
- NumPy dùng để truy cập các hàm toán như tách mảng, lấy giá trị duy nhất, v.v.
matplotlibdùng để vẽ các biểu đồ nhằm trực quan hóa dữ liệu.- Gói
datasetstừsklearndùng để nhập các tập dữ liệu áp dụng SOM. - Gói
MinMaxScalertừsklearndùng để chuẩn hóa tập dữ liệu.
Đoạn mã sau nhập các gói này:
from minisom import MiniSom
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.preprocessing import MinMaxScalerChuẩn bị tập dữ liệu
Trong hướng dẫn này, chúng ta dùng MiniSom để xây dựng SOM và huấn luyện trên bộ IRIS kinh điển. Bộ dữ liệu gồm 3 lớp hoa iris. Mỗi lớp có 50 mẫu. Để chuẩn bị dữ liệu, ta thực hiện các bước:
- Nhập bộ dữ liệu Iris từ
sklearn, - Trích xuất các véc-tơ dữ liệu và các giá trị mục tiêu.
- Chuẩn hóa các véc-tơ dữ liệu. Trong hướng dẫn này, chúng ta dùng MinMaxScaler của scikit-learn.
- Khai báo bộ nhãn cho mỗi trong ba lớp hoa Iris.
Mã dưới đây hiện thực các bước này:
dataset_iris = datasets.load_iris()
data_iris = dataset_iris.data
target_iris = dataset_iris.target
data_iris_normalized = MinMaxScaler().fit_transform(data_iris)
labels_iris = {1:'1', 2:'2', 3:'3'}
data = data_iris_normalized
target = target_irisTriển khai Bản đồ Tự Tổ chức (SOM) trong Python
Để triển khai SOM trong Python, chúng ta định nghĩa và khởi tạo lưới trước khi huấn luyện trên tập dữ liệu. Sau đó có thể trực quan hóa các nơ-ron đã huấn luyện và tập dữ liệu đã được phân cụm.
Định nghĩa lưới SOM
Như đã giải thích, SOM là lưới các nơ-ron. Với MiniSom, ta có thể tạo lưới 2 chiều. Kích thước X và Y của lưới là số nơ-ron theo mỗi trục. Để định nghĩa lưới SOM, ta cũng cần chỉ định:
- Kích thước X và Y của lưới
- Số lượng biến đầu vào - tức số cột dữ liệu.
Khai báo các tham số này dưới dạng hằng số Python:
SOM_X_AXIS_NODES = 8
SOM_Y_AXIS_NODES = 8
SOM_N_VARIABLES = data.shape[1]Đoạn mã mẫu dưới đây minh họa cách khai báo lưới bằng MiniSom:
som = MiniSom(SOM_X_AXIS_NODES, SOM_Y_AXIS_NODES, SOM_N_VARIABLES)Hai tham số đầu là số nơ-ron theo trục X và Y, tham số thứ ba là số biến.
Chúng ta khai báo các tham số và siêu tham số khác khi tạo lưới SOM. Sẽ giải thích sau trong hướng dẫn. Hiện tại, khai báo như sau:
ALPHA = 0.5
DECAY_FUNC = 'linear_decay_to_zero'
SIGMA0 = 1.5
SIGMA_DECAY_FUNC = 'linear_decay_to_one'
NEIGHBORHOOD_FUNC = 'triangle'
DISTANCE_FUNC = 'euclidean'
TOPOLOGY = 'rectangular'
RANDOM_SEED = 123Tạo SOM bằng các tham số này:
som = MiniSom(
SOM_X_AXIS_NODES,
SOM_Y_AXIS_NODES,
SOM_N_VARIABLES,
sigma=SIGMA0,
learning_rate=ALPHA,
neighborhood_function=NEIGHBORHOOD_FUNC,
activation_distance=DISTANCE_FUNC,
topology=TOPOLOGY,
sigma_decay_function = SIGMA_DECAY_FUNC,
decay_function = DECAY_FUNC,
random_seed=RANDOM_SEED,
)Khởi tạo các nơ-ron
Lệnh trên tạo SOM với trọng số ngẫu nhiên cho tất cả nơ-ron. Khởi tạo trọng số từ dữ liệu (thay vì số ngẫu nhiên) có thể giúp huấn luyện hiệu quả hơn.
Khi dùng MiniSom để tạo Bản đồ Tự Tổ chức (SOM), có hai cách để khởi tạo trọng số nơ-ron dựa trên dữ liệu:
- Khởi tạo ngẫu nhiên: Trọng số ban đầu của nơ-ron được rút ngẫu nhiên từ dữ liệu đầu vào. Ta thực hiện bằng cách gọi hàm
.random_weights_init()trên SOM. - Khởi tạo bằng PCA: Principal Component Analysis (PCA) dùng các thành phần chính của dữ liệu đầu vào để khởi tạo trọng số. Trọng số ban đầu của nơ-ron trải trên hai thành phần chính đầu tiên. Cách này thường giúp hội tụ nhanh hơn.
Trong hướng dẫn này, chúng ta dùng khởi tạo PCA. Để áp dụng khởi tạo PCA cho trọng số SOM, dùng hàm .pca_weights_init() như sau:
som.pca_weights_init(data)Huấn luyện SOM
Quá trình huấn luyện cập nhật trọng số SOM để tối thiểu hóa khoảng cách giữa nơ-ron và các điểm dữ liệu.
Dưới đây, chúng tôi giải thích quy trình huấn luyện lặp:
- Khởi tạo: Các véc-tơ trọng số của tất cả nơ-ron được khởi tạo, thường là ngẫu nhiên. Cũng có thể khởi tạo bằng cách lấy mẫu từ phân phối dữ liệu đầu vào.
- Chọn đầu vào: Chọn (ngẫu nhiên) một véc-tơ đầu vào từ tập huấn luyện.
- Xác định BMU: Nơ-ron có véc-tơ trọng số gần véc-tơ đầu vào nhất được xác định là BMU.
- Cập nhật lân cận: BMU và các nơ-ron lân cận cập nhật véc-tơ trọng số. Tốc độ học và hàm lân cận quyết định nơ-ron nào được cập nhật và mức độ bao nhiêu. Ở bước lặp t, với véc-tơ đầu vào x, véc-tơ trọng số của nơ-ron i là wi, tốc độ học (t), và hàm lân cận hbi (hàm này lượng hóa mức cập nhật cho nơ-ron i với BMU b), công thức cập nhật trọng số cho nơ-ron i được biểu diễn:
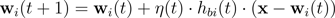
- Tốc độ suy giảm của tốc độ học và bán kính lân cận: Cả tốc độ học và bán kính lân cận đều giảm dần theo thời gian. Ở những vòng lặp đầu, quá trình huấn luyện điều chỉnh lớn hơn trên vùng lân cận rộng hơn. Các vòng sau tinh chỉnh trọng số bằng những thay đổi nhỏ ở các nơ-ron kề. Điều này giúp bản đồ ổn định và hội tụ.
Để huấn luyện SOM, ta đưa dữ liệu đầu vào cho mô hình. Có thể chọn một trong hai cách:
- Lấy mẫu ngẫu nhiên từ dữ liệu đầu vào. Hàm
.train_random()hiện thực kỹ thuật này. - Duyệt tuần tự qua các véc-tơ trong dữ liệu đầu vào. Dùng hàm
.train_batch()để thực hiện.
Các hàm này nhận dữ liệu đầu vào và số vòng lặp làm tham số. Trong hướng dẫn này, chúng ta dùng hàm .train_random() . Khai báo số vòng lặp là hằng số và truyền vào hàm huấn luyện:
N_ITERATIONS = 5000
som.train_random(data, N_ITERATIONS, verbose=True) Sau khi chạy script và hoàn tất huấn luyện, một thông báo với lỗi lượng tử hóa sẽ hiển thị:
quantization error: 0.05357240680504421 Lỗi lượng tử hóa cho biết mức độ mất mát thông tin khi SOM lượng tử hóa (giảm số chiều của) dữ liệu. Lỗi lớn cho thấy khoảng cách giữa nơ-ron và điểm dữ liệu lớn hơn. Điều đó cũng có nghĩa phân cụm kém tin cậy hơn.
Trực quan hóa các nơ-ron SOM
Giờ chúng ta có mô hình SOM đã huấn luyện. Để trực quan hóa, ta dùng bản đồ khoảng cách (còn gọi là U-matrix). Bản đồ khoảng cách hiển thị các nơ-ron SOM như một lưới ô. Màu của mỗi ô biểu thị khoảng cách của nó tới các nơ-ron lân cận.
Bản đồ khoảng cách có cùng kích thước với SOM. Mỗi ô là tổng đã chuẩn hóa của các khoảng cách (Euclid) giữa một nơ-ron và các nơ-ron lân cận.
Truy cập bản đồ khoảng cách SOM bằng hàm .distance_map(). Để tạo U-matrix, ta thực hiện:
- Dùng
pyplotđể tạo một figure có cùng kích thước với SOM. Ở ví dụ này là 8x8. - Vẽ bản đồ khoảng cách bằng matplotlib với hàm
.pcolor(). Ở ví dụ này, chúng ta dùnggist_yarglàm bảng màu. - Hiển thị
colorbar, bảng ánh xạ màu với giá trị vô hướng. Ở đây do khoảng cách đã chuẩn hóa, giá trị vô hướng trong khoảng 0 đến 1.
Mã dưới đây hiện thực các bước trên:
# create the grid
plt.figure(figsize=(8, 8))
#plot the distance map
plt.pcolor(som.distance_map().T, cmap='gist_yarg')
# show the color bar
plt.colorbar()
plt.show()Trong ví dụ này, U-matrix dùng bảng màu đơn sắc. Có thể hiểu theo các hướng dẫn sau:
- Sắc độ sáng hơn biểu thị các nơ-ron gần nhau, và sắc độ tối hơn biểu thị các nơ-ron cách xa hơn.
- Nhóm các sắc độ sáng có thể diễn giải là các cụm. Các nút tối giữa các cụm có thể diễn giải là ranh giới giữa các cụm.
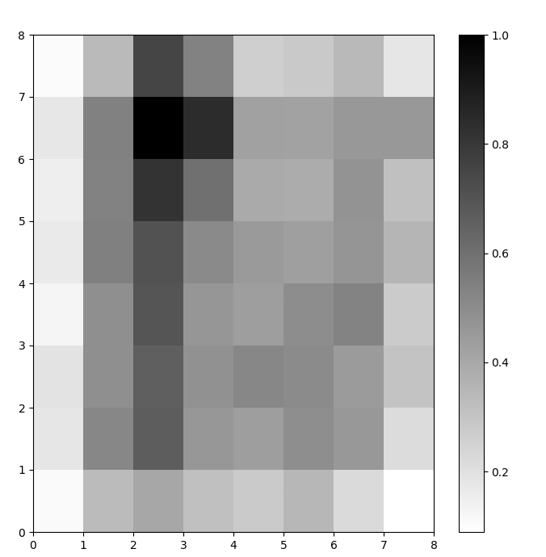
Hình 1: U-matrix của SOM được huấn luyện trên bộ dữ liệu Iris (hình do tác giả)
Đánh giá kết quả phân cụm của SOM
Hình trước minh họa các nơ-ron SOM. Ở phần này, chúng ta cho thấy cách trực quan hóa SOM đã phân cụm dữ liệu như thế nào.
Nhận diện các cụm
Chúng ta chồng ký hiệu lên U-matrix ở trên để biểu thị mỗi ô (nơ-ron) đại diện cho lớp hoa Iris nào. Để làm điều này:
- Như trước, tạo figure 8x8 bằng
pyplot, vẽ bản đồ khoảng cách và hiển thị color bar. - Chỉ định một mảng ba marker của matplotlib, mỗi marker cho một lớp hoa Iris.
- Chỉ định một mảng ba mã màu của matplotlib, mỗi màu cho một lớp hoa Iris.
- Lặp để vẽ nơ-ron chiến thắng cho mỗi điểm dữ liệu:
- Xác định (tọa độ của) nơ-ron chiến thắng cho mỗi điểm dữ liệu bằng hàm
.winner() . - Vẽ vị trí mỗi nơ-ron chiến thắng ở giữa mỗi ô trên lưới.
w[0]vàw[1]lần lượt cho tọa độ X và Y của nơ-ron. Cộng 0.5 vào mỗi tọa độ để vẽ ở giữa ô.
Mã dưới đây minh họa cách thực hiện:
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg')
plt.colorbar()
# create the markers and colors for each class
markers = ['o', 'x', '^']
colors = ['C0', 'C1', 'C2']
# plot the winning neuron for each data point
for count, datapoint in enumerate(data):
# get the winner
w = som.winner(datapoint)
# place a marker on the winning position for the sample data point
plt.plot(w[0]+.5, w[1]+.5, markers[target[count]-1], markerfacecolor='None',
markeredgecolor=colors[target[count]-1], markersize=12, markeredgewidth=2)
plt.show()Hình thu được như dưới đây:
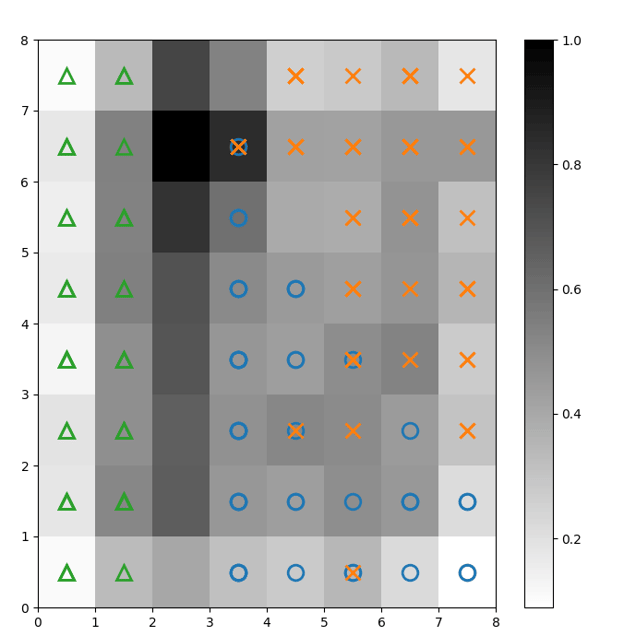
Hình 2: U-matrix được chồng ký hiệu lớp (hình do tác giả)
Dựa trên tài liệu bộ dữ liệu Iris, “một lớp tách tuyến tính khỏi hai lớp còn lại; hai lớp kia không tách tuyến tính khỏi nhau”. Trên U-matrix ở trên, ba lớp này được biểu diễn bằng ba ký hiệu - tam giác, hình tròn và dấu chéo.
Lưu ý rằng không có ranh giới rõ ràng giữa các vòng tròn xanh và dấu chéo cam. Hơn nữa, hai lớp bị chồng lên cùng một nơ-ron ở nhiều ô. Điều này nghĩa là nơ-ron cách đều hai lớp.
Trực quan hóa kết quả phân cụm
SOM là mô hình phân cụm. Các điểm dữ liệu tương tự ánh xạ tới cùng một nơ-ron. Các điểm cùng lớp ánh xạ thành một cụm nơ-ron lân cận. Chúng ta vẽ tất cả điểm dữ liệu lên lưới SOM để nghiên cứu hành vi phân cụm rõ hơn.
Các bước sau mô tả cách tạo biểu đồ phân tán này:
- Lấy tọa độ X và Y của nơ-ron chiến thắng cho mỗi điểm dữ liệu.
- Vẽ bản đồ khoảng cách như đã làm ở Hình 1.
- Dùng
plt.scatter()để vẽ biểu đồ phân tán của tất cả nơ-ron chiến thắng cho mỗi điểm dữ liệu. Thêm độ lệch ngẫu nhiên cho mỗi điểm để tránh chồng lấp trong cùng một ô.
Chúng tôi hiện thực các bước này trong đoạn mã dưới đây:
# get the X and Y coordinates of the winning neuron for each data pointw_x, w_y = zip(*[som.winner(d) for d in data])
w_x = np.array(w_x)
w_y = np.array(w_y)
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg', alpha=.2)
plt.colorbar()
# make a scatter plot of all the winning neurons for each data point
# add a random offset to each point to avoid overlaps
for c in np.unique(target):
idx_target = target==c
plt.scatter(w_x[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
w_y[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
s=50,
c=colors[c-1],
label=labels_iris[c+1]
)
plt.legend(loc='upper right')
plt.grid()
plt.show()Biểu đồ phân tán đầu ra như sau:
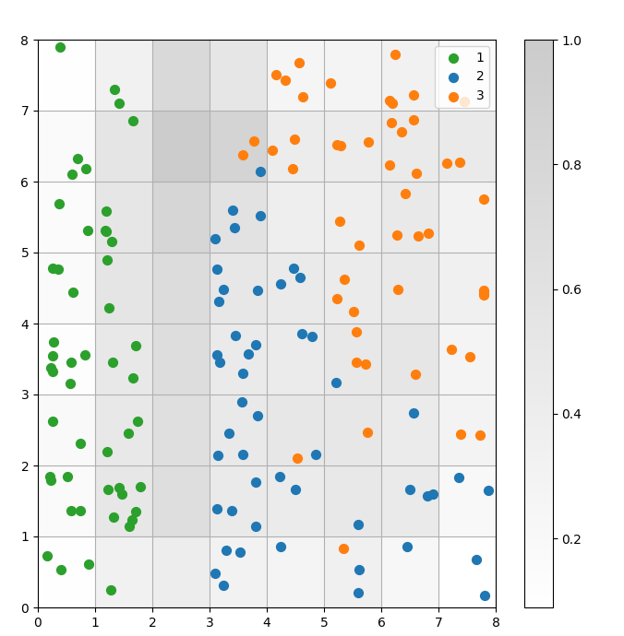 Hình 3: Biểu đồ phân tán các điểm dữ liệu trong các ô (hình do tác giả)
Trong biểu đồ trên, hãy quan sát rằng:
- Một số ô chứa cả chấm xanh và cam.
- Các chấm xanh lá tách biệt rõ ràng với phần còn lại, nhưng chấm xanh dương và cam không tách biệt rõ.
- Những quan sát trên phù hợp với thực tế rằng chỉ một trong ba cụm của bộ Iris có ranh giới rõ.
- Ở Hình 1, các nút tối giữa các cụm (có thể diễn giải là ranh giới giữa cụm) khớp với các ô trống trong biểu đồ phân tán.
Bạn có thể truy cập và chạy toàn bộ mã trên notebook DataLab này.
Tinh chỉnh mô hình SOM
Các phần trước đã cho thấy cách tạo và huấn luyện mô hình SOM cũng như cách nghiên cứu kết quả trực quan. Phần này bàn về cách tinh chỉnh hiệu năng mô hình SOM.
Các siêu tham số chính cần tinh chỉnh
Như mọi mô hình học máy, siêu tham số ảnh hưởng đáng kể đến hiệu năng mô hình.
Một số siêu tham số quan trọng khi huấn luyện SOM gồm:
- Kích thước lưới quyết định kích thước bản đồ. Số nơ-ron trong bản đồ kích thước AxB là A*B.
- Tốc độ học quyết định mức thay đổi trọng số ở mỗi vòng. Ta đặt tốc độ học ban đầu, và nó giảm theo thời gian theo hàm suy giảm.
- Hàm suy giảm quyết định mức giảm của tốc độ học ở mỗi vòng lặp tiếp theo.
- Hàm lân cận là hàm toán xác định những nơ-ron được coi là lân cận của BMU.
- Độ lệch chuẩn xác định độ rộng của hàm lân cận. Ví dụ, hàm Gaussian với độ lệch chuẩn lớn sẽ có vùng lân cận lớn hơn so với cùng hàm với độ lệch chuẩn nhỏ. Ta đặt độ lệch chuẩn ban đầu, và nó giảm theo thời gian theo hàm suy giảm sigma.
- Hàm suy giảm sigma điều khiển mức giảm của độ lệch chuẩn ở mỗi vòng tiếp theo.
- Số vòng huấn luyện quyết định số lần cập nhật trọng số. Mỗi vòng huấn luyện, trọng số nơ-ron được cập nhật một lần.
- Hàm khoảng cách là hàm toán tính khoảng cách giữa nơ-ron và điểm dữ liệu.
- Kiểu tôpô quyết định cách sắp xếp cấu trúc lưới. Các nơ-ron có thể sắp theo dạng hình chữ nhật hoặc lục giác.
Ở phần tiếp theo, chúng tôi đưa ra hướng dẫn đặt giá trị cho các siêu tham số này.
Ảnh hưởng của việc tinh chỉnh siêu tham số
Giá trị siêu tham số nên được quyết định dựa trên mô hình và tập dữ liệu. Ở mức độ nào đó, việc xác định các giá trị này là quá trình thử - sai. Trong phần này, chúng tôi đưa ra hướng dẫn tinh chỉnh từng siêu tham số. Bên cạnh mỗi siêu tham số, chúng tôi ghi (trong ngoặc) các hằng số Python tương ứng dùng trong mã mẫu.
- Kích thước lưới (
SOM_X_AXIS_NODESvàSOM_Y_AXIS_NODES): Kích thước lưới phụ thuộc vào kích thước tập dữ liệu. Quy tắc kinh nghiệm: với tập dữ liệu kích thước N, lưới nên có khoảng 5*sqrt(N) nơ-ron. Ví dụ, nếu bộ dữ liệu có 150 mẫu, lưới nên có 5*sqrt(150) ≈ 61 nơ-ron. Trong hướng dẫn này, bộ Iris có 150 hàng và chúng ta dùng lưới 8x8. - Tốc độ học ban đầu (
ALPHA): Tốc độ cao giúp hội tụ nhanh, còn tốc độ thấp dùng để tinh chỉnh sau các vòng đầu. Tốc độ ban đầu nên đủ lớn để thích ứng nhanh nhưng không quá lớn khiến vượt quá giá trị tối ưu. Trong bài này, tốc độ học ban đầu là 0.5. - Độ lệch chuẩn ban đầu (
SIGMA0): Xác định kích thước/độ rộng lân cận ban đầu. Giá trị lớn xem xét các mẫu tổng quát hơn. Ở ví dụ này, chúng ta dùng sigma khởi đầu 1.5. - Với tốc độ suy giảm (
DECAY_FUNC) và tốc độ suy giảm sigma (SIGMA_DECAY_FUNC), ta có thể chọn một trong ba loại hàm suy giảm: - Nghịch đảo: Phù hợp nếu dữ liệu có cả mẫu tổng quát và cục bộ. Khi đó cần giai đoạn học rộng kéo dài trước khi tập trung vào mẫu cục bộ.
- Tuyến tính: Thích hợp khi muốn giảm đều và ổn định kích thước lân cận hoặc tốc độ học. Hữu ích nếu dữ liệu không cần tinh chỉnh nhiều.
- Tiệm cận: Hữu ích nếu dữ liệu phức tạp và nhiều chiều. Khi đó nên dành nhiều thời gian cho khám phá tổng quát trước khi dần chuyển sang chi tiết tinh hơn.
- Hàm lân cận (
NEIGHBORHOOD_FUNC): Lựa chọn mặc định là Gaussian. Các hàm khác như dưới đây cũng được dùng. - Gaussian (mặc định): Đường cong hình chuông. Mức cập nhật giảm mượt mà khi khoảng cách tới nơ-ron thắng tăng. Cung cấp chuyển tiếp liên tục và bảo toàn tôpô dữ liệu. Phù hợp đa số mục đích nhờ hành vi ổn định, dễ dự đoán.
- Bubble: Tạo vùng lân cận bề rộng cố định. Tất cả nơ-ron trong vùng này được cập nhật như nhau, ngoài vùng thì không (cho một điểm dữ liệu). Tính toán rẻ và dễ triển khai. Hữu ích cho bản đồ nhỏ, nơi ranh giới sắc nét không ảnh hưởng đến phân cụm hiệu quả.
- Mexican hat: Có vùng trung tâm dương bao quanh bởi vùng âm. Nơ-ron gần BMU được cập nhật để tiến gần điểm dữ liệu, nơ-ron xa hơn được cập nhật để lùi ra. Kỹ thuật này tăng độ tương phản và làm sắc nét đặc trưng trên bản đồ. Do nhấn mạnh cụm phân biệt, nó hiệu quả trong nhận dạng mẫu khi cần tách bạch cụm rõ ràng.
- Triangle: Xác định kích thước lân cận dạng tam giác, BMU có ảnh hưởng lớn nhất. Ảnh hưởng giảm tuyến tính theo khoảng cách. Dùng để phân cụm dữ liệu có chuyển tiếp dần giữa các cụm/đặc trưng, như ảnh, tiếng nói, hoặc chuỗi thời gian, nơi các điểm lân cận dự kiến có đặc tính tương tự.
- Hàm khoảng cách (
DISTANCE_FUNC): Để đo khoảng cách giữa nơ-ron và điểm dữ liệu, ta có 4 phương pháp: - Khoảng cách Euclid (mặc định): Hữu ích khi dữ liệu liên tục và muốn đo khoảng cách đường thẳng. Phù hợp đa số tác vụ, nhất là khi điểm dữ liệu phân bố đều và có quan hệ không gian.
- Khoảng cách Cosine: Phù hợp cho văn bản hoặc dữ liệu thưa nhiều chiều, nơi góc giữa các véc-tơ quan trọng hơn độ lớn. Hữu ích để so sánh hướng của dữ liệu.
- Khoảng cách Manhattan: Lý tưởng khi điểm dữ liệu nằm trên lưới (ví dụ ô phố). Ít nhạy cảm với ngoại lệ hơn Euclid.
- Khoảng cách Chebyshev: Phù hợp tình huống có thể di chuyển theo bất kỳ hướng nào (ví dụ khoảng cách trên bàn cờ). Hữu ích cho không gian rời rạc khi muốn ưu tiên độ chênh trục lớn nhất.
- Tôpô (
TOPOLOGY): Trên lưới, nơ-ron có thể sắp theo cấu trúc lục giác hoặc chữ nhật: - Hình chữ nhật (mặc định): mỗi nơ-ron có 4 nơ-ron kề. Phù hợp khi dữ liệu không có quan hệ không gian rõ ràng. Tính toán cũng đơn giản hơn.
- Hình lục giác: mỗi nơ-ron có 6 nơ-ron kề. Ưu tiên nếu dữ liệu có quan hệ không gian được biểu diễn tốt hơn với lưới lục giác, như phân bố tròn hoặc góc.
- Số vòng huấn luyện (
N_ITERATIONS): Về nguyên tắc, thời gian huấn luyện lâu hơn dẫn tới lỗi thấp hơn và trọng số khớp dữ liệu tốt hơn. Tuy nhiên, hiệu năng tăng tiến tiệm cận theo số vòng. Do đó, sau một ngưỡng, lợi ích tăng thêm từ các vòng tiếp theo chỉ còn nhỏ. Quyết định số vòng phù hợp cần thử nghiệm. Trong hướng dẫn này, chúng ta huấn luyện 5000 vòng.
Để xác định cấu hình siêu tham số phù hợp, chúng tôi khuyến nghị thử nghiệm nhiều lựa chọn trên một tập con nhỏ của dữ liệu.
Kết luận
Bản đồ tự tổ chức là công cụ mạnh mẽ cho học không giám sát. Chúng được dùng cho phân cụm, giảm số chiều, phát hiện bất thường và trực quan hóa dữ liệu. Vì bảo toàn các thuộc tính tôpô của dữ liệu nhiều chiều và biểu diễn trên lưới có số chiều thấp, SOM giúp dễ dàng trực quan hóa và diễn giải các bộ dữ liệu phức tạp.
Hướng dẫn này đã bàn về nguyên lý nền tảng của SOM và chỉ ra cách triển khai SOM bằng thư viện Python MiniSom. Bài cũng minh họa cách phân tích kết quả trực quan và giải thích các siêu tham số quan trọng dùng để huấn luyện SOM và tinh chỉnh hiệu năng.
Câu hỏi thường gặp
Huấn luyện SOM có liên quan đến lan truyền ngược không?
SOM là một mạng nơ-ron nhân tạo, nhưng việc huấn luyện không dựa trên sửa lỗi. Do đó, nó không dùng lan truyền ngược với gradient descent. Thay vào đó, SOM được huấn luyện bằng học cạnh tranh.
Tại sao cần các hàm suy giảm?
Ở giai đoạn đầu huấn luyện, mô hình cần khám phá bức tranh tổng quát của dữ liệu. Vì vậy, tốc độ học cần cao và hàm lân cận cần phủ rộng. Các vòng huấn luyện sau đó tinh chỉnh trọng số dựa trên các nơ-ron kề. Khi huấn luyện tiến triển, các hàm suy giảm làm giảm tốc độ học và bán kính lân cận.
Sự khác nhau giữa khởi tạo mặc định (ngẫu nhiên) và khởi tạo ngẫu nhiên dựa trên dữ liệu đầu vào là gì?
Trong khởi tạo mặc định, trọng số được khởi tạo bằng các số ngẫu nhiên tùy ý.
Ở khởi tạo ngẫu nhiên dựa trên dữ liệu đầu vào, trọng số được khởi tạo từ các mẫu chọn ngẫu nhiên trong dữ liệu đầu vào.
SOM có thể nắm bắt các quan hệ phi tuyến trong dữ liệu không?
Có, SOM nắm bắt các mẫu phi tuyến trong dữ liệu bằng cách dùng các hàm lân cận khác nhau. Một điểm dữ liệu có thể ảnh hưởng đến giá trị của nhiều nơ-ron (trong vùng lân cận). Điều này cho phép SOM ghi nhận các quan hệ phức tạp trong dữ liệu.
Sự khác biệt giữa SOM và các phương pháp phân cụm truyền thống là gì?
SOM ánh xạ dữ liệu nhiều chiều lên một lưới có số chiều thấp, bảo toàn quan hệ không gian. Trong khi đó, các kỹ thuật phân cụm truyền thống như K-Means tạo nhóm dựa trên thước đo khoảng cách mà không nhất thiết xét đến tôpô hay quan hệ không gian của dữ liệu.
Lưu ý rằng trong phân tích dữ liệu, quan hệ tôpô hay không gian đề cập tới vị trí tương đối giữa các điểm dữ liệu trong không gian đa chiều.

Arun là cựu nhà sáng lập startup, yêu thích xây dựng những điều mới mẻ. Hiện tại, anh đang khám phá các nền tảng kỹ thuật và toán học của Trí tuệ Nhân tạo. Anh thích chia sẻ những gì mình học được, vì thế anh viết về chúng.
Bên cạnh DataCamp, bạn có thể đọc các bài viết của anh trên Medium, Airbyte và Vultr.


Bản đồ tự tổ chức (SOM) là một dạng mạng nơ-ron nhân tạo dùng cho các bài toán học không giám sát như phân cụm. Với một tập điểm dữ liệu, mô hình học cách chia dữ liệu thành các cụm. SOM chiếu dữ liệu đa chiều phức tạp lên một lưới có số chiều thấp hơn (thông thường là 2 chiều). Điều này giúp việc trực quan hóa dễ dàng hơn. Vì vậy, SOM cũng được dùng để trực quan hóa dữ liệu nhiều chiều.
Trong hướng dẫn này, chúng ta sẽ tìm hiểu các khái niệm cốt lõi của SOM, quá trình học và các trường hợp sử dụng điển hình. Chúng tôi giải thích cách triển khai SOM trong Python bằng thư viện MiniSom và cách biểu diễn kết quả trực quan. Cuối cùng, chúng tôi thảo luận về các siêu tham số quan trọng khi huấn luyện mô hình SOM và cách tinh chỉnh chúng.
Tìm hiểu Bản đồ Tự Tổ chức (SOM)
Trong phần này, chúng tôi trình bày các khái niệm cốt lõi của SOM, quy trình học và các trường hợp sử dụng.
Các khái niệm cốt lõi của SOM
Bản đồ tự tổ chức bao gồm một số khái niệm quan trọng cần nắm vững.
Nơ-ron
Về bản chất, SOM là một lưới các nơ-ron. Trong quá trình huấn luyện, nơ-ron có véc-tơ trọng số gần nhất với một điểm dữ liệu đầu vào sẽ điều chỉnh trọng số của nó và của các nơ-ron lân cận để khớp với điểm dữ liệu đầu vào hơn nữa. Qua nhiều vòng lặp, các nhóm nơ-ron lân cận sẽ ánh xạ tới các điểm dữ liệu có liên quan. Kết quả là dữ liệu đầu vào được phân cụm.
Cấu trúc lưới
Các nơ-ron trong SOM được tổ chức thành một lưới. Các nơ-ron lân cận ánh xạ tới các điểm dữ liệu tương tự. Bộ dữ liệu lớn cần lưới lớn hơn. Thông thường, lưới này là hai chiều. Cấu trúc lưới đóng vai trò là không gian có số chiều thấp để ánh xạ dữ liệu nhiều chiều. Lưới giúp trực quan hóa các mẫu và cụm dữ liệu.
Ánh xạ điểm dữ liệu
Mỗi điểm dữ liệu được so sánh với tất cả các nơ-ron bằng một thước đo khoảng cách. Nơ-ron có véc-tơ trọng số gần điểm dữ liệu đầu vào nhất là Đơn vị Khớp Tốt nhất (BMU) cho điểm dữ liệu đó.
Sau khi xác định BMU, trọng số của BMU và các nơ-ron lân cận của nó được cập nhật. Việc cập nhật này đưa BMU và các nơ-ron lân cận tiến gần hơn tới điểm dữ liệu đầu vào. Ánh xạ này bảo toàn tôpô của dữ liệu, đảm bảo các điểm dữ liệu tương tự được ánh xạ tới các nơ-ron gần nhau.
Quá trình học của SOM
Huấn luyện SOM được xem là không giám sát vì không dựa trên tập dữ liệu gán nhãn. Mục tiêu là điều chỉnh dần các véc-tơ trọng số của nơ-ron để các điểm dữ liệu tương tự được ánh xạ tới các nơ-ron gần nhau.
Học cạnh tranh
SOM sử dụng học cạnh tranh (thay vì gradient descent và lan truyền ngược). Các nơ-ron cạnh tranh để trở thành Đơn vị Khớp Tốt nhất (BMU) cho mỗi điểm dữ liệu đầu vào. Nơ-ron gần điểm dữ liệu nhất được xác định là BMU. BMU và các nơ-ron lân cận của nó được cập nhật để tiếp tục giảm khoảng cách tới điểm dữ liệu. Các nơ-ron lân cận ánh xạ tới các điểm liên quan. Điều này dẫn đến sự chuyên biệt giữa các nơ-ron và phân cụm các điểm dữ liệu đầu vào.
Hàm khoảng cách
SOM dùng hàm khoảng cách để đo khoảng cách giữa nơ-ron và điểm dữ liệu. Khoảng cách này dùng để xác định BMU của mỗi điểm. MiniSom cung cấp bốn hàm khoảng cách để lựa chọn:
Hàm lân cận
Sau khi xác định BMU của một điểm dữ liệu, BMU và các nơ-ron lân cận của nó được cập nhật theo hướng của điểm dữ liệu đó. Hàm lân cận đảm bảo SOM duy trì mối quan hệ tôpô của dữ liệu đầu vào. Hàm lân cận quyết định:
MiniSom có ba hàm lân cận:
Quy trình lặp
Quá trình học trong SOM diễn ra qua nhiều vòng lặp. Mỗi vòng lặp, SOM xử lý nhiều điểm dữ liệu đầu vào. Chúng tôi phác thảo quy trình học qua các bước sau:
Các bước này lặp lại qua nhiều vòng, đi qua nhiều điểm dữ liệu đầu vào. Trọng số dần được cập nhật để bản đồ tự tổ chức và nắm bắt cấu trúc dữ liệu.
Tốc độ học và bán kính lân cận thường giảm dần theo thời gian, cho phép SOM tinh chỉnh trọng số từ từ. Ở phần sau, chúng ta sẽ hiện thực các bước huấn luyện lặp bằng mã Python.
Các trường hợp sử dụng điển hình của SOM
Với kiến trúc độc đáo, SOM có nhiều ứng dụng điển hình trong học máy, phân tích và trực quan hóa.
Phân cụm
SOM dùng để nhóm dữ liệu nhiều chiều vào các cụm điểm tương tự. Điều này giúp xác định cấu trúc tiềm ẩn trong dữ liệu. Mỗi nơ-ron ánh xạ tới các điểm liên quan chặt chẽ và các điểm tương tự được ánh xạ tới cùng một nơ-ron hoặc nơ-ron lân cận, từ đó hình thành các cụm riêng biệt.
Ví dụ, trong marketing, SOM có thể nhóm khách hàng theo hành vi mua sắm. Điều này cho phép thương hiệu điều chỉnh chiến lược tiếp thị cho từng phân khúc khách hàng (cụm).
Giảm số chiều
SOM có thể ánh xạ dữ liệu nhiều chiều với nhiều đặc trưng lên một lưới có ít chiều hơn (thường là lưới 2 chiều). Vì ánh xạ này bảo toàn quan hệ giữa các điểm dữ liệu, số chiều giảm giúp dễ trực quan hóa các bộ dữ liệu phức tạp mà không mất nhiều thông tin.
Bên cạnh việc giúp trực quan hóa và phân tích, SOM còn có thể giảm số chiều dữ liệu trước khi áp dụng các thuật toán học máy khác. SOM cũng được dùng trong xử lý ảnh để giảm số đặc trưng bằng cách phân cụm các điểm ảnh hoặc vùng có đặc tính giống nhau, giúp nhận dạng và phân loại ảnh hiệu quả hơn.
Phát hiện bất thường
Trong quá trình huấn luyện, hầu hết các điểm dữ liệu được ánh xạ tới những nơ-ron cụ thể. Các điểm bất thường (không phù hợp rõ ràng với cụm nào) thường được ánh xạ tới các nơ-ron xa hoặc thưa. Những ngoại lệ này không phù hợp với các cụm đã học và được ánh xạ tới các nơ-ron cách xa BMU của điểm dữ liệu bình thường.
Ví dụ, ánh xạ các giao dịch tài chính lên lưới SOM cho phép chúng ta nhận diện các hoạt động bất thường (ngoại lệ) có thể chỉ ra hành vi gian lận.
Trực quan hóa dữ liệu
Trực quan hóa dữ liệu là một trong những trường hợp sử dụng phổ biến nhất của SOM. Dữ liệu nhiều chiều khó trực quan hóa. SOM giúp dễ dàng hơn bằng cách giảm số chiều của dữ liệu và chiếu lên lưới hai chiều. Điều này cũng giúp phát hiện các cụm trong dữ liệu và các điểm bất thường vốn khó tìm ra ở dữ liệu gốc.
Ví dụ, trực quan hóa dữ liệu giúp phân tích dữ liệu dân số nhiều chiều dễ dàng hơn. Ánh xạ dữ liệu lên lưới 2D sẽ giúp phát hiện điểm tương đồng và khác biệt giữa các nhóm dân số.
Sau khi thảo luận các khái niệm và trường hợp sử dụng cốt lõi của SOM, chúng tôi sẽ minh họa cách triển khai bằng gói Python MiniSom ở các phần sau.
Bạn có thể truy cập và chạy toàn bộ mã trên notebook DataLab này.