

De omgeving voor SOM opzetten
Voordat we de SOM bouwen, bereiden we de omgeving voor met de benodigde pakketten.
Python-bibliotheken installeren
We hebben deze pakketten nodig:
- MiniSom is een op NumPy gebaseerde Python-tool om SOM's te maken en te trainen.
- NumPy wordt gebruikt voor wiskundige functies zoals arrays splitsen, unieke waarden ophalen, enz.
matplotlibwordt gebruikt om allerlei grafieken en diagrammen te plotten voor visualisatie.- Het
datasets-pakket uitsklearnwordt gebruikt om datasets te importeren waarop we de SOM toepassen. - Het pakket
MinMaxScaleruitsklearnnormaliseert de dataset.
De volgende code importeert deze pakketten:
from minisom import MiniSom
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.preprocessing import MinMaxScalerDe dataset voorbereiden
In deze tutorial gebruiken we MiniSom om een SOM te bouwen en die vervolgens te trainen op de canonieke IRIS-dataset. Deze dataset bestaat uit 3 klassen van irissoorten. Elke klasse heeft 50 instanties. Voor de voorbereiding volgen we deze stappen:
- Importeer de Iris-dataset uit
sklearn, - Extraheer de datavectoren en de doelschattingen.
- Normaliseer de datavectoren. In deze tutorial gebruiken we de MinMaxScaler van scikit-learn.
- Declareer een set labels voor elk van de drie klassen irissen.
De volgende code implementeert deze stappen:
dataset_iris = datasets.load_iris()
data_iris = dataset_iris.data
target_iris = dataset_iris.target
data_iris_normalized = MinMaxScaler().fit_transform(data_iris)
labels_iris = {1:'1', 2:'2', 3:'3'}
data = data_iris_normalized
target = target_irisSelf-Organizing Maps (SOM) implementeren in Python
Om een SOM in Python te implementeren, definiëren en initialiseren we het raster voordat we het op de dataset trainen. Daarna kunnen we de getrainde neuronen en de geclusterde dataset visualiseren.
Het SOM-raster definiëren
Zoals eerder uitgelegd is een SOM een raster van neuronen. Met MiniSom kunnen we 2D-rasters maken. De X- en Y-dimensies van het raster zijn het aantal neuronen langs elke as. Om het SOM-raster te definiëren, moeten we ook opgeven:
- De X- en Y-dimensies van het raster
- Het aantal inputvariabelen – dit is het aantal datarijen.
Declareer deze parameters als Python-constants:
SOM_X_AXIS_NODES = 8
SOM_Y_AXIS_NODES = 8
SOM_N_VARIABLES = data.shape[1]Onderstaande voorbeeldcode laat zien hoe je het raster met MiniSom declareert:
som = MiniSom(SOM_X_AXIS_NODES, SOM_Y_AXIS_NODES, SOM_N_VARIABLES)De eerste twee parameters zijn het aantal neuronen langs de X- en Y-as, en de derde parameter is het aantal variabelen.
We declareren andere parameters en hyperparameters bij het aanmaken van het SOM-raster. Die lichten we later in de tutorial toe. Declareer ze nu als volgt:
ALPHA = 0.5
DECAY_FUNC = 'linear_decay_to_zero'
SIGMA0 = 1.5
SIGMA_DECAY_FUNC = 'linear_decay_to_one'
NEIGHBORHOOD_FUNC = 'triangle'
DISTANCE_FUNC = 'euclidean'
TOPOLOGY = 'rectangular'
RANDOM_SEED = 123Maak een SOM met deze parameters:
som = MiniSom(
SOM_X_AXIS_NODES,
SOM_Y_AXIS_NODES,
SOM_N_VARIABLES,
sigma=SIGMA0,
learning_rate=ALPHA,
neighborhood_function=NEIGHBORHOOD_FUNC,
activation_distance=DISTANCE_FUNC,
topology=TOPOLOGY,
sigma_decay_function = SIGMA_DECAY_FUNC,
decay_function = DECAY_FUNC,
random_seed=RANDOM_SEED,
)De neuronen initialiseren
Bovenstaand commando maakt een SOM met willekeurige gewichten voor alle neuronen. Initialiseren met uit de data getrokken gewichten (in plaats van willekeurige getallen) kan het trainingsproces efficiënter maken.
Bij het gebruik van MiniSom om een Self-Organizing Map (SOM) te maken, zijn er twee manieren om de gewichten van neuronen op basis van de data te initialiseren:
- Willekeurige initialisatie: de initiële gewichten van de neuronen worden willekeurig getrokken uit de inputdata. Dit doen we door de functie
.random_weights_init()op de SOM toe te passen. - PCA-initialisatie: Principal Component Analysis (PCA)-initialisatie gebruikt de hoofcomponenten van de inputdata om de gewichten te initialiseren. De begingewichten van de neuronen beslaan de eerste twee hoofcomponenten. Dit leidt vaak tot snellere convergentie.
In deze gids gebruiken we PCA-initialisatie. Om PCA-initialisatie op de SOM-gewichten toe te passen, gebruik je de functie .pca_weights_init() zoals hieronder:
som.pca_weights_init(data)De SOM trainen
Het trainingsproces werkt de SOM-gewichten bij om de afstand tussen neuronen en datapunten te minimaliseren.
Hieronder lichten we het iteratieve trainingsproces toe:
- Initialisatie: de gewichtsvectoren van alle neuronen worden geïnitialiseerd, meestal met willekeurige waarden. Het is ook mogelijk om de gewichten te initialiseren door te sampelen uit de distributie van de inputdata.
- Inputselectie: een inputvector wordt (willekeurig) gekozen uit de trainingsdataset.
- BMU-bepaling: het neuron met de gewichtsvector die het dichtst bij de inputvector ligt, wordt geïdentificeerd als de BMU.
- Buurtupdate: de BMU en zijn naburige neuronen werken hun gewichtsvectoren bij. De learning rate en de buurtfunctie bepalen welke neuronen worden bijgewerkt en met welke sterkte. Bij iteratiestap t, gegeven de inputvector x, de gewichtsvector van neuron i als wi, de learning rate (t) en de buurtfunctie hbi (deze functie kwantificeert de mate van update voor neuron i gegeven de BMU b), wordt de gewichtsupdate voor neuron i gegeven door:
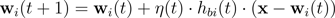
- Afname van learning rate en buurtradius: zowel de learning rate als de buurtradius nemen in de tijd af. In de vroege iteraties worden grotere aanpassingen gedaan over een grotere buurt. Latere iteraties verfijnen de gewichten met kleinere aanpassingen van naburige neuronen. Dit laat de map stabiliseren en convergeren.
Om de SOM te trainen, bieden we het model de inputdata aan. We kunnen hiervoor kiezen uit twee benaderingen:
- Kies willekeurig samples uit de inputdata. De functie
.train_random()implementeert deze techniek. - Doorloop de vectoren in de inputdata sequentieel. Dit gebeurt met de functie
.train_batch().
Deze functies accepteren de inputdata en het aantal iteraties als parameters. In deze gids gebruiken we de functie .train_random() . Declareer het aantal iteraties als constante en geef het door aan de trainingsfunctie:
N_ITERATIONS = 5000
som.train_random(data, N_ITERATIONS, verbose=True) Na het uitvoeren van het script en het voltooien van de training wordt een bericht met de kwantisatiefout weergegeven:
quantization error: 0.05357240680504421 De kwantisatiefout geeft aan hoeveel informatie verloren gaat wanneer de SOM de data kwantiseert (de dimensionaliteit reduceert). Een grote kwantisatiefout duidt op een grotere afstand tussen neuronen en datapunten. Dat betekent ook dat de clustering minder betrouwbaar is.
SOM-neuronen visualiseren
We hebben nu een getraind SOM-model. Voor de visualisatie gebruiken we een afstandskaart (ook wel een U-matrix genoemd). De afstandskaart toont de neuronen van de SOM als een raster van cellen. De kleur van elke cel geeft de afstand tot de naburige neuronen weer.
De afstandskaart is een raster met dezelfde afmetingen als de SOM. Elke cel in de afstandskaart is de genormaliseerde som van de (Euclidische) afstanden tussen een neuron en zijn buren.
Benader de SOM distance map met de functie .distance_map(). Om de U-matrix te genereren, volgen we deze stappen:
- Gebruik
pyplotom een figuur te maken met dezelfde afmetingen als de SOM. In dit voorbeeld zijn de afmetingen 8x8. - Plot de afstandskaart met matplotlib via de functie
.pcolor(). In dit voorbeeld gebruiken wegist_yargals kleurenschema. - Toon de
colorbar, een index die verschillende kleuren aan verschillende scalairen koppelt. In dit geval, omdat de afstanden genormaliseerd zijn, lopen de scalaire afstandswaarden van 0 tot 1.
De onderstaande code voert deze stappen uit:
# create the grid
plt.figure(figsize=(8, 8))
#plot the distance map
plt.pcolor(som.distance_map().T, cmap='gist_yarg')
# show the color bar
plt.colorbar()
plt.show()In dit voorbeeld gebruikt de U-matrix een monotoon kleurenschema. Je kunt deze als volgt interpreteren:
- Lichtere tinten duiden op dicht bij elkaar liggende neuronen, en donkerdere tinten op neuronen die verder van anderen liggen.
- Groepen lichte tinten kunnen worden geïnterpreteerd als clusters. Donkere knopen tussen de clusters kunnen worden gezien als grenzen tussen clusters.
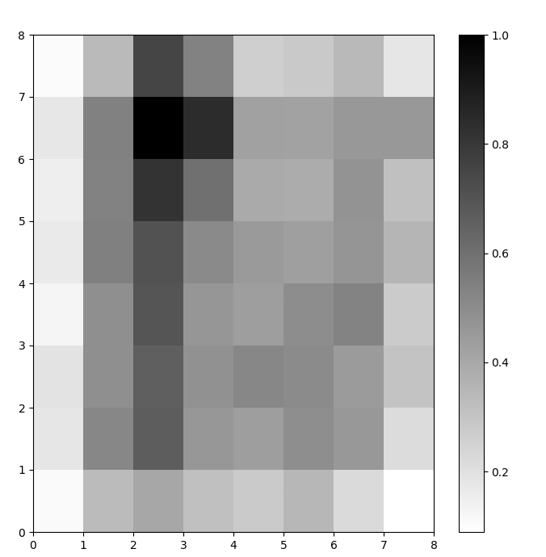
Figuur 1: U-matrix van een SOM getraind op de Iris-dataset (afbeelding door auteur)
De SOM-clusteringresultaten evalueren
De vorige figuur illustreerde de neuronen van de SOM. In deze sectie laten we zien hoe je visualiseert hoe de SOM de data heeft geclusterd.
Clusters identificeren
We leggen markeringen over de bovenstaande U-matrix om aan te geven welke klasse irisplant elke cel (neuron) vertegenwoordigt. Hiervoor:
- Maak, zoals eerder, een 8x8-figuur met
pyplot, plot de afstandskaart en toon de colorbar. - Specificeer een array van drie matplotlib-markers, één voor elke klasse iris.
- Specificeer een array van drie matplotlib-kleuren, één voor elke klasse iris.
- Plot iteratief het winnende neuron voor elk datapunt:
- Bepaal de (coördinaten van het) winnende neuron voor elk datapunt met de functie
.winner(). - Plot de positie van elk winnend neuron in het midden van elke cel op het raster.
w[0]enw[1]geven respectievelijk de X- en Y-coördinaten van het neuron. Er wordt 0,5 bij elke coördinaat opgeteld om het midden van de cel te markeren.
De onderstaande code laat zien hoe je dit doet:
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg')
plt.colorbar()
# create the markers and colors for each class
markers = ['o', 'x', '^']
colors = ['C0', 'C1', 'C2']
# plot the winning neuron for each data point
for count, datapoint in enumerate(data):
# get the winner
w = som.winner(datapoint)
# place a marker on the winning position for the sample data point
plt.plot(w[0]+.5, w[1]+.5, markers[target[count]-1], markerfacecolor='None',
markeredgecolor=colors[target[count]-1], markersize=12, markeredgewidth=2)
plt.show()Het resulterende beeld zie je hieronder:
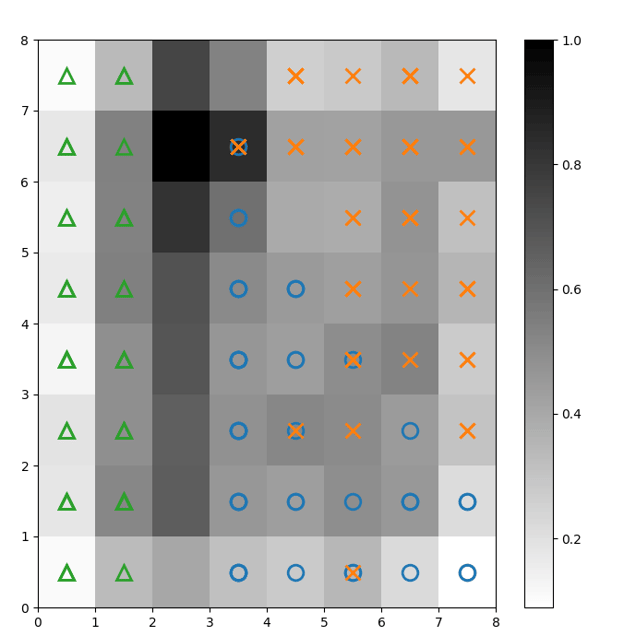
Figuur 2: U-matrix met klassemarkeringen (afbeelding door auteur)
Op basis van de documentatie van de Iris-dataset geldt: “één klasse is lineair te scheiden van de andere twee; de laatste twee zijn onderling niet lineair te scheiden”. In de bovenstaande U-matrix worden deze drie klassen weergegeven door drie markeringen – driehoek, cirkel en kruis.
Let op dat er geen duidelijke grens is tussen de blauwe cirkels en de oranje kruisen. Bovendien liggen in veel cellen twee klassen over hetzelfde neuron heen. Dit betekent dat het neuron even ver van beide klassen ligt.
De clusteringuitkomst visualiseren
Een SOM is een clusteringmodel. Vergelijkbare datapunten worden op hetzelfde neuron geprojecteerd. Datapunten van dezelfde klasse mappen naar een cluster van naburige neuronen. We plotten alle datapunten op het SOM-raster om het clusteringsgedrag beter te bestuderen.
De volgende stappen beschrijven hoe je deze scatterplot maakt:
- Haal de X- en Y-coördinaten op van het winnende neuron voor elk datapunt.
- Plot de afstandskaart, zoals we deden voor Figuur 1.
- Gebruik
plt.scatter()om een scatterplot te maken van alle winnende neuronen voor elk datapunt. Voeg een willekeurige offset toe om overlap binnen dezelfde cel te voorkomen.
We implementeren deze stappen in de onderstaande code:
# get the X and Y coordinates of the winning neuron for each data pointw_x, w_y = zip(*[som.winner(d) for d in data])
w_x = np.array(w_x)
w_y = np.array(w_y)
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg', alpha=.2)
plt.colorbar()
# make a scatter plot of all the winning neurons for each data point
# add a random offset to each point to avoid overlaps
for c in np.unique(target):
idx_target = target==c
plt.scatter(w_x[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
w_y[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
s=50,
c=colors[c-1],
label=labels_iris[c+1]
)
plt.legend(loc='upper right')
plt.grid()
plt.show()De volgende grafiek toont de resulterende scatterplot:
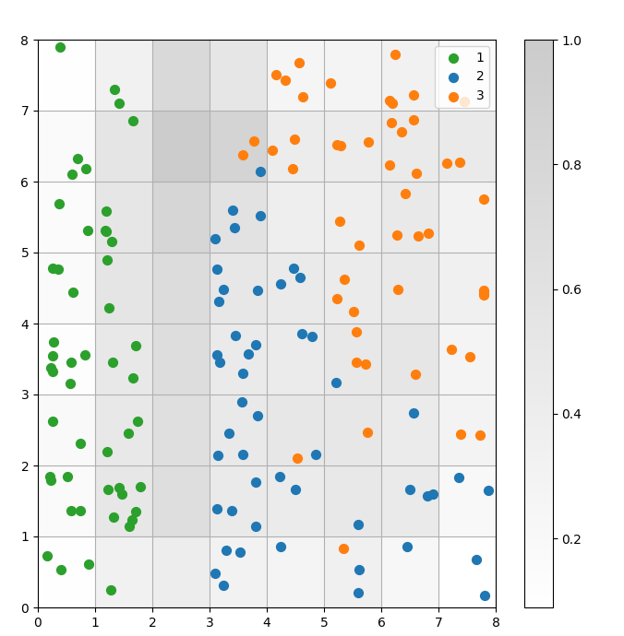 Figuur 3: Scatterplot van datapunten binnen cellen (afbeelding door auteur)
In de bovenstaande scatterplot zie je dat:
- Sommige cellen zowel blauwe als oranje stippen bevatten.
- De groene stippen duidelijk gescheiden zijn van de rest, maar de blauwe en oranje niet schoon gescheiden zijn.
- Deze observaties stroken met het feit dat slechts één van de drie clusters in de Iris-dataset een duidelijke grens heeft.
- In Figuur 1 komen donkere knopen tussen de clusters (die als clustergrenzen kunnen worden geïnterpreteerd) overeen met lege cellen in de scatterplot.
Je kunt de complete code bekijken en uitvoeren in deze DataLab-notebook.
De SOM afstemmen
De vorige secties lieten zien hoe je een SOM-model maakt en traint en hoe je de resultaten visueel bestudeert. In deze sectie bespreken we hoe je de prestaties van SOM-modellen afstemt.
Belangrijke hyperparameters om te tunen
Zoals bij elk machinelearningmodel hebben hyperparameters veel invloed op de prestaties.
Enkele belangrijke hyperparameters bij het trainen van SOM's zijn:
- De rastergrootte bepaalt de grootte van de map. Het aantal neuronen in een raster van AxB is A*B.
- De learning rate bepaalt hoeveel de gewichten in elke iteratie veranderen. We stellen de initiële learning rate in, en die neemt in de tijd af volgens de decay-functie.
- De decay-functie bepaalt in welke mate de learning rate in opeenvolgende iteraties afneemt.
- De buurtfunctie is een wiskundige functie die specificeert welke neuronen als buren van de BMU worden beschouwd.
- De standaarddeviatie specificeert de spreiding van de buurtfunctie. Bijvoorbeeld, een Gaussische buurtfunctie met een hoge standaarddeviatie heeft een grotere buurt dan dezelfde functie met een kleinere standaarddeviatie. We stellen de initiële standaarddeviatie in, die in de tijd afneemt volgens de sigma-decayfunctie.
- De sigma-decay-functie bepaalt hoeveel de standaarddeviatie in opeenvolgende iteraties wordt verlaagd.
- Het aantal trainingsiteraties bepaalt hoe vaak de gewichten worden bijgewerkt. In elke trainingsiteratie worden de neurongewichten één keer geüpdatet.
- De afstandsfunctie is een wiskundige functie die de afstand tussen neuronen en datapunten berekent.
- De topologie bepaalt de lay-out van de rasterstructuur. De neuronen kunnen in een rechthoekig of zeshoekig patroon worden gerangschikt.
In de volgende sectie bespreken we richtlijnen voor het instellen van de waarden van deze hyperparameters.
Impact van hyperparametertuning
Hyperparametervaarden moeten worden bepaald op basis van het model en de dataset. Tot op zekere hoogte is dit een proces van trial-and-error. In deze sectie geven we richtlijnen voor het afstemmen van elke hyperparameter. Achter elke hyperparameter vermelden we (tussen haakjes) de bijbehorende Python-constants in de voorbeeldcode.
- Rastergrootte (
SOM_X_AXIS_NODESenSOM_Y_AXIS_NODES): de rastergrootte hangt af van de omvang van de dataset. De vuistregel is dat bij een dataset van grootte N, het raster ongeveer 5*sqrt(N) neuronen moet bevatten. Bijvoorbeeld, als de dataset 150 samples heeft, zou het raster 5*sqrt(150) = circa 61 neuronen moeten hebben. In deze tutorial heeft de Iris-dataset 150 rijen en gebruiken we een 8x8-raster. - Initiële learning rate (
ALPHA): een hogere rate versnelt de convergentie, terwijl lagere rates worden gebruikt voor fijnere aanpassingen na vroege iteraties. De initiële learning rate moet groot genoeg zijn voor snelle adaptatie maar niet zo groot dat optimale gewichtswaarden worden overschoten. In dit artikel is de initiële learning rate 0,5. - Initiële standaarddeviatie (
SIGMA0): bepaalt de initiële grootte of spreiding van de buurt. Een grotere waarde houdt meer globale patronen in beeld. In dit voorbeeld gebruiken we een startwaarde van 1,5. - Voor de decay rate (
DECAY_FUNC) en de sigma-decayrate (SIGMA_DECAY_FUNC) kunnen we kiezen uit drie typen decay-functies: - Inverse decay: geschikt als de data zowel globale als lokale patronen heeft. Dan is een langere fase van brede verkenning nodig vóór de focus op lokale patronen.
- Lineaire decay: goed voor datasets waar we een gestage en uniforme verkleining van buurtgrootte of learning rate willen. Dit is nuttig als de data niet veel fijnslijpen vereist.
- Asymptotische decay: nuttig bij complexe, hoog-dimensionale data. Dan is het beter om langer te besteden aan globale exploratie en geleidelijk over te gaan naar fijnere details.
- Buurtfunctie (
NEIGHBORHOOD_FUNC): de standaardkeuze is de Gaussische functie. Andere functies, zoals hieronder uitgelegd, worden ook gebruikt. - Gaussisch (standaard): dit is een klokvormige curve. De mate waarin een neuron wordt geüpdatet neemt geleidelijk af naarmate de afstand tot het winnende neuron toeneemt. Het biedt een vloeiende overgang en behoudt de topologie van de data. Geschikt voor de meeste doeleinden door stabiel en voorspelbaar gedrag.
- Bubble: creëert een buurt met vaste breedte. Alle neuronen binnen deze buurt worden evenveel geüpdatet; neuronen daarbuiten niet (voor een gegeven datapunt). Het is rekenkundig goedkoper en eenvoudiger te implementeren. Nuttig voor kleinere mappen waar scherpe buurtgrenzen de clustering niet verstoren.
- Mexican hat: heeft een centrale positieve regio omringd door een negatieve regio. Neuronen dicht bij de BMU bewegen naar het datapunt toe; verder gelegen neuronen bewegen ervan weg. Dit vergroot het contrast en verscherpt de kenmerken in de map. Omdat het duidelijke clusters benadrukt, is het effectief bij patroonherkenning waar duidelijke scheiding gewenst is.
- Triangle: definieert de buurtgrootte als een driehoek, met de BMU met de grootste invloed. De invloed neemt lineair af met de afstand tot de BMU. Wordt gebruikt voor data met geleidelijke overgangen tussen clusters of features, zoals beeld-, spraak- of tijdreeksdata, waar naburige punten vergelijkbare kenmerken delen.
- Afstandsfunctie (
DISTANCE_FUNC): om de afstand tussen neuronen en datapunten te meten, kunnen we kiezen uit 4 methoden: - Euclidische afstand (standaardkeuze): nuttig bij continue data en wanneer we de rechte-lijn afstand willen meten. Geschikt voor de meeste taken, vooral bij gelijkmatig verdeelde en ruimtelijk gerelateerde data.
- Cosinusafstand: goede keuze voor tekst of hoog-dimensionale, sparse data waarbij de hoek tussen vectoren belangrijker is dan de grootte. Nuttig om richting in data te vergelijken.
- Manhattan-afstand: ideaal wanneer datapunten op een raster of rooster liggen (bijv. stadsblokken). Minder gevoelig voor uitschieters dan Euclidische afstand.
- Chebyshev-afstand: geschikt wanneer beweging in elke richting kan plaatsvinden (bijv. schaakbordafstanden). Nuttig voor discrete ruimtes waar we het maximale assenverschil willen prioriteren.
- Topologie (
TOPOLOGY): in een raster kunnen neuronen in een zeshoekige of rechthoekige structuur worden gerangschikt: - Rechthoekig (standaard): elk neuron heeft 4 directe buren. Dit is de juiste keuze wanneer de data geen duidelijke ruimtelijke relatie heeft. Ook rekenkundig eenvoudiger.
- Zeshoekig: elk neuron heeft 6 buren. Dit is de voorkeur als de data ruimtelijke relaties heeft die beter met een zeshoekig raster worden weergegeven, zoals circulaire of angulaire verdelingen.
- Aantal trainingsiteraties (
N_ITERATIONS): in principe leiden langere trainingstijden tot lagere fouten en een betere afstemming van de gewichten op de inputdata. De prestatie neemt echter asymptotisch toe met het aantal iteraties. Na een bepaald aantal iteraties is de winst marginaal. Het juiste aantal iteraties bepalen vergt experimenteren. In deze tutorial trainen we 5000 iteraties.
Om de juiste hyperparameterconfiguratie te bepalen, raden we aan om met verschillende opties te experimenteren op een kleinere subset van de data.
Conclusie
Self-organizing maps zijn een krachtig hulpmiddel voor unsupervised learning. Ze worden gebruikt voor clustering, dimensiereductie, anomaliedetectie en datavisualisatie. Omdat ze de topologische eigenschappen van hoog-dimensionale data behouden en deze op een lager-dimensionaal raster weergeven, maken SOM's het eenvoudig om complexe datasets te visualiseren en te interpreteren.
Deze tutorial besprak de onderliggende principes van SOM's en liet zien hoe je een SOM implementeert met de MiniSom Python-bibliotheek. We demonstreerden ook hoe je de resultaten visueel analyseert en legden de belangrijke hyperparameters uit die worden gebruikt om SOM's te trainen en hun prestaties te finetunen.
FAQs
Omvat SOM-training backpropagation?
Een SOM is een kunstmatig neuraal netwerk, maar de training is niet gebaseerd op foutcorrectie. Het gebruikt dus geen backpropagation met gradient descent. In plaats daarvan worden SOM's getraind met competitief leren.
Wat is het nut van de decay-functies?
Vroeg in het trainingsproces moet het model het globale landschap van de data verkennen. Daarom moet de learning rate hoog zijn en de buurtfunctie breed gespreid. Latere iteraties maken fijnere aanpassingen aan de gewichten op basis van aangrenzende neuronen. Naarmate de training vordert, verlagen de decay-functies de learning rate en de buurtradius.
Wat is het verschil tussen de standaard (willekeurige) initialisatie en willekeurige initialisatie op basis van de inputdata?
Bij de standaardinitialisatie worden de gewichten ingesteld op willekeurige getallen.
Bij willekeurige initialisatie op basis van de inputdata worden de gewichten ingesteld op willekeurig gekozen samples uit de inputdata.
Kunnen SOM's niet-lineaire relaties in de data vastleggen?
Ja, SOM's leggen niet-lineaire patronen in de data vast door verschillende buurtfuncties te gebruiken. Eén enkel datapunt kan de waarden van veel neuronen (in de buurt) beïnvloeden. Dit stelt SOM's in staat om complexe relaties in de data te vangen.
Wat is het verschil tussen SOM en traditionele clusteringmethoden?
SOM's mappen hoog-dimensionale data naar een lager-dimensionaal raster en behouden ruimtelijke relaties. Traditionele clusteringstechnieken zoals K-Means maken groepen op basis van afstandsmaatstaven zonder noodzakelijkerwijs rekening te houden met datatopologie of ruimtelijke relaties.
Merk op dat in data-analyse topologische of ruimtelijke relaties verwijzen naar hoe datapunten zich ten opzichte van elkaar positioneren in een multidimensionale ruimte.



Self-organizing maps (SOM's) zijn een type kunstmatig neuraal netwerk voor unsupervised learning-taken zoals clustering. Gegeven een set datapunten leert het model de data in clusters te verdelen. SOM's projecteren complexe multidimensionale data op een lager-dimensionaal (meestal 2-dimensionaal) raster. Dit maakt visualisatie eenvoudiger. Daarom worden SOM's ook gebruikt om hoog-dimensionale data te visualiseren.
In deze tutorial verkennen we de kernconcepten van SOM's, hun leerproces en typische use-cases. We laten zien hoe je een SOM in Python implementeert met de MiniSom-bibliotheek en hoe je de resultaten visueel weergeeft. Tot slot bespreken we belangrijke hyperparameters bij het trainen van SOM-modellen en hoe je deze fijnstemt.
Self-Organizing Maps (SOM) begrijpen
In deze sectie behandelen we de kernconcepten van SOM's, hun leerproces en hun toepassingen.
Kernconcepten van SOM's
Self-organizing maps omvatten een aantal concepten die belangrijk zijn om te begrijpen.
Neuronen
Een SOM is in essentie een raster van neuronen. Tijdens het trainen past het neuron waarvan de gewichtsvector het dichtst bij een inputdatapunt ligt zijn gewichten en die van zijn buren aan, zodat ze nog beter bij het datapunt passen. Over vele iteraties gaan groepen naburige neuronen corresponderen met verwante datapunten. Dit resulteert in clustering van de inputdataset.
Rasterstructuur
De neuronen in een SOM zijn georganiseerd als een raster. Naburige neuronen corresponderen met vergelijkbare datapunten. Grotere datasets vragen om een groter raster. Meestal is dit raster tweedimensionaal. De rasterstructuur fungeert als de laag-dimensionale ruimte waarop hoog-dimensionale data wordt geprojecteerd. Het raster helpt om patronen en clusters te visualiseren.
Datapunten mappen
Elk datapunt wordt vergeleken met alle neuronen via een afstandsmaat. Het neuron waarvan de gewichtsvector het dichtst bij het inputdatapunt ligt, is de Best Matching Unit (BMU) voor dat datapunt.
Zodra de BMU is bepaald, worden de gewichten van de BMU en zijn naburige neuronen bijgewerkt. Deze update brengt de BMU en de buren nog dichter bij het inputdatapunt. Deze mapping behoudt de topologie van de data, zodat vergelijkbare datapunten op nabijgelegen neuronen worden geprojecteerd.
Leerproces van SOM's
SOM-training wordt beschouwd als unsupervised omdat het niet gebaseerd is op gelabelde datasets. Het doel is om de gewichtsvectoren van neuronen iteratief aan te passen zodat vergelijkbare datapunten aan nabijgelegen neuronen worden toegewezen.
Competitief leren
SOM's gebruiken competitief leren (in plaats van gradient descent en backpropagation). Neuronen strijden om de Best Matching Unit (BMU) te worden voor elk inputdatapunt. Het neuron dat het dichtst bij een datapunt ligt, wordt de BMU. De BMU en zijn buren worden geüpdatet om hun afstand tot het datapunt verder te verkleinen. Naburige neuronen corresponderen met verwante datapunten. Dit leidt tot specialisatie onder neuronen en clustering van de inputdatapunten.
Afstandsfuncties
SOM's gebruiken een afstandsfunctie om de afstand tussen neuronen en datapunten te meten. Deze afstand bepaalt de BMU van elk datapunt. MiniSom biedt vier afstandsfuncties:
Buurtfunctie
Nadat de BMU van een datapunt is bepaald, worden de BMU en zijn naburige neuronen in de richting van dat datapunt geüpdatet. De buurtfunctie zorgt ervoor dat de SOM de topologische relaties van de inputdata behoudt. De buurtfunctie bepaalt:
MiniSom heeft drie buurtfuncties:
Iteratief proces
Het leerproces in SOM's verloopt over meerdere iteraties. In elke iteratie verwerkt de SOM veel inputdatapunten. We schetsen het leerproces in de volgende stappen:
Deze stappen worden vele iteraties herhaald over veel inputdatapunten. De gewichten worden geleidelijk geüpdatet zodat de map zichzelf organiseert en de datastructuur vastlegt.
De learning rate en de buurtradius nemen doorgaans in de tijd af, zodat de SOM de gewichten geleidelijk kan verfijnen. Later in de tutorial implementeren we de stappen van het iteratieve trainingsproces met Python-code.
Typische use-cases van SOM's
Gezien hun unieke architectuur hebben SOM's verschillende typische toepassingen in machine learning, analyse en visualisatie.
Clustering
SOM's worden gebruikt om hoog-dimensionale data te groeperen in clusters van vergelijkbare datapunten. Dit helpt om inherente structuren in de data te identificeren. Elk neuron correspondeert met nauw verwante datapunten en vergelijkbare datapunten worden op hetzelfde of naburige neuronen geprojecteerd, waardoor duidelijke clusters ontstaan.
In marketing kunnen SOM's bijvoorbeeld klanten groeperen op basis van koopgedrag. Zo kan een merk marketingstrategieën afstemmen op verschillende klantsegmenten (clusters).
Dimensiereductie
SOM's kunnen hoog-dimensionale data met veel featurevectoren mappen naar een raster met minder dimensies (meestal een 2D-raster). Omdat deze mapping de relaties tussen datapunten behoudt, maakt de gereduceerde dimensionaliteit het eenvoudiger om complexe datasets te visualiseren zonder noemenswaardig informatieverlies.
Naast het vereenvoudigen van visualisatie- en analysetaken kunnen SOM's ook de dimensionaliteit van data reduceren vóórdat andere machinelearningalgoritmen worden toegepast. SOM's worden ook in beeldverwerking gebruikt om het aantal features te verminderen door pixels of regio's met vergelijkbare kenmerken te clusteren, waardoor beeldherkenning en -classificatie efficiënter worden.
Anomaliedetectie
Tijdens het trainen worden de meeste datapunten op specifieke neuronen geprojecteerd. Anomalieën (datapunten die niet goed in een cluster passen) worden doorgaans op verre of minder bevolkte neuronen geprojecteerd. Deze uitschieters passen niet goed in de geleerde clusters en worden toegewezen aan neuronen die ver van de BMU van normale datapunten liggen.
Bijvoorbeeld: door financiële transacties op een SOM-raster te mappen, kun je ongebruikelijke activiteiten (outliers) identificeren die op mogelijke fraude kunnen wijzen.
Datavisualisatie
Datavisualisatie is een van de meest voorkomende toepassingen van SOM's. Hoog-dimensionale data is moeilijk te visualiseren. SOM's maken dit eenvoudiger door de dimensionaliteit te reduceren en de data op een tweedimensionaal raster te projecteren. Dit helpt ook om clusters in de data en afwijkende datapunten te detecteren die in de oorspronkelijke data lastig te ontdekken zijn.
Zo maakt datavisualisatie het eenvoudiger om hoog-dimensionale bevolkingsdata te analyseren. Door de data op een 2D-raster te mappen, zie je sneller overeenkomsten en verschillen tussen bevolkingsgroepen.
Na de kernconcepten en toepassingen van SOM's te hebben besproken, laten we in de volgende secties zien hoe je ze implementeert met het Python-pakket MiniSom.
Je kunt de complete code bekijken en uitvoeren in deze DataLab-notebook.