
Ana içeriğe atla

Kendini Örgütleyen Haritalar: Python Örnekleriyle Sezgisel Bir Rehber

Kendini Örgütleyen Haritaların temel kavramlarını anlayın ve MiniSom kullanarak Python’da nasıl uygulanacağını öğrenin.
Güncel 3 Eki 2026  · 15 dk. oku

Yapay Zeka ile Keşfedin

ChatGPTClaudePerplexity

Kendini örgütleyen haritalar (SOM), gözetimsiz öğrenme görevlerinde, örneğin kümeleme için kullanılan bir yapay sinir ağı türüdür. Bir veri noktası kümesi verildiğinde, model veriyi kümelere ayırmayı öğrenir. SOM’lar, karmaşık çok boyutlu veriyi daha düşük boyutlu (genellikle 2 boyutlu) bir ızgaraya yansıtır. Bu, görselleştirmeyi kolaylaştırır. Bu nedenle SOM’lar, yüksek boyutlu veriyi görselleştirmek için de kullanılır. 

Bu öğreticide, SOM’ların temel kavramlarını, öğrenme süreçlerini ve tipik kullanım alanlarını inceliyoruz. MiniSom kütüphanesini kullanarak Python’da bir SOM’un nasıl uygulanacağını ve sonuçların görsel olarak nasıl temsil edileceğini açıklıyoruz. Son olarak, SOM modellerinin eğitiminde önemli hiperparametreleri ve bunların nasıl ince ayar yapılacağını tartışıyoruz. 

Kendini Örgütleyen Haritaları (SOM) Anlamak

Bu bölümde, SOM’ların temel kavramlarını, öğrenme süreçlerini ve kullanım alanlarını sunuyoruz. 

SOM’ların temel kavramları

Kendini örgütleyen haritaları anlamak için önemli bir dizi kavram vardır.

Nöronlar

Bir SOM esasen bir nöron ızgarasıdır. Eğitim sırasında, ağırlık vektörü bir girdiye en yakın olan nöron, ağırlıklarını ve komşularının ağırlıklarını, girdiye daha da yaklaşacak şekilde ayarlar. Çok sayıda yineleme boyunca, komşu nöron grupları ilişkili veri noktalarına eşlenir. Bu da giriş veri kümesinin kümelenmesiyle sonuçlanır. 

Izgara yapısı

Bir SOM’daki nöronlar bir ızgara halinde düzenlenir. Komşu nöronlar benzer veri noktalarına eşlenir. Daha büyük veri kümeleri daha büyük bir ızgara gerektirir. Tipik olarak bu ızgara iki boyutludur. Izgara yapısı, yüksek boyutlu verinin üzerine yansıtıldığı düşük boyutlu alan olarak hizmet eder. Izgara, veri örüntülerini ve kümeleri görselleştirmeye yardımcı olur. 

Veri noktalarını eşleme

Her veri noktası, bir uzaklık metriği kullanılarak tüm nöronlarla karşılaştırılır. Ağırlık vektörü giriş veri noktasına en yakın olan nöron, o veri noktası için En İyi Eşleşen Birim (BMU) olarak adlandırılır. 

BMU belirlendikten sonra, BMU’nun ve komşu nöronlarının ağırlıkları güncellenir. Bu güncelleme, BMU’yu ve komşu nöronları giriş veri noktasına daha da yaklaştırır. Bu eşleme, verinin topolojisini korur ve benzer veri noktalarının birbirine yakın nöronlara eşlenmesini sağlar. 

SOM’ların öğrenme süreci

SOM eğitimi, etiketli veri kümelerine dayanmadığı için gözetimsiz olarak kabul edilir. SOM’ları eğitmenin amacı, benzer veri noktalarının birbirine yakın nöronlara eşlenecek şekilde nöronların ağırlık vektörlerini yinelemeli olarak ayarlamaktır. 

Rekabetçi öğrenme

SOM’lar (gradyan inişi ve geri yayılım yerine) rekabetçi öğrenmeyi kullanır. Nöronlar, her giriş veri noktası için En İyi Eşleşen Birim (BMU) olmak için yarışır. Bir veri noktasına en yakın nöron onun BMU’su olarak belirlenir. BMU ve komşu nöronları, veri noktasına olan mesafelerini daha da azaltacak şekilde güncellenir. Komşu nöronlar ilişkili veri noktalarına eşlenir. Bu, nöronlar arasında uzmanlaşmaya ve giriş veri noktalarının kümelenmesine yol açar. 

Uzaklık işlevleri 

SOM’lar, nöronlar ile veri noktaları arasındaki mesafeyi ölçmek için bir uzaklık işlevi kullanır. Bu mesafe, her veri noktasının BMU’sunu belirlemek için kullanılır. MiniSom, seçilebilecek dört uzaklık işlevine sahiptir: 

Komşuluk işlevi

Bir veri noktasının BMU’su belirlendikten sonra, BMU ve komşu nöronları o veri noktasının yönünde güncellenir. Komşuluk işlevi, SOM’un giriş verisinin topolojik ilişkilerini korumasını sağlar. Komşuluk işlevi şunlara karar verir:

  • Hangi nöronların BMU’nun komşuluğunda kabul edileceği
  • Komşu nöronların ne ölçüde güncelleneceği. Genel olarak, BMU’ya daha yakın nöronlar, daha uzaktakilere kıyasla daha büyük bir ayarlama alır

MiniSom üç komşuluk işleviyle gelir: 

  • Gauss (varsayılan). 
  • Kabarcık (Bubble) 
  • Meksika şapkası (Mexican hat)
  • Üçgen (Triangle)

Yinelemeli süreç

SOM’larda öğrenme süreci birkaç yineleme boyunca gerçekleşir. Her yinelemede, SOM birçok giriş veri noktasını işler. Öğrenme sürecini şu adımlarla özetliyoruz:

  • Eğitim başladığında, tüm nöronların ağırlıkları (rastgele) başlatılır. 
  • Bir giriş veri noktası verildiğinde, her nöron girişe olan mesafesini hesaplar.
    • En küçük mesafeye sahip nöron BMU olarak ilan edilir. 
  • BMU’nun ve komşularının ağırlıkları, giriş vektörüne yaklaşacak şekilde ayarlanır. Bu ayarlamanın derecesine şu faktörler karar verir:
    • Bir komşuluk işlevi: BMU’dan daha uzakta olan nöronlar, BMU’ya yakın olanlara göre daha az güncellenir. Bu, verinin topolojik yapısını korur. 
    • Öğrenme oranı: Daha yüksek öğrenme oranı daha büyük güncellemelerle sonuçlanır. 

Bu adımlar, çok sayıda giriş veri noktasında, çok sayıda yineleme boyunca tekrarlanır. Ağırlıklar kademeli olarak güncellenir, böylece harita kendini örgütler ve verinin yapısını yakalar. 

Öğrenme oranı ve komşuluk yarıçapı genellikle zamanla azalır; bu da SOM’un ağırlıkları kademeli olarak ince ayar yapmasını sağlar. Öğreticinin ilerleyen kısımlarında, yinelemeli eğitim sürecinin adımlarını Python kodu kullanarak uygularız. 

SOM’ların tipik kullanım alanları

Benzersiz mimarileri göz önüne alındığında, SOM’ların makine öğrenimi, analiz ve görselleştirmede çeşitli tipik uygulamaları vardır.

Kümeleme

SOM’lar, yüksek boyutlu veriyi benzer veri noktalarının kümelerine ayırmak için kullanılır. Bu, verideki içsel yapıların belirlenmesine yardımcı olur. Her nöron birbirine yakın ilişkili veri noktalarına eşlenir ve benzer veri noktaları aynı veya komşu nöronlara eşlenir; böylece belirgin kümeler oluşur. 

Örneğin pazarlamada, SOM’lar müşterileri satın alma davranışlarına göre gruplayabilir. Bu da bir markanın farklı müşteri segmentlerine (kümelere) yönelik pazarlama stratejilerini uyarlamasına olanak tanır.

Boyut indirgeme

SOM’lar, çok sayıda özellik vektörüne sahip yüksek boyutlu veriyi daha az boyutlu (genellikle 2 boyutlu) bir ızgaraya eşleyebilir. Bu eşleme, veri noktaları arasındaki ilişkileri koruduğundan, indirgenmiş boyut sayısı, karmaşık veri kümelerini önemli bilgi kaybı olmadan görselleştirmeyi kolaylaştırır.

Görselleştirme ve analiz görevlerini kolaylaştırmanın yanı sıra, SOM’lar diğer makine öğrenimi algoritmalarını uygulamadan önce verinin boyutunu da azaltabilir. SOM’lar ayrıca benzer özelliklere sahip pikselleri veya bölgeleri kümelendirerek görüntü işleme alanında özellik sayısını azaltmak için kullanılır; bu da görüntü tanıma ve sınıflandırma görevlerini daha verimli hale getirir. 

Anomali tespiti

Eğitim sürecinde, çoğu veri noktası belirli nöronlara eşlenir. Anomaliler (herhangi bir kümeye iyi uymayan veri noktaları) tipik olarak uzak veya daha az nüfuslu nöronlara eşlenir. Bu aykırı değerler, öğrenilen kümelere iyi uymaz ve normal veri noktalarının BMU’sundan uzak nöronlara eşlenir.

Örneğin, finansal işlemlerin bir SOM ızgarasına eşlenmesi, potansiyel sahtekarlığı işaret edebilecek olağandışı faaliyetlerin (aykırı değerlerin) belirlenmesini sağlar. 

Veri görselleştirme

Veri görselleştirme, SOM’ların en yaygın kullanım alanlarından biridir. Yüksek boyutlu veriyi görselleştirmek zordur. SOM’lar, verinin boyutunu azaltarak ve onu iki boyutlu bir ızgaraya yansıtarak görselleştirmeyi kolaylaştırır. Bu, verideki kümeleri ve orijinal veride keşfedilmesi güç olan anormal veri noktalarını tespit etmeye de yardımcı olabilir. 

Örneğin, veri görselleştirme yüksek boyutlu nüfus verilerini analiz etmeyi kolaylaştırır. Verinin 2B bir ızgaraya eşlenmesi, farklı nüfus grupları arasındaki benzerlik ve farklılıkları görmeyi kolaylaştırır.  

SOM’ların temel kavramlarını ve kullanım alanlarını tartıştıktan sonra, aşağıdaki bölümlerde Python paketi MiniSom kullanarak bunların nasıl uygulanacağını göstereceğiz. 

Tüm koda bu DataLab defterinden erişebilir ve çalıştırabilirsiniz.

SOM için Ortamın Hazırlanması

SOM’u oluşturmadan önce, gerekli paketlerle ortamı hazırlamamız gerekir. 

Python kütüphanelerinin kurulması 

Şu paketlere ihtiyacımız var: 

  • MiniSom, SOM’lar oluşturan ve eğiten NumPy tabanlı bir Python aracıdır. 
  • NumPy, dizileri bölme, benzersiz değerleri alma gibi matematiksel işlevlere erişmek için kullanılır. 
  • matplotlib, veriyi görselleştirmek için çeşitli grafik ve çizelgeler çizmekte kullanılır. 
  • sklearn içindeki datasets paketi, SOM’u uygulayacağımız veri kümelerini içe aktarmak için kullanılır. 
  • sklearn içindeki MinMaxScaler, veri kümesini normalize eder. 

Aşağıdaki kod parçacığı bu paketleri içe aktarır: 

from minisom import MiniSom
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.preprocessing import MinMaxScaler

Veri kümesinin hazırlanması

Bu öğreticide, bir SOM oluşturmak için MiniSom kullanıyor ve ardından onu kanonik IRIS veri kümesi üzerinde eğitiyoruz. Bu veri kümesi 3 sınıf iris bitkisinden oluşur. Her sınıfta 50 örnek vardır. Veriyi hazırlamak için şu adımları izliyoruz: 

  • sklearn’dan Iris veri setini içe aktarın, 
  • Veri vektörlerini ve hedef (etiket) değerlerini çıkarın. 
  • Veri vektörlerini normalize edin. Bu öğreticide, scikit-learn’den MinMaxScaler kullanıyoruz. 
  • Her üç Iris sınıfı için bir etiket kümesi tanımlayın. 

Aşağıdaki kod bu adımları uygular: 

dataset_iris = datasets.load_iris()
data_iris = dataset_iris.data
target_iris = dataset_iris.target
data_iris_normalized = MinMaxScaler().fit_transform(data_iris)
labels_iris = {1:'1', 2:'2', 3:'3'}
data = data_iris_normalized
target = target_iris

Python’da Kendini Örgütleyen Haritaların (SOM) Uygulanması

Python’da bir SOM uygulamak için, veri kümesi üzerinde eğitmeden önce ızgarayı tanımlar ve başlatırız. Ardından eğitilmiş nöronları ve kümelenmiş veri kümesini görselleştirebiliriz. 

SOM ızgarasını tanımlama

Daha önce açıklandığı gibi, bir SOM bir nöron ızgarasıdır. MiniSom’u kullanarak iki boyutlu ızgaralar oluşturabiliriz. Izgaranın X ve Y boyutları, her eksen boyunca nöron sayısıdır. SOM ızgarasını tanımlamak için ayrıca şunları belirtmemiz gerekir:

  • Izgaranın X ve Y boyutları
  • Girdi değişkenlerinin sayısı - bu, veri satırlarının sayısıdır. 

Bu parametreleri Python sabitleri olarak tanımlayın:

SOM_X_AXIS_NODES  = 8
SOM_Y_AXIS_NODES  = 8
SOM_N_VARIABLES  = data.shape[1]

Aşağıdaki örnek kod, MiniSom kullanarak ızgaranın nasıl tanımlanacağını gösterir:

som = MiniSom(SOM_X_AXIS_NODES, SOM_Y_AXIS_NODES, SOM_N_VARIABLES)

İlk iki parametre X ve Y eksenleri boyunca nöron sayısıdır; üçüncü parametre ise değişken sayısıdır. 

SOM ızgarasını oluştururken diğer parametreleri ve hiperparametreleri de bildiririz. Bunları öğreticinin ilerleyen kısımlarında açıklayacağız. Şimdilik bu parametreleri aşağıda gösterildiği gibi tanımlayın: 

ALPHA = 0.5
DECAY_FUNC = 'linear_decay_to_zero'
SIGMA0 = 1.5
SIGMA_DECAY_FUNC = 'linear_decay_to_one'
NEIGHBORHOOD_FUNC = 'triangle'
DISTANCE_FUNC = 'euclidean'
TOPOLOGY = 'rectangular'
RANDOM_SEED = 123

Bu parametreleri kullanarak bir SOM oluşturun:

som = MiniSom(
        SOM_X_AXIS_NODES,
        SOM_Y_AXIS_NODES,
        SOM_N_VARIABLES,
        sigma=SIGMA0,
        learning_rate=ALPHA,
        neighborhood_function=NEIGHBORHOOD_FUNC,
        activation_distance=DISTANCE_FUNC,
        topology=TOPOLOGY,
        sigma_decay_function = SIGMA_DECAY_FUNC,
        decay_function = DECAY_FUNC,
        random_seed=RANDOM_SEED,
        )

Nöronların başlatılması

Yukarıdaki komut, tüm nöronlar için rastgele ağırlıklarla bir SOM oluşturur. Nöronları rastgele sayılar yerine veriden çekilen ağırlıklarla başlatmak, eğitim sürecini daha verimli hale getirebilir. 

MiniSom kullanarak Kendini Örgütleyen Harita (SOM) oluştururken, nöron ağırlıklarını veriye dayalı olarak başlatmanın iki yolu vardır:

  • Rastgele başlatma: Nöronların ilk ağırlıkları giriş verisinden rastgele çekilir. Bunu SOM üzerinde .random_weights_init() işlevini uygulayarak yaparız. 
  • PCA başlatma: Temel Bileşen Analizi (PCA) başlatma, giriş verisinin temel bileşenlerini kullanarak ağırlıkları başlatır. Nöronların başlangıç ağırlıkları ilk iki temel bileşeni kapsar. Bu genellikle daha hızlı yakınsamaya yol açar. 

Bu rehberde PCA başlatmayı kullanıyoruz. SOM ağırlıklarına PCA başlatmayı uygulamak için, aşağıda gösterildiği gibi .pca_weights_init() işlevini kullanın:

som.pca_weights_init(data)

SOM’un eğitilmesi

Eğitim süreci, nöronlar ile veri noktaları arasındaki mesafeyi en aza indirmek için SOM ağırlıklarını günceller. 

Aşağıda, yinelemeli eğitim sürecini açıklıyoruz:

  • Başlatma: Tüm nöronların ağırlık vektörleri genellikle rastgele değerlerle başlatılır. Ağırlıkları giriş veri dağılımından örnekleyerek başlatmak da mümkündür.
  • Girdi seçimi: Eğitim veri setinden bir giriş vektörü (rastgele) seçilir.
  • BMU’nun belirlenmesi: Ağırlık vektörü giriş vektörüne en yakın olan nöron BMU olarak belirlenir. 
  • Komşuluğun güncellenmesi: BMU ve komşu nöronları ağırlık vektörlerini günceller. Öğrenme oranı ve komşuluk işlevi, hangi nöronların ne ölçüde güncelleneceğine karar verir. t yineleme adımında, giriş vektörü x, nöronun ağırlık vektörü i olarak wi, öğrenme oranı (t) ve komşuluk işlevi hbi (bu işlev, BMU nöronu b verildiğinde nöron i için güncelleme derecesini niceler), nöron i için ağırlık güncelleme formülü şu şekilde ifade edilir:
  • Öğrenme oranı ve komşuluk yarıçapının sönümü: Hem öğrenme oranı hem de komşuluk yarıçapı zamanla azalır. İlk yinelemelerde, eğitim süreci daha geniş bir komşulukta daha büyük ayarlamalar yapar. Daha sonraki yinelemeler, bitişik nöronların ağırlıklarında daha küçük değişiklikler yaparak ağırlıkları ince ayar yapmaya yardımcı olur. Bu, haritanın dengelenmesini ve yakınsamasını sağlar. 

SOM’u eğitmek için, modele giriş verisini sunarız. Bunu yapmak için iki yaklaşımdan birini seçebiliriz: 

  • Giriş verisinden rastgele örnekler seçin. .train_random() işlevi bu tekniği uygular. 
  • Giriş verisindeki vektörlerde sırasıyla ilerleyin. Bu, .train_batch() işlevi kullanılarak yapılır. 

Bu işlevler, parametre olarak giriş verisini ve yineleme sayısını kabul eder. Bu rehberde .train_random() işlevini kullanıyoruz. Yineleme sayısını bir sabit olarak tanımlayın ve eğitim işlevine iletin: 

N_ITERATIONS = 5000
som.train_random(data, N_ITERATIONS, verbose=True)  

Betik çalıştırıldıktan ve eğitim tamamlandıktan sonra, bir nicemleme hatası iletisi görüntülenir:

quantization error: 0.05357240680504421 

Nicemleme hatası, SOM’un veriyi nicemlerken (boyutunu azaltırken) kaybettiği bilgi miktarını gösterir. Büyük bir nicemleme hatası, nöronlarla veri noktaları arasındaki mesafenin daha büyük olduğuna işaret eder. Bu aynı zamanda kümelenmenin daha az güvenilir olduğu anlamına gelir. 

SOM nöronlarının görselleştirilmesi 

Artık eğitilmiş bir SOM modelimiz var. Bunu görselleştirmek için bir uzaklık haritası (aynı zamanda U-matrisi olarak da bilinir) kullanıyoruz. Uzaklık haritası, SOM’un nöronlarını hücrelerden oluşan bir ızgara olarak gösterir. Her hücrenin rengi, komşu nöronlara olan mesafesini temsil eder. 

Uzaklık haritası, SOM ile aynı boyutlara sahip bir ızgaradır. Uzaklık haritasındaki her hücre, bir nöron ile komşuları arasındaki (Öklidyen) mesafelerin normalize edilmiş toplamıdır. 

SOM distance map’e .distance_map() işlevini kullanarak erişin. U-matrisini üretmek için şu adımları izliyoruz:

  • pyplot’u kullanarak SOM ile aynı boyutlarda bir şekil oluşturun. Bu örnekte boyutlar 8x8’dir. 
  • Matplotlib ile .pcolor() işlevini kullanarak uzaklık haritasını çizin. Bu örnekte gist_yarg renk düzeni olarak kullanılmıştır. 
  • colorbar’ı görüntüleyin; bu, farklı renkleri farklı skaler değerlere eşleyen bir dizindir. Bu durumda, mesafeler normalize edildiği için skaler mesafe değerleri 0 ile 1 arasındadır. 

Aşağıdaki kod bu adımları uygular: 

# create the grid
plt.figure(figsize=(8, 8))
#plot the distance map
plt.pcolor(som.distance_map().T, cmap='gist_yarg') 
# show the color bar
plt.colorbar()
plt.show()

Bu örnekte, U-matrisi tekdüze bir renk şeması kullanır. Aşağıdaki yönergelerle anlaşılabilir:
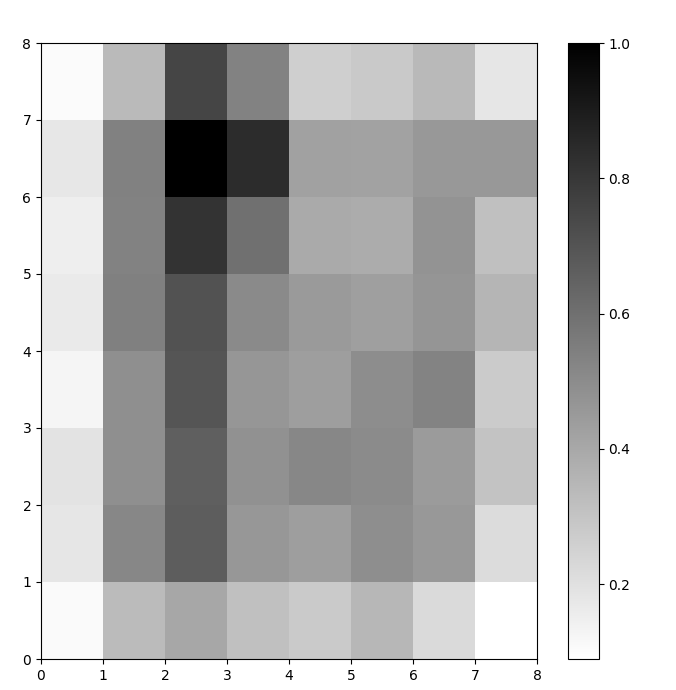
  • Açık tonlar birbirine yakın nöronları, koyu tonlar ise diğerlerinden daha uzakta olan nöronları temsil eder. 
  • Açık tonlardan oluşan gruplar kümeler olarak yorumlanabilir. Kümeler arasındaki koyu düğümler, kümeler arasındaki sınırlar olarak yorumlanabilir. 

Şekil 1: Iris veri kümesinin U-matrisi

Şekil 1: Iris veri kümesi üzerinde eğitilmiş SOM’un U-matrisi (yazarın görseli)

SOM Kümeleme Sonuçlarının Değerlendirilmesi

Önceki görsel, SOM’un nöronlarını grafiksel olarak göstermişti. Bu bölümde, SOM’un veriyi nasıl kümelendirdiğini nasıl görselleştireceğimizi gösteriyoruz. 

Kümeleri belirleme

Hangi hücrenin (nöronun) hangi Iris sınıfını temsil ettiğini belirtmek için yukarıdaki U-matrisinin üzerine işaretçiler yerleştiriyoruz. Bunu yapmak için:

  • Daha önce olduğu gibi pyplot kullanarak 8x8 bir şekil oluşturun, uzaklık haritasını çizin ve renk çubuğunu gösterin. 
  • Üç Iris sınıfının her biri için birer tane olmak üzere üç matplotlib işaretçisi dizisi belirtin. 
  • Her Iris sınıfı için birer tane olmak üzere üç matplotlib renk kodu dizisi belirtin. 
  • Her veri noktası için kazanan nöronu yinelemeli olarak çizin:
    • .winner() işlevini kullanarak her veri noktası için kazanan nöronun (koordinatlarını) belirleyin. 
    • Her kazanan nöronun konumunu ızgaradaki her hücrenin ortasına çizin. w[0] ve w[1] sırasıyla nöronun X ve Y koordinatlarını verir. Hücrenin ortasına çizmek için her koordinata 0,5 eklenir. 

Bunu nasıl yapacağınızı gösteren kod aşağıdadır:

# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg') 
plt.colorbar()
# create the markers and colors for each class
markers = ['o', 'x', '^']
colors = ['C0', 'C1', 'C2']
# plot the winning neuron for each data point
for count, datapoint in enumerate(data):
    # get the winner
    w = som.winner(datapoint)  
    # place a marker on the winning position for the sample data point
    plt.plot(w[0]+.5, w[1]+.5, markers[target[count]-1], markerfacecolor='None',
             markeredgecolor=colors[target[count]-1], markersize=12, markeredgewidth=2)
plt.show()

Ortaya çıkan görsel aşağıda gösterilmiştir: 
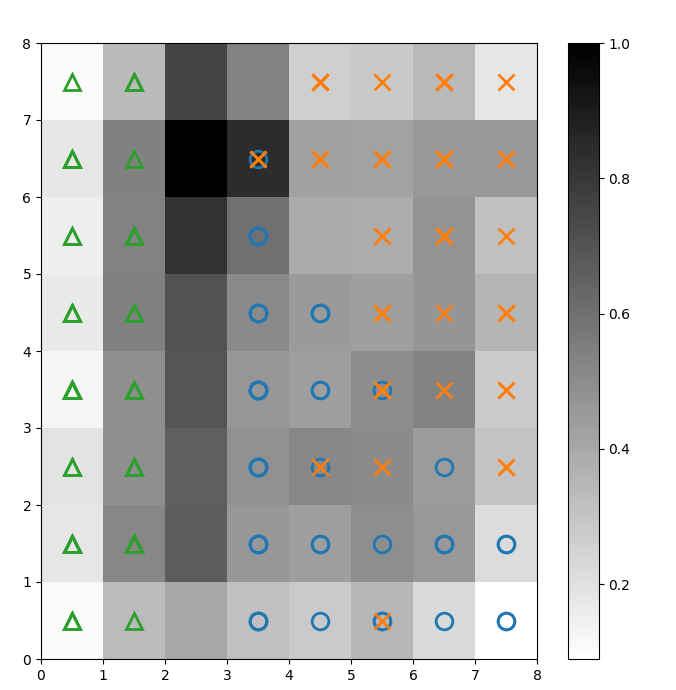
Sınıf işaretçileri bindirilmiş U-matrisi

Şekil 2: Sınıf işaretçileri bindirilmiş U-matrisi (yazarın görseli)

Iris veri kümesi belgelerine göre, “bir sınıf diğer ikisinden doğrusal olarak ayrılabilir; diğer ikisi birbirinden doğrusal olarak ayrılamaz”. Yukarıdaki U-matrisinde bu üç sınıf üç işaretçiyle temsil edilmektedir – üçgen, daire ve çarpı. 

Mavi daireler ile turuncu çarpılar arasında net bir sınır olmadığını fark edin. Ayrıca birçok hücrede iki sınıf aynı nöronun üzerine bindirilmiştir. Bu, nöronun her iki sınıfa da eşit uzaklıkta olduğu anlamına gelir. 

Kümeleme sonucunun görselleştirilmesi

Bir SOM bir kümeleme modelidir. Benzer veri noktaları aynı nörona eşlenir. Aynı sınıftaki veri noktaları, komşu nöronlardan oluşan bir kümeye eşlenir. Kümeleme davranışını daha iyi incelemek için tüm veri noktalarını SOM ızgarasında çizeriz. 

Aşağıdaki adımlar bu dağılım grafiğinin nasıl oluşturulacağını açıklar:

  • Her veri noktası için kazanan nöronun X ve Y koordinatlarını alın. 
  • Şekil 1’de yaptığımız gibi uzaklık haritasını çizin. 
  • plt.scatter() kullanarak, her veri noktası için tüm kazanan nöronların dağılım grafiğini oluşturun. Aynı hücre içindeki veri noktaları arasındaki çakışmaları önlemek için her noktaya rastgele bir ofset ekleyin.

Bu adımları aşağıdaki kodda uyguluyoruz: 

# get the X and Y coordinates of the winning neuron for each data pointw_x, w_y = zip(*[som.winner(d) for d in data])
w_x = np.array(w_x)
w_y = np.array(w_y)
# plot the distance map
plt.figure(figsize=(8, 8))
plt.pcolor(som.distance_map().T, cmap='gist_yarg', alpha=.2)
plt.colorbar()
# make a scatter plot of all the winning neurons for each data point
# add a random offset to each point to avoid overlaps
for c in np.unique(target):
    idx_target = target==c
    plt.scatter(w_x[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
                w_y[idx_target]+.5+(np.random.rand(np.sum(idx_target))-.5)*.8,
                s=50, 
                c=colors[c-1], 
                label=labels_iris[c+1]
                )
plt.legend(loc='upper right')
plt.grid()
plt.show()

Aşağıdaki grafik, elde edilen dağılımı göstermektedir:
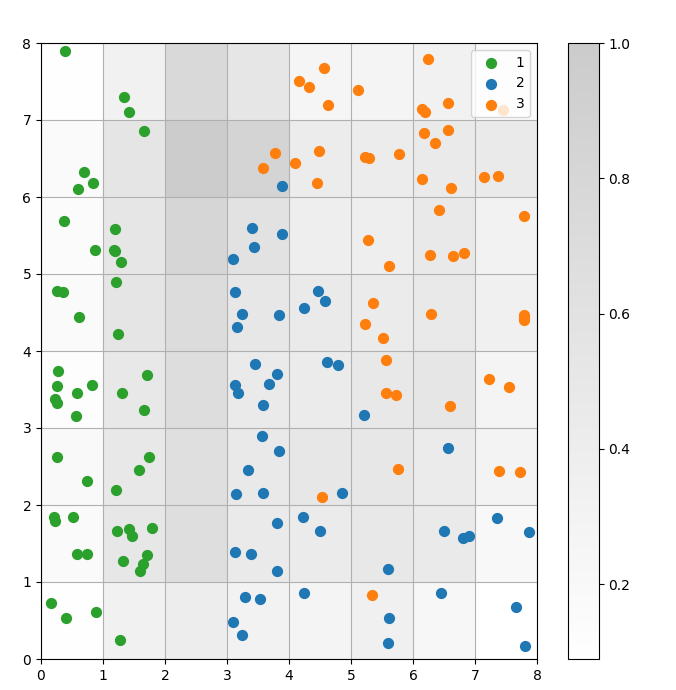
Hücreler içindeki veri noktalarının dağılım grafiği Şekil 3: Hücreler içindeki veri noktalarının dağılım grafiği (yazarın görseli)

Yukarıdaki dağılım grafiğinde şunları gözlemleyin: 

  • Bazı hücreler hem mavi hem turuncu noktalar içeriyor. 
  • Yeşil noktalar, verinin geri kalanından net bir şekilde ayrılmış, fakat mavi ve turuncu noktalar temiz biçimde ayrışmamış. 
  • Yukarıdaki gözlemler, Iris veri kümesindeki üç kümeden yalnızca birinin net bir sınıra sahip olduğu gerçeğiyle uyumludur. 
  • Şekil 1’deki kümeler arasındaki koyu düğümler (kümeler arası sınırlar olarak yorumlanabilir) dağılım grafiğindeki boş hücrelerle örtüşür. 

Tüm koda bu DataLab defterinden erişebilir ve çalıştırabilirsiniz. 

SOM Modelinin İnce Ayarı

Önceki bölümlerde bir SOM modelinin nasıl oluşturulup eğitileceğini ve sonuçların görsel olarak nasıl inceleneceğini gösterdik. Bu bölümde, SOM modellerinin performansının nasıl ayarlanacağını tartışıyoruz. 

Ayarlanacak temel hiperparametreler

Diğer tüm makine öğrenimi modellerinde olduğu gibi, hiperparametreler modelin performansını önemli ölçüde etkiler. 

SOM eğitiminde önemli bazı hiperparametreler şunlardır:

  • Izgara boyutu haritanın boyutunu belirler. AxB ızgara boyutuna sahip bir haritadaki nöron sayısı A*B’dir. 
  • Öğrenme oranı her yinelemede ağırlıkların ne kadar değiştirileceğini belirler. Başlangıç öğrenme oranını belirleriz ve oran, sönüm işlevine göre zamanla azalır. 
  • Sönüm işlevi, öğrenme oranının ardışık yinelemelerde ne ölçüde azaltılacağını belirler. 
  • Komşuluk işlevi, BMU’nun komşuları olarak hangi nöronların kabul edileceğini belirleyen matematiksel bir işlevidir. 
  • Standart sapma komşuluk işlevinin yayılımını belirtir. Örneğin, yüksek standart sapmaya sahip Gauss komşuluk işlevi, daha küçük standart sapmalı aynı işlevden daha büyük bir komşuluğa sahip olacaktır. Başlangıç standart sapmasını ayarlarız ve bu değer sigma sönüm işlevine göre zamanla azalır. 
  • Sigma sönüm işlevi, standart sapmanın ardışık yinelemelerde ne kadar azaltılacağını kontrol eder. 
  • Eğitim yinelemelerinin sayısı ağırlıkların kaç kez güncelleneceğini belirler. Her eğitim yinelemesinde nöron ağırlıkları bir kez güncellenir. 
  • Uzaklık işlevi, nöronlar ile veri noktaları arasındaki mesafeyi hesaplayan matematiksel bir işlevidir. 
  • Topoloji, ızgara yapısının düzenini belirler. Izgaradaki nöronlar dikdörtgen veya altıgen bir düzende yerleştirilebilir. 

Bir sonraki bölümde, bu hiperparametrelerin değerlerini belirlemeye yönelik kılavuzları tartışıyoruz. 

Hiperparametre ayarının etkisi

Hiperparametre değerleri, modele ve veri kümesine bağlı olarak belirlenmelidir. Kısmen, bu değerlerin belirlenmesi deneme-yanılma sürecidir. Bu bölümde her hiperparametre için ayar kılavuzları veriyoruz. Her hiperparametrenin yanında, örnek kodda kullanılan ilgili Python sabitini parantez içinde belirtiyoruz.

  • Izgara boyutu (SOM_X_AXIS_NODES ve SOM_Y_AXIS_NODES): Izgara boyutu, veri kümesinin boyutuna bağlıdır. Kural olarak, N boyutundaki bir veri kümesi için ızgara yaklaşık olarak 5*sqrt(N) nöron içermelidir. Örneğin, veri kümesi 150 örnek içeriyorsa, ızgara 5*sqrt(150) = yaklaşık 61 nöron içermelidir. Bu öğreticide, Iris veri kümesi 150 satırdır ve 8x8 bir ızgara kullanıyoruz. 
  • Başlangıç öğrenme oranı (ALPHA): Daha yüksek oran yakınsamayı hızlandırır; daha düşük oranlar ise erken yinelemelerden sonra daha ince ayarlar için kullanılır. Başlangıç öğrenme oranı, hızlı uyum sağlayacak kadar büyük, ancak en iyi ağırlık değerlerini aşmayacak kadar da küçük olmalıdır. Bu makalede başlangıç öğrenme oranı 0,5’tir. 
  • Başlangıç standart sapması (SIGMA0): Komşuluğun başlangıç boyutunu veya yayılımını belirler. Daha büyük bir değer daha küresel örüntüleri dikkate alır. Bu örnekte başlangıç standart sapması olarak 1,5 kullanıyoruz. 
  • Sönüm oranı (DECAY_FUNC) ve sigma sönüm oranı (SIGMA_DECAY_FUNC) için üç tür sönüm işlevinden birini seçebiliriz: 
    • Ters sönüm: Veri hem küresel hem de yerel örüntüler içeriyorsa uygundur. Bu tür durumlarda, yerel örüntülere odaklanmadan önce daha uzun bir geniş öğrenme evresine ihtiyaç duyarız. 
    • Doğrusal sönüm: Komşuluk boyutu veya öğrenme oranının istikrarlı ve tekdüze biçimde azalmasını istediğimiz veri kümeleri için iyidir. İnce ayarın çok gerekmediği verilerde kullanışlıdır.
    • Asimptotik sönüm: Veri karmaşık ve yüksek boyutluysa kullanışlıdır. Bu tür durumlarda, ince ayrıntılara kademeli geçişten önce küresel keşfe daha fazla zaman ayırmak daha iyidir. 
  • Komşuluk işlevi (NEIGHBORHOOD_FUNC): Varsayılan seçim Gauss işlevdir. Aşağıda açıklandığı gibi diğer işlevler de kullanılır. 
    • Gauss (varsayılan): Çan eğrisidir. Bir nöronun güncelleme derecesi, kazanan nörondan uzaklığı arttıkça düzgün biçimde azalır. Düzgün ve sürekli bir geçiş sağlar ve verinin topolojisini korur. Dengeli ve öngörülebilir davranışı nedeniyle çoğu genel amaç için uygundur.
    • Kabarcık: Sabit genişlikte bir komşuluk oluşturur. Bu komşuluk içindeki tüm nöronlar eşit şekilde güncellenir ve bu komşuluk dışında kalan nöronlar (verilen bir veri noktası için) güncellenmez. Hesaplama açısından daha ucuz ve uygulaması daha kolaydır. Keskin komşuluk sınırlarının etkili kümelenmeyi zedelemediği daha küçük haritalar için kullanışlıdır. 
    • Meksika şapkası: Merkezi pozitif bir bölge ve onu çevreleyen negatif bir bölgeye sahiptir. BMU’ya yakın nöronlar veri noktasına yaklaşacak şekilde güncellenir, daha uzaktakiler ise veri noktasından uzaklaşacak şekilde güncellenir. Bu teknik, haritadaki karşıtlığı artırır ve özellikleri keskinleştirir. Belirgin kümeleri vurguladığından, kümelerin net ayrımının istendiği örüntü tanıma görevlerinde etkilidir.
    • Üçgen: Komşuluk boyutunu, en büyük etkinin BMU’da olduğu bir üçgen olarak tanımlar. Etki, BMU’dan uzaklıkla doğrusal olarak azalır. Komşu veri noktalarının benzer özellikleri paylaşmasının beklendiği görüntü, konuşma veya zaman serisi gibi kümeler veya özellikler arasında kademeli geçişler olan verileri kümelendirmede kullanılır. 
  • Uzaklık işlevi (DISTANCE_FUNC): Nöronlar ile veri noktaları arasındaki mesafeyi ölçmek için 4 yöntemden birini seçebiliriz:
    • Öklidyen mesafe (varsayılan seçim): Veri sürekli olduğunda ve düz çizgi mesafesini ölçmek istediğimizde faydalıdır. Özellikle veri noktalarının eşit dağılmış ve mekansal olarak ilişkili olduğu genel görevlerin çoğuna uygundur.
    • Kosinüs mesafesi: Vektörler arasındaki açının, büyüklükten daha önemli olduğu metin veya yüksek boyutlu seyrek veriler için iyi bir seçimdir. Veride yönlülüğü karşılaştırmak için kullanışlıdır.
    • Manhattan mesafesi: Veri noktalarının bir ızgara veya kafes üzerinde (örn. şehir blokları) olduğu durumlar için idealdir. Öklidyen mesafeye göre aykırı değerlere daha az duyarlıdır.
    • Çebişev mesafesi: Hareketin her yönde gerçekleşebildiği durumlar (örn. satranç tahtası mesafeleri) için uygundur. Maksimum eksen farkını önceliklendirmek istediğimiz ayrık uzaylar için kullanışlıdır.
  • Topoloji (TOPOLOGY): Bir ızgarada, nöronlar altıgen veya dikdörtgen bir yapıda düzenlenebilir: 
    • Dikdörtgen (varsayılan): Her nöronun 4 doğrudan komşusu vardır. Verinin belirgin bir mekansal ilişkisi olmadığında doğru tercihtir. Hesaplama açısından da daha basittir. 
    • Altıgen: Her nöronun 6 komşusu vardır. Verinin, altıgen bir ızgarayla daha iyi temsil edilen mekansal ilişkilere sahip olduğu durumlarda tercih edilir. Bu, dairesel veya açısal veri dağılımları için geçerlidir.
  • Eğitim yineleme sayısı (N_ITERATIONS): İlke olarak, daha uzun eğitim süreleri daha düşük hatalara ve ağırlıkların giriş verisiyle daha iyi hizalanmasına yol açar. Ancak modelin performansı yineleme sayısıyla asimptotik olarak artar. Dolayısıyla belirli bir yineleme sayısından sonra, sonraki yinelemelerden elde edilen performans artışı yalnızca marjinaldir. Doğru yineleme sayısını belirlemek biraz deneme gerektirir. Bu öğreticide modeli 5000 yineleme boyunca eğitiyoruz. 

Doğru hiperparametre yapılandırmasını belirlemek için, verinin daha küçük bir alt kümesinde çeşitli seçeneklerle deneyler yapmanızı öneririz.

Sonuç

Kendini örgütleyen haritalar, gözetimsiz öğrenme için sağlam bir araçtır. Kümeleme, boyut indirgeme, anomali tespiti ve veri görselleştirme için kullanılırlar. Yüksek boyutlu verinin topolojik özelliklerini korudukları ve onu daha düşük boyutlu bir ızgarada temsil ettikleri için, SOM’lar karmaşık veri kümelerini görselleştirmeyi ve yorumlamayı kolaylaştırır. 

Bu öğretici, SOM’ların temel ilkelerini tartıştı ve MiniSom Python kütüphanesini kullanarak bir SOM’un nasıl uygulanacağını gösterdi. Ayrıca sonuçların görsel olarak nasıl analiz edileceğini ve SOM’ları eğitmek ile performanslarını ince ayar yapmak için kullanılan önemli hiperparametreleri açıkladı.

SSS

SOM eğitimi geri yayılım içerir mi?

Bir SOM yapay sinir ağıdır, ancak eğitimi hata düzeltmeye dayanmaz. Bu nedenle, gradyan inişi ile geri yayılım kullanmaz. Bunun yerine SOM’lar rekabetçi öğrenme ile eğitilir.

Sönüm işlevlerine neden ihtiyaç vardır?

Eğitimin erken aşamalarında, modelin verinin küresel manzarasını keşfetmesi gerekir. Bu nedenle öğrenme oranının yüksek, komşuluk işlevinin ise geniş yayılı olması gerekir. Daha sonraki eğitim yinelemeleri, bitişik nöronlara dayalı olarak ağırlıklarda daha ince ayarlamalar yapar. Eğitim ilerledikçe, sönüm işlevleri öğrenme oranını ve komşuluk yarıçapını azaltır.

Varsayılan (rastgele) başlatma ile girdi verisine dayalı rastgele başlatma arasındaki fark nedir?

Varsayılan başlatmada, ağırlıklar rastgele sayılara ayarlanır.

Girdi verisine dayalı rastgele başlatmada ise, ağırlıklar giriş verisinden rastgele seçilen örneklere ayarlanır.

SOM’lar verideki doğrusal olmayan ilişkileri yakalayabilir mi?

Evet, SOM’lar çeşitli komşuluk işlevleri kullanarak verideki doğrusal olmayan örüntüleri yakalar. Tek bir veri noktası birçok nöronun (komşuluk içindeki) değerlerini etkileyebilir. Bu, SOM’ların verideki karmaşık ilişkileri yakalamasını sağlar.

SOM ile geleneksel kümeleme yöntemleri arasındaki fark nedir?

SOM’lar, mekansal ilişkileri koruyarak yüksek boyutlu veriyi daha düşük boyutlu bir ızgaraya eşler. Öte yandan, K-Ortalamalar gibi geleneksel kümeleme teknikleri, verinin topolojisini veya mekansal ilişkilerini mutlaka dikkate almadan, uzaklık metriklerine dayalı gruplar oluşturur. 

Veri analizinde topolojik veya mekansal ilişkilerin, veri noktalarının çok boyutlu bir uzayda birbirine göre nasıl konumlandığına atıfta bulunduğunu unutmayın.


Arun Nanda's photo
Author
Arun Nanda
LinkedIn

Arun, yeni şeyler inşa etmekten keyif alan, eski bir girişim kurucusudur. Şu anda Yapay Zekânın teknik ve matematiksel temellerini keşfediyor. Öğrendiklerini paylaşmayı sevdiği için bu konuda yazılar yazıyor.

DataCamp’in yanı sıra, yazılarını Medium, Airbyte ve Vultr üzerinde okuyabilirsiniz.

Konular
Makine Öğrenimi
Python

Makine öğrenimi ve Python hakkında daha fazla bilgi edinmek için bu kurslara göz atın!

Kurs

Python ile Ağaç Tabanlı Modellerle Machine Learning

5 sa
119.3K
Bu kursta, scikit-learn kullanarak regresyon ve sınıflandırma için ağaç tabanlı modeller ve kümeleri nasıl kullanacağınızı öğreneceksiniz.
Ayrıntıları GörüntüleRight Arrow
Kursa Başla
Devamını GörRight Arrow
İlgili

blog

2026’da En Popüler 40 Yazılım Mühendisi Mülakat Sorusu

Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Dario Radečić's photo

Dario Radečić

15 dk.

blog

Hızlı Sevkiyat İçin Pratik Vibe Kodlama Teknoloji Yığını

Ön uç, arka uç, veritabanları, kimlik doğrulama, depolama, e-posta, test, dağıtım ve izleme için en iyi araçları keşfedin.
Abid Ali Awan's photo

Abid Ali Awan

14 dk.

Eğitim

Python'da Listeyi String'e Nasıl Dönüştürürsünüz

Bu hızlı eğitimde, Python'da bir listeyi string'e nasıl dönüştüreceğinizi öğrenin.
Adel Nehme's photo

Adel Nehme

Eğitim

.gitignore Nasıl Kullanılır: Örneklerle Pratik Bir Giriş

Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!
Kurtis Pykes 's photo

Kurtis Pykes

8 dk.

Devamını GörDevamını Gör

