
课程
使用 Weaviate 实现端到端 RAG
2 小时
898
实践并学习路径你的进步。
使用 Google 继续Self-RAG 引入迭代推理与自我评估,使系统能够动态调整检索与生成,直至得到高质量响应。与一次性流程不同,Self-RAG 在每一步中融入反馈回路,以做出更明智的决策。
Self-RAG 流程涉及四个关键决策:
通过在每一步引入自我反思,Self-RAG 使检索更可靠,避免幻觉,并确保最终答案与用户问题紧密相关且有依据。
本节将按步骤讲解如何使用 LangGraph 实现 Self-RAG。您将学习如何搭建环境、创建基础的知识向量库,并配置 Self-RAG 所需的关键组件,如检索评估器、问题重写器与网页搜索工具。
我们还将学习如何构建一个整合所有部件的 LangGraph 工作流,展示 Self-RAG 如何处理不同类型的查询,以获得更准确可靠的结果。
首先安装所需依赖包。此步骤用于搭建运行 Self-RAG 流水线的环境。
%pip install -U langchain_community tiktoken langchain-openai langchainhub chromadb langchain langgraph接着,配置您的 OpenAI API 密钥:
import os
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"为执行 RAG,我们首先需要一个包含文档的知识库。本步骤将从 Substack 新闻简报抓取示例文档,创建一个向量库,作为我们的代理知识库。该向量库可帮助基于用户查询找到相关文档。
我们先从提供的 URL 加载文档,并使用文本分割器将其拆分为更小的片段。随后使用 OpenAIEmbeddings 对这些片段进行嵌入,并存储到向量数据库(Chroma)中,以便高效检索。
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import WebBaseLoader
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings
urls = [
    "<https://ryanocm.substack.com/p/123-how-tiny-experiments-can-lead>",
    "<https://ryanocm.substack.com/p/122-life-razor-the-one-sentence-that>",
    "<https://ryanocm.substack.com/p/121-warren-buffetts-255-strategy>",
    "<https://ryanocm.substack.com/p/120-30-years-on-earth-11-habits-that>",
]
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    chunk_size=250, chunk_overlap=0
)
doc_splits = text_splitter.split_documents(docs_list)
# Add to vectorDB
vectorstore = Chroma.from_documents(
    documents=doc_splits,
    collection_name="rag-chroma",
    embedding=OpenAIEmbeddings(),
)
retriever = vectorstore.as_retriever()要高效实现 Self-RAG,我们需要多个各司其职的 LLM,并分别使用特定提示与数据模型。为避免重复编码,这里通过辅助函数来一致、可复用地创建 LLM 与结构化输出。
借助 create_structured_llm 辅助函数,我们可以用预定义的结构化输出模式初始化一个 LLM。
def create_structured_llm(model, schema):
    llm = ChatOpenAI(model=model, temperature=0)
    return llm.with_structured_output(schema)
create_grading_prompt 辅助函数便于为 Self-RAG 中使用的所有 LLM 生成提示。通过提供系统消息与人类模板,它会创建用于评估文档相关性、幻觉与回答质量的结构化提示。
def create_grading_prompt(system_message, human_template):
    return ChatPromptTemplate.from_messages([
        ("system", system_message),
        ("human", human_template),
    ])
最后,我们为许多评估模型采用一个简洁的二值评分模型以简化流程。无需为每个评估器创建单独的数据模型,而是定义统一的 BinaryScoreModel,以在不同评分任务间标准化输出。
class BinaryScoreModel(BaseModel):
binary_score: str = Field(description="Binary score: 'yes' or 'no'")在准备好辅助函数后,我们即可创建 Self-RAG 所需的关键 LLM 组件。这些组件用于评估检索文档、检测幻觉、评估回答有用性,并在需要时优化查询。
检索评估器用于判断检索到的文档是否与用户问题相关。它使用结构化的二值评分模型,基于关键词匹配与语义含义给出简单的“yes”或“no”。此步骤确保仅将有用文档用于生成。
retrieval_evaluator_llm = create_structured_llm("gpt-4o-mini", BinaryScoreModel)
retrieval_evaluator_prompt = create_grading_prompt(
    "You are a document retrieval evaluator responsible for checking the relevancy of a retrieved document to the user's question. \\n If the document contains keyword(s) or semantic meaning related to the question, grade it as relevant. \\n Output a binary score 'yes' or 'no'.",
    "Retrieved document: \\n\\n {document} \\n\\n User question: {question}"
)
retrieval_grader = retrieval_evaluator_prompt | retrieval_evaluator_llm即便文档相关,LLM 仍可能产生无依据的陈述。幻觉评估器检查生成回答是否以检索事实为依据,并过滤掉幻觉。同样使用二值评分模型。
hallucination_grader = create_grading_prompt(
    "You are a grader assessing whether an LLM generation is grounded in / supported by a set of retrieved facts. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer is grounded in / supported by the set of facts.",
    "Set of facts: \\n\\n {documents} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)即使回答相关且基于事实,若未充分解决用户问题仍然不够。答案评估器用于判断生成的回答是否直接回应用户意图,同样以“yes/ no”二值评分。
answer_grader = create_grading_prompt(
    "You are a grader assessing whether an answer addresses / resolves a question. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer resolves the question.",
    "User question: \\n\\n {question} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)当缺失相关文档时,重写查询可提升检索效果。问题重写器基于原始输入优化查询,以提高找到有用上下文的机会。
question_rewriter = create_grading_prompt(
    "You are a question re-writer that converts an input question to a better version optimized for vectorstore retrieval. Look at the input and try to reason about the underlying semantic intent / meaning.",
    "Here is the initial question: \\n\\n {question} \\n Formulate an improved question."
) | ChatOpenAI(model="gpt-4o-mini", temperature=0) | StrOutputParser()最后,RAG 链负责核心的检索增强生成流程。它格式化检索文档,将其注入 LLM 提示,并提取生成结果。
rag_prompt = hub.pull("rlm/rag-prompt")
rag_llm = ChatOpenAI(model_name="gpt-4o-mini", temperature=0)
def format_docs(docs):
    return "\\n\\n".join(doc.page_content for doc in docs)
rag_chain = rag_prompt | rag_llm | StrOutputParser()要用 LangGraph 构建 Self-RAG 工作流,请遵循以下四步:
创建一个共享状态,在工作流的节点之间传递数据。此状态将保存用户问题、检索文档与生成答案等变量。
from typing import List

from typing_extensions import TypedDict

class GraphState(TypedDict):
    """
    Represents the state of our graph.

    Attributes:
        question: question
        generation: LLM generation
        documents: list of documents
    """

    question: str
    generation: str
documents: List[str]在 LangGraph 工作流中,每个函数节点处理 Self-RAG 流水线中的特定任务,如检索文档、评估文档相关性、幻觉检查等。以下是各函数说明:
retrieve 函数从知识库中查找与用户问题相关的文档。它使用检索器对象(通常由预处理文档构建的向量库)。该函数接收包含用户问题的当前状态,调用检索器获取相关文档,并将文档添加回状态。
def retrieve(state):
    print("---RETRIEVE---")
    question = state["question"]
    documents = retriever.invoke(question)
    return {"documents": documents, "question": question}
generate 函数使用检索到的文档为用户问题生成回答。它与 RAG 链配合,将提示与语言模型结合。该函数接收检索文档与用户问题,经由 RAG 链处理后,将答案加入状态。
def generate(state):
    print("---GENERATE---")
    return {
        "documents": state["documents"],
        "question": state["question"],
        "generation": rag_chain.invoke({"context": state["documents"], "question": state["question"]})
    }
grade_documents 函数使用检索评估器检查每个检索文档与用户问题的相关度,确保仅将有用信息用于最终回答。该函数会对每个文档的相关度评分并过滤无用文档。同时更新状态(如设置 web_search 标记)以指示当大多数文档不相关时是否需要网页搜索。
def grade_documents(state):
    print("---CHECK DOCUMENT RELEVANCE TO QUESTION---")
    question = state["question"]
    documents = state["documents"]

    filtered_docs = [d for d in documents if retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score == "yes"]

    for d in documents:
        grade = retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score
        print(f"---GRADE: DOCUMENT {'RELEVANT' if grade == 'yes' else 'NOT RELEVANT'}---")

    return {"documents": filtered_docs, "question": question}
transform_query 函数在原始查询未找到相关文档时改写用户问题,以获得更佳的搜索结果。它利用问题重写器使问题更清晰、更具体。更好的问题将提升从知识库与网页搜索中找到有用文档的概率。
def transform_query(state):
    print("---TRANSFORM QUERY---")
return {"documents": state["documents"], "question": question_rewriter.invoke({"question": state["question"]})}在 Self-RAG 中,边函数通过在检索与生成流程的关键节点做出决策来控制执行流。不同于固定流水线的传统 RAG,Self-RAG 会根据检索文档与生成结果的质量动态调整。条件边如下:
decide_to_generate)该边函数评估检索文档是否足够相关以进入生成阶段。若未找到有用文档,则触发查询改写以优化检索,然后再次尝试;否则进入答案生成。
def decide_to_generate(state):
    print("---ASSESS GRADED DOCUMENTS---")
    if not state["documents"]:
        print("---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---")
        return "transform_query"
    print("---DECISION: GENERATE---")
return "generate"grade_generation_v_documents_and_question)该边函数评估生成回答的准确性与有用性。它首先检查是否存在幻觉;若回答未完全得到检索文档支持,则重试生成。若回答有依据但未充分解答问题,则回到查询改写以改进检索。
def grade_generation_v_documents_and_question(state):
    print("---CHECK HALLUCINATIONS---")

    hallucination_score = hallucination_grader.invoke({"documents": state["documents"], "generation": state["generation"]}).binary_score
    if hallucination_score == "yes":
        print("---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---")
        answer_score = answer_grader.invoke({"question": state["question"], "generation": state["generation"]}).binary_score
        if answer_score == "yes":
            print("---DECISION: GENERATION ADDRESSES QUESTION---")
            return "useful"
        print("---DECISION: GENERATION DOES NOT ADDRESS QUESTION---")
        return "not useful"
    print("---DECISION: GENERATION IS NOT GROUNDED IN DOCUMENTS, RE-TRY---")
return "not supported"定义完所有节点与边之后,我们即可在 LangGraph 工作流中将它们连接起来,构建 Self-RAG 流水线。即通过边连接节点以管理信息与决策的流动,确保工作流能依据各步骤结果正确运行。
from langgraph.graph import END, StateGraph, START

workflow = StateGraph(GraphState)

# Define the nodes
workflow.add_node("retrieve", retrieve)  # retrieve
workflow.add_node("grade_documents", grade_documents)  # grade documents
workflow.add_node("generate", generate)  # generatae
workflow.add_node("transform_query", transform_query)  # transform_query

# Build graph
workflow.add_edge(START, "retrieve")
workflow.add_edge("retrieve", "grade_documents")
workflow.add_conditional_edges(
    "grade_documents",
    decide_to_generate,
    {
        "transform_query": "transform_query",
        "generate": "generate",
    },
)
workflow.add_edge("transform_query", "retrieve")
workflow.add_conditional_edges(
    "generate",
    grade_generation_v_documents_and_question,
    {
        "not supported": "generate",
        "useful": END,
        "not useful": "transform_query",
    },
)

# Compile
app = workflow.compile()
from IPython.display import Image, display
try:
display(Image(app.get_graph(xray=True).draw_mermaid_png()))
except Exception:
# This requires some extra dependencies and is optional
pass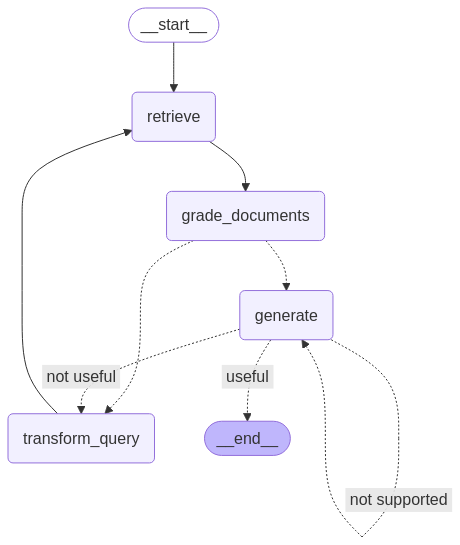
为测试我们的搭建效果,我们用示例查询运行工作流,检验其如何检索信息、评估文档相关性并生成回答。
第一个查询用于检验 Self-RAG 在其知识库中查找答案的能力。
res = app.invoke({"question": "How to improve relationships"})
print(res['generation'])
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: GENERATE---
---GENERATE---
---CHECK HALLUCINATIONS---
---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---
---DECISION: GENERATION ADDRESSES QUESTION---
To improve relationships, consider seeking therapy or life coaching,
as these can provide valuable insights and challenge your perspectives.
Engaging in one-on-one or group therapy can help you reflect on how your
past experiences shape your current interactions. Finding a therapist you
connect with can significantly enhance your understanding and growth in
relationships.第二个查询用于测试 Self-RAG 的反思能力:当知识库缺乏相关文档时,能否通过重写查询来改进。注意:基于我们设置的 LangGraph 流程,系统存在陷入无限循环的风险。为防止此问题,我们将递归上限设为 10。
更好的做法是实现重试上限:在尝试 N 次后,如仍未找到有用文档,系统应退出并告知用户无法找到答案。相比无限循环,这将带来更好的用户体验。
res = app.invoke({"question": "How to cook a bagel?"}, {"recursion_limit": 10})---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
GraphRecursionError: Recursion limit of 10 reached without hitting a stop condition. You can increase the limit by setting the recursion_limit config key.尽管 Self-RAG 优于传统 RAG,但也存在自身挑战。
主要挑战之一是计算速度与成本。反复的检索与优化循环需要大量算力,尤其在实时应用中可能会降低效率。
此外,由于 Self-RAG 依赖固定知识库而非网页搜索,当所需信息不存在时会遇到困难。在这种情况下,系统会在并不存在的信息上反复搜索,浪费时间与资源。
另一项挑战是保持事实准确性。尽管 Self-RAG 旨在自我优化回答,但仍可能检索并生成无关信息。在“过于含糊”与“过度细节”之间找到平衡也颇为棘手,且往往需要大量高质量数据与算力。
总体而言,Self-RAG 使 RAG 向自驱与代理式方向迈出重要一步。通过引入能转换查询、过滤无关文档并对自身答案迭代的反馈回路,Self-RAG 克服了传统 RAG 的诸多限制。
要进一步了解 Self-RAG,请查阅原论文 here。
用这些课程学习 AI!
课程
课程
实践并学习路径你的进步。
使用 Google 继续