
कोर्स
Weaviate के साथ एंड-टू-एंड RAG
2 घंटा
898
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंSelf-RAG क्रमिक तर्क और स्व-मूल्यांकन पेश करता है, जिससे सिस्टम उच्च-गुणवत्ता वाले उत्तर तक पहुँचने तक रिट्रीवल और जेनरेशन को गतिशील रूप से समायोजित कर सकता है। RAG को एक-बार के प्रोसेस की तरह देखने के बजाय, Self-RAG हर चरण में बेहतर निर्णय लेने के लिए फीडबैक लूप शामिल करता है।
Self-RAG प्रक्रिया में चार प्रमुख निर्णय शामिल होते हैं:
हर चरण में आत्म-चिंतन जोड़कर, Self-RAG रिट्रीवल को अधिक विश्वसनीय बनाता है, भ्रम (हैलुसिनेशन) को रोकता है, और सुनिश्चित करता है कि अंतिम उत्तर उपयोगकर्ता के प्रश्न से जुड़ा और प्रासंगिक हो।
इस खंड में, मैं बताऊँगा कि LangGraph का उपयोग करके Self-RAG को चरण-दर-चरण कैसे लागू करें। आप सीखेंगे कि अपना एनवायरनमेंट कैसे सेटअप करें, एक बेसिक नॉलेज वेक्टर स्टोर कैसे बनाएँ, और Self-RAG के लिए आवश्यक प्रमुख कंपोनेंट्स—जैसे रिट्रीवल इवैलुएटर, प्रश्न रीराइटर, और वेब सर्च टूल—कैसे कॉन्फ़िगर करें।
हम यह भी सीखेंगे कि इन सभी हिस्सों को एक साथ लाने वाला LangGraph वर्कफ़्लो कैसे बनाया जाए, जो दिखाएगा कि Self-RAG कैसे विभिन्न प्रकार की क्वेरी को अधिक सटीक और विश्वसनीय परिणामों के लिए संभाल सकता है।
सबसे पहले, आवश्यक पैकेज इंस्टॉल करें। यह चरण Self-RAG पाइपलाइन चलाने के लिए एनवायरनमेंट तैयार करता है।
%pip install -U langchain_community tiktoken langchain-openai langchainhub chromadb langchain langgraphइसके बाद, OpenAI के लिए अपनी API कुंजियाँ कॉन्फ़िगर करें:
import os
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"RAG करने के लिए, हमें पहले दस्तावेज़ों से भरा हुआ एक नॉलेज बेस चाहिए। इस चरण में, हम एक Substack न्यूज़लेटर से कुछ नमूना दस्तावेज़ स्क्रैप करेंगे ताकि एक वेक्टर स्टोर बनाया जा सके, जो हमारे प्रॉक्सी नॉलेज बेस के रूप में काम करेगा। यह वेक्टर स्टोर उपयोगकर्ता की क्वेरी के आधार पर प्रासंगिक दस्तावेज़ खोजने में मदद करता है।
हम दिए गए URLs से दस्तावेज़ लोड करके शुरू करते हैं और उन्हें टेक्स्ट स्प्लिटर का उपयोग करके छोटे हिस्सों में बाँटते हैं। इन हिस्सों को फिर एम्बेड किया जाता है OpenAIEmbeddings का उपयोग करके और एक वेक्टर डेटाबेस (Chroma) में कुशल दस्तावेज़ रिट्रीवल के लिए संग्रहीत किया जाता है।
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import WebBaseLoader
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings
urls = [
    "<https://ryanocm.substack.com/p/123-how-tiny-experiments-can-lead>",
    "<https://ryanocm.substack.com/p/122-life-razor-the-one-sentence-that>",
    "<https://ryanocm.substack.com/p/121-warren-buffetts-255-strategy>",
    "<https://ryanocm.substack.com/p/120-30-years-on-earth-11-habits-that>",
]
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    chunk_size=250, chunk_overlap=0
)
doc_splits = text_splitter.split_documents(docs_list)
# Add to vectorDB
vectorstore = Chroma.from_documents(
    documents=doc_splits,
    collection_name="rag-chroma",
    embedding=OpenAIEmbeddings(),
)
retriever = vectorstore.as_retriever()Self-RAG को प्रभावी ढंग से लागू करने के लिए, हमें कई LLMs की आवश्यकता होती है जिनकी अलग-अलग भूमिकाएँ हों, और प्रत्येक विशिष्ट प्रॉम्प्ट और डेटा मॉडल का उपयोग करे। कोड दोहराने के बजाय, यहाँ हम LLMs और संरचित आउटपुट को एक संगत, पुन: प्रयोज्य तरीके से बनाने के लिए हेल्पर फ़ंक्शन सेट कर रहे हैं।
create_structured_llm हेल्पर फ़ंक्शन के साथ, हम एक पूर्वनिर्धारित संरचित आउटपुट स्कीमा के साथ एक LLM को प्रारंभ कर सकते हैं।
def create_structured_llm(model, schema):
    llm = ChatOpenAI(model=model, temperature=0)
    return llm.with_structured_output(schema)
create_grading_prompt हेल्पर फ़ंक्शन Self-RAG में उपयोग किए गए सभी LLMs के लिए प्रॉम्प्ट बनाना आसान बनाता है। यह एक सिस्टम संदेश और एक ह्यूमन टेम्पलेट लेते हुए दस्तावेज़ प्रासंगिकता, हैलुसिनेशन, और प्रतिक्रिया गुणवत्ता का आकलन करने के लिए एक स्ट्रक्चर्ड प्रॉम्प्ट बनाता है।
def create_grading_prompt(system_message, human_template):
    return ChatPromptTemplate.from_messages([
        ("system", system_message),
        ("human", human_template),
    ])
अंत में, हम अपने कई LLM मॉडलों के लिए एक सरल बाइनरी स्कोरिंग मॉडल का उपयोग करके प्रक्रिया को सुव्यवस्थित करते हैं। प्रत्येक इवैलुएटर के लिए अलग डेटा मॉडल बनाने के बजाय, हम एक ही BinaryScoreModel परिभाषित करते हैं जो विभिन्न ग्रेडिंग कार्यों में आउटपुट को मानकीकृत करता है।
class BinaryScoreModel(BaseModel):
binary_score: str = Field(description="Binary score: 'yes' or 'no'")अब जब हमारे पास हेल्पर फ़ंक्शन हैं, तो हम Self-RAG के लिए आवश्यक प्रमुख LLM कंपोनेंट बना सकते हैं। ये कंपोनेंट रिट्रीव्ड दस्तावेज़ों का मूल्यांकन करते हैं, हैलुसिनेशन का पता लगाते हैं, प्रतिक्रिया की उपयोगिता ग्रेड करते हैं, और जरूरत पड़ने पर क्वेरी को परिष्कृत करते हैं।
रिट्रीवल इवैलुएटर यह निर्धारित करता है कि रिट्रीव्ड दस्तावेज़ उपयोगकर्ता के प्रश्न से संबंधित है या नहीं। एक संरचित बाइनरी स्कोरिंग मॉडल का उपयोग करके, यह कीवर्ड मिलान और सैमांटिक अर्थ के आधार पर साधारण "yes" या "no" असाइन करता है। यह चरण सुनिश्चित करता है कि केवल उपयोगी दस्तावेज़ों का जेनरेशन में उपयोग हो।
retrieval_evaluator_llm = create_structured_llm("gpt-4o-mini", BinaryScoreModel)
retrieval_evaluator_prompt = create_grading_prompt(
    "You are a document retrieval evaluator responsible for checking the relevancy of a retrieved document to the user's question. \\n If the document contains keyword(s) or semantic meaning related to the question, grade it as relevant. \\n Output a binary score 'yes' or 'no'.",
    "Retrieved document: \\n\\n {document} \\n\\n User question: {question}"
)
retrieval_grader = retrieval_evaluator_prompt | retrieval_evaluator_llmप्रासंगिक दस्तावेज़ों के बावजूद, LLMs असमर्थित दावे कर सकते हैं। हैलुसिनेशन ग्रेडर यह जाँचता है कि जनरेट किया गया उत्तर रिट्रीव्ड तथ्यों पर आधारित है या नहीं, और किसी भी हैलुसिनेशन को फ़िल्टर करता है। यह भी बाइनरी ग्रेडिंग मॉडल का पालन करता है।
hallucination_grader = create_grading_prompt(
    "You are a grader assessing whether an LLM generation is grounded in / supported by a set of retrieved facts. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer is grounded in / supported by the set of facts.",
    "Set of facts: \\n\\n {documents} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)यदि प्रतिक्रिया प्रासंगिक और तथ्य-आधारित है, तब भी यह पर्याप्त नहीं है यदि वह उपयोगकर्ता के प्रश्न का पूरा उत्तर नहीं देती। आंसर ग्रेडर बाइनरी "yes" या "no" स्कोर का उपयोग करके यह मूल्यांकन करता है कि जनरेट की गई प्रतिक्रिया सीधे उपयोगकर्ता के आशय को संबोधित करती है या नहीं।
answer_grader = create_grading_prompt(
    "You are a grader assessing whether an answer addresses / resolves a question. \\
 Give a binary score 'yes' or 'no'. 'Yes' means that the answer resolves the question.",
    "User question: \\
\\n {question} \\
\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)जब प्रासंगिक दस्तावेज़ नहीं मिलते, तो क्वेरी को पुनः लिखना रिट्रीवल में सुधार कर सकता है। क्वेश्चन रीराइटर मूल उपयोगकर्ता इनपुट को लेकर उसे बेहतर दस्तावेज़ रिट्रीवल के लिए ऑप्टिमाइज़ करता है, ताकि सिस्टम को उपयोगी संदर्भ मिलने की अधिकतम संभावना हो।
question_rewriter = create_grading_prompt(
    "You are a question re-writer that converts an input question to a better version optimized for vectorstore retrieval. Look at the input and try to reason about the underlying semantic intent / meaning.",
    "Here is the initial question: \\
\\n {question} \\
 Formulate an improved question."
) | ChatOpenAI(model="gpt-4o-mini", temperature=0) | StrOutputParser()अंत में, RAG चेन कोर रिट्रीवल-ऑगमेंटेड जेनरेशन प्रक्रिया को संभालता है। यह रिट्रीव्ड दस्तावेज़ों को फ़ॉर्मैट करता है, उन्हें LLM प्रॉम्प्ट में फ़ीड करता है, और जनरेट की गई प्रतिक्रिया निकालता है।
rag_prompt = hub.pull("rlm/rag-prompt")
rag_llm = ChatOpenAI(model_name="gpt-4o-mini", temperature=0)
def format_docs(docs):
    return "\\n\\n".join(doc.page_content for doc in docs)
rag_chain = rag_prompt | rag_llm | StrOutputParser()LangGraph के साथ Self-RAG वर्कफ़्लो बनाने के लिए, इन चार मुख्य चरणों का पालन करें:
वर्कफ़्लो के दौरान नोड्स के बीच चलते समय डेटा संग्रहीत करने के लिए एक साझा स्टेट बनाएँ। यह स्टेट उपयोगकर्ता के प्रश्न, रिट्रीव्ड दस्तावेज़, और जनरेट किए गए उत्तर जैसी सभी वेरिएबल्स रखेगा।
from typing import List

from typing_extensions import TypedDict

class GraphState(TypedDict):
    """
    Represents the state of our graph.

    Attributes:
        question: question
        generation: LLM generation
        documents: list of documents
    """

    question: str
    generation: str
documents: List[str]LangGraph वर्कफ़्लो में, प्रत्येक फ़ंक्शन नोड Self-RAG पाइपलाइन में एक विशिष्ट कार्य संभालता है, जैसे दस्तावेज़ रिट्रीवल, दस्तावेज़ प्रासंगिकता का मूल्यांकन, हैलुसिनेशन जाँच, आदि। प्रत्येक फ़ंक्शन का विवरण इस प्रकार है:
retrieve फ़ंक्शन नॉलेज बेस से उपयोगकर्ता के प्रश्न से संबंधित दस्तावेज़ ढूँढता है। यह एक रिट्रीवर ऑब्जेक्ट का उपयोग करता है, जो आमतौर पर प्री-प्रोसेस्ड दस्तावेज़ों से बनाए गए वेक्टर स्टोर से बनता है। यह फ़ंक्शन वर्तमान स्टेट (जिसमें उपयोगकर्ता का प्रश्न शामिल है) लेता है, रिट्रीवर से प्रासंगिक दस्तावेज़ लेता है, और इन्हें स्टेट में जोड़ता है।
def retrieve(state):
    print("---RETRIEVE---")
    question = state["question"]
    documents = retriever.invoke(question)
    return {"documents": documents, "question": question}
generate फ़ंक्शन रिट्रीव्ड दस्तावेज़ों का उपयोग करके उपयोगकर्ता के प्रश्न का उत्तर जनरेट करता है। यह RAG चेन के साथ काम करता है, जो एक प्रॉम्प्ट को भाषा मॉडल के साथ जोड़ता है। यह फ़ंक्शन रिट्रीव्ड दस्तावेज़ और उपयोगकर्ता का प्रश्न लेता है, उन्हें RAG चेन से प्रोसेस करता है, और फिर उत्तर स्टेट में जोड़ता है।
def generate(state):
    print("---GENERATE---")
    return {
        "documents": state["documents"],
        "question": state["question"],
        "generation": rag_chain.invoke({"context": state["documents"], "question": state["question"]})
    }
grade_documents फ़ंक्शन रिट्रीवल इवैलुएटर का उपयोग करके प्रत्येक रिट्रीव्ड दस्तावेज़ की उपयोगकर्ता के प्रश्न के प्रति प्रासंगिकता जाँचता है। इससे सुनिश्चित होता है कि अंतिम उत्तर के लिए केवल उपयोगी जानकारी ही उपयोग हो। यह फ़ंक्शन प्रत्येक दस्तावेज़ की प्रासंगिकता रेट करता है और जो उपयोगी नहीं हैं उन्हें फ़िल्टर करता है। यह स्टेट को web_search फ़्लैग के साथ भी अपडेट करता है ताकि दिखाया जा सके कि जब अधिकांश दस्तावेज़ प्रासंगिक न हों तो वेब सर्च की आवश्यकता है।
def grade_documents(state):
    print("---CHECK DOCUMENT RELEVANCE TO QUESTION---")
    question = state["question"]
    documents = state["documents"]

    filtered_docs = [d for d in documents if retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score == "yes"]

    for d in documents:
        grade = retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score
        print(f"---GRADE: DOCUMENT {'RELEVANT' if grade == 'yes' else 'NOT RELEVANT'}---")

    return {"documents": filtered_docs, "question": question}
transform_query फ़ंक्शन उपयोगकर्ता के प्रश्न में सुधार करता है ताकि बेहतर सर्च परिणाम मिल सकें, खासकर तब जब मूल क्वेरी से प्रासंगिक दस्तावेज़ न मिलें। यह प्रश्न रीराइटर का उपयोग करके प्रश्न को अधिक स्पष्ट और विशिष्ट बनाता है। बेहतर प्रश्न नॉलेज बेस और वेब सर्च दोनों से उपयोगी दस्तावेज़ मिलने की संभावना बढ़ाता है।
def transform_query(state):
    print("---TRANSFORM QUERY---")
return {"documents": state["documents"], "question": question_rewriter.invoke({"question": state["question"]})}Self-RAG में, एज फ़ंक्शन रिट्रीवल और जेनरेशन प्रक्रिया के प्रत्येक चरण में प्रमुख निर्णय लेकर निष्पादन के प्रवाह को नियंत्रित करते हैं। पारंपरिक RAG, जो एक फिक्स्ड पाइपलाइन का अनुसरण करता है, के विपरीत, Self-RAG रिट्रीव्ड दस्तावेज़ों और जनरेटेड प्रतिक्रियाओं की गुणवत्ता के आधार पर गतिशील रूप से अनुकूलित होता है। ये कंडीशनल एज इस प्रकार हैं:
decide_to_generate)यह एज फ़ंक्शन आकलन करता है कि रिट्रीव्ड दस्तावेज़ जेनरेशन के लिए पर्याप्त रूप से प्रासंगिक हैं या नहीं। यदि कोई उपयोगी दस्तावेज़ नहीं मिलते, तो यह सर्च को परिष्कृत करने के लिए क्वेरी ट्रांसफॉर्मेशन को ट्रिगर करता है ताकि फिर से रिट्रीवल हो सके। अन्यथा, यह उत्तर जेनरेशन की ओर बढ़ता है।
def decide_to_generate(state):
    print("---ASSESS GRADED DOCUMENTS---")
    if not state["documents"]:
        print("---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---")
        return "transform_query"
    print("---DECISION: GENERATE---")
return "generate"grade_generation_v_documents_and_question)यह एज फ़ंक्शन जनरेटेड प्रतिक्रिया की सटीकता और उपयोगिता का मूल्यांकन करता है। यह पहले हैलुसिनेशन की जाँच करता है; यदि प्रतिक्रिया रिट्रीव्ड दस्तावेज़ों द्वारा पूरी तरह समर्थित नहीं है, तो यह जेनरेशन को फिर से आज़माता है। यदि प्रतिक्रिया आधारित है लेकिन प्रश्न का पूरा उत्तर नहीं देती, तो यह रिट्रीवल को बेहतर बनाने के लिए क्वेरी रिफाइनमेंट पर वापस जाता है।
def grade_generation_v_documents_and_question(state):
    print("---CHECK HALLUCINATIONS---")

    hallucination_score = hallucination_grader.invoke({"documents": state["documents"], "generation": state["generation"]}).binary_score
    if hallucination_score == "yes":
        print("---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---")
        answer_score = answer_grader.invoke({"question": state["question"], "generation": state["generation"]}).binary_score
        if answer_score == "yes":
            print("---DECISION: GENERATION ADDRESSES QUESTION---")
            return "useful"
        print("---DECISION: GENERATION DOES NOT ADDRESS QUESTION---")
        return "not useful"
    print("---DECISION: GENERATION IS NOT GROUNDED IN DOCUMENTS, RE-TRY---")
return "not supported"जब सभी नोड और एज परिभाषित हो जाएँ, तब हम LangGraph वर्कफ़्लो में इन्हें जोड़कर Self-RAG पाइपलाइन बना सकते हैं। इसका अर्थ है सूचनाओं और निर्णयों के प्रवाह को प्रबंधित करने के लिए नोड्स को एज के साथ कनेक्ट करना, ताकि प्रत्येक चरण के परिणाम के आधार पर वर्कफ़्लो सही ढंग से चले।
from langgraph.graph import END, StateGraph, START

workflow = StateGraph(GraphState)

# Define the nodes
workflow.add_node("retrieve", retrieve)  # retrieve
workflow.add_node("grade_documents", grade_documents)  # grade documents
workflow.add_node("generate", generate)  # generatae
workflow.add_node("transform_query", transform_query)  # transform_query

# Build graph
workflow.add_edge(START, "retrieve")
workflow.add_edge("retrieve", "grade_documents")
workflow.add_conditional_edges(
    "grade_documents",
    decide_to_generate,
    {
        "transform_query": "transform_query",
        "generate": "generate",
    },
)
workflow.add_edge("transform_query", "retrieve")
workflow.add_conditional_edges(
    "generate",
    grade_generation_v_documents_and_question,
    {
        "not supported": "generate",
        "useful": END,
        "not useful": "transform_query",
    },
)

# Compile
app = workflow.compile()
from IPython.display import Image, display
try:
display(Image(app.get_graph(xray=True).draw_mermaid_png()))
except Exception:
# This requires some extra dependencies and is optional
pass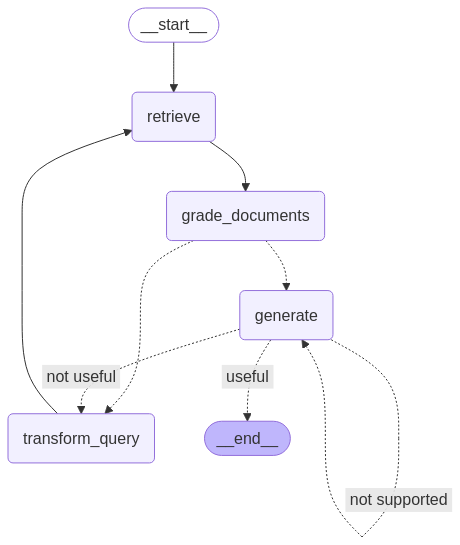
हमारे सेटअप का परीक्षण करने के लिए, हम नमूना क्वेरी के साथ वर्कफ़्लो चलाते हैं ताकि देखा जा सके कि यह जानकारी कैसे रिट्रीव करता है, दस्तावेज़ प्रासंगिकता का आकलन कैसे करता है, और प्रतिक्रियाएँ कैसे जनरेट करता है।
पहली क्वेरी यह जाँचती है कि Self-RAG अपने नॉलेज बेस के भीतर उत्तर कितनी अच्छी तरह ढूँढता है।
res = app.invoke({"question": "How to improve relationships"})
print(res['generation'])
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: GENERATE---
---GENERATE---
---CHECK HALLUCINATIONS---
---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---
---DECISION: GENERATION ADDRESSES QUESTION---
To improve relationships, consider seeking therapy or life coaching,
as these can provide valuable insights and challenge your perspectives.
Engaging in one-on-one or group therapy can help you reflect on how your
past experiences shape your current interactions. Finding a therapist you
connect with can significantly enhance your understanding and growth in
relationships.और दूसरी क्वेरी यह परखती है कि जब नॉलेज बेस में प्रासंगिक दस्तावेज़ नहीं होते, तब Self-RAG क्वेरी को पुनर्लिखकर कैसे आत्म-चिंतन करता है। ध्यान दें कि जिस तरह हमने LangGraph फ्लो सेट किया है, उसमें सिस्टम के अनंत लूप में फँसने का जोखिम है। इसे रोकने के लिए, हमने रिकर्शन लिमिट 10 रखी है।
एक बेहतर तरीका यह हो सकता है कि रीट्राई लिमिट लागू की जाए; N प्रयासों के बाद, यदि कोई उपयोगी दस्तावेज़ नहीं मिलते, तो सिस्टम को बाहर निकलकर उपयोगकर्ता को सूचित करना चाहिए कि उत्तर नहीं मिल सका। यह अनिश्चित काल तक लूप करने के बजाय बेहतर उपयोगकर्ता अनुभव होगा।
res = app.invoke({"question": "How to cook a bagel?"}, {"recursion_limit": 10})---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
GraphRecursionError: Recursion limit of 10 reached without hitting a stop condition. You can increase the limit by setting the recursion_limit config key.हालाँकि Self-RAG पारंपरिक RAG में सुधार करता है, इसकी अपनी चुनौतियाँ भी हैं।
एक मुख्य चुनौती इसका कम्प्यूटेशनल स्पीड और लागत है। रिट्रीवल और रिफाइनमेंट के बार-बार के चक्रों के लिए पर्याप्त प्रोसेसिंग पावर की आवश्यकता होती है, जो विशेष रूप से रियल-टाइम एप्लिकेशन में चीजों को धीमा कर सकती है।
इसके अलावा, चूँकि Self-RAG वेब सर्च के बजाय एक फिक्स्ड नॉलेज बेस पर निर्भर करता है, जब आवश्यक जानकारी उपलब्ध नहीं होती तब इसे कठिनाई हो सकती है। ऐसे मामलों में, सिस्टम ऐसी चीज़ की तलाश में बार-बार समय और संसाधन बर्बाद करता है जो वहाँ होती ही नहीं।
एक और चुनौती तथ्यात्मक सटीकता बनाए रखना है। भले ही Self-RAG अपने उत्तरों को परिष्कृत करने के लिए डिज़ाइन किया गया है, फिर भी यह अप्रासंगिक जानकारी रिट्रीव और जनरेट कर सकता है। सिस्टम को बहुत अस्पष्ट और अत्यधिक विस्तृत होने के बीच संतुलित करने के लिए फाइन-ट्यून करना भी मुश्किल है, क्योंकि इसके लिए बहुत अधिक उच्च-गुणवत्ता वाले डेटा और कम्प्यूटेशनल शक्ति की आवश्यकता होती है।
कुल मिलाकर, Self-RAG RAG में एक बड़ा कदम है, जो इसे अधिक स्व-चालित और अधिक एजेंटिक बनाता है। क्वेरी को ट्रांसफॉर्म करने, अप्रासंगिक दस्तावेज़ों को फ़िल्टर करने, और अपने उत्तरों पर पुनरावृत्ति करने वाला फीडबैक लूप जोड़कर, Self-RAG पारंपरिक RAG की कई सीमाओं को पार कर जाता है।
Self-RAG के बारे में और जानने के लिए, मूल पेपर देखें यहाँ।
इन कोर्सेज़ के साथ AI सीखें!
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें