

Apa Itu Self-RAG?
Self-RAG memperkenalkan penalaran iteratif dan evaluasi mandiri, memungkinkan sistem untuk menyesuaikan proses pengambilan dan generasi secara dinamis hingga respons berkualitas tinggi tercapai. Alih-alih memperlakukan RAG sebagai proses satu kali, self-RAG memasukkan loop umpan balik untuk membuat keputusan yang lebih cerdas di setiap langkah.
Proses Self-RAG melibatkan empat keputusan utama:
- Haruskah dilakukan retrieval?
- Sistem terlebih dahulu memutuskan apakah akan mengambil dokumen berdasarkan pertanyaan saja atau berdasarkan upaya jawaban awal. Ini menghindari pengambilan yang tidak perlu dan memungkinkan adaptasi dinamis.
- Apakah dokumen yang diambil relevan?
- Setiap dokumen yang diambil dievaluasi secara independen untuk relevansinya. Jika dokumen tidak berguna untuk menjawab kueri, dokumen tersebut dibuang sebelum tahap generasi.
- Apakah respons yang dihasilkan berlandaskan dokumen yang diambil?
- Setelah menghasilkan jawaban, sistem memeriksa apakah semua klaim dalam respons didukung oleh konten yang diambil. Jika ditemukan pernyataan yang tidak didukung, sistem dapat mencoba memperbaiki respons.
- Apakah respons benar-benar menjawab pertanyaan pengguna?
- Meski jawaban benar secara faktual, bisa jadi tidak sepenuhnya menjawab pertanyaan pengguna. Berdasarkan jawaban dan pertanyaan pengguna, sistem akan memprediksi apakah jawaban akhir berguna atau tidak (biner) dan memutuskan untuk membuat ulang atau berhenti.
Dengan memperkenalkan refleksi diri di setiap langkah, Self-RAG membuat retrieval lebih andal, mencegah halusinasi, dan memastikan jawaban akhir berlandaskan dan relevan dengan pertanyaan pengguna.
Implementasi Self-RAG Menggunakan LangGraph
Pada bagian ini, saya akan menjelaskan langkah demi langkah cara mengimplementasikan self-RAG menggunakan LangGraph. Anda akan mempelajari cara menyiapkan lingkungan, membuat knowledge vector store dasar, dan mengonfigurasi komponen kunci yang dibutuhkan untuk self-RAG, seperti evaluator retrieval, penulis ulang pertanyaan, dan alat pencarian web.
Kita juga akan mempelajari cara membangun alur kerja LangGraph yang menyatukan semua bagian ini, menunjukkan bagaimana self-RAG dapat menangani berbagai jenis kueri untuk hasil yang lebih akurat dan andal.
Langkah 1: Penyiapan dan instalasi
Pertama, instal paket yang diperlukan. Langkah ini menyiapkan lingkungan untuk menjalankan pipeline Self-RAG.
%pip install -U langchain_community tiktoken langchain-openai langchainhub chromadb langchain langgraphSelanjutnya, konfigurasikan kunci API Anda untuk OpenAI:
import os
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"Langkah 2: Menyiapkan basis pengetahuan proxy
Untuk melakukan RAG, pertama-tama kita memerlukan basis pengetahuan yang berisi dokumen. Pada langkah ini, kita akan mengambil beberapa dokumen contoh dari buletin Substack untuk membuat vector store, yang bertindak sebagai basis pengetahuan proxy kita. Vector store ini membantu kita menemukan dokumen relevan berdasarkan kueri pengguna.
Kita mulai dengan memuat dokumen dari URL yang disediakan dan membaginya menjadi bagian-bagian kecil menggunakan pemisah teks. Bagian-bagian ini kemudian di-embed menggunakan OpenAIEmbeddings dan disimpan dalam sebuah basis data vektor (Chroma) untuk pengambilan dokumen yang efisien.
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import WebBaseLoader
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings
urls = [
"<https://ryanocm.substack.com/p/123-how-tiny-experiments-can-lead>",
"<https://ryanocm.substack.com/p/122-life-razor-the-one-sentence-that>",
"<https://ryanocm.substack.com/p/121-warren-buffetts-255-strategy>",
"<https://ryanocm.substack.com/p/120-30-years-on-earth-11-habits-that>",
]
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
chunk_size=250, chunk_overlap=0
)
doc_splits = text_splitter.split_documents(docs_list)
# Add to vectorDB
vectorstore = Chroma.from_documents(
documents=doc_splits,
collection_name="rag-chroma",
embedding=OpenAIEmbeddings(),
)
retriever = vectorstore.as_retriever()Langkah 3: Menyiapkan fungsi pembantu
Untuk mengimplementasikan Self-RAG secara efektif, kita memerlukan beberapa LLM dengan peran berbeda, masing-masing menggunakan prompt dan model data khusus. Alih-alih menduplikasi kode, di sini kita menyiapkan fungsi pembantu untuk membuat LLM dan keluaran terstruktur dengan cara yang konsisten dan dapat digunakan ulang.
Dengan fungsi pembantu create_structured_llm, kita dapat menginisialisasi LLM dengan skema keluaran terstruktur yang telah ditentukan.
def create_structured_llm(model, schema):
llm = ChatOpenAI(model=model, temperature=0)
return llm.with_structured_output(schema)Fungsi pembantu create_grading_prompt memudahkan pembuatan prompt untuk semua LLM yang digunakan dalam self-RAG. Dengan mengambil pesan sistem dan templat manusia, fungsi ini membuat prompt terstruktur untuk mengevaluasi relevansi dokumen, halusinasi, dan kualitas respons.
def create_grading_prompt(system_message, human_template):
return ChatPromptTemplate.from_messages([
("system", system_message),
("human", human_template),
])Terakhir, kita menyederhanakan proses dengan menggunakan model penilaian biner sederhana untuk banyak model LLM kita. Alih-alih membuat model data terpisah untuk setiap evaluator, kita mendefinisikan satu BinaryScoreModel yang menstandarkan keluaran di berbagai tugas penilaian.
class BinaryScoreModel(BaseModel):
binary_score: str = Field(description="Binary score: 'yes' or 'no'")Langkah 4: Membangun komponen inti LLM
Setelah kita memiliki fungsi pembantu, kita dapat membuat komponen LLM kunci yang dibutuhkan untuk Self-RAG. Komponen ini mengevaluasi dokumen yang diambil, mendeteksi halusinasi, menilai kegunaan respons, dan menyempurnakan kueri saat diperlukan.
Evaluator retrieval
Evaluator retrieval menentukan apakah dokumen yang diambil relevan dengan pertanyaan pengguna. Dengan menggunakan model penilaian biner terstruktur, ia memberikan "ya" atau "tidak" sederhana berdasarkan pencocokan kata kunci dan makna semantik. Langkah ini memastikan hanya dokumen yang berguna yang digunakan untuk generasi.
retrieval_evaluator_llm = create_structured_llm("gpt-4o-mini", BinaryScoreModel)
retrieval_evaluator_prompt = create_grading_prompt(
"You are a document retrieval evaluator responsible for checking the relevancy of a retrieved document to the user's question. \\n If the document contains keyword(s) or semantic meaning related to the question, grade it as relevant. \\n Output a binary score 'yes' or 'no'.",
"Retrieved document: \\n\\n {document} \\n\\n User question: {question}"
)
retrieval_grader = retrieval_evaluator_prompt | retrieval_evaluator_llmHallucination grader
Bahkan dengan dokumen yang relevan, LLM masih dapat menghasilkan klaim yang tidak didukung. Hallucination grader memeriksa apakah respons yang dihasilkan berlandaskan pada fakta yang diambil, menyaring halusinasi. Komponen ini juga mengikuti model penilaian biner.
hallucination_grader = create_grading_prompt(
"You are a grader assessing whether an LLM generation is grounded in / supported by a set of retrieved facts. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer is grounded in / supported by the set of facts.",
"Set of facts: \\n\\n {documents} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)Answer grader
Respons yang relevan dan berbasis fakta tidaklah cukup jika tidak sepenuhnya menjawab pertanyaan pengguna. Answer grader mengevaluasi apakah respons yang dihasilkan secara langsung menjawab maksud pengguna, lagi-lagi menggunakan skor biner "ya" atau "tidak".
answer_grader = create_grading_prompt(
"You are a grader assessing whether an answer addresses / resolves a question. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer resolves the question.",
"User question: \\n\\n {question} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)Penulis ulang pertanyaan
Saat dokumen relevan tidak ditemukan, merumuskan ulang kueri dapat meningkatkan retrieval. Penulis ulang pertanyaan mengambil masukan asli pengguna dan mengoptimalkannya untuk pengambilan dokumen yang lebih baik, memastikan sistem memiliki peluang terbaik untuk menemukan konteks yang berguna.
question_rewriter = create_grading_prompt(
"You are a question re-writer that converts an input question to a better version optimized for vectorstore retrieval. Look at the input and try to reason about the underlying semantic intent / meaning.",
"Here is the initial question: \\n\\n {question} \\n Formulate an improved question."
) | ChatOpenAI(model="gpt-4o-mini", temperature=0) | StrOutputParser()Rantai RAG
Terakhir, rantai RAG menangani proses inti retrieval-augmented generation. Ia memformat dokumen yang diambil, memasukkannya ke dalam prompt LLM, dan mengekstrak respons yang dihasilkan.
rag_prompt = hub.pull("rlm/rag-prompt")
rag_llm = ChatOpenAI(model_name="gpt-4o-mini", temperature=0)
def format_docs(docs):
return "\\n\\n".join(doc.page_content for doc in docs)
rag_chain = rag_prompt | rag_llm | StrOutputParser()Langkah 5: Menyiapkan alur kerja LangGraph
Untuk membangun alur kerja Self-RAG dengan LangGraph, ikuti empat langkah utama berikut:
- Definisikan state graf
- Definisikan fungsi node
- Definisikan fungsi edge
- Hubungkan semua node dan edge
Definisikan state graf
Buat state bersama untuk menyimpan data saat berpindah antar node selama alur kerja. State ini akan menampung semua variabel, seperti pertanyaan pengguna, dokumen yang diambil, dan jawaban yang dihasilkan.
from typing import List
from typing_extensions import TypedDict
class GraphState(TypedDict):
"""
Represents the state of our graph.
Attributes:
question: question
generation: LLM generation
documents: list of documents
"""
question: str
generation: str
documents: List[str]Definisikan fungsi node
Dalam alur kerja LangGraph, setiap fungsi node menangani tugas spesifik dalam pipeline Self-RAG, seperti mengambil dokumen, mengevaluasi relevansi dokumen, pemeriksaan halusinasi, dan sebagainya. Berikut rincian setiap fungsi:
Fungsi retrieve menemukan dokumen dari basis pengetahuan yang relevan dengan pertanyaan pengguna. Ia menggunakan objek retriever, yang biasanya berupa vector store yang dibuat dari dokumen pra-proses. Fungsi ini mengambil state saat ini, termasuk pertanyaan pengguna, dan menggunakan retriever untuk mendapatkan dokumen relevan. Lalu menambahkan dokumen ini ke state.
def retrieve(state):
print("---RETRIEVE---")
question = state["question"]
documents = retriever.invoke(question)
return {"documents": documents, "question": question}Fungsi generate membuat respons terhadap pertanyaan pengguna menggunakan dokumen yang diambil. Ia bekerja dengan rantai RAG, yang menggabungkan prompt dengan model bahasa. Fungsi ini mengambil dokumen yang diambil dan pertanyaan pengguna, memprosesnya melalui rantai RAG, lalu menambahkan jawaban ke state.
def generate(state):
print("---GENERATE---")
return {
"documents": state["documents"],
"question": state["question"],
"generation": rag_chain.invoke({"context": state["documents"], "question": state["question"]})
}Fungsi grade_documents memeriksa seberapa relevan setiap dokumen yang diambil terhadap pertanyaan pengguna menggunakan evaluator retrieval. Ini membantu memastikan hanya informasi yang berguna yang digunakan untuk jawaban akhir. Fungsi ini menilai relevansi tiap dokumen dan menyaring yang tidak berguna. Ia juga memperbarui state dengan flag web_search untuk menunjukkan apakah pencarian web diperlukan saat sebagian besar dokumen tidak relevan.
def grade_documents(state):
print("---CHECK DOCUMENT RELEVANCE TO QUESTION---")
question = state["question"]
documents = state["documents"]
filtered_docs = [d for d in documents if retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score == "yes"]
for d in documents:
grade = retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score
print(f"---GRADE: DOCUMENT {'RELEVANT' if grade == 'yes' else 'NOT RELEVANT'}---")
return {"documents": filtered_docs, "question": question}Fungsi transform_query menyempurnakan pertanyaan pengguna untuk mendapatkan hasil pencarian yang lebih baik, terutama jika kueri asli tidak menemukan dokumen relevan. Ia menggunakan penulis ulang pertanyaan untuk membuat pertanyaan lebih jelas dan spesifik. Pertanyaan yang lebih baik meningkatkan peluang menemukan dokumen berguna dari basis pengetahuan maupun pencarian web.
def transform_query(state):
print("---TRANSFORM QUERY---")
return {"documents": state["documents"], "question": question_rewriter.invoke({"question": state["question"]})}Definisikan fungsi edge
Dalam self-RAG, fungsi edge mengontrol alur eksekusi dengan membuat keputusan kunci di setiap langkah proses retrieval dan generasi. Tidak seperti RAG tradisional yang mengikuti pipeline tetap, self-RAG beradaptasi secara dinamis berdasarkan kualitas dokumen yang diambil dan respons yang dihasilkan. Edge bersyarat ini sebagai berikut:
Memutuskan untuk mengambil lagi atau menghasilkan (decide_to_generate)
Fungsi edge ini menilai apakah dokumen yang diambil cukup relevan untuk melanjutkan ke tahap generasi. Jika tidak ada dokumen yang berguna, ia memicu transformasi kueri untuk menyempurnakan pencarian sebelum upaya retrieval berikutnya. Jika tidak, alur dilanjutkan ke pembuatan jawaban.
def decide_to_generate(state):
print("---ASSESS GRADED DOCUMENTS---")
if not state["documents"]:
print("---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---")
return "transform_query"
print("---DECISION: GENERATE---")
return "generate"Memvalidasi jawaban yang dihasilkan (grade_generation_v_documents_and_question)
Fungsi edge ini mengevaluasi akurasi dan kegunaan respons yang dihasilkan. Pertama, ia memeriksa halusinasi; jika respons tidak sepenuhnya didukung oleh dokumen yang diambil, sistem mencoba generasi ulang. Jika respons berlandaskan dokumen namun belum sepenuhnya menjawab pertanyaan, alur kembali ke penyempurnaan kueri untuk meningkatkan retrieval.
def grade_generation_v_documents_and_question(state):
print("---CHECK HALLUCINATIONS---")
hallucination_score = hallucination_grader.invoke({"documents": state["documents"], "generation": state["generation"]}).binary_score
if hallucination_score == "yes":
print("---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---")
answer_score = answer_grader.invoke({"question": state["question"], "generation": state["generation"]}).binary_score
if answer_score == "yes":
print("---DECISION: GENERATION ADDRESSES QUESTION---")
return "useful"
print("---DECISION: GENERATION DOES NOT ADDRESS QUESTION---")
return "not useful"
print("---DECISION: GENERATION IS NOT GROUNDED IN DOCUMENTS, RE-TRY---")
return "not supported"Hubungkan semua node dan edge
Setelah semua node dan edge didefinisikan, kita dapat menghubungkannya dalam alur kerja LangGraph untuk membangun pipeline Self-RAG. Ini berarti menghubungkan node dengan edge untuk mengelola aliran informasi dan keputusan, memastikan alur kerja berjalan dengan benar berdasarkan hasil setiap langkah.
from langgraph.graph import END, StateGraph, START
workflow = StateGraph(GraphState)
# Define the nodes
workflow.add_node("retrieve", retrieve) # retrieve
workflow.add_node("grade_documents", grade_documents) # grade documents
workflow.add_node("generate", generate) # generatae
workflow.add_node("transform_query", transform_query) # transform_query
# Build graph
workflow.add_edge(START, "retrieve")
workflow.add_edge("retrieve", "grade_documents")
workflow.add_conditional_edges(
"grade_documents",
decide_to_generate,
{
"transform_query": "transform_query",
"generate": "generate",
},
)
workflow.add_edge("transform_query", "retrieve")
workflow.add_conditional_edges(
"generate",
grade_generation_v_documents_and_question,
{
"not supported": "generate",
"useful": END,
"not useful": "transform_query",
},
)
# Compile
app = workflow.compile()from IPython.display import Image, display
try:
display(Image(app.get_graph(xray=True).draw_mermaid_png()))
except Exception:
# This requires some extra dependencies and is optional
pass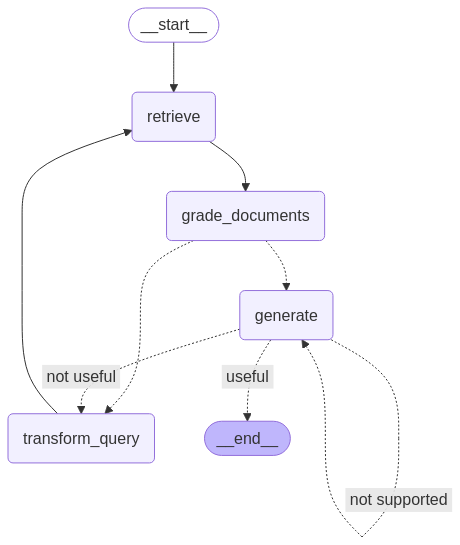
Langkah 6: Menguji alur kerja
Untuk menguji setelan kita, jalankan alur kerja dengan kueri contoh untuk memeriksa bagaimana ia mengambil informasi, mengevaluasi relevansi dokumen, dan menghasilkan respons.
Kueri pertama memeriksa seberapa baik Self-RAG menemukan jawaban dalam basis pengetahuannya.
res = app.invoke({"question": "How to improve relationships"})
print(res['generation'])---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: GENERATE---
---GENERATE---
---CHECK HALLUCINATIONS---
---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---
---DECISION: GENERATION ADDRESSES QUESTION---
To improve relationships, consider seeking therapy or life coaching,
as these can provide valuable insights and challenge your perspectives.
Engaging in one-on-one or group therapy can help you reflect on how your
past experiences shape your current interactions. Finding a therapist you
connect with can significantly enhance your understanding and growth in
relationships.Dan kueri kedua menguji kemampuan refleksi Self-RAG dengan menulis ulang kueri saat basis pengetahuan tidak memiliki dokumen yang relevan. Perhatikan bahwa dengan cara kita menyiapkan alur LangGraph, ada risiko sistem terjebak dalam loop tak berujung. Untuk mencegahnya, kita menetapkan batas rekursi ke 10.
Pendekatan yang lebih baik adalah menerapkan batas percobaan ulang; setelah N percobaan, jika tidak ada dokumen berguna yang ditemukan, sistem sebaiknya keluar dan memberi tahu pengguna bahwa jawaban tidak dapat ditemukan. Ini akan memberikan pengalaman pengguna yang lebih baik daripada terus berulang tanpa henti.
res = app.invoke({"question": "How to cook a bagel?"}, {"recursion_limit": 10})---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
GraphRecursionError: Recursion limit of 10 reached without hitting a stop condition. You can increase the limit by setting the recursion_limit config key.Keterbatasan Self-RAG
Meskipun self-RAG meningkatkan RAG tradisional, ia memiliki tantangannya sendiri.
Salah satu tantangan utama adalah kecepatan dan biayanya secara komputasi. Siklus berulang pengambilan dan penyempurnaan membutuhkan daya pemrosesan yang signifikan, yang dapat memperlambat proses, terutama pada aplikasi waktu nyata.
Selain itu, karena Self-RAG mengandalkan basis pengetahuan tetap alih-alih pencarian web, ia mungkin kesulitan saat informasi yang dibutuhkan tidak tersedia. Dalam kasus seperti itu, sistem membuang waktu dan sumber daya untuk berulang kali mencari sesuatu yang sebenarnya tidak ada.
Tantangan lain adalah menjaga akurasi faktual. Meskipun Self-RAG dirancang untuk menyempurnakan responsnya sendiri, ia masih dapat mengambil dan menghasilkan informasi yang tidak relevan. Menyetel sistem agar seimbang antara terlalu umum dan terlalu rinci juga rumit, karena membutuhkan banyak data berkualitas tinggi dan daya komputasi.
Kesimpulan
Secara keseluruhan, self-RAG merupakan langkah besar dalam RAG, menjadikannya lebih berfokus pada penggerak mandiri dan lebih agentik. Dengan memperkenalkan loop umpan balik yang mengubah kueri, menyaring dokumen yang tidak relevan, dan mengiterasi jawabannya sendiri, self-RAG mengatasi banyak keterbatasan RAG tradisional.
Untuk mempelajari lebih lanjut tentang self-RAG, lihat makalah aslinya di sini.

Ryan adalah lead data scientist yang mengkhususkan diri dalam membangun aplikasi AI menggunakan LLM. Ia adalah kandidat PhD di bidang Pemrosesan Bahasa Alami dan Knowledge Graph di Imperial College London, tempat ia juga menyelesaikan gelar Master di Ilmu Komputer. Di luar data science, ia menulis newsletter Substack mingguan, The Limitless Playbook, di mana ia membagikan satu ide yang dapat langsung dipraktikkan dari para pemikir top dunia dan sesekali menulis tentang konsep inti AI.




Sistem Retrieval-Augmented Generation (RAG) tradisional mengambil dokumen dan menghasilkan jawaban dalam satu langkah, namun pendekatan tersebut sering gagal karena membawa kembali informasi yang tidak relevan, melewatkan dokumen kunci, dan gagal menjawab pertanyaan pengguna secara langsung, sehingga menghambat akurasi keseluruhan RAG.
Masa depan RAG bersifat agentik; sistem yang dapat berpikir dan beradaptasi untuk meningkatkan jawabannya sendiri. Meskipun RAG agentik penuh masih berkembang, self-RAG adalah contoh sederhana namun kuat dari ide ini dalam praktik.
Self-RAG memiliki loop umpan balik bawaan yang menyaring dokumen buruk, menulis ulang kueri jika pengambilan gagal, serta memeriksa apakah jawaban masuk akal dan mencoba lagi jika diperlukan.
Dalam artikel ini, saya akan memperkenalkan Self-RAG dan memandu Anda melalui implementasi langkah demi langkah menggunakan LangGraph.