

Self-RAG Nedir?
Self-RAG, yinelemeli akıl yürütme ve öz-değerlendirme getirerek sistemin, yüksek kaliteli bir yanıt elde edilene kadar getirme ve üretimi dinamik olarak ayarlamasına olanak tanır. RAG’i tek atımlık bir süreç olarak ele almak yerine, self-RAG her adımda daha akıllı kararlar almak için geri bildirim döngüleri içerir.
Self-RAG süreci dört temel kararı içerir:
- Getirme yapılmalı mı?
- Sistem, belgeleri yalnızca soruya göre mi yoksa ilk bir yanıt denemesine göre mi getireceğine önce karar verir. Bu, gereksiz getirmeyi önler ve dinamik uyarlamayı mümkün kılar.
- Getirilen belgeler ilgili mi?
- Her getirilen belge, alaka düzeyi açısından bağımsız olarak değerlendirilir. Bir belge sorguyu yanıtlamak için faydalı değilse, üretimden önce elenir.
- Üretilen yanıt getirilen belgelere dayanıyor mu?
- Bir yanıt üretildikten sonra sistem, yanıttaki tüm iddiaların getirilen içerikle desteklenip desteklenmediğini kontrol eder. Desteklenmeyen ifadeler bulunursa, yanıtı iyileştirmeye çalışabilir.
- Yanıt gerçekten kullanıcının sorusunu yanıtlıyor mu?
- Bir yanıt olgusal olarak doğru olsa bile, kullanıcının sorusunu tam olarak karşılamayabilir. Yanıt ve soruya bakarak sistem, son yanıtın faydalı olup olmadığını (ikili) tahmin eder ve yeniden üretmeye mi yoksa durmaya mı karar verir.
Her adımda öz-yansıtma getirerek Self-RAG, getirmeyi daha güvenilir kılar, halüsinasyonları önler ve nihai yanıtın kullanıcının sorusuna dayalı ve ilgili olmasını sağlar.
LangGraph Kullanarak Self-RAG Uygulaması
Bu bölümde, LangGraph kullanarak self-RAG’in nasıl adım adım uygulanacağını açıklayacağım. Ortamınızı nasıl kuracağınızı, temel bir bilgi vektör deposu oluşturmayı ve self-RAG için gerekli bileşenleri (getirme değerlendiricisi, soru yeniden yazıcı ve web arama aracı gibi) nasıl yapılandıracağınızı öğreneceksiniz.
Ayrıca tüm bu parçaları bir araya getiren bir LangGraph iş akışını nasıl kuracağımızı öğrenerek self-RAG’in daha doğru ve güvenilir sonuçlar için farklı sorgu türlerini nasıl yönettiğini göstereceğiz.
Adım 1: Kurulum ve yükleme
Önce gerekli paketleri yükleyin. Bu adım, Self-RAG hattını çalıştırmak için ortamı hazırlar.
%pip install -U langchain_community tiktoken langchain-openai langchainhub chromadb langchain langgraphArdından, OpenAI için API anahtarlarınızı yapılandırın:
import os
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"Adım 2: Vekil bir bilgi tabanı kurun
RAG gerçekleştirmek için önce belgelerle doldurulmuş bir bilgi tabanına ihtiyacımız var. Bu adımda, bir Substack bülteninden bazı örnek belgeleri kazıyarak bir vektör deposu oluşturacağız; bu depo vekil bilgi tabanımız gibi davranır. Bu vektör deposu, kullanıcı sorgularına göre ilgili belgeleri bulmamıza yardımcı olur.
Sağlanan URL’lerden belgeleri yükleyerek başlıyoruz ve bunları bir metin bölücü kullanarak daha küçük parçalara ayırıyoruz. Bu bölümler daha sonra OpenAIEmbeddings ile gömülür ve verimli belge getirme için bir vektör veritabanında (Chroma) saklanır.
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import WebBaseLoader
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings
urls = [
"<https://ryanocm.substack.com/p/123-how-tiny-experiments-can-lead>",
"<https://ryanocm.substack.com/p/122-life-razor-the-one-sentence-that>",
"<https://ryanocm.substack.com/p/121-warren-buffetts-255-strategy>",
"<https://ryanocm.substack.com/p/120-30-years-on-earth-11-habits-that>",
]
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
chunk_size=250, chunk_overlap=0
)
doc_splits = text_splitter.split_documents(docs_list)
# Add to vectorDB
vectorstore = Chroma.from_documents(
documents=doc_splits,
collection_name="rag-chroma",
embedding=OpenAIEmbeddings(),
)
retriever = vectorstore.as_retriever()Adım 3: Yardımcı fonksiyonları kurun
Self-RAG’i etkili şekilde uygulamak için, her biri belirli istemler ve veri modelleri kullanan, farklı rollere sahip birden fazla LLM’e ihtiyacımız var. Kodu yinelenmekten kaçınmak için burada, LLM’leri ve yapılandırılmış çıktıları tutarlı ve yeniden kullanılabilir bir şekilde oluşturmak üzere yardımcı fonksiyonlar kuruyoruz.
create_structured_llm yardımcı fonksiyonu ile, önceden tanımlı bir yapılandırılmış çıktı şemasına sahip bir LLM başlatabiliriz.
def create_structured_llm(model, schema):
llm = ChatOpenAI(model=model, temperature=0)
return llm.with_structured_output(schema)create_grading_prompt yardımcı fonksiyonu, self-RAG içinde kullanılan tüm LLM’ler için istemler üretmeyi kolaylaştırır. Bir sistem mesajı ve bir insan şablonu alarak, belge alakasını, halüsinasyonları ve yanıt kalitesini değerlendirmek için yapılandırılmış bir istem oluşturur.
def create_grading_prompt(system_message, human_template):
return ChatPromptTemplate.from_messages([
("system", system_message),
("human", human_template),
])Son olarak, birçok LLM modelimiz için basit bir ikili puanlama modeli kullanarak süreci sadeleştiriyoruz. Her değerlendirici için ayrı bir veri modeli oluşturmak yerine, farklı derecelendirme görevlerinde çıktıları standartlaştıran tek bir BinaryScoreModel tanımlıyoruz.
class BinaryScoreModel(BaseModel):
binary_score: str = Field(description="Binary score: 'yes' or 'no'")Adım 4: Çekirdek LLM bileşenlerini oluşturma
Artık yardımcı fonksiyonlarımız hazır olduğuna göre, Self-RAG için gereken temel LLM bileşenlerini oluşturabiliriz. Bu bileşenler getirilen belgeleri değerlendirir, halüsinasyonları tespit eder, yanıtın faydasını derecelendirir ve gerektiğinde sorguları iyileştirir.
Getirme değerlendiricisi
Getirme değerlendiricisi, getirilen bir belgenin kullanıcının sorusuyla ilgili olup olmadığını belirler. Yapılandırılmış bir ikili puanlama modeli kullanarak, anahtar sözcük eşleşmesi ve anlamsal anlama temelinde basit bir "evet" veya "hayır" atar. Bu adım, yalnızca faydalı belgelerin üretimde kullanılmasını sağlar.
retrieval_evaluator_llm = create_structured_llm("gpt-4o-mini", BinaryScoreModel)
retrieval_evaluator_prompt = create_grading_prompt(
"You are a document retrieval evaluator responsible for checking the relevancy of a retrieved document to the user's question. \\n If the document contains keyword(s) or semantic meaning related to the question, grade it as relevant. \\n Output a binary score 'yes' or 'no'.",
"Retrieved document: \\n\\n {document} \\n\\n User question: {question}"
)
retrieval_grader = retrieval_evaluator_prompt | retrieval_evaluator_llmHalüsinasyon değerlendiricisi
İlgili belgeler olsa bile, LLM’ler desteklenmeyen iddialar üretebilir. Halüsinasyon değerlendiricisi, üretilen yanıtın getirilen gerçeklere dayanıp dayanmadığını kontrol eder ve halüsinasyonları eler. Bu da ikili bir derecelendirme modelini izler.
hallucination_grader = create_grading_prompt(
"You are a grader assessing whether an LLM generation is grounded in / supported by a set of retrieved facts. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer is grounded in / supported by the set of facts.",
"Set of facts: \\n\\n {documents} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)Yanıt değerlendiricisi
İlgili ve olgusal bir yanıt, kullanıcının sorusunu tam olarak karşılamıyorsa yeterli değildir. Yanıt değerlendiricisi, üretilen yanıtın kullanıcının niyetini doğrudan karşılayıp karşılamadığını yine ikili bir "evet" veya "hayır" puanıyla değerlendirir.
answer_grader = create_grading_prompt(
"You are a grader assessing whether an answer addresses / resolves a question. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer resolves the question.",
"User question: \\n\\n {question} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)Soru yeniden yazıcı
İlgili belgeler eksik olduğunda, sorguyu yeniden formüle etmek getirmeyi iyileştirebilir. Soru yeniden yazıcı, özgün kullanıcı girdisini daha iyi belge getirme için optimize eder ve sistemin faydalı bağlam bulma şansını artırır.
question_rewriter = create_grading_prompt(
"You are a question re-writer that converts an input question to a better version optimized for vectorstore retrieval. Look at the input and try to reason about the underlying semantic intent / meaning.",
"Here is the initial question: \\n\\n {question} \\n Formulate an improved question."
) | ChatOpenAI(model="gpt-4o-mini", temperature=0) | StrOutputParser()RAG Zinciri
Son olarak, RAG zinciri temel getirme destekli üretim sürecini yönetir. Getirilen belgeleri biçimlendirir, bunları bir LLM istemine besler ve üretilen yanıtı çıkarır.
rag_prompt = hub.pull("rlm/rag-prompt")
rag_llm = ChatOpenAI(model_name="gpt-4o-mini", temperature=0)
def format_docs(docs):
return "\\n\\n".join(doc.page_content for doc in docs)
rag_chain = rag_prompt | rag_llm | StrOutputParser()Adım 5: LangGraph iş akışını kurun
LangGraph ile Self-RAG iş akışını oluşturmak için şu dört ana adımı izleyin:
- Graf durumunu tanımlayın
- Düğüm fonksiyonlarını tanımlayın
- Kenar fonksiyonlarını tanımlayın
- Tüm düğüm ve kenarları birbirine bağlayın
Graf durumunu tanımlayın
İş akışı sırasında veriler düğümler arasında taşınırken depolanacağı ortak bir durum oluşturun. Bu durum, kullanıcının sorusu, getirilen belgeler ve üretilen yanıtlar gibi tüm değişkenleri tutacaktır.
from typing import List
from typing_extensions import TypedDict
class GraphState(TypedDict):
"""
Represents the state of our graph.
Attributes:
question: question
generation: LLM generation
documents: list of documents
"""
question: str
generation: str
documents: List[str]Düğüm fonksiyonlarını tanımlayın
LangGraph iş akışında, her fonksiyon düğümü Self-RAG hattında belirli bir görevi üstlenir; örneğin belgeleri getirme, belge alakasını değerlendirme, halüsinasyon kontrolleri vb. İşte her fonksiyonun dökümü:
retrieve fonksiyonu, bilgi tabanından kullanıcının sorusuyla ilgili belgeleri bulur. Genellikle ön işlenmiş belgelerden oluşturulmuş bir vektör deposu olan bir getirici nesnesi kullanır. Bu fonksiyon, kullanıcının sorusu da dahil olmak üzere mevcut durumu alır, getiriciyle ilgili belgeleri bulur ve ardından bu belgeleri duruma ekler.
def retrieve(state):
print("---RETRIEVE---")
question = state["question"]
documents = retriever.invoke(question)
return {"documents": documents, "question": question}generate fonksiyonu, getirilen belgeleri kullanarak kullanıcının sorusuna bir yanıt oluşturur. Bir istemi bir dil modeliyle birleştiren RAG zinciri ile çalışır. Bu fonksiyon, getirilen belgeleri ve kullanıcının sorusunu RAG zincirinden geçirir ve ardından yanıtı duruma ekler.
def generate(state):
print("---GENERATE---")
return {
"documents": state["documents"],
"question": state["question"],
"generation": rag_chain.invoke({"context": state["documents"], "question": state["question"]})
}grade_documents fonksiyonu, getirilen her belgenin kullanıcının sorusuyla ne kadar ilişkili olduğunu getirme değerlendiricisi kullanarak kontrol eder. Bu, nihai yanıt için yalnızca faydalı bilgilerin kullanılmasına yardımcı olur. Fonksiyon, her belgenin alaka düzeyini derecelendirir ve faydalı olmayanları filtreler. Ayrıca, çoğu belgenin ilgili olmadığı durumlarda web aramasına ihtiyaç olup olmadığını göstermek için web_search bayrağıyla durumu günceller.
def grade_documents(state):
print("---CHECK DOCUMENT RELEVANCE TO QUESTION---")
question = state["question"]
documents = state["documents"]
filtered_docs = [d for d in documents if retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score == "yes"]
for d in documents:
grade = retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score
print(f"---GRADE: DOCUMENT {'RELEVANT' if grade == 'yes' else 'NOT RELEVANT'}---")
return {"documents": filtered_docs, "question": question}transform_query fonksiyonu, özellikle özgün sorgu ilgili belgeleri bulamazsa, daha iyi arama sonuçları elde etmek için kullanıcının sorusunu iyileştirir. Soru yeniden yazıcıyı kullanarak soruyu daha açık ve özgül hale getirir. Daha iyi bir soru, hem bilgi tabanından hem de web aramalarından faydalı belgeler bulma olasılığını artırır.
def transform_query(state):
print("---TRANSFORM QUERY---")
return {"documents": state["documents"], "question": question_rewriter.invoke({"question": state["question"]})}Kenar fonksiyonlarını tanımlayın
Self-RAG’de kenar fonksiyonları, getirme ve üretim sürecinin her adımında önemli kararlar vererek yürütme akışını kontrol eder. Sabit bir hattı izleyen geleneksel RAG’in aksine, self-RAG getirilen belgelerin ve üretilen yanıtların kalitesine göre dinamik olarak uyum sağlar. Bu koşullu kenarlar şunlardır:
Yeniden getirmeye mi yoksa üretmeye mi karar verin (decide_to_generate)
Bu kenar fonksiyonu, üretime geçmek için getirilen belgelerin yeterince ilgili olup olmadığını değerlendirir. Faydalı belge bulunamazsa, aramayı iyileştirmek için sorgu dönüşümünü tetikler ve ardından yeniden getirme dener. Aksi halde yanıt üretimine ilerler.
def decide_to_generate(state):
print("---ASSESS GRADED DOCUMENTS---")
if not state["documents"]:
print("---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---")
return "transform_query"
print("---DECISION: GENERATE---")
return "generate"Üretilen yanıtı doğrulayın (grade_generation_v_documents_and_question)
Bu kenar fonksiyonu, üretilen yanıtın doğruluğunu ve faydasını değerlendirir. Önce halüsinasyonları kontrol eder; yanıt getirilen belgelerle tam olarak desteklenmiyorsa, üretimi yeniden dener. Yanıt temelliyse ancak soruyu tam karşılamıyorsa, getirmeyi iyileştirmek üzere sorgu rafinmanına geri döner.
def grade_generation_v_documents_and_question(state):
print("---CHECK HALLUCINATIONS---")
hallucination_score = hallucination_grader.invoke({"documents": state["documents"], "generation": state["generation"]}).binary_score
if hallucination_score == "yes":
print("---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---")
answer_score = answer_grader.invoke({"question": state["question"], "generation": state["generation"]}).binary_score
if answer_score == "yes":
print("---DECISION: GENERATION ADDRESSES QUESTION---")
return "useful"
print("---DECISION: GENERATION DOES NOT ADDRESS QUESTION---")
return "not useful"
print("---DECISION: GENERATION IS NOT GROUNDED IN DOCUMENTS, RE-TRY---")
return "not supported"Tüm düğüm ve kenarları birbirine bağlayın
Tüm düğüm ve kenarlar tanımlandıktan sonra, Self-RAG hattını oluşturmak için bunların hepsini LangGraph iş akışında birbirine bağlayabiliriz. Bu, bilgi ve karar akışını yönetmek için düğümlerin kenarlarla bağlanması ve iş akışının her adımın sonuçlarına göre doğru şekilde çalışmasının sağlanması anlamına gelir.
from langgraph.graph import END, StateGraph, START
workflow = StateGraph(GraphState)
# Define the nodes
workflow.add_node("retrieve", retrieve) # retrieve
workflow.add_node("grade_documents", grade_documents) # grade documents
workflow.add_node("generate", generate) # generatae
workflow.add_node("transform_query", transform_query) # transform_query
# Build graph
workflow.add_edge(START, "retrieve")
workflow.add_edge("retrieve", "grade_documents")
workflow.add_conditional_edges(
"grade_documents",
decide_to_generate,
{
"transform_query": "transform_query",
"generate": "generate",
},
)
workflow.add_edge("transform_query", "retrieve")
workflow.add_conditional_edges(
"generate",
grade_generation_v_documents_and_question,
{
"not supported": "generate",
"useful": END,
"not useful": "transform_query",
},
)
# Compile
app = workflow.compile()from IPython.display import Image, display
try:
display(Image(app.get_graph(xray=True).draw_mermaid_png()))
except Exception:
# This requires some extra dependencies and is optional
pass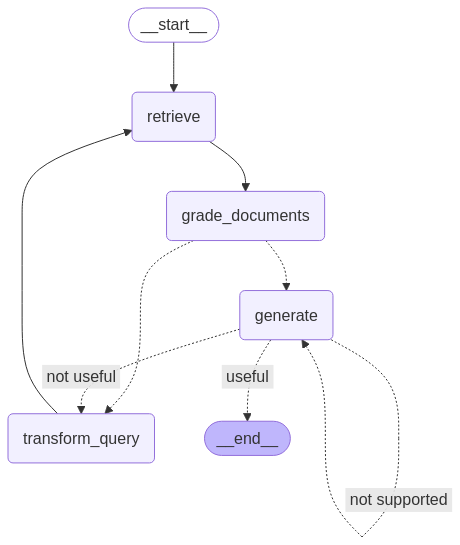
Adım 6: İş akışını test etme
Kurulumumuzu test etmek için, bilginin nasıl getirildiğini, belge alakasının nasıl değerlendirildiğini ve yanıtların nasıl üretildiğini görmek üzere örnek sorgularla iş akışını çalıştırıyoruz.
İlk sorgu, Self-RAG’in cevapları bilgi tabanı içinde ne kadar iyi bulduğunu kontrol eder.
res = app.invoke({"question": "How to improve relationships"})
print(res['generation'])---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: GENERATE---
---GENERATE---
---CHECK HALLUCINATIONS---
---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---
---DECISION: GENERATION ADDRESSES QUESTION---
To improve relationships, consider seeking therapy or life coaching,
as these can provide valuable insights and challenge your perspectives.
Engaging in one-on-one or group therapy can help you reflect on how your
past experiences shape your current interactions. Finding a therapist you
connect with can significantly enhance your understanding and growth in
relationships.Ve ikinci sorgu, bilgi tabanında ilgili belgeler olmadığında sorguyu yeniden yazarak Self-RAG’in yansıtma yeteneğini sınar. LangGraph akışını kurma şeklimiz nedeniyle sistemin sonsuz döngüye girme riski olduğuna dikkat edin. Bunu önlemek için yineleme sınırını 10 olarak ayarladık.
Daha iyi bir yaklaşım, bir yeniden deneme sınırı uygulamak olabilir; N denemeden sonra hâlâ faydalı belge bulunamazsa sistem çıkmalı ve bir yanıt bulunamadığını kullanıcıya bildirmelidir. Bu, sonsuz döngüye girmek yerine daha iyi bir kullanıcı deneyimi sağlar.
res = app.invoke({"question": "How to cook a bagel?"}, {"recursion_limit": 10})---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
GraphRecursionError: Recursion limit of 10 reached without hitting a stop condition. You can increase the limit by setting the recursion_limit config key.Self-RAG’in Sınırlamaları
Self-RAG geleneksel RAG’i geliştirirken, kendi zorluklarıyla birlikte gelir.
Başlıca zorluklardan biri hesaplama hızı ve maliyetidir. Tekrarlayan getirme ve iyileştirme döngüleri önemli işlem gücü gerektirir ve özellikle gerçek zamanlı uygulamalarda yavaşlamaya neden olabilir.
Buna ek olarak, Self-RAG web aramalarından ziyade sabit bir bilgi tabanına dayandığından, gerekli bilgi mevcut olmadığında zorlanabilir. Bu gibi durumlarda sistem, aslında orada olmayan bir şeyi tekrar tekrar arayarak zaman ve kaynak israf eder.
Bir diğer zorluk da olgusal doğruluğu korumaktır. Self-RAG kendi yanıtlarını iyileştirmek üzere tasarlanmış olsa da, yine de alakasız bilgiler getirebilir ve üretebilir. Sistemi, fazla genel olmakla aşırı ayrıntılı olmak arasında bir denge kuracak şekilde ince ayarlamak da zordur; çünkü çok miktarda yüksek kaliteli veri ve hesaplama gücü gerektirir.
Sonuç
Genel olarak, self-RAG RAG’de büyük bir ilerlemedir; onu daha öz-yönelimli ve daha etmen odaklı hale getirir. Sorguları dönüştüren, alakasız belgeleri eleyen ve kendi yanıtları üzerinde yineleyen bir geri bildirim döngüsü getirerek self-RAG, geleneksel RAG’in birçok sınırlamasını aşar.
Self-RAG hakkında daha fazla bilgi için özgün makaleye buradan göz atın.

Ryan, LLM'ler kullanarak yapay zeka uygulamaları geliştirme konusunda uzmanlaşmış kıdemli bir veri bilimcisidir. Imperial College London'da Doğal Dil İşleme ve Bilgi Grafiklerinde doktora adayıdır ve aynı kurumda Bilgisayar Bilimleri alanında yüksek lisansını tamamlamıştır. Veri bilimi dışında, haftalık Substack bülteni The Limitless Playbook'u yayımlar; burada dünyanın önde gelen düşünürlerinden uygulanabilir tek bir fikri paylaşır ve zaman zaman temel yapay zeka kavramları hakkında yazar.



Geleneksel Retrieval-Augmented Generation (RAG) sistemleri belgeleri getirip yanıtları tek adımda üretir; ancak bu yaklaşım çoğu zaman alakasız bilgiler getirdiği, kritik belgeleri kaçırdığı ve kullanıcı sorularını doğrudan yanıtlamadığı için başarısız olur; bu da RAG’in genel doğruluğunu olumsuz etkiler.
RAG’in geleceği etmen odaklıdır; kendi yanıtlarını geliştirmek için düşünebilen ve uyum sağlayabilen sistemler. Tam kapsamlı etmen temelli RAG hâlâ evrilirken, self-RAG bu fikrin uygulamadaki basit ama güçlü bir örneğidir.
Self-RAG, hatalı belgeleri eleyen, getirmenin başarısız olduğu durumlarda sorguyu yeniden yazan ve yanıtın mantıklı olup olmadığını kontrol ederek gerekirse tekrar deneyen yerleşik bir geri bildirim döngüsüne sahiptir.
Bu yazıda Self-RAG’i tanıtacak ve sizi, kullanarak LangGraph adım adım bir uygulamadan geçireceğim.