

Che cos’è Self-RAG?
Self-RAG introduce ragionamento iterativo e autovalutazione, consentendo al sistema di adattare dinamicamente recupero e generazione finché non ottiene una risposta di alta qualità. Invece di trattare il RAG come un processo one-shot, self-RAG incorpora cicli di feedback per prendere decisioni più intelligenti a ogni passaggio.
Il processo Self-RAG prevede quattro decisioni chiave:
- Il recupero deve avvenire?
- Il sistema decide innanzitutto se recuperare documenti sulla base della sola domanda o di un tentativo iniziale di risposta. Ciò evita recuperi inutili e abilita un adattamento dinamico.
- I documenti recuperati sono pertinenti?
- Ogni documento recuperato viene valutato in modo indipendente per la pertinenza. Se un documento non è utile a rispondere alla query, viene scartato prima della generazione.
- La risposta generata è fondata sui documenti recuperati?
- Dopo aver generato una risposta, il sistema verifica che tutte le affermazioni nella risposta siano supportate dai contenuti recuperati. Se trova affermazioni non supportate, può tentare di affinare la risposta.
- La risposta risponde davvero alla domanda dell’utente?
- Anche se una risposta è corretta, potrebbe non affrontare pienamente la domanda dell’utente. Data la risposta e la domanda dell’utente, il sistema prevede se la risposta finale è utile o meno (binaria) e decide se rigenerare o fermarsi.
Introducendo l’autoriflessione a ogni passaggio, Self-RAG rende il recupero più affidabile, prevenendo allucinazioni e assicurando che la risposta finale sia fondata e pertinente alla domanda dell’utente.
Implementazione di Self-RAG con LangGraph
In questa sezione spiegherò passo dopo passo come implementare self-RAG usando LangGraph. Imparerai a configurare l’ambiente, creare un semplice vector store della conoscenza e impostare i componenti chiave necessari per self-RAG, come il valutatore del recupero, il riscrittore di domande e lo strumento di ricerca sul web.
Vedremo anche come costruire un workflow LangGraph che unisce tutte queste parti, mostrando come self-RAG possa gestire vari tipi di query per risultati più accurati e affidabili.
Passo 1: Setup e installazione
Per prima cosa, installa i pacchetti richiesti. Questo passaggio prepara l’ambiente per eseguire la pipeline Self-RAG.
%pip install -U langchain_community tiktoken langchain-openai langchainhub chromadb langchain langgraphPoi configura le tue chiavi API per OpenAI:
import os
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"Passo 2: Imposta una knowledge base proxy
Per eseguire il RAG, ci serve innanzitutto una knowledge base popolata di documenti. In questo passaggio, effettueremo lo scraping di alcuni documenti di esempio da una newsletter Substack per creare un vector store, che fungerà da knowledge base proxy. Questo vector store aiuta a trovare documenti pertinenti in base alle query degli utenti.
Iniziamo caricando i documenti dagli URL forniti e dividendoli in sezioni più piccole usando un text splitter. Queste sezioni vengono poi incorporate usando OpenAIEmbeddings e archiviate in un database vettoriale (Chroma) per un recupero efficiente dei documenti.
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import WebBaseLoader
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings
urls = [
"<https://ryanocm.substack.com/p/123-how-tiny-experiments-can-lead>",
"<https://ryanocm.substack.com/p/122-life-razor-the-one-sentence-that>",
"<https://ryanocm.substack.com/p/121-warren-buffetts-255-strategy>",
"<https://ryanocm.substack.com/p/120-30-years-on-earth-11-habits-that>",
]
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
chunk_size=250, chunk_overlap=0
)
doc_splits = text_splitter.split_documents(docs_list)
# Add to vectorDB
vectorstore = Chroma.from_documents(
documents=doc_splits,
collection_name="rag-chroma",
embedding=OpenAIEmbeddings(),
)
retriever = vectorstore.as_retriever()Passo 3: Imposta le funzioni helper
Per implementare efficacemente Self-RAG, ci servono più LLM con ruoli diversi, ciascuno con prompt e modelli dati specifici. Invece di duplicare il codice, qui impostiamo funzioni helper per creare LLM e output strutturati in modo coerente e riutilizzabile.
Con la funzione helper create_structured_llm possiamo inizializzare un LLM con uno schema di output strutturato predefinito.
def create_structured_llm(model, schema):
llm = ChatOpenAI(model=model, temperature=0)
return llm.with_structured_output(schema)La funzione helper create_grading_prompt semplifica la generazione di prompt per tutti gli LLM utilizzati in self-RAG. Prendendo un messaggio di sistema e un template umano, crea un prompt strutturato per valutare pertinenza dei documenti, allucinazioni e qualità delle risposte.
def create_grading_prompt(system_message, human_template):
return ChatPromptTemplate.from_messages([
("system", system_message),
("human", human_template),
])Infine, semplifichiamo il processo usando un semplice modello di scoring binario per molti dei nostri modelli LLM. Invece di creare un modello dati separato per ciascun valutatore, definiamo un unico BinaryScoreModel che standardizza gli output tra diversi compiti di valutazione.
class BinaryScoreModel(BaseModel):
binary_score: str = Field(description="Binary score: 'yes' or 'no'")Passo 4: Costruire i componenti LLM principali
Ora che abbiamo predisposto le funzioni helper, possiamo creare i componenti LLM chiave necessari per Self-RAG. Questi componenti valutano i documenti recuperati, rilevano le allucinazioni, misurano l’utilità della risposta e raffinano le query quando serve.
Valutatore del recupero
Il valutatore del recupero determina se un documento recuperato è pertinente alla domanda dell’utente. Usando un modello di scoring binario strutturato, assegna un semplice "yes" o "no" in base al match di keyword e al significato semantico. Questo passaggio garantisce che solo i documenti utili vengano usati per la generazione.
retrieval_evaluator_llm = create_structured_llm("gpt-4o-mini", BinaryScoreModel)
retrieval_evaluator_prompt = create_grading_prompt(
"You are a document retrieval evaluator responsible for checking the relevancy of a retrieved document to the user's question. \\n If the document contains keyword(s) or semantic meaning related to the question, grade it as relevant. \\n Output a binary score 'yes' or 'no'.",
"Retrieved document: \\n\\n {document} \\n\\n User question: {question}"
)
retrieval_grader = retrieval_evaluator_prompt | retrieval_evaluator_llmValutatore delle allucinazioni
Anche con documenti pertinenti, gli LLM possono comunque produrre affermazioni non supportate. Il valutatore delle allucinazioni verifica se la risposta generata è fondata sui fatti recuperati, filtrando eventuali allucinazioni. Segue anch’esso un modello di valutazione binaria.
hallucination_grader = create_grading_prompt(
"You are a grader assessing whether an LLM generation is grounded in / supported by a set of retrieved facts. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer is grounded in / supported by the set of facts.",
"Set of facts: \\n\\n {documents} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)Valutatore della risposta
Una risposta pertinente e basata sui fatti non basta se non risponde pienamente alla domanda dell’utente. Il valutatore della risposta stima se la risposta generata affronta direttamente l’intento dell’utente, ancora una volta usando un punteggio binario "yes" o "no".
answer_grader = create_grading_prompt(
"You are a grader assessing whether an answer addresses / resolves a question. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer resolves the question.",
"User question: \\n\\n {question} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)Riscrittore di domande
Quando mancano documenti pertinenti, riformulare la query può migliorare il recupero. Il riscrittore di domande prende l’input originale dell’utente e lo ottimizza per un miglior recupero dei documenti, garantendo al sistema le migliori possibilità di trovare contesto utile.
question_rewriter = create_grading_prompt(
"You are a question re-writer that converts an input question to a better version optimized for vectorstore retrieval. Look at the input and try to reason about the underlying semantic intent / meaning.",
"Here is the initial question: \\n\\n {question} \\n Formulate an improved question."
) | ChatOpenAI(model="gpt-4o-mini", temperature=0) | StrOutputParser()Catena RAG
Infine, la catena RAG gestisce il processo principale di retrieval-augmented generation. Formattta i documenti recuperati, li inserisce in un prompt LLM ed estrae la risposta generata.
rag_prompt = hub.pull("rlm/rag-prompt")
rag_llm = ChatOpenAI(model_name="gpt-4o-mini", temperature=0)
def format_docs(docs):
return "\\n\\n".join(doc.page_content for doc in docs)
rag_chain = rag_prompt | rag_llm | StrOutputParser()Passo 5: Imposta il workflow LangGraph
Per costruire il workflow Self-RAG con LangGraph, segui questi quattro passaggi principali:
- Definisci lo stato del grafo
- Definisci le funzioni dei nodi
- Definisci le funzioni degli edge
- Collega insieme tutti i nodi e gli edge
Definisci lo stato del grafo
Crea uno stato condiviso per archiviare i dati mentre si spostano tra i nodi durante il workflow. Questo stato conterrà tutte le variabili, come la domanda dell’utente, i documenti recuperati e le risposte generate.
from typing import List
from typing_extensions import TypedDict
class GraphState(TypedDict):
"""
Represents the state of our graph.
Attributes:
question: question
generation: LLM generation
documents: list of documents
"""
question: str
generation: str
documents: List[str]Definisci le funzioni dei nodi
Nel workflow LangGraph, ogni funzione nodo gestisce un compito specifico nella pipeline Self-RAG, come recuperare documenti, valutare la pertinenza dei documenti, controllare le allucinazioni, ecc. Ecco una panoramica di ciascuna funzione:
La funzione retrieve trova i documenti nella knowledge base pertinenti alla domanda dell’utente. Usa un oggetto retriever, solitamente un vector store creato da documenti pre-processati. Questa funzione prende lo stato corrente, inclusa la domanda dell’utente, e utilizza il retriever per ottenere documenti pertinenti. Poi aggiunge questi documenti allo stato.
def retrieve(state):
print("---RETRIEVE---")
question = state["question"]
documents = retriever.invoke(question)
return {"documents": documents, "question": question}La funzione generate crea una risposta alla domanda dell’utente usando i documenti recuperati. Lavora con la catena RAG, che combina un prompt con un modello linguistico. Questa funzione prende i documenti recuperati e la domanda dell’utente, li elabora attraverso la catena RAG e poi aggiunge la risposta allo stato.
def generate(state):
print("---GENERATE---")
return {
"documents": state["documents"],
"question": state["question"],
"generation": rag_chain.invoke({"context": state["documents"], "question": state["question"]})
}La funzione grade_documents verifica quanto ciascun documento recuperato sia pertinente alla domanda dell’utente usando il valutatore del recupero. Questo aiuta a garantire che solo le informazioni utili vengano usate per la risposta finale. La funzione valuta la pertinenza di ogni documento e filtra quelli non utili. Aggiorna anche lo stato con un flag web_search per indicare se serve una ricerca web quando la maggior parte dei documenti non è pertinente.
def grade_documents(state):
print("---CHECK DOCUMENT RELEVANCE TO QUESTION---")
question = state["question"]
documents = state["documents"]
filtered_docs = [d for d in documents if retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score == "yes"]
for d in documents:
grade = retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score
print(f"---GRADE: DOCUMENT {'RELEVANT' if grade == 'yes' else 'NOT RELEVANT'}---")
return {"documents": filtered_docs, "question": question}La funzione transform_query migliora la domanda dell’utente per ottenere risultati di ricerca migliori, soprattutto se la query originale non trova documenti pertinenti. Usa un riscrittore di domande per rendere la domanda più chiara e specifica. Una domanda migliore aumenta le probabilità di trovare documenti utili sia nella knowledge base sia nelle ricerche web.
def transform_query(state):
print("---TRANSFORM QUERY---")
return {"documents": state["documents"], "question": question_rewriter.invoke({"question": state["question"]})}Definisci le funzioni degli edge
In self-RAG, le funzioni degli edge controllano il flusso di esecuzione prendendo decisioni chiave a ogni passaggio del processo di recupero e generazione. A differenza del RAG tradizionale, che segue una pipeline fissa, self-RAG si adatta dinamicamente in base alla qualità dei documenti recuperati e delle risposte generate. Questi edge condizionali sono i seguenti:
Decidere se recuperare di nuovo o generare (decide_to_generate)
Questa funzione edge valuta se i documenti recuperati sono sufficientemente pertinenti per procedere con la generazione. Se non si trovano documenti utili, attiva la trasformazione della query per affinare la ricerca prima di un nuovo tentativo di recupero. Altrimenti, passa alla generazione della risposta.
def decide_to_generate(state):
print("---ASSESS GRADED DOCUMENTS---")
if not state["documents"]:
print("---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---")
return "transform_query"
print("---DECISION: GENERATE---")
return "generate"Validare la risposta generata (grade_generation_v_documents_and_question)
Questa funzione edge valuta accuratezza e utilità della risposta generata. Controlla prima le allucinazioni; se la risposta non è pienamente supportata dai documenti recuperati, riprova la generazione. Se la risposta è fondata ma non risponde del tutto alla domanda, torna alla rifinitura della query per migliorare il recupero.
def grade_generation_v_documents_and_question(state):
print("---CHECK HALLUCINATIONS---")
hallucination_score = hallucination_grader.invoke({"documents": state["documents"], "generation": state["generation"]}).binary_score
if hallucination_score == "yes":
print("---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---")
answer_score = answer_grader.invoke({"question": state["question"], "generation": state["generation"]}).binary_score
if answer_score == "yes":
print("---DECISION: GENERATION ADDRESSES QUESTION---")
return "useful"
print("---DECISION: GENERATION DOES NOT ADDRESS QUESTION---")
return "not useful"
print("---DECISION: GENERATION IS NOT GROUNDED IN DOCUMENTS, RE-TRY---")
return "not supported"Collega insieme tutti i nodi e gli edge
Una volta definiti tutti i nodi e gli edge, possiamo collegarli nel workflow LangGraph per costruire la pipeline Self-RAG. Significa connettere i nodi con edge per gestire il flusso di informazioni e decisioni, assicurando che il workflow funzioni correttamente in base ai risultati di ogni passaggio.
from langgraph.graph import END, StateGraph, START
workflow = StateGraph(GraphState)
# Define the nodes
workflow.add_node("retrieve", retrieve) # retrieve
workflow.add_node("grade_documents", grade_documents) # grade documents
workflow.add_node("generate", generate) # generatae
workflow.add_node("transform_query", transform_query) # transform_query
# Build graph
workflow.add_edge(START, "retrieve")
workflow.add_edge("retrieve", "grade_documents")
workflow.add_conditional_edges(
"grade_documents",
decide_to_generate,
{
"transform_query": "transform_query",
"generate": "generate",
},
)
workflow.add_edge("transform_query", "retrieve")
workflow.add_conditional_edges(
"generate",
grade_generation_v_documents_and_question,
{
"not supported": "generate",
"useful": END,
"not useful": "transform_query",
},
)
# Compile
app = workflow.compile()from IPython.display import Image, display
try:
display(Image(app.get_graph(xray=True).draw_mermaid_png()))
except Exception:
# This requires some extra dependencies and is optional
pass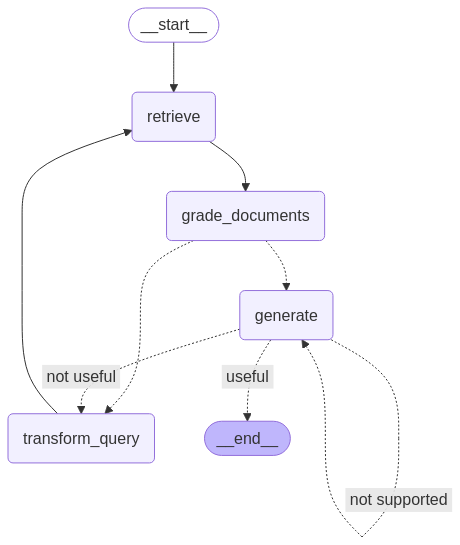
Passo 6: Test del workflow
Per testare la nostra configurazione, eseguiamo il workflow con query di esempio per verificare come recupera le informazioni, valuta la pertinenza dei documenti e genera le risposte.
La prima query verifica quanto bene Self-RAG trovi risposte all’interno della sua knowledge base.
res = app.invoke({"question": "How to improve relationships"})
print(res['generation'])---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: GENERATE---
---GENERATE---
---CHECK HALLUCINATIONS---
---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---
---DECISION: GENERATION ADDRESSES QUESTION---
To improve relationships, consider seeking therapy or life coaching,
as these can provide valuable insights and challenge your perspectives.
Engaging in one-on-one or group therapy can help you reflect on how your
past experiences shape your current interactions. Finding a therapist you
connect with can significantly enhance your understanding and growth in
relationships.E la seconda query mette alla prova la capacità di riflessione di Self-RAG riscrivendo la query quando la knowledge base non ha i documenti pertinenti. Nota che, per come abbiamo impostato il flusso LangGraph, c’è il rischio che il sistema rimanga bloccato in un loop infinito. Per evitarlo, abbiamo impostato il limite di ricorsione a 10.
Un approccio migliore potrebbe essere implementare un limite di retry; dopo N tentativi, se non si trovano documenti utili, il sistema dovrebbe uscire e informare l’utente che non è stato possibile trovare una risposta. Sarebbe un’esperienza utente migliore rispetto a un loop indefinito.
res = app.invoke({"question": "How to cook a bagel?"}, {"recursion_limit": 10})---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
GraphRecursionError: Recursion limit of 10 reached without hitting a stop condition. You can increase the limit by setting the recursion_limit config key.Limitazioni di Self-RAG
Sebbene self-RAG migliori il RAG tradizionale, presenta anche delle sfide.
Una delle principali è la velocità e il costo computazionale. I cicli ripetuti di recupero e affinamento richiedono molta potenza di calcolo, il che può rallentare, soprattutto nelle applicazioni real-time.
Inoltre, poiché Self-RAG si basa su una knowledge base fissa piuttosto che su ricerche web, può incontrare difficoltà quando le informazioni necessarie non sono disponibili. In tali casi, il sistema spreca tempo e risorse cercando ripetutamente qualcosa che semplicemente non c’è.
Un’altra sfida è mantenere l’accuratezza fattuale. Anche se Self-RAG è progettato per affinare le proprie risposte, può comunque recuperare e generare informazioni irrilevanti. Ottimizzare il sistema per trovare un equilibrio tra troppo vago e eccessivamente dettagliato è complesso, perché richiede molti dati di alta qualità e potenza computazionale.
Conclusione
Nel complesso, self-RAG rappresenta un grande passo avanti nel RAG, rendendolo più autodiretto e agentico. Introducendo un ciclo di feedback che trasforma le query, filtra i documenti irrilevanti e itera sulle proprie risposte, self-RAG supera molte limitazioni del RAG tradizionale.
Per saperne di più su self-RAG, dai un’occhiata all’articolo originale qui.

Ryan è un lead data scientist specializzato nello sviluppo di applicazioni di IA con LLM. È dottorando in Elaborazione del Linguaggio Naturale e Knowledge Graph all’Imperial College London, dove ha anche conseguito la laurea magistrale in Informatica. Oltre alla data science, scrive una newsletter settimanale su Substack, The Limitless Playbook, in cui condivide un’idea pratica dei migliori pensatori al mondo e, di tanto in tanto, scrive sui concetti fondamentali dell’IA.





I sistemi di Retrieval-Augmented Generation (RAG) tradizionali recuperano documenti e generano risposte in un unico passaggio, ma spesso questo approccio fallisce perché riporta informazioni irrilevanti, perde documenti chiave e non risponde direttamente alle domande degli utenti, compromettendo l’accuratezza complessiva del RAG.
Il futuro del RAG è agentico: sistemi che sanno pensare e adattarsi per migliorare le proprie risposte. Sebbene il RAG pienamente agentico sia ancora in evoluzione, self-RAG è un esempio semplice ma potente di questa idea in azione.
Self-RAG include un ciclo di feedback integrato che filtra i documenti scadenti, riscrive la query se il recupero fallisce e verifica se la risposta ha senso, provando di nuovo se necessario.
In questo articolo ti presenterò Self-RAG e ti guiderò in un’implementazione passo dopo passo usando LangGraph.