

Wat is Self-RAG?
Self-RAG introduceert iteratief redeneren en zelfevaluatie, waardoor het systeem de retrieval en generatie dynamisch kan bijsturen totdat een hoogwaardig antwoord is bereikt. In plaats van RAG als een eenmalig proces te behandelen, integreert self-RAG feedbacklussen om bij elke stap slimmere beslissingen te nemen.
Het Self-RAG-proces omvat vier kernbeslissingen:
- Moet er retrieval plaatsvinden?
- Het systeem beslist eerst of het documenten moet ophalen op basis van alleen de vraag of op basis van een eerste antwoordpoging. Dit voorkomt onnodige retrieval en maakt dynamische aanpassing mogelijk.
- Zijn de opgehaalde documenten relevant?
- Elk opgehaald document wordt onafhankelijk beoordeeld op relevantie. Als een document niet nuttig is voor het beantwoorden van de query, wordt het vóór de generatie weggegooid.
- Is de gegenereerde respons gebaseerd op de opgehaalde documenten?
- Na het genereren van een antwoord controleert het systeem of alle beweringen in de respons worden ondersteund door de opgehaalde inhoud. Als er niet-ondersteunde uitspraken worden gevonden, kan het systeem proberen de respons te verfijnen.
- Beantwoordt de respons daadwerkelijk de vraag van de gebruiker?
- Zelfs als een antwoord feitelijk correct is, kan het de vraag van de gebruiker niet volledig beantwoorden. Gegeven het antwoord en de vraag van de gebruiker voorspelt het systeem of het uiteindelijke antwoord nuttig is of niet (binair) en beslist het of het opnieuw moet genereren of moet stoppen.
Door zelfreflectie bij elke stap in te voeren, maakt Self-RAG retrieval betrouwbaarder, voorkomt het hallucinaties en zorgt het ervoor dat het uiteindelijke antwoord gegrond en relevant is voor de vraag van de gebruiker.
Self-RAG implementeren met LangGraph
In dit deel leg ik stap voor stap uit hoe je self-RAG implementeert met LangGraph. Je leert je omgeving in te richten, een basis vectorstore voor kennis te maken en de kerncomponenten te configureren die nodig zijn voor self-RAG, zoals de retrieval evaluator, question rewriter en webzoektool.
We leren ook hoe je een LangGraph-workflow bouwt die al deze onderdelen samenbrengt, en laten zien hoe self-RAG verschillende soorten queries kan afhandelen voor nauwkeurigere en betrouwbaardere resultaten.
Stap 1: Setup en installatie
Installeer eerst de vereiste pakketten. Deze stap zet de omgeving op om de Self-RAG-pijplijn te draaien.
%pip install -U langchain_community tiktoken langchain-openai langchainhub chromadb langchain langgraphConfigureer vervolgens je API-sleutels voor OpenAI:
import os
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"Stap 2: Richt een proxy-kennisbank in
Om RAG uit te voeren, hebben we eerst een kennisbank gevuld met documenten nodig. In deze stap scrapen we enkele voorbeeldartikelen van een Substack-nieuwsbrief om een vectorstore te maken, die dient als onze proxy-kennisbank. Deze vectorstore helpt ons relevante documenten te vinden op basis van gebruikersvragen.
We beginnen met het laden van documenten van de opgegeven URL’s en splitsen ze in kleinere secties met een text splitter. Deze secties worden vervolgens ge-embed met OpenAIEmbeddings en opgeslagen in een vectordatabase (Chroma) voor efficiënte documentopvraging.
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import WebBaseLoader
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings
urls = [
"<https://ryanocm.substack.com/p/123-how-tiny-experiments-can-lead>",
"<https://ryanocm.substack.com/p/122-life-razor-the-one-sentence-that>",
"<https://ryanocm.substack.com/p/121-warren-buffetts-255-strategy>",
"<https://ryanocm.substack.com/p/120-30-years-on-earth-11-habits-that>",
]
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
chunk_size=250, chunk_overlap=0
)
doc_splits = text_splitter.split_documents(docs_list)
# Add to vectorDB
vectorstore = Chroma.from_documents(
documents=doc_splits,
collection_name="rag-chroma",
embedding=OpenAIEmbeddings(),
)
retriever = vectorstore.as_retriever()Stap 3: Hulpfuncties opzetten
Om Self-RAG effectief te implementeren, hebben we meerdere LLM’s met verschillende rollen nodig, elk met specifieke prompts en datamodellen. In plaats van code te dupliceren, richten we hier hulpfuncties in om LLM’s en gestructureerde outputs op een consistente, herbruikbare manier te maken.
Met de helperfunctie create_structured_llm kunnen we een LLM initialiseren met een vooraf gedefinieerd schema voor gestructureerde output.
def create_structured_llm(model, schema):
llm = ChatOpenAI(model=model, temperature=0)
return llm.with_structured_output(schema)De helperfunctie create_grading_prompt maakt het eenvoudig om prompts te genereren voor alle LLM’s die in self-RAG worden gebruikt. Door een systeemboodschap en een human-template te nemen, creëert het een gestructureerde prompt voor het beoordelen van documentrelevantie, hallucinaties en antwoordkwaliteit.
def create_grading_prompt(system_message, human_template):
return ChatPromptTemplate.from_messages([
("system", system_message),
("human", human_template),
])Tot slot stroomlijnen we het proces door voor veel van onze LLM-modellen een eenvoudig binair scoringsmodel te gebruiken. In plaats van voor elke evaluator een apart datamodel te maken, definiëren we één BinaryScoreModel dat outputs standaardiseert over verschillende beoordelingstaken heen.
class BinaryScoreModel(BaseModel):
binary_score: str = Field(description="Binary score: 'yes' or 'no'")Stap 4: De kern-LLM-componenten bouwen
Nu we onze hulpfuncties klaar hebben, kunnen we de belangrijkste LLM-componenten maken die nodig zijn voor Self-RAG. Deze componenten beoordelen opgehaalde documenten, detecteren hallucinaties, beoordelen de bruikbaarheid van antwoorden en verfijnen indien nodig queries.
Retrieval evaluator
De retrieval evaluator bepaalt of een opgehaald document relevant is voor de vraag van de gebruiker. Met een gestructureerd binair scoringsmodel kent hij een eenvoudig "yes" of "no" toe op basis van trefwoorden en semantische betekenis. Deze stap zorgt ervoor dat alleen nuttige documenten worden gebruikt voor generatie.
retrieval_evaluator_llm = create_structured_llm("gpt-4o-mini", BinaryScoreModel)
retrieval_evaluator_prompt = create_grading_prompt(
"You are a document retrieval evaluator responsible for checking the relevancy of a retrieved document to the user's question. \\n If the document contains keyword(s) or semantic meaning related to the question, grade it as relevant. \\n Output a binary score 'yes' or 'no'.",
"Retrieved document: \\n\\n {document} \\n\\n User question: {question}"
)
retrieval_grader = retrieval_evaluator_prompt | retrieval_evaluator_llmHallucinatiebeoordelaar
Zelfs met relevante documenten kunnen LLM’s nog steeds niet-ondersteunde claims produceren. De hallucinatiebeoordelaar controleert of de gegenereerde respons gegrond is in de opgehaalde feiten en filtert eventuele hallucinaties eruit. Ook dit volgt een binair beoordelingsmodel.
hallucination_grader = create_grading_prompt(
"You are a grader assessing whether an LLM generation is grounded in / supported by a set of retrieved facts. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer is grounded in / supported by the set of facts.",
"Set of facts: \\n\\n {documents} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)Antwoordbeoordelaar
Een relevant en feitelijk antwoord is niet genoeg als het de vraag van de gebruiker niet volledig beantwoordt. De antwoordbeoordelaar evalueert of de gegenereerde respons direct inspeelt op de intentie van de gebruiker, opnieuw met een binaire score "yes" of "no".
answer_grader = create_grading_prompt(
"You are a grader assessing whether an answer addresses / resolves a question. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer resolves the question.",
"User question: \\n\\n {question} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)Question rewriter
Als relevante documenten ontbreken, kan het herformuleren van de query de retrieval verbeteren. De question rewriter neemt de oorspronkelijke gebruikersinput en optimaliseert die voor betere documentopvraging, zodat het systeem de grootste kans heeft om nuttige context te vinden.
question_rewriter = create_grading_prompt(
"You are a question re-writer that converts an input question to a better version optimized for vectorstore retrieval. Look at the input and try to reason about the underlying semantic intent / meaning.",
"Here is the initial question: \\n\\n {question} \\n Formulate an improved question."
) | ChatOpenAI(model="gpt-4o-mini", temperature=0) | StrOutputParser()RAG-keten
Tot slot handelt de RAG-keten het kernproces van retrieval-augmented generation af. Hij formatteert opgehaalde documenten, voert ze in een LLM-prompt en extraheert de gegenereerde respons.
rag_prompt = hub.pull("rlm/rag-prompt")
rag_llm = ChatOpenAI(model_name="gpt-4o-mini", temperature=0)
def format_docs(docs):
return "\\n\\n".join(doc.page_content for doc in docs)
rag_chain = rag_prompt | rag_llm | StrOutputParser()Stap 5: LangGraph-workflow opzetten
Om de Self-RAG-workflow met LangGraph te bouwen, volg je deze vier hoofdpunten:
- Definieer de graph state
- Definieer node-functies
- Definieer edge-functies
- Verbind alle nodes en edges
Definieer de graph state
Maak een gedeelde state om data op te slaan terwijl die tussen nodes beweegt tijdens de workflow. Deze state bevat alle variabelen, zoals de vraag van de gebruiker, opgehaalde documenten en gegenereerde antwoorden.
from typing import List
from typing_extensions import TypedDict
class GraphState(TypedDict):
"""
Represents the state of our graph.
Attributes:
question: question
generation: LLM generation
documents: list of documents
"""
question: str
generation: str
documents: List[str]Definieer node-functies
In de LangGraph-workflow handelt elke functienode een specifieke taak in de Self-RAG-pijplijn af, zoals documenten ophalen, relevantie beoordelen, hallucinatiecontroles, enzovoort. Hier is een overzicht van elke functie:
De functie retrieve zoekt documenten uit de kennisbank die relevant zijn voor de vraag van de gebruiker. Hij gebruikt een retrieverobject, meestal een vectorstore gemaakt van voorbewerkte documenten. Deze functie neemt de huidige state, inclusief de vraag van de gebruiker, en gebruikt de retriever om relevante documenten te halen. Vervolgens voegt hij deze documenten toe aan de state.
def retrieve(state):
print("---RETRIEVE---")
question = state["question"]
documents = retriever.invoke(question)
return {"documents": documents, "question": question}De functie generate maakt een antwoord op de vraag van de gebruiker met de opgehaalde documenten. Hij werkt met de RAG-keten, die een prompt combineert met een taalmodel. Deze functie neemt de opgehaalde documenten en de vraag van de gebruiker, verwerkt ze via de RAG-keten en voegt vervolgens het antwoord toe aan de state.
def generate(state):
print("---GENERATE---")
return {
"documents": state["documents"],
"question": state["question"],
"generation": rag_chain.invoke({"context": state["documents"], "question": state["question"]})
}De functie grade_documents controleert hoe relevant elk opgehaald document is voor de vraag van de gebruiker met de retrieval evaluator. Dit helpt ervoor te zorgen dat alleen nuttige informatie wordt gebruikt voor het uiteindelijke antwoord. Deze functie beoordeelt de relevantie van elk document en filtert diegenen eruit die niet nuttig zijn. Hij werkt ook de state bij met een vlag web_search om aan te geven of een webzoekactie nodig is wanneer de meeste documenten niet relevant zijn.
def grade_documents(state):
print("---CHECK DOCUMENT RELEVANCE TO QUESTION---")
question = state["question"]
documents = state["documents"]
filtered_docs = [d for d in documents if retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score == "yes"]
for d in documents:
grade = retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score
print(f"---GRADE: DOCUMENT {'RELEVANT' if grade == 'yes' else 'NOT RELEVANT'}---")
return {"documents": filtered_docs, "question": question}De functie transform_query verbetert de vraag van de gebruiker om betere zoekresultaten te krijgen, vooral als de oorspronkelijke query geen relevante documenten vindt. Hij gebruikt een question rewriter om de vraag duidelijker en specifieker te maken. Een betere vraag vergroot de kans op het vinden van nuttige documenten uit zowel de kennisbank als webzoekacties.
def transform_query(state):
print("---TRANSFORM QUERY---")
return {"documents": state["documents"], "question": question_rewriter.invoke({"question": state["question"]})}Definieer edge-functies
In self-RAG sturen edge-functies de uitvoering door sleutelbeslissingen te nemen bij elke stap van het retrieval- en generatieproces. In tegenstelling tot traditionele RAG, die een vaste pijplijn volgt, past self-RAG zich dynamisch aan op basis van de kwaliteit van opgehaalde documenten en gegenereerde antwoorden. Deze conditionele edges zijn als volgt:
Beslis om opnieuw te retrieven of te genereren (decide_to_generate)
Deze edge-functie beoordeelt of de opgehaalde documenten voldoende relevant zijn om door te gaan met generatie. Als er geen bruikbare documenten zijn gevonden, wordt querytransformatie geactiveerd om de zoekopdracht te verfijnen vóór een nieuwe ophaalpoging. Anders gaan we door naar het genereren van een antwoord.
def decide_to_generate(state):
print("---ASSESS GRADED DOCUMENTS---")
if not state["documents"]:
print("---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---")
return "transform_query"
print("---DECISION: GENERATE---")
return "generate"Valideer het gegenereerde antwoord (grade_generation_v_documents_and_question)
Deze edge-functie evalueert de juistheid en bruikbaarheid van de gegenereerde respons. Eerst wordt gecontroleerd op hallucinaties; als de respons niet volledig wordt ondersteund door opgehaalde documenten, wordt de generatie opnieuw geprobeerd. Als de respons gegrond is maar de vraag niet volledig beantwoordt, wordt teruggelust naar queryverfijning om de retrieval te verbeteren.
def grade_generation_v_documents_and_question(state):
print("---CHECK HALLUCINATIONS---")
hallucination_score = hallucination_grader.invoke({"documents": state["documents"], "generation": state["generation"]}).binary_score
if hallucination_score == "yes":
print("---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---")
answer_score = answer_grader.invoke({"question": state["question"], "generation": state["generation"]}).binary_score
if answer_score == "yes":
print("---DECISION: GENERATION ADDRESSES QUESTION---")
return "useful"
print("---DECISION: GENERATION DOES NOT ADDRESS QUESTION---")
return "not useful"
print("---DECISION: GENERATION IS NOT GROUNDED IN DOCUMENTS, RE-TRY---")
return "not supported"Verbind alle nodes en edges
Zodra alle nodes en edges zijn gedefinieerd, kunnen we ze nu in de LangGraph-workflow met elkaar verbinden om de Self-RAG-pijplijn te bouwen. Dit betekent het verbinden van de nodes met edges om de informatiestroom en beslissingen te sturen, zodat de workflow correct draait op basis van de resultaten van elke stap.
from langgraph.graph import END, StateGraph, START
workflow = StateGraph(GraphState)
# Define the nodes
workflow.add_node("retrieve", retrieve) # retrieve
workflow.add_node("grade_documents", grade_documents) # grade documents
workflow.add_node("generate", generate) # generatae
workflow.add_node("transform_query", transform_query) # transform_query
# Build graph
workflow.add_edge(START, "retrieve")
workflow.add_edge("retrieve", "grade_documents")
workflow.add_conditional_edges(
"grade_documents",
decide_to_generate,
{
"transform_query": "transform_query",
"generate": "generate",
},
)
workflow.add_edge("transform_query", "retrieve")
workflow.add_conditional_edges(
"generate",
grade_generation_v_documents_and_question,
{
"not supported": "generate",
"useful": END,
"not useful": "transform_query",
},
)
# Compile
app = workflow.compile()from IPython.display import Image, display
try:
display(Image(app.get_graph(xray=True).draw_mermaid_png()))
except Exception:
# This requires some extra dependencies and is optional
pass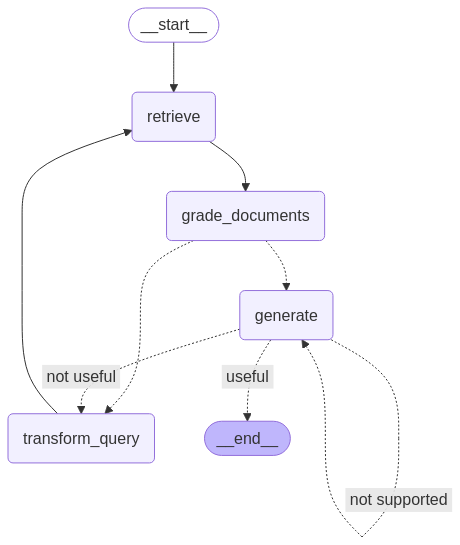
Stap 6: De workflow testen
Om onze setup te testen, draaien we de workflow met voorbeeldqueries om te controleren hoe hij informatie ophaalt, documentrelevantie beoordeelt en responsen genereert.
De eerste query controleert hoe goed Self-RAG antwoorden vindt binnen de eigen kennisbank.
res = app.invoke({"question": "How to improve relationships"})
print(res['generation'])---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: GENERATE---
---GENERATE---
---CHECK HALLUCINATIONS---
---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---
---DECISION: GENERATION ADDRESSES QUESTION---
To improve relationships, consider seeking therapy or life coaching,
as these can provide valuable insights and challenge your perspectives.
Engaging in one-on-one or group therapy can help you reflect on how your
past experiences shape your current interactions. Finding a therapist you
connect with can significantly enhance your understanding and growth in
relationships.En de tweede query test het reflectievermogen van Self-RAG door de query te herschrijven wanneer de kennisbank niet over de relevante documenten beschikt. Let op dat er, gezien de manier waarop we de LangGraph-flow hebben ingericht, een risico is dat het systeem in een oneindige lus vastloopt. Om dit te voorkomen, hebben we de recursielimiet op 10 gezet.
Een betere aanpak kan zijn om een retry-limiet te implementeren; na N pogingen, als er geen bruikbare documenten worden gevonden, zou het systeem moeten stoppen en de gebruiker laten weten dat er geen antwoord kon worden gevonden. Dat biedt een betere gebruikerservaring dan oneindig blijven loopen.
res = app.invoke({"question": "How to cook a bagel?"}, {"recursion_limit": 10})---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
GraphRecursionError: Recursion limit of 10 reached without hitting a stop condition. You can increase the limit by setting the recursion_limit config key.Beperkingen van Self-RAG
Hoewel self-RAG een verbetering is ten opzichte van traditionele RAG, kent het ook eigen uitdagingen.
Een belangrijke uitdaging is de rekensnelheid en -kosten. De herhaalde cycli van ophalen en verfijnen vereisen aanzienlijke rekenkracht, wat dingen kan vertragen, vooral in real-time toepassingen.
Daarnaast kan Self-RAG, doordat het vertrouwt op een vaste kennisbank in plaats van webzoekopdrachten, moeite hebben wanneer de benodigde informatie niet beschikbaar is. In zulke gevallen verspilt het systeem tijd en middelen door herhaaldelijk te zoeken naar iets dat er simpelweg niet is.
Een andere uitdaging is het waarborgen van feitelijke juistheid. Hoewel Self-RAG is ontworpen om eigen responsen te verfijnen, kan het nog steeds irrelevante informatie ophalen en genereren. Het systeem zo afstellen dat het een balans vindt tussen te vaag en te gedetailleerd is ook lastig, omdat dit veel hoogwaardige data en rekenkracht vereist.
Conclusie
Al met al is self-RAG een grote stap vooruit binnen RAG: meer zelfsturend en agentisch. Door een feedbacklus te introduceren die queries transformeert, irrelevante documenten wegfiltert en eigen antwoorden iteratief verbetert, overwint self-RAG veel beperkingen van traditionele RAG.
Wil je meer leren over self-RAG, bekijk dan het oorspronkelijke paper hier.

Ryan is lead data scientist en gespecialiseerd in het bouwen van AI-toepassingen met LLM’s. Hij is promovendus in Natural Language Processing en Knowledge Graphs aan Imperial College London, waar hij ook zijn master in Computer Science heeft behaald. Buiten data science om schrijft hij een wekelijkse Substack-nieuwsbrief, The Limitless Playbook, waarin hij één toepasbaar idee van ’s werelds beste denkers deelt en af en toe schrijft over kernconcepten in AI.


Traditionele Retrieval-Augmented Generation (RAG)-systemen halen documenten op en genereren antwoorden in één stap, maar die aanpak gaat vaak mis doordat irrelevante informatie wordt teruggebracht, essentiële documenten ontbreken en vragen niet direct worden beantwoord. Dat schaadt de algehele nauwkeurigheid van RAG.
De toekomst van RAG is agentisch: systemen die kunnen nadenken en zich aanpassen om hun eigen antwoorden te verbeteren. Hoewel volledig agentische RAG nog in ontwikkeling is, self-RAG is een eenvoudig maar krachtig voorbeeld van dit idee in de praktijk.
Self-RAG heeft een ingebouwde feedbacklus die slechte documenten eruit filtert, de query herschrijft als ophalen faalt, en controleert of het antwoord logisch is en indien nodig opnieuw probeert.
In dit artikel introduceer ik Self-RAG en neem ik je stap voor stap mee door een implementatie using LangGraph.