

Self-RAG là gì?
Self-RAG đưa vào lý luận lặp và tự đánh giá, cho phép hệ thống điều chỉnh động việc truy xuất và sinh nội dung cho đến khi đạt được phản hồi chất lượng cao. Thay vì coi RAG là quy trình một lần, self-RAG tích hợp các vòng phản hồi để đưa ra quyết định thông minh hơn ở mỗi bước.
Quy trình Self-RAG bao gồm bốn quyết định chính:
- Có nên truy xuất không?
- Hệ thống trước tiên quyết định nên truy xuất tài liệu dựa trên câu hỏi hay dựa trên một lần thử trả lời ban đầu. Điều này tránh truy xuất không cần thiết và cho phép thích ứng linh hoạt.
- Các tài liệu truy xuất có liên quan không?
- Mỗi tài liệu truy xuất được đánh giá độc lập về mức độ liên quan. Nếu tài liệu không hữu ích để trả lời truy vấn, nó sẽ bị loại bỏ trước khi sinh nội dung.
- Phản hồi sinh ra có dựa trên các tài liệu đã truy xuất không?
- Sau khi tạo câu trả lời, hệ thống kiểm tra xem mọi khẳng định trong phản hồi có được hỗ trợ bởi nội dung đã truy xuất không. Nếu phát hiện phát biểu không được hỗ trợ, hệ thống có thể cố gắng tinh chỉnh phản hồi.
- Phản hồi có thực sự trả lời câu hỏi của người dùng không?
- Ngay cả khi câu trả lời đúng về mặt sự kiện, nó có thể không giải quyết đầy đủ câu hỏi của người dùng. Dựa trên câu trả lời và câu hỏi, hệ thống sẽ dự đoán liệu câu trả lời cuối cùng có hữu ích hay không (nhị phân) và quyết định tạo lại hay dừng.
Bằng cách đưa tự phản tư vào mọi bước, Self-RAG làm cho truy xuất đáng tin cậy hơn, ngăn ảo giác và đảm bảo câu trả lời cuối cùng bám sát và liên quan đến câu hỏi của người dùng.
Triển khai Self-RAG bằng LangGraph
Trong phần này, tôi sẽ giải thích từng bước cách triển khai self-RAG bằng LangGraph. Bạn sẽ học cách thiết lập môi trường, tạo một kho vector tri thức cơ bản và cấu hình các thành phần chính cần cho self-RAG như bộ đánh giá truy xuất, bộ viết lại câu hỏi và công cụ tìm kiếm web.
Chúng ta cũng sẽ học cách xây dựng một quy trình LangGraph để kết nối tất cả các phần này, minh họa cách self-RAG xử lý nhiều loại truy vấn nhằm mang lại kết quả chính xác và đáng tin cậy hơn.
Bước 1: Thiết lập và cài đặt
Trước tiên, hãy cài đặt các gói cần thiết. Bước này thiết lập môi trường để chạy pipeline Self-RAG.
%pip install -U langchain_community tiktoken langchain-openai langchainhub chromadb langchain langgraphTiếp theo, cấu hình khóa API cho OpenAI:
import os
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"Bước 2: Thiết lập kho tri thức đại diện
Để thực hiện RAG, trước hết chúng ta cần một kho tri thức chứa các tài liệu. Ở bước này, chúng ta sẽ thu thập một số tài liệu mẫu từ một bản tin Substack để tạo kho vector, đóng vai trò là kho tri thức đại diện. Kho vector này giúp tìm tài liệu liên quan dựa trên truy vấn của người dùng.
Chúng ta bắt đầu bằng cách tải tài liệu từ các URL cung cấp và chia chúng thành các phần nhỏ hơn bằng bộ tách văn bản. Các phần này sau đó được nhúng bằng OpenAIEmbeddings và lưu vào một cơ sở dữ liệu vector (Chroma) để truy xuất tài liệu hiệu quả.
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import WebBaseLoader
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings
urls = [
"<https://ryanocm.substack.com/p/123-how-tiny-experiments-can-lead>",
"<https://ryanocm.substack.com/p/122-life-razor-the-one-sentence-that>",
"<https://ryanocm.substack.com/p/121-warren-buffetts-255-strategy>",
"<https://ryanocm.substack.com/p/120-30-years-on-earth-11-habits-that>",
]
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
chunk_size=250, chunk_overlap=0
)
doc_splits = text_splitter.split_documents(docs_list)
# Add to vectorDB
vectorstore = Chroma.from_documents(
documents=doc_splits,
collection_name="rag-chroma",
embedding=OpenAIEmbeddings(),
)
retriever = vectorstore.as_retriever()Bước 3: Thiết lập các hàm trợ giúp
Để triển khai Self-RAG hiệu quả, chúng ta cần nhiều LLM với các vai trò khác nhau, mỗi LLM sử dụng prompt và mô hình dữ liệu cụ thể. Thay vì lặp lại mã, ở đây chúng ta thiết lập các hàm trợ giúp để tạo LLM và đầu ra có cấu trúc theo cách nhất quán, có thể tái sử dụng.
Với hàm trợ giúp create_structured_llm, chúng ta có thể khởi tạo LLM với lược đồ đầu ra có cấu trúc được xác định trước.
def create_structured_llm(model, schema):
llm = ChatOpenAI(model=model, temperature=0)
return llm.with_structured_output(schema)Hàm trợ giúp create_grading_prompt giúp tạo prompt dễ dàng cho tất cả LLM dùng trong self-RAG. Bằng cách nhận thông điệp hệ thống và mẫu cho người dùng, nó tạo prompt có cấu trúc để đánh giá mức độ liên quan của tài liệu, ảo giác và chất lượng phản hồi.
def create_grading_prompt(system_message, human_template):
return ChatPromptTemplate.from_messages([
("system", system_message),
("human", human_template),
])Cuối cùng, chúng ta tinh gọn quy trình bằng cách dùng một mô hình chấm điểm nhị phân đơn giản cho nhiều mô-đun LLM. Thay vì tạo mô hình dữ liệu riêng cho mỗi bộ đánh giá, chúng ta định nghĩa một BinaryScoreModel để chuẩn hóa đầu ra trên các tác vụ chấm điểm khác nhau.
class BinaryScoreModel(BaseModel):
binary_score: str = Field(description="Binary score: 'yes' or 'no'")Bước 4: Xây dựng các thành phần LLM cốt lõi
Giờ đây khi đã có các hàm trợ giúp, chúng ta có thể tạo các thành phần LLM chính cần cho Self-RAG. Những thành phần này đánh giá tài liệu đã truy xuất, phát hiện ảo giác, chấm điểm mức độ hữu ích của phản hồi và tinh chỉnh truy vấn khi cần.
Bộ đánh giá truy xuất
Bộ đánh giá truy xuất xác định xem tài liệu truy xuất có liên quan đến câu hỏi của người dùng hay không. Sử dụng mô hình chấm điểm nhị phân có cấu trúc, nó gán "yes" hoặc "no" dựa trên khớp từ khóa và ý nghĩa ngữ nghĩa. Bước này đảm bảo chỉ những tài liệu hữu ích mới được dùng để sinh nội dung.
retrieval_evaluator_llm = create_structured_llm("gpt-4o-mini", BinaryScoreModel)
retrieval_evaluator_prompt = create_grading_prompt(
"You are a document retrieval evaluator responsible for checking the relevancy of a retrieved document to the user's question. \\n If the document contains keyword(s) or semantic meaning related to the question, grade it as relevant. \\n Output a binary score 'yes' or 'no'.",
"Retrieved document: \\n\\n {document} \\n\\n User question: {question}"
)
retrieval_grader = retrieval_evaluator_prompt | retrieval_evaluator_llmBộ chấm ảo giác
Ngay cả với tài liệu liên quan, LLM vẫn có thể tạo ra khẳng định không được hỗ trợ. Bộ chấm ảo giác kiểm tra xem phản hồi sinh ra có dựa trên sự kiện đã truy xuất hay không, lọc bỏ các ảo giác. Nó cũng sử dụng mô hình chấm điểm nhị phân.
hallucination_grader = create_grading_prompt(
"You are a grader assessing whether an LLM generation is grounded in / supported by a set of retrieved facts. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer is grounded in / supported by the set of facts.",
"Set of facts: \\n\\n {documents} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)Bộ chấm câu trả lời
Một phản hồi liên quan và dựa trên sự kiện vẫn là chưa đủ nếu nó không trả lời đầy đủ câu hỏi của người dùng. Bộ chấm câu trả lời đánh giá liệu phản hồi sinh ra có trực tiếp đáp ứng ý định của người dùng hay không, cũng dùng điểm nhị phân "yes" hoặc "no".
answer_grader = create_grading_prompt(
"You are a grader assessing whether an answer addresses / resolves a question. \\n Give a binary score 'yes' or 'no'. 'Yes' means that the answer resolves the question.",
"User question: \\n\\n {question} \\n\\n LLM generation: {generation}"
) | create_structured_llm("gpt-4o-mini", BinaryScoreModel)Bộ viết lại câu hỏi
Khi thiếu tài liệu liên quan, việc diễn đạt lại truy vấn có thể cải thiện truy xuất. Bộ viết lại câu hỏi lấy đầu vào ban đầu của người dùng và tối ưu hóa để truy xuất tài liệu tốt hơn, đảm bảo hệ thống có cơ hội tìm thấy ngữ cảnh hữu ích cao nhất.
question_rewriter = create_grading_prompt(
"You are a question re-writer that converts an input question to a better version optimized for vectorstore retrieval. Look at the input and try to reason about the underlying semantic intent / meaning.",
"Here is the initial question: \\n\\n {question} \\n Formulate an improved question."
) | ChatOpenAI(model="gpt-4o-mini", temperature=0) | StrOutputParser()Chuỗi RAG
Cuối cùng, chuỗi RAG xử lý quy trình sinh nội dung tăng cường truy xuất cốt lõi. Nó định dạng các tài liệu đã truy xuất, đưa chúng vào prompt cho LLM và trích xuất phản hồi sinh ra.
rag_prompt = hub.pull("rlm/rag-prompt")
rag_llm = ChatOpenAI(model_name="gpt-4o-mini", temperature=0)
def format_docs(docs):
return "\\n\\n".join(doc.page_content for doc in docs)
rag_chain = rag_prompt | rag_llm | StrOutputParser()Bước 5: Thiết lập quy trình LangGraph
Để xây dựng quy trình Self-RAG với LangGraph, hãy làm theo bốn bước chính sau:
- Xác định trạng thái của đồ thị
- Định nghĩa các hàm nút
- Định nghĩa các hàm cạnh
- Kết nối tất cả các nút và cạnh với nhau
Xác định trạng thái của đồ thị
Tạo trạng thái dùng chung để lưu trữ dữ liệu khi nó di chuyển giữa các nút trong quá trình thực thi. Trạng thái này sẽ giữ tất cả biến, như câu hỏi của người dùng, tài liệu truy xuất và câu trả lời đã sinh.
from typing import List
from typing_extensions import TypedDict
class GraphState(TypedDict):
"""
Represents the state of our graph.
Attributes:
question: question
generation: LLM generation
documents: list of documents
"""
question: str
generation: str
documents: List[str]Định nghĩa các hàm nút
Trong quy trình LangGraph, mỗi nút hàm xử lý một tác vụ cụ thể trong pipeline Self-RAG, như truy xuất tài liệu, đánh giá mức độ liên quan, kiểm tra ảo giác, v.v. Sau đây là chi tiết từng hàm:
Hàm retrieve tìm tài liệu từ kho tri thức liên quan đến câu hỏi của người dùng. Nó sử dụng một đối tượng retriever, thường là kho vector được tạo từ tài liệu đã tiền xử lý. Hàm này nhận trạng thái hiện tại, bao gồm câu hỏi của người dùng, và dùng retriever để lấy tài liệu liên quan. Sau đó thêm các tài liệu này vào trạng thái.
def retrieve(state):
print("---RETRIEVE---")
question = state["question"]
documents = retriever.invoke(question)
return {"documents": documents, "question": question}Hàm generate tạo phản hồi cho câu hỏi của người dùng bằng các tài liệu đã truy xuất. Nó làm việc với chuỗi RAG, kết hợp prompt với mô hình ngôn ngữ. Hàm này nhận tài liệu đã truy xuất và câu hỏi của người dùng, xử lý chúng qua chuỗi RAG, rồi thêm câu trả lời vào trạng thái.
def generate(state):
print("---GENERATE---")
return {
"documents": state["documents"],
"question": state["question"],
"generation": rag_chain.invoke({"context": state["documents"], "question": state["question"]})
}Hàm grade_documents kiểm tra mức độ liên quan của từng tài liệu truy xuất với câu hỏi người dùng bằng bộ đánh giá truy xuất. Điều này giúp đảm bảo chỉ thông tin hữu ích được dùng cho câu trả lời cuối. Hàm này chấm mức độ liên quan của từng tài liệu và lọc bỏ tài liệu không hữu ích. Nó cũng cập nhật trạng thái với cờ web_search để cho biết có cần tìm kiếm web khi đa số tài liệu không liên quan hay không.
def grade_documents(state):
print("---CHECK DOCUMENT RELEVANCE TO QUESTION---")
question = state["question"]
documents = state["documents"]
filtered_docs = [d for d in documents if retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score == "yes"]
for d in documents:
grade = retrieval_grader.invoke({"question": question, "document": d.page_content}).binary_score
print(f"---GRADE: DOCUMENT {'RELEVANT' if grade == 'yes' else 'NOT RELEVANT'}---")
return {"documents": filtered_docs, "question": question}Hàm transform_query cải thiện câu hỏi của người dùng để có kết quả tìm kiếm tốt hơn, đặc biệt khi truy vấn ban đầu không tìm được tài liệu liên quan. Nó dùng bộ viết lại câu hỏi để làm cho câu hỏi rõ ràng và cụ thể hơn. Câu hỏi tốt hơn sẽ tăng khả năng tìm được tài liệu hữu ích từ cả kho tri thức và tìm kiếm web.
def transform_query(state):
print("---TRANSFORM QUERY---")
return {"documents": state["documents"], "question": question_rewriter.invoke({"question": state["question"]})}Định nghĩa các hàm cạnh
Trong self-RAG, các hàm cạnh điều khiển luồng thực thi bằng cách đưa ra quyết định quan trọng ở mỗi bước của quá trình truy xuất và sinh nội dung. Khác với RAG truyền thống đi theo một pipeline cố định, self-RAG thích ứng động dựa trên chất lượng tài liệu truy xuất và phản hồi đã sinh. Các cạnh điều kiện gồm:
Quyết định truy xuất lại hay sinh câu trả lời (decide_to_generate)
Hàm cạnh này đánh giá liệu các tài liệu đã truy xuất đủ liên quan để tiến hành sinh nội dung hay chưa. Nếu không tìm thấy tài liệu hữu ích, nó kích hoạt biến đổi truy vấn để tinh chỉnh tìm kiếm trước khi thử truy xuất lần nữa. Nếu ngược lại, nó chuyển sang bước sinh câu trả lời.
def decide_to_generate(state):
print("---ASSESS GRADED DOCUMENTS---")
if not state["documents"]:
print("---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---")
return "transform_query"
print("---DECISION: GENERATE---")
return "generate"Xác thực câu trả lời đã sinh (grade_generation_v_documents_and_question)
Hàm cạnh này đánh giá độ chính xác và mức độ hữu ích của phản hồi đã sinh. Trước tiên nó kiểm tra ảo giác; nếu phản hồi không được các tài liệu hỗ trợ đầy đủ, nó sẽ thử sinh lại. Nếu phản hồi dựa trên tài liệu nhưng chưa trả lời đầy đủ câu hỏi, nó quay lại bước tinh chỉnh truy vấn để cải thiện truy xuất.
def grade_generation_v_documents_and_question(state):
print("---CHECK HALLUCINATIONS---")
hallucination_score = hallucination_grader.invoke({"documents": state["documents"], "generation": state["generation"]}).binary_score
if hallucination_score == "yes":
print("---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---")
answer_score = answer_grader.invoke({"question": state["question"], "generation": state["generation"]}).binary_score
if answer_score == "yes":
print("---DECISION: GENERATION ADDRESSES QUESTION---")
return "useful"
print("---DECISION: GENERATION DOES NOT ADDRESS QUESTION---")
return "not useful"
print("---DECISION: GENERATION IS NOT GROUNDED IN DOCUMENTS, RE-TRY---")
return "not supported"Kết nối tất cả các nút và cạnh
Khi tất cả nút và cạnh đã được định nghĩa, giờ đây chúng ta có thể liên kết chúng trong quy trình LangGraph để xây dựng pipeline Self-RAG. Điều này có nghĩa là kết nối các nút bằng các cạnh để quản lý luồng thông tin và quyết định, đảm bảo quy trình chạy đúng dựa trên kết quả của từng bước.
from langgraph.graph import END, StateGraph, START
workflow = StateGraph(GraphState)
# Define the nodes
workflow.add_node("retrieve", retrieve) # retrieve
workflow.add_node("grade_documents", grade_documents) # grade documents
workflow.add_node("generate", generate) # generatae
workflow.add_node("transform_query", transform_query) # transform_query
# Build graph
workflow.add_edge(START, "retrieve")
workflow.add_edge("retrieve", "grade_documents")
workflow.add_conditional_edges(
"grade_documents",
decide_to_generate,
{
"transform_query": "transform_query",
"generate": "generate",
},
)
workflow.add_edge("transform_query", "retrieve")
workflow.add_conditional_edges(
"generate",
grade_generation_v_documents_and_question,
{
"not supported": "generate",
"useful": END,
"not useful": "transform_query",
},
)
# Compile
app = workflow.compile()from IPython.display import Image, display
try:
display(Image(app.get_graph(xray=True).draw_mermaid_png()))
except Exception:
# This requires some extra dependencies and is optional
pass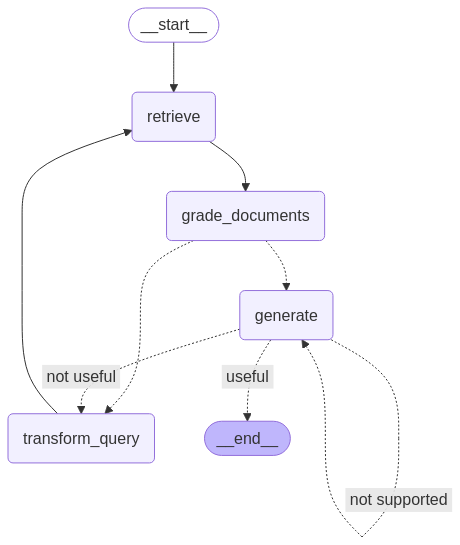
Bước 6: Kiểm thử quy trình
Để kiểm thử thiết lập, chúng ta chạy quy trình với các truy vấn mẫu để kiểm tra cách nó truy xuất thông tin, đánh giá mức độ liên quan của tài liệu và tạo phản hồi.
Truy vấn đầu tiên kiểm tra mức độ Self-RAG tìm câu trả lời trong kho tri thức của nó.
res = app.invoke({"question": "How to improve relationships"})
print(res['generation'])---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: GENERATE---
---GENERATE---
---CHECK HALLUCINATIONS---
---DECISION: GENERATION IS GROUNDED IN DOCUMENTS---
---DECISION: GENERATION ADDRESSES QUESTION---
To improve relationships, consider seeking therapy or life coaching,
as these can provide valuable insights and challenge your perspectives.
Engaging in one-on-one or group therapy can help you reflect on how your
past experiences shape your current interactions. Finding a therapist you
connect with can significantly enhance your understanding and growth in
relationships.Và truy vấn thứ hai kiểm tra khả năng tự phản tư của Self-RAG bằng cách viết lại truy vấn khi kho tri thức không có tài liệu liên quan. Lưu ý rằng theo cách chúng ta thiết lập luồng LangGraph, có nguy cơ hệ thống bị kẹt trong vòng lặp vô hạn. Để ngăn điều này, chúng ta đặt giới hạn đệ quy là 10.
Một cách tốt hơn là triển khai giới hạn số lần thử; sau N lần, nếu không tìm được tài liệu hữu ích, hệ thống nên thoát và thông báo cho người dùng rằng không thể tìm thấy câu trả lời. Điều này sẽ mang lại trải nghiệm tốt hơn thay vì lặp vô tận.
res = app.invoke({"question": "How to cook a bagel?"}, {"recursion_limit": 10})---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
---CHECK DOCUMENT RELEVANCE TO QUESTION---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---GRADE: DOCUMENT NOT RELEVANT---
---ASSESS GRADED DOCUMENTS---
---DECISION: ALL DOCUMENTS ARE NOT RELEVANT TO QUESTION, TRANSFORM QUERY---
---TRANSFORM QUERY---
---RETRIEVE---
GraphRecursionError: Recursion limit of 10 reached without hitting a stop condition. You can increase the limit by setting the recursion_limit config key.Hạn chế của Self-RAG
Dù self-RAG cải tiến so với RAG truyền thống, nó cũng có những thách thức riêng.
Một thách thức chính là tốc độ tính toán và chi phí. Các vòng lặp truy xuất và tinh chỉnh lặp lại đòi hỏi năng lực xử lý đáng kể, có thể làm chậm hệ thống, đặc biệt trong ứng dụng thời gian thực.
Ngoài ra, do Self-RAG dựa vào kho tri thức cố định thay vì tìm kiếm web, nó có thể gặp khó khi thông tin cần thiết không có sẵn. Trong các trường hợp như vậy, hệ thống lãng phí thời gian và tài nguyên khi lặp lại việc tìm kiếm thứ vốn dĩ không tồn tại.
Một thách thức khác là duy trì độ chính xác về sự kiện. Mặc dù Self-RAG được thiết kế để tự tinh chỉnh phản hồi, nó vẫn có thể truy xuất và sinh ra thông tin không liên quan. Việc tinh chỉnh hệ thống để cân bằng giữa quá mơ hồ và quá chi tiết cũng phức tạp, vì cần rất nhiều dữ liệu chất lượng cao và năng lực tính toán.
Kết luận
Tổng thể, self-RAG là một bước tiến lớn của RAG, khiến nó tự chủ hơn và mang tính tác tử cao hơn. Bằng cách đưa vào vòng phản hồi để biến đổi truy vấn, lọc tài liệu không liên quan và lặp lại trên chính câu trả lời của mình, self-RAG khắc phục nhiều hạn chế của RAG truyền thống.
Để tìm hiểu thêm về self-RAG, hãy xem bài báo gốc tại đây.

Ryan là trưởng nhóm khoa học dữ liệu, chuyên xây dựng các ứng dụng AI sử dụng LLM. Anh là nghiên cứu sinh Tiến sĩ về Xử lý Ngôn ngữ Tự nhiên và Đồ thị Tri thức tại Imperial College London, nơi anh cũng hoàn thành bằng Thạc sĩ Khoa học Máy tính. Ngoài lĩnh vực khoa học dữ liệu, anh viết bản tin Substack hàng tuần, The Limitless Playbook, nơi anh chia sẻ một ý tưởng có thể áp dụng ngay từ các tư tưởng gia hàng đầu thế giới và đôi khi viết về những khái niệm cốt lõi của AI.


Các hệ thống Retrieval-Augmented Generation (RAG) truyền thống truy xuất tài liệu và tạo câu trả lời trong một bước, nhưng cách tiếp cận đó thường thất bại vì đưa về thông tin không liên quan, bỏ sót tài liệu quan trọng và không trả lời trực tiếp câu hỏi của người dùng, làm giảm độ chính xác tổng thể của RAG.
Tương lai của RAG là tác tử hóa; các hệ thống có thể suy nghĩ và thích nghi để cải thiện chính câu trả lời của mình. Dù RAG tác tử đầy đủ vẫn đang phát triển, self-RAG là một ví dụ đơn giản nhưng mạnh mẽ cho ý tưởng này trong thực tế.
Self-RAG có vòng phản hồi tích hợp để lọc tài liệu kém chất lượng, viết lại truy vấn nếu truy xuất thất bại, và kiểm tra tính hợp lý của câu trả lời rồi thử lại khi cần.
Trong bài viết này, tôi sẽ giới thiệu Self-RAG và hướng dẫn bạn triển khai từng bước sử d LangGraph.