课程
SQL 中的数据处理
4 小时
337.1K
要提升 SQL 查询的性能,首先需要了解当您按下运行快捷键时,内部都发生了什么。
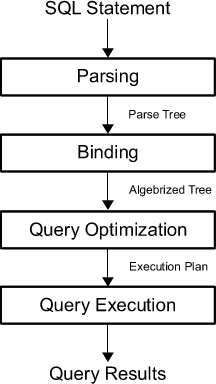
首先,查询会被解析为“解析树”;系统会检查查询是否满足语法与语义要求。解析器会为输入查询创建内部表示。随后,这一输出被传递给重写引擎。
接着,优化器负责为给定查询寻找最优的执行(或查询)计划。执行计划会精确定义每个操作所用的算法,以及各操作如何协调执行。
为找到最优计划,优化器会枚举所有可能的执行计划,评估每个计划的质量或代价,结合数据库当前状态信息,然后选择最佳者作为最终执行计划。由于查询优化器并非完美,数据库用户与管理员有时需要手动检查并调优优化器生成的计划,以获得更好性能。
此时您或许会问,什么样的计划才算“好的查询计划”?
如前所述,计划的代价质量至关重要。更具体地,包括评估该计划所需的磁盘 I/O 次数、计划的 CPU 成本、数据库客户端可观察到的总体响应时间,以及总执行时间。这正是时间复杂度概念将要发挥作用的地方。稍后您会读到更多。
随后,系统的执行引擎会执行选定的查询计划,评估并返回查询结果。
上一节未直说的一点是,垃圾进,垃圾出(GIGO)原则会自然体现在查询处理与执行中:提出查询的人,某种意义上也掌握了 SQL 查询性能的关键。如果优化器拿到的是糟糕的查询,它所能做的也十分有限。
这意味着,当您编写查询时,有一些事情是您可以做的。正如引言所说,职责是双重的:不仅要写出达到一定质量标准的查询,还要大致判断查询中可能潜伏的性能问题位置。
一个理想的起点,是思考查询中可能出问题的“位置”。一般来说,初学者最容易在四类子句与关键字上遇到性能问题:
WHERE 子句;INNER JOIN 或 LEFT JOIN 关键字;以及,HAVING 子句;诚然,这种方法简单而朴素,但对新手而言,这些子句与语句是很好的提示位。可以说,在入门阶段,错误往往就发生在这里,且讽刺的是,它们也最难被发现。
不过,您也应意识到,性能需要放在上下文中评估才有意义:仅仅说这些子句和关键字“不好”,并不是正确的 SQL 性能思维。在查询中包含 WHERE 或 HAVING 子句,并不必然意味着这是个糟糕的查询。
继续阅读下一节,了解反模式及其替代做法,帮助您构建 SQL 查询。以下提示与技巧旨在提供参考。是否需要重写查询,取决于数据量、数据库类型、执行频率等因素。关键还是看您的查询目标,并尽可能了解目标数据库!
“数据越多越好”的思维并不适用于写 SQL 查询:不仅会因超出所需而模糊洞见,还可能因为拉取过多数据而拖累查询性能。
因此,通常要留意 SELECT 语句、DISTINCT 子句和 LIKE 运算符。
SELECT Statement写完查询后,首先可以检查 SELECT 语句是否尽量精简。目标是移除不必要的列,只拉取服务于查询目标的数据。
若您有包含 EXISTS 的相关子查询,且只是做存在性检查,尽量在该子查询的 SELECT 中使用常量,而不是实际列值。
请记住,相关子查询会使用外层查询的值。另请注意,虽然在此上下文中 NULL 也可视作“常量”,但它会造成严重困惑!
看下面的示例,理解使用常量的含义:
SELECT driverslicensenr, name FROM Drivers WHERE EXISTS (SELECT '1' FROM Fines WHERE fines.driverslicensenr = drivers.driverslicensenr);提示:拥有相关子查询并非总是好主意。您可以考虑用 INNER JOIN 重写以去除它们:
SELECT driverslicensenr, name FROM drivers INNER JOIN fines ON fines.driverslicensenr = drivers.driverslicensenr; DISTINCT ClauseSELECT DISTINCT 用于仅返回不重复的值。若可避免,应尽量不要使用 DISTINCT。如前例所示,加入该子句通常会增加执行时间。因此务必评估是否确实需要这一步去重才能得到目标结果。
LIKE Operator在查询中使用 LIKE 时,若模式以 % 或 _ 开头,将无法使用索引(即便存在索引)。从另一个角度看,这类查询也可能放宽了条件,从而拉取过多与查询目标并不相关的记录。
再次强调,了解数据库中的数据有助于您制定更精准的匹配模式,只筛出真正相关的行。
当无法再缩减 SELECT 时,可以考虑其他方式限制结果集。例如使用 LIMIT 子句与数据类型转换等方法。
TOP、LIMIT 与 ROWNUM 子句您可以在查询中添加 LIMIT 或 TOP 来设置结果集的最大行数。示例如下:
SELECT TOP 3 * FROM Drivers;注意,您还可以进一步指定 PERCENT,例如将第一行改为 SELECT TOP 50 PERCENT *。
SELECT driverslicensenr, name FROM Drivers LIMIT 2;此外,还可添加 ROWNUM 子句,它与 LIMIT 等效:
SELECT *FROM DriversWHERE driverslicensenr = 123456 AND ROWNUM <= 3;应尽量使用最高效(即最小)的数据类型。为可用更小类型却提供了超大的类型,往往有风险。
然而,在查询中加入数据类型转换,会增加执行时间。
替代做法是尽量避免类型转换。当然,并非总能移除或省略类型转换;当必须使用时,务必谨慎评估其必要性,并在执行前测试其影响。
类型转换引出了下一个要点:不要过度设计查询。尽量保持简洁高效。这看似“老生常谈”,尤其是在查询很容易变复杂的情况下。
不过,您会在接下来的示例中看到,简单查询很容易被写得比必要的更复杂。
OR Operator在查询中使用 OR 运算符时,很可能无法使用索引。
请记住:索引是一种数据结构,用于加速从数据库表中检索数据;但它也有代价:需要额外的写入及存储空间来维护索引结构。借助索引,可以在访问表时快速定位数据,而无需每次都逐行扫描整张表。索引可建立在表中的一个或多个列上。
若未能利用数据库中的索引,查询势必更慢。因此应尽量寻找替代写法来避免使用 OR;
考虑下面的查询:
SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr = 123456OR driverslicensenr = 678910OR driverslicensenr = 345678;可以替换为:
IN 条件;或SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr IN (123456, 678910, 345678);SELECT 再以 UNION 合并。提示:谨慎使用 UNION,因为会多次扫描同一张表。同时要意识到,使用 UNION 会增加执行时间。UNION 的替代方案包括:把所有条件合并到一个 SELECT 语句中,或用 OUTER JOIN 代替 UNION。
提示:还要注意,尽管 OR(以及后文提到的其他运算符)通常无法利用索引,但索引查找也并非总是优选!
NOT Operator当查询包含 NOT 运算符时,也很可能无法使用索引,与 OR 类似,从而拖慢查询。例如:
SELECT driverslicensenr, nameFROM DriversWHERE NOT (year > 1980);这条查询比您预期更慢,主要因为写得过于复杂。更好的做法是用比较运算符(如 >、<> 或 !>)替换 NOT。上述示例可改写为:
SELECT driverslicensenr, nameFROM DriversWHERE year <= 1980;是不是更简洁了?
AND OperatorAND 也是一种可能无法利用索引、且在复杂低效写法下拖慢查询的运算符,例如:
SELECT driverslicensenr, nameFROM DriversWHERE year >= 1960 AND year <= 1980;更好的写法是使用 BETWEEN:
SELECT driverslicensenr, nameFROM DriversWHERE year BETWEEN 1960 AND 1980;ANY 和 ALL 运算符ANY 与 ALL 也需谨慎使用,因为包含它们通常无法利用索引。实用的替代方案包括使用聚合函数,如 MIN 或 MAX。
提示:当使用这些替代方案时,要意识到跨多行的聚合函数(如 SUM、AVG、MIN、MAX)可能导致长时间运行。在此情形下,可尝试减少需要处理的行数,或预先计算这些值。再次说明,做出查询选择时,了解环境与查询目标非常重要!
当列参与到计算或标量函数中时,也往往无法使用索引。解决办法是将该列从计算或函数中“隔离”出来。示例如下:
SELECT driverslicensenr, nameFROM DriversWHERE year + 10 = 1980;看起来有些“花哨”,不如重新思考计算方式,改写为:
SELECT driverslicensenr, nameFROM DriversWHERE year = 1970;最后一点是不要过度限制查询,否则会影响性能。尤其是在联接与 HAVING 子句上要注意。
当联接两张表时,考虑联接中的表顺序可能很重要。若两表相差悬殊,可将更大的表放在联接的最后。
在联接中加入过多条件,会迫使 SQL 选择特定路径,而该路径未必最优。
HAVING ClauseHAVING 最初加入 SQL,是因为 WHERE 不能与聚合函数配合使用。HAVING 通常与 GROUP BY 一起,用于限制只返回满足特定条件的分组。然而,使用该子句时通常无法使用索引,这会导致性能下降——如您已知晓的。
若要寻找替代方案,考虑使用 WHERE。对比如下:
SELECT state, COUNT(*) FROM Drivers WHERE state IN ('GA', 'TX') GROUP BY state ORDER BY stateSELECT state, COUNT(*) FROM Drivers GROUP BY stateHAVING state IN ('GA', 'TX') ORDER BY state第一条在分组前用 WHERE 限制需要汇总的行数;而第二条先对整表分组汇总,再用 HAVING 丢弃部分结果。在这类情形中,使用 WHERE 显然更优,因为不浪费资源。
您会发现,这里关注的不是限制最终结果集,而是限制查询过程中的中间记录数量。
注意:二者差异在于,WHERE 针对单行设定条件;而 HAVING 针对聚合结果或基于多行产生单一结果(如 MIN、MAX、SUM 等)后再设定条件。
可见,评估查询质量、编写与重写查询并不轻松,尤其当您要求其尽可能高效时;避免反模式并考虑替代写法,也是您在专业环境中为数据库编写查询时应承担的职责之一。
上述清单只是对部分反模式与提示的简要概览,希望能帮助初学者;若想了解资深开发者眼中的高频反模式,参见这段讨论。
前述反模式背后隐含着一个事实:它们归根结底源于基于集合与过程式两种构建查询的差异。
过程式查询更像编程:您告诉系统要做什么、以及如何做。
例如,在联接中添加冗余条件,或滥用 HAVING,又或通过一个函数再接一个函数地处理,或使用包含循环、条件、自定义函数(UDF)、游标等的逻辑来得到最终结果。在这种思路下,您常常是先要一部分数据,再要另一部分,如此逐步推进。
不出所料,这种方法常被称为“逐步”或“逐行”(row-by-row)查询。
另一种是基于集合的方法,您只需声明要做什么。您的职责是声明结果集需要满足的条件或要求;至于如何取数,则交给内部机制去决定具体实现:让数据库引擎选择执行查询的最佳算法或处理逻辑。
鉴于 SQL 天生是基于集合的语言,这种方法通常要比过程式更高效,也解释了为何在某些情况下,SQL 会比代码更快。
提示:数据科学领域的顶级雇主通常要求您掌握基于集合的查询思路!您常常需要在这两种方法间切换。
注意:若发现自己写出了过程式查询,应考虑重写或重构。
反模式并非一成不变;随着您作为 SQL 开发者的成长,它也会演进。再加上在考虑替代写法时,要权衡的因素很多,这意味着避免反模式与重写查询可能相当困难。此时,借助工具、采取更结构化的方法来优化查询会很有帮助。
同时注意,上一节提到的一些反模式,本质上是性能方面的问题,例如 AND、OR、NOT 的索引利用不足。考虑性能不仅需要更结构化的方法,也需要更深入的分析。
无论如何,这种结构化且深入的方法大多以查询计划为基础。正如您记得的,查询计划是查询被解析为“解析树”后的产物,它定义了每个操作所用的算法,以及操作如何协调执行。
如引言所述,您有时需要手动检查并调优优化器生成的计划。在这种情况下,您需要基于查询计划再次分析查询。
要获取查询计划,需使用数据库管理系统提供的工具。常见工具包括:
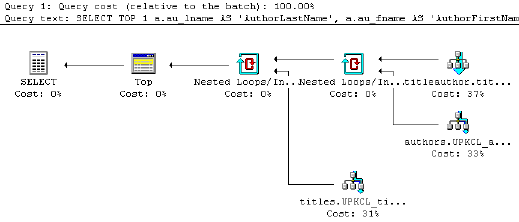
EXPLAIN PLAN 是一个例子,但不同 RDBMS 的指令名称不同。您也可能看到 EXPLAIN(MySQL、PostgreSQL)或 EXPLAIN QUERY PLAN(SQLite)。注意:在 PostgreSQL 中,EXPLAIN 仅给出计划器拟如何执行查询的描述(不真正运行);而 EXPLAIN ANALYZE 会实际执行查询,并返回预期与实际计划的对比分析。一般而言,“实际执行计划”指真正运行了查询;“估算执行计划”则是不执行、仅说明会怎么做。尽管二者在逻辑上等价,但实际计划更有用,因为包含执行中发生的更多细节与统计信息。
本节余下内容将介绍 EXPLAIN 与 ANALYZE,以及如何用它们了解查询计划与潜在性能。我们将从两个表的示例开始:one_million 与 half_million。
您可以用 EXPLAIN 获取表 one_million 的当前信息;将其置于查询最前面,运行后会返回查询计划:
EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18584.82 rows=1025082 width=36)(1 row)此处可见,查询代价为 0.00..18584.82,行数为 1025082,列宽为 36。
随后,您可以用 ANALYZE 更新统计信息:
ANALYZE one_million;EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(1 row)除 EXPLAIN 与 ANALYZE 外,还可用 EXPLAIN ANALYZE 获取实际执行时间:
EXPLAIN ANALYZESELECT *FROM one_million;QUERY PLAN___________________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(actual time=0.015..1207.019 rows=1000000 loops=1)Total runtime: 2320.146 ms(2 rows)EXPLAIN ANALYZE 的劣势显而易见:它会真正执行查询,请谨慎使用!
到目前为止,您看到的算法是 Seq Scan(顺序扫描)或全表扫描:即按顺序读取表中每一行,并检查是否满足条件。就性能而言,顺序扫描并非最佳,因为仍是全表扫描。但当表装不下内存时,它也不算差:即便磁盘较慢,顺序读也很快。
关于索引扫描,稍后会看到更多。
当然还有其他算法。比如,以下联接的查询计划:
EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN_________________________________________________________________Hash Join (cost=15417.00..68831.00 rows=500000 width=42)(actual time=1241.471..5912.553 rows=500000 loops=1)Hash Cond: (one_million.counter = half_million.counter) -> Seq Scan on one_million (cost=0.00..18334.00 rows=1000000 width=37) (actual time=0.007..1254.027 rows=1000000 loops=1) -> Hash (cost=7213.00..7213.00 rows=500000 width=5) (actual time=1241.251..1241.251 rows=500000 loops=1) Buckets: 4096 Batches: 16 Memory Usage: 770kB -> Seq Scan on half_million (cost=0.00..7213.00 rows=500000 width=5)(actual time=0.008..601.128 rows=500000 loops=1)Total runtime: 6468.337 ms可见优化器选择了 Hash Join!记住这一操作,稍后估算时间复杂度会用到。注意,这里 half_million.counter 没有索引,您可以在下例中添加:
CREATE INDEX ON half_million(counter);EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN________________________________________________________________Merge Join (cost=4.12..37650.65 rows=500000 width=42)(actual time=0.033..3272.940 rows=500000 loops=1)Merge Cond: (one_million.counter = half_million.counter) -> Index Scan using one_million_counter_idx on one_million (cost=0.00..32129.34 rows=1000000 width=37) (actual time=0.011..694.466 rows=500001 loops=1) -> Index Scan using half_million_counter_idx on half_million (cost=0.00..14120.29 rows=500000 width=5)(actual time=0.010..683.674 rows=500000 loops=1)Total runtime: 3833.310 ms(5 rows)可以看到,创建索引后,优化器改用了 Merge join,并出现了 Index Scan。
注意 索引扫描与全表(顺序)扫描的区别:后者逐行扫描整表;前者(也称“表扫描”)会扫描数据页或索引页以定位相应记录。
总运行时间减少,性能更好;但由于出现两次索引扫描,内存的重要性上升,尤其当表装不下内存时。此时需要先完成一次完整索引扫描(快速的顺序读,不是问题),随后进行大量随机读以按索引值取行。正是这些随机读,通常比顺序读慢几个数量级。在这种情形下,全表扫描反而可能比完整索引扫描更快。
现在您已初步查看了查询计划,可以借助计算复杂度理论,从更正式的角度思考性能。该理论计算机科学领域关注按难度对计算问题进行分类;这些计算问题可以是算法,也可以是查询。
不过,对于查询,我们并非按“难度”分类,而是按运行并返回结果所需的时间进行分类。这就是时间复杂度。要表达或度量这种复杂度,可以使用大 O 记号。
用大 O 记号,您可以根据输入规模变大时运行时间的增长速度来表达运行时长。大 O 记号会忽略常数与低阶项,使您聚焦于查询运行时间中最重要的部分:增长速率。以这种方式表达(忽略常数与低阶项)时,我们称时间复杂度是“渐近”的,即输入规模趋于无穷大。
在数据库语境中,复杂度衡量的是:随着数据表(因此数据库)规模增长,查询运行时间会增加多少。
注意:数据库规模的增长不仅源于表中数据增多,数据库中存在的索引也会影响大小。
如前所述,执行计划会定义每个操作所用的算法。因此,每次查询执行时间都可逻辑地表示为与计划中涉及的表大小有关的函数,即复杂度函数。换言之,您可以结合大 O 记号与执行计划,来估算查询复杂度与性能。
接下来,您将对四类时间复杂度有个大致认识,并看到查询的时间复杂度如何随运行上下文而变化。
提示:索引是故事的关键部分!
注意:索引类型、执行计划与不同数据库的实现各不相同,所以下述复杂度仅为一般性描述,具体取决于您的环境。
若算法无论输入大小如何,都需相同时间,则为常数时间。对应到查询,即无论表大小如何,运行时间相同。
这类查询并不常见,但例如:
SELECT TOP 1 t.* FROM t时间复杂度为常数,因为您只从表中选择一行任意记录,所需时间与表大小无关。
若算法的执行时间与输入规模成正比(输入增大,时间线性增长),则为线性时间。对数据库而言,即执行时间与表大小成正比:行数越多,查询时间越长。
一个例子是对未建索引列使用 WHERE 的查询:需要全表扫描或 Seq Scan,时间复杂度为 O(n)。这意味着必须读取每一行以找到目标行。您没有任何“上限”,即使第一行就匹配,也仍需读取所有行。
再看一个例子:若 i_id 未建索引,下述查询的复杂度为 O(n):
SELECT i_id FROM item;COUNT(*) FROM TABLE; 的计数查询,若未存储总行数,通常时间复杂度为 O(n);若表的总行数被存储,则复杂度更接近 O(1)。与线性时间密切相关的是包含联接的执行计划。示例如下:
请记住:嵌套联接会将一表的每条记录与另一表的每条记录比较。
若算法的执行时间与输入规模的对数成正比,则为对数时间;对于查询,即执行时间与数据库大小的对数成正比。
当执行计划进行 Index Scan 或聚簇索引扫描时,通常为对数时间。聚簇索引的叶子层存放表的实际数据行;它与其他索引类似,定义在一个或多个列上,这些列构成索引键,聚簇键即该聚簇索引的键列。聚簇索引扫描本质上是 RDBMS 自上而下地在聚簇索引中读取行。
如下例所示,若 i_id 上有索引,通常复杂度为 O(log(n)):
SELECT i_stock FROM item WHERE i_id = N; 注意:若无索引,时间复杂度将为 O(n)。
若算法执行时间与输入规模的平方成正比,则为二次时间。对数据库而言,即查询执行时间与数据库大小的平方成正比。
一个可能具有二次时间复杂度的查询示例如下:
SELECT * FROM item, author WHERE item.i_a_id=author.a_id 其最小复杂度可达 O(n log(n)),但最大复杂度可达 O(n^2),具体取决于联接属性上的索引信息。
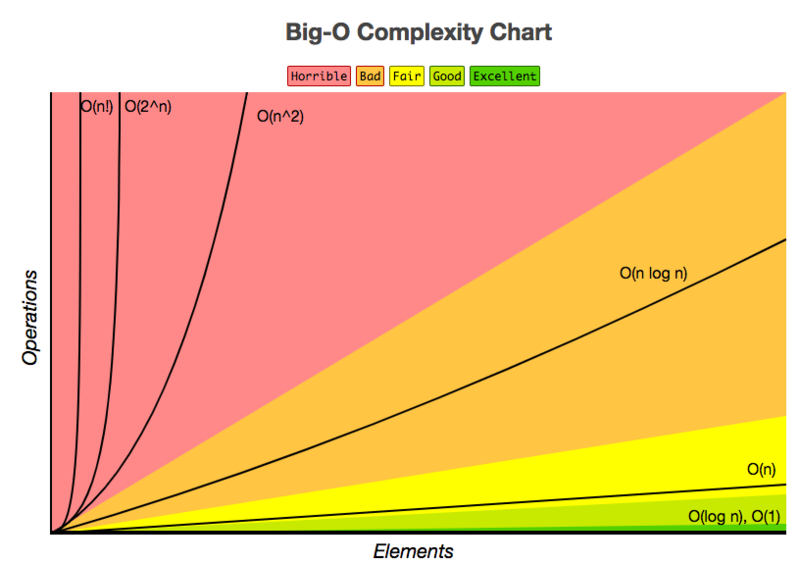
总之,您也可以参考这份速查表,据此估计不同时间复杂度下查询的性能表现:
在理解查询计划与时间复杂度后,您可以进一步调优 SQL 查询。可以从以下方面入手:
恭喜!您已读完本文,对 SQL 查询性能有了初步认识。希望您对反模式、查询优化器,以及用于审查、估算与解读查询计划复杂度的工具有了更多了解。当然,还有更多内容值得探索!若想进一步学习,推荐阅读 R. Ramakrishnan 与 J. Gehrke 合著的《Database Management Systems》。
最后,分享一位 StackOverflow 用户的这句总结:
“我最不喜欢的反模式,就是不测试自己的查询。
以下情形都会中招:
- 查询涉及多张表。
- 自以为设计最优,却从不验证假设。
- 只要第一个能跑通的查询就满足,完全不关心是否接近优化。”
如果您想开始学习 SQL,可以考虑以下 DataCamp 课程:
进一步了解 SQL
课程