
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Om de performance van je SQL-query te verbeteren, moet je eerst weten wat er intern gebeurt wanneer je de sneltoets indrukt om de query uit te voeren.
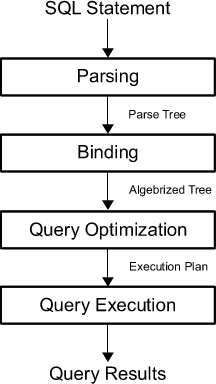
Eerst wordt de query geparseerd in een “parse tree”; de query wordt geanalyseerd op syntactische en semantische vereisten. De parser maakt een interne representatie van de inputquery. Deze output gaat vervolgens naar de rewrite-engine.
Daarna is het de taak van de optimizer om het optimale uitvoerings- of queryplan te vinden voor de gegeven query. Het uitvoeringsplan definieert precies welk algoritme voor elke operatie wordt gebruikt en hoe de uitvoering van de operaties op elkaar is afgestemd.
Om het meest optimale uitvoeringsplan te vinden, somt de optimizer alle mogelijke plannen op, bepaalt de kwaliteit of kost van elk plan, neemt informatie mee over de huidige databanktoestand en kiest vervolgens het beste als definitief plan. Omdat query-optimizers niet perfect zijn, moeten databasegebruikers en -beheerders plannen soms handmatig bekijken en tunen om betere performance te halen.
Je vraagt je nu waarschijnlijk af wat wordt gezien als een “goed queryplan”.
Zoals je al las, speelt de kost van een plan een grote rol. Concreet zijn zaken als het aantal benodigde disk-I/O’s om het plan te evalueren, de CPU-kost van het plan en de totale responstijd die de databaseclient waarneemt, plus de totale uitvoeringstijd, essentieel. Daar komt het idee van tijdscomplexiteit bij kijken. Later lees je hier meer over.
Vervolgens wordt het gekozen queryplan uitgevoerd door de execution engine van het systeem en worden de resultaten van je query teruggegeven.
Wat in de vorige sectie misschien niet expliciet was, is dat het Garbage In, Garbage Out (GIGO)-principe vanzelf naar boven komt bij queryverwerking en -uitvoering: degene die de query formuleert, heeft ook de sleutel tot de performance van je SQL-queries in handen. Als de optimizer een slecht geformuleerde query krijgt, kan die maar beperkt uitrichten.
Dat betekent dat er dingen zijn die jij kunt doen tijdens het schrijven van een query. Zoals je in de inleiding zag, is de verantwoordelijkheid tweeledig: het gaat niet alleen om queries schrijven die aan een bepaalde standaard voldoen, maar ook om inzicht krijgen in waar performanceproblemen in je query kunnen schuilen.
Een ideaal startpunt is nadenken over “plekken” in je queries waar issues kunnen binnensluipen. In het algemeen zijn er vier clausules en keywords waar beginners vaak performanceproblemen zien ontstaan:
WHERE-clausule;INNER JOIN of LEFT JOIN; En,HAVING-clausule;Toegegeven, deze aanpak is simpel en naïef, maar voor beginners zijn dit uitstekende aanknopingspunten. Het is veilig om te zeggen dat dit de plekken zijn waar fouten vaak gebeuren en –ironisch genoeg– ook lastig te ontdekken zijn.
Besef wel dat performance pas betekenis krijgt binnen een context: simpelweg zeggen dat deze clausules en keywords “slecht” zijn, is niet de juiste manier om over SQL-performance na te denken. Een WHERE- of HAVING-clausule in je query betekent niet per se dat de query slecht is.
Bekijk de volgende sectie om meer te leren over antipatterns en alternatieve benaderingen om je SQL-query op te bouwen. Deze tips en tricks zijn bedoeld als leidraad. Of en hoe je je query herschrijft, hangt onder meer af van de hoeveelheid data, de database en hoe vaak je de query moet draaien. Het hangt volledig af van het doel van je query, en enige voorkennis van de database die je wilt bevragen is cruciaal!
De mindset “hoe meer data, hoe beter” is er niet een waar je per se naar moet leven bij het schrijven van SQL-queries: je loopt niet alleen het risico je inzichten te vertroebelen door meer op te halen dan je nodig hebt, maar ook de performance kan lijden onder het feit dat je query te veel data ophaalt.
Daarom is het doorgaans slim om extra alert te zijn op de SELECT-instructie, de DISTINCT-clausule en de LIKE-operator.
SELECT-instructieControleer als eerste of je SELECT-instructie zo compact mogelijk is. Je doel hier is overbodige kolommen uit SELECT te verwijderen. Zo dwing je jezelf alleen data op te halen die je querydoel dient.
Heb je gecorreleerde subqueries met EXISTS, probeer dan in de SELECT van die subquery een constante te gebruiken in plaats van de waarde van een echte kolom te selecteren. Dit is vooral handig als je alleen de aanwezigheid wilt controleren.
Onthoud dat een gecorreleerde subquery een subquery is die waarden uit de buitenste query gebruikt. En bedenk dat, hoewel NULL in deze context als “constante” kan werken, dat erg verwarrend is!
Bekijk het volgende voorbeeld om te begrijpen wat wordt bedoeld met een constante gebruiken:
SELECT driverslicensenr, name FROM Drivers WHERE EXISTS (SELECT '1' FROM Fines WHERE fines.driverslicensenr = drivers.driverslicensenr);Tip: een gecorreleerde subquery is niet altijd een goed idee. Overweeg om ze te schrappen door ze bijvoorbeeld te herschrijven met een INNER JOIN:
SELECT driverslicensenr, name FROM drivers INNER JOIN fines ON fines.driverslicensenr = drivers.driverslicensenr; DISTINCT-clausuleDe instructie SELECT DISTINCT wordt gebruikt om alleen unieke waarden terug te geven. DISTINCT is een clausule die je zeker moet proberen te vermijden als het kan. Zoals je in andere voorbeelden hebt gelezen, neemt de uitvoeringstijd toe zodra je deze clausule toevoegt. Overweeg daarom altijd of je deze DISTINCT-bewerking écht nodig hebt om je gewenste resultaat te behalen.
LIKE-operatorAls je de LIKE-operator gebruikt en het patroon begint met % of _, wordt de index niet gebruikt. Dat voorkomt dat de database een index gebruikt (als die bestaat). Vanuit een andere invalshoek kun je ook stellen dat dit soort query mogelijk teveel records ophaalt die niet per se bij je querydoel passen.
Ook hier helpt kennis van de data in de database om een patroon te formuleren dat correct filtert en alleen de rijen vindt die er voor je query echt toe doen.
Als je je SELECT-instructie niet verder kunt beperken met filters, overweeg dan op andere manieren je resultaten te beperken. Hier komen benaderingen zoals de LIMIT-clausule en datatypes-conversies in beeld.
TOP, LIMIT en ROWNUM-clausulesJe kunt LIMIT of TOP toevoegen om een maximum aantal rijen in te stellen voor de resultset. Hier zijn wat voorbeelden:
SELECT TOP 3 * FROM Drivers;Let op dat je PERCENT verder kunt specificeren, bijvoorbeeld door de eerste regel te wijzigen in SELECT TOP 50 PERCENT *.
SELECT driverslicensenr, name FROM Drivers LIMIT 2;Daarnaast kun je ook de ROWNUM-clausule gebruiken, wat gelijkwaardig is aan LIMIT in je query:
SELECT *FROM DriversWHERE driverslicensenr = 123456 AND ROWNUM <= 3;Gebruik altijd de meest efficiënte, dus kleinste, datatypes. Er is altijd risico als je een enorm datatype opgeeft terwijl een kleiner volstaat.
Maar als je een conversie van datatypes aan je query toevoegt, vergroot je alleen de uitvoeringstijd.
Een alternatief is conversies zoveel mogelijk vermijden. Let ook hier op dat het niet altijd mogelijk is om conversies te schrappen, maar wees terughoudend met het opnemen ervan en test het effect voordat je de query draait.
Datatypes-conversies brengen ons bij het volgende punt: over-engineer je queries niet. Houd ze simpel en efficiënt. Dat klinkt misschien te simpel of zelfs suf als tip, zeker omdat queries complex kunnen worden.
Toch zul je in de voorbeelden hieronder zien dat je eenvoudige queries al snel complexer maakt dan nodig.
OR-operatorAls je de OR-operator gebruikt, is de kans groot dat er geen index wordt gebruikt.
Onthoud dat een index een datastructuur is die het ophalen van data versnelt, maar tegen een prijs: extra writes en extra opslagruimte om de index bij te houden. Indexen worden gebruikt om snel data te vinden zonder elke rij van een tabel te hoeven doorzoeken. Ze kunnen worden gemaakt op een of meer kolommen.
Als je de aanwezige indexen niet benut, duurt je query onvermijdelijk langer. Zoek daarom naar alternatieven voor OR in je query;
Overweeg de volgende query:
SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr = 123456OR driverslicensenr = 678910OR driverslicensenr = 345678;Je kunt de operator vervangen door:
IN; ofSELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr IN (123456, 678910, 345678);SELECT-statements met een UNION.Tip: wees hier voorzichtig om UNION niet onnodig te gebruiken, want je loopt dan meerdere keren door dezelfde tabel. Realiseer je ook dat UNION de uitvoeringstijd vergroot. Alternatieven zijn: de query zo herformuleren dat alle voorwaarden in één SELECT staan, of een OUTER JOIN gebruiken in plaats van UNION.
Tip: bedenk ook hier dat, hoewel OR – en ook andere operators hieronder – waarschijnlijk geen index gebruiken, indexlookups niet altijd de voorkeur hebben!
NOT-operatorAls je query de NOT-operator bevat, wordt de index waarschijnlijk niet gebruikt, net zoals bij OR. Dat vertraagt je query. Als je niet weet wat hiermee bedoeld wordt, bekijk dan deze query:
SELECT driverslicensenr, nameFROM DriversWHERE NOT (year > 1980);Deze query zal zeker trager lopen dan je verwacht, vooral omdat hij complexer is geformuleerd dan nodig: in zulke gevallen zoek je beter een alternatief. Vervang NOT door vergelijkingsoperators, zoals >, <> of !>; Het bovenstaande voorbeeld kan herschreven worden naar:
SELECT driverslicensenr, nameFROM DriversWHERE year <= 1980;Dat oogt meteen een stuk netter, toch?
AND-operatorDe AND-operator is nog zo’n operator die geen gebruikmaakt van een index en je query kan vertragen als hij onnodig complex en inefficiënt wordt gebruikt, zoals hieronder:
SELECT driverslicensenr, nameFROM DriversWHERE year >= 1960 AND year <= 1980;Het is beter om deze query te herschrijven met BETWEEN:
SELECT driverslicensenr, nameFROM DriversWHERE year BETWEEN 1960 AND 1980;ANY en ALLOok met ANY en ALL moet je oppassen, want door deze in te zetten wordt de index vaak niet gebruikt. Handige alternatieven zijn aggregatiefuncties zoals MIN of MAX.
Tip: als je de voorgestelde alternatieven gebruikt, wees je bewust dat aggregatiefuncties zoals SUM, AVG, MIN, MAX over veel rijen kunnen leiden tot langlopende queries. Probeer in zulke gevallen het aantal te verwerken rijen te minimaliseren of waarden vooraf te berekenen. Je ziet opnieuw hoe belangrijk het is om je omgeving, je querydoel, … te kennen bij het kiezen van je query!
Ook wanneer een kolom wordt gebruikt in een berekening of in een scalare functie, wordt de index niet gebruikt. Een mogelijke oplossing is de betreffende kolom te isoleren zodat die geen deel meer uitmaakt van de berekening of functie. Overweeg dit voorbeeld:
SELECT driverslicensenr, nameFROM DriversWHERE year + 10 = 1980;Ziet er gek uit, hè? Probeer de berekening te heroverwegen en herschrijf naar zoiets als:
SELECT driverslicensenr, nameFROM DriversWHERE year = 1970;Deze laatste tip betekent dat je de query niet te hard moet proberen te beperken, omdat dat de performance kan schaden. Dit geldt vooral voor joins en voor de HAVING-clausule.
Als je twee tabellen joint, kan de volgorde van de tabellen in je join belangrijk zijn. Merk je dat één tabel aanzienlijk groter is dan de andere, herschrijf de query dan zo dat de grootste tabel als laatste in de join staat.
Als je te veel condities toevoegt aan je joins, dwing je SQL een bepaald pad te kiezen. Het kan echter zijn dat dit pad niet altijd het snelste is.
HAVING-clausuleDe HAVING-clausule is oorspronkelijk aan SQL toegevoegd omdat het keyword WHERE niet met aggregatiefuncties kon worden gebruikt. HAVING wordt doorgaans gebruikt met GROUP BY om de gegroepeerde rijen te beperken tot die groepen die aan bepaalde voorwaarden voldoen. Gebruik je deze clausule, dan wordt de index niet gebruikt, wat –zoals je weet– kan resulteren in een minder presterende query.
Zoek je een alternatief, overweeg dan de WHERE-clausule. Bekijk deze queries:
SELECT state, COUNT(*) FROM Drivers WHERE state IN ('GA', 'TX') GROUP BY state ORDER BY stateSELECT state, COUNT(*) FROM Drivers GROUP BY stateHAVING state IN ('GA', 'TX') ORDER BY stateDe eerste query gebruikt WHERE om het aantal rijen dat moet worden opgeteld te beperken, terwijl de tweede alle rijen optelt en daarna HAVING gebruikt om die sommen weg te gooien. In dit soort gevallen is de WHERE-variant duidelijk beter omdat je geen resources verspilt.
Je ziet dat dit niet gaat om het beperken van de uiteindelijke resultset, maar om het beperken van het tussentijdse aantal records binnen een query.
Let op dat het verschil tussen deze twee clausules is dat WHERE een voorwaarde introduceert op individuele rijen, terwijl HAVING een voorwaarde introduceert op aggregaties of resultaten van een selectie waarbij één resultaat, zoals MIN, MAX, SUM, … is geproduceerd uit meerdere rijen.
Je ziet: de kwaliteit beoordelen en het (her)schrijven van queries is geen makkelijke klus als je ook de performance in het oog houdt; Antipatterns vermijden en alternatieven overwegen hoort bij je verantwoordelijkheid als je queries schrijft die in een professionele omgeving op databases moeten draaien.
Deze lijst was slechts een kleine greep uit enkele antipatterns en tips die beginners hopelijk helpen; Wil je weten wat meer senior ontwikkelaars als meest voorkomende antipatterns zien, bekijk dan deze discussie.
Wat impliciet was in de antipatterns hierboven, is dat ze feitelijk neerkomen op het verschil tussen een set-gebaseerde en een procedurele aanpak van query’s opbouwen.
De procedurele aanpak lijkt op programmeren: je vertelt het systeem wat het moet doen én hoe.
Een voorbeeld is het toevoegen van redundante condities in joins of het misbruiken van de HAVING-clausule, zoals hierboven, waarbij je de database bevraagt door een functie uit te voeren en daarna nog een functie, of logica gebruikt met loops, condities, User Defined Functions (UDF’s), cursors, … om het eindresultaat te krijgen. In deze aanpak vraag je vaak eerst een subset van de data op, daarna nog een subset, enzovoort.
Niet verrassend wordt dit vaak “stap-voor-stap” of “row-by-row”-querying genoemd.
De andere benadering is de set-gebaseerde, waarbij je alleen specificeert wat er moet gebeuren. Jouw rol is voorwaarden of eisen te definiëren voor de resultset die je met de query wilt verkrijgen. Hoe je data wordt opgehaald, laat je over aan de interne mechanismen die de implementatie bepalen: je laat de database-engine de beste algoritmen of verwerkingslogica kiezen om je query uit te voeren.
Aangezien SQL set-gebaseerd is, is het geen verrassing dat deze aanpak vaak effectiever is dan de procedurele – en het verklaart ook waarom SQL in sommige gevallen sneller kan zijn dan code.
Tip de set-gebaseerde aanpak is ook degene die topwerkgevers in de data science-industrie van je verwachten te beheersen! Je zult vaak moeten schakelen tussen deze twee typen benaderingen.
Let op dat als je jezelf betrapt op een procedurele query, je moet overwegen die te herschrijven of te refactoren.
Omdat antipatterns niet statisch zijn en meegroeien met jouw ontwikkeling als SQL-developer, en omdat er veel afwegingen zijn bij alternatieven, is het vermijden van antipatterns en het herschrijven van queries best lastig. Alle hulp is welkom, en daarom kan een meer gestructureerde aanpak met tools de juiste weg zijn om je query te optimaliseren.
Let op dat sommige antipatterns uit de vorige sectie hun oorsprong hebben in performance-zorgen, zoals de operators AND, OR en NOT en het niet benutten van indexen. Over performance nadenken vraagt niet alleen om een gestructureerde aanpak, maar ook om een diepgaandere.
Hoe dan ook, deze gestructureerde en diepgaande aanpak is meestal gebaseerd op het queryplan, dat –zoals je je herinnert– het resultaat is van de query die eerst in een “parse tree” wordt geparset en precies definieert welk algoritme voor elke operatie wordt gebruikt en hoe de uitvoering wordt gecoördineerd.
Zoals je in de inleiding hebt gelezen, kan het zijn dat je plannen die de optimizer produceert handmatig moet bekijken en tunen. In zulke gevallen analyseer je je query opnieuw aan de hand van het queryplan.
Om dit plan te krijgen, gebruik je de tools die je databasebeheersysteem biedt. Enkele mogelijke tools zijn:
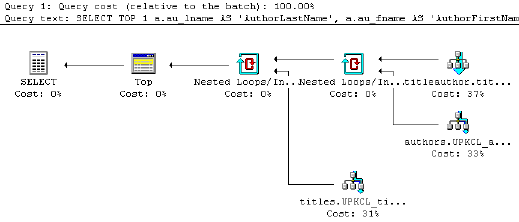
EXPLAIN PLAN in Oracle, maar de naam verschilt per RDBMS. Elders vind je EXPLAIN (MySQL, PostgreSQL) of EXPLAIN QUERY PLAN (SQLite).Let op werk je met PostgreSQL, dan is er verschil tussen EXPLAIN, waarbij je alleen een beschrijving krijgt van hoe de planner de query wil uitvoeren zonder die te draaien, en EXPLAIN ANALYZE, dat de query daadwerkelijk uitvoert en je een analyse geeft van het verwachte versus werkelijke plan. In het algemeen is een echt uitvoeringsplan er een waarbij je de query daadwerkelijk draait, terwijl een geschat plan uitwerkt wat het zou doen zonder uit te voeren. Hoewel logisch equivalent, is een werkelijk plan nuttiger omdat het extra details en statistieken bevat over wat er daadwerkelijk gebeurde.
In de rest van deze sectie leer je meer over EXPLAIN en ANALYZE en hoe je hiermee meer inzicht krijgt in je queryplan en de mogelijke performance. We beginnen met voorbeelden met twee tabellen: one_million en half_million.
Je kunt de huidige informatie van de tabel one_million ophalen met EXPLAIN; Zet het direct boven je query, en bij uitvoering krijg je het queryplan terug:
EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18584.82 rows=1025082 width=36)(1 row)In dit geval zie je dat de kost 0.00..18584.82 is en het aantal rijen 1025082. De breedte (aantal kolommen in bytes) is 36.
Vernieuw vervolgens je statistische informatie met ANALYZE.
ANALYZE one_million;EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(1 row)Naast EXPLAIN en ANALYZE kun je ook de daadwerkelijke uitvoeringstijd ophalen met EXPLAIN ANALYZE:
EXPLAIN ANALYZESELECT *FROM one_million;QUERY PLAN___________________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(actual time=0.015..1207.019 rows=1000000 loops=1)Total runtime: 2320.146 ms(2 rows)Nadeel van EXPLAIN ANALYZE is natuurlijk dat de query echt wordt uitgevoerd, dus wees voorzichtig!
Tot nu toe zag je vooral Seq Scan (sequential scan) of Full Table Scan: elke rij van de tabel wordt sequentieel gelezen en gecontroleerd of die aan een conditie voldoet. Qua performance is de sequential scan zeker niet het beste plan omdat je nog steeds een full table scan doet. Maar als de tabel niet in het geheugen past, zijn sequentiële reads behoorlijk snel, zelfs met trage disks.
Later zie je hier meer over bij de index scan.
Er zijn echter ook andere algoritmen. Neem dit queryplan voor een join:
EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN_________________________________________________________________Hash Join (cost=15417.00..68831.00 rows=500000 width=42)(actual time=1241.471..5912.553 rows=500000 loops=1)Hash Cond: (one_million.counter = half_million.counter) -> Seq Scan on one_million (cost=0.00..18334.00 rows=1000000 width=37) (actual time=0.007..1254.027 rows=1000000 loops=1) -> Hash (cost=7213.00..7213.00 rows=500000 width=5) (actual time=1241.251..1241.251 rows=500000 loops=1) Buckets: 4096 Batches: 16 Memory Usage: 770kB -> Seq Scan on half_million (cost=0.00..7213.00 rows=500000 width=5)(actual time=0.008..601.128 rows=500000 loops=1)Total runtime: 6468.337 msJe ziet dat de query-optimizer hier voor een Hash Join koos! Onthoud deze operatie, want je hebt dit nodig om de tijdscomplexiteit te schatten. Merk op dat er geen index is op half_million.counter, die je in het volgende voorbeeld kunt toevoegen:
CREATE INDEX ON half_million(counter);EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN________________________________________________________________Merge Join (cost=4.12..37650.65 rows=500000 width=42)(actual time=0.033..3272.940 rows=500000 loops=1)Merge Cond: (one_million.counter = half_million.counter) -> Index Scan using one_million_counter_idx on one_million (cost=0.00..32129.34 rows=1000000 width=37) (actual time=0.011..694.466 rows=500001 loops=1) -> Index Scan using half_million_counter_idx on half_million (cost=0.00..14120.29 rows=500000 width=5)(actual time=0.010..683.674 rows=500000 loops=1)Total runtime: 3833.310 ms(5 rows)Door de index te maken, kiest de optimizer nu voor een Merge join met Index Scans.
Let op het verschil tussen de index scan en de full table/sequential scan: bij de eerste worden data- of indexpagina’s gescand om de juiste records te vinden, bij de tweede wordt elke rij gescand.
Je ziet dat de totale runtime is verminderd en de performance beter zou moeten zijn, maar er zijn twee index scans, waardoor geheugen belangrijker wordt, zeker als de tabel niet in het geheugen past. Dan doe je eerst een volledige index scan (snelle sequentiële reads), maar vervolgens veel willekeurige reads om rijen op indexwaarde op te halen. Die random reads zijn doorgaans orders of magnitude trager dan sequentiële reads. In die gevallen is de full table scan inderdaad sneller dan de full index scan.
Nu je het queryplan kort hebt onderzocht, kun je dieper graven en over performance nadenken in meer formele termen met behulp van de computationele complexiteitstheorie. Dit vakgebied in de theoretische informatica classificeert onder andere computationele problemen naar moeilijkheid; die problemen kunnen algoritmen zijn, maar ook queries.
Voor queries classificeer je ze niet per se naar moeilijkheid, maar naar de tijd die nodig is om resultaten te krijgen. Dit heet expliciet tijdscomplexiteit en om die te verwoorden of te meten, kun je de big-O-notatie gebruiken.
Met big O druk je de runtime uit in termen van hoe snel die groeit ten opzichte van de input wanneer de input arbitrair groot wordt. Big O laat coëfficiënten en lagere-orde-termen weg, zodat je focust op het belangrijkste deel van de looptijd: de groeisnelheid. Wanneer je het zo uitdrukt, heet de beschrijving asymptotisch: de inputgrootte gaat naar oneindig.
In databasetaal meet de complexiteit hoeveel langer een query duurt naarmate de grootte van de tabellen –en dus de database– toeneemt.
Let op dat je database niet alleen groeit naarmate er meer data in tabellen staat, maar ook doordat indexen aanwezig zijn.
Zoals je zag, definieert het uitvoeringsplan onder andere welk algoritme voor elke operatie wordt gebruikt. Daardoor kan elke querylooptijd logisch worden uitgedrukt als een functie van de tabelgrootte(n) in het plan, de zogeheten complexiteitsfunctie. Met andere woorden: je kunt big O en je uitvoeringsplan gebruiken om querycomplexiteit en performance te schatten.
In de volgende subsections krijg je een algemeen idee van vier types tijdscomplexiteit en zie je voorbeelden van hoe die voor queries kunnen variëren afhankelijk van de context.
Hint: indexen spelen hier een rol!
Let op er zijn verschillende soorten indexen, uitvoeringsplannen en implementaties in verschillende databases, dus de hieronder genoemde tijdscomplexiteiten zijn heel algemeen en kunnen per situatie variëren.
Een algoritme draait in constante tijd als het evenveel tijd kost ongeacht de inputgrootte. Voor een query betekent dit: evenveel tijd ongeacht de tabelgrootte.
Deze queries zijn niet heel gangbaar, maar hier is een voorbeeld:
SELECT TOP 1 t.* FROM tDe tijdscomplexiteit is constant omdat je één willekeurige rij selecteert. De tijdsduur is dus onafhankelijk van de grootte van de tabel.
Een algoritme draait in lineaire tijd als de uitvoeringstijd recht evenredig is met de inputgrootte; de tijd groeit lineair naarmate de input toeneemt. Voor databases betekent dit: de uitvoeringstijd is recht evenredig met de tabelgrootte.
Een voorbeeld is een query met een WHERE-clausule op een kolom zonder index: er is een full table scan of Seq Scan nodig, wat O(n) oplevert. Elke rij moet gelezen worden om de juiste te vinden. Je hebt geen limiet, dus elke rij moet gelezen worden, zelfs als de eerste al matcht.
Overweeg ook dit voorbeeld dat O(n) is als er geen index op i_id staat:
SELECT i_id FROM item;COUNT(*) FROM TABLE;, een tijdscomplexiteit van O(n) hebben, omdat een full table scan nodig is, tenzij het totaal aantal rijen is opgeslagen voor de tabel. Dan wordt het eerder O(1).Nauw verwant aan lineaire tijd is de uitvoeringstijd voor plannen met joins. Enkele voorbeelden:
Onthoud: een nested join vergelijkt elk record in de ene tabel met elk record in de andere.
Een algoritme draait in logaritmische tijd als de uitvoeringstijd evenredig is met de logaritme van de inputgrootte; voor queries geldt dat de uitvoeringstijd evenredig is met de logaritme van de databasegrootte.
Dit geldt voor plannen met een Index Scan of clustered index scan. Een clustered index is een index waarvan het bladniveau de daadwerkelijke datarijen bevat. Een clustered index wordt, net als andere indexen, gedefinieerd op één of meer kolommen (de index key). De clustering key is de sleutelkolom(men) van een clustered index. Een clustered index scan is dan het lezen van boven naar beneden in de clustered index om de rij(en) te vinden.
Overweeg dit voorbeeld met een index op i_id, dat doorgaans O(log(n)) oplevert:
SELECT i_stock FROM item WHERE i_id = N; Let op zonder index zou de tijdscomplexiteit O(n) zijn.
Een algoritme draait in kwadratische tijd als de uitvoeringstijd evenredig is met het kwadraat van de inputgrootte. Voor databases betekent dit: de uitvoeringstijd is evenredig met het kwadraat van de databasegrootte.
Een mogelijk voorbeeld met kwadratische tijdscomplexiteit:
SELECT * FROM item, author WHERE item.i_a_id=author.a_id De minimale complexiteit is O(n log(n)), maar de maximale kan O(n^2) zijn, afhankelijk van indexinformatie op de joinattributen.
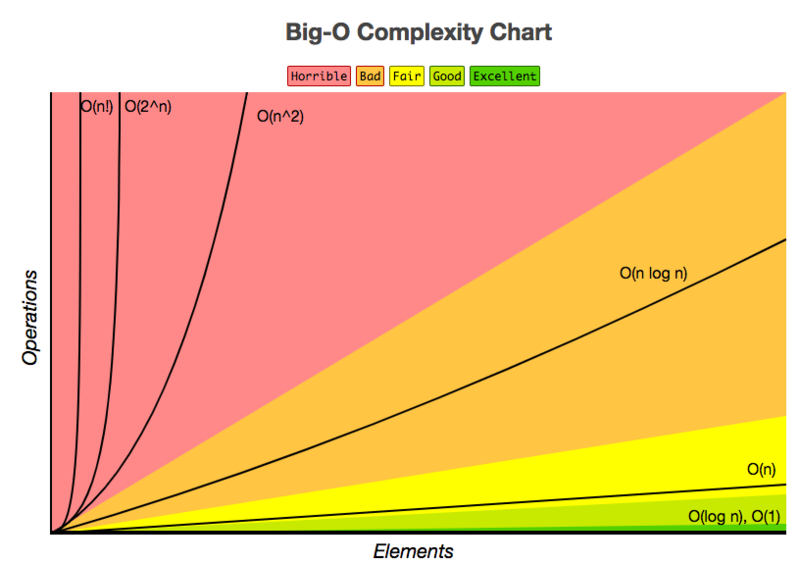
Samenvattend kun je ook naar het volgende cheat sheet kijken om de performance van queries in te schatten op basis van hun tijdscomplexiteit en hoe goed ze zouden presteren:
Met het queryplan en de tijdscomplexiteit in gedachten kun je je SQL-query verder tunen. Let in het bijzonder op het volgende:
Gefeliciteerd! Je bent aan het einde van deze blogpost, die je een kleine blik gaf op SQL-queryperformance. Hopelijk heb je meer inzicht gekregen in antipatterns, de query-optimizer en de tools om de complexiteit van je queryplan te beoordelen, te schatten en te interpreteren. Er valt echter nog veel meer te ontdekken! Wil je meer weten, overweeg dan het boek “Database Management Systems” van R. Ramakrishnan en J. Gehrke.
Tot slot wil ik je deze quote van een StackOverflow-gebruiker niet onthouden:
“Mijn favoriete antipatroon is je queries niet testen.
Dit is van toepassing wanneer:
- Je query meer dan één tabel omvat.
- Je denkt dat je een optimaal ontwerp hebt, maar je aannames niet test.
- Je de eerste query die werkt accepteert, zonder enig idee of die ook maar in de buurt van geoptimaliseerd is."
Als je wilt beginnen met SQL, overweeg dan deze DataCamp-cursussen:
Leer meer over SQL
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

