Curso
Manipulación de datos en SQL
4 h
335K
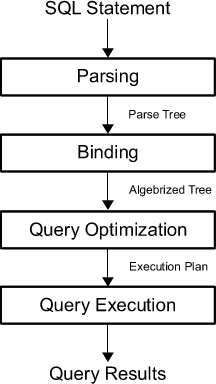
Para mejorar el rendimiento de una consulta SQL, primero necesitas saber qué ocurre internamente cuando pulsas el atajo para ejecutarla.
Primero, la consulta se analiza y se convierte en un «árbol sintáctico»; Se comprueba que cumpla los requisitos sintácticos y semánticos. El parser crea una representación interna de la consulta de entrada. Ese resultado pasa después al motor de reescritura.
Luego, el optimizador se encarga de encontrar el plan de ejecución óptimo para la consulta. El plan de ejecución define exactamente qué algoritmo se usa en cada operación y cómo se coordinan.
Para hallar el plan más óptimo, el optimizador enumera todas las posibilidades, estima la calidad o el coste de cada plan, tiene en cuenta el estado actual de la base de datos y, por último, elige el mejor como plan final. Dado que los optimizadores no son perfectos, a veces usuarios y administradores deben revisar y ajustar manualmente los planes para mejorar el rendimiento.
Ahora quizá te preguntes qué se considera un «buen plan de ejecución».
Como ya has leído, el coste de un plan influye mucho. En concreto, aspectos como el número de I/O de disco necesarios para evaluar el plan, el coste de CPU, el tiempo de respuesta que percibe el cliente de base de datos y el tiempo total de ejecución son clave. Aquí entra la idea de la complejidad temporal. Leerás más sobre ello enseguida.
Después, el plan elegido se ejecuta, el motor de ejecución del sistema lo evalúa y te devuelve los resultados.
Algo que quizá no haya quedado claro es que el principio de Garbage In, Garbage Out (GIGO) aparece de forma natural en el procesamiento y la ejecución: quien formula la consulta tiene en gran medida la llave del rendimiento. Si el optimizador recibe una consulta mal planteada, podrá hacer poco.
Esto significa que hay cosas que tú puedes hacer al escribir una consulta. Como viste en la introducción, la responsabilidad es doble: no solo se trata de escribir consultas que cumplan cierto estándar, sino también de intuir dónde pueden esconderse los cuellos de botella.
Un buen punto de partida es pensar en «zonas» de tus consultas donde pueden colarse problemas. En general, hay cuatro cláusulas y palabras clave donde quienes empiezan suelen encontrarse con problemas de rendimiento:
WHERE;INNER JOIN o LEFT JOIN; Y,HAVING;Es un enfoque simple y quizá ingenuo, pero como principiante estas cláusulas son buenos indicadores, y es bastante habitual que los fallos se concentren ahí y, paradójicamente, cueste detectarlos.
Ahora bien, el rendimiento necesita contexto para tener sentido: afirmar sin más que estas cláusulas son «malas» no tiene sentido. Incluir WHERE o HAVING no convierte tu consulta en mala por sí misma.
Pasa a la siguiente sección para ver anti‑patrones y alternativas a la hora de construir tu consulta SQL. Estos trucos son una guía: si tienes que reescribir o no tu consulta depende del volumen de datos, de la base de datos, de cuántas veces la ejecutes, etc. Todo depende del objetivo de la consulta, y conocer de antemano la base de datos a la que apuntas es crucial.
La mentalidad de «cuantos más datos, mejor» no aplica cuando escribes consultas SQL: no solo corres el riesgo de enterrar tus conclusiones bajo información irrelevante, también puedes perjudicar el rendimiento al traer demasiados datos.
Por eso conviene vigilar especialmente la instrucción SELECT, la cláusula DISTINCT y el operador LIKE.
SELECT StatementLo primero que puedes revisar es si tu SELECT es lo más compacto posible. El objetivo es eliminar columnas innecesarias del SELECT. Así te obligas a traer solo lo que aporta al objetivo de la consulta.
Si tienes subconsultas correlacionadas con EXISTS, intenta usar una constante en el SELECT de esa subconsulta en lugar del valor de una columna real. Es útil cuando solo estás comprobando la existencia.
Recuerda que una subconsulta correlacionada usa valores de la consulta externa. Y ojo: aunque NULL podría servir como «constante», es muy confuso.
Fíjate en este ejemplo para ver a qué nos referimos con usar una constante:
SELECT driverslicensenr, name FROM Drivers WHERE EXISTS (SELECT '1' FROM Fines WHERE fines.driverslicensenr = drivers.driverslicensenr);Consejo: una subconsulta correlacionada no siempre es buena idea. Puedes plantearte eliminarla reescribiéndola, por ejemplo, con un INNER JOIN:
SELECT driverslicensenr, name FROM drivers INNER JOIN fines ON fines.driverslicensenr = drivers.driverslicensenr; DISTINCT ClauseSELECT DISTINCT devuelve solo valores únicos. DISTINCT es una cláusula que conviene evitar si puedes: como habrás visto, añadirla suele aumentar el tiempo de ejecución. Valora siempre si de verdad la necesitas para conseguir el resultado deseado.
LIKE OperatorCuando usas LIKE, el índice no se utiliza si el patrón empieza por % o _. Eso impide que la base de datos use un índice (si existe). Además, este tipo de patrón puede abrir la puerta a recuperar demasiados registros que no aportan a tu objetivo.
De nuevo, conocer bien los datos de la base te ayudará a formular un patrón que filtre correctamente y devuelva solo las filas relevantes.
Si no puedes evitar acotar tu SELECT, plantéate limitar el resultado por otras vías. Aquí entran en juego cláusulas como LIMIT y conversiones de tipo de datos.
TOP, LIMIT And ROWNUM ClausesPuedes añadir LIMIT o TOP para fijar un máximo de filas en el conjunto de resultados. Ejemplos:
SELECT TOP 3 * FROM Drivers;Nota: puedes especificar PERCENT; por ejemplo, cambiando la primera línea por SELECT TOP 50 PERCENT *.
SELECT driverslicensenr, name FROM Drivers LIMIT 2;También puedes usar ROWNUM, equivalente a LIMIT en tu consulta:
SELECT *FROM DriversWHERE driverslicensenr = 123456 AND ROWNUM <= 3;Usa siempre los tipos de datos más eficientes, es decir, los más pequeños posibles. Aportar un tipo enorme cuando uno más pequeño basta puede pasarte factura.
Ahora bien, añadir conversiones de tipo en tu consulta suele incrementar el tiempo de ejecución.
La alternativa es evitarlas siempre que puedas. No siempre será posible, pero intenta ser prudente al incluirlas y, si lo haces, prueba su impacto antes de ejecutar la consulta en serio.
Las conversiones de tipo nos llevan al siguiente punto: no sobre‑ingenierices tus consultas. Manténlas simples y eficientes. Puede parecer una obviedad, especialmente porque las consultas pueden volverse complejas.
Aun así, verás en los ejemplos siguientes lo fácil que es complicar de más consultas sencillas.
OR OperatorSi usas OR, es probable que no se aprovechen índices.
Recuerda: un índice es una estructura que acelera la recuperación de datos en una tabla, pero tiene coste: más escrituras y más espacio para mantenerlo. Sirve para localizar datos sin recorrer todas las filas cada vez. Se crean con una o varias columnas.
Si no aprovechas los índices disponibles, tu consulta tardará más. Por eso conviene buscar alternativas a OR:
Considera esta consulta:
SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr = 123456OR driverslicensenr = 678910OR driverslicensenr = 345678;Puedes sustituir el operador por:
IN; oSELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr IN (123456, 678910, 345678);SELECT con un UNION.Consejo: no uses UNION sin necesidad, porque recorres la misma tabla varias veces. Además, UNION incrementa el tiempo de ejecución. Alternativas: reformular para agrupar todas las condiciones en un único SELECT, o usar un OUTER JOIN en lugar de UNION.
Consejo: ten en cuenta también que, aunque OR —y otros operadores de las siguientes secciones— probablemente no usen índice, ¡las búsquedas por índice no siempre son preferibles!
NOT OperatorCon NOT sucede algo similar: a menudo impide el uso del índice, como OR, y ralentiza tu consulta. Si no te queda claro, mira este ejemplo:
SELECT driverslicensenr, nameFROM DriversWHERE NOT (year > 1980);Esta consulta seguramente sea más lenta de lo que esperas, sobre todo porque está formulada de forma innecesariamente compleja. Mejor busca una alternativa: sustituye NOT por operadores de comparación como >, <> o !>. El ejemplo anterior podría reescribirse así:
SELECT driverslicensenr, nameFROM DriversWHERE year <= 1980;Mucho más limpio, ¿verdad?
AND OperatorAND es otro operador que puede impedir el uso de índices y ralentizar tu consulta si lo usas de forma innecesariamente compleja, como aquí:
SELECT driverslicensenr, nameFROM DriversWHERE year >= 1960 AND year <= 1980;Mejor reescribir usando BETWEEN:
SELECT driverslicensenr, nameFROM DriversWHERE year BETWEEN 1960 AND 1980;ANY and ALL OperatorsTambién conviene ser prudente con ANY y ALL, ya que al incluirlos es probable que no se usen índices. Aquí pueden ayudar funciones de agregación como MIN o MAX.
Consejo: si recurres a estas alternativas, recuerda que las agregaciones como SUM, AVG, MIN, MAX sobre muchas filas pueden dar lugar a consultas lentas. Puedes intentar reducir el número de filas a procesar o pre‑calcular esos valores. De nuevo, conocer tu entorno y el objetivo de la consulta es clave al decidir.
Si usas una columna dentro de un cálculo o de una función escalar, el índice tampoco se usa. Una posible solución es aislar la columna para que deje de formar parte del cálculo o función. Por ejemplo:
SELECT driverslicensenr, nameFROM DriversWHERE year + 10 = 1980;Queda raro, ¿no? Mejor replantea el cálculo y reescribe así:
SELECT driverslicensenr, nameFROM DriversWHERE year = 1970;No intentes restringir en exceso la consulta, porque puede perjudicar su rendimiento. Esto es especialmente cierto con joins y con la cláusula HAVING.
Al unir dos tablas, puede importar el orden en el que las pones en el join. Si una es mucho más grande, podrías reescribir la consulta para colocar la tabla más grande al final del join.
Si añades demasiadas condiciones al join, obligas a SQL a elegir un camino concreto que puede no ser el más eficiente.
HAVING ClauseHAVING se añadió a SQL porque WHERE no podía usarse con funciones de agregación. Normalmente se emplea junto con GROUP BY para limitar los grupos devueltos a los que cumplen ciertas condiciones. Sin embargo, si usas HAVING, no se aprovechan índices y —como ya sabes— el rendimiento puede resentirse.
Como alternativa, considera usar WHERE. Por ejemplo:
SELECT state, COUNT(*) FROM Drivers WHERE state IN ('GA', 'TX') GROUP BY state ORDER BY stateSELECT state, COUNT(*) FROM Drivers GROUP BY stateHAVING state IN ('GA', 'TX') ORDER BY stateLa primera usa WHERE para reducir las filas que hay que sumar; la segunda suma todas las filas y luego usa HAVING para descartar parte del trabajo. En estos casos, la opción con WHERE es claramente mejor porque no desperdicias recursos.
Fíjate en que no se trata de limitar el resultado final, sino de reducir los registros intermedios dentro de la consulta.
Nota: la diferencia es que WHERE impone una condición sobre filas individuales, mientras que HAVING lo hace sobre agregaciones o resultados de una selección donde un único resultado —como MIN, MAX, SUM, …— se produce a partir de múltiples filas.
Como ves, evaluar la calidad y reescribir consultas no es trivial cuando buscas el máximo rendimiento. Evitar anti‑patrones y contemplar alternativas también forma parte de tu responsabilidad al trabajar con bases de datos en entornos profesionales.
Esta lista es solo una pequeña panorámica de anti‑patrones y consejos que pueden ayudar a quienes empiezan. Si quieres conocer los que más ven los perfiles senior, echa un vistazo a este debate.
Lo implícito en los anti‑patrones anteriores es que, en el fondo, remiten a la diferencia entre un enfoque basado en conjuntos y uno procedimental al construir consultas.
El enfoque procedimental se parece a programar: le dices al sistema qué hacer y cómo hacerlo.
Un ejemplo son las condiciones redundantes en joins o abusar de HAVING, como antes: consultas que encadenan funciones, o lógica con bucles, condiciones, UDFs, cursores, … para llegar al resultado. En este enfoque, sueles pedir un subconjunto, luego otro, y así sucesivamente.
No sorprende que se llame enfoque «paso a paso» o «fila a fila».
El otro enfoque es el basado en conjuntos, donde solo especificas qué quieres. Tu papel es fijar las condiciones para el conjunto de resultados. Cómo se recuperan los datos lo dejas a los mecanismos internos: permites que el motor elija los mejores algoritmos o la lógica de procesamiento.
Como SQL es un lenguaje basado en conjuntos, no extraña que este enfoque sea más eficaz que el procedimental y explique por qué, a veces, SQL puede ser más rápido que el código.
Consejo el enfoque basado en conjuntos es el que más suelen pedir los mejores empleadores del sector de datos. A menudo tendrás que alternar entre ambos.
Nota: si te encuentras con una consulta demasiado procedimental, plantéate reescribirla o refactorizarla.
Sabiendo que los anti‑patrones evolucionan conforme creces como desarrollador de SQL, y que hay mucho que considerar al pensar alternativas, evitar anti‑patrones y reescribir puede ser una tarea compleja. Toda ayuda viene bien, y por eso un enfoque más estructurado con herramientas puede ser la mejor vía.
Nota: algunos anti‑patrones mencionados tenían su origen en cuestiones de rendimiento, como los operadores AND, OR y NOT y su falta de uso de índices. Pensar en rendimiento exige un enfoque más estructurado y más profundo.
En cualquier caso, este enfoque suele basarse en el plan de ejecución, que —como recuerdas— es el resultado de analizar la consulta en un «árbol sintáctico» y define qué algoritmo se usa en cada operación y cómo se coordinan.
Como viste en la introducción, puede que tengas que examinar y afinar manualmente los planes que produce el optimizador. En esos casos, necesitarás analizar de nuevo tu consulta mirando el plan de ejecución.
Para obtener este plan, usa las herramientas que ofrezca tu sistema gestor de bases de datos. Algunas opciones habituales:
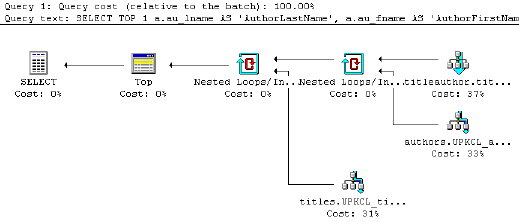
EXPLAIN PLAN en Oracle, pero el nombre varía según el RDBMS: puedes encontrar EXPLAIN (MySQL, PostgreSQL) o EXPLAIN QUERY PLAN (SQLite).Nota: en PostgreSQL, EXPLAIN te muestra cómo planea ejecutarse la consulta sin correrla, mientras que EXPLAIN ANALYZE la ejecuta y compara lo esperado con lo real. En general, un plan real se obtiene ejecutando la consulta, mientras que un plan estimado calcula qué haría sin ejecutarla. Aunque equivalentes en lógica, el plan real es más útil porque incluye detalles y estadísticas de lo que sucedió.
En lo que queda de sección, verás más sobre EXPLAIN y ANALYZE y cómo usarlos para entender el plan y el posible rendimiento. Usaremos dos tablas: one_million y half_million.
Puedes obtener información de la tabla one_million con EXPLAIN; Colócalo encima de tu consulta y, al ejecutarla, te devolverá el plan:
EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18584.82 rows=1025082 width=36)(1 row)Aquí ves que el coste es 0.00..18584.82, el número de filas 1025082 y el ancho de columnas 36.
Después puedes actualizar las estadísticas con ANALYZE.
ANALYZE one_million;EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(1 row)Además de EXPLAIN y ANALYZE, puedes ver el tiempo real de ejecución con EXPLAIN ANALYZE:
EXPLAIN ANALYZESELECT *FROM one_million;QUERY PLAN___________________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(actual time=0.015..1207.019 rows=1000000 loops=1)Total runtime: 2320.146 ms(2 rows)La desventaja de EXPLAIN ANALYZE es obvia: la consulta se ejecuta. Úsalo con cabeza.
Hasta ahora solo has visto Seq Scan (secuencial) o Full Table Scan: recorre cada fila de la tabla y comprueba si cumple la condición. En rendimiento, no es el mejor plan porque hace un escaneo completo. Aun así, no es tan malo cuando la tabla no cabe en memoria: las lecturas secuenciales son rápidas incluso con discos lentos.
Volveremos a esto al hablar de index scan.
Hay otros algoritmos. Por ejemplo, este plan para un join:
EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN_________________________________________________________________Hash Join (cost=15417.00..68831.00 rows=500000 width=42)(actual time=1241.471..5912.553 rows=500000 loops=1)Hash Cond: (one_million.counter = half_million.counter) -> Seq Scan on one_million (cost=0.00..18334.00 rows=1000000 width=37) (actual time=0.007..1254.027 rows=1000000 loops=1) -> Hash (cost=7213.00..7213.00 rows=500000 width=5) (actual time=1241.251..1241.251 rows=500000 loops=1) Buckets: 4096 Batches: 16 Memory Usage: 770kB -> Seq Scan on half_million (cost=0.00..7213.00 rows=500000 width=5)(actual time=0.008..601.128 rows=500000 loops=1)Total runtime: 6468.337 msEl optimizador ha elegido un Hash Join. Recuerda esta operación: la necesitarás para estimar la complejidad temporal. Observa que no hay índice en half_million.counter, que puedes crear en el siguiente ejemplo:
CREATE INDEX ON half_million(counter);EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN________________________________________________________________Merge Join (cost=4.12..37650.65 rows=500000 width=42)(actual time=0.033..3272.940 rows=500000 loops=1)Merge Cond: (one_million.counter = half_million.counter) -> Index Scan using one_million_counter_idx on one_million (cost=0.00..32129.34 rows=1000000 width=37) (actual time=0.011..694.466 rows=500001 loops=1) -> Index Scan using half_million_counter_idx on half_million (cost=0.00..14120.29 rows=500000 width=5)(actual time=0.010..683.674 rows=500000 loops=1)Total runtime: 3833.310 ms(5 rows)Al crear el índice, el optimizador ha optado por un Merge join con Index Scan.
Nota la diferencia entre index scan y full table scan (secuencial): el primero recorre páginas de datos o de índice para encontrar los registros adecuados; el segundo revisa cada fila de la tabla.
El tiempo total se reduce y el rendimiento mejora, pero hay dos index scans, con lo que la memoria cobra importancia, sobre todo si la tabla no cabe en memoria. En esos casos, primero haces un escaneo completo de índice (lecturas secuenciales rápidas), pero después hay muchas lecturas aleatorias para traer filas por valor de índice. Esas lecturas aleatorias suelen ser mucho más lentas que las secuenciales. En esos escenarios, el full table scan puede ser más rápido que el full index scan.
Ahora que has visto el plan de ejecución, puedes profundizar y pensar en rendimiento en términos más formales con la teoría de complejidad computacional. Esta disciplina clasifica problemas computacionales por su dificultad, entre otras cosas; En nuestro caso, nos interesa el tiempo que tarda una consulta en ejecutarse y devolver resultados: la complejidad temporal, que se expresa con la notación O grande.
Con O grande expresas el tiempo en función de cómo crece con respecto a la entrada, cuando esta se hace arbitrariamente grande. Se omiten coeficientes y términos de menor orden para centrarte en lo importante: la tasa de crecimiento del tiempo de ejecución. Así, la complejidad se describe asintóticamente: el tamaño de entrada tiende a infinito.
En bases de datos, la complejidad mide cuánto más tarda una consulta a medida que crecen las tablas (y la base de datos).
Nota: el tamaño de tu base no solo crece por añadir filas; la mera existencia de índices también influye.
Como has visto, el plan de ejecución define, entre otras cosas, qué algoritmo se usa en cada operación, lo que permite expresar el tiempo de ejecución como una función del tamaño de las tablas implicadas: una función de complejidad. En otras palabras, puedes usar O grande y tu plan para estimar complejidad y rendimiento.
En las siguientes subsecciones verás una idea general de cuatro tipos de complejidad temporal y ejemplos de cómo puede variar según el contexto.
Pista: los índices son parte de la historia.
Nota: existen distintos tipos de índices, planes y implementaciones según la base de datos, así que las complejidades que listamos son muy generales y pueden variar.
Un algoritmo tiene tiempo constante si tarda lo mismo independientemente del tamaño de la entrada. En consultas, si tarda lo mismo sin importar el tamaño de la tabla.
No son comunes, pero un ejemplo sería:
SELECT TOP 1 t.* FROM tLa complejidad es constante porque seleccionas una fila arbitraria. El tiempo no depende del tamaño de la tabla.
Un algoritmo tiene tiempo lineal si su tiempo es proporcional al tamaño de entrada. En bases de datos, al tamaño de la tabla: a más filas, más tarda.
Un ejemplo es una consulta con WHERE sobre una columna sin índice: se necesitará un escaneo completo (Seq Scan) con complejidad O(n). Hay que leer todas las filas para encontrar la correcta.
Otro ejemplo con complejidad O(n) si no hay índice en i_id:
SELECT i_id FROM item;COUNT(*) FROM TABLE; serán O(n) salvo que el total de filas se mantenga almacenado; entonces sería más bien O(1).Muy relacionado con el tiempo lineal está el tiempo de planes con joins. Ejemplos:
Recuerda: un nested join compara cada registro de una tabla con cada registro de la otra.
Un algoritmo tiene tiempo logarítmico si su tiempo es proporcional al logaritmo del tamaño de entrada; en consultas, al logaritmo del tamaño de la base.
Esto ocurre en planes con Index Scan o escaneos de índice agrupado. Un índice agrupado es aquel cuya hoja contiene las filas reales de la tabla. Se define sobre una o más columnas (clave de indexación). El escaneo del índice agrupado recorre esa estructura de arriba abajo.
Ejemplo con índice en i_id, con complejidad típica O(log n):
SELECT i_stock FROM item WHERE i_id = N; Nota: sin índice, sería O(n).
Un algoritmo tiene tiempo cuadrático si su tiempo es proporcional al cuadrado del tamaño de entrada. En bases de datos, el tiempo de la consulta es proporcional al cuadrado del tamaño.
Un posible ejemplo:
SELECT * FROM item, author WHERE item.i_a_id=author.a_id La complejidad mínima sería O(n log n), pero la máxima puede llegar a O(n^2) según los índices en los atributos del join.
En resumen, puedes consultar esta chuleta para estimar el rendimiento según la complejidad temporal y su impacto:
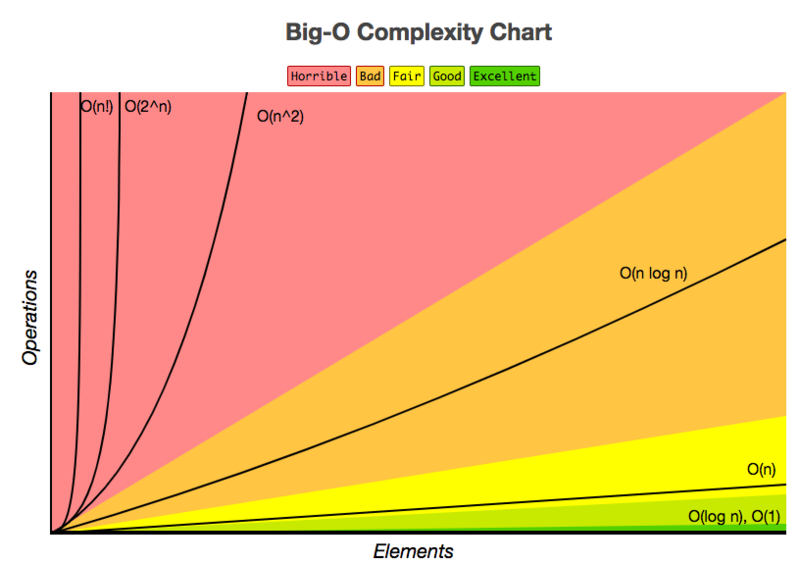
Con el plan y la complejidad temporal en mente, puedes afinar aún más tus consultas SQL. Empieza prestando atención a lo siguiente:
¡Enhorabuena! Has llegado al final de este artículo, que te ha dado un pequeño vistazo al rendimiento de consultas SQL. Esperamos que ahora entiendas mejor los anti‑patrones, el optimizador y las herramientas para revisar, estimar e interpretar la complejidad de tu plan. ¡Pero hay mucho más! Si quieres profundizar, te recomendamos el libro «Database Management Systems» de R. Ramakrishnan y J. Gehrke.
Para terminar, no quiero dejar de compartir esta cita de un usuario de StackOverflow:
«Mi anti‑patrón favorito es no probar tus consultas.
Se aplica cuando:
- Tu consulta implica más de una tabla.
- Crees que tienes un diseño óptimo, pero no te molestas en comprobar tus suposiciones.
- Aceptas la primera consulta que funciona, sin idea de si está siquiera cerca de estar optimizada."
Si quieres empezar con SQL, plantéate estos cursos de DataCamp:
Aprende más sobre SQL
Curso
Tutorial
Sejal Jaiswal
15 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Travis Tang
8 min
Tutorial
DataCamp Team
3 min
Tutorial
Eugenia Anello
6 min