Kurs
Datenbearbeitung in SQL
4 Std.
335K
Um die Performance deiner SQL-Query zu verbessern, musst du zuerst verstehen, was intern passiert, wenn du sie ausführst.
Zuerst wird die Query in einen „Parse Tree“ übersetzt; Sie wird syntaktisch und semantisch geprüft. Der Parser erzeugt eine interne Repräsentation der Eingabequery. Dieses Ergebnis geht an die Rewrite-Engine.
Anschließend sucht der Optimizer den optimalen Ausführungs- bzw. Query-Plan für die gegebene Abfrage. Der Ausführungsplan legt genau fest, welcher Algorithmus für welche Operation genutzt wird und wie die Ausführung koordiniert ist.
Um den bestmöglichen Plan zu finden, enumeriert der Optimizer mögliche Pläne, bewertet deren Kosten, berücksichtigt den aktuellen Datenbankzustand und wählt den besten als finalen Ausführungsplan. Weil Optimizer nicht perfekt sind, müssen Nutzer:innen und Admins Pläne manchmal manuell prüfen und tunen, um bessere Performance zu erzielen.
Jetzt fragst du dich vermutlich, was ein „guter Query-Plan“ ist.
Wie schon angedeutet, spielt die Plan-Kostenqualität eine große Rolle. Wichtig sind u. a. die Anzahl der benötigten Festplatten-I/Os, die CPU-Kosten, die vom Client beobachtbare Antwortzeit und die gesamte Ausführungsdauer. Hier kommt die Zeitkomplexität ins Spiel – mehr dazu gleich.
Danach wird der gewählte Plan vom Execution Engine des Systems ausgeführt und die Ergebnisse werden zurückgegeben.
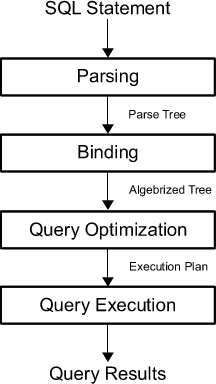
Aus dem Vorherigen ergibt sich: Das Prinzip „Garbage In, Garbage Out (GIGO)“ gilt auch hier. Wer die Query formuliert, hat großen Einfluss auf die Performance. Liefert der Optimizer eine schlecht formulierte Query, kann er nur begrenzt retten.
Es gibt also Dinge, die du beim Schreiben beachten kannst. Wie eingangs erwähnt, trägst du eine doppelte Verantwortung: qualitative Queries schreiben und gleichzeitig potenzielle Performancefallen erkennen.
Ein guter Start ist, dir „Stellen“ in deinen Queries zu markieren, an denen Probleme häufig auftauchen. Gerade für Einsteiger:innen sind es typischerweise vier Klauseln bzw. Schlüsselwörter:
WHERE-Klausel,INNER JOIN oder LEFT JOIN, undHAVING-Klausel.Dieser Ansatz ist simpel und naiv, aber als Beginner sind das gute Anhaltspunkte – hier passieren die meisten Fehler und sie sind ironischerweise schwer zu sehen.
Denk aber daran: Performance braucht Kontext. Nur zu sagen, diese Klauseln seien „schlecht“, greift zu kurz. Eine WHERE- oder HAVING-Klausel macht eine Query nicht automatisch schlecht.
Im nächsten Abschnitt findest du Anti-Patterns und Alternativen für den Query-Aufbau. Diese Tipps sind Leitplanken. Ob und wie du wirklich umschreiben solltest, hängt u. a. von Datenmenge, Datenbank und Ausführungshäufigkeit ab. Es kommt auf das Ziel deiner Query an – Vorwissen über die Datenbank, die du abfragst, ist entscheidend!
„Je mehr Daten, desto besser“ ist beim Schreiben von SQL-Queries kein guter Leitsatz: Du riskierst nicht nur, deine Erkenntnisse zu verwässern – auch die Performance leidet, wenn deine Query zu viele Daten zieht.
Deshalb solltest du besonders auf das SELECT-Statement, die DISTINCT-Klausel und den LIKE-Operator achten.
SELECT StatementPrüfe zuerst, ob dein SELECT so schlank wie möglich ist. Ziel: Unnötige Spalten aus SELECT entfernen. So zwingst du dich, nur Daten zu ziehen, die deinem Query-Ziel dienen.
Wenn du korrelierte Subqueries mit EXISTS hast, nutze in der Subquery im SELECT besser eine Konstante, statt den Wert einer Spalte zu selektieren – besonders, wenn du nur die Existenz prüfst.
Merke: Eine korrelierte Subquery nutzt Werte aus der äußeren Query. Und auch wenn NULL hier als „Konstante“ funktionieren kann, ist das sehr verwirrend!
Beispiel für den Einsatz einer Konstante:
SELECT driverslicensenr, name FROM Drivers WHERE EXISTS (SELECT '1' FROM Fines WHERE fines.driverslicensenr = drivers.driverslicensenr);Tipp: Eine korrelierte Subquery ist nicht immer die beste Idee. Du kannst sie oft durch einen INNER JOIN ersetzen:
SELECT driverslicensenr, name FROM drivers INNER JOIN fines ON fines.driverslicensenr = drivers.driverslicensenr; DISTINCT ClauseSELECT DISTINCT liefert nur eindeutige Werte zurück. DISTINCT solltest du nach Möglichkeit vermeiden. Wie in vielen Beispielen steigt die Laufzeit, sobald du die Klausel hinzufügst. Prüfe also immer, ob du DISTINCT wirklich brauchst, um dein Ziel zu erreichen.
LIKE OperatorWenn das Muster bei LIKE mit % oder _ beginnt, kann ein Index nicht genutzt werden. Das verhindert die Indexverwendung (falls vorhanden). Außerdem läufst du Gefahr, zu viele irrelevante Zeilen zu erhalten.
Dein Wissen über die Daten hilft dir, passende Muster zu formulieren, die wirklich nur die relevanten Zeilen herausfiltern.
Wenn du dein SELECT nicht ausreichend filtern kannst, begrenze die Ergebnisse auf andere Weise. Hier helfen z. B. die LIMIT-Klausel und Datentypkonvertierungen – mit Bedacht eingesetzt.
TOP, LIMIT und ROWNUM-KlauselnMit LIMIT oder TOP setzt du eine Obergrenze für die Anzahl der Zeilen im Resultset. Beispiele:
SELECT TOP 3 * FROM Drivers;Hinweis: Mit PERCENT kannst du prozentual eingrenzen, z. B. SELECT TOP 50 PERCENT *.
SELECT driverslicensenr, name FROM Drivers LIMIT 2;Alternativ kannst du auch ROWNUM einsetzen, was LIMIT entspricht:
SELECT *FROM DriversWHERE driverslicensenr = 123456 AND ROWNUM <= 3;Nutze immer den effizientesten, also kleinsten, sinnvollen Datentyp. Ein zu großer Typ kann Probleme verursachen.
Fügst du aber Datentypkonvertierungen in der Query ein, steigt die Ausführungszeit.
Vermeide Konvertierungen, wenn möglich. Nicht immer lassen sie sich weglassen, aber geh sparsam damit um und teste den Effekt vor der Ausführung.
Datentypkonvertierungen führen zum nächsten Punkt: Over-Engineering vermeiden. Halte Queries einfach und effizient. Das klingt banal – gerade weil Queries komplex werden können.
Wie die folgenden Beispiele zeigen, macht man einfache Queries schnell unnötig kompliziert.
OR OperatorBei OR wird häufig kein Index genutzt.
Merke: Ein Index beschleunigt das Lesen aus einer Tabelle, kostet aber zusätzliche Schreibvorgänge und Speicherplatz. Er hilft, Daten schnell zu finden, ohne jede Zeile durchsuchen zu müssen. Indizes können auf einer oder mehreren Spalten liegen.
Wenn du vorhandene Indizes nicht nutzt, dauert die Query länger. Suche daher Alternativen zu OR:
Betrachte diese Query:
SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr = 123456OR driverslicensenr = 678910OR driverslicensenr = 345678;Ersetze den Operator z. B. durch:
IN; oderSELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr IN (123456, 678910, 345678);SELECT-Statements mit UNION.Tipp: Nutze UNION nicht unnötig, da du dieselbe Tabelle mehrfach liest – das erhöht die Laufzeit. Alternativen: alle Bedingungen in einem SELECT formulieren oder statt UNION einen OUTER JOIN verwenden.
Tipp: Auch wenn OR – wie die folgenden Operatoren – oft keinen Index nutzt, sind Index-Lookups nicht immer die beste Wahl!
NOT OperatorAuch bei NOT wird häufig kein Index verwendet – wie bei OR. Das verlangsamt die Query. Beispiel:
SELECT driverslicensenr, nameFROM DriversWHERE NOT (year > 1980);Diese Formulierung ist unnötig komplex. Nutze lieber Vergleichsoperatoren wie >, <> oder !>. Das Beispiel wird zu:
SELECT driverslicensenr, nameFROM DriversWHERE year <= 1980;Schon deutlich sauberer, oder?
AND OperatorAuch AND kann Queries verlangsamen, wenn es unnötig kompliziert eingesetzt wird, etwa so:
SELECT driverslicensenr, nameFROM DriversWHERE year >= 1960 AND year <= 1980;Besser ist die Umschreibung mit BETWEEN:
SELECT driverslicensenr, nameFROM DriversWHERE year BETWEEN 1960 AND 1980;ANY and ALL OperatorsAuch bei ANY und ALL wird oft kein Index genutzt. Als Alternativen bieten sich Aggregationsfunktionen wie MIN oder MAX an.
Tipp: Aggregationen wie SUM, AVG, MIN, MAX über viele Zeilen können Queries stark verlangsamen. Versuche dann, die Datenmenge zu reduzieren oder Werte vorab zu berechnen. Du siehst: Kontext ist alles – Umgebung, Query-Ziel usw. bestimmen die beste Lösung.
Wird eine Spalte in Berechnungen oder Skalarfunktionen verwendet, greift oft kein Index. Lösung: Isoliere die Spalte, sodass sie nicht Teil der Berechnung ist. Beispiel:
SELECT driverslicensenr, nameFROM DriversWHERE year + 10 = 1980;Sieht seltsam aus, oder? Besser umformulieren zu:
SELECT driverslicensenr, nameFROM DriversWHERE year = 1970;Beschränke eine Query nicht übermäßig hart – das kann die Performance verschlechtern. Besonders relevant bei Joins und bei der HAVING-Klausel.
Beim Join zweier Tabellen kann die Reihenfolge wichtig sein. Ist eine Tabelle deutlich größer, setze sie im Join nach Möglichkeit an letzte Stelle.
Zu viele Bedingungen zwingen SQL auf einen bestimmten Pfad – der ist nicht immer der performanteste.
HAVING ClauseHAVING wurde eingeführt, weil WHERE nicht mit Aggregaten funktioniert. HAVING wird zusammen mit GROUP BY genutzt, um Gruppen anhand von Bedingungen einzuschränken. Nutzt du HAVING, wird in der Regel kein Index verwendet – das kann die Performance drücken.
Nutze stattdessen nach Möglichkeit WHERE. Beispiel:
SELECT state, COUNT(*) FROM Drivers WHERE state IN ('GA', 'TX') GROUP BY state ORDER BY stateSELECT state, COUNT(*) FROM Drivers GROUP BY stateHAVING state IN ('GA', 'TX') ORDER BY stateDie erste Query schränkt bereits vor der Aggregation per WHERE ein; die zweite aggregiert alles und filtert dann per HAVING – Ressourcenverschwendung. In solchen Fällen ist WHERE klar im Vorteil.
Hier geht es nicht um das Endergebnis, sondern darum, die Anzahl der Zwischenzeilen in der Query zu begrenzen.
Hinweis: WHERE setzt Bedingungen auf Einzelzeilen; HAVING setzt Bedingungen auf Aggregationen bzw. Ergebnisse, die aus mehreren Zeilen entstanden sind (MIN, MAX, SUM …).
Du siehst: Die Qualität von Queries zu bewerten und sie performant zu formulieren, ist nicht trivial. Anti-Patterns vermeiden und Alternativen prüfen gehört zum Job – besonders in professionellen Umgebungen.
Diese Liste ist ein kurzer Überblick für Einsteiger:innen. Was erfahrene Entwickler:innen als häufigste Anti-Patterns sehen, findest du in dieser Diskussion.
Hinter vielen Anti-Patterns steckt der Unterschied zwischen mengenbasiertem und prozeduralem Vorgehen beim Query-Aufbau.
Die prozedurale Herangehensweise ähnelt Programmierung: Du sagst dem System, was es wie tun soll.
Beispiele sind redundante Join-Bedingungen oder der Missbrauch von HAVING; du rufst Funktion auf Funktion auf oder nutzt Logik mit Schleifen, Bedingungen, User Defined Functions (UDFs), Cursorn … Oft fragst du erst einen Teil der Daten ab, dann den nächsten und so weiter.
Kein Wunder, dass man das auch „Schritt für Schritt“ oder „row-by-row“ nennt.
Der andere Ansatz ist mengenbasiert: Du beschreibst nur, was du willst. Deine Aufgabe ist, Bedingungen für das gewünschte Resultset zu definieren. Wie die Daten geholt werden, überlässt du dem Datenbank-Engine, das die besten Algorithmen/Logik wählt.
SQL ist mengenbasiert – daher ist dieser Ansatz meist deutlich effektiver und erklärt, warum SQL in manchen Fällen schneller ist als Code.
Tipp Top-Arbeitgeber in der Datenbranche erwarten, dass du den mengenbasierten Ansatz beherrschst – und bei Bedarf zwischen beiden wechseln kannst.
Hinweis: Wenn du eine prozedurale Query vor dir hast, solltest du sie überarbeiten.
Anti-Patterns ändern sich mit deiner Erfahrung – und Alternativen abzuwägen ist komplex. Daher ist ein strukturierter Ansatz mit Tools sinnvoll, um Queries zu optimieren.
Hinweis: Einige Anti-Patterns haben ihre Ursache in Performance, etwa AND, OR, NOT und deren fehlende Indexnutzung. Performance zu denken erfordert Struktur und Tiefe.
Diese strukturierte, tiefere Betrachtung basiert vor allem auf dem Query-Plan, der nach dem Parsen entsteht und genau festlegt, welche Algorithmen genutzt und wie Operationen koordiniert werden.
Wie in der Einleitung angedeutet, kann es sein, dass du vom Optimizer erzeugte Pläne manuell prüfen und tunen musst. Dann analysierst du die Query erneut über den Ausführungsplan.
Um an den Plan zu kommen, nutzt du die Tools deines Datenbankmanagementsystems. Mögliche Tools sind z. B.:
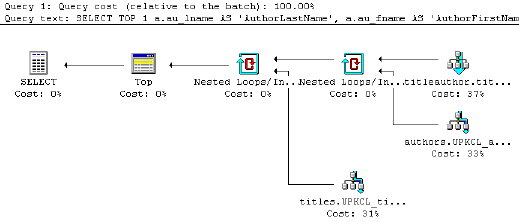
EXPLAIN PLAN; je nach RDBMS heißt es EXPLAIN (MySQL, PostgreSQL) oder EXPLAIN QUERY PLAN (SQLite).Hinweis: In PostgreSQL unterscheidet man EXPLAIN (zeigt, wie der Planner die Query ausführen würde, ohne sie zu starten) und EXPLAIN ANALYZE (führt die Query aus und liefert den Vergleich Erwartung vs. Realität). Ein echter Ausführungsplan entsteht, wenn die Query tatsächlich läuft; ein geschätzter Plan simuliert nur. Der reale Plan ist hilfreicher, da er zusätzliche Details und Statistiken enthält.
Im Folgenden lernst du EXPLAIN und ANALYZE kennen und wie du damit Plan und potenzielle Performance einschätzt. In den Beispielen arbeiten wir mit zwei Tabellen: one_million und half_million.
Mit EXPLAIN bekommst du den Plan für one_million – einfach vor die Query setzen:
EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18584.82 rows=1025082 width=36)(1 row)Hier siehst du Kosten 0.00..18584.82, Zeilen 1025082 und eine Spaltenbreite von 36.
Mit ANALYZE aktualisierst du die Statistiken:
ANALYZE one_million;EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(1 row)Mit EXPLAIN ANALYZE erhältst du die tatsächliche Ausführungszeit:
EXPLAIN ANALYZESELECT *FROM one_million;QUERY PLAN___________________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(actual time=0.015..1207.019 rows=1000000 loops=1)Total runtime: 2320.146 ms(2 rows)Nachteil: EXPLAIN ANALYZE führt die Query wirklich aus – also vorsichtig einsetzen!
Bisher siehst du den Algorithmus Seq Scan (Full Table Scan): Jede Zeile der Tabelle wird sequentiell gelesen und auf Bedingungen geprüft. Performance-mäßig ist das nicht ideal, aber bei Tabellen, die nicht in den Speicher passen, sind sequentielle Lesevorgänge durchaus schnell.
Später sehen wir den Index Scan.Es gibt weitere Algorithmen. Hier z. B. ein Plan für einen Join:
EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN_________________________________________________________________Hash Join (cost=15417.00..68831.00 rows=500000 width=42)(actual time=1241.471..5912.553 rows=500000 loops=1)Hash Cond: (one_million.counter = half_million.counter) -> Seq Scan on one_million (cost=0.00..18334.00 rows=1000000 width=37) (actual time=0.007..1254.027 rows=1000000 loops=1) -> Hash (cost=7213.00..7213.00 rows=500000 width=5) (actual time=1241.251..1241.251 rows=500000 loops=1) Buckets: 4096 Batches: 16 Memory Usage: 770kB -> Seq Scan on half_million (cost=0.00..7213.00 rows=500000 width=5)(actual time=0.008..601.128 rows=500000 loops=1)Total runtime: 6468.337 msDer Optimizer hat einen Hash Join gewählt. Merke dir diese Operation – du brauchst sie gleich für die Zeitkomplexität. Beachte: Auf half_million.counter gibt es keinen Index. Den fügen wir im nächsten Beispiel hinzu:
CREATE INDEX ON half_million(counter);EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN________________________________________________________________Merge Join (cost=4.12..37650.65 rows=500000 width=42)(actual time=0.033..3272.940 rows=500000 loops=1)Merge Cond: (one_million.counter = half_million.counter) -> Index Scan using one_million_counter_idx on one_million (cost=0.00..32129.34 rows=1000000 width=37) (actual time=0.011..694.466 rows=500001 loops=1) -> Index Scan using half_million_counter_idx on half_million (cost=0.00..14120.29 rows=500000 width=5)(actual time=0.010..683.674 rows=500000 loops=1)Total runtime: 3833.310 ms(5 rows)Nach dem Index hat sich der Plan auf Merge Join mit Index Scans geändert.
Hinweis: Unterschied zwischen Index Scan und Full Table/Sequential Scan: Beim Index Scan werden Daten- oder Indexseiten gezielt gelesen, beim Full Table Scan jede Zeile der Tabelle.
Die Gesamtlaufzeit sinkt – die Performance ist besser. Allerdings erfordern zwei Index Scans mehr Speicher, besonders wenn die Tabelle nicht in den Speicher passt. Dann folgt auf den schnellen sequentiellen Index-Scan oft viele zufällige Lesevorgänge, um Zeilen per Indexwert zu holen – die sind wesentlich langsamer als sequentielle Lesevorgänge. In solchen Fällen kann ein Full Table Scan schneller sein als ein kompletter Index Scan.
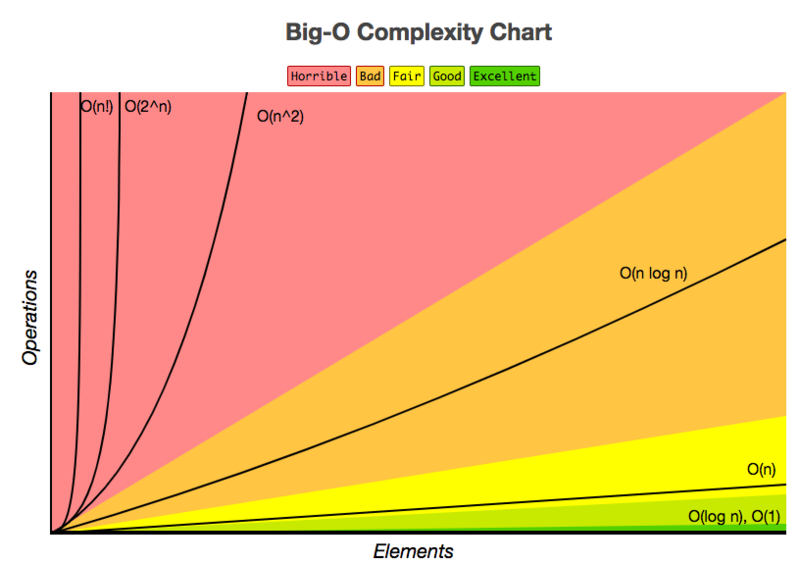
Mit dem Query-Plan im Blick kannst du die Performance formaler über die Komplexitätstheorie betrachten. Diese klassifiziert Probleme nach Aufwand – bei Queries interessiert uns die Laufzeit bis zum Ergebnis, also die Zeitkomplexität, beschrieben mit der Big-O-Notation.
Big O beschreibt, wie die Laufzeit relativ zur Eingabegröße wächst, wenn diese gegen unendlich geht. Konstanten und niedrigere Terme werden ignoriert, um die Wachstumsrate zu fokussieren – die Beschreibung ist asymptotisch.
Auf Datenbanken bezogen misst die Komplexität, wie stark die Laufzeit einer Query mit der Tabellengröße – und damit der Datenbank – zunimmt.
Hinweis: Die DB-Größe wächst nicht nur mit mehr Zeilen, sondern auch durch vorhandene Indizes.
Da der Ausführungsplan u. a. die verwendeten Algorithmen definiert, lässt sich die Ausführungszeit als Funktion der Tabellengröße ausdrücken – die Komplexitätsfunktion. Sprich: Mit Big O und deinem Plan kannst du die Query-Komplexität und Performance abschätzen.
Im Folgenden bekommst du einen Überblick über vier Komplexitätsklassen und Beispiele, wie sich die Laufzeit je nach Kontext ändern kann.
Hinweis: Indizes spielen hier eine zentrale Rolle!
Wichtig: Es gibt verschiedene Indexarten, Pläne und DB-Implementierungen – die folgenden Werte sind generalisiert und hängen von deinem Setup ab.
Ein Algorithmus läuft in konstanter Zeit, wenn die Laufzeit unabhängig von der Eingabegröße ist. Bei Queries also unabhängig von der Tabellengröße.
Solche Queries sind selten, aber z. B.:
SELECT TOP 1 t.* FROM tDie Laufzeit ist konstant, weil genau eine beliebige Zeile gewählt wird – unabhängig von der Tabellengröße.
Linear, wenn die Laufzeit proportional zur Eingabegröße wächst. In DBs: proportional zur Tabellengröße.
Beispiel: WHERE auf einer nicht indizierten Spalte – es braucht einen Full Table Scan/Seq Scan, also O(n). Jede Zeile muss gelesen werden, um die passende zu finden.
Auch diese Query hat O(n), sofern kein Index auf i_id liegt:
SELECT i_id FROM item;COUNT(*) FROM TABLE; – O(n), es sei denn, die Gesamtzeilenzahl ist gespeichert. Dann eher O(1).Zu linearer Zeit gehören häufig auch Join-Pläne. Beispiele:
Merke: Nested Loop vergleicht jeden Satz der einen mit jedem Satz der anderen Tabelle.
Logarithmisch, wenn die Laufzeit proportional zum Logarithmus der Eingabegröße ist.
Das gilt für Pläne mit Index Scan bzw. Clustered Index Scan. Ein Clustered Index hält die Datenzeilen auf Blattebene. Der Cluster-Schlüssel ist die Indexschlüsselspalte(n). Beim Clustered Index Scan liest das RDBMS die passenden Zeilen entlang des Index.
Beispiel mit Index auf i_id – typischerweise O(log(n)):
SELECT i_stock FROM item WHERE i_id = N; Hinweis: Ohne Index wäre es O(n).
Quadratisch, wenn die Laufzeit proportional zum Quadrat der Eingabegröße ist. Bei Queries entsprechend zur „Quadrat“-Größe der Datenbank.
Mögliches Beispiel:
SELECT * FROM item, author WHERE item.i_a_id=author.a_id Die minimale Komplexität ist O(n log(n)), die maximale O(n^2) – je nach Index auf den Join-Attributen.
Für eine Übersicht zur Big-O-Notation und Performance schau dir dieses Cheat Sheet an:
Mit Query-Plan und Zeitkomplexität im Hinterkopf kannst du weiter tunen. Achte besonders auf:
Glückwunsch! Du hast das Ende erreicht und einen Einblick in SQL-Query-Performance, Anti-Patterns, den Optimizer und Tools zur Bewertung, Schätzung und Interpretation der Komplexität deines Query-Plans bekommen. Es gibt noch viel mehr zu entdecken! Ein guter Einstieg ist das Buch „Database Management Systems“ von R. Ramakrishnan und J. Gehrke.
Zum Schluss noch ein Zitat von einem StackOverflow-Nutzer:
„Mein Lieblings-Antipattern ist, Queries nicht zu testen.
Das trifft zu, wenn:
- Deine Query mehr als eine Tabelle umfasst.
- Du glaubst, ein optimales Design zu haben, aber deine Annahmen nicht testest.
- Du die erste funktionierende Query akzeptierst, ohne zu wissen, ob sie auch nur annähernd optimiert ist."
Wenn du mit SQL starten willst, probiere diese DataCamp-Kurse:
Mehr über SQL lernen
Kurs