
Last chance! 50% off DataCamp Premium
Sale ends in
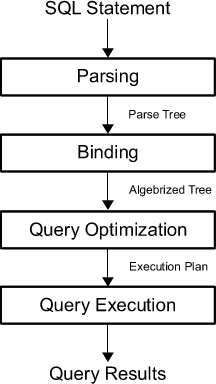
SQL sorgunuzun performansını artırmak için, önce çalıştırma kısayoluna bastığınızda dahili olarak neler olduğunu bilmeniz gerekir.
İlk olarak sorgu bir “ayrıştırma ağacına” (parse tree) dönüştürülür; Sorgu, sözdizimsel ve anlamsal gereklilikleri karşılayıp karşılamadığı açısından analiz edilir. Ayrıştırıcı (parser), giriş sorgusunun dahili bir temsilini oluşturur. Bu çıktı daha sonra yeniden yazma motoruna iletilir.
Ardından, belirli sorgu için en uygun yürütme veya sorgu planını bulmak optimizasyon aracısının (optimizer) görevidir. Yürütme planı, her işlem için hangi algoritmanın kullanıldığını ve işlemlerin yürütülmesinin nasıl koordine edildiğini tam olarak tanımlar.
Gerçekten en uygun yürütme planını bulmak için, optimize edici tüm olası yürütme planlarını sıralar, her planın kalitesini veya maliyetini belirler, mevcut veritabanı durumu hakkında bilgi alır ve ardından en iyisini nihai yürütme planı olarak seçer. Sorgu optimize edicileri kusursuz olmadığından, veritabanı kullanıcıları ve yöneticileri bazen daha iyi performans elde etmek için optimize edicinin ürettiği planları manuel olarak inceleyip ayarlamak zorunda kalabilir.
Muhtemelen şimdi “iyi bir sorgu planı”nın ne olduğunu merak ediyorsunuz.
Daha önce okuduğunuz gibi, planın maliyetinin kalitesi büyük rol oynar. Daha özel olarak, planı değerlendirmek için gereken disk G/Ç sayısı, planın CPU maliyeti, veritabanı istemcisi tarafından gözlemlenebilen genel yanıt süresi ve toplam yürütme süresi gibi unsurlar kritiktir. İşte burada zaman karmaşıklığı kavramı devreye girecek. Bununla ilgili daha fazlasını ileride okuyacaksınız.
Sonraki adımda, seçilen sorgu planı yürütülür, sistemin yürütme motoru tarafından değerlendirilir ve sorgunuzun sonuçları döndürülür.
Önceki bölümden açıkça anlaşılmamış olabilecek bir nokta, Sorgu işleme ve yürütme içinde Doğru Girdi, Doğru Çıktı (GIGO) ilkesinin doğal olarak ortaya çıktığıdır: sorguyu formüle eden kişi, SQL sorgularınızın performans anahtarlarını da elinde tutar. Optimize edici zayıf formüle edilmiş bir sorgu alırsa, yapabilecekleri sınırlı olacaktır.
Bu, sorgu yazarken sizin yapabileceğiniz bazı şeyler olduğu anlamına gelir. Girişte de gördüğünüz gibi, sorumluluk iki yönlüdür: yalnızca belirli bir standardı karşılayan sorgular yazmakla kalmayıp, performans sorunlarının sorgunuzun neresinde pusuda olabileceğine dair bir fikir edinmek de gerekir.
İdeal bir başlangıç noktası, sorgularınız içinde sorunların sızabileceği “bölgeleri” düşünmektir. Genel olarak, yeni başlayanların performans sorunları bekleyebileceği dört ifade ve anahtar kelime vardır:
WHERE ifadesi;INNER JOIN veya LEFT JOIN anahtar kelimesi; Ve,HAVING ifadesi;Kabul edelim, bu yaklaşım basit ve naiftir, ancak yeni başlayanlar için bu ifadeler ve deyimler mükemmel işaretlerdir ve açıkça söylemek gerekirse yeni başlarken hataların en çok buralarda yapıldığını ve ironik biçimde en zor fark edildikleri yerlerin de yine buralar olduğunu söylemek güvenlidir.
Ancak performansın anlamlı olması için bağlama ihtiyaç duyduğunu da fark etmelisiniz: SQL performansını düşünürken bu ifadeler ve anahtar kelimelerin kötü olduğunu söylemek doğru yaklaşım değildir. Sorgunuzda bir WHERE veya HAVING ifadesinin bulunması, bunun mutlaka kötü bir sorgu olduğu anlamına gelmez.
SQL sorgunuzu oluşturmaya yönelik anti-pattern’ler ve alternatif yaklaşımlar hakkında daha fazla bilgi edinmek için aşağıdaki bölüme göz atın. Bu ipuçları ve püf noktaları bir rehber niteliğindedir. Sorgunuzu gerçekten yeniden yazmanız gerekip gerekmediği ve nasıl yazmanız gerektiği; veri miktarı, veritabanı, sorguyu çalıştırma sıklığı gibi unsurlara bağlıdır. Tamamen sorgunuzun amacına bağlıdır ve sorgulamak istediğiniz veritabanı hakkında ön bilgiye sahip olmak çok kritiktir!
“Ne kadar çok veri, o kadar iyi” zihniyeti, SQL sorguları yazarken ille de benimsemeniz gereken bir yaklaşım değildir: yalnızca gerçekten ihtiyacınız olandan fazlasını almak içgörülerinizi gölgeleyebileceği gibi, sorgunuzun çok fazla veri çekmesi performansı da olumsuz etkileyebilir.
Bu nedenle genellikle SELECT deyimine, DISTINCT ifadesine ve LIKE işleçine dikkat etmek iyi bir fikirdir.
SELECT DeyimiSorgunuzu yazdıktan sonra kontrol edebileceğiniz ilk şey, SELECT deyiminin mümkün olduğunca sade olup olmadığıdır. Buradaki amacınız, SELECT’ten gereksiz sütunları çıkarmak olmalıdır. Böylece, yalnızca sorgu amacınıza hizmet eden verileri çekmeye kendinizi zorlarsınız.
EXISTS içeren ilişkili alt sorgularınız varsa, o alt sorgunun SELECT deyiminde gerçek bir sütun değeri seçmek yerine sabit bir değer kullanmayı deneyin. Özellikle yalnızca varlık kontrolü yaparken bu oldukça kullanışlıdır.
Unutmayın, ilişkili alt sorgu, dış sorgudaki değerleri kullanan alt sorgudur. Ve NULL’ın bu bağlamda “sabit” olarak çalışabilmesine rağmen oldukça kafa karıştırıcı olduğunu unutmayın!
Aşağıdaki örneğe bakarak sabit değer kullanmanın ne demek olduğunu anlayın:
SELECT driverslicensenr, name FROM Drivers WHERE EXISTS (SELECT '1' FROM Fines WHERE fines.driverslicensenr = drivers.driverslicensenr);İpucu: İlişkili alt sorguya sahip olmak her zaman iyi bir fikir değildir. Örneğin, bunları bir INNER JOIN ile yeniden yazarak onlardan kurtulmayı düşünebilirsiniz:
SELECT driverslicensenr, name FROM drivers INNER JOIN fines ON fines.driverslicensenr = drivers.driverslicensenr; DISTINCT İfadesiSELECT DISTINCT deyimi yalnızca benzersiz (farklı) değerleri döndürmek için kullanılır. DISTINCT, mümkünse kesinlikle kaçınmaya çalışmanız gereken bir ifadedir. Diğer örneklerde de gördüğünüz gibi, bu ifadeyi sorgunuza eklediğinizde yürütme süresi yalnızca artar. Bu nedenle, istediğiniz sonuçlara ulaşmak için bu DISTINCT işleminin gerçekten gerekli olup olmadığını her zaman sorgulamak iyi bir fikirdir.
LIKE İşleciBir sorguda LIKE işleci kullandığınızda, desen % veya _ ile başlıyorsa indeks kullanılmaz. Bu, (varsa) veritabanının indeksi kullanmasını engeller. Elbette, başka bir açıdan, bu tür bir sorgunun, sorgu amacınızı gereğince karşılamayan çok fazla kaydı getirmeye kapı aralayabileceğini de savunabilirsiniz.
Yine, veritabanında depolanan veriler hakkındaki bilginiz, yalnızca sorgunuz için gerçekten önemli satırları bulacak şekilde tüm veriler arasında doğru biçimde filtreleyecek bir desen formüle etmenize yardımcı olabilir.
SELECT deyiminizi daraltmaktan kaçınamıyorsanız, sonuçlarınızı başka yollarla sınırlamayı düşünebilirsiniz. İşte burada LIMIT ifadesi ve veri tipi dönüşümleri gibi yaklaşımlar devreye girer.
TOP, LIMIT ve ROWNUM İfadeleriSorgularınıza sonuç kümesi için maksimum satır sayısı belirlemek üzere LIMIT veya TOP ifadelerini ekleyebilirsiniz. İşte bazı örnekler:
SELECT TOP 3 * FROM Drivers;Not: Örneğin, sorgunun ilk satırını SELECT TOP 50 PERCENT * olarak değiştirerek PERCENT belirtimini daha da özelleştirebilirsiniz.
SELECT driverslicensenr, name FROM Drivers LIMIT 2;Ek olarak, sorgunuzda LIMIT kullanımına eşdeğer olan ROWNUM ifadesini de ekleyebilirsiniz:
SELECT *FROM DriversWHERE driverslicensenr = 123456 AND ROWNUM <= 3;Mümkün olan en verimli, yani en küçük veri tiplerini kullanmalısınız. Daha küçük bir tip yeterli olabilecekken çok büyük bir veri tipi vermek her zaman risktir.
Bununla birlikte, sorgunuza veri tipi dönüşümü eklediğinizde, yürütme süresini yalnızca artırmış olursunuz.
Bir alternatif, veri tipi dönüşümünden olabildiğince kaçınmaktır. Burada da her zaman dönüşümü kaldırmanın veya atlamanın mümkün olmayabileceğini, ancak bunları dahil etme konusunda dikkatli olmayı ve eklediğinizde sorguyu çalıştırmadan önce etkisini test etmeyi hedeflemeniz gerektiğini unutmayın.
Veri tipi dönüşümleri bizi bir sonraki noktaya getiriyor: sorgularınızı fazla mühendislik yapmayın. Basit ve verimli tutmaya çalışın. Bu, özellikle sorgular karmaşık hale gelebildiği için, bir ipucu olacak kadar basit veya hatta “saçma” görünebilir.
Ancak, bir sonraki bölümlerde bahsedilen örneklerde göreceğiniz üzere, basit sorguları gereğinden fazla karmaşıklaştırmaya kolayca başlayabilirsiniz.
OR İşleciSorgunuzda OR işleci kullandığınızda, muhtemelen bir indeks kullanmıyorsunuz demektir.
Unutmayın, indeks; veritabanı tablonuzdaki veri alma hızını artıran bir veri yapısıdır, ancak bir maliyeti vardır: ek yazmalar ve indeks veri yapısını sürdürmek için ek depolama alanı gerekir. İndeksler, veritabanı tablosuna her erişildiğinde her satırı aramak zorunda kalmadan verileri hızla bulmak için kullanılır. İndeksler, bir veritabanı tablosundaki bir veya daha fazla sütun kullanılarak oluşturulabilir.
Veritabanının sunduğu indekslerden yararlanmazsanız, sorgunuzun çalışması kaçınılmaz olarak daha uzun sürer. Bu nedenle sorgunuzda OR kullanmaya alternatifler aramak en iyisidir;
Aşağıdaki sorguyu düşünün:
SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr = 123456OR driverslicensenr = 678910OR driverslicensenr = 345678;İşleci şu şekilde değiştirebilirsiniz:
IN içeren bir koşul; veyaSELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr IN (123456, 678910, 345678);UNION ile birleştirilmiş iki SELECT deyimi.İpucu: Burada, aynı tabloyu birden çok kez dolaştığınız için gereksiz yere UNION kullanmamaya dikkat etmelisiniz. Aynı zamanda, sorgunuzda UNION kullandığınızda yürütme süresinin artacağını da bilmelisiniz. UNION’a alternatifler: tüm koşullar tek bir SELECT ifadesine yerleştirilecek şekilde sorguyu yeniden formüle etmek veya UNION yerine bir OUTER JOIN kullanmak.
İpucu: Burada da aklınızda bulundurun: OR — ve sonraki bölümlerde bahsedilecek diğer işleçler — büyük olasılıkla bir indeksi kullanmıyor olsa da, indeks aramaları her zaman tercih edilmez!
NOT İşleciSorgunuz NOT işleci içerdiğinde, tıpkı OR’da olduğu gibi, indeksin kullanılmaması muhtemeldir. Bu da kaçınılmaz olarak sorgunuzu yavaşlatacaktır. Kastedileni anlamadıysanız, şu sorguyu düşünün:
SELECT driverslicensenr, nameFROM DriversWHERE NOT (year > 1980);Bu sorgu, beklediğinizden daha yavaş çalışacaktır; esas olarak olması gerekenden daha karmaşık formüle edildiği için: bu gibi durumlarda alternatif aramak en iyisidir. NOT yerine >, <> veya !> gibi karşılaştırma işleçleri kullanmayı düşünün; Yukarıdaki örnek gerçekten yeniden yazılarak şu hale gelebilir:
SELECT driverslicensenr, nameFROM DriversWHERE year <= 1980;Çok daha temiz görünüyor, değil mi?
AND İşleciAND işleci de indeksi kullanmayan ve aşağıdaki örnekte olduğu gibi gereğinden fazla karmaşık ve verimsiz kullanıldığında sorgunuzu yavaşlatabilecek bir işleçtir:
SELECT driverslicensenr, nameFROM DriversWHERE year >= 1960 AND year <= 1980;Bu sorguyu BETWEEN işleciyle yeniden yazmak daha iyidir:
SELECT driverslicensenr, nameFROM DriversWHERE year BETWEEN 1960 AND 1980;ANY ve ALL İşleçleriANY ve ALL işleçleri de dikkatli kullanmanız gerekenlerdir; bu işleçleri sorgularınıza dahil ettiğinizde indeks kullanılmaz. Burada MIN veya MAX gibi toplama (agregasyon) fonksiyonları faydalı alternatifler olabilir.
İpucu: Önerilen alternatifleri kullandığınız durumlarda, SUM, AVG, MIN, MAX gibi tüm toplama fonksiyonlarının çok sayıda satır üzerinde çalışmasının uzun süren sorgulara yol açabileceğinin farkında olun. Bu gibi durumlarda, ya işlenecek satır sayısını en aza indirmeye çalışabilir ya da bu değerleri önceden hesaplayabilirsiniz. Yine karar verirken ortamınızın, sorgu amacınızın vb. farkında olmanın önemini görüyorsunuz!
Bir sütun bir hesaplamada veya skaler bir fonksiyonda kullanıldığında da indeks kullanılmaz. Olası bir çözüm, ilgili sütunu basitçe izole ederek artık hesaplamanın veya fonksiyonun parçası olmamasını sağlamaktır. Şu örneği düşünün:
SELECT driverslicensenr, nameFROM DriversWHERE year + 10 = 1980;Biraz tuhaf görünüyor, değil mi? Bunun yerine, hesaplamayı yeniden gözden geçirin ve sorguyu şu şekilde yazın:
SELECT driverslicensenr, nameFROM DriversWHERE year = 1970;Bu son ipucu, sorguyu aşırı kısıtlamaya çalışmamanız gerektiği anlamına gelir; bu, performansı etkileyebilir. Bu özellikle JOIN’ler ve HAVING ifadesi için geçerlidir.
İki tabloyu birleştirirken, join’de tabloların sırasını dikkate almak önemli olabilir. Tablolardan birinin diğerine göre belirgin şekilde daha büyük olduğunu fark ederseniz, sorgunuzu en büyük tablo join’de en sona gelecek şekilde yeniden yazmak isteyebilirsiniz.
Join’lerinize çok fazla koşul eklediğinizde, SQL’i belirli bir yolu seçmeye zorlamış olursunuz. Ancak bu yol her zaman en performanslı olanı olmayabilir.
HAVING İfadesiHAVING ifadesi, başlangıçta WHERE anahtar kelimesinin toplama fonksiyonlarıyla kullanılamaması nedeniyle SQL’e eklenmiştir. HAVING genellikle döndürülen satır gruplarını belirli koşulları karşılayanlarla sınırlamak için GROUP BY ile birlikte kullanılır. Ancak bu ifadeyi sorgunuzda kullanırsanız, indeks kullanılmaz; bu da — bildiğiniz gibi — pek iyi performans göstermeyen bir sorguya neden olabilir.
Bir alternatif arıyorsanız, WHERE ifadesini kullanmayı düşünün. Aşağıdaki sorgulara bakın:
SELECT state, COUNT(*) FROM Drivers WHERE state IN ('GA', 'TX') GROUP BY state ORDER BY stateSELECT state, COUNT(*) FROM Drivers GROUP BY stateHAVING state IN ('GA', 'TX') ORDER BY stateİlk sorgu, toplanması gereken satır sayısını sınırlamak için WHERE ifadesini kullanır; ikinci sorgu ise tablodaki tüm satırları toplar ve sonra hesapladığı toplamların bir kısmını HAVING ile eler. Bu tür durumlarda, hiçbir kaynağı israf etmediğiniz için WHERE ifadesiyle olan alternatif açıkça daha iyidir.
Gördüğünüz gibi mesele, sonuç kümesini sınırlamak değil, bunun yerine bir sorgu içindeki ara kayıt sayısını sınırlamaktır.
Not: Bu iki ifade arasındaki fark, WHERE’in tek tek satırlara koşul uygulaması, HAVING’in ise birden çok satırdan üretilmiş tek bir sonuç (MIN, MAX, SUM, …) gibi toplamlara veya seçim sonuçlarına koşul uygulamasıdır.
Gördüğünüz gibi, kaliteyi değerlendirmek, sorgu yazmak ve yeniden yazmak; sorguların mümkün olduğunca performanslı olması gerektiğini hesaba kattığınızda kolay bir iş değildir; Anti-pattern’lerden kaçınmak ve alternatifleri değerlendirmek, profesyonel bir ortamda veritabanlarında çalıştırmak istediğiniz sorguları yazarken sorumluluklarınızın bir parçası olacaktır.
Bu liste, umarız yeni başlayanlara yardımcı olacak bazı anti-pattern’ler ve ipuçlarına kısa bir genel bakıştı; Daha kıdemli geliştiricilerin en sık görülen anti-pattern’ler hakkında ne düşündüğüne dair fikir edinmek isterseniz, bu tartışmaya göz atın.
Yukarıdaki anti-pattern’lerde örtük olan şey, aslında bunların sorgularınızı oluştururken küme tabanlı yaklaşımla prosedürel yaklaşım arasındaki farka dayandığıdır.
Prosedürel sorgulama yaklaşımı, programlamaya oldukça benzer: sisteme ne yapacağını ve nasıl yapacağını söylersiniz.
Bunun bir örneği, join’lerde gereksiz koşullar kullanmanız veya yukarıdaki örneklerde olduğu gibi HAVING ifadesini kötüye kullanmanızdır; veritabanını bir fonksiyon çalıştırıp ardından başka bir fonksiyon çağırarak sorgularsınız ya da döngüler, koşullar, Kullanıcı Tanımlı Fonksiyonlar (UDF), imleçler (cursor) … içeren bir mantık kullanırsınız. Bu yaklaşımda, kendinizi sıklıkla verinin bir alt kümesini isterken, ardından başka bir alt kümesini talep ederken bulursunuz.
Bu yaklaşımın sık sık “adım adım” veya “satır satır” sorgulama olarak adlandırılması şaşırtıcı değildir.
Diğer yaklaşım ise küme tabanlı yaklaşımdır; burada yalnızca ne yapılacağını belirtirsiniz. Rolünüz, sorgudan elde etmek istediğiniz sonuç kümesi için koşulları veya gereksinimleri belirtmektir. Verinizin nasıl getirileceğini, sorgunun uygulanmasını belirleyen dahili mekanizmalara bırakırsınız: sorgunuzu yürütmek için en iyi algoritmaları veya işleme mantığını veritabanı motorunun belirlemesine izin verirsiniz.
SQL küme tabanlı olduğundan, bu yaklaşımın prosedürel olana göre çok daha etkili olacağı sürpriz değildir; ayrıca, bazı durumlarda SQL’in koddan daha hızlı çalışabilmesini de açıklar.
İpucu küme tabanlı sorgulama yaklaşımı, veri bilimi sektöründeki önde gelen işverenlerin sizden ustalaşmanızı beklediği yaklaşımdır! Çoğu zaman bu iki yaklaşım arasında geçiş yapmanız gerekir.
Not: Eğer kendinizi prosedürel bir sorguyla bulursanız, bunu yeniden yazmayı veya yeniden düzenlemeyi (refactor) düşünün.
Anti-pattern’lerin statik olmadığını, siz SQL geliştiricisi olarak ilerledikçe evrildiğini ve alternatifleri düşünürken dikkate alınacak çok şey olduğunu bilmek, sorgu anti-pattern’lerinden kaçınmanın ve sorguları yeniden yazmanın oldukça zor bir görev olabileceği anlamına gelir. Her türlü yardım işe yarayabilir; bu nedenle, bazı araçlarla sorgunuzu optimize etmeye daha yapılandırılmış bir yaklaşımla gitmek doğru bir yol olabilir.
Not: Önceki bölümde bahsedilen bazı anti-pattern’lerin, örneğin AND, OR ve NOT işleçleri ve indeks kullanmamaları gibi, performans kaygılarında kök saldığını da unutmayın. Performansı düşünmek yalnızca daha yapılandırılmış değil, aynı zamanda daha derinlemesine bir yaklaşım da gerektirir.
Öyle ya da böyle, bu yapılandırılmış ve derinlemesine yaklaşım çoğunlukla sorgu planına dayanacaktır; hatırlarsanız, bu plan sorgunun önce bir “ayrıştırma ağacına” dönüştürülmesinin sonucudur ve her işlem için hangi algoritmanın kullanıldığını ve işlemlerin yürütülmesinin nasıl koordine edildiğini tam olarak tanımlar.
Girişte okuduğunuz gibi, optimize edici tarafından üretilen planları manuel olarak inceleyip ayarlamanız gerekebilir. Bu tür durumlarda, sorgu planına bakarak sorgunuzu yeniden analiz etmeniz gerekecektir.
Bu plana erişmek için, veritabanı yönetim sisteminizin (DBMS) size sunduğu araçları kullanmanız gerekir. Elinizin altında olabilecek bazı araçlar şunlardır:
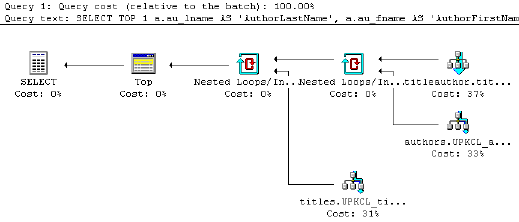
EXPLAIN PLAN deyimi; ancak komutun adı çalıştığınız RDBMS’e göre değişir. Başka yerlerde EXPLAIN (MySQL, PostgreSQL) veya EXPLAIN QUERY PLAN (SQLite) bulabilirsiniz.Not: PostgreSQL ile çalışıyorsanız EXPLAIN ile EXPLAIN ANALYZE arasındaki farkı bilin; EXPLAIN, sorguyu çalıştırmadan planlayıcının sorguyu nasıl yürütmeyi düşündüğüne dair bir tasvir sunarken, EXPLAIN ANALYZE sorguyu gerçekten çalıştırır ve beklenen ile gerçek sorgu planlarının analizini döndürür. Genel olarak, gerçek yürütme planı, sorguyu gerçekten çalıştırdığınız; tahmini yürütme planı ise sorguyu çalıştırmadan ne yapacağını hesapladığınız plandır. Mantıksal olarak eşdeğer olsalar da, gerçek yürütme planı daha faydalıdır; çünkü sorgu yürütülürken gerçekte ne olduğuna dair ek ayrıntılar ve istatistikler içerir.
Bu bölümün geri kalanında, EXPLAIN ve ANALYZE hakkında ve sorgu planınız ve sorgunuzun olası performansı hakkında daha fazla bilgi edinmek için bunları nasıl kullanabileceğiniz hakkında daha fazlasını öğreneceksiniz. Bunu yapmak için, one_million ve half_million adlı iki tabloyla çalıştığınız bazı örneklerle başlayacaksınız.
one_million tablosunun mevcut bilgilerini EXPLAIN yardımıyla alabilirsiniz; Bunu sorgunuzun en üstüne koyduğunuzdan emin olun, çalıştırıldığında size sorgu planını verecektir:
EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18584.82 rows=1025082 width=36)(1 row)Bu durumda, sorgunun maliyetinin 0.00..18584.82 ve satır sayısının 1025082 olduğunu görürsünüz. Sütun genişliği ise 36’dır.
Ayrıca, istatistiksel bilgilerinizi ANALYZE ile yenileyebilirsiniz.
ANALYZE one_million;EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(1 row)EXPLAIN ve ANALYZE’ın yanı sıra, gerçek yürütme süresini EXPLAIN ANALYZE ile de alabilirsiniz:
EXPLAIN ANALYZESELECT *FROM one_million;QUERY PLAN___________________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(actual time=0.015..1207.019 rows=1000000 loops=1)Total runtime: 2320.146 ms(2 rows)Burada EXPLAIN ANALYZE kullanmanın dezavantajı, sorgunun gerçekten çalıştırılmasıdır; bu nedenle dikkatli olun!
Şu ana kadar gördüğünüz algoritma Seq Scan (Sıralı Tarama) ya da Full Table Scan’dir: taranan tablonun her satırının art arda (seri) okunduğu ve bulunan sütunların bir koşulu karşılayıp karşılamadığına bakıldığı bir taramadır. Performans açısından, Sıralı Tarama kesinlikle en iyi yürütme planı değildir; çünkü hâlâ tam tablo taraması yaparsınız. Ancak tablo belleğe sığmıyorsa o kadar da kötü değildir: sıralı okumalar, yavaş disklerde bile oldukça hızlıdır.
İndeks taramasından bahsederken bunu daha sonra tekrar göreceksiniz.
Elbette başka algoritmalar da var. Örneğin, bir join için şu sorgu planına bakın:
EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN_________________________________________________________________Hash Join (cost=15417.00..68831.00 rows=500000 width=42)(actual time=1241.471..5912.553 rows=500000 loops=1)Hash Cond: (one_million.counter = half_million.counter) -> Seq Scan on one_million (cost=0.00..18334.00 rows=1000000 width=37) (actual time=0.007..1254.027 rows=1000000 loops=1) -> Hash (cost=7213.00..7213.00 rows=500000 width=5) (actual time=1241.251..1241.251 rows=500000 loops=1) Buckets: 4096 Batches: 16 Memory Usage: 770kB -> Seq Scan on half_million (cost=0.00..7213.00 rows=500000 width=5)(actual time=0.008..601.128 rows=500000 loops=1)Total runtime: 6468.337 msSorgu optimize edicinin burada bir Hash Join seçtiğini görüyorsunuz! Bu işlemi hatırlayın; çünkü sorgunuzun zaman karmaşıklığını tahmin etmek için buna ihtiyacınız olacak. Şimdilik, half_million.counter üzerinde bir indeks olmadığını ve bunu bir sonraki örnekte ekleyebileceğinizi not edin:
CREATE INDEX ON half_million(counter);EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN________________________________________________________________Merge Join (cost=4.12..37650.65 rows=500000 width=42)(actual time=0.033..3272.940 rows=500000 loops=1)Merge Cond: (one_million.counter = half_million.counter) -> Index Scan using one_million_counter_idx on one_million (cost=0.00..32129.34 rows=1000000 width=37) (actual time=0.011..694.466 rows=500001 loops=1) -> Index Scan using half_million_counter_idx on half_million (cost=0.00..14120.29 rows=500000 width=5)(actual time=0.010..683.674 rows=500000 loops=1)Total runtime: 3833.310 ms(5 rows)İndeksi oluşturarak, sorgu optimize edicinin şimdi Index Scanlerin gerçekleştiği bir Merge join tercih ettiğini görüyorsunuz.
Not: indeks taraması ile tam tablo veya sıralı tarama arasındaki fark şudur: ilki (tablo taraması olarak da adlandırılır), uygun kayıtları bulmak için veri veya indeks sayfalarını tarar; ikincisi ise tablonun her satırını tarar.
Toplam çalışma süresinin azaldığını ve performansın daha iyi olması gerektiğini görürsünüz; ancak iki indeks taraması vardır; bu da özellikle tablo belleğe sığmıyorsa belleğin daha önemli hale geldiği anlamına gelir. Bu gibi durumlarda önce tam bir indeks taraması yapılır; bunlar hızlı sıralı okumalardır ve sorun teşkil etmez; fakat sonrasında indeks değerine göre satırları almak için çok sayıda rastgele okuma yapılır. Genellikle rastgele okumalar, sıralı okumalardan katbekat daha yavaştır. Bu durumlarda, tam tablo taraması gerçekten de tam indeks taramasından daha hızlıdır.
Artık sorgu planını kısaca incelediğinize göre, performansı daha biçimsel terimlerle düşünmek için hesaplama karmaşıklığı teorisinden yararlanabilirsiniz. Bu, teorik bilgisayar bilimlerinin, diğer şeylerin yanı sıra, hesaplama problemlerini zorluklarına göre sınıflandırmaya odaklanan bir alanıdır; Bu hesaplama problemleri algoritmalar olabileceği gibi sorgular da olabilir.
Sorgular için ise, onları zorlarına göre sınıflandırmaktan ziyade, çalıştırılıp sonuçların alınmasının ne kadar sürdüğüne göre sınıflandırırsınız. Buna açıkça zaman karmaşıklığı denir ve bu tür karmaşıklığı ifade etmek veya ölçmek için Big O gösterimini kullanabilirsiniz.
Big O gösteriminde, çalışma süresini, girdi keyfi olarak büyüdükçe, girdiye göre ne kadar hızlı büyüdüğü açısından ifade edersiniz. Big O, sorgunuzun çalışma süresinin önemli kısmına, yani büyüme hızına odaklanabilmeniz için katsayıları ve daha düşük dereceli terimleri dışlar. Bu şekilde, katsayıları ve düşük dereceli terimleri atarak ifade edildiğinde, zaman karmaşıklığının asimptotik olarak tanımlandığı söylenir. Bu, girdi boyutunun sonsuza gittiği anlamına gelir.
Veritabanı dilinde, karmaşıklık; veri tablolarının ve dolayısıyla veritabanının boyutu arttıkça bir sorgunun çalışmasının ne kadar daha uzun sürdüğünü ölçer.
Not: Veritabanınızın boyutu yalnızca tablolara daha fazla veri eklendikçe artmaz; veritabanında indekslerin bulunması gerçeği de boyutta rol oynar.
Daha önce gördüğünüz gibi, yürütme planı; diğer şeylerin yanı sıra, her işlem için hangi algoritmanın kullanıldığını tanımlar; bu da her sorgu yürütme süresinin, sorgu planına dahil olan tablo boyutunun bir fonksiyonu olarak mantıksal biçimde ifade edilebileceği anlamına gelir; buna karmaşıklık fonksiyonu denir. Başka bir deyişle, Big O gösterimini ve yürütme planınızı kullanarak sorgu karmaşıklığını ve performansını tahmin edebilirsiniz.
Aşağıdaki alt bölümlerde, dört tür zaman karmaşıklığı hakkında genel bir fikir edinecek ve sorguların zaman karmaşıklığının çalıştırıldıkları bağlama göre nasıl değişebileceğine dair bazı örnekler göreceksiniz.
İpucu: Burada indeksler hikâyenin bir parçasıdır!
Not: Farklı indeks türleri, farklı yürütme planları ve çeşitli veritabanları için farklı uygulamalar söz konusudur; dolayısıyla aşağıda listelenen zaman karmaşıklıkları çok geneldir ve belirli ayarlarınıza göre değişebilir.
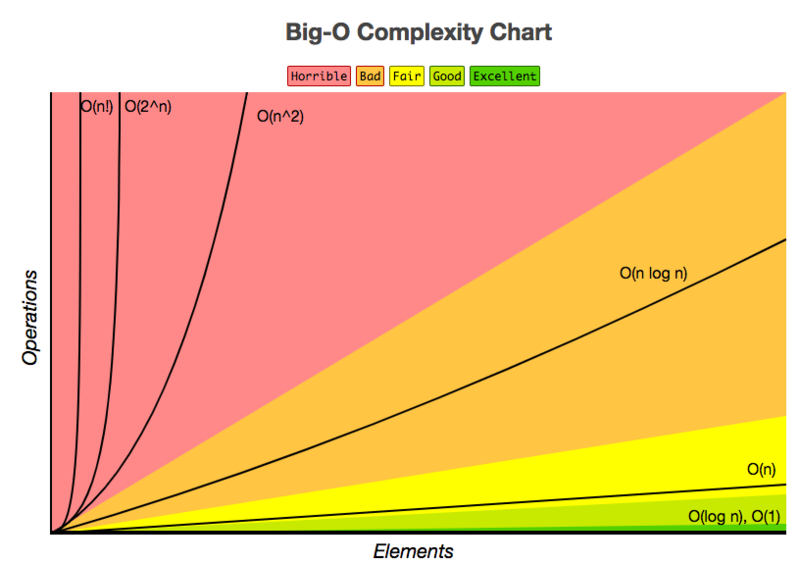
Bir algoritma, girdi boyutundan bağımsız olarak aynı sürede çalışıyorsa sabit zamanda çalışır denir. Bir sorgudan söz ederken, tablo boyutundan bağımsız olarak aynı sürede çalışıyorsa sabit zamanda çalışır denir.
Bu tür sorgular pek yaygın değildir; yine de şöyle bir örnek verilebilir:
SELECT TOP 1 t.* FROM tZaman karmaşıklığı sabittir; çünkü tablodan rastgele bir satır seçersiniz. Bu nedenle süre, tablonun boyutundan bağımsız olmalıdır.
Bir algoritmanın yürütme süresi, girdi boyutuyla doğru orantılıysa, yani girdi boyutu arttıkça süre doğrusal olarak artıyorsa doğrusal zamanda çalıştığı söylenir. Veritabanları için bu, yürütme süresinin tablo boyutuyla doğru orantılı olacağı anlamına gelir: tablodaki satır sayısı arttıkça sorgunun süresi de artar.
Örneğin, indekslenmemiş bir sütunda WHERE koşulu bulunan bir sorgu: Tam tablo taraması veya Seq Scan gerekir ve bu O(n) zaman karmaşıklığıyla sonuçlanır. Bu, doğru kimliğe sahip olanı bulmak için her satırın okunması gerektiği anlamına gelir. Hiçbir limit yoktur; dolayısıyla ilk satır koşulu karşılasa bile her satır okunmalıdır.
Ayrıca, i_id üzerinde indeks yoksa O(n) karmaşıklığına sahip olacak şu sorgu örneğini düşünün:
SELECT i_id FROM item;COUNT(*) FROM TABLE; gibi sayım sorgularının da zaman karmaşıklığının, tablo için toplam satır sayısı saklanmıyorsa, O(n) olacağı anlamına gelir; toplam satır sayısı saklanıyorsa karmaşıklık daha çok O(1) olurdu.Doğrusal yürütme süresine yakından ilgili bir konu da join içeren yürütme planlarının süresidir. İşte bazı örnekler:
Unutmayın: İç içe join, bir tablodaki her kaydı diğer tablodaki her kayıtla karşılaştıran join’dir.
Bir algoritmanın yürütme süresi, girdi boyutunun logaritmasıyla orantılıysa logaritmik zamanda çalıştığı söylenir; Sorgular için bu, yürütme süresinin veritabanı boyutunun logaritmasıyla orantılı olması durumunda geçerlidir.
Bu logaritmik zaman karmaşıklığı, bir Index Scan veya kümelenmiş indeks taramasının gerçekleştirildiği yürütme planları için geçerlidir. Kümelenmiş indeks, indeksin yaprak düzeyinde tablonun gerçek veri satırlarını içerdiği bir indekstir. Kümelenmiş indeks de diğer indekslere benzer: bir veya daha fazla sütunda tanımlanır. Bunlar indeks anahtarını oluşturur. Kümelenme anahtarı, kümelenmiş indeksin anahtar sütunlarıdır. Kümelenmiş indeks taraması, RDBMS’inizin kümelenmiş indeksi yukarıdan aşağıya okuyarak satır(lar)ı bulmasıdır.
Aşağıdaki sorgu örneğini düşünün; burada i_id üzerinde bir indeks vardır ve genellikle O(log(n)) karmaşıklığıyla sonuçlanır:
SELECT i_stock FROM item WHERE i_id = N; Not: İndeks olmadan zaman karmaşıklığı O(n) olurdu.
Bir algoritmanın yürütme süresi, girdi boyutunun karesiyle orantılıysa kare zamanda çalıştığı söylenir. Veritabanları için bu, bir sorgunun yürütme süresinin veritabanı boyutunun karesiyle orantılı olduğu anlamına gelir.
Kare zaman karmaşıklığına sahip olabilecek bir sorguya örnek:
SELECT * FROM item, author WHERE item.i_a_id=author.a_id Minimum karmaşıklık O(n log(n)) olurken, maksimum karmaşıklık join özniteliklerinin indeks bilgilerine bağlı olarak O(n^2) olabilir.
Özetlemek için, sorguların zaman karmaşıklığına göre performanslarını ve ne kadar iyi çalışacaklarını tahmin etmek üzere şu kısayol tablosuna da bakabilirsiniz:
Sorgu planını ve zaman karmaşıklığını göz önünde bulundurarak, SQL sorgunuzu daha da ayarlamayı düşünebilirsiniz. Şu noktalara özellikle dikkat ederek başlayabilirsiniz:
Tebrikler! SQL sorgu performansına kısa bir bakış sunan bu blog yazısının sonuna geldiniz. Umarız anti-pattern’ler, sorgu optimize edici ve sorgu planınızın karmaşıklığını gözden geçirmek, tahmin etmek ve yorumlamak için kullanabileceğiniz araçlar hakkında daha fazla içgörü edinmişsinizdir. Ancak keşfedilecek daha çok şey var! Daha fazlasını öğrenmek isterseniz, R. Ramakrishnan ve J. Gehrke tarafından yazılan “Database Management Systems” kitabını okumanızı öneririz.
Son olarak, bir StackOverflow kullanıcısının şu alıntısını sizden esirgemek istemem:
“Favori anti-pattern’üm, sorgularınızı test etmemektir.
Şu durumlarda geçerlidir:
- Sorgunuz birden fazla tablo içeriyorsa.
- Bir sorgu için en iyi tasarıma sahip olduğunuzu düşünüyor ancak varsayımlarınızı test etmiyorsanız.
- İşler gibi görünen ilk sorguyu, optimizeye yakın olup olmadığına dair en ufak bir fikriniz olmadan kabul ediyorsanız."
SQL’e başlamak istiyorsanız, şu DataCamp kurslarını düşünebilirsiniz:
SQL hakkında daha fazlasını öğrenin
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




