Khóa học
Xử lý dữ liệu trong SQL
4 giờ
337.2K
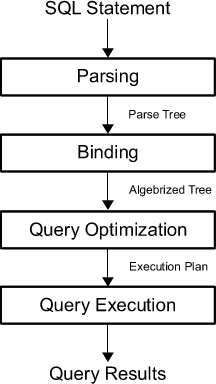
Để cải thiện hiệu năng của truy vấn SQL, trước hết bạn cần biết chuyện gì xảy ra bên trong khi bạn nhấn phím tắt để chạy truy vấn.
Đầu tiên, truy vấn được phân tích thành một “cây phân tích cú pháp” (parse tree); Truy vấn được kiểm tra xem có đáp ứng yêu cầu về cú pháp và ngữ nghĩa hay không. Bộ phân tích cú pháp tạo ra một biểu diễn nội bộ của truy vấn đầu vào. Kết quả này được chuyển cho bộ máy viết lại.
Sau đó, nhiệm vụ của bộ tối ưu hóa là tìm kế hoạch thực thi hoặc kế hoạch truy vấn tối ưu cho truy vấn đã cho. Kế hoạch thực thi xác định chính xác thuật toán nào được dùng cho từng phép toán, và cách điều phối việc thực thi các phép toán.
Để thực sự tìm ra kế hoạch thực thi tối ưu nhất, bộ tối ưu hóa liệt kê tất cả các kế hoạch khả dĩ, xác định chất lượng hoặc chi phí của mỗi kế hoạch, xét đến thông tin về trạng thái hiện tại của cơ sở dữ liệu, rồi chọn phương án tốt nhất làm kế hoạch thực thi cuối cùng. Vì bộ tối ưu có thể không hoàn hảo, người dùng và quản trị viên cơ sở dữ liệu đôi khi cần kiểm tra và tinh chỉnh thủ công các kế hoạch do bộ tối ưu tạo ra để có hiệu năng tốt hơn.
Bây giờ hẳn bạn tự hỏi thế nào là một “kế hoạch truy vấn tốt”.
Như bạn đã đọc, chất lượng hay chi phí của kế hoạch đóng vai trò đáng kể. Cụ thể, những yếu tố như số lần I/O đĩa cần để đánh giá kế hoạch, chi phí CPU của kế hoạch và thời gian phản hồi tổng thể quan sát được bởi client của cơ sở dữ liệu, cùng tổng thời gian thực thi là thiết yếu. Đây là lúc khái niệm độ phức tạp thời gian xuất hiện. Bạn sẽ đọc thêm về điều này sau.
Tiếp theo, kế hoạch truy vấn đã chọn được thực thi, đánh giá bởi engine thực thi của hệ thống, và kết quả truy vấn của bạn được trả về.
Điều có thể chưa rõ từ phần trước là nguyên tắc Rác vào, rác ra (GIGO) tự nhiên xuất hiện trong xử lý và thực thi truy vấn: người viết truy vấn cũng nắm chìa khóa hiệu năng cho các truy vấn SQL của bạn. Nếu bộ tối ưu nhận một truy vấn kém, nó cũng chỉ làm được đến vậy.
Điều đó có nghĩa có những việc bạn có thể làm khi viết truy vấn. Như đã thấy ở phần mở đầu, trách nhiệm là hai chiều: không chỉ viết truy vấn đạt chuẩn nhất định, mà còn hình dung được nơi các vấn đề hiệu năng có thể ẩn náu trong truy vấn của bạn.
Điểm khởi đầu lý tưởng là nghĩ về các “điểm” trong truy vấn nơi lỗi có thể len vào. Nhìn chung, có bốn mệnh đề và từ khóa mà người mới có thể kỳ vọng vấn đề hiệu năng xảy ra:
WHERE;INNER JOIN hoặc LEFT JOIN; Và,HAVING;Thừa nhận rằng cách tiếp cận này đơn giản và ngây thơ, nhưng với người mới, các mệnh đề và câu lệnh này là gợi ý tuyệt vời, và có thể nói rằng khi mới bắt đầu, đây là những điểm lỗi dễ xảy ra và trớ trêu thay cũng khó phát hiện.
Tuy nhiên, bạn cũng nên nhận ra rằng hiệu năng cần bối cảnh để trở nên có ý nghĩa: chỉ nói rằng các mệnh đề và từ khóa này là xấu không phải là cách đúng khi nghĩ về hiệu năng SQL. Có WHERE hay HAVING trong truy vấn không nhất thiết nghĩa là truy vấn tệ.
Xem phần tiếp theo để tìm hiểu thêm về anti-pattern và cách tiếp cận thay thế để xây dựng truy vấn SQL. Những mẹo này là định hướng. Việc bạn có cần viết lại truy vấn hay không phụ thuộc vào lượng dữ liệu, hệ cơ sở dữ liệu, số lần cần chạy truy vấn, v.v. Tất cả phụ thuộc vào mục tiêu truy vấn, và có hiểu biết trước về cơ sở dữ liệu bạn muốn truy vấn là tối quan trọng!
Tư duy “càng nhiều dữ liệu càng tốt” không phải điều bạn nên theo khi viết truy vấn SQL: không chỉ khiến insight của bạn bị che mờ vì lấy nhiều hơn mức cần thiết, mà hiệu năng cũng có thể giảm vì truy vấn kéo lên quá nhiều dữ liệu.
Vì vậy, nhìn chung, hãy chú ý đến câu lệnh SELECT, mệnh đề DISTINCT và toán tử LIKE.
SELECTĐiều đầu tiên bạn có thể kiểm tra sau khi viết truy vấn là liệu câu lệnh SELECT đã gọn nhất có thể chưa. Mục tiêu là loại bỏ các cột không cần thiết khỏi SELECT. Cách này buộc bạn chỉ kéo lên dữ liệu phục vụ mục tiêu truy vấn.
Nếu bạn có các truy vấn con tương quan dùng EXISTS, hãy thử dùng một hằng trong câu lệnh SELECT của truy vấn con thay vì chọn giá trị từ cột thực. Điều này đặc biệt hữu ích khi bạn chỉ cần kiểm tra sự tồn tại.
Nhớ rằng truy vấn con tương quan là truy vấn con dùng giá trị từ truy vấn ngoài. Và lưu ý rằng, dù NULL có thể hoạt động như một “hằng” trong ngữ cảnh này, nó rất gây nhầm lẫn!
Xem ví dụ sau để hiểu ý nghĩa của việc dùng hằng:
SELECT driverslicensenr, name FROM Drivers WHERE EXISTS (SELECT '1' FROM Fines WHERE fines.driverslicensenr = drivers.driverslicensenr);Mẹo: có thể việc dùng truy vấn con tương quan không phải lúc nào cũng là ý hay. Bạn có thể cân nhắc loại bỏ chúng, ví dụ viết lại bằng INNER JOIN:
SELECT driverslicensenr, name FROM drivers INNER JOIN fines ON fines.driverslicensenr = drivers.driverslicensenr; DISTINCTCâu lệnh SELECT DISTINCT dùng để trả về các giá trị khác nhau. DISTINCT là mệnh đề bạn nên tránh nếu có thể. Như bạn đã đọc trong các ví dụ khác, thời gian thực thi chỉ tăng lên nếu bạn thêm mệnh đề này vào truy vấn. Vì vậy, luôn cân nhắc xem bạn có thực sự cần thao tác DISTINCT để có được kết quả mong muốn hay không.
LIKEKhi bạn dùng toán tử LIKE trong một truy vấn, chỉ mục sẽ không được dùng nếu mẫu bắt đầu bằng % hoặc _. Điều này sẽ ngăn hệ cơ sở dữ liệu dùng chỉ mục (nếu có). Dĩ nhiên, ở góc độ khác, bạn cũng có thể cho rằng kiểu truy vấn này có thể mở đường cho việc lấy quá nhiều bản ghi không thật sự đáp ứng mục tiêu truy vấn.
Một lần nữa, hiểu biết về dữ liệu lưu trong cơ sở dữ liệu sẽ giúp bạn xây dựng mẫu lọc chính xác qua toàn bộ dữ liệu để chỉ tìm những hàng thật sự quan trọng cho truy vấn.
Khi bạn không thể tránh lọc trong câu lệnh SELECT, hãy cân nhắc giới hạn kết quả theo cách khác. Đây là nơi các cách như mệnh đề LIMIT và chuyển đổi kiểu dữ liệu phát huy tác dụng.
TOP, LIMIT và ROWNUMBạn có thể thêm mệnh đề LIMIT hoặc TOP vào truy vấn để đặt số hàng tối đa cho tập kết quả. Ví dụ:
SELECT TOP 3 * FROM Drivers;Lưu ý rằng bạn có thể chỉ định thêm PERCENT, chẳng hạn thay dòng đầu bằng SELECT TOP 50 PERCENT *.
SELECT driverslicensenr, name FROM Drivers LIMIT 2;Ngoài ra, bạn cũng có thể thêm mệnh đề ROWNUM, tương đương với việc dùng LIMIT trong truy vấn:
SELECT *FROM DriversWHERE driverslicensenr = 123456 AND ROWNUM <= 3;Bạn nên luôn dùng kiểu dữ liệu hiệu quả nhất, tức là nhỏ nhất, có thể. Luôn có rủi ro khi bạn dùng kiểu dữ liệu quá lớn trong khi kiểu nhỏ hơn là đủ.
Tuy nhiên, khi bạn thêm chuyển đổi kiểu dữ liệu vào truy vấn, bạn chỉ làm tăng thời gian thực thi.
Một cách thay thế là tránh chuyển đổi kiểu dữ liệu càng nhiều càng tốt. Cũng lưu ý rằng không phải lúc nào cũng có thể bỏ chuyển đổi kiểu ra khỏi truy vấn, nhưng bạn nên cẩn trọng khi thêm chúng và khi làm, hãy kiểm thử tác động của việc thêm đó trước khi chạy truy vấn.
Chuyển đổi kiểu dữ liệu dẫn bạn đến điểm tiếp theo: đừng “kỹ nghệ hóa” quá mức truy vấn. Hãy cố giữ chúng đơn giản và hiệu quả. Điều này có thể nghe quá đơn giản hoặc ngớ ngẩn để thành mẹo, nhất là vì truy vấn có thể phức tạp.
Tuy nhiên, bạn sẽ thấy trong các ví dụ tiếp theo rằng bạn có thể dễ dàng khiến các truy vấn đơn giản trở nên phức tạp hơn mức cần.
ORKhi dùng toán tử OR trong truy vấn, nhiều khả năng bạn sẽ không dùng đến chỉ mục.
Nhớ rằng chỉ mục là cấu trúc dữ liệu giúp tăng tốc độ truy xuất dữ liệu trong bảng, nhưng phải trả giá: sẽ có thêm thao tác ghi và cần thêm dung lượng lưu trữ để duy trì dữ liệu chỉ mục. Chỉ mục giúp định vị dữ liệu nhanh mà không cần tìm từng hàng mỗi lần truy cập bảng. Chỉ mục có thể được tạo trên một hoặc nhiều cột.
Nếu bạn không tận dụng các chỉ mục sẵn có, truy vấn sẽ mất nhiều thời gian hơn để chạy. Vì vậy, tốt nhất hãy tìm phương án thay thế cho OR trong truy vấn;
Xét truy vấn sau:
SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr = 123456OR driverslicensenr = 678910OR driverslicensenr = 345678;Bạn có thể thay toán tử bằng:
IN; hoặcSELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr IN (123456, 678910, 345678);SELECT với UNION.Mẹo: ở đây, bạn cần cẩn trọng để không dùng UNION một cách không cần thiết vì bạn sẽ đi qua cùng một bảng nhiều lần. Đồng thời, hãy nhận ra rằng khi bạn dùng UNION trong truy vấn, thời gian thực thi sẽ tăng. Các thay thế cho UNION gồm: viết lại truy vấn sao cho mọi điều kiện nằm trong một câu lệnh SELECT, hoặc dùng OUTER JOIN thay cho UNION.
Mẹo: cũng lưu ý rằng, dù OR — và các toán tử khác sẽ nêu ở phần sau — nhiều khả năng không dùng chỉ mục, việc tra cứu qua chỉ mục cũng không phải lúc nào là tốt nhất!
NOTKhi truy vấn chứa toán tử NOT, nhiều khả năng chỉ mục không được dùng, tương tự như với OR. Điều này sẽ làm truy vấn chậm lại. Nếu bạn chưa rõ ý này, hãy xem truy vấn sau:
SELECT driverslicensenr, nameFROM DriversWHERE NOT (year > 1980);Truy vấn này chắc chắn sẽ chạy chậm hơn kỳ vọng, chủ yếu vì nó được diễn đạt phức tạp hơn mức cần: trong các trường hợp như thế này, tốt nhất là tìm phương án thay thế. Hãy cân nhắc thay NOT bằng các toán tử so sánh như >, <> hoặc !>; Ví dụ trên có thể được viết lại như sau:
SELECT driverslicensenr, nameFROM DriversWHERE year <= 1980;Nhìn đã gọn gàng hơn nhiều, phải không?
ANDToán tử AND là một toán tử khác không tận dụng chỉ mục, và có thể làm chậm truy vấn nếu dùng theo cách quá phức tạp và kém hiệu quả, như ví dụ dưới đây:
SELECT driverslicensenr, nameFROM DriversWHERE year >= 1960 AND year <= 1980;Tốt hơn là viết lại và dùng toán tử BETWEEN:
SELECT driverslicensenr, nameFROM DriversWHERE year BETWEEN 1960 AND 1980;ANY và ALLANY và ALL cũng là những toán tử bạn nên thận trọng vì khi đưa vào truy vấn, chỉ mục sẽ không được dùng. Các lựa chọn thay thế hữu ích ở đây là các hàm tổng hợp như MIN hoặc MAX.
Mẹo: trong các trường hợp dùng phương án thay thế, bạn cần biết rằng mọi hàm tổng hợp như SUM, AVG, MIN, MAX trên nhiều hàng có thể khiến truy vấn chạy lâu. Khi đó, bạn có thể cố gắng giảm số hàng cần xử lý hoặc tính trước các giá trị này. Một lần nữa bạn thấy việc hiểu môi trường, mục tiêu truy vấn,… rất quan trọng khi quyết định nên dùng truy vấn nào!
Trong các trường hợp cột được dùng trong phép tính hoặc hàm vô hướng, chỉ mục cũng không được dùng. Một giải pháp khả dĩ là đơn giản cô lập cột cụ thể để nó không còn là một phần của phép tính hoặc hàm. Xem ví dụ:
SELECT driverslicensenr, nameFROM DriversWHERE year + 10 = 1980;Trông khá “ngộ”, phải không? Thay vào đó, hãy cân nhắc lại phép tính và viết lại như sau:
SELECT driverslicensenr, nameFROM DriversWHERE year = 1970;Mẹo cuối cùng này nghĩa là bạn không nên cố siết truy vấn quá mức vì có thể ảnh hưởng hiệu năng. Điều này đặc biệt đúng với join và mệnh đề HAVING.
Khi bạn join hai bảng, có thể quan trọng khi cân nhắc thứ tự các bảng trong phép join. Nếu nhận thấy một bảng lớn hơn đáng kể, bạn có thể viết lại truy vấn để đặt bảng lớn nhất ở cuối phép join.
Khi bạn thêm quá nhiều điều kiện vào join, bạn buộc SQL phải chọn một lộ trình cụ thể. Tuy nhiên, lộ trình đó không phải lúc nào cũng hiệu năng hơn.
HAVINGMệnh đề HAVING ban đầu được thêm vào SQL vì từ khóa WHERE không thể dùng với hàm tổng hợp. HAVING thường được dùng cùng GROUP BY để giới hạn các nhóm hàng trả về chỉ còn những nhóm đáp ứng điều kiện nhất định. Tuy nhiên, nếu bạn dùng mệnh đề này, chỉ mục sẽ không được dùng, điều mà — như bạn đã biết — có thể dẫn đến truy vấn kém hiệu năng.
Nếu bạn muốn phương án khác, hãy cân nhắc dùng mệnh đề WHERE. Xem hai truy vấn sau:
SELECT state, COUNT(*) FROM Drivers WHERE state IN ('GA', 'TX') GROUP BY state ORDER BY stateSELECT state, COUNT(*) FROM Drivers GROUP BY stateHAVING state IN ('GA', 'TX') ORDER BY stateTruy vấn đầu dùng WHERE để giới hạn số hàng cần cộng, trong khi truy vấn thứ hai cộng tất cả hàng trong bảng rồi dùng HAVING để loại bỏ các tổng vừa tính. Trong những trường hợp như thế, phương án với WHERE hiển nhiên tốt hơn vì bạn không lãng phí tài nguyên.
Bạn thấy đây không phải là giới hạn tập kết quả, mà là giới hạn số bản ghi trung gian trong một truy vấn.
Lưu ý sự khác biệt giữa hai mệnh đề nằm ở chỗ WHERE đặt điều kiện trên từng hàng, còn HAVING đặt điều kiện trên các phép tổng hợp hoặc kết quả chọn lọc nơi một kết quả đơn như MIN, MAX, SUM,… được tạo từ nhiều hàng.
Bạn thấy đấy, đánh giá chất lượng, viết và viết lại truy vấn không hề đơn giản khi xét đến yêu cầu hiệu năng tối đa; Tránh anti-pattern và cân nhắc phương án thay thế cũng sẽ là một phần trách nhiệm khi bạn viết truy vấn để chạy trên cơ sở dữ liệu trong môi trường chuyên nghiệp.
Danh sách này chỉ là cái nhìn tổng quan nhỏ về một số anti-pattern và mẹo có thể giúp người mới; Nếu bạn muốn biết các lập trình viên dày dạn coi đâu là những anti-pattern thường gặp nhất, hãy xem thảo luận này.
Điều ẩn sau các anti-pattern trên là chúng thực chất quy về sự khác biệt giữa cách xây dựng truy vấn dựa trên tập hợp và cách thủ tục.
Cách thủ tục khi truy vấn giống việc lập trình: bạn nói cho hệ thống làm gì và làm như thế nào.
Một ví dụ là các điều kiện dư thừa trong join hoặc trường hợp bạn lạm dụng mệnh đề HAVING, như các ví dụ trên, trong đó bạn truy vấn cơ sở dữ liệu bằng cách thực hiện một hàm rồi gọi một hàm khác, hoặc bạn dùng logic chứa vòng lặp, điều kiện, Hàm do người dùng định nghĩa (UDF), con trỏ,… để ra kết quả cuối. Với cách này, bạn thường sẽ yêu cầu một tập con dữ liệu, rồi yêu cầu một tập con khác, v.v.
Không ngạc nhiên khi cách này thường được gọi là truy vấn “bước-đến-bước” hoặc “theo từng hàng”.
Cách còn lại là dựa trên tập hợp, nơi bạn chỉ cần chỉ định làm gì. Vai trò của bạn là nêu các điều kiện hoặc yêu cầu cho tập kết quả bạn muốn nhận từ truy vấn. Cách dữ liệu được lấy, bạn để cho cơ chế bên trong quyết định: bạn để engine cơ sở dữ liệu chọn thuật toán hay logic xử lý tốt nhất để thực thi truy vấn.
Vì SQL dựa trên tập hợp, không có gì ngạc nhiên khi cách này sẽ hiệu quả hơn cách thủ tục và cũng giải thích vì sao, trong một số trường hợp, SQL có thể chạy nhanh hơn code.
Mẹo cách truy vấn dựa trên tập hợp cũng là điều hầu hết nhà tuyển dụng hàng đầu trong ngành khoa học dữ liệu yêu cầu bạn thành thạo! Bạn sẽ thường xuyên cần chuyển qua lại giữa hai cách này.
Lưu ý nếu bạn thấy mình có một truy vấn mang tính thủ tục, hãy cân nhắc viết lại hoặc refactor.
Biết rằng anti-pattern không tĩnh và sẽ thay đổi khi bạn tiến bộ như một lập trình viên SQL, cùng thực tế có rất nhiều điều phải cân nhắc khi nghĩ về phương án thay thế, cũng có nghĩa là việc tránh anti-pattern và viết lại truy vấn có thể khá khó. Mọi trợ giúp đều đáng giá, và đó là lý do một cách tiếp cận có cấu trúc để tối ưu hóa truy vấn bằng các công cụ có thể là cách nên làm.
Lưu ý thêm rằng một số anti-pattern ở phần trước bắt nguồn từ lo ngại hiệu năng, như các toán tử AND, OR và NOT và việc không dùng chỉ mục của chúng. Nghĩ về hiệu năng không chỉ cần cách tiếp cận có cấu trúc mà còn cần cách tiếp cận chuyên sâu hơn.
Dù thế nào, cách tiếp cận có cấu trúc và chuyên sâu này sẽ chủ yếu dựa trên kế hoạch truy vấn, thứ — như bạn nhớ — là kết quả sau khi truy vấn được phân tích thành “cây phân tích cú pháp” và xác định chính xác thuật toán nào dùng cho mỗi phép toán và cách điều phối việc thực thi.
Như đã nêu ở phần giới thiệu, có thể bạn cần kiểm tra và tinh chỉnh thủ công các kế hoạch do bộ tối ưu tạo ra. Trong các trường hợp như vậy, bạn sẽ cần phân tích lại truy vấn bằng cách xem kế hoạch truy vấn.
Để lấy được kế hoạch này, bạn sẽ cần dùng các công cụ mà hệ quản trị cơ sở dữ liệu cung cấp. Một số công cụ bạn có thể có gồm:
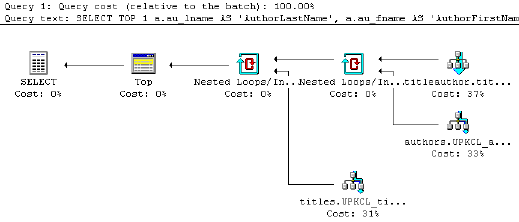
EXPLAIN PLAN trong Oracle, nhưng tên gọi khác nhau theo RDBMS bạn dùng. Nơi khác, bạn có thể thấy EXPLAIN (MySQL, PostgreSQL) hoặc EXPLAIN QUERY PLAN (SQLite).Lưu ý nếu bạn dùng PostgreSQL, hãy phân biệt giữa EXPLAIN, nơi bạn chỉ nhận mô tả ý tưởng về cách planner dự định thực thi truy vấn mà không chạy nó, trong khi EXPLAIN ANALYZE thực sự chạy truy vấn và trả về cho bạn phân tích so sánh kế hoạch dự kiến với thực tế. Nói chung, kế hoạch thực thi thực tế là khi bạn thực sự chạy truy vấn, còn kế hoạch ước tính là tính xem sẽ làm gì mà không chạy. Dù tương đương về logic, kế hoạch thực tế hữu ích hơn nhiều vì chứa thêm chi tiết và thống kê về những gì thực sự xảy ra khi thực thi.
Ở phần còn lại, bạn sẽ tìm hiểu thêm về EXPLAIN và ANALYZE và cách dùng hai công cụ này để hiểu thêm về kế hoạch truy vấn và hiệu năng tiềm năng của truy vấn. Để làm điều này, bạn sẽ bắt đầu với một số ví dụ làm việc với hai bảng: one_million và half_million.
Bạn có thể truy xuất thông tin hiện tại của bảng one_million với EXPLAIN; Đặt nó ngay trên truy vấn của bạn, và khi chạy, nó sẽ trả về kế hoạch truy vấn:
EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18584.82 rows=1025082 width=36)(1 row)Ở đây, bạn thấy chi phí truy vấn là 0.00..18584.82 và số hàng là 1025082. Độ rộng số cột là 36.
Bạn cũng có thể làm mới thống kê với ANALYZE.
ANALYZE one_million;EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(1 row)Ngoài EXPLAIN và ANALYZE, bạn cũng có thể lấy thời gian thực thi thực tế với EXPLAIN ANALYZE:
EXPLAIN ANALYZESELECT *FROM one_million;QUERY PLAN___________________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(actual time=0.015..1207.019 rows=1000000 loops=1)Total runtime: 2320.146 ms(2 rows)Điểm bất lợi của EXPLAIN ANALYZE ở đây dĩ nhiên là truy vấn thực sự được chạy, nên hãy cẩn thận!
Cho đến giờ, thuật toán bạn thấy là Seq Scan (Sequential Scan) hay Full Table Scan: đó là quét một cơ sở dữ liệu nơi mỗi hàng của bảng được đọc tuần tự và các cột được kiểm tra xem có thỏa điều kiện hay không. Về hiệu năng, Sequential Scan chắc chắn không phải kế hoạch tốt nhất vì bạn vẫn đang quét toàn bảng. Tuy nhiên, nó không quá tệ khi bảng không vừa trong bộ nhớ: đọc tuần tự khá nhanh ngay cả với đĩa chậm.
Bạn sẽ thấy thêm về điều này sau khi nói về index scan.
Tuy nhiên, còn các thuật toán khác. Lấy ví dụ kế hoạch truy vấn cho một phép join:
EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN_________________________________________________________________Hash Join (cost=15417.00..68831.00 rows=500000 width=42)(actual time=1241.471..5912.553 rows=500000 loops=1)Hash Cond: (one_million.counter = half_million.counter) -> Seq Scan on one_million (cost=0.00..18334.00 rows=1000000 width=37) (actual time=0.007..1254.027 rows=1000000 loops=1) -> Hash (cost=7213.00..7213.00 rows=500000 width=5) (actual time=1241.251..1241.251 rows=500000 loops=1) Buckets: 4096 Batches: 16 Memory Usage: 770kB -> Seq Scan on half_million (cost=0.00..7213.00 rows=500000 width=5)(actual time=0.008..601.128 rows=500000 loops=1)Total runtime: 6468.337 msBạn thấy bộ tối ưu đã chọn Hash Join! Hãy nhớ phép này, vì bạn sẽ cần nó để ước lượng độ phức tạp thời gian của truy vấn. Hiện chưa có chỉ mục trên half_million.counter, bạn có thể thêm ở ví dụ tiếp theo:
CREATE INDEX ON half_million(counter);EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN________________________________________________________________Merge Join (cost=4.12..37650.65 rows=500000 width=42)(actual time=0.033..3272.940 rows=500000 loops=1)Merge Cond: (one_million.counter = half_million.counter) -> Index Scan using one_million_counter_idx on one_million (cost=0.00..32129.34 rows=1000000 width=37) (actual time=0.011..694.466 rows=500001 loops=1) -> Index Scan using half_million_counter_idx on half_million (cost=0.00..14120.29 rows=500000 width=5)(actual time=0.010..683.674 rows=500000 loops=1)Total runtime: 3833.310 ms(5 rows)Bạn thấy rằng, khi tạo chỉ mục, bộ tối ưu đã quyết định dùng Merge join với các Index Scan.
Lưu ý sự khác biệt giữa index scan và full table scan hay sequential scan: index scan (còn gọi là “table scan” trong một số ngữ cảnh) quét các trang dữ liệu hoặc chỉ mục để tìm bản ghi phù hợp, trong khi full table scan quét từng hàng của bảng.
Bạn thấy tổng thời gian chạy đã giảm và hiệu năng nên tốt hơn, nhưng có hai index scan, khiến bộ nhớ trở nên quan trọng hơn, đặc biệt nếu bảng không vừa bộ nhớ. Khi đó, trước tiên bạn phải thực hiện full index scan — đọc tuần tự nhanh và không vấn đề — nhưng sau đó có rất nhiều lượt đọc ngẫu nhiên để lấy hàng theo giá trị chỉ mục. Chính các lượt đọc ngẫu nhiên này thường chậm hơn nhiều so với đọc tuần tự. Trong các trường hợp này, full table scan thực sự nhanh hơn full index scan.
Bây giờ bạn đã xem qua kế hoạch truy vấn, bạn có thể đào sâu hơn và nghĩ về hiệu năng theo các khái niệm chính quy với sự trợ giúp của lý thuyết độ phức tạp tính toán. Đây là lĩnh vực trong khoa học máy tính lý thuyết tập trung vào phân loại các bài toán tính toán theo độ khó, v.v.; Các bài toán này có thể là thuật toán, nhưng cũng có thể là truy vấn.
Với truy vấn, bạn không nhất thiết phân loại theo độ khó, mà theo thời gian chạy để nhận kết quả. Đây gọi là độ phức tạp thời gian, và để diễn đạt/đo lường độ phức tạp này, bạn có thể dùng ký hiệu big O.
Với big O, bạn biểu thị thời gian chạy theo tốc độ tăng tương đối với đầu vào khi đầu vào tăng đến rất lớn. Ký hiệu big O loại bỏ các hệ số và hạng bậc thấp để bạn tập trung vào phần quan trọng của thời gian chạy: tốc độ tăng. Khi diễn đạt như vậy, loại bỏ hệ số và hạng bậc thấp, độ phức tạp thời gian được mô tả tiệm cận. Nghĩa là kích thước đầu vào tiến tới vô hạn.
Trong ngôn ngữ cơ sở dữ liệu, độ phức tạp đo lường mất bao lâu để chạy truy vấn khi kích thước các bảng dữ liệu, và vì thế kích thước cơ sở dữ liệu, tăng lên.
Lưu ý kích thước cơ sở dữ liệu không chỉ tăng khi có thêm dữ liệu trong bảng, mà ngay cả sự hiện diện của các chỉ mục cũng làm tăng kích thước.
Như bạn đã thấy, kế hoạch thực thi xác định, trong số những thứ khác, thuật toán dùng cho mỗi phép toán, khiến thời gian thực thi truy vấn có thể được biểu diễn logic như một hàm theo kích thước bảng tham gia trong kế hoạch truy vấn, gọi là hàm độ phức tạp. Nói cách khác, bạn có thể dùng ký hiệu big O và kế hoạch thực thi để ước lượng độ phức tạp truy vấn và hiệu năng.
Trong các tiểu mục tiếp theo, bạn sẽ có cái nhìn khái quát về bốn loại độ phức tạp thời gian, và xem một số ví dụ về cách độ phức tạp thời gian của truy vấn có thể thay đổi theo bối cảnh chạy.
Gợi ý: chỉ mục là một phần câu chuyện ở đây!
Lưu ý rằng có các loại chỉ mục khác nhau, các kế hoạch thực thi khác nhau và các triển khai khác nhau giữa các cơ sở dữ liệu, nên các độ phức tạp liệt kê dưới đây rất tổng quát và có thể thay đổi theo bối cảnh của bạn.
Một thuật toán chạy trong thời gian hằng nếu nó cần cùng một lượng thời gian bất kể kích thước đầu vào. Với truy vấn, nó chạy trong thời gian hằng nếu cần cùng một lượng thời gian bất kể kích thước bảng.
Những truy vấn kiểu này không thực sự phổ biến, nhưng đây là một ví dụ:
SELECT TOP 1 t.* FROM tĐộ phức tạp thời gian là hằng vì bạn chọn một hàng tùy ý từ bảng. Do đó, thời gian không phụ thuộc vào kích thước bảng.
Một thuật toán chạy trong thời gian tuyến tính nếu thời gian thực thi tỉ lệ thuận với kích thước đầu vào, tức thời gian tăng tuyến tính khi đầu vào tăng. Với cơ sở dữ liệu, điều này có nghĩa thời gian thực thi tỉ lệ thuận với kích thước bảng: khi số hàng tăng, thời gian truy vấn tăng.
Một ví dụ là truy vấn có mệnh đề WHERE trên cột không được đánh chỉ mục: cần full table scan hoặc Seq Scan, dẫn đến độ phức tạp O(n). Tức là cần đọc mọi hàng để tìm hàng có ID đúng. Bạn không có giới hạn nào, nên mọi hàng đều cần đọc, dù hàng đầu tiên đã khớp điều kiện.
Xem thêm ví dụ dưới về truy vấn có độ phức tạp O(n) nếu không có chỉ mục trên i_id:
SELECT i_id FROM item;COUNT(*) FROM TABLE; sẽ có độ phức tạp O(n), vì cần full table scan trừ khi tổng số hàng được lưu sẵn cho bảng. Khi đó, độ phức tạp sẽ gần O(1).Liên quan chặt chẽ đến thời gian tuyến tính là thời gian thực thi cho các kế hoạch có join. Ví dụ:
Nhớ: nested join là join so sánh mọi bản ghi ở một bảng với mọi bản ghi ở bảng kia.
Một thuật toán chạy trong thời gian logarit nếu thời gian thực thi tỉ lệ với logarit của kích thước đầu vào; Với truy vấn, điều này nghĩa là chúng chạy với thời gian tỉ lệ logarit của kích thước cơ sở dữ liệu.
Độ phức tạp này đúng với các kế hoạch có Index Scan hoặc quét chỉ mục cụm (clustered). Chỉ mục cụm là chỉ mục có mức lá chứa chính các hàng dữ liệu thực của bảng. Chỉ mục cụm cũng như chỉ mục khác: được định nghĩa trên một hay nhiều cột — tạo thành khóa chỉ mục. Khóa phân cụm là các cột khóa của chỉ mục cụm. Quét chỉ mục cụm về cơ bản là RDBMS đọc từ trên xuống dưới trong chỉ mục cụm để lấy hàng phù hợp.
Xem truy vấn ví dụ sau, với chỉ mục trên i_id và thường cho độ phức tạp O(log(n)):
SELECT i_stock FROM item WHERE i_id = N; Lưu ý rằng nếu không có chỉ mục, độ phức tạp sẽ là O(n).
Một thuật toán chạy trong thời gian bậc hai nếu thời gian thực thi tỉ lệ với bình phương kích thước đầu vào. Với cơ sở dữ liệu, nghĩa là thời gian chạy truy vấn tỉ lệ với bình phương kích thước cơ sở dữ liệu.
Một ví dụ khả dĩ về truy vấn có độ phức tạp bậc hai là:
SELECT * FROM item, author WHERE item.i_a_id=author.a_id Độ phức tạp tối thiểu sẽ là O(n log(n)), nhưng tối đa có thể là O(n^2), tùy vào thông tin chỉ mục của thuộc tính join.
Tóm lại, bạn cũng có thể xem bảng cheat sheet sau để ước lượng hiệu năng truy vấn theo độ phức tạp thời gian và mức độ hoạt động của chúng:
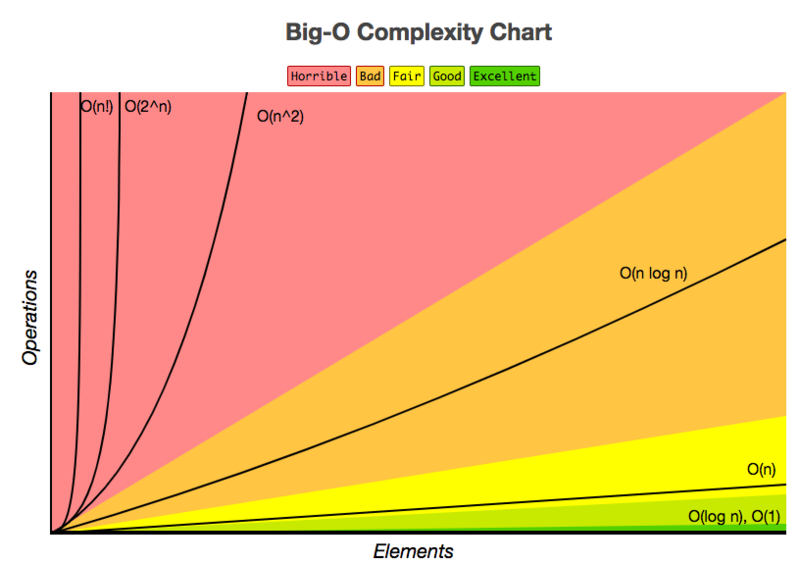
Với kế hoạch truy vấn và độ phức tạp thời gian trong đầu, bạn có thể cân nhắc tinh chỉnh truy vấn SQL hơn nữa. Bạn có thể bắt đầu bằng cách chú ý đặc biệt đến các điểm sau:
Chúc mừng! Bạn đã đi đến cuối bài viết, nơi mang đến cái nhìn nhỏ về hiệu năng truy vấn SQL. Hy vọng bạn đã có thêm hiểu biết về anti-pattern, bộ tối ưu truy vấn và các công cụ có thể dùng để rà soát, ước lượng và diễn giải độ phức tạp của kế hoạch truy vấn. Tuy nhiên, vẫn còn rất nhiều điều để khám phá! Nếu muốn biết thêm, hãy đọc cuốn “Database Management Systems” của R. Ramakrishnan và J. Gehrke.
Cuối cùng, tôi muốn chia sẻ với bạn câu trích dẫn này từ một người dùng StackOverflow:
“Anti-pattern yêu thích của tôi là không kiểm thử truy vấn.
Điều này áp dụng khi:
- Truy vấn của bạn liên quan nhiều hơn một bảng.
- Bạn nghĩ mình có thiết kế tối ưu cho một truy vấn, nhưng không buồn kiểm thử giả định của mình.
- Bạn chấp nhận truy vấn đầu tiên chạy được, mà không biết nó có gần tối ưu hay không.”
Nếu bạn muốn bắt đầu với SQL, hãy cân nhắc các khóa học của DataCamp:
Tìm hiểu thêm về SQL
Khóa học
blog
Matt Crabtree
10 phút
