Curso
Manipulação de dados em SQL
4 h
335K
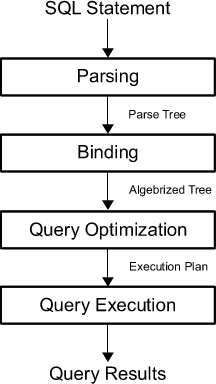
Para melhorar o desempenho de uma consulta SQL, primeiro é preciso entender o que acontece internamente quando você executa a query.
Primeiro, a consulta é analisada e transformada em uma “árvore de parsing”; verifica-se se ela atende aos requisitos sintáticos e semânticos. O parser cria uma representação interna da consulta. Essa saída é enviada para o mecanismo de reescrita.
Depois, o otimizador busca o plano de execução ideal para aquela consulta. O plano define quais algoritmos serão usados em cada operação e como a execução dessas operações será coordenada.
Para achar o melhor plano, o otimizador enumera possíveis planos, estima o custo/qualidade de cada um, considera o estado atual do banco e escolhe o melhor como plano final. Como otimizadores não são perfeitos, às vezes usuários e administradores precisam examinar e ajustar manualmente os planos para obter mais performance.
Você deve estar se perguntando: o que é um “bom plano de consulta”?
Como vimos, o custo do plano pesa bastante. Em especial, contam o número de operações de I/O em disco para avaliar o plano, o custo de CPU, o tempo de resposta percebido pelo cliente e o tempo total de execução. É aqui que entra a noção de complexidade de tempo. Falaremos disso já já.
Depois disso, o plano é executado pelo mecanismo de execução do sistema e os resultados são retornados.
O que pode não ter ficado explícito é que o princípio Garbage In, Garbage Out (GIGO) aparece naturalmente no processamento e execução: quem formula a consulta tem grande impacto na performance. Se o otimizador recebe uma query mal formulada, há um limite para o que ele consegue fazer.
Isso significa que há coisas que você pode fazer ao escrever a consulta. Como vimos, a responsabilidade é dupla: não é só escrever uma query “bem-feita”, mas também identificar onde podem estar os gargalos de desempenho.
Um bom ponto de partida é pensar em “pontos sensíveis” onde problemas tendem a aparecer. Em geral, quatro cláusulas/palavras-chave são foco de dor para iniciantes:
WHERE;INNER JOIN ou LEFT JOIN; eHAVING;É uma abordagem simples, até ingênua, mas para quem está começando esses são ótimos indicadores — e, ironicamente, os erros aí são comuns e difíceis de notar.
Também é importante lembrar que desempenho requer contexto: dizer que essas cláusulas são “ruins” por si só não faz sentido. Ter WHERE ou HAVING não torna sua consulta ruim automaticamente.
Confira a próxima seção para conhecer antipadrões e alternativas na hora de construir sua consulta SQL. As dicas a seguir são guias: a necessidade de reescrever depende do volume de dados, do banco, da frequência de execução etc. Tudo depende do objetivo da consulta — e conhecer o banco que você está consultando é crucial!
A mentalidade “quanto mais dado, melhor” não deve guiar você ao escrever consultas: além de poluir os insights com dados desnecessários, sua performance pode cair por trazer informação demais.
Por isso, vale ficar de olho no SELECT, na cláusula DISTINCT e no operador LIKE.
SELECTVerifique se o SELECT está o mais enxuto possível. O objetivo é remover colunas desnecessárias. Assim, você se força a trazer apenas o que atende ao objetivo da consulta.
Se houver subconsultas correlacionadas com EXISTS, use uma constante no SELECT dessa subquery em vez de selecionar o valor de uma coluna real. Isso é útil quando você só checa a existência.
Lembre: uma subconsulta correlacionada usa valores da consulta externa. E, embora NULL “funcione” como constante, é bem confuso!
Veja um exemplo de uso de constante:
SELECT driverslicensenr, name FROM Drivers WHERE EXISTS (SELECT '1' FROM Fines WHERE fines.driverslicensenr = drivers.driverslicensenr);Dica: subconsulta correlacionada nem sempre é boa. Considere reescrever com um INNER JOIN para eliminá-la:
SELECT driverslicensenr, name FROM drivers INNER JOIN fines ON fines.driverslicensenr = drivers.driverslicensenr; DISTINCTSELECT DISTINCT retorna apenas valores distintos. Evite DISTINCT quando puder: como você verá em outros exemplos, adicionar essa cláusula tende a aumentar o tempo de execução. Sempre avalie se ela é realmente necessária para alcançar o resultado desejado.
LIKEAo usar LIKE, o índice não é utilizado se o padrão começa com % ou _. Isso impede o uso de índice (se existir). Além disso, essa consulta pode abrir margem para retornar muitos registros que não ajudam seu objetivo.
Conhecer os dados do banco ajuda a formular padrões que filtrem corretamente e tragam apenas as linhas relevantes.
Quando não der para filtrar mais no SELECT, limite os resultados de outras formas. Aqui entram LIMIT e conversões de tipo de dado.
TOP, LIMIT e ROWNUMUse LIMIT ou TOP para definir um número máximo de linhas no resultado. Exemplos:
SELECT TOP 3 * FROM Drivers;Observação: você pode especificar PERCENT, por exemplo, SELECT TOP 50 PERCENT *.
SELECT driverslicensenr, name FROM Drivers LIMIT 2;Além disso, você pode usar ROWNUM, equivalente a LIMIT em algumas bases:
SELECT *FROM DriversWHERE driverslicensenr = 123456 AND ROWNUM <= 3;Sempre use tipos de dados mais eficientes (menores) possíveis. Fornecer um tipo muito grande quando um menor resolve é arriscado.
Ao adicionar conversões de tipo na query, você tende a aumentar o tempo de execução.
Evite conversões quando puder. Nem sempre dá para removê-las, mas inclua com cuidado e teste o impacto antes de rodar em produção.
As conversões de tipo levam a outro ponto: não faça overengineering. Mantenha simples e eficiente. Pode parecer básico, mas queries crescem em complexidade rapidamente.
Você verá adiante como é fácil complicar o que poderia ser simples.
ORAo usar OR, é provável que o índice não seja usado.
Lembre: um índice acelera a recuperação de dados em uma tabela, mas custa: mais escritas e mais espaço para manter a estrutura. Ele permite localizar dados rapidamente sem varrer todas as linhas.
Se você ignora os índices disponíveis, a consulta tende a demorar mais. Procure alternativas ao OR:
Exemplo:
SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr = 123456OR driverslicensenr = 678910OR driverslicensenr = 345678;Substitua por:
IN; ouSELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr IN (123456, 678910, 345678);SELECT com UNION.Dica: cuidado para não usar UNION sem necessidade, pois você varre a mesma tabela várias vezes. E UNION tende a aumentar o tempo de execução. Alternativas: concentrar as condições em um único SELECT ou usar OUTER JOIN em vez de UNION.
Dica: lembre também que, embora OR (e outros operadores a seguir) provavelmente não use índice, nem sempre lookup por índice é preferível!
NOTQuando sua query contém NOT, o índice tende a não ser usado, como em OR. Isso pode deixá-la lenta. Exemplo:
SELECT driverslicensenr, nameFROM DriversWHERE NOT (year > 1980);Essa consulta pode ser mais lenta do que você imagina e está mais complexa do que precisa. Prefira operadores de comparação como >, <> ou !>. Reescrevendo:
SELECT driverslicensenr, nameFROM DriversWHERE year <= 1980;Bem mais limpo, né?
ANDAND também pode não usar índice e deixar a consulta lenta quando usado de forma complexa, como abaixo:
SELECT driverslicensenr, nameFROM DriversWHERE year >= 1960 AND year <= 1980;Melhor reescrever com BETWEEN:
SELECT driverslicensenr, nameFROM DriversWHERE year BETWEEN 1960 AND 1980;ANY e ALLANY e ALL também merecem cuidado: ao incluí-los, o índice tende a não ser usado. Alternativas úteis são funções de agregação como MIN ou MAX.
Dica: ao usar agregações como SUM, AVG, MIN, MAX sobre muitas linhas, a consulta pode demorar. Tente reduzir o número de linhas processadas ou pré-calcular valores. Mais uma vez, conhecer o ambiente e o objetivo da query ajuda a decidir.
Se uma coluna entra em um cálculo ou função escalar, o índice tende a não ser usado. Uma solução é isolar a coluna para que ela não faça parte do cálculo/função. Exemplo:
SELECT driverslicensenr, nameFROM DriversWHERE year + 10 = 1980;Esquisito, né? Reescreva a conta e simplifique:
SELECT driverslicensenr, nameFROM DriversWHERE year = 1970;Não restrinja demais sua consulta — isso pode afetar a performance. Isso vale especialmente para joins e para a cláusula HAVING.
Ao juntar duas tabelas, considere a ordem. Se uma for bem maior, pode ser vantajoso colocá-la por último no join.
Adicionar condições demais obriga o SQL a seguir um caminho específico — que pode não ser o mais eficiente.
HAVINGHAVING surgiu porque WHERE não podia ser usado com agregações. Em geral, HAVING vem com GROUP BY para restringir grupos de linhas retornados. Mas, se você usa HAVING, o índice não é utilizado, o que pode prejudicar a performance.
Alternativa: use WHERE. Compare:
SELECT state, COUNT(*) FROM Drivers WHERE state IN ('GA', 'TX') GROUP BY state ORDER BY stateSELECT state, COUNT(*) FROM Drivers GROUP BY stateHAVING state IN ('GA', 'TX') ORDER BY stateA primeira restringe as linhas antes de somar; a segunda soma tudo e depois descarta com HAVING. Nesse caso, a opção com WHERE é claramente melhor por não desperdiçar recursos.
Perceba que aqui não se trata de limitar o conjunto final, mas sim a quantidade intermediária de registros dentro da query.
Observação: WHERE impõe condição sobre linhas individuais; HAVING impõe condição sobre agregações ou resultados de seleção (como MIN, MAX, SUM etc.) produzidos a partir de múltiplas linhas.
Como deu para ver, avaliar qualidade, escrever e reescrever consultas não é trivial quando buscamos máxima performance. Evitar antipadrões e considerar alternativas faz parte da sua responsabilidade ao rodar queries em ambientes profissionais.
Esta lista trouxe um panorama para iniciantes. Para ver o que desenvolvedores mais experientes consideram antipadrões frequentes, confira esta discussão.
Um ponto implícito nos antipadrões acima é a diferença entre construir consultas de forma baseada em conjuntos ou de forma procedural.
A abordagem procedural se parece com programação: você diz ao sistema o que fazer e como fazer.
Exemplos incluem condições redundantes em joins ou abuso de HAVING, executar uma função e depois outra, ou usar lógica com laços, condições, UDFs, cursores etc. Nessa abordagem, você costuma pedir um subconjunto, depois outro, e assim por diante.
Não à toa, é chamada de “passo a passo” ou “linha a linha”.
Na abordagem baseada em conjuntos, você só especifica o que deseja. Seu papel é definir condições e requisitos do resultado; o “como” fica a cargo dos mecanismos internos do banco, que escolhem os melhores algoritmos e a lógica de processamento.
Como SQL é baseado em conjuntos, essa abordagem tende a ser mais eficiente e explica por que, às vezes, SQL é mais rápido do que código.
Dica grandes empregadores na área de dados esperam que você domine a abordagem baseada em conjuntos! Você vai alternar entre as duas.
Observação: se cair em uma query procedural, considere reescrever/refatorar.
Como antipadrões mudam com a sua experiência e há muito a considerar nas alternativas, evitar antipadrões e reescrever consultas pode ser desafiador. Toda ajuda é bem-vinda — e uma abordagem mais estruturada com ferramentas pode ser o melhor caminho.
Observação: alguns antipadrões citados têm raiz em performance, como os operadores AND, OR e NOT e o não uso de índices. Pensar em performance exige método e profundidade.
Essa abordagem estruturada e profunda se baseia no plano de execução, que, como vimos, é o resultado após a consulta ser analisada e define exatamente quais algoritmos e coordenação de operações serão usados.
Como vimos, pode ser necessário examinar e ajustar manualmente os planos produzidos pelo otimizador. Nesses casos, você analisa novamente sua query olhando o plano de execução.
Para obtê-lo, use as ferramentas do seu sistema gerenciador de banco. Entre elas:
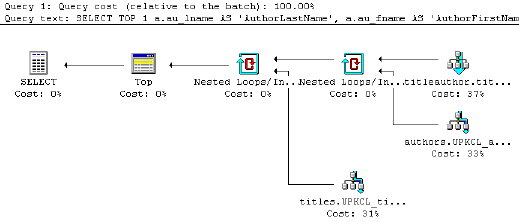
EXPLAIN PLAN; em outros RDBMS, você encontra EXPLAIN (MySQL, PostgreSQL) ou EXPLAIN QUERY PLAN (SQLite).Observação: no PostgreSQL, EXPLAIN descreve como o planejador pretende executar a consulta sem rodá-la, enquanto EXPLAIN ANALYZE executa e compara plano estimado versus real. Em geral, o plano real (com a query executada) é mais útil por trazer detalhes e estatísticas do que de fato aconteceu.
A seguir, você verá EXPLAIN e ANALYZE na prática para entender o plano e a possível performance. Usaremos duas tabelas: one_million e half_million.
Você pode inspecionar informações atuais da tabela one_million com EXPLAIN; coloque-o antes da query para ver o plano:
EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18584.82 rows=1025082 width=36)(1 row)Nesse caso, o custo é 0.00..18584.82, o número de linhas 1025082 e a largura (colunas) 36.
Você pode atualizar as estatísticas com ANALYZE:
ANALYZE one_million;EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(1 row)Além de EXPLAIN e ANALYZE, obtenha o tempo real de execução com EXPLAIN ANALYZE:
EXPLAIN ANALYZESELECT *FROM one_million;QUERY PLAN___________________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(actual time=0.015..1207.019 rows=1000000 loops=1)Total runtime: 2320.146 ms(2 rows)O lado negativo de EXPLAIN ANALYZE é que a query é executada — cuidado!
Até agora, vimos o algoritmo Seq Scan (varredura sequencial ou full table scan): cada linha é lida em ordem e verifica-se se atende à condição. Em termos de performance, não é o melhor plano, pois varre a tabela inteira. Mas nem sempre é ruim: quando a tabela não cabe em memória, leituras sequenciais são rápidas, mesmo em discos lentos.
Falaremos mais disso ao tratar de index scan.
Há outros algoritmos. Veja este plano de um join:
EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN_________________________________________________________________Hash Join (cost=15417.00..68831.00 rows=500000 width=42)(actual time=1241.471..5912.553 rows=500000 loops=1)Hash Cond: (one_million.counter = half_million.counter) -> Seq Scan on one_million (cost=0.00..18334.00 rows=1000000 width=37) (actual time=0.007..1254.027 rows=1000000 loops=1) -> Hash (cost=7213.00..7213.00 rows=500000 width=5) (actual time=1241.251..1241.251 rows=500000 loops=1) Buckets: 4096 Batches: 16 Memory Usage: 770kB -> Seq Scan on half_million (cost=0.00..7213.00 rows=500000 width=5)(actual time=0.008..601.128 rows=500000 loops=1)Total runtime: 6468.337 msO otimizador escolheu um Hash Join. Guarde essa informação: ela ajuda a estimar a complexidade de tempo. Note que não há índice em half_million.counter. Vamos criá-lo:
CREATE INDEX ON half_million(counter);EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN________________________________________________________________Merge Join (cost=4.12..37650.65 rows=500000 width=42)(actual time=0.033..3272.940 rows=500000 loops=1)Merge Cond: (one_million.counter = half_million.counter) -> Index Scan using one_million_counter_idx on one_million (cost=0.00..32129.34 rows=1000000 width=37) (actual time=0.011..694.466 rows=500001 loops=1) -> Index Scan using half_million_counter_idx on half_million (cost=0.00..14120.29 rows=500000 width=5)(actual time=0.010..683.674 rows=500000 loops=1)Total runtime: 3833.310 ms(5 rows)Ao criar o índice, o otimizador passou a usar Merge join com Index Scans.
Observação: no index scan, o banco percorre páginas de dados/índice para achar os registros; no full table scan, ele varre linha a linha.
O tempo total caiu e a performance melhorou, mas há dois index scans — memória passa a pesar, especialmente se a tabela não couber em RAM. Nesses casos, faz-se um full index scan (leituras sequenciais rápidas), mas depois há muitas leituras aleatórias para buscar linhas por valor de índice, que são muito mais lentas. Aí, o full table scan pode ser mais rápido que o full index scan.
Com o plano em mãos, podemos pensar em performance em termos formais usando teoria da complexidade. Em vez de classificar “dificuldade”, no caso de queries olhamos o tempo para executar e retornar resultados — a complexidade de tempo — medida pela notação Big O.
Com Big O, você expressa o tempo de execução em função de como ele cresce conforme o input aumenta. Ignoramos constantes e termos de ordem inferior para focar no que importa: a taxa de crescimento. Desse modo, descrevemos a complexidade assintoticamente (input indo ao infinito).
No contexto de bancos, a complexidade mede quanto a execução cresce conforme as tabelas — e o banco — aumentam.
Observação: o tamanho do banco cresce não só com mais dados nas tabelas, mas também com a presença de índices.
O plano define, entre outras coisas, quais algoritmos são usados em cada operação. Assim, o tempo de execução pode ser expresso como função do tamanho das tabelas envolvidas — a função de complexidade. Em outras palavras, você pode usar Big O e o plano para estimar a complexidade e a performance.
Nas seções seguintes, veja quatro tipos gerais de complexidade e exemplos de como a complexidade varia conforme o contexto.
Dica: índices fazem parte dessa história!
Observação: existem diferentes tipos de índices, planos e implementações em cada banco; as complexidades abaixo são gerais e podem variar conforme o seu cenário.
Um algoritmo roda em tempo constante se leva o mesmo tempo independentemente do tamanho do input. Para uma query, isso significa tempo igual, não importa o tamanho da tabela.
Não é comum, mas aqui vai um exemplo:
SELECT TOP 1 t.* FROM tA complexidade é constante porque você seleciona uma linha arbitrária. O tempo independe do tamanho.
Tempo linear significa que a execução é proporcional ao tamanho do input. Em bancos, proporcional ao tamanho da tabela: conforme cresce o número de linhas, cresce o tempo.
Exemplo: uma query com WHERE em coluna sem índice exige full table scan (Seq Scan) e terá O(n). Cada linha precisa ser lida.
Outro exemplo de O(n) sem índice em i_id:
SELECT i_id FROM item;COUNT(*) FROM TABLE; também tendem a ser O(n), a menos que a contagem total esteja armazenada — aí poderia ser O(1).Relacionado ao tempo linear estão planos com joins. Exemplos:
Lembre: nest loop compara cada registro de uma tabela com cada registro da outra.
Tempo logarítmico significa execução proporcional ao log do input. Em queries, proporcional ao log do tamanho do banco/tabela.
Isso vale para planos com Index Scan ou varredura de índice clusterizado. Em um índice clusterizado, o nível folha contém as linhas de dados reais. Um index scan clusterizado varre a estrutura do índice de cima a baixo até as linhas desejadas.
Exemplo com índice em i_id — geralmente O(log n):
SELECT i_stock FROM item WHERE i_id = N; Observação: sem índice, seria O(n).
Tempo quadrático cresce com o quadrado do tamanho do input. Em bancos, execução proporcional ao quadrado do tamanho do banco/tabela.
Um exemplo possível:
SELECT * FROM item, author WHERE item.i_a_id=author.a_id A complexidade mínima seria O(n log n), mas a máxima pode chegar a O(n^2), dependendo de índices nas chaves de junção.
Para resumir, consulte este cheat sheet para estimar performance de acordo com a complexidade:
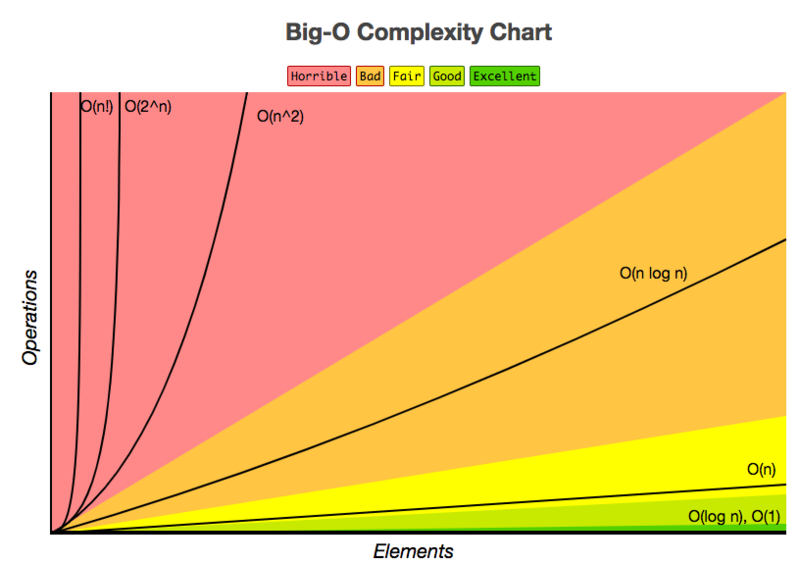
Com o plano de execução e a complexidade em mente, você pode ajustar ainda mais suas consultas. Foque em:
Parabéns! Você chegou ao fim deste post, com uma visão prática sobre performance de consultas SQL. Esperamos que agora você entenda melhor antipadrões, o otimizador e as ferramentas para revisar, estimar e interpretar a complexidade do seu plano. Há muito mais para explorar! Se quiser ir além, leia “Database Management Systems”, de R. Ramakrishnan e J. Gehrke.
Para fechar, uma citação de um usuário do StackOverflow:
“Meu antipadrão favorito é não testar suas consultas.
Isso se aplica quando:
- Sua consulta envolve mais de uma tabela.
- Você acha que tem um design ótimo, mas não testa suas suposições.
- Você aceita a primeira query que funciona, sem a menor ideia se ela está perto do ideal."
Se quer começar com SQL, experimente estes cursos da DataCamp:
Saiba mais sobre SQL
Curso
blog
Summer Worsley
13 min
Tutorial
Sejal Jaiswal
15 min
Tutorial
DataCamp Team
3 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Javier Canales Luna
15 min