कोर्स
SQL में Data Manipulation
4 घंटा
336.7K
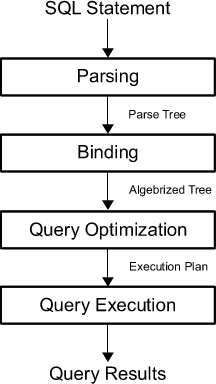
अपनी SQL क्वेरी का प्रदर्शन सुधारने के लिए, आपको पहले यह जानना होगा कि जब आप क्वेरी चलाने के लिए शॉर्टकट दबाते हैं तो अंदर क्या होता है।
सबसे पहले, क्वेरी को एक “पार्स ट्री” में पार्स किया जाता है; क्वेरी का विश्लेषण किया जाता है ताकि देखा जा सके कि क्या यह सिंटैक्स और सिमैंटिक्स आवश्यकताओं को पूरा करती है। पार्सर इनपुट क्वेरी का एक आंतरिक प्रतिनिधित्व बनाता है। यह आउटपुट फिर रीराइट इंजन को भेज दिया जाता है।
इसके बाद ऑप्टिमाइज़र का कार्य दी गई क्वेरी के लिए इष्टतम एक्ज़िक्यूशन या क्वेरी प्लान खोजना है। एक्ज़िक्यूशन प्लान यह परिभाषित करता है कि प्रत्येक ऑपरेशन के लिए कौन सा एल्गोरिथ्म इस्तेमाल होगा और ऑपरेशनों के निष्पादन का समन्वय कैसे होगा।
वास्तव में सबसे इष्टतम प्लान खोजने के लिए, ऑप्टिमाइज़र सभी संभावित प्लानों को सूचीबद्ध करता है, प्रत्येक प्लान की गुणवत्ता या लागत निर्धारित करता है, वर्तमान डेटाबेस स्थिति की जानकारी लेता है, और फिर सर्वश्रेष्ठ प्लान को अंतिम एक्ज़िक्यूशन प्लान के रूप में चुनता है। क्योंकि क्वेरी ऑप्टिमाइज़र हमेशा परिपूर्ण नहीं होते, डेटाबेस उपयोगकर्ता और प्रशासक कभी-कभी बेहतर प्रदर्शन पाने के लिए ऑप्टिमाइज़र द्वारा बनाए गए प्लानों की मैन्युअल जाँच और ट्यूनिंग करते हैं।
अब आप सोच रहे होंगे कि “अच्छा क्वेरी प्लान” किसे माना जाए।
जैसा कि आपने पढ़ा, प्लान की लागत/गुणवत्ता एक बड़ा कारक है। विशेष रूप से, प्लान का मूल्यांकन करने के लिए आवश्यक डिस्क I/O की संख्या, CPU लागत, डेटाबेस क्लाइंट द्वारा देखे जाने वाला रिस्पॉन्स टाइम, और कुल एक्ज़िक्यूशन समय—ये सभी महत्वपूर्ण हैं। यहीं समय जटिलता का विचार काम आता है। इसके बारे में आप आगे और पढ़ेंगे।
इसके बाद, चयनित क्वेरी प्लान को सिस्टम के एक्ज़िक्यूशन इंजन द्वारा चलाया और मूल्यांकित किया जाता है, और आपकी क्वेरी के परिणाम लौटाए जाते हैं।
पिछले खंड से जो बात स्पष्ट नहीं हुई होगी, वह है कि गार्बेज इन, गार्बेज आउट (GIGO) सिद्धांत स्वाभाविक रूप से क्वेरी प्रोसेसिंग और एक्ज़िक्यूशन में उभरता है: जो व्यक्ति क्वेरी बनाता है, वही आपकी SQL क्वेरियों के प्रदर्शन की चाबी भी रखता है। यदि ऑप्टिमाइज़र को खराब ढंग से तैयार की गई क्वेरी मिलती है, तो वह सीमित ही सुधार कर पाएगा।
इसका मतलब है कि क्वेरी लिखते समय कुछ चीजें आप कर सकते हैं। जैसा कि आपने परिचय में देखा, ज़िम्मेदारी दोहरी है: यह केवल मानक के अनुरूप क्वेरियाँ लिखने तक सीमित नहीं है, बल्कि यह भी समझना है कि आपकी क्वेरी में प्रदर्शन संबंधी समस्याएँ कहाँ छिपी हो सकती हैं।
एक आदर्श शुरुआती बिंदु यह है कि अपनी क्वेरियों में ऐसे “स्पॉट्स” सोचें जहाँ समस्याएँ घुस सकती हैं। सामान्यतः, चार क्लॉज़ और कीवर्ड ऐसे हैं जहाँ नए उपयोगकर्ता प्रदर्शन संबंधी समस्याओं की उम्मीद कर सकते हैं:
WHERE क्लॉज़;INNER JOIN या LEFT JOIN कीवर्ड; और,HAVING क्लॉज़;मान्य है, यह दृष्टिकोण सरल और भोला है, पर शुरुआती लोगों के लिए ये क्लॉज़ और स्टेटमेंट्स उत्कृष्ट संकेतक हैं, और यह कहना सुरक्षित है कि शुरुआती चरण में गलतियाँ अक्सर यहीं होती हैं और विडंबना यह कि इन्हें पहचानना भी यहीं मुश्किल पड़ता है।
हालाँकि, आपको यह भी समझना चाहिए कि प्रदर्शन संदर्भ पर निर्भर होकर ही अर्थपूर्ण होता है: केवल यह कहना कि ये क्लॉज़ और कीवर्ड खराब हैं—SQL प्रदर्शन के संदर्भ में सही दृष्टिकोण नहीं है। आपकी क्वेरी में WHERE या HAVING क्लॉज़ होना आवश्यक रूप से खराब क्वेरी नहीं बनाता।
अगले खंड को देखें ताकि एंटी-पैटर्न्स और अपनी SQL क्वेरी बनाने के वैकल्पिक तरीकों के बारे में और जान सकें। ये टिप्स और ट्रिक्स मार्गदर्शक हैं। आपको वास्तव में क्वेरी फिर से लिखने की ज़रूरत है या नहीं—यह डेटा की मात्रा, डेटाबेस, और क्वेरी चलाने की आवृत्ति सहित कई बातों पर निर्भर करता है। यह पूरी तरह आपकी क्वेरी के उद्देश्य पर निर्भर करता है, और जिस डेटाबेस पर क्वेरी करनी है उसके बारे में पूर्व-ज्ञान होना अत्यंत महत्वपूर्ण है!
“जितना अधिक डेटा, उतना बेहतर” वाली सोच SQL क्वेरियाँ लिखते समय हमेशा सही नहीं होती: न केवल आप ज़रूरत से ज़्यादा डेटा लेकर अपनी अंतर्दृष्टि धुंधली कर सकते हैं, बल्कि बहुत अधिक डेटा खींचने से आपकी क्वेरी का परफॉर्मेंस भी गिर सकता है।
इसीलिए सामान्यतः SELECT स्टेटमेंट, DISTINCT क्लॉज़ और LIKE ऑपरेटर पर नज़र रखना अच्छा विचार है।
SELECT स्टेटमेंटक्वेरी लिखते ही सबसे पहले देखें कि SELECT स्टेटमेंट यथासंभव कॉम्पैक्ट है या नहीं। लक्ष्य यह होना चाहिए कि SELECT से अनावश्यक कॉलम हटाएँ। इस तरह आप खुद को केवल वही डेटा खींचने के लिए बाध्य करेंगे जो आपकी क्वेरी के उद्देश्य की पूर्ति करता है।
यदि आपके पास EXISTS वाले कोरिलेटेड सबक्वेरियाँ हैं, तो उस सबक्वेरी के SELECT स्टेटमेंट में किसी वास्तविक कॉलम का मान चुनने के बजाय एक कॉन्स्टैंट का उपयोग करने का प्रयास करें। यह विशेष रूप से तब उपयोगी है जब आप सिर्फ अस्तित्व की जाँच कर रहे हों।
याद रखें कि कोरिलेटेड सबक्वेरी वह होती है जो आउटर क्वेरी के मानों का उपयोग करती है। और ध्यान दें कि हालाँकि NULL इस संदर्भ में “कॉन्स्टैंट” की तरह काम कर सकता है, यह बहुत भ्रमित करने वाला होता है!
कॉन्स्टैंट का उपयोग करने का अर्थ समझने के लिए नीचे दिया उदाहरण देखें:
SELECT driverslicensenr, name FROM Drivers WHERE EXISTS (SELECT '1' FROM Fines WHERE fines.driverslicensenr = drivers.driverslicensenr);टिप: यह जानना उपयोगी है कि कोरिलेटेड सबक्वेरी रखना हमेशा अच्छा विचार नहीं होता। आप उन्हें हटाने पर विचार कर सकते हैं, उदाहरण के लिए, उन्हें INNER JOIN के साथ फिर से लिखकर:
SELECT driverslicensenr, name FROM drivers INNER JOIN fines ON fines.driverslicensenr = drivers.driverslicensenr; DISTINCT क्लॉज़SELECT DISTINCT स्टेटमेंट का उपयोग केवल भिन्न (अलग) मान लौटाने के लिए किया जाता है। यदि संभव हो तो DISTINCT से बचने का प्रयास अवश्य करें। जैसा कि आप अन्य उदाहरणों में पढ़ चुके हैं, इस क्लॉज़ को जोड़ने से एक्ज़िक्यूशन टाइम बढ़ता है। इसलिए हमेशा यह सोचना अच्छा है कि क्या वाकई आपको मनचाहा परिणाम पाने के लिए इस DISTINCT ऑपरेशन की आवश्यकता है।
LIKE ऑपरेटरजब आप क्वेरी में LIKE ऑपरेटर का उपयोग करते हैं, तो यदि पैटर्न % या _ से शुरू होता है तो इंडेक्स का उपयोग नहीं होता। यह डेटाबेस को इंडेक्स (यदि मौजूद हो) का उपयोग करने से रोक देगा। निश्चित रूप से, दूसरे दृष्टिकोण से यह भी तर्क दिया जा सकता है कि इस प्रकार की क्वेरी आपके लक्ष्य से असंबंधित बहुत सारे रिकॉर्ड्स भी ला सकती है।
एक बार फिर, डेटाबेस में स्टोर किए गए डेटा का आपका ज्ञान आपको ऐसा पैटर्न गढ़ने में मदद करेगा जो ठीक से फ़िल्टर कर केवल वही पंक्तियाँ निकाले जो आपकी क्वेरी के लिए वाकई मायने रखती हैं।
जब SELECT स्टेटमेंट को फ़िल्टर करना अवश्यम्भावी हो, तो परिणाम सीमित करने के अन्य तरीकों पर विचार करें। यहाँ LIMIT क्लॉज़ और डेटा टाइप कन्वर्शन जैसी विधियाँ काम आती हैं।
TOP, LIMIT और ROWNUM क्लॉज़आप अपनी क्वेरियों में LIMIT या TOP क्लॉज़ जोड़कर रिज़ल्ट सेट की अधिकतम पंक्तियाँ निर्धारित कर सकते हैं। उदाहरण:
SELECT TOP 3 * FROM Drivers;नोट: आप PERCENT भी निर्दिष्ट कर सकते हैं, जैसे यदि आप क्वेरी की पहली पंक्ति को SELECT TOP 50 PERCENT * से बदल दें।
SELECT driverslicensenr, name FROM Drivers LIMIT 2;इसके अलावा, आप ROWNUM क्लॉज़ भी जोड़ सकते हैं, जो आपकी क्वेरी में LIMIT के समतुल्य है:
SELECT *FROM DriversWHERE driverslicensenr = 123456 AND ROWNUM <= 3;हमेशा सबसे कुशल—यानी सबसे छोटे—डेटा टाइप्स का उपयोग करें। जहाँ छोटा टाइप पर्याप्त हो, वहाँ बहुत बड़ा टाइप देना जोखिम भरा है।
लेकिन, जब आप क्वेरी में डेटा टाइप कन्वर्शन जोड़ते हैं, तो एक्ज़िक्यूशन टाइम बढ़ता ही है।
विकल्प यह है कि डेटा टाइप कन्वर्शन से यथासंभव बचें। यहाँ भी ध्यान दें कि कन्वर्शन को हमेशा हटाना संभव नहीं होता, पर आपको इन्हें शामिल करते समय सावधान रहना चाहिए और जब करें, तो क्वेरी चलाने से पहले उसके प्रभाव का परीक्षण अवश्य करें।
डेटा टाइप कन्वर्शन अगली बात की ओर ले जाते हैं: अपनी क्वेरियों को ओवर-इंजीनियर न करें। उन्हें सरल और कुशल रखने की कोशिश करें। यह टिप बहुत सरल या मूर्खतापूर्ण लग सकती है, खासकर क्योंकि क्वेरियाँ जटिल हो सकती हैं।
हालाँकि, आप आगे के उदाहरणों में देखेंगे कि कैसे सरल क्वेरियों को अनावश्यक रूप से जटिल बनाना आसान है।
OR ऑपरेटरजब आप अपनी क्वेरी में OR ऑपरेटर का उपयोग करते हैं, तो संभावना है कि आप इंडेक्स का उपयोग नहीं कर रहे हैं।
याद रखें कि इंडेक्स एक डेटा संरचना है जो आपकी डेटाबेस टेबल से डेटा निकालने की गति बढ़ाती है, पर इसकी एक कीमत है: अतिरिक्त राइट्स होंगे और इंडेक्स संरचना को बनाए रखने के लिए अतिरिक्त स्टोरेज स्पेस की आवश्यकता होगी। इंडेक्स का उपयोग बिना हर बार हर पंक्ति खोजे, तुरंत डेटा लोकेट/लुकअप करने के लिए किया जाता है। इंडेक्स एक या अधिक कॉलम्स पर बनाए जा सकते हैं।
यदि आप डेटाबेस में शामिल इंडेक्स का उपयोग नहीं करते, तो आपकी क्वेरी का समय अनिवार्य रूप से बढ़ेगा। इसलिए क्वेरी में OR का उपयोग करने के विकल्प तलाशना बेहतर है;
यह क्वेरी देखें:
SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr = 123456OR driverslicensenr = 678910OR driverslicensenr = 345678;आप ऑपरेटर को इस तरह बदल सकते हैं:
IN वाली कंडीशन; याSELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr IN (123456, 678910, 345678);SELECT स्टेटमेंट्स के साथ UNION।टिप: यहाँ अनावश्यक रूप से UNION का उपयोग न करें क्योंकि आप एक ही टेबल से कई बार गुजरते हैं। साथ ही, UNION का उपयोग करने से एक्ज़िक्यूशन टाइम बढ़ेगा। UNION के विकल्प हैं: क्वेरी को ऐसे फिर से लिखना कि सभी शर्तें एक ही SELECT में आ जाएँ, या UNION की जगह OUTER JOIN का उपयोग।
टिप: ध्यान रखें कि भले ही OR—और आगे बताए जाने वाले अन्य ऑपरेटर—अक्सर इंडेक्स का उपयोग नहीं करते, इंडेक्स लुकअप हमेशा वांछनीय भी नहीं होते!
NOT ऑपरेटरजब आपकी क्वेरी में NOT ऑपरेटर हो, तो OR की तरह ही संभव है कि इंडेक्स का उपयोग न हो। इससे आपकी क्वेरी धीमी हो जाएगी। यदि बात स्पष्ट न हो, तो यह देखें:
SELECT driverslicensenr, nameFROM DriversWHERE NOT (year > 1980);यह क्वेरी आपकी अपेक्षा से धीमी चलेगी, मुख्यतः क्योंकि इसे आवश्यकता से अधिक जटिल तरीके से लिखा गया है: ऐसे मामलों में, विकल्प तलाशना बेहतर है। NOT को तुलना ऑपरेटरों जैसे >, <> या !> से बदलने पर विचार करें; ऊपर का उदाहरण वास्तव में इस प्रकार फिर से लिखा जा सकता है:
SELECT driverslicensenr, nameFROM DriversWHERE year <= 1980;अब यह काफी साफ दिखता है, है ना?
AND ऑपरेटरAND ऑपरेटर भी ऐसा ऑपरेटर है जो इंडेक्स का उपयोग नहीं करता और यदि अत्यधिक जटिल व अल्प-प्रभावी तरीके से इस्तेमाल हो, तो क्वेरी को धीमा कर सकता है, जैसे नीचे:
SELECT driverslicensenr, nameFROM DriversWHERE year >= 1960 AND year <= 1980;इसे BETWEEN ऑपरेटर से फिर लिखना बेहतर है:
SELECT driverslicensenr, nameFROM DriversWHERE year BETWEEN 1960 AND 1980;ANY और ALL ऑपरेटर्सANY और ALL ऑपरेटर्स के साथ भी सावधानी रखें क्योंकि इन्हें शामिल करने पर इंडेक्स का उपयोग नहीं होगा। यहाँ MIN या MAX जैसी एग्रीगेशन फ़ंक्शंस उपयोगी विकल्प हो सकते हैं।
टिप: जहाँ आप प्रस्तावित विकल्पों का उपयोग करते हैं, वहाँ यह जानना ज़रूरी है कि SUM, AVG, MIN, MAX जैसी सभी एग्रीगेशन फ़ंक्शंस—बहुत सी पंक्तियों पर—लंबा समय ले सकती हैं। ऐसे में, या तो हैंडल की जाने वाली पंक्तियों की संख्या कम करें या इन मानों को पूर्व-गणना करें। आप फिर देखते हैं कि वातावरण, क्वेरी का उद्देश्य, … इत्यादि का ज्ञान निर्णय लेने में महत्वपूर्ण है!
जहाँ किसी कॉलम का उपयोग किसी कैलकुलेशन या स्केलर फ़ंक्शन में होता है, वहाँ भी इंडेक्स का उपयोग नहीं होता। एक समाधान यह है कि उस कॉलम को कैलकुलेशन/फ़ंक्शन से अलग कर दें। उदाहरण देखें:
SELECT driverslicensenr, nameFROM DriversWHERE year + 10 = 1980;यह थोड़ा अटपटा लगता है, है ना? इसके बजाय गणना पर पुनर्विचार करें और क्वेरी को इस तरह लिखें:
SELECT driverslicensenr, nameFROM DriversWHERE year = 1970;इस अंतिम टिप का अर्थ है कि क्वेरी को बहुत अधिक प्रतिबंधित करने की कोशिश न करें क्योंकि इससे प्रदर्शन प्रभावित हो सकता है। यह विशेष रूप से जॉइन्स और HAVING क्लॉज़ पर लागू होता है।
जब आप दो टेबल्स को जॉइन करते हैं, तो जॉइन में टेबल्स के क्रम पर विचार करना महत्वपूर्ण हो सकता है। यदि एक टेबल दूसरी की तुलना में काफी बड़ी है, तो क्वेरी को इस तरह लिखना चाहेंगे कि सबसे बड़ी टेबल जॉइन में अंत में आए।
जब आप जॉइन्स पर बहुत अधिक शर्तें जोड़ते हैं, तो आप SQL को एक विशेष रास्ता चुनने के लिए बाध्य करते हैं। हो सकता है कि वह रास्ता हमेशा सबसे परफॉर्मेंट न हो।
HAVING क्लॉज़HAVING क्लॉज़ को मूलतः इसलिए जोड़ा गया क्योंकि WHERE कीवर्ड का उपयोग एग्रीगेट फ़ंक्शंस के साथ नहीं किया जा सकता था। प्रायः HAVING को GROUP BY के साथ इस्तेमाल किया जाता है ताकि लौटाई गई पंक्तियों के समूहों को कुछ शर्तें पूरी करने वालों तक सीमित किया जा सके। लेकिन, यदि आप इस क्लॉज़ का उपयोग करते हैं, तो इंडेक्स का उपयोग नहीं होता—जैसा कि आप जानते हैं—इससे क्वेरी का प्रदर्शन गिर सकता है।
यदि आप विकल्प खोज रहे हैं, तो WHERE क्लॉज़ का उपयोग करने पर विचार करें। ये क्वेरियाँ देखें:
SELECT state, COUNT(*) FROM Drivers WHERE state IN ('GA', 'TX') GROUP BY state ORDER BY stateSELECT state, COUNT(*) FROM Drivers GROUP BY stateHAVING state IN ('GA', 'TX') ORDER BY stateपहली क्वेरी WHERE के साथ उन पंक्तियों की संख्या सीमित करती है जिन्हें जोड़ा जाना है, जबकि दूसरी क्वेरी पूरी टेबल की सभी पंक्तियों का योग करती है और फिर HAVING से अनचाहे योगों को हटा देती है। ऐसे मामलों में WHERE वाला विकल्प स्पष्टतः बेहतर है, क्योंकि आप संसाधन बर्बाद नहीं करते।
देखा आपने—यह परिणाम सेट सीमित करने के बारे में नहीं, बल्कि क्वेरी के भीतर मध्यवर्ती रिकॉर्ड्स की संख्या सीमित करने के बारे में है।
नोट: इन दोनों क्लॉज़ में फर्क यह है कि WHERE व्यक्तिगत पंक्तियों पर शर्त लगाता है, जबकि HAVING एग्रीगेशंस या ऐसे चयन के परिणामों पर शर्त लगाता है जहाँ कई पंक्तियों से MIN, MAX, SUM… जैसा एकल परिणाम निकाला गया हो।
देखा जाए तो, क्वेरियों की गुणवत्ता का मूल्यांकन, लिखना और फिर लिखना आसान नहीं है—खासकर तब जब उन्हें यथासंभव परफॉर्मेंट भी रखना हो; एंटी-पैटर्न्स से बचना और विकल्पों पर विचार करना, पेशेवर माहौल में डेटाबेस पर चलने वाली क्वेरियाँ लिखते समय आपकी ज़िम्मेदारी का हिस्सा है।
यह सूची बस कुछ एंटी-पैटर्न्स और टिप्स का संक्षिप्त अवलोकन थी जो शुरुआती लोगों की मदद करे; यदि आप जानना चाहते हैं कि अधिक अनुभवी डेवलपर्स किन एंटी-पैटर्न्स को सबसे आम मानते हैं, तो यह चर्चा देखें।
ऊपर बताए गए एंटी-पैटर्न्स में जो निहित था, वह यह कि अंततः बात सेट-आधारित और प्रक्रियात्मक दृष्टिकोणों के अंतर पर आ टिकती है।
क्वेरी का प्रक्रियात्मक दृष्टिकोण प्रोग्रामिंग जैसा है: आप सिस्टम को बताते हैं कि क्या करना है और कैसे करना है।
उदाहरण है जॉइन्स में अनावश्यक शर्तें, या ऊपर दिखाए गए HAVING के दुरुपयोग के मामले, जहाँ आप किसी फ़ंक्शन को चलाते हैं और फिर दूसरा फ़ंक्शन बुलाते हैं, या लूप्स, कंडीशन्स, यूज़र डिफ़ाइंड फ़ंक्शंस (UDFs), कर्सर्स, … से युक्त लॉजिक का उपयोग करके अंतिम परिणाम पाते हैं। इस दृष्टिकोण में आप अक्सर पहले डेटा का एक सबसेट माँगते हैं, फिर दूसरा सबसेट, और आगे ऐसे ही।
अचरज नहीं कि इसे अक्सर “स्टेप-बाय-स्टेप” या “रो-बाय-रो” क्वेरिंग कहा जाता है।
दूसरा दृष्टिकोण सेट-आधारित है, जहाँ आप केवल बताते हैं कि क्या करना है। आपकी भूमिका यह बताने तक सीमित है कि आप किस परिणाम सेट के लिए क्या शर्तें/आवश्यकताएँ रखते हैं। डेटा कैसे निकलेगा—यह आप क्वेरी के आंतरिक तंत्र पर छोड़ देते हैं: डेटाबेस इंजन आपकी क्वेरी को चलाने के लिए सर्वश्रेष्ठ एल्गोरिद्म/प्रोसेसिंग लॉजिक चुनता है।
क्योंकि SQL सेट-आधारित है, यह आश्चर्य नहीं कि यह दृष्टिकोण प्रक्रियात्मक की तुलना में अधिक प्रभावी साबित होता है और यह भी समझाता है कि कुछ मामलों में SQL कोड से तेज़ क्यों हो सकता है।
टिप सेट-आधारित क्वेरिंग वह दृष्टिकोण है जिसे डेटा साइंस उद्योग के शीर्ष नियोक्ता आपसे माहिर होने की अपेक्षा रखते हैं! आपको अक्सर इन दोनों के बीच स्विच करना होगा।
नोट: यदि आप कभी खुद को प्रक्रियात्मक क्वेरी के साथ पाते हैं, तो उसे फिर से लिखने/रिफैक्टर करने पर विचार करें।
यह जानते हुए कि एंटी-पैटर्न्स स्थिर नहीं होते और आपके SQL डेवलपर के रूप में बढ़ने के साथ विकसित होते हैं—और यह कि विकल्प सोचते समय बहुत कुछ विचार करना पड़ता है—का मतलब है कि एंटी-पैटर्न्स से बचना और क्वेरियाँ फिर से लिखना कठिन काम हो सकता है। कोई भी मदद उपयोगी होती है, इसलिए कुछ टूल्स के साथ अधिक संरचित तरीके से क्वेरी ऑप्टिमाइज़ करना एक बेहतर मार्ग हो सकता है।
नोट: पिछले खंड में बताए कुछ एंटी-पैटर्न्स की जड़ें प्रदर्शन संबंधी चिंताओं में थीं—जैसे AND, OR और NOT ऑपरेटर्स और इनका इंडेक्स का उपयोग न करना। परफॉर्मेंस पर सोचना केवल अधिक संरचित ही नहीं, बल्कि अधिक गहराई वाला दृष्टिकोण भी मांगता है।
जो भी हो, यह संरचित और गहन दृष्टिकोण प्रायः क्वेरी प्लान पर आधारित होगा, जो—जैसा कि याद है—क्वेरी को “पार्स ट्री” में पार्स करने का परिणाम होता है और यह परिभाषित करता है कि प्रत्येक ऑपरेशन के लिए कौन सा एल्गोरिद्म उपयोग होगा और ऑपरेशनों का निष्पादन कैसे समन्वित होगा।
जैसा कि आपने परिचय में पढ़ा, कभी-कभी आपको ऑप्टिमाइज़र द्वारा बनाए गए प्लानों की मैन्युअल जाँच और ट्यूनिंग करनी पड़ सकती है। ऐसे में, आपको क्वेरी प्लान देखकर अपनी क्वेरी का फिर से विश्लेषण करना होगा।
यह प्लान पाने के लिए, आपको अपने डेटाबेस मैनेजमेंट सिस्टम द्वारा उपलब्ध कराए गए टूल्स का उपयोग करना होगा। कुछ टूल्स जो आपके पास हो सकते हैं:
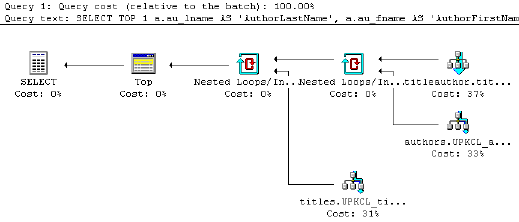
EXPLAIN PLAN स्टेटमेंट है, पर निर्देश का नाम आपके RDBMS के अनुसार बदलता है। अन्यत्र आपको EXPLAIN (MySQL, PostgreSQL) या EXPLAIN QUERY PLAN (SQLite) मिल सकता है।नोट: यदि आप PostgreSQL के साथ काम कर रहे हैं, तो EXPLAIN और EXPLAIN ANALYZE में फर्क है: EXPLAIN केवल यह बताता है कि प्लानर क्वेरी को कैसे चलाने का इरादा रखता है, बिना चलाए; जबकि EXPLAIN ANALYZE वास्तव में क्वेरी चलाता है और अपेक्षित बनाम वास्तविक क्वेरी प्लानों का विश्लेषण लौटाता है। सामान्यतः, वास्तविक एक्ज़िक्यूशन प्लान वह है जहाँ आप सच में क्वेरी चलाते हैं, जबकि अनुमानित प्लान बिना चलाए बताता है कि क्या होगा। तार्किक रूप से समकक्ष होने पर भी, वास्तविक प्लान अधिक उपयोगी होता है क्योंकि इसमें निष्पादन के दौरान वास्तव में क्या हुआ—इसकी अतिरिक्त जानकारियाँ और आँकड़े होते हैं।
आगे के भाग में, आप EXPLAIN और ANALYZE के बारे में और सीखेंगे और कैसे इनसे क्वेरी प्लान व संभावित परफॉर्मेंस के बारे में समझ पाएँ। इसके लिए, कुछ उदाहरणों से शुरुआत करेंगे जिनमें आप दो टेबल्स: one_million और half_million के साथ काम करेंगे।
one_million टेबल की वर्तमान जानकारी आप EXPLAIN की मदद से पा सकते हैं; इसे अपनी क्वेरी के सबसे ऊपर रखें, और चलाने पर यह आपको क्वेरी प्लान लौटाएगा:
EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18584.82 rows=1025082 width=36)(1 row)यहाँ आप देखते हैं कि क्वेरी की लागत 0.00..18584.82 है और पंक्तियों की संख्या 1025082 है। कॉलम चौड़ाई 36 है।
आप ANALYZE की मदद से अपने सांख्यिकीय जानकारी को नवीकृत भी कर सकते हैं।
ANALYZE one_million;EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(1 row)EXPLAIN और ANALYZE के अलावा, आप EXPLAIN ANALYZE से वास्तविक एक्ज़िक्यूशन टाइम भी प्राप्त कर सकते हैं:
EXPLAIN ANALYZESELECT *FROM one_million;QUERY PLAN___________________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(actual time=0.015..1207.019 rows=1000000 loops=1)Total runtime: 2320.146 ms(2 rows)EXPLAIN ANALYZE का यहाँ नुकसान स्पष्ट है—क्वेरी वास्तव में चलती है, तो सावधान रहें!
अब तक आपने जो एल्गोरिद्म देखा है वह Seq Scan (Sequential Scan) या फुल टेबल स्कैन है: इसमें टेबल की हर पंक्ति क्रमवार पढ़ी जाती है और पाए गए कॉलम्स को शर्त पूरी होने के लिए जाँचा जाता है। परफॉर्मेंस की दृष्टि से, Sequential Scan सर्वश्रेष्ठ नहीं है क्योंकि आप अभी भी फुल टेबल स्कैन कर रहे हैं। फिर भी, जब टेबल मेमोरी में फिट नहीं होती, तब यह बुरा नहीं—सीक्वेंशियल रीड्स धीमी डिस्क पर भी तेज़ चलती हैं।
इंडेक्स स्कैन पर बात करते समय आप इसे आगे और देखेंगे।
हालाँकि अन्य एल्गोरिद्म भी हैं। उदाहरण के लिए यह जॉइन का क्वेरी प्लान देखें:
EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN_________________________________________________________________Hash Join (cost=15417.00..68831.00 rows=500000 width=42)(actual time=1241.471..5912.553 rows=500000 loops=1)Hash Cond: (one_million.counter = half_million.counter) -> Seq Scan on one_million (cost=0.00..18334.00 rows=1000000 width=37) (actual time=0.007..1254.027 rows=1000000 loops=1) -> Hash (cost=7213.00..7213.00 rows=500000 width=5) (actual time=1241.251..1241.251 rows=500000 loops=1) Buckets: 4096 Batches: 16 Memory Usage: 770kB -> Seq Scan on half_million (cost=0.00..7213.00 rows=500000 width=5)(actual time=0.008..601.128 rows=500000 loops=1)Total runtime: 6468.337 msआप देखते हैं कि क्वेरी ऑप्टिमाइज़र ने यहाँ Hash Join चुना! इसे याद रखें—आपको क्वेरी की समय जटिलता का अनुमान लगाने में यह काम आएगा। फिलहाल ध्यान दें कि half_million.counter पर कोई इंडेक्स नहीं है, जिसे आप अगले उदाहरण में जोड़ सकते हैं:
CREATE INDEX ON half_million(counter);EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN________________________________________________________________Merge Join (cost=4.12..37650.65 rows=500000 width=42)(actual time=0.033..3272.940 rows=500000 loops=1)Merge Cond: (one_million.counter = half_million.counter) -> Index Scan using one_million_counter_idx on one_million (cost=0.00..32129.34 rows=1000000 width=37) (actual time=0.011..694.466 rows=500001 loops=1) -> Index Scan using half_million_counter_idx on half_million (cost=0.00..14120.29 rows=500000 width=5)(actual time=0.010..683.674 rows=500000 loops=1)Total runtime: 3833.310 ms(5 rows)आप देखते हैं कि इंडेक्स बनाने से ऑप्टिमाइज़र अब Merge join पर गया है जहाँ Index Scan हो रहे हैं।
नोट: इंडेक्स स्कैन और फुल टेबल/सीक्वेंशियल स्कैन का अंतर—पहला, जिसे “टेबल स्कैन” भी कहते हैं, उपयुक्त रिकॉर्ड्स खोजने के लिए डेटा या इंडेक्स पेजेस स्कैन करता है, जबकि दूसरा टेबल की हर पंक्ति स्कैन करता है।
कुल रनटाइम घटा है और परफॉर्मेंस बेहतर होना चाहिए, पर यहाँ दो इंडेक्स स्कैन हैं, जिससे मेमोरी का महत्त्व बढ़ जाता है—खासकर यदि टेबल मेमोरी में फिट नहीं होती। ऐसे मामलों में, पहले फुल इंडेक्स स्कैन करते हैं—ये तेज़ सीक्वेंशियल रीड्स हैं—पर फिर इंडेक्स वैल्यू से पंक्तियाँ लाने के लिए बहुत से रैंडम रीड्स होते हैं। यही रैंडम रीड्स आमतौर पर सीक्वेंशियल रीड्स से कई गुना धीमे होते हैं। ऐसे मामलों में फुल टेबल स्कैन वास्तव में फुल इंडेक्स स्कैन से तेज़ होता है।
अब जब आपने क्वेरी प्लान का संक्षिप्त परीक्षण कर लिया, तो आप कम्प्यूटेशनल कॉम्प्लेक्सिटी थ्योरी की मदद से प्रदर्शन के बारे में अधिक औपचारिक रूप से सोचना शुरू कर सकते हैं। यह सैद्धांतिक कंप्यूटर विज्ञान का क्षेत्र है जो अन्य बातों के साथ कम्प्यूटेशनल समस्याओं को उनकी कठिनाई के अनुसार वर्गीकृत करता है; ये समस्याएँ एल्गोरिद्म हो सकती हैं, क्वेरियाँ भी।
लेकिन क्वेरियों के लिए, आप उन्हें कठिनाई के अनुसार नहीं, बल्कि उन्हें चलाने और परिणाम पाने में लगने वाले समय के अनुसार वर्गीकृत करते हैं। इसे समय जटिलता कहा जाता है और इसे व्यक्त/मापा जाता है बिग O नोटेशन से।
बिग O से आप रनटाइम को इस रूप में व्यक्त करते हैं कि इनपुट के मनमाने रूप से बड़ा होने पर यह कितनी तेज़ी से बढ़ता है। बिग O गुणांक और निम्न-क्रम के पदों को निकाल देता है ताकि आप अपनी क्वेरी के रनिंग टाइम के महत्वपूर्ण भाग—उसकी वृद्धि दर—पर फोकस कर सकें। इस तरह—गुणांक और निम्न-क्रम के पदों को हटा कर—वर्णित समय जटिलता को असिंप्टोटिक कहा जाता है। यानी इनपुट आकार अनंत की ओर जाता है।
डेटाबेस भाषा में, जटिलता मापती है कि जैसे-जैसे टेबल्स का आकार—और इसलिए डेटाबेस—बढ़ता है, क्वेरी चलने में कितना अधिक समय लगता है।
नोट: आपका डेटाबेस आकार केवल इसलिए नहीं बढ़ता कि टेबल्स में अधिक डेटा है, बल्कि इंडेक्स की उपस्थिति भी आकार बढ़ाती है।
जैसा कि आपने देखा, एक्ज़िक्यूशन प्लान यह भी बताता है कि प्रत्येक ऑपरेशन के लिए कौन सा एल्गोरिद्म उपयोग होगा—इससे हर क्वेरी का एक्ज़िक्यूशन टाइम क्वेरी प्लान में शामिल टेबल साइज का एक फ़ंक्शन के रूप में व्यक्त किया जा सकता है—इसे कॉम्प्लेक्सिटी फ़ंक्शन कहते हैं। दूसरे शब्दों में, आप बिग O नोटेशन और अपने एक्ज़िक्यूशन प्लान का उपयोग करके क्वेरी कॉम्प्लेक्सिटी और परफॉर्मेंस का अनुमान लगा सकते हैं।
निम्न उपखंडों में आप समय जटिलताओं के चार प्रकारों का सामान्य विचार पाएँगे और देखेंगे कि संदर्भ के अनुसार क्वेरियों की समय जटिलता कैसे बदल सकती है।
संकेत: यहाँ इंडेक्स कहानी का हिस्सा हैं!
नोट: अलग-अलग तरह के इंडेक्स, अलग-अलग एक्ज़िक्यूशन प्लान और विभिन्न डेटाबेसों के अलग इम्प्लीमेंटेशन होते हैं—इसलिए नीचे दी गई समय जटिलताएँ बहुत सामान्य हैं और आपकी विशिष्ट सेटिंग के अनुसार भिन्न हो सकती हैं।
किसी एल्गोरिद्म को कॉन्स्टैंट टाइम कहा जाता है यदि इनपुट आकार चाहे जो हो, उसे समान समय लगता है। क्वेरी के लिए, वह तब कॉन्स्टैंट टाइम में चलेगी जब टेबल के आकार से स्वतंत्र होकर समान समय ले।
ऐसी क्वेरियाँ बहुत आम नहीं हैं, फिर भी एक उदाहरण:
SELECT TOP 1 t.* FROM tटाइम कॉम्प्लेक्सिटी कॉन्स्टैंट है क्योंकि आप टेबल से कोई एक मनमाना रो चुनते हैं। अतः समय की लंबाई टेबल साइज से स्वतंत्र रहनी चाहिए।
किसी एल्गोरिद्म का समय यदि इनपुट साइज के सीधे अनुपात में बढ़ता है—तो वह लिनियर टाइम है। डेटाबेस के लिए, समय टेबल साइज के अनुपात में होगा: जैसे-जैसे रो बढ़ेंगी, क्वेरी टाइम बढ़ेगा।
उदाहरण है बिना इंडेक्स वाले कॉलम पर WHERE वाली क्वेरी: फुल टेबल स्कैन या Seq Scan लगेगा, जिसकी समय जटिलता O(n) होगी। यानी हर रो पढ़नी होगी ताकि सही ID मिल सके। कोई लिमिट नहीं है, तो पहली रो ही मिल जाए तब भी सभी रो पढ़नी पड़ेंगी।
यह उदाहरण भी देखें, जिसमें यदि i_id पर इंडेक्स नहीं है तो जटिलता O(n) होगी:
SELECT i_id FROM item;COUNT(*) FROM TABLE; जैसी काउंट क्वेरियाँ भी—जब तक टेबल का कुल रो काउंट स्टोर न हो—O(n) होंगी। यदि काउंट संग्रहीत हो, तो जटिलता O(1) के जैसी होगी।लिनियर समय से निकटता से संबंधित हैं जॉइन्स वाले प्लानों के समय। उदाहरण:
याद रखें: नेस्टेड जॉइन वह है जो एक टेबल की हर रिकॉर्ड की तुलना दूसरी की हर रिकॉर्ड से करता है।
किसी एल्गोरिद्म का समय यदि इनपुट साइज के लॉगरिद्म के अनुपात में बढ़ता है, तो वह लॉगारिथमिक टाइम है; क्वेरियों के लिए इसका अर्थ है कि एक्ज़िक्यूशन टाइम डेटाबेस साइज के लॉगरिद्म के अनुपात में होगा।
यह लॉगारिथमिक जटिलता उन प्लानों पर लागू है जहाँ Index Scan या क्लस्टर्ड इंडेक्स स्कैन होता है। क्लस्टर्ड इंडेक्स में इंडेक्स का लीफ लेवल वास्तविक डेटा रोज़ रखता है। क्लस्टर्ड किसी अन्य इंडेक्स जैसा ही है—एक या अधिक कॉलम्स पर परिभाषित—जो इंडेक्स की बनते हैं। क्लस्टरिंग की वही की कॉलम्स हैं। क्लस्टर्ड इंडेक्स स्कैन मूलतः RDBMS का क्लस्टर्ड इंडेक्स में ऊपर से नीचे पढ़ना है।
यह क्वेरी देखें, जहाँ i_id पर इंडेक्स है—सामान्यतः जटिलता O(log(n)):
SELECT i_stock FROM item WHERE i_id = N; नोट: इंडेक्स न होने पर जटिलता O(n) होती।
किसी एल्गोरिद्म का समय यदि इनपुट साइज के वर्ग के अनुपात में बढ़ता है, तो वह क्वाड्रैटिक टाइम है। डेटाबेस के लिए, क्वेरी का समय डेटाबेस साइज के वर्ग के अनुपात में होगा।
क्वाड्रैटिक जटिलता वाली क्वेरी का एक संभावित उदाहरण:
SELECT * FROM item, author WHERE item.i_a_id=author.a_id न्यूनतम जटिलता O(n log(n)) हो सकती है, पर अधिकतम O(n^2) तक जा सकती है—जॉइन एट्रिब्यूट्स के इंडेक्स पर निर्भर।
सारांश के रूप में, आप यह चीट शीट भी देख सकते हैं ताकि समय जटिलता के अनुसार क्वेरियों के परफॉर्मेंस का अनुमान लगा सकें:
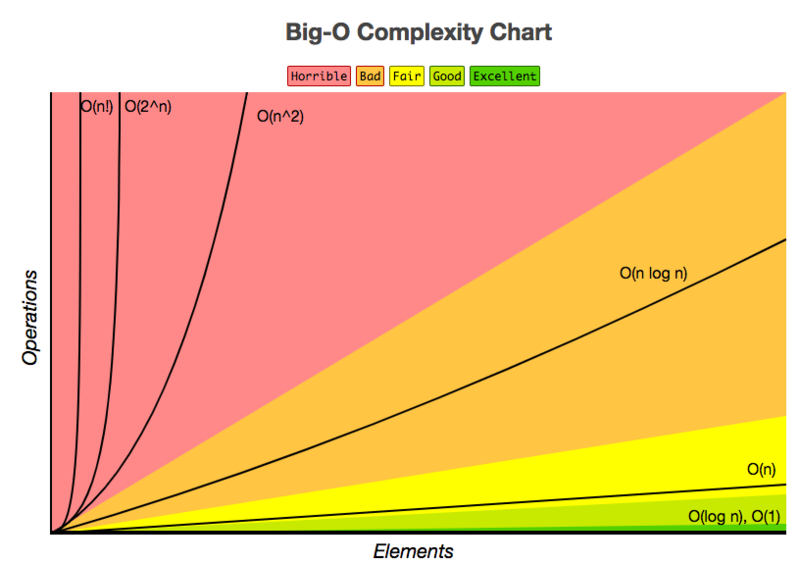
क्वेरी प्लान और समय जटिलता को ध्यान में रखते हुए, आप अपनी SQL क्वेरी को आगे भी ट्यून कर सकते हैं। आप विशेष रूप से इन बिंदुओं पर ध्यान देना शुरू कर सकते हैं:
बधाई! आप इस ब्लॉग पोस्ट के अंत तक पहुँच गए हैं, जिसने आपको SQL क्वेरी परफॉर्मेंस की एक झलक दी। उम्मीद है आपको एंटी-पैटर्न्स, क्वेरी ऑप्टिमाइज़र और वे टूल्स जिनसे आप अपने क्वेरी प्लान की जटिलता की समीक्षा, अनुमान और व्याख्या कर सकते हैं—इन सबमें अधिक अंतर्दृष्टि मिली होगी। पर जानने को बहुत कुछ और भी है! अधिक जानना चाहें तो R. Ramakrishnan और J. Gehrke की “Database Management Systems” पुस्तक पढ़ें।
अंत में, StackOverflow के एक उपयोगकर्ता का यह उद्धरण आपके लिए:
“मेरा पसंदीदा एंटीपैटर्न है—अपनी क्वेरियों का परीक्षण न करना।
यह तब लागू होता है जब:
- आपकी क्वेरी में एक से अधिक टेबल शामिल हों।
- आपको लगता है कि क्वेरी के लिए आपका डिज़ाइन इष्टतम है, पर आप अपनी धारणाओं का परीक्षण करने की जहमत नहीं उठाते।
- आप पहली काम करने वाली क्वेरी को स्वीकार कर लेते हैं, बिना यह जाने कि वह ऑप्टिमाइज़ेशन के कितने करीब है या नहीं।”
यदि आप SQL शुरू करना चाहते हैं, तो ये DataCamp कोर्स करें:
SQL के बारे में और जानें
कोर्स