Kursus
Manipulasi Data di SQL
4 jam
337.3K
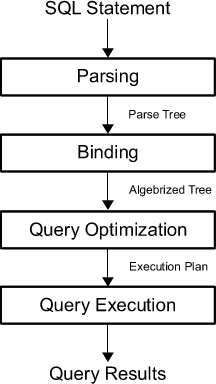
Untuk meningkatkan performa query SQL Anda, pertama-tama Anda perlu tahu apa yang terjadi di balik layar saat Anda menekan pintasan untuk menjalankan query.
Pertama, query diurai menjadi “parse tree”; Query dianalisis untuk melihat apakah memenuhi persyaratan sintaksis dan semantis. Parser membuat representasi internal dari query masukan. Keluaran ini kemudian diteruskan ke mesin penulis ulang (rewrite engine).
Selanjutnya, tugas optimizer adalah menemukan rencana eksekusi atau rencana query yang paling optimal untuk query tersebut. Rencana eksekusi menentukan dengan tepat algoritme apa yang digunakan untuk setiap operasi, dan bagaimana koordinasi eksekusi operasi dilakukan.
Untuk menemukan rencana eksekusi paling optimal, optimizer membuat enumerasi semua rencana yang mungkin, menentukan kualitas atau biaya tiap rencana, mempertimbangkan informasi tentang keadaan basis data saat ini, lalu memilih yang terbaik sebagai rencana eksekusi final. Karena optimizer query bisa tidak sempurna, pengguna dan administrator basis data terkadang perlu memeriksa dan menyetel rencana yang dihasilkan optimizer secara manual untuk mendapatkan performa yang lebih baik.
Sekarang Anda mungkin bertanya-tanya apa yang dianggap sebagai “rencana query yang baik”.
Seperti yang sudah Anda baca, kualitas atau biaya suatu rencana berperan besar. Lebih spesifik, hal-hal seperti jumlah I/O disk yang diperlukan untuk mengevaluasi rencana, biaya CPU rencana dan waktu respons keseluruhan yang dirasakan klien basis data, serta total waktu eksekusi adalah hal penting. Di sinilah konsep kompleksitas waktu berperan. Anda akan membacanya lebih lanjut nanti.
Berikutnya, rencana query yang dipilih dieksekusi, dievaluasi oleh mesin eksekusi sistem, dan hasil query Anda dikembalikan.
Hal yang mungkin belum tampak jelas dari bagian sebelumnya adalah bahwa prinsip Garbage In, Garbage Out (GIGO) secara alami muncul dalam pemrosesan dan eksekusi query: orang yang merumuskan query juga memegang kunci performa query SQL Anda. Jika optimizer menerima query yang dirumuskan dengan buruk, kemampuannya terbatas.
Artinya, ada beberapa hal yang dapat Anda lakukan saat menulis query. Seperti yang telah Anda lihat di pengantar, tanggung jawabnya dua sisi: bukan hanya menulis query yang memenuhi standar tertentu, tetapi juga memiliki gambaran di mana masalah performa mungkin bersembunyi di dalam query Anda.
Titik awal yang ideal adalah memikirkan “titik rawan” dalam query Anda tempat masalah bisa menyelinap. Secara umum, ada empat klausa dan kata kunci di mana pemula dapat menduga masalah performa akan terjadi:
WHERE;INNER JOIN atau LEFT JOIN; Dan,HAVING;Memang, pendekatan ini sederhana dan naif, tetapi bagi pemula, klausa dan pernyataan ini adalah penunjuk yang sangat baik, dan dapat dikatakan aman bahwa saat Anda baru mulai, titik-titik inilah tempat kesalahan terjadi dan—ironisnya—juga sulit dideteksi.
Namun, Anda juga harus menyadari bahwa performa memerlukan konteks agar bermakna: sekadar mengatakan bahwa klausa dan kata kunci ini buruk bukanlah cara yang tepat saat memikirkan performa SQL. Memiliki klausa WHERE atau HAVING dalam query Anda tidak serta-merta berarti query tersebut buruk.
Lihat bagian berikut untuk mempelajari lebih lanjut tentang anti-pola dan pendekatan alternatif untuk membangun query SQL Anda. Tips dan trik ini dimaksudkan sebagai panduan. Cara dan kebutuhan Anda untuk menulis ulang query bergantung pada jumlah data, basis data, dan frekuensi eksekusi query, di antara hal-hal lainnya. Semuanya bergantung pada tujuan query Anda, dan memiliki pengetahuan awal tentang basis data yang ingin Anda query sangat krusial!
Pola pikir “semakin banyak data, semakin baik” tidak selalu tepat saat Anda menulis query SQL: bukan hanya berisiko mengaburkan wawasan dengan mengambil lebih dari yang Anda butuhkan, performa juga bisa menurun karena query Anda menarik terlalu banyak data.
Itulah mengapa umumnya ide yang baik untuk memperhatikan pernyataan SELECT, klausa DISTINCT, dan operator LIKE.
SELECTHal pertama yang bisa Anda periksa setelah menulis query adalah apakah pernyataan SELECT sudah seramping mungkin. Tujuan Anda adalah menghapus kolom yang tidak perlu dari SELECT. Dengan begitu, Anda memaksa diri hanya mengambil data yang mendukung tujuan query.
Jika Anda memiliki subquery berkorelasi yang menggunakan EXISTS, coba gunakan konstanta di pernyataan SELECT subquery tersebut alih-alih memilih nilai dari kolom aktual. Ini sangat berguna ketika Anda hanya memeriksa keberadaan.
Ingat bahwa subquery berkorelasi adalah subquery yang menggunakan nilai dari query luar. Dan perhatikan bahwa, meskipun NULL dapat berfungsi sebagai “konstanta” dalam konteks ini, itu sangat membingungkan!
Pertimbangkan contoh berikut untuk memahami maksud penggunaan konstanta:
SELECT driverslicensenr, name FROM Drivers WHERE EXISTS (SELECT '1' FROM Fines WHERE fines.driverslicensenr = drivers.driverslicensenr);Tip: ada baiknya diketahui bahwa memiliki subquery berkorelasi tidak selalu merupakan ide yang bagus. Anda bisa mempertimbangkan menghilangkannya dengan, misalnya, menulis ulang menggunakan INNER JOIN:
SELECT driverslicensenr, name FROM drivers INNER JOIN fines ON fines.driverslicensenr = drivers.driverslicensenr; DISTINCTPernyataan SELECT DISTINCT digunakan untuk mengembalikan hanya nilai unik. DISTINCT adalah klausa yang sebaiknya Anda hindari jika memungkinkan. Seperti yang Anda baca pada contoh lain, waktu eksekusi hanya akan meningkat jika Anda menambahkan klausa ini ke query Anda. Karena itu, selalu pertimbangkan apakah Anda benar-benar memerlukan operasi DISTINCT untuk mendapatkan hasil yang Anda inginkan.
LIKESaat Anda menggunakan operator LIKE dalam query, indeks tidak digunakan jika pola dimulai dengan % atau _. Hal ini akan mencegah basis data menggunakan indeks (jika ada). Tentu saja, dari sudut pandang lain, Anda juga bisa berargumen bahwa jenis query ini berpotensi membuka peluang untuk mengambil terlalu banyak record yang tidak benar-benar memenuhi tujuan query Anda.
Sekali lagi, pengetahuan Anda tentang data yang tersimpan dalam basis data dapat membantu Anda merumuskan pola yang akan memfilter dengan tepat untuk menemukan hanya baris yang benar-benar relevan bagi query Anda.
Ketika Anda tidak dapat menghindari memfilter pernyataan SELECT, Anda bisa mempertimbangkan membatasi hasil dengan cara lain. Di sinilah pendekatan seperti klausa LIMIT dan konversi tipe data berperan.
TOP, LIMIT, dan ROWNUMAnda dapat menambahkan klausa LIMIT atau TOP ke query untuk menetapkan jumlah maksimum baris pada himpunan hasil. Berikut beberapa contohnya:
SELECT TOP 3 * FROM Drivers;Catatan bahwa Anda dapat menentukan PERCENT lebih lanjut, misalnya dengan mengubah baris pertama query menjadi SELECT TOP 50 PERCENT *.
SELECT driverslicensenr, name FROM Drivers LIMIT 2;Selain itu, Anda juga dapat menambahkan klausa ROWNUM, yang setara dengan menggunakan LIMIT dalam query:
SELECT *FROM DriversWHERE driverslicensenr = 123456 AND ROWNUM <= 3;Anda harus selalu menggunakan tipe data yang paling efisien, yaitu yang terkecil, sebisa mungkin. Selalu ada risiko saat Anda memberikan tipe data yang sangat besar padahal yang lebih kecil sudah cukup.
Namun, ketika Anda menambahkan konversi tipe data ke query, Anda hanya akan meningkatkan waktu eksekusi.
Alternatifnya adalah menghindari konversi tipe data sebisa mungkin. Perhatikan juga bahwa tidak selalu mungkin untuk menghapus atau mengabaikan konversi tipe data dari query Anda, tetapi Anda harus berhati-hati saat menyertakannya dan, ketika dilakukan, uji dampaknya sebelum menjalankan query.
Konversi tipe data membawa kita ke poin berikutnya: Anda tidak boleh membuat query terlalu rumit. Usahakan tetap sederhana dan efisien. Ini mungkin terdengar terlalu sederhana atau bahkan sepele sebagai saran, terutama karena query bisa menjadi kompleks.
Namun, Anda akan lihat pada contoh-contoh di bagian selanjutnya bahwa Anda bisa dengan mudah membuat query sederhana menjadi lebih rumit dari yang diperlukan.
ORSaat Anda menggunakan operator OR dalam query, besar kemungkinan Anda tidak menggunakan indeks.
Ingat bahwa indeks adalah struktur data yang meningkatkan kecepatan pengambilan data di tabel basis data, tetapi ada biayanya: akan ada penulisan tambahan, dan ruang penyimpanan tambahan diperlukan untuk memelihara struktur data indeks. Indeks digunakan untuk dengan cepat menemukan atau melihat data tanpa harus mencari setiap baris di basis data setiap kali tabel diakses. Indeks dapat dibuat menggunakan satu atau lebih kolom dalam tabel basis data.
Jika Anda tidak memanfaatkan indeks yang tersedia di basis data, query Anda tak terelakkan akan berjalan lebih lama. Itulah mengapa sebaiknya mencari alternatif penggunaan operator OR dalam query;
Pertimbangkan query berikut:
SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr = 123456OR driverslicensenr = 678910OR driverslicensenr = 345678;Anda dapat mengganti operator tersebut dengan:
IN; atauSELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr IN (123456, 678910, 345678);SELECT dengan UNION.Tip: di sini, Anda perlu berhati-hati agar tidak menggunakan operasi UNION secara tidak perlu karena Anda melewati tabel yang sama berkali-kali. Pada saat yang sama, sadari bahwa saat Anda menggunakan UNION dalam query, waktu eksekusi akan meningkat. Alternatif untuk operasi UNION adalah: merumuskan ulang query sedemikian rupa sehingga semua kondisi ditempatkan dalam satu instruksi SELECT, atau menggunakan OUTER JOIN alih-alih UNION.
Tip: ingat juga bahwa, meski OR—dan juga operator lain yang disebutkan di bagian berikutnya—kemungkinan tidak menggunakan indeks, pencarian menggunakan indeks tidak selalu lebih disukai!
NOTKetika query Anda mengandung operator NOT, kemungkinan indeks tidak digunakan, seperti pada operator OR. Ini akan memperlambat query Anda. Jika Anda belum paham maksudnya, pertimbangkan query berikut:
SELECT driverslicensenr, nameFROM DriversWHERE NOT (year > 1980);Query ini pasti berjalan lebih lambat dari yang Anda kira, terutama karena dirumuskan lebih rumit dari yang seharusnya: dalam kasus seperti ini, sebaiknya cari alternatif. Pertimbangkan mengganti NOT dengan operator perbandingan, seperti >, <> atau !>; Contoh di atas bisa ditulis ulang menjadi seperti ini:
SELECT driverslicensenr, nameFROM DriversWHERE year <= 1980;Terlihat jauh lebih rapi, bukan?
ANDOperator AND adalah operator lain yang tidak memanfaatkan indeks, dan dapat memperlambat query Anda jika digunakan secara terlalu kompleks dan tidak efisien, seperti pada contoh berikut:
SELECT driverslicensenr, nameFROM DriversWHERE year >= 1960 AND year <= 1980;Lebih baik menulis ulang query ini dan menggunakan operator BETWEEN:
SELECT driverslicensenr, nameFROM DriversWHERE year BETWEEN 1960 AND 1980;ANY dan ALLOperator ANY dan ALL juga harus diwaspadai karena, dengan menyertakannya dalam query, indeks tidak akan digunakan. Alternatif yang berguna di sini adalah fungsi agregasi seperti MIN atau MAX.
Tip: dalam kasus Anda menggunakan alternatif yang diusulkan, sadari bahwa semua fungsi agregasi seperti SUM, AVG, MIN, MAX pada banyak baris dapat menghasilkan query yang berjalan lama. Dalam kasus seperti itu, cobalah meminimalkan jumlah baris yang diproses atau prahitung nilai-nilai tersebut. Sekali lagi terlihat pentingnya memahami lingkungan, tujuan query, dan lain-lain saat memutuskan query mana yang digunakan!
Dalam kasus di mana sebuah kolom digunakan dalam perhitungan atau fungsi skalar, indeks juga tidak digunakan. Solusi yang mungkin adalah dengan mengisolasi kolom spesifik tersebut sehingga tidak lagi menjadi bagian dari perhitungan atau fungsi. Pertimbangkan contoh berikut:
SELECT driverslicensenr, nameFROM DriversWHERE year + 10 = 1980;Terlihat unik, bukan? Sebagai gantinya, pertimbangkan kembali perhitungannya dan tulis ulang query menjadi seperti ini:
SELECT driverslicensenr, nameFROM DriversWHERE year = 1970;Saran terakhir ini berarti Anda tidak boleh membatasi query secara berlebihan karena dapat memengaruhi performanya. Ini terutama berlaku untuk join dan klausa HAVING.
Saat Anda melakukan join dua tabel, penting untuk mempertimbangkan urutan tabel dalam join. Jika Anda melihat satu tabel jauh lebih besar dari yang lain, Anda mungkin ingin menulis ulang query sehingga tabel terbesar diletakkan terakhir dalam join.
Ketika Anda menambahkan terlalu banyak kondisi pada join, Anda memaksa SQL memilih jalur tertentu. Bisa jadi jalur ini tidak selalu yang paling cepat.
HAVINGKlausa HAVING awalnya ditambahkan ke SQL karena kata kunci WHERE tidak dapat digunakan dengan fungsi agregasi. HAVING biasanya digunakan dengan klausa GROUP BY untuk membatasi kelompok baris yang dikembalikan hanya pada yang memenuhi kondisi tertentu. Namun, jika Anda menggunakan klausa ini dalam query, indeks tidak digunakan, yang—seperti yang Anda tahu—dapat menghasilkan query dengan performa kurang baik.
Jika Anda mencari alternatif, pertimbangkan menggunakan klausa WHERE. Pertimbangkan query berikut:
SELECT state, COUNT(*) FROM Drivers WHERE state IN ('GA', 'TX') GROUP BY state ORDER BY stateSELECT state, COUNT(*) FROM Drivers GROUP BY stateHAVING state IN ('GA', 'TX') ORDER BY stateQuery pertama menggunakan klausa WHERE untuk membatasi jumlah baris yang perlu dijumlahkan, sedangkan query kedua menjumlahkan semua baris di tabel lalu menggunakan HAVING untuk membuang hasil jumlahnya. Dalam kasus seperti ini, alternatif dengan klausa WHERE jelas lebih baik, karena Anda tidak membuang sumber daya.
Terlihat bahwa ini bukan tentang membatasi himpunan hasil akhir, melainkan membatasi jumlah record perantara dalam sebuah query.
Catatan bahwa perbedaan antara kedua klausa ini terletak pada fakta bahwa klausa WHERE memperkenalkan kondisi pada baris individual, sementara klausa HAVING memperkenalkan kondisi pada agregasi atau hasil seleksi di mana satu hasil seperti MIN, MAX, SUM,… dihasilkan dari banyak baris.
Seperti yang Anda lihat, mengevaluasi kualitas, menulis, dan menulis ulang query bukan pekerjaan mudah jika Anda mempertimbangkan bahwa query harus secepat mungkin; Menghindari anti-pola dan mempertimbangkan alternatif juga akan menjadi bagian dari tanggung jawab saat Anda menulis query untuk dijalankan pada basis data di lingkungan profesional.
Daftar ini hanyalah gambaran kecil tentang beberapa anti-pola dan tips yang semoga membantu pemula; Jika Anda ingin mengetahui pandangan pengembang yang lebih senior tentang anti-pola yang paling sering terjadi, lihat diskusi ini.
Hal yang tersirat dalam anti-pola di atas adalah bahwa semuanya bermuara pada perbedaan antara pendekatan berbasis himpunan dan pendekatan prosedural dalam membangun query Anda.
Pendekatan prosedural terhadap query mirip dengan pemrograman: Anda memberi tahu sistem apa yang harus dilakukan dan bagaimana melakukannya.
Contohnya adalah kondisi berlebihan dalam join atau kasus di mana Anda menyalahgunakan klausa HAVING, seperti pada contoh di atas, di mana Anda men-query basis data dengan menjalankan suatu fungsi lalu memanggil fungsi lain, atau menggunakan logika yang berisi loop, kondisi, User Defined Functions (UDF), kursor, … untuk mendapatkan hasil akhir. Dalam pendekatan ini, Anda sering kali meminta subset data, lalu meminta subset lain, dan seterusnya.
Tidak mengherankan jika pendekatan ini sering disebut “langkah-demi-langkah” atau “baris-demi-baris”.
Pendekatan lainnya adalah pendekatan berbasis himpunan, di mana Anda hanya menentukan apa yang harus dilakukan. Peran Anda adalah menentukan kondisi atau persyaratan untuk himpunan hasil yang ingin Anda peroleh dari query. Cara data Anda diambil diserahkan kepada mekanisme internal yang menentukan implementasi query: Anda membiarkan mesin basis data menentukan algoritme atau logika pemrosesan terbaik untuk mengeksekusi query Anda.
Karena SQL berbasis himpunan, tidak mengherankan jika pendekatan ini umumnya lebih efektif daripada pendekatan prosedural dan juga menjelaskan mengapa, dalam beberapa kasus, SQL dapat bekerja lebih cepat daripada kode.
Tip Pendekatan berbasis himpunan juga yang paling sering diminta oleh pemberi kerja teratas di industri ilmu data! Anda sering perlu berganti antara dua jenis pendekatan ini.
Catatan jika Anda menemukan diri Anda dengan query prosedural, pertimbangkan untuk menulis ulang atau melakukan refaktor.
Menyadari bahwa anti-pola tidak statis dan berkembang seiring pertumbuhan Anda sebagai pengembang SQL serta banyaknya hal yang perlu dipertimbangkan saat memikirkan alternatif berarti menghindari anti-pola query dan menulis ulang query bisa menjadi tugas yang cukup sulit. Bantuan apa pun akan berguna, dan itulah mengapa pendekatan yang lebih terstruktur untuk mengoptimalkan query dengan beberapa alat bisa menjadi jalan yang tepat.
Catatan juga bahwa beberapa anti-pola yang disebutkan di bagian terakhir berakar pada kekhawatiran performa, seperti operator AND, OR, dan NOT serta tidak digunakannya indeks. Memikirkan performa tidak hanya memerlukan pendekatan yang lebih terstruktur tetapi juga lebih mendalam.
Bagaimanapun, pendekatan terstruktur dan mendalam ini umumnya didasarkan pada rencana query, yang, seperti Anda ingat, merupakan hasil dari query yang pertama-tama diurai menjadi “parse tree” dan mendefinisikan dengan tepat algoritme apa yang digunakan untuk setiap operasi serta bagaimana koordinasi eksekusi operasi dilakukan.
Seperti yang Anda baca di pengantar, bisa jadi Anda perlu memeriksa dan menyetel rencana yang dihasilkan optimizer secara manual. Dalam kasus seperti itu, Anda perlu menganalisis kembali query Anda dengan melihat rencana query.
Untuk mendapatkan rencana ini, Anda perlu menggunakan alat yang disediakan oleh sistem manajemen basis data Anda. Beberapa alat yang mungkin tersedia antara lain:
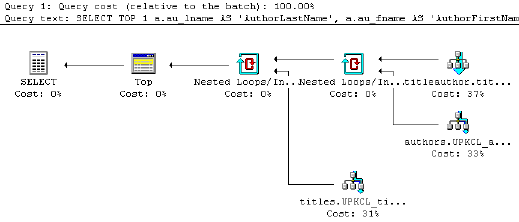
EXPLAIN PLAN di Oracle, tetapi nama instruksinya bervariasi menurut RDBMS yang Anda gunakan. Di tempat lain, Anda mungkin menemukan EXPLAIN (MySQL, PostgreSQL) atau EXPLAIN QUERY PLAN (SQLite).Catatan jika Anda bekerja dengan PostgreSQL, bedakan antara EXPLAIN, di mana Anda hanya mendapatkan deskripsi tentang bagaimana planner berniat mengeksekusi query tanpa menjalankannya, sementara EXPLAIN ANALYZE benar-benar mengeksekusi query dan mengembalikan analisis perbandingan antara rencana yang diharapkan dan aktual. Secara umum, rencana eksekusi aktual adalah yang benar-benar menjalankan query, sedangkan rencana eksekusi estimasi menghitung apa yang akan dilakukan tanpa menjalankan query. Meskipun setara secara logis, rencana eksekusi aktual jauh lebih berguna karena berisi detail dan statistik tambahan tentang apa yang benar-benar terjadi saat mengeksekusi query.
Di sisa bagian ini, Anda akan mempelajari lebih lanjut tentang EXPLAIN dan ANALYZE serta bagaimana menggunakannya untuk mempelajari lebih lanjut tentang rencana query Anda dan potensi performanya. Untuk melakukannya, Anda akan memulai dengan beberapa contoh menggunakan dua tabel: one_million dan half_million.
Anda dapat mengambil informasi terkini dari tabel one_million dengan bantuan EXPLAIN; Pastikan untuk meletakkannya tepat di atas query Anda, dan saat dijalankan, itu akan mengembalikan rencana query:
EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18584.82 rows=1025082 width=36)(1 row)Dalam kasus ini, Anda melihat bahwa biaya query adalah 0.00..18584.82 dan jumlah baris adalah 1025082. Lebar jumlah kolom adalah 36.
Anda juga dapat memperbarui informasi statistik dengan bantuan ANALYZE.
ANALYZE one_million;EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(1 row)Selain EXPLAIN dan ANALYZE, Anda juga dapat mengambil waktu eksekusi aktual dengan bantuan EXPLAIN ANALYZE:
EXPLAIN ANALYZESELECT *FROM one_million;QUERY PLAN___________________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(actual time=0.015..1207.019 rows=1000000 loops=1)Total runtime: 2320.146 ms(2 rows)Kekurangan menggunakan EXPLAIN ANALYZE di sini jelas bahwa query benar-benar dieksekusi, jadi berhati-hatilah!
Sejauh ini, algoritme yang Anda lihat adalah Seq Scan (Sequential Scan) atau Full Table Scan: ini adalah pemindaian pada basis data di mana setiap baris tabel dibaca secara berurutan (serial), dan kolom yang ditemukan diperiksa apakah memenuhi kondisi atau tidak. Terkait performa, Sequential Scan jelas bukan rencana eksekusi terbaik karena Anda masih melakukan pemindaian seluruh tabel. Namun, ini tidak terlalu buruk saat tabel tidak muat di memori: pembacaan berurutan berjalan cukup cepat bahkan pada disk lambat.
Anda akan melihat lebih banyak tentang ini nanti saat membahas index scan.
Namun, ada algoritme lain. Ambil contoh rencana query untuk join berikut ini:
EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN_________________________________________________________________Hash Join (cost=15417.00..68831.00 rows=500000 width=42)(actual time=1241.471..5912.553 rows=500000 loops=1)Hash Cond: (one_million.counter = half_million.counter) -> Seq Scan on one_million (cost=0.00..18334.00 rows=1000000 width=37) (actual time=0.007..1254.027 rows=1000000 loops=1) -> Hash (cost=7213.00..7213.00 rows=500000 width=5) (actual time=1241.251..1241.251 rows=500000 loops=1) Buckets: 4096 Batches: 16 Memory Usage: 770kB -> Seq Scan on half_million (cost=0.00..7213.00 rows=500000 width=5)(actual time=0.008..601.128 rows=500000 loops=1)Total runtime: 6468.337 msAnda melihat bahwa optimizer memilih Hash Join di sini! Ingat operasi ini, karena Anda akan membutuhkannya untuk mengestimasi kompleksitas waktu query Anda. Untuk saat ini, perhatikan bahwa tidak ada indeks pada half_million.counter, yang dapat Anda tambahkan pada contoh berikut:
CREATE INDEX ON half_million(counter);EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN________________________________________________________________Merge Join (cost=4.12..37650.65 rows=500000 width=42)(actual time=0.033..3272.940 rows=500000 loops=1)Merge Cond: (one_million.counter = half_million.counter) -> Index Scan using one_million_counter_idx on one_million (cost=0.00..32129.34 rows=1000000 width=37) (actual time=0.011..694.466 rows=500001 loops=1) -> Index Scan using half_million_counter_idx on half_million (cost=0.00..14120.29 rows=500000 width=5)(actual time=0.010..683.674 rows=500000 loops=1)Total runtime: 3833.310 ms(5 rows)Anda melihat bahwa, dengan membuat indeks, optimizer sekarang memutuskan menggunakan Merge join dengan Index Scan.
Catatan perbedaan antara index scan dan full table scan atau sequential scan: yang pertama, yang juga disebut “table scan”, memindai halaman data atau indeks untuk menemukan record yang sesuai, sedangkan yang kedua memindai setiap baris tabel.
Anda melihat total runtime berkurang dan performa seharusnya lebih baik, tetapi ada dua index scan, yang membuat memori menjadi lebih penting di sini, terutama jika tabel tidak muat di memori. Dalam kasus seperti itu, Anda pertama-tama harus melakukan full index scan, yang berupa pembacaan berurutan yang cepat dan tidak bermasalah, tetapi kemudian ada banyak pembacaan acak untuk mengambil baris berdasarkan nilai indeks. Pembacaan acak inilah yang umumnya jauh lebih lambat daripada pembacaan berurutan. Dalam kasus seperti ini, full table scan memang lebih cepat daripada full index scan.
Sekarang setelah Anda meninjau rencana query secara singkat, Anda dapat menggali lebih dalam dan memikirkan performa dalam istilah yang lebih formal dengan bantuan teori kompleksitas komputasional. Bidang dalam ilmu komputer teoretis ini berfokus pada pengelompokan masalah komputasional menurut tingkat kesulitannya, di antaranya; Masalah komputasional ini bisa berupa algoritme, tetapi juga query.
Untuk query, Anda tidak selalu mengelompokkan menurut kesulitannya, melainkan menurut waktu yang dibutuhkan untuk menjalankannya dan mendapatkan hasil. Ini secara eksplisit disebut kompleksitas waktu dan untuk mengungkapkan atau mengukurnya, Anda dapat menggunakan notasi big O.
Dengan notasi big O, Anda mengekspresikan waktu eksekusi dalam hal seberapa cepat ia bertumbuh relatif terhadap masukan, saat masukan menjadi sangat besar. Notasi big O mengecualikan koefisien dan suku orde lebih rendah sehingga Anda dapat fokus pada bagian penting dari waktu berjalan query Anda: laju pertumbuhannya. Ketika diekspresikan seperti ini, dengan mengabaikan koefisien dan suku orde rendah, kompleksitas waktu dikatakan dideskripsikan secara asimtotik. Artinya ukuran masukan menuju tak terhingga.
Dalam bahasa basis data, kompleksitas mengukur seberapa banyak lebih lama waktu yang dibutuhkan query untuk berjalan saat ukuran tabel data—dan karenanya basis data—meningkat.
Catatan bahwa ukuran basis data Anda tidak hanya meningkat seiring makin banyak data disimpan di tabel, tetapi juga fakta bahwa indeks hadir dalam basis data turut memengaruhi ukurannya.
Seperti yang telah Anda lihat, rencana eksekusi, antara lain, mendefinisikan algoritme apa yang digunakan untuk setiap operasi, yang membuat setiap waktu eksekusi query dapat secara logis diekspresikan sebagai fungsi dari ukuran tabel yang terlibat dalam rencana query, yang disebut fungsi kompleksitas. Dengan kata lain, Anda dapat menggunakan notasi big O dan rencana eksekusi untuk memperkirakan kompleksitas query dan performanya.
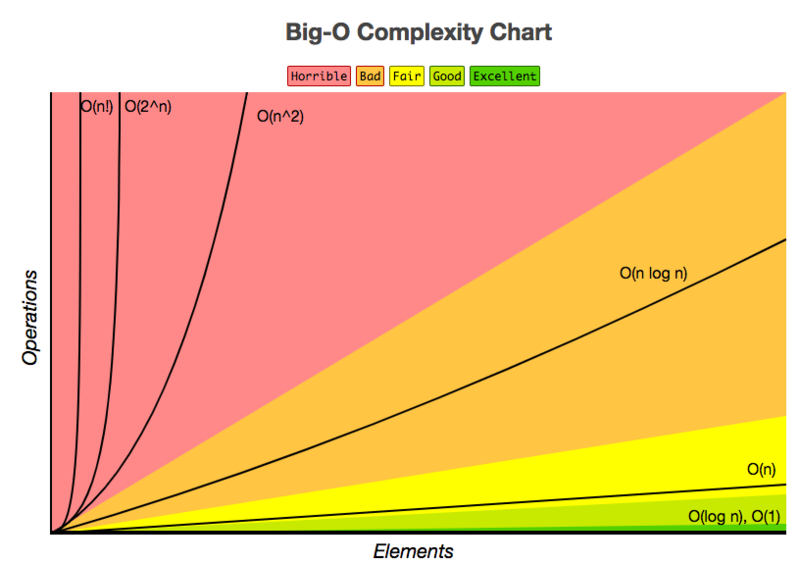
Pada subbagian berikut, Anda akan mendapatkan gambaran umum tentang empat jenis kompleksitas waktu, dan Anda akan melihat beberapa contoh bagaimana kompleksitas waktu query dapat bervariasi sesuai konteks eksekusinya.
Petunjuk: indeks adalah bagian dari cerita di sini!
Catatan bahwa ada berbagai jenis indeks, rencana eksekusi, dan implementasi untuk berbagai basis data yang perlu dipertimbangkan, sehingga kompleksitas waktu di bawah ini sangat umum dan dapat bervariasi menurut pengaturan spesifik Anda.
Sebuah algoritme dikatakan berjalan dalam waktu konstan jika memerlukan waktu yang sama terlepas dari ukuran masukan. Untuk query, ia akan berjalan dalam waktu konstan jika memerlukan waktu yang sama tanpa memandang ukuran tabel.
Jenis query ini tidak terlalu umum, namun berikut salah satu contohnya:
SELECT TOP 1 t.* FROM tKompleksitas waktunya konstan karena Anda memilih satu baris arbitrer dari tabel. Oleh karena itu, lamanya waktu seharusnya independen dari ukuran tabel.
Sebuah algoritme dikatakan berjalan dalam waktu linear jika waktu eksekusinya berbanding lurus dengan ukuran masukan, yaitu waktu bertambah linear seiring ukuran masukan meningkat. Untuk basis data, ini berarti waktu eksekusi akan berbanding lurus dengan ukuran tabel: saat jumlah baris dalam tabel bertambah, waktu untuk query pun bertambah.
Contohnya adalah query dengan klausa WHERE pada kolom yang tidak diindeks: diperlukan full table scan atau Seq Scan, yang menghasilkan kompleksitas waktu O(n). Artinya setiap baris perlu dibaca untuk menemukan yang memiliki ID yang benar. Anda sama sekali tidak memiliki batasan, jadi setiap baris memang harus dibaca meskipun baris pertama cocok dengan kondisi.
Pertimbangkan juga contoh query berikut yang akan memiliki kompleksitas O(n) jika tidak ada indeks pada i_id:
SELECT i_id FROM item;COUNT(*) FROM TABLE; akan memiliki kompleksitas waktu O(n), karena diperlukan full table scan kecuali total jumlah baris disimpan untuk tabel tersebut. Maka, kompleksitasnya lebih mirip O(1).Yang terkait erat dengan waktu eksekusi linear adalah waktu eksekusi untuk rencana yang memiliki join. Berikut beberapa contohnya:
Ingat: nested join adalah join yang membandingkan setiap record di satu tabel terhadap setiap record di tabel lainnya.
Sebuah algoritme dikatakan berjalan dalam waktu logaritmik jika waktu eksekusinya sebanding dengan logaritma dari ukuran masukan; Untuk query, ini berarti query akan berjalan jika waktu eksekusinya sebanding dengan logaritma dari ukuran basis data.
Kompleksitas waktu logaritmik ini berlaku untuk rencana query di mana dilakukan Index Scan atau pemindaian indeks terklaster. Indeks terklaster adalah indeks di mana level daun dari indeks berisi baris data aktual dari tabel. Indeks terklaster mirip dengan indeks lain: ia didefinisikan pada satu atau beberapa kolom. Kolom-kolom ini membentuk kunci indeks. Clustering key adalah kolom kunci dari indeks terklaster. Pemindaian indeks terklaster pada dasarnya adalah operasi RDBMS Anda membaca baris dari atas ke bawah dalam indeks terklaster.
Pertimbangkan contoh query berikut, di mana terdapat indeks pada i_id dan umumnya akan menghasilkan kompleksitas O(log(n)):
SELECT i_stock FROM item WHERE i_id = N; Catatan tanpa indeks, kompleksitas waktunya akan O(n).
Sebuah algoritme dikatakan berjalan dalam waktu kuadratik jika waktu eksekusinya sebanding dengan kuadrat dari ukuran masukan. Sekali lagi, untuk basis data, ini berarti waktu eksekusi query sebanding dengan kuadrat dari ukuran basis data.
Contoh kemungkinan query dengan kompleksitas waktu kuadratik adalah berikut ini:
SELECT * FROM item, author WHERE item.i_a_id=author.a_id Kompleksitas minimumnya O(n log(n)), tetapi kompleksitas maksimumnya bisa O(n^2), bergantung pada informasi indeks dari atribut join.
Untuk merangkum, Anda juga dapat melihat cheat sheet berikut untuk mengestimasi performa query menurut kompleksitas waktunya dan seberapa baik kinerjanya:
Dengan rencana query dan kompleksitas waktu dalam pikiran, Anda dapat mempertimbangkan menyetel query SQL Anda lebih lanjut. Anda bisa mulai dengan memberi perhatian khusus pada poin-poin berikut:
Selamat! Anda telah mencapai akhir artikel ini, yang memberi Anda gambaran singkat tentang performa query SQL. Semoga Anda mendapatkan lebih banyak wawasan tentang anti-pola, optimizer query, dan alat yang dapat Anda gunakan untuk meninjau, memperkirakan, dan menafsirkan kompleksitas rencana query Anda. Namun, masih banyak yang bisa dipelajari! Jika Anda ingin tahu lebih banyak, pertimbangkan untuk membaca buku “Database Management Systems”, yang ditulis oleh R. Ramakrishnan dan J. Gehrke.
Terakhir, saya tidak ingin menyembunyikan kutipan dari seorang pengguna StackOverflow ini:
“Anti-pola favorit saya adalah tidak menguji query Anda.
Ini berlaku ketika:
- Query Anda melibatkan lebih dari satu tabel.
- Anda merasa memiliki desain optimal untuk sebuah query, tetapi tidak repot menguji asumsi Anda.
- Anda menerima query pertama yang bekerja, tanpa tahu apakah itu sudah mendekati optimal.”
Jika Anda ingin mulai belajar SQL, pertimbangkan untuk mengikuti kursus-kursus DataCamp berikut:
Pelajari lebih lanjut tentang SQL
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



