
Last chance! 50% off DataCamp Premium
Sale ends in
Per migliorare le performance di una query SQL, devi prima sapere cosa succede internamente quando premi la scorciatoia per eseguirla.
Per prima cosa, la query viene analizzata in un “albero di parsing”: si verifica se soddisfa i requisiti sintattici e semantici. Il parser crea una rappresentazione interna della query in input. Questo output passa poi al motore di riscrittura.
Tocca quindi all’ottimizzatore trovare il piano di esecuzione o query plan ottimale per la query fornita. Il piano di esecuzione definisce esattamente quale algoritmo viene usato per ogni operazione e come viene coordinata l’esecuzione delle operazioni.
Per trovare davvero il piano più ottimale, l’ottimizzatore enumera tutti i possibili piani di esecuzione, ne determina la qualità o il costo, considera informazioni sullo stato corrente del database e poi sceglie il migliore come piano di esecuzione finale. Poiché gli ottimizzatori non sono perfetti, utenti e amministratori talvolta devono esaminare e ottimizzare manualmente i piani prodotti per ottenere prestazioni migliori.
A questo punto ti chiederai cosa si intenda per “buon piano di esecuzione”.
Come hai già letto, la qualità, intesa come costo di un piano, gioca un ruolo notevole. Più nello specifico, contano il numero di I/O su disco necessari per valutare il piano, il costo CPU del piano e il tempo di risposta complessivo osservabile dal client del database, oltre al tempo totale di esecuzione. Qui entra in gioco la nozione di complessità temporale. Ne leggerai più avanti.
Successivamente, il piano scelto viene eseguito, valutato dal motore di esecuzione del sistema e vengono restituiti i risultati della query.
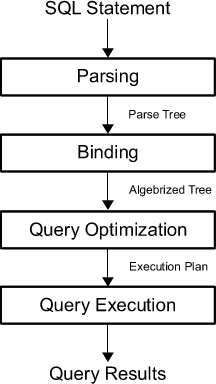
Ciò che potrebbe non essere emerso chiaramente dalla sezione precedente è che il principio Garbage In, Garbage Out (GIGO) si manifesta naturalmente nell’elaborazione ed esecuzione delle query: chi formula la query detiene anche le chiavi delle performance delle tue query SQL. Se l’ottimizzatore riceve una query formulata male, potrà fare ben poco.
Questo significa che ci sono cose che tu puoi fare mentre scrivi una query. Come visto nell’introduzione, la responsabilità è duplice: non si tratta solo di scrivere query che rispettino uno standard, ma anche di farti un’idea di dove potrebbero annidarsi problemi di performance all’interno della tua query.
Un ottimo punto di partenza è pensare ai “punti critici” nelle tue query in cui potrebbero insinuarsi problemi. In generale, ci sono quattro clausole e keyword in cui i principianti possono aspettarsi problemi di performance:
WHERE;INNER JOIN o LEFT JOIN; E,HAVING;È vero, questo approccio è semplice e ingenuo, ma per chi inizia queste clausole e istruzioni sono ottimi indizi, ed è sicuro dire che, all’inizio, sono proprio questi i punti in cui si commettono errori e, ironia della sorte, anche i più difficili da individuare.
Detto ciò, devi anche renderti conto che la performance ha bisogno di contesto per avere senso: dire semplicemente che queste clausole e keyword sono “cattive” non è la via giusta quando pensi alle performance SQL. Avere una clausola WHERE o HAVING in una query non significa necessariamente che la query sia pessima.
Dai un’occhiata alla sezione seguente per scoprire anti-pattern e approcci alternativi per costruire la tua query SQL. Questi suggerimenti sono una guida. Se e come riscrivere la tua query dipende dalla quantità di dati, dal database e dal numero di volte che devi eseguire la query, tra le altre cose. Dipende interamente dallo scopo della query, e avere un po’ di conoscenza pregressa del database che vuoi interrogare è cruciale!
La mentalità del “più dati, meglio è” non è quella giusta quando scrivi query SQL: non solo rischi di offuscare gli insight ottenendo più del necessario, ma potresti anche peggiorare le performance perché la query estrae troppi dati.
Per questo di solito è una buona idea prestare attenzione all’istruzione SELECT, alla clausola DISTINCT e all’operatore LIKE.
SELECT StatementUna prima cosa da verificare, una volta scritta la query, è se l’istruzione SELECT è il più compatta possibile. L’obiettivo qui è rimuovere le colonne non necessarie dal SELECT. In questo modo ti costringi a estrarre solo i dati utili allo scopo della query.
Se hai subquery correlate con EXISTS, prova a usare una costante nel SELECT di quella subquery invece di selezionare il valore di una colonna reale. È particolarmente utile quando verifichi solo l’esistenza.
Ricorda che una subquery correlata usa valori dalla query esterna. E nota che, anche se NULL può funzionare in questo contesto come “costante”, è molto fuorviante!
Considera il seguente esempio per capire cosa si intende con usare una costante:
SELECT driverslicensenr, name FROM Drivers WHERE EXISTS (SELECT '1' FROM Fines WHERE fines.driverslicensenr = drivers.driverslicensenr);Suggerimento: avere una subquery correlata non è sempre una buona idea. Puoi valutare di eliminarla riscrivendola, per esempio, con un INNER JOIN:
SELECT driverslicensenr, name FROM drivers INNER JOIN fines ON fines.driverslicensenr = drivers.driverslicensenr; DISTINCT ClauseSELECT DISTINCT viene usato per restituire solo valori distinti (diversi). DISTINCT è una clausola che dovresti cercare di evitare se puoi. Come hai letto in altri esempi, il tempo di esecuzione aumenta quando aggiungi questa clausola alla query. È quindi sempre una buona idea chiederti se ti serve davvero questa operazione DISTINCT per ottenere i risultati desiderati.
LIKE OperatorQuando usi l’operatore LIKE in una query, l’indice non viene utilizzato se il pattern inizia con % o _. Questo impedirà al database di usare un indice (se esiste). Ovviamente, da un altro punto di vista, si può anche sostenere che questo tipo di query lascia potenzialmente la porta aperta a recuperare troppi record che non soddisfano davvero l’obiettivo della query.
Ancora una volta, la tua conoscenza dei dati nel database può aiutarti a formulare un pattern che filtri correttamente tutti i dati per trovare solo le righe davvero rilevanti per la query.
Quando non puoi evitare di filtrare il tuo SELECT, puoi considerare di limitare i risultati in altri modi. Qui entrano in gioco approcci come la clausola LIMIT e le conversioni di tipo dati.
TOP, LIMIT And ROWNUM ClausesPuoi aggiungere le clausole LIMIT o TOP alle query per impostare un numero massimo di righe nel result set. Ecco alcuni esempi:
SELECT TOP 3 * FROM Drivers;Nota che puoi specificare anche PERCENT, ad esempio cambiando la prima riga in SELECT TOP 50 PERCENT *.
SELECT driverslicensenr, name FROM Drivers LIMIT 2;Inoltre, puoi anche aggiungere la clausola ROWNUM, equivalente a usare LIMIT nella query:
SELECT *FROM DriversWHERE driverslicensenr = 123456 AND ROWNUM <= 3;Dovresti sempre usare i tipi di dati più efficienti, cioè più piccoli, possibile. C’è sempre un rischio quando fornisci un tipo enorme dove uno più piccolo sarebbe più che sufficiente.
Tuttavia, quando aggiungi conversioni di tipo alla tua query, non fai che aumentare il tempo di esecuzione.
Un’alternativa è evitare le conversioni di tipo il più possibile. Nota anche qui che non è sempre possibile rimuoverle o ometterle, ma dovresti senz’altro essere cauto nell’includerle e, quando lo fai, testare l’effetto prima di eseguire la query.
Le conversioni di tipo dati portano al punto successivo: non sovra-ingegnerizzare le query. Tienile semplici ed efficienti. Potrebbe sembrare un consiglio banale, soprattutto perché le query possono diventare complesse.
Tuttavia, vedrai negli esempi delle prossime sezioni che è facile complicare query semplici più del necessario.
OR OperatorQuando usi l’operatore OR nella query, è probabile che tu non stia usando un indice.
Ricorda che un indice è una struttura dati che migliora la velocità di recupero dei dati in una tabella, ma ha un costo: ci saranno scritture aggiuntive e serve spazio extra per mantenere la struttura dell’indice. Gli indici servono a localizzare o cercare rapidamente i dati senza dover scandire ogni riga della tabella ogni volta che vi si accede. Possono essere creati su una o più colonne di una tabella.
Se non sfrutti gli indici presenti nel database, la tua query impiegherà inevitabilmente più tempo. Per questo è meglio cercare alternative all’uso di OR nella query;
Considera la seguente query:
SELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr = 123456OR driverslicensenr = 678910OR driverslicensenr = 345678;Puoi sostituire l’operatore con:
IN; oppureSELECT driverslicensenr, nameFROM DriversWHERE driverslicensenr IN (123456, 678910, 345678);SELECT con un UNION.Suggerimento: qui fai attenzione a non usare UNION inutilmente, perché passi più volte sulla stessa tabella. Al contempo, ricorda che usare UNION aumenta il tempo di esecuzione. Alternative a UNION sono: riformulare la query in modo che tutte le condizioni siano in un’unica istruzione SELECT, oppure usare un OUTER JOIN invece di UNION.
Suggerimento: tieni presente anche qui che, sebbene OR —e anche altri operatori citati nelle sezioni seguenti— probabilmente non usi un indice, le ricerche tramite indice non sono sempre preferibili!
NOT OperatorQuando la query contiene l’operatore NOT, è probabile che l’indice non venga usato, proprio come con OR. Questo rallenterà inevitabilmente la query. Se non ti è chiaro, considera la seguente query:
SELECT driverslicensenr, nameFROM DriversWHERE NOT (year > 1980);Questa query sarà certamente più lenta di quanto potresti aspettarti, soprattutto perché è formulata in modo più complesso del necessario: in casi come questo, è meglio cercare un’alternativa. Considera di sostituire NOT con operatori di confronto, come >, <> o !>; L’esempio sopra può infatti essere riscritto così:
SELECT driverslicensenr, nameFROM DriversWHERE year <= 1980;Già più pulito, no?
AND OperatorL’operatore AND è un altro che non sfrutta l’indice e può rallentare la query se usato in modo eccessivamente complesso e inefficiente, come nell’esempio seguente:
SELECT driverslicensenr, nameFROM DriversWHERE year >= 1960 AND year <= 1980;È meglio riscrivere la query usando l’operatore BETWEEN:
SELECT driverslicensenr, nameFROM DriversWHERE year BETWEEN 1960 AND 1980;ANY and ALL OperatorsAnche gli operatori ANY e ALL vanno usati con cautela perché, includendoli nelle query, l’indice non verrà usato. Alternative utili qui sono funzioni di aggregazione come MIN o MAX.
Suggerimento: quando usi le alternative proposte, considera che tutte le funzioni di aggregazione come SUM, AVG, MIN, MAX su molte righe possono portare a query lunghe. In questi casi, prova a minimizzare il numero di righe da elaborare o a pre-calcolare questi valori. Ancora una volta, è importante essere consapevoli dell’ambiente, dello scopo della query, … quando prendi decisioni su quale query usare!
Anche quando una colonna è usata in un calcolo o in una funzione scalare, l’indice non viene usato. Una soluzione possibile è isolare semplicemente la colonna specifica in modo che non faccia più parte del calcolo o della funzione. Considera il seguente esempio:
SELECT driverslicensenr, nameFROM DriversWHERE year + 10 = 1980;Sembra strano, vero? Invece, prova a riconsiderare il calcolo e riscrivi così:
SELECT driverslicensenr, nameFROM DriversWHERE year = 1970;Questo ultimo consiglio significa che non dovresti cercare di restringere troppo la query, perché può comprometterne le performance. Questo vale soprattutto per i join e per la clausola HAVING.
Quando unisci due tabelle, può essere importante considerare l’ordine delle tabelle nel join. Se noti che una tabella è molto più grande dell’altra, potresti riscrivere la query in modo che la tabella più grande sia posizionata per ultima nel join.
Quando aggiungi troppe condizioni ai join, costringi SQL a scegliere un percorso specifico. Tuttavia, potrebbe non essere sempre quello più performante.
HAVING ClauseLa clausola HAVING è stata aggiunta a SQL perché la keyword WHERE non poteva essere usata con funzioni di aggregazione. HAVING è tipicamente usata con GROUP BY per limitare i gruppi di righe restituite a quelle che soddisfano certe condizioni. Tuttavia, se la usi nella query, l’indice non viene usato e —come già sai— questo può portare a una query non proprio brillante in termini di prestazioni.
Se cerchi un’alternativa, considera la clausola WHERE. Osserva queste query:
SELECT state, COUNT(*) FROM Drivers WHERE state IN ('GA', 'TX') GROUP BY state ORDER BY stateSELECT state, COUNT(*) FROM Drivers GROUP BY stateHAVING state IN ('GA', 'TX') ORDER BY stateLa prima usa WHERE per limitare il numero di righe da sommare, mentre la seconda somma tutte le righe in tabella e poi usa HAVING per scartare le somme calcolate. In questi casi, l’alternativa con WHERE è ovviamente migliore, perché non sprechi risorse.
Vedi che non si tratta di limitare il set di risultati finale, ma di limitare il numero intermedio di record all’interno di una query.
Nota che la differenza tra le due clausole sta nel fatto che WHERE introduce una condizione sulle singole righe, mentre HAVING introduce una condizione su aggregazioni o risultati di una selezione in cui un singolo risultato, come MIN, MAX, SUM, … è stato prodotto da più righe.
Come vedi, valutare la qualità, scrivere e riscrivere query non è un compito facile se consideri che devono essere il più performanti possibile; Evitare gli anti-pattern e considerare alternative sarà parte della tua responsabilità quando scrivi query da eseguire su database in un contesto professionale.
Questa lista era solo una piccola panoramica di alcuni anti-pattern e consigli che speriamo aiutino i principianti; Se vuoi capire quali sono gli anti-pattern più frequenti per sviluppatori più senior, dai un’occhiata a questa discussione.
Ciò che era implicito negli anti-pattern sopra è che in realtà si riducono alla differenza tra approccio set-based e procedurale nella costruzione delle query.
L’approccio procedurale alle query somiglia molto alla programmazione: dici al sistema cosa fare e come farlo.
Un esempio sono le condizioni ridondanti nei join o i casi in cui abusi della clausola HAVING, come negli esempi precedenti, in cui interroghi il database eseguendo una funzione e poi richiamandone un’altra, oppure usi logica con cicli, condizioni, User Defined Functions (UDF), cursori, … per arrivare al risultato finale. Con questo approccio, spesso chiederai un sottoinsieme di dati, poi un altro sottoinsieme, e così via.
Non sorprende che questo approccio sia spesso chiamato “step-by-step” o query “row-by-row”.
L’altro approccio è quello set-based, in cui specifichi solo cosa fare. Il tuo ruolo consiste nello specificare condizioni o requisiti per il result set che vuoi ottenere. Come i dati vengano recuperati lo lasci ai meccanismi interni che determinano l’implementazione della query: lasci che il motore del database scelga i migliori algoritmi o la logica di elaborazione per eseguirla.
Dato che SQL è set-based, non sorprende che questo approccio sia spesso più efficace di quello procedurale e spieghi anche perché, in alcuni casi, SQL può essere più veloce del codice.
Suggerimento l’approccio set-based alle query è anche quello che la maggior parte dei top employer nella data science vuole che tu padroneggi! Dovrai spesso passare da un approccio all’altro.
Nota che se ti ritrovi con una query procedurale, dovresti considerare di riscriverla o refattorizzarla.
Il fatto che gli anti-pattern non siano statici e si evolvano man mano che cresci come sviluppatore SQL, e che ci sia molto da considerare quando pensi alle alternative, significa anche che evitare anti-pattern e riscrivere query può essere un compito difficile. Qualsiasi aiuto è benvenuto, ed è per questo che un approccio più strutturato all’ottimizzazione della query, con alcuni strumenti, può essere la strada giusta.
Nota anche che alcuni anti-pattern menzionati nella sezione precedente affondavano le radici in preoccupazioni di performance, come gli operatori AND, OR e NOT e il loro mancato uso degli indici. Pensare alle performance richiede non solo un approccio più strutturato, ma anche più approfondito.
In ogni caso, questo approccio strutturato e approfondito si baserà per lo più sul piano di esecuzione che, come ricordi, è il risultato della query prima analizzata in un “albero di parsing” e definisce esattamente quale algoritmo viene usato per ogni operazione e come sono coordinate le esecuzioni.
Come hai letto nell’introduzione, può capitare che tu debba esaminare e ottimizzare manualmente i piani prodotti dall’ottimizzatore. In questi casi, dovrai analizzare di nuovo la query osservando il piano di esecuzione.
Per ottenere questo piano, dovrai utilizzare gli strumenti forniti dal tuo sistema di gestione del database. Alcuni strumenti che potresti avere a disposizione sono i seguenti:
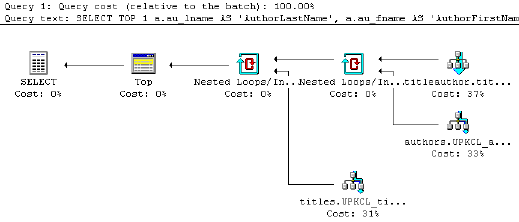
EXPLAIN PLAN in Oracle, ma il nome varia a seconda dell’RDBMS con cui lavori. Altrove potresti trovare EXPLAIN (MySQL, PostgreSQL) o EXPLAIN QUERY PLAN (SQLite).Nota che, se lavori con PostgreSQL, c’è differenza tra EXPLAIN, che ti dà solo una descrizione dell’idea di come il planner intende eseguire la query senza lanciarla, e EXPLAIN ANALYZE, che invece esegue la query e ti restituisce un’analisi tra piano atteso e piano reale. In generale, un piano di esecuzione reale è quello in cui esegui davvero la query, mentre uno stimato calcola cosa farebbe senza eseguirla. Pur essendo logicamente equivalenti, un piano reale è molto più utile perché contiene dettagli aggiuntivi e statistiche su ciò che è effettivamente accaduto.
Nel resto di questa sezione, imparerai di più su EXPLAIN e ANALYZE e su come usarli per conoscere meglio il tuo piano di esecuzione e le possibili performance della query. Per farlo, vedrai alcuni esempi con due tabelle: one_million e half_million.
Puoi recuperare le informazioni correnti della tabella one_million con EXPLAIN; Mettilo subito sopra la tua query e, quando la esegui, ti restituirà il piano:
EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18584.82 rows=1025082 width=36)(1 row)In questo caso, vedi che il costo della query è 0.00..18584.82 e che il numero di righe è 1025082. La larghezza in colonne è 36.
Puoi poi aggiornare le statistiche con ANALYZE.
ANALYZE one_million;EXPLAINSELECT *FROM one_million;QUERY PLAN____________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(1 row)Oltre a EXPLAIN e ANALYZE, puoi recuperare il tempo di esecuzione reale con EXPLAIN ANALYZE:
EXPLAIN ANALYZESELECT *FROM one_million;QUERY PLAN___________________________________________________________Seq Scan on one_million(cost=0.00..18334.00 rows=1000000 width=37)(actual time=0.015..1207.019 rows=1000000 loops=1)Total runtime: 2320.146 ms(2 rows)Lo svantaggio di usare EXPLAIN ANALYZE qui è ovviamente che la query viene effettivamente eseguita, quindi fai attenzione!
Finora, l’unico algoritmo che hai visto è il Seq Scan (Sequential Scan) o Full Table Scan: è una scansione in cui ogni riga della tabella viene letta in ordine sequenziale e si verifica se le colonne soddisfano una condizione. In termini di performance, il Sequential Scan non è certo il piano migliore in circolazione, perché stai comunque facendo una scansione completa della tabella. Tuttavia, non è troppo male quando la tabella non entra in memoria: le letture sequenziali sono rapide anche con dischi lenti.
Ne vedrai di più in seguito, quando parlerai di index scan.
Esistono però altri algoritmi. Considera, ad esempio, questo piano per un join:
EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN_________________________________________________________________Hash Join (cost=15417.00..68831.00 rows=500000 width=42)(actual time=1241.471..5912.553 rows=500000 loops=1)Hash Cond: (one_million.counter = half_million.counter) -> Seq Scan on one_million (cost=0.00..18334.00 rows=1000000 width=37) (actual time=0.007..1254.027 rows=1000000 loops=1) -> Hash (cost=7213.00..7213.00 rows=500000 width=5) (actual time=1241.251..1241.251 rows=500000 loops=1) Buckets: 4096 Batches: 16 Memory Usage: 770kB -> Seq Scan on half_million (cost=0.00..7213.00 rows=500000 width=5)(actual time=0.008..601.128 rows=500000 loops=1)Total runtime: 6468.337 msVedi che l’ottimizzatore ha scelto un Hash Join! Ricorda questa operazione: ti servirà per stimare la complessità temporale della query. Per ora, nota che non c’è un indice su half_million.counter, che potresti aggiungere nel prossimo esempio:
CREATE INDEX ON half_million(counter);EXPLAIN ANALYZESELECT *FROM one_million JOIN half_millionON (one_million.counter=half_million.counter);QUERY PLAN________________________________________________________________Merge Join (cost=4.12..37650.65 rows=500000 width=42)(actual time=0.033..3272.940 rows=500000 loops=1)Merge Cond: (one_million.counter = half_million.counter) -> Index Scan using one_million_counter_idx on one_million (cost=0.00..32129.34 rows=1000000 width=37) (actual time=0.011..694.466 rows=500001 loops=1) -> Index Scan using half_million_counter_idx on half_million (cost=0.00..14120.29 rows=500000 width=5)(actual time=0.010..683.674 rows=500000 loops=1)Total runtime: 3833.310 ms(5 rows)Vedi che, creando l’indice, l’ottimizzatore ha deciso per un Merge join con Index Scan.
Nota la differenza tra index scan e full table/Sequential Scan: il primo scansiona le pagine di dati o dell’indice per trovare i record appropriati, il secondo scansiona ogni riga della tabella.
Il tempo totale si è ridotto e le performance dovrebbero essere migliori, ma ci sono due index scan, quindi la memoria diventa più importante, specialmente se la tabella non entra in memoria. In tali casi, fai prima una scansione completa dell’indice, che è una lettura sequenziale veloce e non crea problemi, ma poi hai molte letture casuali per recuperare le righe tramite il valore dell’indice. Sono proprio quelle letture casuali a essere di ordini di grandezza più lente delle sequenziali. In questi casi, il full table scan è effettivamente più veloce del full index scan.
Ora che hai dato un’occhiata al piano di esecuzione, puoi andare più a fondo e pensare alle performance in termini più formali con l’aiuto della teoria della complessità computazionale. Quest’area dell’informatica teorica si concentra, tra le altre cose, sulla classificazione dei problemi computazionali in base alla loro difficoltà; Questi problemi possono essere algoritmi, ma anche query.
Per le query, però, non le classifichi necessariamente per difficoltà, ma per il tempo di esecuzione e di restituzione dei risultati. Questo è detto complessità temporale e, per esprimerla o misurarla, puoi usare la notazione O grande.
Con la notazione O grande esprimi il runtime in termini di quanto cresce rapidamente rispetto all’input, man mano che l’input diventa arbitrariamente grande. La notazione O grande esclude coefficienti e termini di ordine inferiore, così puoi concentrarti sulla parte importante del tempo di esecuzione della query: il suo tasso di crescita. Espressa così, scartando coefficienti e termini inferiori, la complessità temporale è detta asintotica. Significa che la dimensione dell’input tende all’infinito.
Nel linguaggio dei database, la complessità misura di quanto aumenta il tempo di esecuzione di una query al crescere della dimensione delle tabelle, e quindi del database.
Nota che la dimensione del database cresce non solo con l’aggiunta di dati nelle tabelle, ma anche con la presenza stessa di indici.
Come visto, il piano di esecuzione definisce, tra le altre cose, quale algoritmo viene usato per ogni operazione, il che fa sì che ogni tempo di esecuzione di una query possa essere espresso logicamente come funzione della dimensione delle tabelle coinvolte nel piano, detta funzione di complessità. In altre parole, puoi usare la notazione O grande e il tuo piano di esecuzione per stimare la complessità e le performance.
Nelle sottosezioni seguenti, avrai un’idea generale di quattro tipi di complessità temporale e vedrai alcuni esempi di come la complessità delle query possa variare in base al contesto di esecuzione.
Dritta: gli indici sono parte della storia!
Nota, però, che esistono diversi tipi di indici, piani di esecuzione e implementazioni per vari database, quindi le complessità elencate sono molto generali e possono variare in base al tuo contesto specifico.
Un algoritmo ha tempo costante se richiede la stessa quantità di tempo indipendentemente dalla dimensione dell’input. Per una query, il tempo è costante se richiede lo stesso tempo a prescindere dalla dimensione della tabella.
Queste query non sono comuni, ma eccone un esempio:
SELECT TOP 1 t.* FROM tLa complessità è costante perché selezioni una riga arbitraria dalla tabella. Quindi la durata dovrebbe essere indipendente dalla dimensione della tabella.
Un algoritmo ha tempo lineare se il tempo di esecuzione è direttamente proporzionale alla dimensione dell’input, cioè il tempo cresce linearmente con l’aumentare dell’input. Per i database, significa che il tempo è proporzionale alla dimensione della tabella: all’aumentare delle righe, cresce il tempo della query.
Un esempio è una query con clausola WHERE su una colonna non indicizzata: servirà un full table scan o Seq Scan, con complessità O(n). Significa che ogni riga deve essere letta per trovare quella con l’ID giusto. Non hai alcun limite, quindi ogni riga va letta, anche se la prima soddisfa la condizione.
Considera anche il seguente esempio, che avrebbe complessità O(n) se non ci fosse indice su i_id:
SELECT i_id FROM item;COUNT(*) FROM TABLE;, avranno complessità O(n), perché servirà un full table scan, a meno che il conteggio totale delle righe non sia memorizzato per la tabella. In tal caso, la complessità sarebbe più simile a O(1).Strettamente legato al tempo lineare è il tempo per piani che includono join. Ecco alcuni esempi:
Ricorda: un nested join confronta ogni record di una tabella con ogni record dell’altra.
Un algoritmo ha tempo logaritmico se il tempo di esecuzione è proporzionale al logaritmo della dimensione dell’input; Per le query, significa che l’esecuzione è proporzionale al logaritmo della dimensione del database.
Questa complessità è tipica dei piani in cui si esegue un Index Scan o uno scan su indice cluster. Un indice cluster è un indice in cui il livello foglia dell’indice contiene le righe di dati reali della tabella. Un cluster è come qualsiasi altro indice: è definito su una o più colonne, che formano la chiave dell’indice. La clustering key è quindi l’insieme di colonne chiave di un indice cluster. Un cluster index scan è sostanzialmente l’operazione con cui l’RDBMS legge dall’alto verso il basso per trovare le righe nel cluster index.
Considera la query seguente, con indice su i_id, che in generale risulterebbe in complessità O(log(n)):
SELECT i_stock FROM item WHERE i_id = N; Nota che senza indice la complessità sarebbe O(n).
Un algoritmo ha tempo quadratico se il tempo di esecuzione è proporzionale al quadrato della dimensione dell’input. Ancora una volta, per i database, significa che il tempo di esecuzione di una query è proporzionale al quadrato della dimensione del database.
Un possibile esempio di query con complessità quadratica è la seguente:
SELECT * FROM item, author WHERE item.i_a_id=author.a_id La complessità minima sarebbe O(n log(n)), ma la massima potrebbe essere O(n^2), a seconda delle informazioni di indice sugli attributi di join.
Per riassumere, puoi anche consultare la seguente cheat sheet per stimare le performance delle query in base alla loro complessità temporale e a come potrebbero comportarsi:
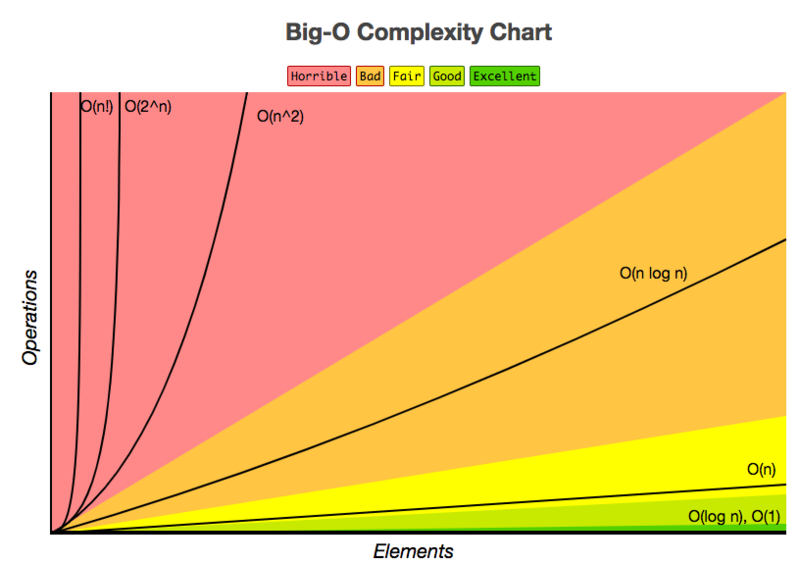
Con piano di esecuzione e complessità temporale in mente, puoi considerare di ottimizzare ulteriormente la tua query SQL. Puoi iniziare prestando particolare attenzione ai seguenti punti:
Congratulazioni! Sei arrivato alla fine di questo post, che ti ha dato una piccola anteprima delle performance delle query SQL. Speriamo tu abbia ottenuto più insight su anti-pattern, ottimizzatore e strumenti per rivedere, stimare e interpretare la complessità del piano di esecuzione. C’è però molto altro da scoprire! Se vuoi saperne di più, considera la lettura del libro “Database Management Systems”, di R. Ramakrishnan e J. Gehrke.
Infine, non voglio privarti di questa citazione di un utente StackOverflow:
“Il mio anti-pattern preferito è non testare le proprie query.
Si applica quando:
- La tua query coinvolge più di una tabella.
- Pensi di avere un design ottimale per una query, ma non ti prendi la briga di testare le tue assunzioni.
- Accetti la prima query che funziona, senza alcuna idea se sia anche lontanamente ottimizzata."
Se vuoi iniziare con SQL, prendi in considerazione questi corsi DataCamp:
Scopri di più su SQL
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min



