Kurs
Python ile Veri Bilimine Giriş
4 sa
503.4K
Duygu analizi, bir metinde ifade edilen duygusal tonu veya hissi belirlemek için kullanılan bir tekniktir. Metinde kullanılan kelime ve ifadeleri analiz ederek, altta yatan duygunun olumlu, olumsuz veya nötr olup olmadığını tespit etmeyi içerir.
Duygu analizi; sosyal medya takibi, müşteri geri bildirimi analizi ve pazar araştırması gibi geniş bir uygulama alanına sahiptir.
Duygu analizindeki temel zorluklardan biri, insan dilinin doğasında bulunan karmaşıklıktır. Metin verileri çoğu zaman alay, ironi ve geleneksel yöntemlerle yorumlanması güç başka mecazi ifadeler içerir.
Ancak, doğal dil işleme (NLP) ve makine öğrenimindeki son gelişmeler, büyük hacimli metin verileri üzerinde yüksek doğrulukla duygu analizi yapılmasını mümkün kılmıştır.
Metin verileri üzerinde farklı karmaşıklık ve doğruluk seviyelerine sahip birden fazla duygu analizi yöntemi vardır. En yaygın yöntemler; sözlük (lexicon) tabanlı yaklaşım, makine öğrenimi (ML) tabanlı yaklaşım ve önceden eğitilmiş dönüştürücü (transformer) tabanlı derin öğrenme yaklaşımıdır. Her birine biraz daha yakından bakalım:
NLTK Vader duygu analizörü gibi bu tür analizler, bir metnin duygusunu belirlemek için önceden tanımlanmış kural ve sezgilerin kullanılmasını içerir. Bu kurallar genellikle metnin olumlu veya olumsuz kelime ve ifadeler içermesi gibi sözcüksel ve sözdizimsel özelliklere dayanır.
Sözlük tabanlı analiz uygulaması ve yorumlanması görece basit olsa da, özellikle karmaşık veya muğlak metin verileriyle çalışırken ML tabanlı veya transformer tabanlı yaklaşımlar kadar doğru olmayabilir.
Bu yaklaşım, bir metnin duygusunu, etiketli bir eğitim verisi kümesine dayanarak tanıyacak bir modelin eğitilmesini içerir. Bu modeller; karar ağaçları, destek vektör makineleri (SVM) ve sinir ağları dahil olmak üzere çok çeşitli ML algoritmaları ile eğitilebilir.
ML tabanlı yaklaşımlar, özellikle karmaşık metin verileriyle uğraşırken kural tabanlı analizden daha doğru olabilir; ancak daha fazla etiketli eğitim verisi gerektirir ve hesaplama açısından daha maliyetli olabilir.
BERT ve GPT-4 gibi derin öğrenme tabanlı yaklaşımlar, çok büyük miktarda metin verisi üzerinde eğitilmiş hazır modellerin kullanılmasını içerir. Bu modeller, metnin bağlam ve anlamını kodlamak için karmaşık sinir ağları kullanır ve duygu analizi dahil çok çeşitli NLP görevlerinde son teknoloji doğruluk sağlar. Ancak bu modeller önemli hesaplama kaynakları gerektirir ve her kullanım senaryosu için pratik olmayabilir.
Hangi yaklaşımın seçileceği, eldeki projenin özel ihtiyaç ve kısıtlarına bağlı olacaktır.
NLTK kütüphanesini kullanmak için bilgisayarınızda bir Python ortamı olmalıdır. Python kurmanın en kolay yolu, Anaconda Dağıtımını indirip kurmaktır. Bu dağıtım, Python 3 temel ortamıyla birlikte Jupyter Notebook dahil olmak üzere çeşitli ek bileşenlerle gelir. Ayrıca NLTK ve diğer birçok yararlı kütüphane önceden kurulu geldiği için NLTK'yı ayrıca kurmanıza gerek yoktur.
Eğer herhangi bir dağıtım kullanmadan Python kurmayı tercih ederseniz, Python'u doğrudan python.org adresinden indirip kurabilirsiniz. Bu durumda Python ortamınız hazır olduğunda NLTK'yı ayrıca kurmanız gerekecektir.
NLTK kütüphanesini kurmak için komut satırını açın ve şunu yazın:
pip install nltkNLTK'nın etkili şekilde kullanılmadan önce bazı ek verilerin de indirilmesini gerektirdiğini belirtmek gerekir. Bu veriler, NLTK'nın çeşitli NLP görevlerini yerine getirmek için kullandığı önceden eğitilmiş modelleri, derlemleri ve diğer kaynakları içerir. Bu verileri indirmek için terminalde veya Python betiğinizde şu komutu çalıştırın:
import nltk

nltk.download('all')
Metin ön işleme, metin verilerini temizleyip normalize ederek analiz etmeyi kolaylaştırdığı için duygu analizi yapmanın kritik bir adımıdır. Ön işleme, ham metin verisini analiz için kullanılabilir bir forma dönüştürmeye yardımcı olan bir dizi teknikten oluşur. Yaygın ön işleme teknikleri arasında tokenleştirme, durak kelime (stop word) kaldırma, kök bulma (stemming) ve gövdeleme (lemmatization) bulunur.
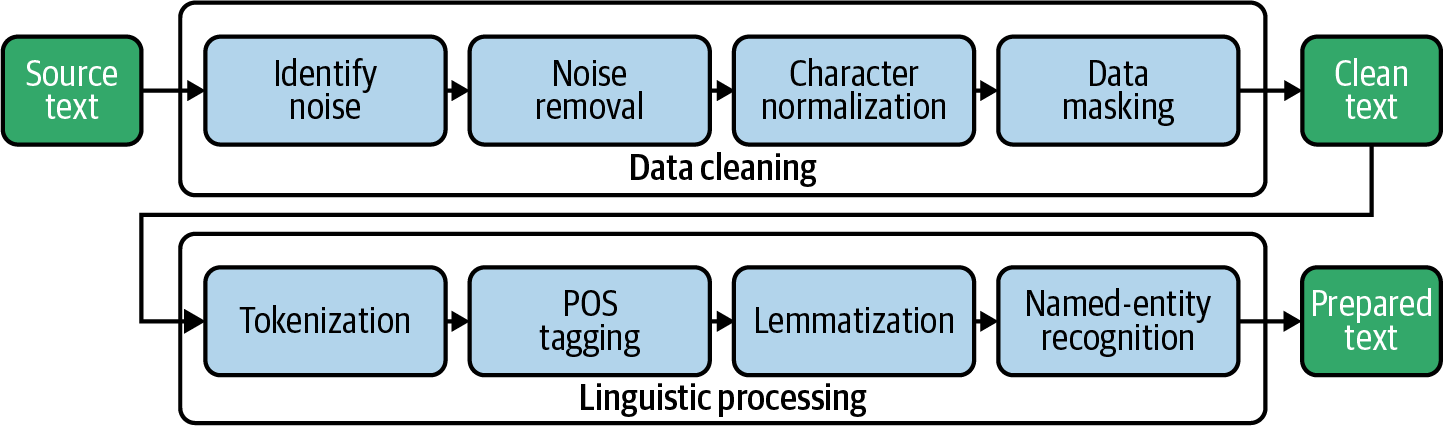
Tokenleştirme, metni tek tek kelimelere veya belirteçlere (token) ayırmayı içeren bir metin ön işleme adımıdır. Bu adım, ham metinden bireysel kelimeleri ayırmaya yardımcı olduğu için metin verilerini analiz etmede temel öneme sahiptir ve analizi kolaylaştırır. Tokenleştirme genellikle NLTK'nın metni tek tek kelimelere ve noktalama işaretlerine ayırabilen word_tokenize fonksiyonu ile yapılır.
Durak kelimeleri kaldırma, genellikle çok az anlam taşıyan yaygın ve ilgisiz kelimeleri çıkarmayı içeren kritik bir ön işleme adımıdır. Durak kelimeler; "and", "the", "of" ve "it" gibi bir dilde çok sık geçen ve fazla anlam taşımayan kelimelerdir. Bu kelimeler kaldırılmazsa gürültüye neden olabilir ve analizi yanıltabilir.
Durak kelimeler kaldırıldığında, metinde kalan kelimeler ifade edilen duyguyu belirtme olasılığı daha yüksek olur. Bu da duygu analizinin doğruluğunu artırmaya yardımcı olabilir. NLTK, çeşitli diller için yerleşik durak kelime listeleri sağlar ve bu listeler metin verilerinden bu kelimeleri filtrelemek için kullanılabilir.
Stemming ve lemmatization, kelimeleri kök formlarına indirgemek için kullanılan tekniklerdir. Stemming, kelimelerden "ing" veya "ed" gibi son ekleri kaldırarak taban forma indirgemeyi içerir. Örneğin, "jumping" kelimesi "jump" haline getirilir.
Lemmatization ise, kelimeleri sözcük türlerine (part of speech) bağlı olarak temel formlarına indirger. Örneğin, "jumped" kelimesi "jump" olarak lemmatize edilirken, "jumping" bir şimdiki zaman ortaç (present participle) olduğu için "jumping" olarak kalabilir.
Stemming ve lemmatization hakkında daha fazla bilgi için Python'da Stemming ve Lemmatization eğitimimize göz atın.
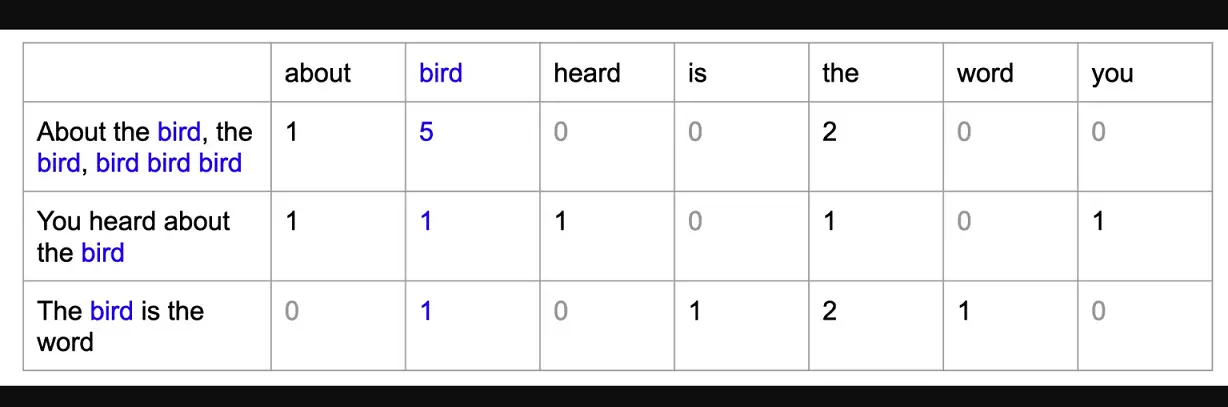
Kelimelerin torbası modeli, metin verilerini sayısal özellikler kümesi olarak temsil etmek için kullanılan bir doğal dil işleme (NLP) tekniğidir. Bu modelde, her belge veya metin parçası bir "kelime torbası" olarak temsil edilir; metindeki her kelime, ortaya çıkan vektörde ayrı bir özellik veya boyutla temsil edilir. Her bir özelliğin değeri, ilgili kelimenin metinde kaç kez geçtiğine göre belirlenir.
Kelimelerin torbası modeli, metin verilerini genellikle sayısal girdiler bekleyen makine öğrenimi algoritmalarıyla analiz etmemizi sağladığı için NLP'de kullanışlıdır. Metin verilerini sayısal özellikler olarak temsil ederek, makine öğrenimi modellerini metni sınıflandırmak veya duyguları analiz etmek için eğitebiliriz.
Bir sonraki bölümdeki örnekte, Amazon müşteri veri kümesi üzerinde duygu analizi için NLTK Vader modeli kullanılacaktır. Bu örnekte, NLTK Vader API'si girdi olarak sayısal vektörler yerine metin kabul ettiğinden bu adımı uygulamamız gerekmez; ancak duyguyu tahmin etmek için gözetimli bir makine öğrenimi modeli kuruyor olsaydınız (etiketli veriye sahip olduğunuzu varsayarak), modeli eğitmeden önce işlenmiş metni bir kelimelerin torbası modeline dönüştürmeniz gerekirdi.
Python'da NLTK kullanarak duygu analizi yapmak için, metin verileri önce tokenleştirme, durak kelime kaldırma ve stemming veya lemmatization gibi tekniklerle ön işlenmelidir. Metin ön işlemden geçirildikten sonra, metnin duygusunu (olumlu veya olumsuz) analiz etmek için Vader duygu analizörüne aktaracağız.
Önce, veri işleme için pandas, doğal dil işleme için nltk ve duygu analizi için SentimentIntensityAnalyzer gibi metin ve duygu analizi için gerekli kütüphaneleri içe aktaracağız.
Ardından, nltk.download() kullanarak tüm NLTK derlemlerini (dilbilimsel veri koleksiyonu) indireceğiz.
Ortam kurulduktan sonra, pd.read_csv() ile Amazon yorumlarından oluşan bir veri kümesi yükleyeceğiz. Bu, verileri analiz etmek için kullanabileceğimiz bir DataFrame nesnesi oluşturacaktır. İçeriği df ile görüntüleyeceğiz.
# import libraries
import pandas as pd

import nltk

from nltk.sentiment.vader import SentimentIntensityAnalyzer

from nltk.corpus import stopwords

from nltk.tokenize import word_tokenize

from nltk.stem import WordNetLemmatizer


# download nltk corpus (first time only)
import nltk

nltk.download('all')


# Load the amazon review dataset

df = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/amazon.csv')

df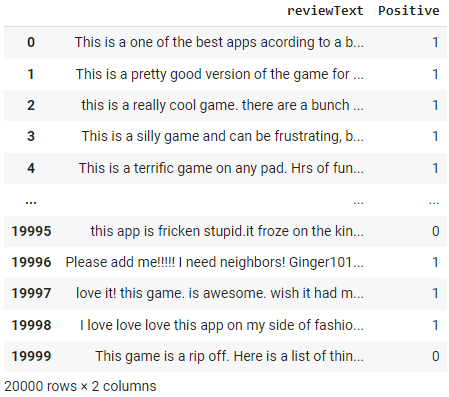
preprocess_text adlı bir fonksiyon oluşturalım. Bu fonksiyonda önce NLTK'nın word_tokenize fonksiyonuyla belgeleri tokenleştirecek, sonra NLTK'nın stepwords modülünü kullanarak durak kelimeleri kaldıracak ve son olarak NLTK'dan WordNetLemmatizer ile filtered_tokens üzerinde lemmatization uygulayacağız.
# create preprocess_text function
def preprocess_text(text):

    # Tokenize the text

    tokens = word_tokenize(text.lower())


    # Remove stop words

    filtered_tokens = [token for token in tokens if token not in stopwords.words('english')]


    # Lemmatize the tokens

    lemmatizer = WordNetLemmatizer()

    lemmatized_tokens = [lemmatizer.lemmatize(token) for token in filtered_tokens]


    # Join the tokens back into a string

    processed_text = ' '.join(lemmatized_tokens)

    return processed_text

# apply the function df

df['reviewText'] = df['reviewText'].apply(preprocess_text)
df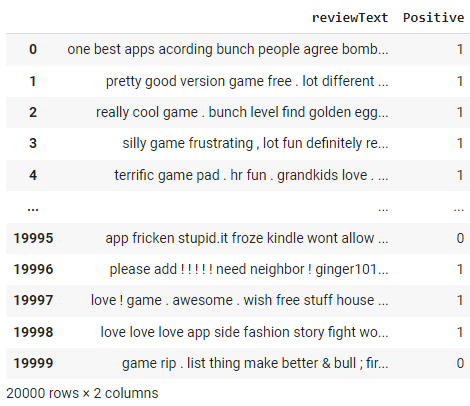
Yukarıdaki adımda uyguladığımız preprocess_text fonksiyonunun sonucu olarak "review text" sütunundaki değişikliklere dikkat edin.
Önce, nltk.sentiment.vader kütüphanesinden bir Duygu Yoğunluğu Analizörü nesnesi başlatacağız.
Sonra, girdi olarak bir metin dizesi alan get_sentiment adlı bir fonksiyon tanımlayacağız. Fonksiyon, analizör nesnesinin polarity_scores yöntemini çağırarak metin için olumlu, olumsuz ve nötr duygu puanlarını içeren bir sözlük elde eder.
Ardından fonksiyon, olumlu puanın 0'dan büyük olup olmadığını kontrol eder; büyükse duygu puanı olarak 1, değilse 0 döndürür. Bu, olumlu puanı 0'dan büyük olan her metnin olumlu; olumlu puanı pozitif olmayan her metnin ise olumsuz olarak sınıflandırılacağı anlamına gelir.
Son olarak, apply yöntemiyle df DataFrame'inin reviewText sütununa get_sentiment fonksiyonunu uygulayacağız. Bu işlem, her yorum için duygu puanını saklayan sentiment adlı yeni bir sütun oluşturur. Güncellenmiş DataFrame'i df ile görüntüleyeceğiz.
# initialize NLTK sentiment analyzer

analyzer = SentimentIntensityAnalyzer()


# create get_sentiment function

def get_sentiment(text):

    scores = analyzer.polarity_scores(text)

    sentiment = 1 if scores['pos'] > 0 else 0

    return sentiment


# apply get_sentiment function

df['sentiment'] = df['reviewText'].apply(get_sentiment)

df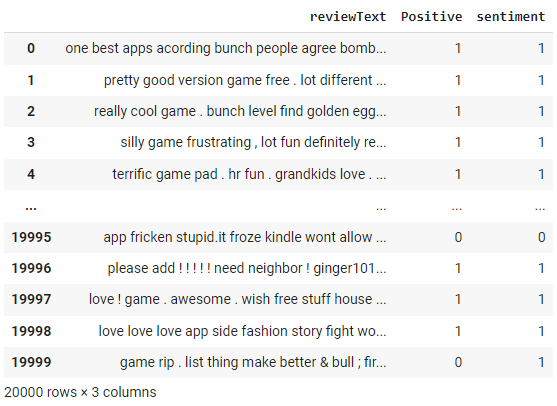
NLTK duygu analizörü -1 ile +1 arasında bir puan döndürür. Yukarıdaki get_sentiment fonksiyonunda eşik değeri olarak 0 kullandık. 0'ın üzerindeki her şey 1 (olumlu) olarak sınıflandırılır. Gerçek etiketlere sahip olduğumuz için, bu yöntemin performansını bir karmaşıklık matrisi oluşturarak değerlendirebiliriz.
from sklearn.metrics import confusion_matrix

print(confusion_matrix(df['Positive'], df['sentiment']))Çıktı:
[[ 1131  3636]

 [  576 14657]]
Sınıflandırma raporunu da inceleyebiliriz:
from sklearn.metrics import classification_report

print(classification_report(df['Positive'], df['sentiment']))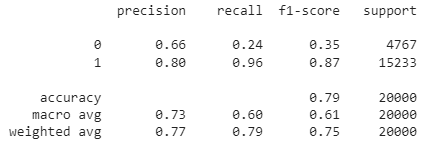
Görüldüğü gibi, bu kural tabanlı duygu analizi modelinin genel doğruluğu %79'dur. Veriler etiketli olduğu için, ML tabanlı bir yaklaşımın daha iyi doğruluk sağlayıp sağlamayacağını değerlendirmek amacıyla bir ML modeli de kurmayı deneyebilirsiniz.
Tam not defterine Datacamp workspace üzerinden göz atın.
NLTK, Python'da duygu analizi ve diğer doğal dil işleme görevleri için güçlü ve esnek bir kütüphanedir. NLTK'yı kullanarak metin verilerini ön işleyebilir, kelimelerin torbası modeline dönüştürebilir ve Vader duygu analizörüyle duygu analizi yapabiliriz.
Bu eğitimde, NLTK ile duygu analizinin temellerini; metin verilerinin ön işlenmesini, bir kelimelerin torbası modeli oluşturmayı ve NLTK Vader kullanarak duygu analizi yapmayı ele aldık. Ayrıca NLTK duygu analizinin avantaj ve sınırlamalarını tartıştık ve daha fazla okuma ve keşif için öneriler sunduk.
Genel olarak NLTK, Python'da duygu analizi ve diğer doğal dil işleme görevleri için güçlü ve yaygın kullanılan bir araçtır. Bu eğitimde sunulan teknik ve araçlarda ustalaşarak, metin verilerinin duygusuna dair değerli içgörüler elde edebilir ve bu içgörüleri çok çeşitli uygulamalarda veri odaklı kararlar almak için kullanabilirsiniz.
NLTK, scikit-learn, spaCy ve SpeechRecognition dahil Python kütüphane ve çerçevelerini kullanarak TED konuşmaları, makaleler ve film yorumları gibi gerçek dünya verilerine NLP uygulamayı öğrenmek istiyorsanız, aşağıdaki kaynaklara göz atın:
Python kullanarak metin verilerini işleme ve analiz etme konusunda sağlam bir temel sunar. NLP'ye yeni başlıyor olun ya da becerilerinizi geliştirmek istiyor olun, bu kurs yapılandırılmamış verileri değerli içgörülere dönüştürmeniz için gereken araç ve bilgileri sağlayacaktır.
Python Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




