Khóa học
Nhập môn Khoa học Dữ liệu với Python
4 giờ
504.2K
Phân tích cảm xúc là kỹ thuật dùng để xác định sắc thái cảm xúc hay thái độ được biểu đạt trong văn bản. Kỹ thuật này phân tích các từ và cụm từ được sử dụng để nhận diện cảm xúc ngầm, dù là tích cực, tiêu cực hay trung tính.
Phân tích cảm xúc có phạm vi ứng dụng rộng, bao gồm giám sát mạng xã hội, phân tích phản hồi khách hàng và nghiên cứu thị trường.
Một trong những thách thức chính của phân tích cảm xúc là sự phức tạp vốn có của ngôn ngữ tự nhiên. Dữ liệu văn bản thường chứa châm biếm, mỉa mai và các biện pháp tu từ khác khó diễn giải bằng các phương pháp truyền thống.
Tuy vậy, các tiến bộ gần đây trong xử lý ngôn ngữ tự nhiên (NLP) và học máy đã giúp có thể thực hiện phân tích cảm xúc trên khối lượng lớn dữ liệu văn bản với độ chính xác cao.
Có nhiều cách để thực hiện phân tích cảm xúc trên dữ liệu văn bản, với các mức độ phức tạp và độ chính xác khác nhau. Các phương pháp phổ biến nhất gồm cách tiếp cận dựa trên từ điển (lexicon), dựa trên học máy (ML) và dựa trên học sâu transformers đã được huấn luyện sẵn. Hãy xem chi tiết từng phương pháp:
Kiểu phân tích này, như bộ phân tích cảm xúc Vader của NLTK, sử dụng tập các quy tắc và heuristic được định nghĩa sẵn để xác định cảm xúc của văn bản. Các quy tắc thường dựa trên đặc trưng từ vựng và cú pháp, như sự xuất hiện của các từ và cụm từ tích cực hoặc tiêu cực.
Dù phân tích dựa trên từ điển tương đối đơn giản để triển khai và diễn giải, nó có thể không chính xác bằng các phương pháp dựa trên ML hoặc transformers, đặc biệt khi xử lý dữ liệu văn bản phức tạp hoặc mơ hồ.
Cách tiếp cận này huấn luyện một mô hình để nhận diện cảm xúc của văn bản dựa trên tập dữ liệu huấn luyện đã gán nhãn. Các mô hình có thể được huấn luyện bằng nhiều thuật toán ML, bao gồm cây quyết định, máy vectơ hỗ trợ (SVM) và mạng nơ-ron.
Các phương pháp dựa trên ML có thể chính xác hơn phân tích theo luật, đặc biệt khi xử lý văn bản phức tạp, nhưng yêu cầu lượng dữ liệu huấn luyện đã gán nhãn lớn hơn và có thể tốn kém tài nguyên tính toán.
Một cách tiếp cận dựa trên học sâu, như với BERT và GPT-4, sử dụng các mô hình đã được huấn luyện trên lượng dữ liệu văn bản khổng lồ. Các mô hình này dùng mạng nơ-ron phức tạp để mã hóa ngữ cảnh và ý nghĩa của văn bản, cho phép đạt độ chính xác hàng đầu trên nhiều tác vụ NLP, bao gồm phân tích cảm xúc. Tuy nhiên, các mô hình này đòi hỏi tài nguyên tính toán đáng kể và có thể không phù hợp cho mọi trường hợp sử dụng.
Lựa chọn phương pháp phụ thuộc vào nhu cầu và ràng buộc cụ thể của dự án.
Để dùng thư viện NLTK, bạn cần có môi trường Python trên máy. Cách đơn giản nhất là tải và cài Anaconda Distribution. Bản phân phối này đi kèm môi trường nền Python 3 và nhiều công cụ tiện ích, bao gồm Jupyter Notebook. Bạn cũng không cần cài NLTK vì Anaconda đã tích hợp sẵn NLTK và nhiều thư viện hữu ích khác.
Nếu bạn chọn cài Python không qua bản phân phối, có thể tải và cài trực tiếp từ python.org. Khi đó, bạn sẽ cần cài NLTK sau khi môi trường Python sẵn sàng.
Để cài thư viện NLTK, mở terminal và gõ:
pip install nltkLưu ý NLTK cũng cần tải thêm một số dữ liệu trước khi sử dụng hiệu quả. Dữ liệu này gồm các mô hình huấn luyện sẵn, corpora và tài nguyên khác mà NLTK dùng để thực hiện các tác vụ NLP. Để tải dữ liệu, chạy lệnh sau trong terminal hoặc script Python của bạn:
import nltk

nltk.download('all')
Tiền xử lý văn bản là bước then chốt trong phân tích cảm xúc, giúp làm sạch và chuẩn hóa dữ liệu văn bản để dễ phân tích hơn. Bước này gồm chuỗi kỹ thuật nhằm biến đổi văn bản thô thành dạng có thể dùng cho phân tích. Một số kỹ thuật phổ biến gồm tách từ (tokenization), loại bỏ từ dừng (stop words), stemming và lemmatization.
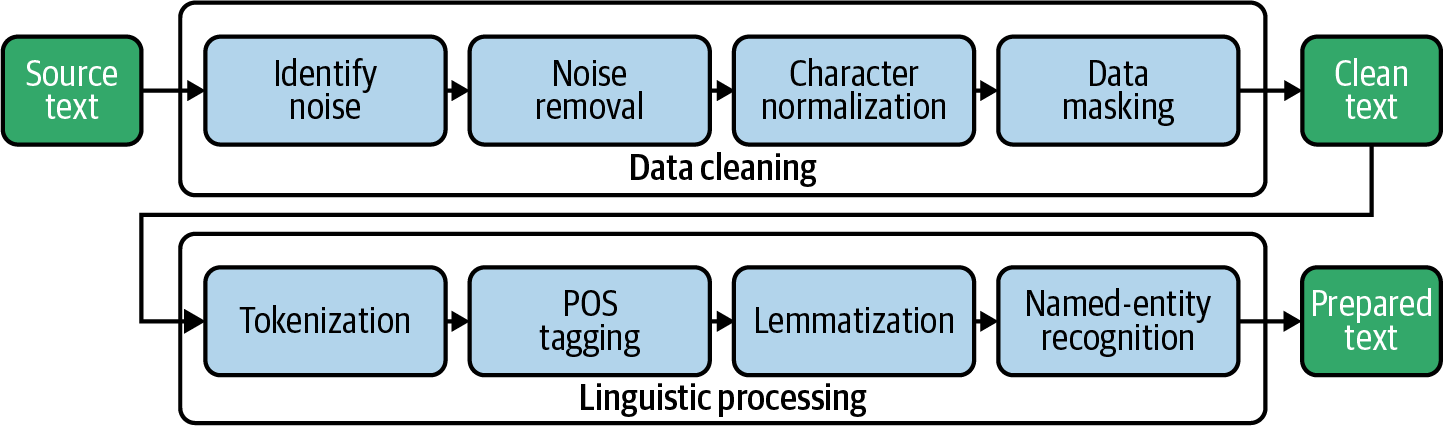
Tokenization là bước tiền xử lý trong phân tích cảm xúc nhằm chia văn bản thành các từ hoặc token riêng lẻ. Đây là bước quan trọng giúp tách các từ khỏi văn bản thô, khiến việc phân tích và hiểu dữ liệu trở nên dễ dàng hơn. Thông thường, tokenization được thực hiện bằng hàm word_tokenize tích hợp trong NLTK, có thể tách văn bản thành từng từ và dấu câu.
Loại bỏ từ dừng là bước quan trọng nhằm loại đi những từ phổ biến và không liên quan, ít khả năng truyền tải cảm xúc. Từ dừng là các từ rất thông dụng trong ngôn ngữ và không mang nhiều ý nghĩa, như "and", "the", "of" và "it". Nếu không loại bỏ, chúng có thể gây nhiễu và làm lệch kết quả phân tích.
Bằng cách loại bỏ từ dừng, các từ còn lại trong văn bản có nhiều khả năng phản ánh cảm xúc được biểu đạt. Điều này giúp cải thiện độ chính xác của phân tích cảm xúc. NLTK cung cấp sẵn danh sách từ dừng cho nhiều ngôn ngữ, có thể dùng để lọc các từ này khỏi dữ liệu văn bản.
Stemming và lemmatization là các kỹ thuật dùng để đưa từ về dạng gốc. Stemming loại bỏ hậu tố của từ, như "ing" hoặc "ed", để đưa về dạng cơ sở. Ví dụ, "jumping" sẽ được rút gọn thành "jump".
Lemmatization thì đưa từ về dạng gốc dựa trên loại từ (part of speech). Ví dụ, "jumped" sẽ được đưa về "jump", nhưng "jumping" có thể được giữ là "jumping" vì là hiện tại phân từ.
Để tìm hiểu thêm về stemming và lemmatization, xem hướng dẫn Stemming và Lemmatization trong Python của chúng tôi.
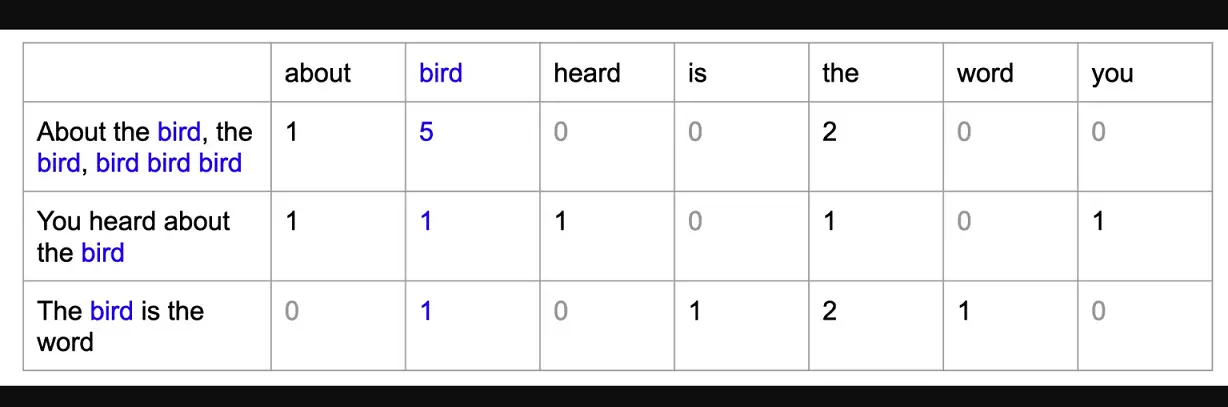
Mô hình bag of words là kỹ thuật trong xử lý ngôn ngữ tự nhiên (NLP) để biểu diễn dữ liệu văn bản dưới dạng các đặc trưng số. Trong mô hình này, mỗi tài liệu hay đoạn văn bản được biểu diễn như một "túi" từ, với mỗi từ là một đặc trưng hoặc chiều trong vector kết quả. Giá trị của mỗi đặc trưng được xác định bởi số lần từ tương ứng xuất hiện trong văn bản.
Mô hình bag of words hữu ích vì cho phép chúng ta phân tích văn bản bằng các thuật toán học máy, vốn thường yêu cầu đầu vào dạng số. Bằng cách biểu diễn văn bản dưới dạng đặc trưng số, ta có thể huấn luyện mô hình học máy để phân loại văn bản hoặc phân tích cảm xúc.
Ví dụ ở phần tiếp theo sẽ dùng mô hình NLTK Vader để phân tích cảm xúc trên bộ dữ liệu khách hàng Amazon. Trong ví dụ này, chúng ta không cần thực hiện bước BoW vì API Vader của NLTK nhận đầu vào là văn bản thay vì vector số, nhưng nếu bạn xây dựng mô hình học máy có giám sát để dự đoán cảm xúc (giả sử có dữ liệu gán nhãn), bạn sẽ phải chuyển văn bản đã xử lý sang mô hình bag of words trước khi huấn luyện.
Để thực hiện phân tích cảm xúc bằng NLTK trong Python, trước tiên cần tiền xử lý dữ liệu văn bản bằng các kỹ thuật như tokenization, loại bỏ từ dừng và stemming hoặc lemmatization. Sau khi tiền xử lý, chúng ta sẽ chuyển văn bản tới bộ phân tích cảm xúc Vader để xác định cảm xúc (tích cực hoặc tiêu cực).
Trước hết, chúng ta sẽ import các thư viện cần thiết cho phân tích văn bản và phân tích cảm xúc, như pandas để xử lý dữ liệu, nltk cho NLP và SentimentIntensityAnalyzer để phân tích cảm xúc.
Tiếp theo, chúng ta sẽ tải toàn bộ corpus của NLTK (tập dữ liệu ngôn ngữ) bằng nltk.download().
Khi môi trường đã sẵn sàng, chúng ta sẽ tải bộ dữ liệu đánh giá Amazon bằng pd.read_csv(). Thao tác này tạo một đối tượng DataFrame trong Python để phân tích dữ liệu. Chúng ta sẽ hiển thị nội dung DataFrame bằng df.
# import libraries
import pandas as pd

import nltk

from nltk.sentiment.vader import SentimentIntensityAnalyzer

from nltk.corpus import stopwords

from nltk.tokenize import word_tokenize

from nltk.stem import WordNetLemmatizer


# download nltk corpus (first time only)
import nltk

nltk.download('all')


# Load the amazon review dataset

df = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/amazon.csv')

df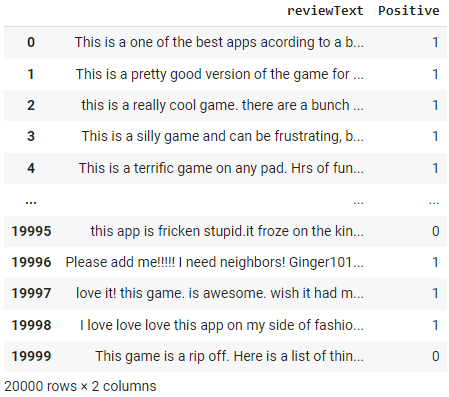
Hãy tạo hàm preprocess_text trong đó chúng ta trước tiên tách token cho tài liệu bằng hàm word_tokenize của NLTK, sau đó loại bỏ từ dừng bằng module stepwords của NLTK và cuối cùng lemmatize filtered_tokens bằng WordNetLemmatizer của NLTK.
# create preprocess_text function
def preprocess_text(text):

    # Tokenize the text

    tokens = word_tokenize(text.lower())


    # Remove stop words

    filtered_tokens = [token for token in tokens if token not in stopwords.words('english')]


    # Lemmatize the tokens

    lemmatizer = WordNetLemmatizer()

    lemmatized_tokens = [lemmatizer.lemmatize(token) for token in filtered_tokens]


    # Join the tokens back into a string

    processed_text = ' '.join(lemmatized_tokens)

    return processed_text

# apply the function df

df['reviewText'] = df['reviewText'].apply(preprocess_text)
df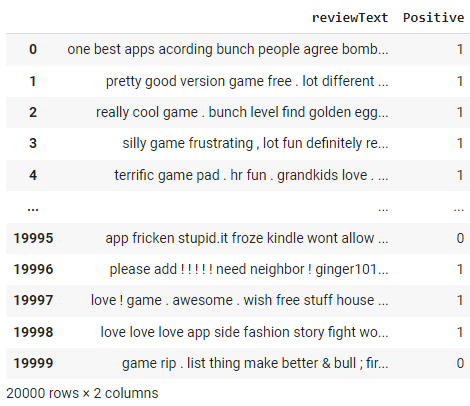
Lưu ý các thay đổi trong cột "review text" là kết quả của hàm preprocess_text mà chúng ta đã áp dụng ở bước trên.
Đầu tiên, chúng ta sẽ khởi tạo một đối tượng Sentiment Intensity Analyzer từ thư viện nltk.sentiment.vader.
Tiếp theo, chúng ta sẽ định nghĩa hàm get_sentiment nhận chuỗi văn bản làm đầu vào. Hàm này gọi phương thức polarity_scores của đối tượng analyzer để lấy một dictionary điểm cảm xúc cho văn bản, bao gồm điểm cho cảm xúc tích cực, tiêu cực và trung tính.
Hàm sẽ kiểm tra xem điểm tích cực có lớn hơn 0 không và trả về điểm cảm xúc là 1 nếu có, ngược lại là 0. Điều này có nghĩa mọi văn bản có điểm tích cực lớn hơn 0 sẽ được phân loại là tích cực, còn văn bản có điểm không dương sẽ được phân loại là tiêu cực.
Cuối cùng, chúng ta sẽ áp dụng hàm get_sentiment lên cột reviewText của DataFrame df bằng phương thức apply. Điều này tạo cột mới tên sentiment trong DataFrame, lưu điểm cảm xúc cho mỗi đánh giá. Sau đó, chúng ta sẽ hiển thị DataFrame đã cập nhật bằng df.
# initialize NLTK sentiment analyzer

analyzer = SentimentIntensityAnalyzer()


# create get_sentiment function

def get_sentiment(text):

    scores = analyzer.polarity_scores(text)

    sentiment = 1 if scores['pos'] > 0 else 0

    return sentiment


# apply get_sentiment function

df['sentiment'] = df['reviewText'].apply(get_sentiment)

df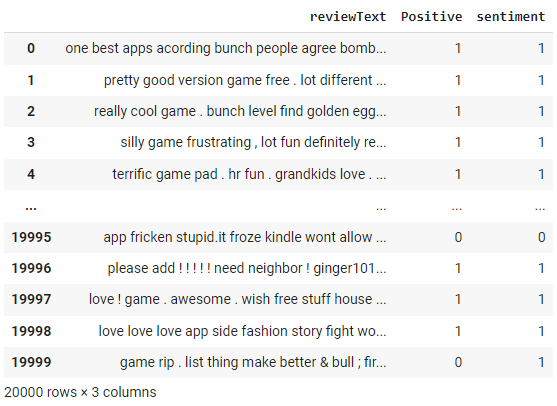
Bộ phân tích cảm xúc của NLTK trả về điểm trong khoảng -1 đến +1. Chúng ta đã dùng ngưỡng cắt là 0 trong hàm get_sentiment ở trên. Bất cứ giá trị lớn hơn 0 được phân loại là 1 (tức tích cực). Vì có nhãn thực, chúng ta có thể đánh giá hiệu năng phương pháp này bằng cách xây dựng ma trận nhầm lẫn.
from sklearn.metrics import confusion_matrix

print(confusion_matrix(df['Positive'], df['sentiment']))
Đầu ra:
[[ 1131  3636]

 [  576 14657]]
Chúng ta cũng có thể xem báo cáo phân loại:
from sklearn.metrics import classification_report

print(classification_report(df['Positive'], df['sentiment']))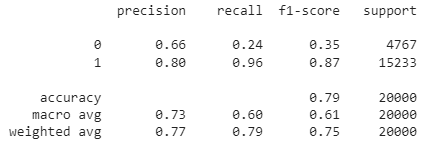
Như bạn thấy, độ chính xác tổng thể của mô hình phân tích cảm xúc dựa trên luật này là 79%. Vì đây là dữ liệu đã gán nhãn, bạn cũng có thể thử xây dựng mô hình ML để xem liệu cách tiếp cận dựa trên ML có cho độ chính xác tốt hơn không.
Xem toàn bộ notebook trên Datacamp workspace.
NLTK là thư viện mạnh mẽ và linh hoạt để thực hiện phân tích cảm xúc và các tác vụ NLP khác trong Python. Với NLTK, chúng ta có thể tiền xử lý văn bản, chuyển đổi thành mô hình bag of words, và thực hiện phân tích cảm xúc bằng bộ phân tích Vader.
Qua hướng dẫn này, chúng ta đã khám phá những điều căn bản của phân tích cảm xúc với NLTK, bao gồm tiền xử lý văn bản, tạo mô hình bag of words và thực hiện phân tích cảm xúc bằng NLTK Vader. Chúng ta cũng đã thảo luận ưu và nhược điểm của phân tích cảm xúc với NLTK, đồng thời gợi ý tài liệu để đọc và khám phá thêm.
Tổng quan, NLTK là công cụ mạnh và được sử dụng rộng rãi cho phân tích cảm xúc và các tác vụ NLP khác trong Python. Bằng cách nắm vững các kỹ thuật và công cụ được trình bày trong hướng dẫn này, bạn có thể thu được insight giá trị về cảm xúc trong dữ liệu văn bản và dùng chúng để đưa ra quyết định dựa trên dữ liệu trong nhiều ứng dụng khác nhau.
Nếu bạn muốn học cách áp dụng NLP lên dữ liệu thực tế, bao gồm các bài TED, bài báo và đánh giá phim, bằng các thư viện và framework Python như NLTK, scikit-learn, spaCy và SpeechRecognition, hãy xem các tài nguyên dưới đây:
Khóa học này cung cấp nền tảng vững chắc để xử lý và phân tích dữ liệu văn bản bằng Python. Dù bạn mới bắt đầu với NLP hay muốn mở rộng kỹ năng, khóa học sẽ trang bị cho bạn công cụ và kiến thức để chuyển đổi dữ liệu phi cấu trúc thành insight giá trị.
Khóa học Python
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
