कोर्स
Python में Data Science परिचय
4 घंटा
503.5K
सेंटिमेंट एनालिसिस एक ऐसी तकनीक है जिसका उपयोग किसी टेक्स्ट में व्यक्त भावनात्मक स्वर या भावना का निर्धारण करने के लिए किया जाता है। इसमें टेक्स्ट में प्रयुक्त शब्दों और वाक्यांशों का विश्लेषण करके अंतर्निहित भावना की पहचान की जाती है, चाहे वह सकारात्मक हो, नकारात्मक हो या तटस्थ।
सेंटिमेंट एनालिसिस के कई उपयोग हैं, जिनमें सोशल मीडिया मॉनिटरिंग, ग्राहक फीडबैक विश्लेषण और मार्केट रिसर्च शामिल हैं।
सेंटिमेंट एनालिसिस की मुख्य चुनौतियों में से एक मानवीय भाषा की अंतर्निहित जटिलता है। टेक्स्ट डेटा में अक्सर व्यंग्य, तंज और अन्य आलंकारिक शैलियाँ होती हैं जिन्हें पारंपरिक तरीकों से समझना कठिन हो सकता है।
हालांकि, नैचुरल लैंग्वेज प्रोसेसिंग (NLP) और मशीन लर्निंग में हालिया प्रगति के चलते बड़े पैमाने पर टेक्स्ट डेटा पर उच्च सटीकता के साथ सेंटिमेंट एनालिसिस करना संभव हो गया है।
टेक्स्ट डेटा पर सेंटिमेंट एनालिसिस करने के कई तरीके हैं, जिनकी जटिलता और सटीकता अलग-अलग होती है। सबसे सामान्य तरीकों में लेक्सिकॉन-आधारित दृष्टिकोण, मशीन लर्निंग (ML) आधारित दृष्टिकोण और प्री-ट्रेन्ड ट्रांसफॉर्मर-आधारित डीप लर्निंग दृष्टिकोण शामिल हैं। आइए प्रत्येक को विस्तार से देखें:
इस प्रकार का विश्लेषण, जैसे NLTK का Vader सेंटिमेंट एनालाइज़र, किसी टेक्स्ट के सेंटिमेंट का निर्धारण करने के लिए पूर्व-निर्धारित नियमों और ह्यूरिस्टिक्स के सेट का उपयोग करता है। ये नियम सामान्यतः टेक्स्ट की लेक्सिकल और सिंटैक्टिक विशेषताओं पर आधारित होते हैं, जैसे सकारात्मक या नकारात्मक शब्दों और वाक्यांशों की उपस्थिति।
लेक्सिकॉन-आधारित विश्लेषण लागू करने और समझने में अपेक्षाकृत सरल हो सकता है, लेकिन जटिल या संदिग्ध टेक्स्ट डेटा के मामले में यह ML-आधारित या ट्रांसफॉर्मर-आधारित तरीकों जितना सटीक नहीं हो सकता।
यह दृष्टिकोण लेबल किए गए प्रशिक्षण डेटा के आधार पर टेक्स्ट के सेंटिमेंट की पहचान करने के लिए एक मॉडल को प्रशिक्षित करने पर आधारित है। इन मॉडलों को विभिन्न ML एल्गोरिद्म जैसे डिसिजन ट्री, सपोर्ट वेक्टर मशीन (SVMs) और न्यूरल नेटवर्क का उपयोग करके प्रशिक्षित किया जा सकता है।
ML-आधारित दृष्टिकोण, विशेषकर जटिल टेक्स्ट डेटा के मामले में, नियम-आधारित विश्लेषण की तुलना में अधिक सटीक हो सकते हैं, लेकिन इन्हें अधिक मात्रा में लेबल्ड प्रशिक्षण डेटा की आवश्यकता होती है और ये अधिक कंप्यूटेशनल संसाधन मांग सकते हैं।
BERT और GPT-4 जैसे मॉडलों में दिखे डीप लर्निंग-आधारित दृष्टिकोण में विशाल टेक्स्ट डेटा पर प्रशिक्षित प्री-ट्रेन्ड मॉडलों का उपयोग किया जाता है। ये मॉडल टेक्स्ट के संदर्भ और अर्थ को एन्कोड करने के लिए जटिल न्यूरल नेटवर्क का उपयोग करते हैं, जिससे वे सेंटिमेंट एनालिसिस सहित विभिन्न NLP कार्यों पर अत्याधुनिक सटीकता प्राप्त कर पाते हैं। हालांकि, इन मॉडलों को महत्वपूर्ण कंप्यूटेशनल संसाधनों की आवश्यकता होती है और ये हर उपयोग-प्रकरण के लिए व्यावहारिक नहीं होते।
कौन-सा तरीका चुनना है, यह आपके प्रोजेक्ट की विशिष्ट आवश्यकताओं और सीमाओं पर निर्भर करेगा।
NLTK लाइब्रेरी का उपयोग करने के लिए आपके कंप्यूटर पर Python वातावरण होना चाहिए। Python इंस्टॉल करने का सबसे आसान तरीका है Anaconda Distribution डाउनलोड और इंस्टॉल करना। इस डिस्ट्रीब्यूशन में Python 3 बेस वातावरण और अन्य सुविधाएँ, जैसे Jupyter Notebook, शामिल हैं। आपको NLTK लाइब्रेरी अलग से इंस्टॉल करने की आवश्यकता भी नहीं है, क्योंकि इसमें NLTK और कई अन्य उपयोगी लाइब्रेरियाँ पहले से आती हैं।
यदि आप किसी डिस्ट्रीब्यूशन के बिना Python इंस्टॉल करना चुनते हैं, तो आप सीधे python.org से Python डाउनलोड और इंस्टॉल कर सकते हैं। इस स्थिति में, Python वातावरण तैयार होने के बाद आपको NLTK इंस्टॉल करना होगा।
NLTK लाइब्रेरी इंस्टॉल करने के लिए, कमांड टर्मिनल खोलें और टाइप करें:
pip install nltkध्यान देने योग्य बात यह है कि NLTK को प्रभावी ढंग से उपयोग करने से पहले कुछ अतिरिक्त डेटा भी डाउनलोड करना पड़ता है। इसमें प्री-ट्रेन्ड मॉडल, कॉर्पोरा और अन्य संसाधन शामिल हैं जिनका उपयोग NLTK विभिन्न NLP कार्यों के लिए करता है। यह डेटा डाउनलोड करने के लिए, टर्मिनल या अपनी Python स्क्रिप्ट में निम्न कमांड चलाएँ:
import nltk

nltk.download('all')
टेक्स्ट प्रीप्रोसेसिंग सेंटिमेंट एनालिसिस करने का एक अहम कदम है, क्योंकि यह टेक्स्ट डेटा को साफ और सामान्यीकृत करता है, जिससे उसका विश्लेषण करना आसान हो जाता है। प्रीप्रोसेसिंग में कई तकनीकें शामिल होती हैं जो कच्चे टेक्स्ट डेटा को विश्लेषण के योग्य रूप में बदलती हैं। कुछ सामान्य तकनीकें हैं टोकनाइज़ेशन, स्टॉप वर्ड हटाना, स्टेमिंग और लेमाटाइज़ेशन।
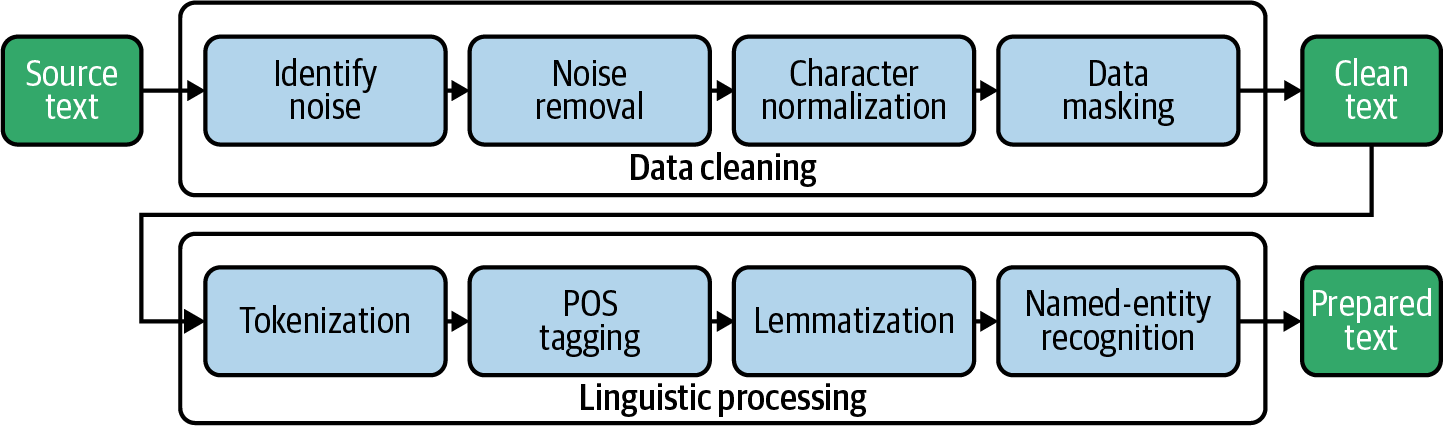
टोकनाइज़ेशन सेंटिमेंट एनालिसिस में टेक्स्ट प्रीप्रोसेसिंग का एक चरण है, जिसमें टेक्स्ट को अलग-अलग शब्दों या टोकन में तोड़ा जाता है। यह टेक्स्ट डेटा का विश्लेषण करने में जरूरी है क्योंकि यह कच्चे टेक्स्ट से शब्दों को अलग करता है, जिससे विश्लेषण और समझ आसान हो जाती है। आम तौर पर NLTK के बिल्ट-इन word_tokenize फ़ंक्शन से टोकनाइज़ेशन किया जाता है, जो टेक्स्ट को शब्दों और विराम-चिह्नों में विभाजित करता है।
स्टॉप वर्ड हटाना सेंटिमेंट एनालिसिस में एक महत्वपूर्ण प्रीप्रोसेसिंग चरण है, जिसमें सामान्य और अप्रासंगिक शब्दों को हटाया जाता है जो प्रायः कोई भाव व्यक्त नहीं करते। स्टॉप वर्ड्स वे अत्यधिक सामान्य शब्द होते हैं जो बहुत अर्थ नहीं ढोते, जैसे "and", "the", "of" और "it"। यदि इन्हें न हटाया जाए तो ये शोर पैदा कर सकते हैं और विश्लेषण को बिगाड़ सकते हैं।
स्टॉप वर्ड्स हटाने से टेक्स्ट में बचे शब्द अधिक संभावना से व्यक्त किए जा रहे सेंटिमेंट का संकेत देते हैं। इससे सेंटिमेंट एनालिसिस की सटीकता में सुधार हो सकता है। NLTK कई भाषाओं के लिए स्टॉप वर्ड्स की बिल्ट-इन सूची प्रदान करता है, जिसका उपयोग टेक्स्ट डेटा से ऐसे शब्दों को फिल्टर करने में किया जा सकता है।
स्टेमिंग और लेमाटाइज़ेशन वे तकनीकें हैं जिनसे शब्दों को उनके मूल रूप में घटाया जाता है। स्टेमिंग में शब्दों से "ing" या "ed" जैसे प्रत्ययों को हटाकर उन्हें उनके बेस फ़ॉर्म में बदला जाता है। उदाहरण के लिए, "jumping" का स्टेम "jump" होगा।
वहीं, लेमाटाइज़ेशन में शब्दों को उनके पद-वर्ग (part of speech) के आधार पर मूल रूप में घटाया जाता है। उदाहरण के लिए, "jumped" का लेमा "jump" होगा, लेकिन "jumping" का लेमा वर्तमान कृदंत होने के कारण "jumping" ही रहेगा।
स्टेमिंग और लेमाटाइज़ेशन के बारे में अधिक जानने के लिए हमारा Python में Stemming और Lemmatization ट्यूटोरियल देखें।
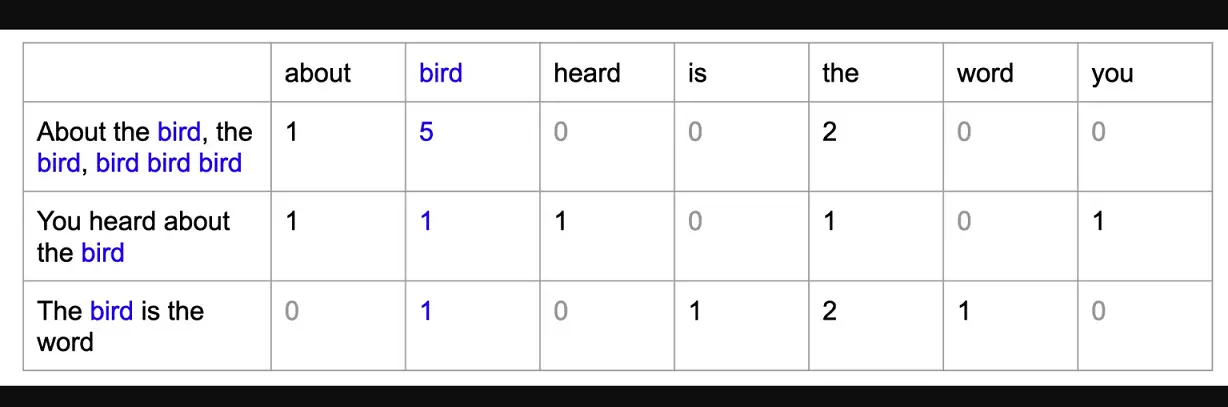
बैग ऑफ वर्ड्स मॉडल NLP में टेक्स्ट डेटा को संख्यात्मक फ़ीचर्स के सेट के रूप में प्रस्तुत करने की तकनीक है। इस मॉडल में प्रत्येक दस्तावेज़ या टेक्स्ट को शब्दों के "बैग" के रूप में दर्शाया जाता है, जहाँ टेक्स्ट के प्रत्येक शब्द को परिणामी वेक्टर में अलग फीचर या डायमेंशन माना जाता है। प्रत्येक फीचर का मान उस शब्द के टेक्स्ट में आने की संख्या से निर्धारित होता है।
बैग ऑफ वर्ड्स मॉडल NLP में उपयोगी है क्योंकि यह हमें टेक्स्ट डेटा का विश्लेषण मशीन लर्निंग एल्गोरिद्म के माध्यम से करने में सक्षम बनाता है, जो आमतौर पर संख्यात्मक इनपुट मांगते हैं। टेक्स्ट डेटा को संख्यात्मक फीचर्स में बदलकर हम मशीन लर्निंग मॉडल्स को टेक्स्ट वर्गीकृत करने या सेंटिमेंट विश्लेषित करने के लिए प्रशिक्षित कर सकते हैं।
अगले सेक्शन का उदाहरण Amazon ग्राहक डेटासेट पर सेंटिमेंट एनालिसिस के लिए NLTK के Vader मॉडल का उपयोग करेगा। इस विशेष उदाहरण में हमें यह चरण करने की आवश्यकता नहीं है क्योंकि NLTK Vader API इनपुट के रूप में टेक्स्ट स्वीकार करता है, न कि संख्यात्मक वेक्टर। लेकिन यदि आप सेंटिमेंट की भविष्यवाणी करने के लिए एक सुपरवाइज़्ड मशीन लर्निंग मॉडल बना रहे होते (मानते हुए आपके पास लेबल्ड डेटा है), तो मॉडल को ट्रेन करने से पहले आपको प्रोसेस्ड टेक्स्ट को बैग ऑफ वर्ड्स मॉडल में बदलना होगा।
Python में NLTK का उपयोग करके सेंटिमेंट एनालिसिस करने के लिए, सबसे पहले टेक्स्ट डेटा का टोकनाइज़ेशन, स्टॉप वर्ड हटाना और स्टेमिंग या लेमाटाइज़ेशन जैसी तकनीकों से प्रीप्रोसेसिंग करनी होगी। एक बार टेक्स्ट प्रीप्रोसेस हो जाए, तो हम उसे Vader सेंटिमेंट एनालाइज़र को पास करेंगे ताकि टेक्स्ट के सेंटिमेंट (सकारात्मक या नकारात्मक) का विश्लेषण किया जा सके।
सबसे पहले, हम टेक्स्ट विश्लेषण और सेंटिमेंट एनालिसिस के लिए आवश्यक लाइब्रेरियाँ इंपोर्ट करेंगे, जैसे डेटा हैंडलिंग के लिए pandas, नैचुरल लैंग्वेज प्रोसेसिंग के लिए nltk, और सेंटिमेंट एनालिसिस के लिए SentimentIntensityAnalyzer।
इसके बाद, हम nltk.download() का उपयोग करके NLTK का पूरा कॉर्पस (भाषावैज्ञानिक डेटा का संग्रह) डाउनलोड करेंगे।
पर्यावरण सेटअप होने के बाद, हम pd.read_csv() का उपयोग करके Amazon रिव्यूज़ का डेटासेट लोड करेंगे। इससे Python में एक DataFrame ऑब्जेक्ट बनेगा जिसका उपयोग हम डेटा का विश्लेषण करने के लिए कर सकते हैं। हम df का उपयोग करके DataFrame की सामग्री प्रदर्शित करेंगे।
# import libraries
import pandas as pd

import nltk

from nltk.sentiment.vader import SentimentIntensityAnalyzer

from nltk.corpus import stopwords

from nltk.tokenize import word_tokenize

from nltk.stem import WordNetLemmatizer


# download nltk corpus (first time only)
import nltk

nltk.download('all')


# Load the amazon review dataset

df = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/amazon.csv')

df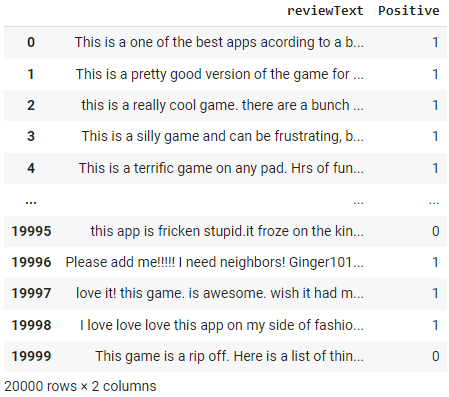
आइए एक फ़ंक्शन preprocess_text बनाते हैं, जिसमें हम पहले NLTK के word_tokenize फ़ंक्शन से डॉक्युमेंट्स को टोकनाइज़ करेंगे, फिर NLTK के stepwords मॉड्यूल से स्टॉप वर्ड्स हटाएँगे और अंत में NLTK के WordNetLemmatizer से filtered_tokens का लेमाटाइज़ेशन करेंगे।
# create preprocess_text function
def preprocess_text(text):

    # Tokenize the text

    tokens = word_tokenize(text.lower())


    # Remove stop words

    filtered_tokens = [token for token in tokens if token not in stopwords.words('english')]


    # Lemmatize the tokens

    lemmatizer = WordNetLemmatizer()

    lemmatized_tokens = [lemmatizer.lemmatize(token) for token in filtered_tokens]


    # Join the tokens back into a string

    processed_text = ' '.join(lemmatized_tokens)

    return processed_text

# apply the function df

df['reviewText'] = df['reviewText'].apply(preprocess_text)
df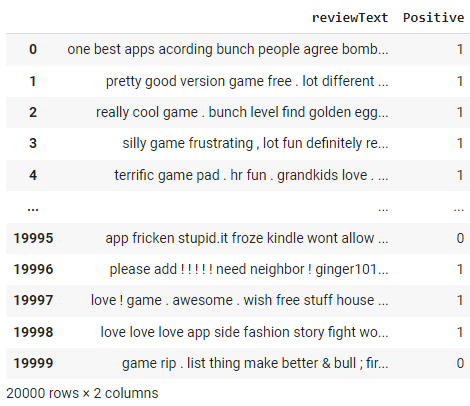
ऊपर दिए गए चरण में लागू किए गए preprocess_text फ़ंक्शन के परिणामस्वरूप "review text" कॉलम में आए बदलावों पर ध्यान दें।
पहले हम nltk.sentiment.vader लाइब्रेरी से Sentiment Intensity Analyzer ऑब्जेक्ट इनिशियलाइज़ करेंगे।
इसके बाद, हम get_sentiment नाम का एक फ़ंक्शन परिभाषित करेंगे जो इनपुट के रूप में टेक्स्ट स्ट्रिंग लेता है। यह फ़ंक्शन analyzer ऑब्जेक्ट के polarity_scores मेथड को कॉल करके टेक्स्ट के लिए सेंटिमेंट स्कोर का डिक्शनरी प्राप्त करता है, जिसमें सकारात्मक, नकारात्मक और तटस्थ सेंटिमेंट के स्कोर शामिल होते हैं।
फ़ंक्शन फिर जाँच करेगा कि क्या सकारात्मक स्कोर 0 से अधिक है; यदि हाँ, तो 1 लौटाएगा, अन्यथा 0। यानी जिस भी टेक्स्ट का पॉजिटिव स्कोर 0 से अधिक होगा, उसे सकारात्मक सेंटिमेंट के रूप में वर्गीकृत किया जाएगा, और जिसका स्कोर सकारात्मक नहीं होगा, उसे नकारात्मक सेंटिमेंट के रूप में।
अंत में, हम df DataFrame के reviewText कॉलम पर apply मेथड का उपयोग करते हुए get_sentiment फ़ंक्शन लागू करेंगे। इससे DataFrame में sentiment नाम का नया कॉलम बनेगा, जिसमें प्रत्येक समीक्षा का सेंटिमेंट स्कोर संग्रहीत होगा। फिर हम df का उपयोग करके अपडेटेड DataFrame प्रदर्शित करेंगे।
# initialize NLTK sentiment analyzer

analyzer = SentimentIntensityAnalyzer()


# create get_sentiment function

def get_sentiment(text):

    scores = analyzer.polarity_scores(text)

    sentiment = 1 if scores['pos'] > 0 else 0

    return sentiment


# apply get_sentiment function

df['sentiment'] = df['reviewText'].apply(get_sentiment)

df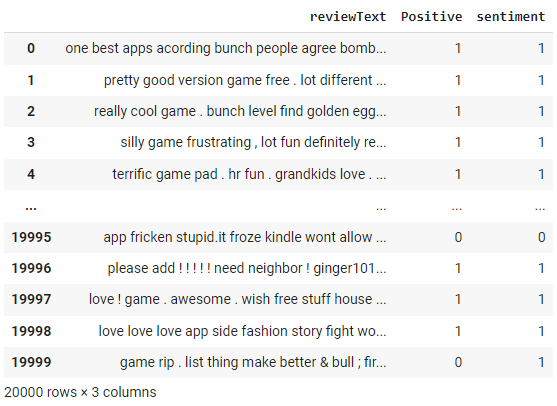
NLTK सेंटिमेंट एनालाइज़र -1 से +1 के बीच स्कोर लौटाता है। ऊपर दिए गए get_sentiment फ़ंक्शन में हमने 0 का कट-ऑफ थ्रेशोल्ड उपयोग किया है। 0 से ऊपर कुछ भी 1 (अर्थात सकारात्मक) के रूप में वर्गीकृत होता है। चूँकि हमारे पास वास्तविक लेबल हैं, हम कन्फ्यूज़न मैट्रिक्स बनाकर इस विधि के प्रदर्शन का मूल्यांकन कर सकते हैं।
from sklearn.metrics import confusion_matrix

print(confusion_matrix(df['Positive'], df['sentiment']))आउटपुट:
[[ 1131  3636]

 [  576 14657]]
हम क्लासिफिकेशन रिपोर्ट भी देख सकते हैं:
from sklearn.metrics import classification_report

print(classification_report(df['Positive'], df['sentiment']))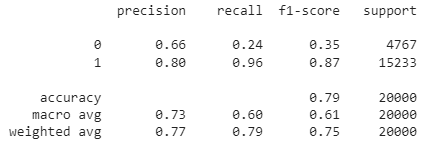
जैसा कि आप देख सकते हैं, इस नियम-आधारित सेंटिमेंट एनालिसिस मॉडल की समग्र सटीकता 79% है। चूँकि यह लेबल्ड डेटा है, आप एक ML मॉडल बनाकर भी देख सकते हैं कि क्या ML-आधारित दृष्टिकोण बेहतर सटीकता देता है।
पूरा नोटबुक Datacamp workspace पर देखें।
NLTK Python में सेंटिमेंट एनालिसिस और अन्य नैचुरल लैंग्वेज प्रोसेसिंग कार्यों के लिए एक शक्तिशाली और लचीली लाइब्रेरी है। NLTK का उपयोग करके हम टेक्स्ट डेटा का प्रीप्रोसेसिंग कर सकते हैं, उसे बैग ऑफ वर्ड्स मॉडल में बदल सकते हैं और Vader के सेंटिमेंट एनालाइज़र से सेंटिमेंट एनालिसिस कर सकते हैं।
इस ट्यूटोरियल में, हमने NLTK सेंटिमेंट एनालिसिस की मूल बातें देखीं, जिनमें टेक्स्ट डेटा का प्रीप्रोसेसिंग, बैग ऑफ वर्ड्स मॉडल बनाना और NLTK Vader का उपयोग करके सेंटिमेंट एनालिसिस करना शामिल है। हमने NLTK सेंटिमेंट एनालिसिस के फायदे और सीमाएँ भी चर्चा कीं, और आगे पढ़ने व अन्वेषण के लिए सुझाव दिए।
कुल मिलाकर, NLTK Python में सेंटिमेंट एनालिसिस और अन्य NLP कार्यों के लिए एक व्यापक रूप से प्रयुक्त और प्रभावशाली टूल है। इस ट्यूटोरियल में प्रस्तुत तकनीकों और टूल्स में महारत हासिल करके आप टेक्स्ट डेटा के सेंटिमेंट के बारे में मूल्यवान अंतर्दृष्टियाँ प्राप्त कर सकते हैं और इन अंतर्दृष्टियों का उपयोग विभिन्न अनुप्रयोगों में डेटा-चालित निर्णय लेने के लिए कर सकते हैं।
यदि आप Python की लाइब्रेरी और फ्रेमवर्क—जिनमें NLTK, scikit-learn, spaCy और SpeechRecognition शामिल हैं—का उपयोग करते हुए TED टॉक्स, लेखों और मूवी रिव्यू जैसे वास्तविक डेटा पर NLP लागू करना सीखना चाहते हैं, तो नीचे दिए गए संसाधन देखें:
यह Python का उपयोग करके टेक्स्ट डेटा को प्रोसेस और विश्लेषित करने के लिए एक मजबूत आधार प्रदान करता है। चाहे आप NLP में नए हों या अपने कौशल का विस्तार करना चाहते हों, यह कोर्स आपको असंरचित डेटा को मूल्यवान अंतर्दृष्टियों में बदलने के लिए आवश्यक टूल्स और ज्ञान से लैस करेगा।
Python पाठ्यक्रम
कोर्स
कोर्स
कोर्स