Corso
Introduzione alla Data Science in Python
4 ore
504.2K
L'analisi del sentiment è una tecnica usata per determinare il tono emotivo o il sentimento espresso in un testo. Comporta l'analisi delle parole e delle frasi usate nel testo per identificare il sentimento sottostante, che può essere positivo, negativo o neutro.
L'analisi del sentiment ha un'ampia gamma di applicazioni, tra cui il monitoraggio dei social media, l'analisi dei feedback dei clienti e le ricerche di mercato.
Una delle principali sfide nell'analisi del sentiment è la complessità intrinseca del linguaggio umano. I dati testuali contengono spesso sarcasmo, ironia e altre forme di linguaggio figurato che possono essere difficili da interpretare con metodi tradizionali.
Tuttavia, i recenti progressi nell'elaborazione del linguaggio naturale (NLP) e nel machine learning hanno reso possibile eseguire l'analisi del sentiment su grandi volumi di dati testuali con un alto grado di accuratezza.
Esistono diversi modi per eseguire l'analisi del sentiment sui dati testuali, con vari gradi di complessità e accuratezza. I metodi più comuni includono un approccio basato su lessici, un approccio basato sul machine learning (ML) e un approccio di deep learning basato su transformer pre-addestrati. Vediamoli più nel dettaglio:
Questo tipo di analisi, come il sentiment analyzer Vader di NLTK, prevede l'uso di un insieme di regole e euristiche predefinite per determinare il sentiment di un testo. Queste regole sono in genere basate su caratteristiche lessicali e sintattiche del testo, come la presenza di parole e frasi positive o negative.
Sebbene l'analisi basata su lessici sia relativamente semplice da implementare e interpretare, potrebbe non essere accurata quanto gli approcci basati su ML o su transformer, soprattutto con testi complessi o ambigui.
Questo approccio prevede l'addestramento di un modello a identificare il sentiment di un testo a partire da un insieme di dati di addestramento etichettati. Questi modelli possono essere addestrati usando un'ampia gamma di algoritmi di ML, tra cui alberi decisionali, support vector machine (SVM) e reti neurali.
Gli approcci basati su ML possono essere più accurati dell'analisi a regole, specialmente con testi complessi, ma richiedono una maggiore quantità di dati etichettati e possono essere più costosi dal punto di vista computazionale.
Un approccio basato sul deep learning, come visto con BERT e GPT-4, prevede l'uso di modelli pre-addestrati su enormi quantità di dati testuali. Questi modelli usano reti neurali complesse per codificare il contesto e il significato del testo, permettendo di ottenere risultati all'avanguardia in un'ampia gamma di task NLP, inclusa l'analisi del sentiment. Tuttavia, questi modelli richiedono notevoli risorse computazionali e potrebbero non essere pratici per tutti i casi d'uso.
La scelta dell'approccio dipenderà dalle esigenze e dai vincoli specifici del progetto.
Per usare la libreria NLTK, devi avere un ambiente Python sul tuo computer. Il modo più semplice per installare Python è scaricare e installare l'Anaconda Distribution. Questa distribuzione include l'ambiente base Python 3 e altri strumenti utili, incluso Jupyter Notebook. Inoltre, non devi installare la libreria NLTK, poiché viene fornita preinstallata insieme a molte altre librerie utili.
Se scegli di installare Python senza alcuna distribuzione, puoi scaricarlo e installarlo direttamente da python.org. In questo caso, dovrai installare NLTK quando il tuo ambiente Python sarà pronto.
Per installare la libreria NLTK, apri il terminale dei comandi e digita:
pip install nltkVale la pena notare che NLTK richiede anche il download di alcuni dati aggiuntivi prima di poter essere utilizzato in modo efficace. Questi dati includono modelli pre-addestrati, corpora e altre risorse che NLTK utilizza per svolgere varie attività di NLP. Per scaricare questi dati, esegui il seguente comando nel terminale o nel tuo script Python:
import nltk

nltk.download('all')Il preprocessing del testo è un passaggio fondamentale per eseguire l'analisi del sentiment, perché aiuta a ripulire e normalizzare i dati testuali, rendendoli più facili da analizzare. Il preprocessing comprende una serie di tecniche che trasformano i dati testuali grezzi in una forma utilizzabile per l'analisi. Alcune tecniche comuni includono tokenizzazione, rimozione delle stop word, stemming e lemmatizzazione.
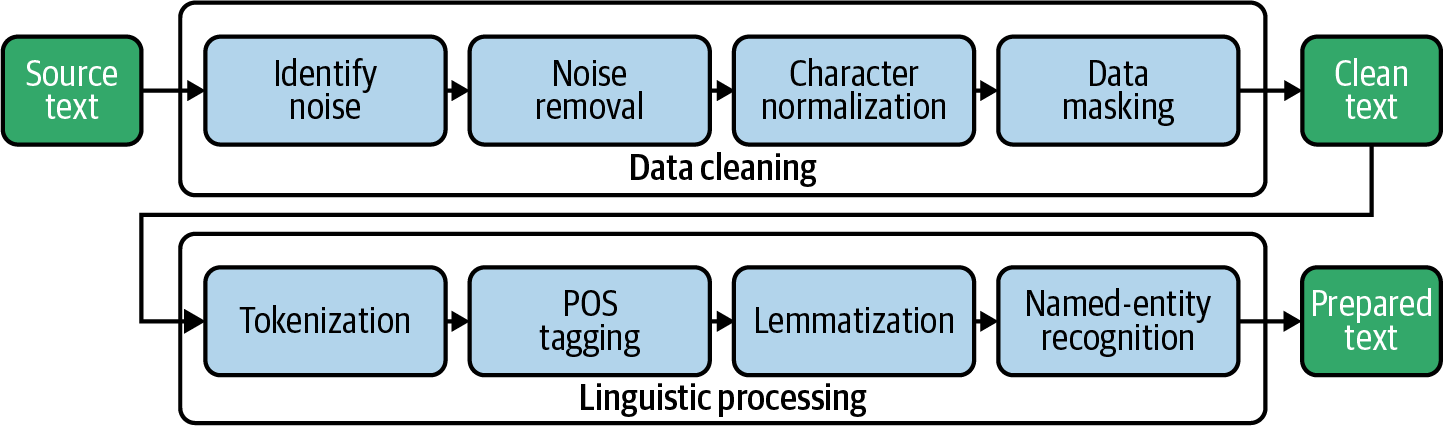
La tokenizzazione è un passaggio di preprocessing nell'analisi del sentiment che consiste nel suddividere il testo in singole parole o token. È uno step essenziale nell'analisi dei dati testuali perché separa le singole parole dal testo grezzo, rendendolo più facile da analizzare e comprendere. La tokenizzazione si esegue tipicamente con la funzione word_tokenize integrata in NLTK, che può dividere il testo in singole parole e segni di punteggiatura.
La rimozione delle stop word è un passaggio cruciale del preprocessing che consiste nell'eliminare parole comuni e irrilevanti che difficilmente veicolano sentiment. Le stop word sono parole molto frequenti in una lingua e con scarso contenuto informativo, come "and", "the", "of" e "it". Se non rimosse, queste parole possono introdurre rumore e alterare l'analisi.
Rimuovendo le stop word, le parole rimanenti nel testo sono più probabilmente indicative del sentimento espresso. Questo può aiutare a migliorare l'accuratezza dell'analisi del sentiment. NLTK fornisce un elenco integrato di stop word per diverse lingue, che può essere utilizzato per filtrare queste parole dai dati testuali.
Stemming e lemmatizzazione sono tecniche usate per ridurre le parole alle loro forme radice. Lo stemming comporta la rimozione dei suffissi dalle parole, come "ing" o "ed", per ridurle alla forma base. Ad esempio, la parola "jumping" verrebbe ridotta a "jump".
La lemmatizzazione, invece, riduce le parole alla forma base in base alla loro parte del discorso. Ad esempio, la parola "jumped" verrebbe lemmatizzata a "jump", ma la parola "jumping" verrebbe lemmatizzata a "jumping" poiché è un participio presente.
Per saperne di più su stemming e lemmatizzazione, dai un'occhiata al nostro tutorial Stemming e lemmatizzazione in Python.
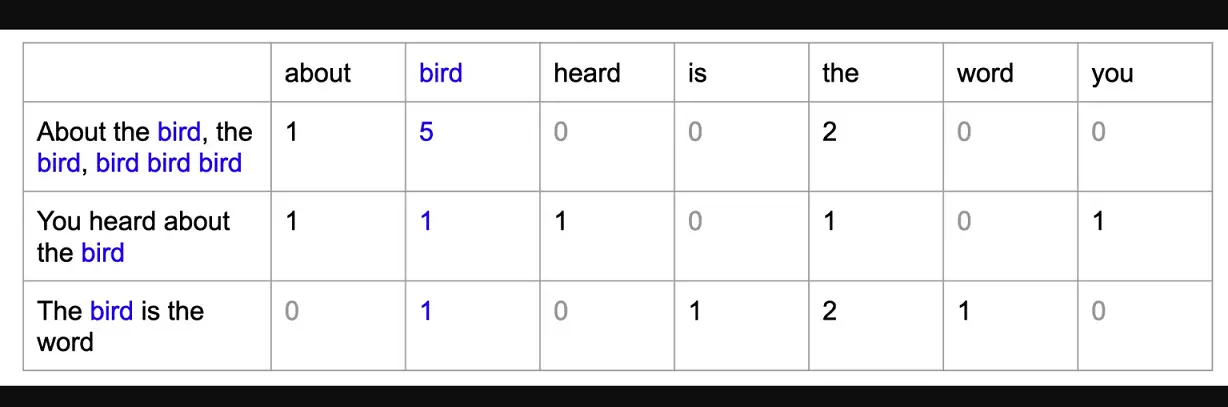
Il modello bag of words è una tecnica usata nell'elaborazione del linguaggio naturale (NLP) per rappresentare i dati testuali come un insieme di caratteristiche numeriche. In questo modello, ogni documento o testo è rappresentato come un "sacchetto" di parole, con ogni parola rappresentata da una caratteristica o dimensione separata nel vettore risultante. Il valore di ciascuna caratteristica è determinato dal numero di volte in cui la parola corrispondente appare nel testo.
Il modello bag of words è utile in NLP perché consente di analizzare i dati testuali utilizzando algoritmi di machine learning, che in genere richiedono input numerici. Rappresentando i dati testuali come caratteristiche numeriche, possiamo addestrare modelli di machine learning per classificare testi o analizzare sentiment.
L'esempio nella prossima sezione utilizzerà il modello Vader di NLTK per l'analisi del sentiment sul dataset dei clienti di Amazon. In questo esempio specifico, non è necessario eseguire questo passaggio perché l'API Vader di NLTK accetta il testo come input invece di vettori numerici, ma se stessi costruendo un modello di machine learning supervisionato per prevedere il sentiment (supponendo di avere dati etichettati), dovresti trasformare il testo processato in un modello bag of words prima di addestrare il modello.
Per eseguire l'analisi del sentiment con NLTK in Python, i dati testuali devono prima essere preprocessati con tecniche come tokenizzazione, rimozione delle stop word e stemming o lemmatizzazione. Una volta preprocessato il testo, lo passeremo al sentiment analyzer Vader per analizzare il sentiment del testo (positivo o negativo).
Per prima cosa, importeremo le librerie necessarie per l'analisi del testo e del sentiment, come pandas per la gestione dei dati, nltk per l'elaborazione del linguaggio naturale e SentimentIntensityAnalyzer per l'analisi del sentiment.
Scaricheremo quindi l'intero corpus di NLTK (una raccolta di dati linguistici) usando nltk.download().
Una volta configurato l'ambiente, caricheremo un dataset di recensioni Amazon usando pd.read_csv(). Questo creerà un oggetto DataFrame in Python che potremo usare per analizzare i dati. Visualizzeremo il contenuto del DataFrame usando df.
# import libraries
import pandas as pd

import nltk

from nltk.sentiment.vader import SentimentIntensityAnalyzer

from nltk.corpus import stopwords

from nltk.tokenize import word_tokenize

from nltk.stem import WordNetLemmatizer


# download nltk corpus (first time only)
import nltk

nltk.download('all')


# Load the amazon review dataset

df = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/amazon.csv')

df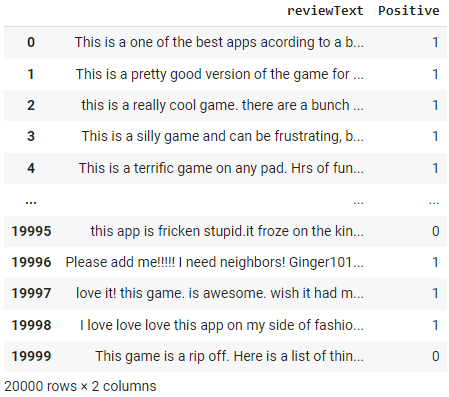
Creiamo una funzione preprocess_text in cui prima tokenizziamo i documenti usando la funzione word_tokenize di NLTK, poi rimuoviamo le stop word usando il modulo stepwords di NLTK e infine lemmatizziamo i filtered_tokens con WordNetLemmatizer di NLTK.
# create preprocess_text function
def preprocess_text(text):

    # Tokenize the text

    tokens = word_tokenize(text.lower())


    # Remove stop words

    filtered_tokens = [token for token in tokens if token not in stopwords.words('english')]


    # Lemmatize the tokens

    lemmatizer = WordNetLemmatizer()

    lemmatized_tokens = [lemmatizer.lemmatize(token) for token in filtered_tokens]


    # Join the tokens back into a string

    processed_text = ' '.join(lemmatized_tokens)

    return processed_text

# apply the function df

df['reviewText'] = df['reviewText'].apply(preprocess_text)
df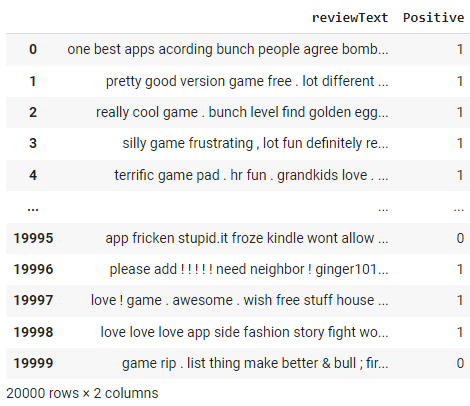
Nota le modifiche nella colonna "review text" come risultato della funzione preprocess_text che abbiamo applicato nel passaggio precedente.
Per prima cosa, inizializzeremo un oggetto Sentiment Intensity Analyzer dalla libreria nltk.sentiment.vader.
Successivamente, definiremo una funzione chiamata get_sentiment che prende in input una stringa di testo. La funzione richiama il metodo polarity_scores dell'oggetto analyzer per ottenere un dizionario di punteggi di sentiment per il testo, che include un punteggio per il sentiment positivo, negativo e neutro.
La funzione verificherà quindi se il punteggio positivo è maggiore di 0 e restituirà un punteggio di sentiment pari a 1 in tal caso, altrimenti 0. Ciò significa che qualsiasi testo con un punteggio positivo sarà classificato come avente un sentiment positivo, e qualsiasi testo con un punteggio non positivo sarà classificato come avente un sentiment negativo.
Infine, applicheremo la funzione get_sentiment alla colonna reviewText del DataFrame df usando il metodo apply. Questo crea una nuova colonna chiamata sentiment nel DataFrame, che memorizza il punteggio di sentiment per ciascuna recensione. Quindi mostreremo il DataFrame aggiornato usando df.
# initialize NLTK sentiment analyzer

analyzer = SentimentIntensityAnalyzer()


# create get_sentiment function

def get_sentiment(text):

    scores = analyzer.polarity_scores(text)

    sentiment = 1 if scores['pos'] > 0 else 0

    return sentiment


# apply get_sentiment function

df['sentiment'] = df['reviewText'].apply(get_sentiment)

df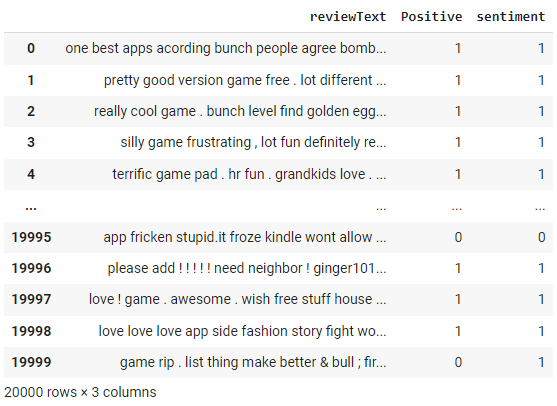
Il sentiment analyzer di NLTK restituisce un punteggio compreso tra -1 e +1. Abbiamo usato una soglia di cut-off pari a 0 nella funzione get_sentiment sopra. Qualsiasi valore superiore a 0 è classificato come 1 (cioè positivo). Poiché abbiamo etichette reali, possiamo valutare le prestazioni di questo metodo costruendo una matrice di confusione.
from sklearn.metrics import confusion_matrix

print(confusion_matrix(df['Positive'], df['sentiment']))Output:
[[ 1131  3636]

 [  576 14657]]
Possiamo anche verificare il classification report:
from sklearn.metrics import classification_report

print(classification_report(df['Positive'], df['sentiment']))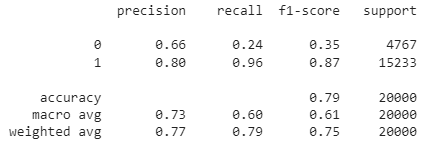
Come puoi vedere, l'accuratezza complessiva di questo modello di analisi del sentiment basato su regole è del 79%. Poiché si tratta di dati etichettati, puoi anche provare a costruire un modello di ML per valutare se un approccio basato su ML porti a una migliore accuratezza.
Consulta il notebook completo sul workspace di Datacamp.
NLTK è una libreria potente e flessibile per eseguire l'analisi del sentiment e altre attività di elaborazione del linguaggio naturale in Python. Usando NLTK, possiamo preprocessare i dati testuali, convertirli in un modello bag of words ed eseguire l'analisi del sentiment con il sentiment analyzer di Vader.
In questo tutorial, abbiamo esplorato le basi dell'analisi del sentiment con NLTK, incluso il preprocessing dei dati testuali, la creazione di un modello bag of words e l'esecuzione dell'analisi del sentiment con NLTK Vader. Abbiamo anche discusso vantaggi e limitazioni dell'analisi del sentiment con NLTK e fornito suggerimenti per ulteriori letture ed esplorazioni.
Nel complesso, NLTK è uno strumento potente e ampiamente utilizzato per eseguire l'analisi del sentiment e altre attività di NLP in Python. Padroneggiando le tecniche e gli strumenti presentati in questo tutorial, potrai ottenere insight preziosi sul sentiment dei dati testuali e utilizzare questi insight per prendere decisioni basate sui dati in un'ampia gamma di applicazioni.
Se vuoi imparare ad applicare l'NLP a dati reali, inclusi TED talk, articoli e recensioni di film, usando librerie e framework Python, tra cui NLTK, scikit-learn, spaCy e SpeechRecognition, dai un'occhiata alle risorse qui sotto:
Offre solide basi per elaborare e analizzare dati testuali con Python. Che tu sia alle prime armi con l'NLP o voglia ampliare le tue competenze, questo corso ti fornirà gli strumenti e le conoscenze per convertire dati non strutturati in insight di valore.
Corsi di Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



