Cursus
Introductie tot Data Science in Python
4 uur
504.2K
Sentimentanalyse is een techniek om de emotionele toon of het sentiment in een tekst te bepalen. Dit houdt in dat je de gebruikte woorden en zinsdelen analyseert om het onderliggende sentiment te identificeren: positief, negatief of neutraal.
Sentimentanalyse kent een breed scala aan toepassingen, waaronder socialmediamonitoring, analyse van klantfeedback en marktonderzoek.
Een van de grootste uitdagingen bij sentimentanalyse is de inherente complexiteit van menselijke taal. Tekst bevat vaak sarcasme, ironie en andere vormen van beeldspraak die met traditionele methoden lastig te interpreteren zijn.
Recente ontwikkelingen in natural language processing (NLP) en machine learning maken het echter mogelijk om sentimentanalyse op grote hoeveelheden tekstdata met hoge nauwkeurigheid uit te voeren.
Er zijn meerdere manieren om sentimentanalyse op tekstdata uit te voeren, met uiteenlopende complexiteit en nauwkeurigheid. De meest gangbare methoden zijn een lexicongebaseerde aanpak, een machine learning (ML)-aanpak en een voorgetrainde, transformer-gebaseerde deep-learningaanpak. Laten we ze stuk voor stuk bekijken:
Dit type analyse, zoals de NLTK VADER-sentimentanalyzer, gebruikt een set vooraf gedefinieerde regels en heuristieken om het sentiment van een tekst te bepalen. Deze regels zijn doorgaans gebaseerd op lexicale en syntactische kenmerken van de tekst, zoals de aanwezigheid van positieve of negatieve woorden en uitdrukkingen.
Hoewel lexicongebaseerde analyse relatief eenvoudig te implementeren en te interpreteren is, is ze mogelijk minder nauwkeurig dan ML- of transformer-gebaseerde benaderingen, zeker bij complexe of dubbelzinnige tekstdata.
Deze aanpak traint een model om het sentiment van een tekst te identificeren op basis van gelabelde trainingsdata. Modellen kunnen worden getraind met uiteenlopende ML-algoritmen, waaronder beslisbomen, support vector machines (SVM's) en neurale netwerken.
ML-gebaseerde benaderingen kunnen nauwkeuriger zijn dan regelgebaseerde analyse, vooral bij complexe tekstdata, maar vereisen meer gelabelde trainingsdata en kunnen rekenintensiever zijn.
Een deep-learningbenadering, zoals bij BERT en GPT-4, gebruikt voorgetrainde modellen die op enorme hoeveelheden tekstdata zijn getraind. Deze modellen zetten met complexe neurale netwerken de context en betekenis van tekst om, waardoor ze state-of-the-art nauwkeurigheid behalen op uiteenlopende NLP-taken, waaronder sentimentanalyse. Deze modellen vragen echter aanzienlijke rekenresources en zijn niet altijd praktisch voor elke usecase.
De keuze hangt af van de specifieke behoeften en beperkingen van je project.
Om de NLTK-bibliotheek te gebruiken, heb je een Python-omgeving op je computer nodig. De eenvoudigste manier om Python te installeren is via de Anaconda Distribution. Deze distributie bevat de basisomgeving voor Python 3 en handige extra's, waaronder Jupyter Notebook. Je hoeft NLTK ook niet apart te installeren, want deze komt voorgeïnstalleerd met NLTK en veel andere nuttige libraries.
Kies je ervoor om Python zonder distributie te installeren, download en installeer Python dan rechtstreeks via python.org. In dat geval moet je NLTK installeren zodra je Python-omgeving klaar is.
Om de NLTK-bibliotheek te installeren, open je de terminal en typ je:
pip install nltkHoud er rekening mee dat NLTK ook aanvullende data nodig heeft voordat je de library effectief kunt gebruiken. Deze data omvat voorgetrainde modellen, corpora en andere resources die NLTK gebruikt voor diverse NLP-taken. Om deze data te downloaden, voer je de volgende code uit in de terminal of in je Python-script:
import nltk

nltk.download('all')Preprocessing van tekst is cruciaal voor sentimentanalyse: het helpt om tekstdata op te schonen en te normaliseren, zodat analyse eenvoudiger wordt. De preprocessing-stap omvat een reeks technieken die rauwe tekst omzetten in een vorm die je kunt gebruiken voor analyse. Veelvoorkomende technieken zijn tokenization, stopwoorden verwijderen, stemming en lemmatization.
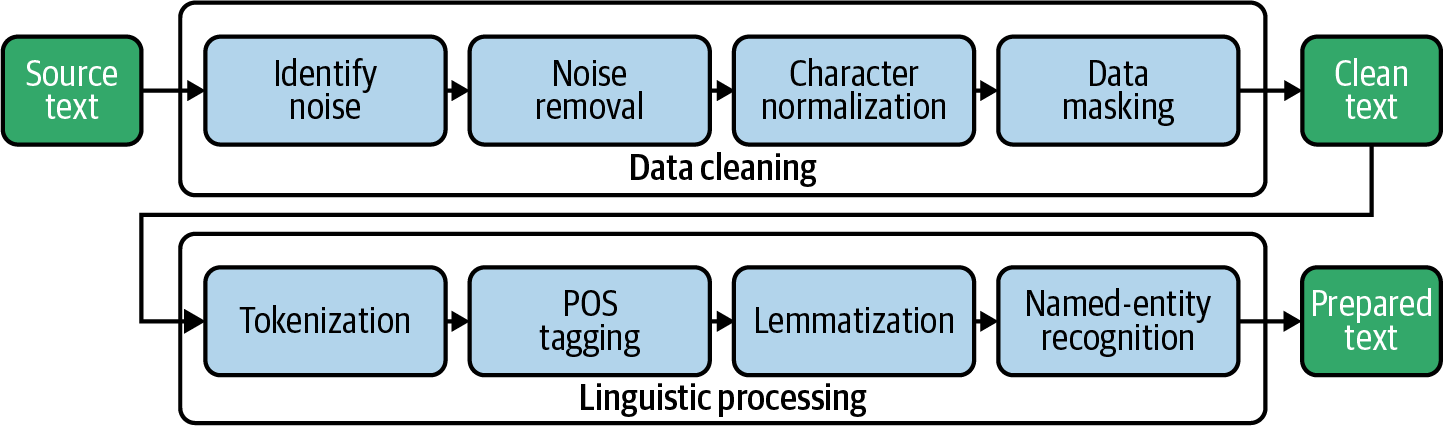
Tokenization is een preprocessing-stap waarbij je tekst opdeelt in afzonderlijke woorden of tokens. Dit is essentieel omdat je zo losse woorden uit de ruwe tekst haalt, wat de analyse en interpretatie vereenvoudigt. Tokenization wordt meestal uitgevoerd met NLTK's ingebouwde functie word_tokenize, die de tekst kan splitsen in woorden en leestekens.
Stopwoorden verwijderen is een belangrijke preprocessing-stap waarbij je algemene, weinigzeggende woorden weghaalt die waarschijnlijk weinig sentiment overbrengen. Stopwoorden zijn veelvoorkomende woorden in een taal die weinig betekenis dragen, zoals "and", "the", "of" en "it". Als je ze niet verwijdert, kunnen ze ruis veroorzaken en de analyse vertekenen.
Door stopwoorden te verwijderen, zijn de overgebleven woorden in de tekst eerder indicatief voor het sentiment. Dit kan de nauwkeurigheid van de sentimentanalyse verbeteren. NLTK biedt een ingebouwde lijst met stopwoorden voor verschillende talen, die je kunt gebruiken om deze woorden uit de tekstdata te filteren.
Stemming en lemmatization zijn technieken om woorden terug te brengen naar hun stam- of grondvorm. Stemming verwijdert achtervoegsels van woorden, zoals "ing" of "ed", om ze te reduceren tot de basisvorm. Zo wordt "jumping" bijvoorbeeld teruggebracht tot "jump".
Lemmatization brengt woorden terug tot hun basisvorm op basis van hun woordsoort. Zo wordt "jumped" lemmatized naar "jump", maar "jumping" blijft "jumping" omdat het een tegenwoordig deelwoord is.
Wil je meer leren over stemming en lemmatization? Bekijk dan onze tutorial Stemming and Lemmatization in Python.
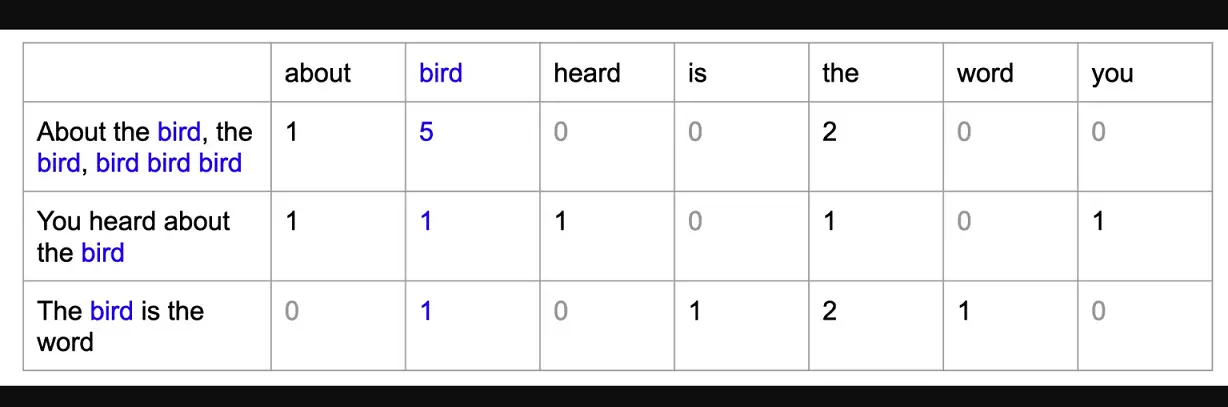
Het bag-of-words-model is een techniek in NLP om tekstdata te representeren als numerieke features. In dit model wordt ieder document of tekstfragment weergegeven als een "zak" met woorden, waarbij elk woord uit de tekst een aparte feature of dimensie vormt in de resulterende vector. De waarde van elke feature wordt bepaald door hoe vaak het corresponderende woord in de tekst voorkomt.
Het bag-of-words-model is nuttig omdat we tekstdata zo met machine-learningalgoritmen kunnen analyseren, die doorgaans numerieke input nodig hebben. Door tekstdata als numerieke features te representeren, kunnen we ML-modellen trainen om tekst te classificeren of sentiment te analyseren.
Het voorbeeld in de volgende sectie gebruikt het NLTK VADER-model voor sentimentanalyse op de Amazon-klantendataset. In dit specifieke voorbeeld hoeven we deze stap niet uit te voeren, omdat de NLTK VADER-API tekst als input accepteert in plaats van numerieke vectoren. Maar als je een supervised ML-model zou bouwen om sentiment te voorspellen (ervan uitgaande dat je gelabelde data hebt), moet je de verwerkte tekst vóór het trainen omzetten naar een bag-of-words-representatie.
Om sentimentanalyse met NLTK in Python uit te voeren, moet je de tekstdata eerst pre-processen met technieken zoals tokenization, stopwoorden verwijderen en stemming of lemmatization. Zodra de tekst is voorbewerkt, geven we deze door aan de VADER-sentimentanalyzer om het sentiment (positief of negatief) te bepalen.
We importeren eerst de benodigde libraries voor tekst- en sentimentanalyse, zoals pandas voor datahandling, nltk voor NLP en SentimentIntensityAnalyzer voor sentimentanalyse.
Vervolgens downloaden we de volledige NLTK-corpus (een verzameling taalkundige data) met nltk.download().
Wanneer de omgeving is ingericht, laden we een dataset met Amazon-reviews met pd.read_csv(). Dit levert een DataFrame-object in Python op waarmee we de data kunnen analyseren. We tonen de inhoud van het DataFrame met df.
# import libraries
import pandas as pd

import nltk

from nltk.sentiment.vader import SentimentIntensityAnalyzer

from nltk.corpus import stopwords

from nltk.tokenize import word_tokenize

from nltk.stem import WordNetLemmatizer


# download nltk corpus (first time only)
import nltk

nltk.download('all')


# Load the amazon review dataset

df = pd.read_csv('https://raw.githubusercontent.com/pycaret/pycaret/master/datasets/amazon.csv')

df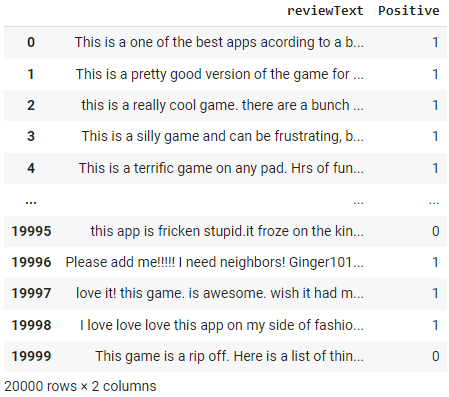
Laten we een functie preprocess_text maken waarin we eerst de documenten tokenizen met de functie word_tokenize uit NLTK, vervolgens stopwoorden verwijderen met de module stopwords uit NLTK en tot slot de filtered_tokens lemmatizen met WordNetLemmatizer uit NLTK.
# create preprocess_text function
def preprocess_text(text):

    # Tokenize the text

    tokens = word_tokenize(text.lower())


    # Remove stop words

    filtered_tokens = [token for token in tokens if token not in stopwords.words('english')]


    # Lemmatize the tokens

    lemmatizer = WordNetLemmatizer()

    lemmatized_tokens = [lemmatizer.lemmatize(token) for token in filtered_tokens]


    # Join the tokens back into a string

    processed_text = ' '.join(lemmatized_tokens)

    return processed_text

# apply the function df

df['reviewText'] = df['reviewText'].apply(preprocess_text)
df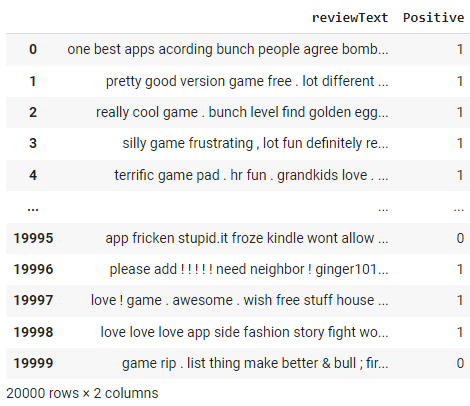
Let op de veranderingen in de kolom "review text" als resultaat van de functie preprocess_text die we hierboven hebben toegepast.
Eerst initialiseren we een Sentiment Intensity Analyzer-object uit de nltk.sentiment.vader-library.
Vervolgens definiëren we een functie get_sentiment die een tekststring als invoer neemt. De functie roept de methode polarity_scores van het analyzer-object aan om een woordenboek met sentimentscores voor de tekst te verkrijgen, inclusief scores voor positief, negatief en neutraal sentiment.
De functie controleert daarna of de positieve score groter is dan 0 en geeft in dat geval een sentimentscore van 1 terug, anders 0. Dit betekent dat elke tekst met een positieve score wordt geclassificeerd als positief sentiment, en elke tekst zonder positieve score als negatief sentiment.
Tot slot passen we de functie get_sentiment toe op de kolom reviewText van het DataFrame df met de methode apply. Dit creëert een nieuwe kolom met de naam sentiment in het DataFrame, waarin de sentimentscore voor elke review wordt opgeslagen. We tonen vervolgens het bijgewerkte DataFrame met df.
# initialize NLTK sentiment analyzer

analyzer = SentimentIntensityAnalyzer()


# create get_sentiment function

def get_sentiment(text):

    scores = analyzer.polarity_scores(text)

    sentiment = 1 if scores['pos'] > 0 else 0

    return sentiment


# apply get_sentiment function

df['sentiment'] = df['reviewText'].apply(get_sentiment)

df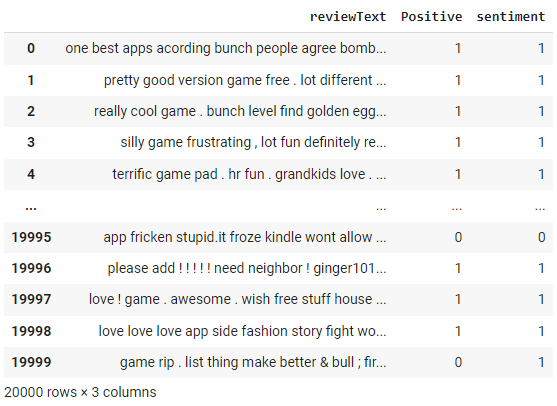
De NLTK-sentimentanalyzer geeft een score terug tussen -1 en +1. We hebben in de bovenstaande functie get_sentiment een drempelwaarde van 0 gebruikt. Alles boven 0 wordt geclassificeerd als 1 (oftewel positief). Omdat we echte labels hebben, kunnen we de prestaties van deze methode evalueren met een verwarringsmatrix.
from sklearn.metrics import confusion_matrix

print(confusion_matrix(df['Positive'], df['sentiment']))Output:
[[ 1131  3636]

 [  576 14657]]
We kunnen ook het classificatierapport bekijken:
from sklearn.metrics import classification_report

print(classification_report(df['Positive'], df['sentiment']))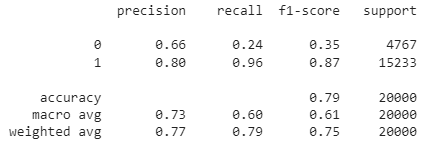
Zoals je ziet is de algehele nauwkeurigheid van dit regelgebaseerde sentimentanalysemodel 79%. Omdat dit gelabelde data is, kun je ook een ML-model bouwen om te zien of een ML-gebaseerde aanpak tot een betere nauwkeurigheid leidt.
Bekijk de volledige notebook in de Datacamp-werkruimte.
NLTK is een krachtige en flexibele bibliotheek voor sentimentanalyse en andere NLP-taken in Python. Met NLTK kun je tekstdata pre-processen, omzetten naar een bag-of-words-model en sentimentanalyse uitvoeren met de VADER-sentimentanalyzer.
In deze tutorial hebben we de basis van NLTK-sentimentanalyse verkend, waaronder het pre-processen van tekstdata, het maken van een bag-of-words-model en het uitvoeren van sentimentanalyse met NLTK VADER. We hebben ook de voordelen en beperkingen van NLTK-sentimentanalyse besproken en suggesties gegeven voor verdere verdieping.
Al met al is NLTK een krachtig en breed gebruikt hulpmiddel voor sentimentanalyse en andere NLP-taken in Python. Door de technieken en tools uit deze tutorial onder de knie te krijgen, kun je waardevolle inzichten uit tekstdata halen en die inzetten voor datagedreven beslissingen in allerlei toepassingen.
Wil je leren hoe je NLP toepast op real-world data, waaronder TED-talks, artikelen en filmrecensies, met Python-libraries en -frameworks zoals NLTK, scikit-learn, spaCy en SpeechRecognition? Bekijk dan de onderstaande resources:
Dit biedt een sterke basis voor het verwerken en analyseren van tekstdata met Python. Of je nu nieuw bent in NLP of je skills wilt uitbreiden, deze cursus geeft je de tools en kennis om ongestructureerde data om te zetten in waardevolle inzichten.
Python-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

