Curso
Programación asistida por IA para desarrolladores
1 h 30 min
10.7K
Z.ai ha lanzado GLM-5.3-Flash, el hermano optimizado en costes de su buque insignia GLM-5.3, que llegó bajo un nombre en clave anónimo antes de presentarse públicamente como "Ox Alpha". Qwen3.8-Flash-Next salió el mismo día, así que el segmento de LLM de bajo coste se puso interesante rápido.
Si has estado siguiendo la carrera entre los laboratorios chinos de pesos abiertos y la vanguardia occidental, este lanzamiento merece tu atención.
La promesa principal es sencilla: rendimiento en programación y agentes cercano a la vanguardia por una fracción del coste.
GLM-5.3-Flash obtiene 84,3 en Terminal-Bench 2.1, quedándose a tiro de Claude Opus 4.8 (85,0) y GPT-5.6 Terra (87,4).
Usa un diseño mixture-of-experts con configuración 320B-A18B (320B parámetros agregados, 18B activos por token), admite una ventana de contexto de 1M de tokens y es multimodal de forma nativa.
En este artículo, cubro todo lo nuevo de GLM-5.3-Flash, repasando sus funcionalidades y analizando los benchmarks. Para ver el modelo en acción, no te pierdas nuestro tutorial de GLM-5.3-Flash, en el que lo usamos con CrewAI para crear un equipo financiero multiagente.
Si quieres compararlo con el otro modelo económico que salió el mismo día, consulta nuestra guía de Qwen3.8-Flash-Next, y si buscas un modelo MoE similar que ejecutamos en local, echa un vistazo a nuestro tutorial sobre ejecutar DeepSeek-V4-Flash-0731.
GLM-5.3-Flash es el modelo optimizado en costes de la familia GLM-5.3 de Z.ai. Está por debajo del GLM-5.3 completo en capacidad, pero muy por debajo en precio.
Artificial Analysis lo valora con un índice de inteligencia de 57, frente a 60 para GLM-5.3.
El intercambio es velocidad y coste: Flash se sirve a un precio cercano a una décima parte del de GLM-5.2, o aproximadamente una novena parte del precio combinado de GLM-5.3, y genera tokens más despacio.
El modelo se publicó primero como vista previa anónima antes de recibir nombre, y la comunidad pronto lo apodó "Ox Alpha".
El checkpoint público está disponible como zai-org/GLM-5.3-Flash en Hugging Face, con soporte de contexto largo (~1M de tokens) y funcionalidades de tool calling y multimodalidad expuestas a través del ecosistema.
El benchmark clave aquí es Terminal-Bench 2.1, donde GLM-5.3-Flash alcanza 84,3. Es superior a los 82,7 que vimos en DeepSeek-V4-Flash-0731 y a solo 0,7 puntos de Claude Opus 4.8. Para un modelo con un precio combinado ponderado por uso estimado en unos $0,10 por 1M de tokens, ahí está el titular del lanzamiento.
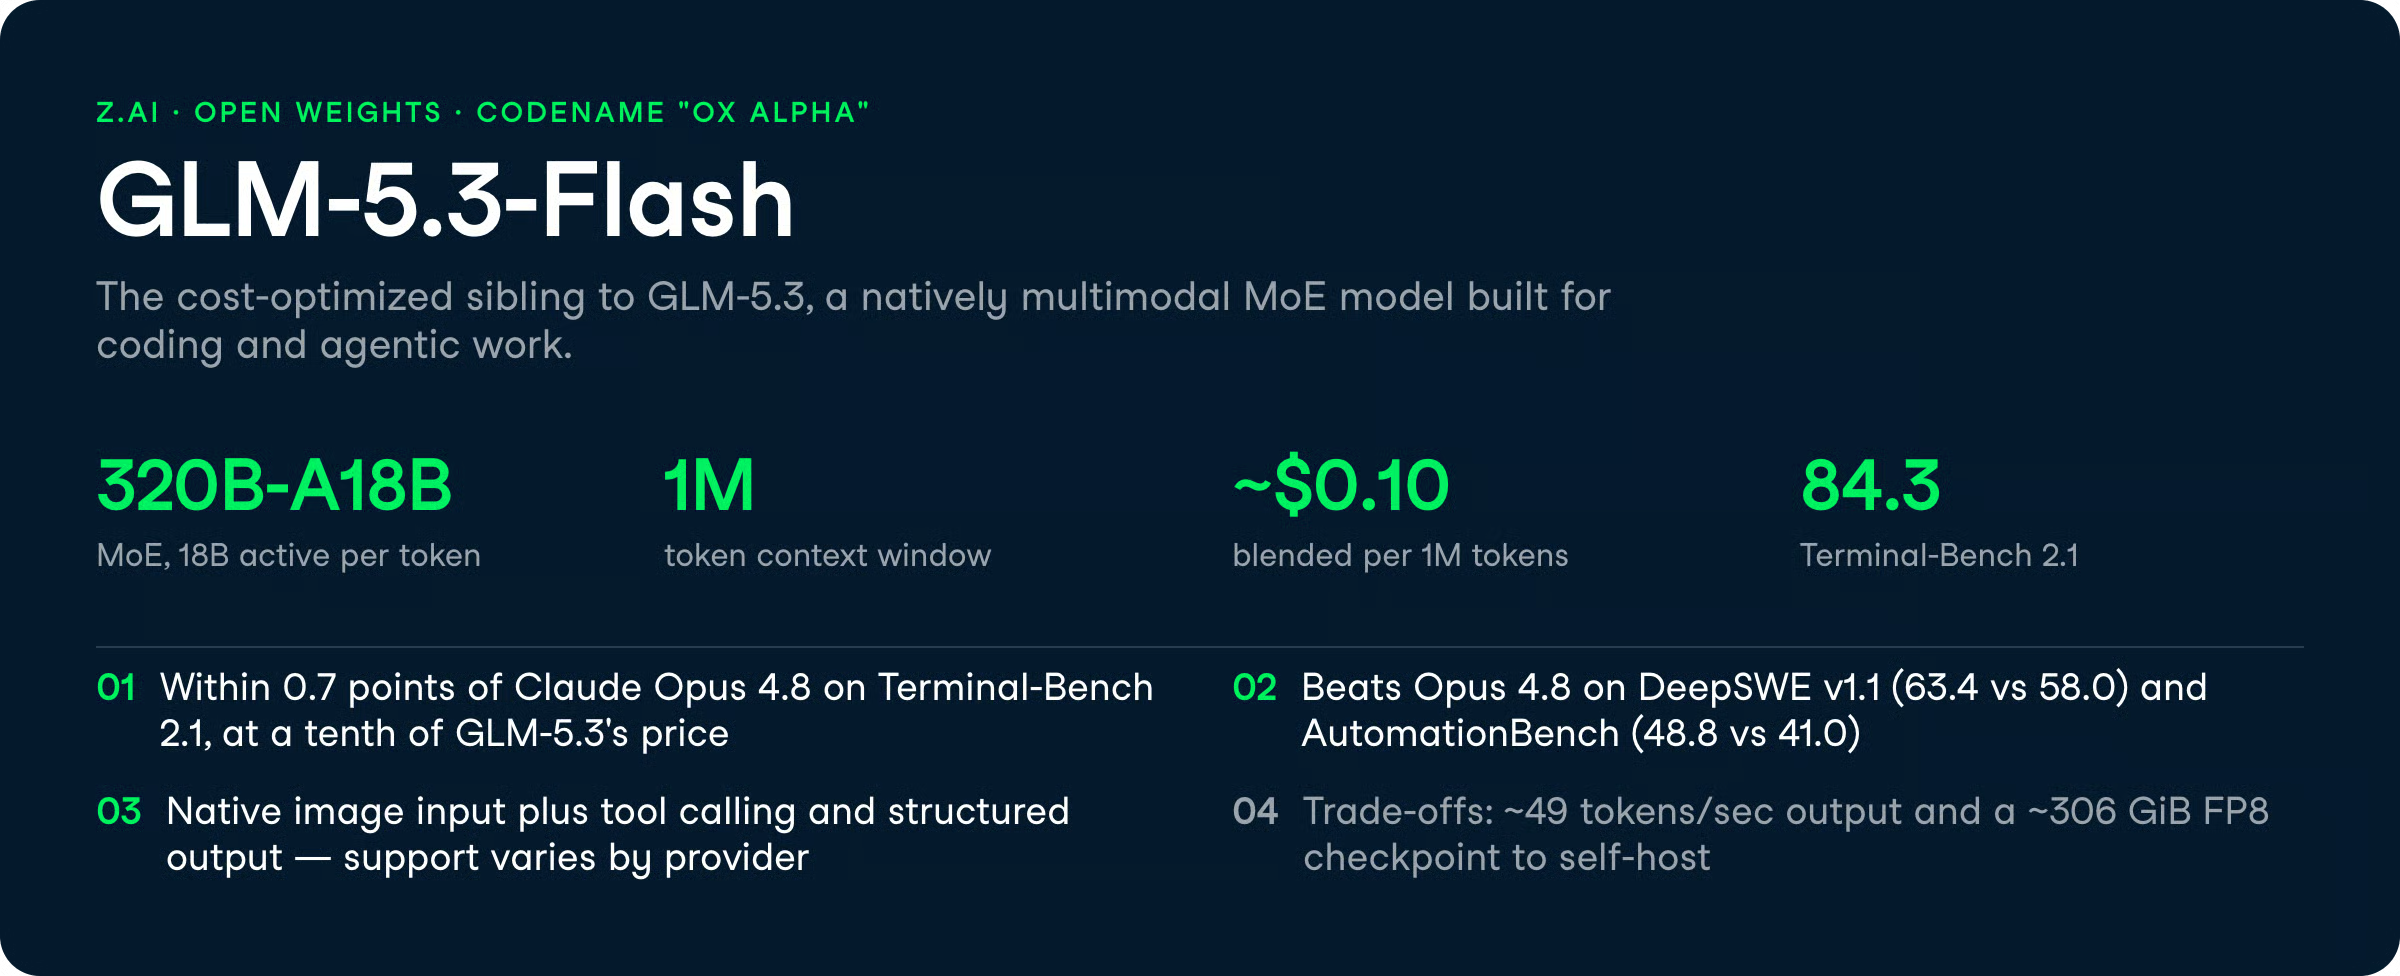
GLM-5.3-Flash está pensado para desarrolladores que quieren rendimiento en agentes y programación sin pagar precio de buque insignia.
Estas son las capacidades que más importan en el día a día.
Puedes ejecutar agentes de código y flujos de automatización a un precio que hace viable el uso a gran escala.
GLM-5.3-Flash logra 84,3 en Terminal-Bench 2.1 y 63,4 en DeepSWE v1.1, un salto notable desde el 46,2 de GLM-5.2 en la misma evaluación.
Para profesionales, el atractivo está en ejecutar tareas de programación que serían caras en modelos de clase Opus.
Algunas comparativas sitúan a Flash como "fuerte" para código y agentes de automatización a un coste sustancialmente menor que GLM-5.3, y el salto en DeepSWE frente a GLM-5.2 sugiere que las mejoras en programación son reales y no específicas de un benchmark.
Puedes introducir repositorios completos, documentos largos o trazas de agentes con múltiples archivos en una sola petición.
GLM-5.3-Flash admite una ventana de contexto de 1M de tokens, igual que GLM-5.3 y los 1M de GPT-5.6 Terra y Claude Sonnet 5.
Ahora bien, algunos comentarios de la comunidad mencionan un "desfase" de la atención a longitudes extremas más allá de ~700K tokens, una limitación compartida por la mayoría de pares con contextos amplios.
Se reporta buen recuerdo a lo largo de cientos de miles de tokens, pero no asumas una recuperación perfecta al final de la ventana.
Puedes integrar GLM-5.3-Flash en frameworks de agentes con llamadas a funciones y esquemas JSON forzados. El modelo consigue 78,4 en Toolathlon y 48,8 en AutomationBench, este último un gran salto frente al 26,2 de GLM-5.2.
Un aspecto a vigilar: el soporte varía según el proveedor.
Algunas pasarelas marcan la salida estructurada como no compatible y el manejo del prompt de sistema difiere entre proveedores alojados, así que puede que tengas que adaptar tu esquema de herramientas y el modo JSON por endpoint.
Puedes enviar imágenes junto con texto para lectura de gráficos, análisis de documentos y razonamiento visual.
GLM-5.3-Flash obtiene un 89,4% en CharXiv-R, 80,5 en MMVU y 78,0 en Chartography, lo que apunta a un manejo sólido de gráficos y documentos visuales.
El soporte multimodal es nativo y no un añadido posterior, aunque, como con la llamada a herramientas, la superficie exacta depende del proveedor que uses. Un uso básico en Hugging Face puede no exponer todo lo que ofrece la API alojada.
GLM-5.3-Flash puntúa 57 en el Artificial Analysis Intelligence Index v4.1.1 a $0,045 por tarea (con descuento). Z.ai afirma que ese nivel de inteligencia antes costaba aproximadamente diez veces más.
La evaluación con seis benchmarks que sigue compara Flash con GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra y Gemini 3.7 Flash.
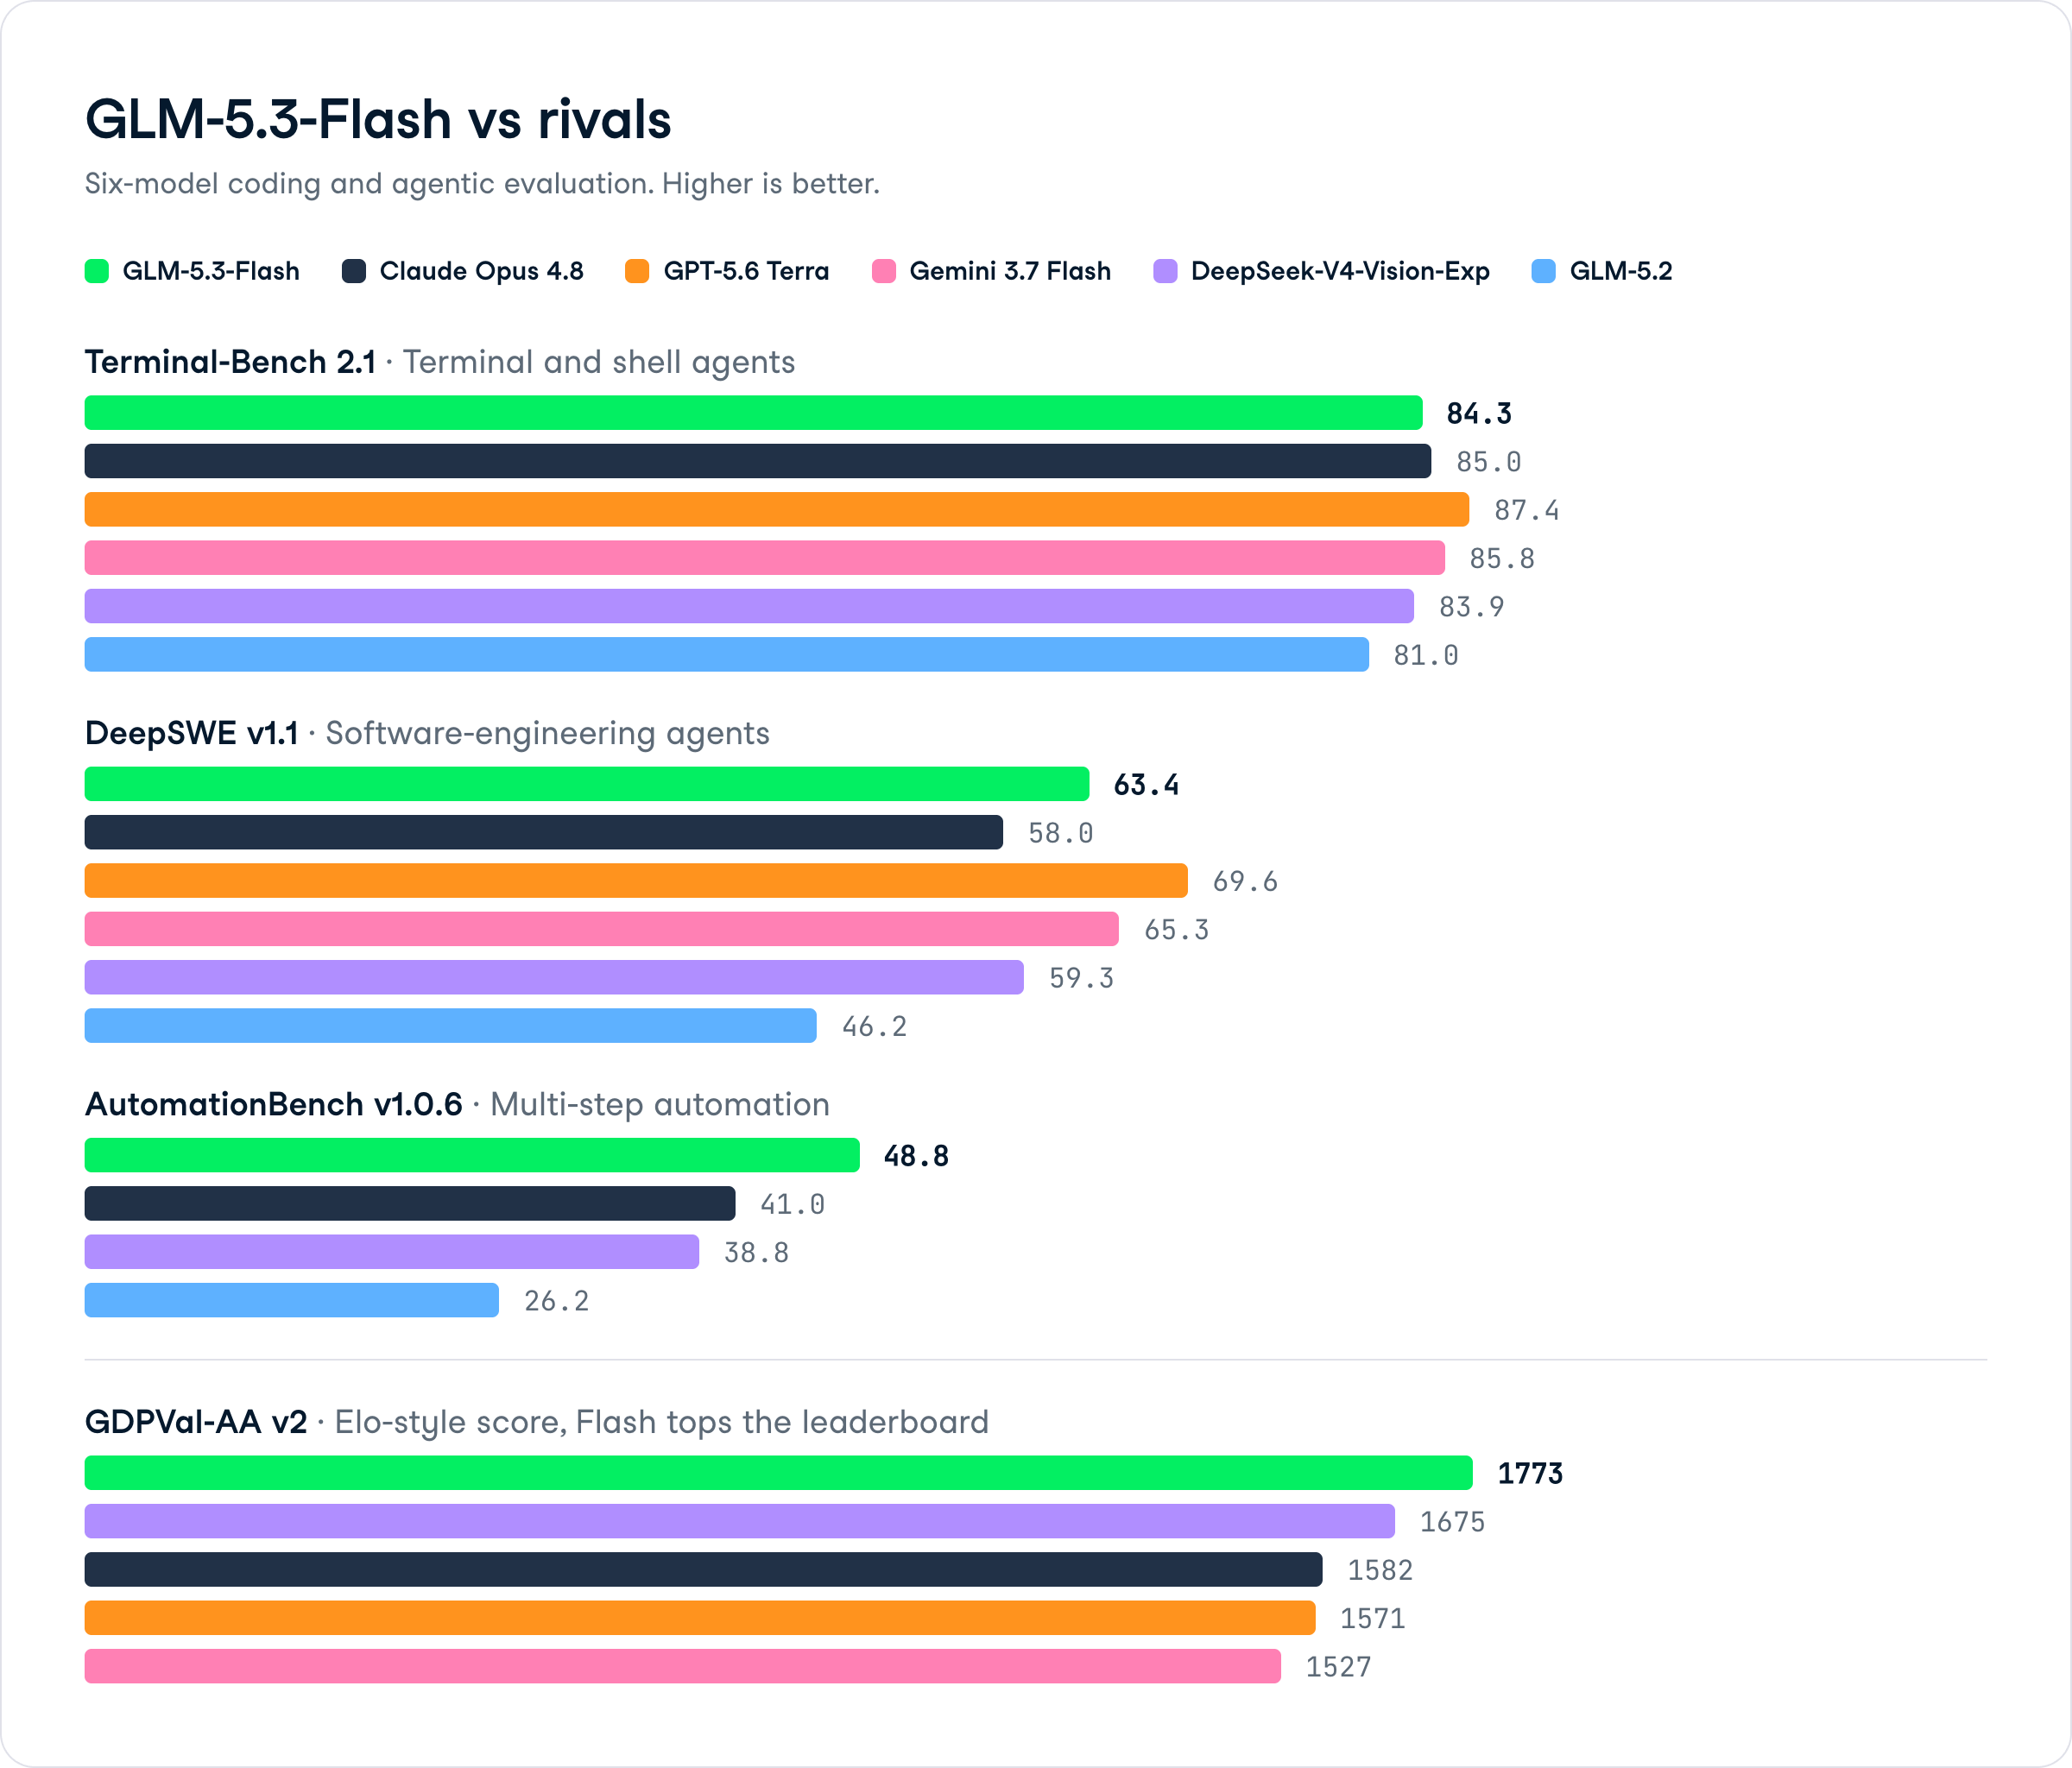
En este benchmark de agentes para ingeniería de software, GLM-5.3-Flash alcanza 63,4, por delante de Claude Opus 4.8 (58,0) y DeepSeek-V4-Vision-Exp (59,3), y sube desde el 46,2 de GLM-5.2.
Se queda por detrás de GPT-5.6 Terra (69,6) y Gemini 3.7 Flash (65,3), pero superar a Claude al coste de Flash es aquí el dato práctico.
GLM-5.3-Flash logra 48,8 en flujos de automatización multi-paso, la mayor ventaja frente a Claude Opus 4.8 (41,0) y DeepSeek-V4-Vision-Exp (38,8) de todos los benchmarks del conjunto.
GLM-5.2 obtuvo 26,2, así que también es la mejora generación a generación más marcada.
En esta evaluación general de desarrollo y programación, Flash encabeza la tabla con 1773, por delante de DeepSeek-V4-Vision-Exp (1675), Claude Opus 4.8 (1582), GPT-5.6 Terra (1571) y Gemini 3.7 Flash (1527).
Flash consigue 84,3 en tareas de terminal y shell para agentes, situándose justo por debajo de Claude Opus 4.8 (85,0) y Gemini 3.7 Flash (85,8), y detrás de GPT-5.6 Terra (87,4). Supera ligeramente a GLM-5.2 (81,0) y DeepSeek-V4-Vision-Exp (83,9). Competitivo, no dominante.
GLM-5.3-Flash está disponible a través de la API de Z.ai y mediante múltiples pasarelas de terceros, incluyendo Baseten, Deep Infra, Venice AI y Requesty.
El checkpoint público zai-org/GLM-5.3-Flash está en Hugging Face para autoalojamiento.
El precio base oficial de Z.ai y su promoción por tiempo limitado son los siguientes:
Apidog informa de un precio combinado ponderado por uso de unos $0,10 por 1M de tokens para Flash, frente a aproximadamente $0,90 para GLM-5.3.
Las pasarelas de terceros lo tarifican de forma distinta: EmpirioLabs a $0,07 entrada / $0,25 salida, Venice AI a $0,09 / $0,31 y Requesty a $0,14 / $0,45 con una promoción del 55% hasta el 9 de septiembre de 2026.
La contrapartida es el rendimiento y el hardware.
Flash sirve a ~49 tokens/seg frente a ~86 de GLM-5.3, y Artificial Analysis le da 2/4 en velocidad.
El autoalojamiento tampoco es ligero: el checkpoint FP8 ocupa ~306 GiB solo en pesos antes de KV-cache y ejecución, así que necesitas varias GPU con mucha memoria (piensa en >4×80 GiB) en lugar de una sola tarjeta.
La elección entre ambos depende de coste frente a índice de inteligencia y rendimiento. La tabla siguiente resume el intercambio.
| Atributo | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Índice de inteligencia (Artificial Analysis) | 57 | 60 |
| Precio combinado / 1M tokens | ~$0,10 | ~$0,90 |
| Velocidad de salida | ~49 tokens/seg | ~86 tokens/seg |
| Tiempo al primer token | ~1,52 s | ~1,57 s |
| Terminal-Bench 2.1 | 84,3 | N/D en notas |
| Ventana de contexto | 1M | 1M |
Elige Flash cuando el coste por token sea la restricción y tu trabajo sea programación o agentes. Elige GLM-5.3 cuando necesites esos puntos extra de índice de inteligencia y aproximadamente el doble de rendimiento.
Ambos modelos se lanzaron el 26 de agosto de 2026, dirigidos al mismo segmento económico para agentes. GLM-5.3-Flash supera a Qwen3.8-Flash-Next en el único benchmark que comparten directamente (DeepSWE v1.1: 63,4 vs 58,7), pero son lo bastante distintos como para que la elección dependa más de tu carga de trabajo que de una sola cifra.
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| Arquitectura | 320B total / 18B activos | 125B total / 6B activos |
| Contexto nativo | 1M tokens | 262K (1M con YaRN) |
| DeepSWE v1.1 | 63,4 | 58,7 |
| Precio de entrada | ~$0,075/1M (promo) | $0,16/1M |
| Multimodal | Sí (nativo) | Sí (nativo) |
GLM-5.3-Flash activa tres veces más parámetros por token, lo que probablemente explica su ventaja en DeepSWE y el resultado en Terminal-Bench 2.1 (84,3).
Qwen3.8-Flash-Next contraataca con mejores puntuaciones reportadas en SWE-bench Pro (62,5) y en benchmarks de oficina y agentes como CoWorkBench (73,9) y JobBench (55,7), donde GLM no publica cifras comparables.
En precio, GLM es más barato durante su ventana promocional. En eficiencia de parámetros, Qwen hace más con una huella activa menor. En autoalojamiento, el checkpoint más pequeño de Qwen es mucho más fácil de ejecutar en local.
Si tu prioridad son los agentes de programación y el rendimiento bruto en tareas agenticas, GLM-5.3-Flash trae mejores números donde la comparación es directa. Si tus flujos son de oficina, multimodales o se benefician de un checkpoint más pequeño en local, Qwen3.8-Flash-Next merece ser tu primera prueba.
Consulta nuestra guía completa de Qwen3.8-Flash-Next para un desglose al detalle.
GLM-5.3-Flash es la apuesta clara de Z.ai por el segmento económico de agentes: quedarse a uno o dos puntos de Opus 4.8 y GPT-5.6 Terra en evaluaciones de código, y rebajar su precio en un orden de magnitud.
El 84,3 en Terminal-Bench 2.1 con un combinado de ~$0,10 por 1M de tokens es su argumento, y es sólido para programación y automatización a gran volumen.
Las limitaciones llegan por la velocidad y la infraestructura.
Con ~49 tokens/seg no es el modelo para streaming sensible a la latencia, y el checkpoint FP8 de ~306 GiB descarta un despliegue local casual. Usuarios tempranos en r/opencodeCLI reportaron colas y arranques lentos bajo carga, aunque la GA probablemente haya mejorado eso.
Mi recomendación: si el coste por token es tu restricción y tu trabajo es programación o agentes, vale la pena probar GLM-5.3-Flash frente a GPT-5.6 Terra y Claude Opus 4.8 antes de decidir.
Si necesitas esos 3 puntos extra de índice de inteligencia y más rendimiento, el GLM-5.3 completo existe por algo. Además, llega el mismo día que Qwen3.8-Flash-Next, así que ahora mismo conviene comparar dentro de la gama económica.
Si quieres familiarizarte con modelos como este, te recomiendo nuestro itinerario de aprendizaje AI Fundamentals para sentar las bases y luego nuestro tutorial sobre ejecutar un modelo MoE Flash en local para la parte práctica.
Los mejores cursos de DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
Tutorial
DataCamp Team
2 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
15 min
Tutorial
Josep Ferrer
11 min
Tutorial
Moez Ali
11 min