Curso
Trabajar con la API de OpenAI
3 h
172.6K
El modelo más avanzado de OpenAI, Generative Pre-trained Transformer 4 (GPT-4), lanzado en marzo de 2023, supone un gran salto en inteligencia artificial y marca un nuevo estándar en capacidades de IA. Disponible a través de ChatGPT Plus, la API de OpenAI y Microsoft Copilot, GPT-4 destaca por sus capacidades multimodales, especialmente con GPT-4V, que le permite procesar imágenes junto con texto y abre la puerta a aplicaciones innovadoras en múltiples ámbitos.
En el núcleo del avance de GPT-4 está su arquitectura basada en transformers, ampliamente preentrenada con una gran variedad de datos de internet y fuentes con licencia, y afinada con una combinación de feedback humano y aprendizaje por refuerzo impulsado por IA. Este enfoque busca mejorar la alineación del modelo con estándares éticos humanos y el cumplimiento de políticas.
Aunque GPT-4 supone una mejora respecto a su predecesor, GPT-3, hereda algunas de sus limitaciones, lo que pone de relieve los complejos retos de los modelos de lenguaje grandes y la IA generativa. Parte de esos retos pueden abordarse con un proceso llamado ajuste fino (fine-tuning), que es el tema de este tutorial. Los objetivos de este tutorial son:
No obstante, conviene señalar que el ajuste fino de GPT-4 está actualmente en acceso experimental, y los desarrolladores elegibles pueden solicitar acceso desde la interfaz de ajuste fino. Aun así, las técnicas que cubrimos se aplican a todos los modelos GPT.
El ajuste fino es un proceso avanzado para adaptar modelos preentrenados (como GPT-4) a tareas o dominios específicos, aprovechando el amplio conocimiento base adquirido durante el entrenamiento inicial con conjuntos de datos diversos. Consiste en ajustar los parámetros del modelo con datos específicos de la tarea para mejorar su rendimiento y permitirle abordar aplicaciones concretas con mayor precisión y eficiencia.
Un ejemplo ilustrativo del impacto del ajuste fino es mejorar las respuestas del modelo ante consultas especializadas. Por ejemplo, un modelo preentrenado podría dar una explicación básica de por qué el cielo es azul. Con el ajuste fino, esa respuesta puede enriquecerse con contexto científico detallado, haciéndola más adecuada para aplicaciones específicas como plataformas educativas.
Los métodos de ajuste fino van desde el instruction fine-tuning, donde se entrena con ejemplos que muestran las respuestas deseadas, hasta el parameter-efficient fine-tuning (PEFT), que actualiza solo una parte de los parámetros del modelo para ahorrar recursos computacionales y evitar el olvido catastrófico.
En contraste, la generación aumentada con recuperación (RAG) representa un enfoque distinto. RAG combina elementos de recuperación de información y modelos generativos para mejorar la calidad del contenido generado incorporando información obtenida de fuentes externas durante el propio proceso de generación.
Mientras que el ajuste fino se centra en optimizar modelos existentes para tareas concretas, RAG integra conocimiento externo para enriquecer la generación de contenido.
La elección entre ajuste fino y RAG depende de los requisitos de la aplicación: necesidad de información actualizada, recursos computacionales disponibles y nivel de especialización deseado. El ajuste fino ofrece una forma directa de aprovechar la vasta base de conocimiento de los modelos preentrenados para tareas específicas, mientras que RAG aporta un enfoque dinámico para garantizar la relevancia y precisión de la información que usa el modelo.
El ajuste fino de los modelos de generación de texto de OpenAI es una forma potente de adaptarlos a necesidades concretas, pero exige tiempo y recursos. Antes de lanzarte a ello, conviene exprimir el rendimiento del modelo mediante prompt engineering, prompt chaining (dividir tareas complejas en prompts más simples y secuenciales) y uso de funciones. Este enfoque se recomienda por varias razones:
El ajuste fino puede ser especialmente útil en los siguientes escenarios:
Dada la naturaleza propietaria de los modelos de OpenAI, si quieres ajustar cualquiera de sus modelos debes usar su API de ajuste fino. Este proceso implica subir tus datos a los servidores de OpenAI para entrenar el modelo.
Actualmente, solo los siguientes modelos admiten ajuste fino vía API.
El ajuste fino de GPT-4 está en acceso experimental, y los desarrolladores elegibles pueden solicitar acceso desde la interfaz de ajuste fino. Independientemente del modelo, el proceso y el código de este tutorial no cambian.
Este es el paso más importante. La calidad de un modelo ajustado depende directamente de los datos que crees para afinarlo. Para la API de OpenAI, los datos deben estar en formato jsonl.
El formato JSONL es un formato de texto donde cada línea es un objeto JSON independiente, lo que facilita procesar grandes conjuntos de datos línea a línea. Es especialmente útil para manejar datos que pueden dividirse en registros individuales sin perder estructura.
Ejemplo:
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
Para este tutorial, he creado datos de ejemplo con solo cinco casos. Los datos son preguntas sobre varios temas de machine learning y respuestas al estilo de Shakespeare.
Datos de ejemplo creados para este tutorial:
{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "What is machine learning?"}, {"role": "assistant", "content": "'Tis but the art of teaching machines to think, to learn from data most fine, and decisions to link."}]}

{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "How doth neural networks work?"}, {"role": "assistant", "content": "They're like the brains of yon digital beast, with layers many, and nodes that cease."}]}El primer paso para crear un trabajo de ajuste fino con la API de OpenAI es subir el archivo. Para usar esta API, debes tener instalada la librería openai en Python.
!pip install openaiAhora inicia sesión en tu cuenta de platform.openai.com y genera un token de API:
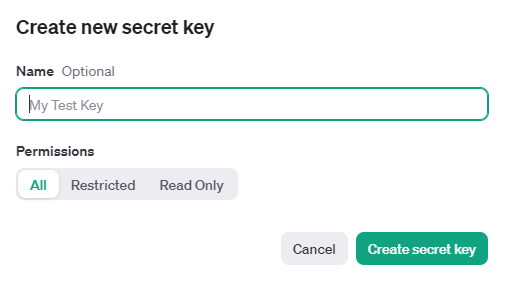
Después, puedes establecer el token como variable de entorno usando la librería os.
import os


# Set the OPENAI_API_KEY environment variable
os.environ['OPENAI_API_KEY'] = '...'Tu archivo de entrenamiento debe estar en formato jsonl. Una vez subido, el procesamiento puede tardar un rato. El tamaño máximo para subir archivos es de 1 GB. Para subir un archivo al servidor de OpenAI:
from openai import OpenAI
client = OpenAI()


client.files.create(
  file=open("train.jsonl", "rb"),
  purpose="fine-tune"
)
Salida:
FileObject(id='file-rIua39sJX1O64gzxTYfpvJx7', bytes=11165, created_at=1709499930, filename='train.jsonl', object='file', purpose='fine-tune', status='processed', status_details=None)Una vez verificado que el archivo se ha subido correctamente, el siguiente paso es crear un trabajo de ajuste fino. training_file es el ID que devolvió la API al subir el archivo de entrenamiento. Para iniciar un trabajo de ajuste fino:
from openai import OpenAI
client = OpenAI()


client.fine_tuning.jobs.create(
  training_file="file-rIua39sJX1O64gzxTYfpvJx7",
  model="gpt-3.5-turbo" #change to gpt-4-0613 if you have access
)
Para configurar opciones adicionales, como archivo de validación o hiperparámetros, consulta la documentación del API de ajuste fino.
El tiempo de los trabajos de ajuste fino varía entre minutos y horas, según el modelo y el tamaño del dataset. Por ejemplo, con solo 50 ejemplos en nuestro train.jsonl y usando el modelo gpt-3.5-turbo, el trabajo terminó en solo 7 minutos.
Al finalizar el trabajo, también recibirás un correo de confirmación.
Además de configurar un trabajo de ajuste fino, puedes ver el listado de trabajos actuales, comprobar el estado de uno concreto o cancelarlo.
from openai import OpenAI
client = OpenAI()


# List 10 fine-tuning jobs
client.fine_tuning.jobs.list(limit=10)


# Retrieve the state of a fine-tune
client.fine_tuning.jobs.retrieve("...")


# Cancel a job
client.fine_tuning.jobs.cancel("...")


# List up to 10 events from a fine-tuning job
client.fine_tuning.jobs.list_events(fine_tuning_job_id="...", limit=10)


# Delete a fine-tuned model (must be an owner of the org the model was created in)
client.models.delete("ft:gpt-3.5-turbo:xxx:xxx")\OpenAI ofrece métricas clave como pérdida de entrenamiento, precisión de tokens en entrenamiento, pérdida en test y precisión de tokens en test. Estas métricas ayudan a comprobar que el entrenamiento progresa como se espera: la pérdida disminuye y la precisión mejora. Puedes ver estas métricas útiles en un objeto de eventos durante un trabajo de ajuste fino activo.
{
    "object": "fine_tuning.job.event",
    "id": "ftjob-Na7BnF5y91wwGJ4EgxtzVyDD",
    "created_at": 1693582679,
    "level": "info",
    "message": "Step 100/100: training loss=0.00",
    "data": {
        "step": 100,
        "train_loss": 1.805623287509661e-5,
        "train_mean_token_accuracy": 1.0
    },
    "type": "metrics"
}
También puedes ver esta información en la interfaz.
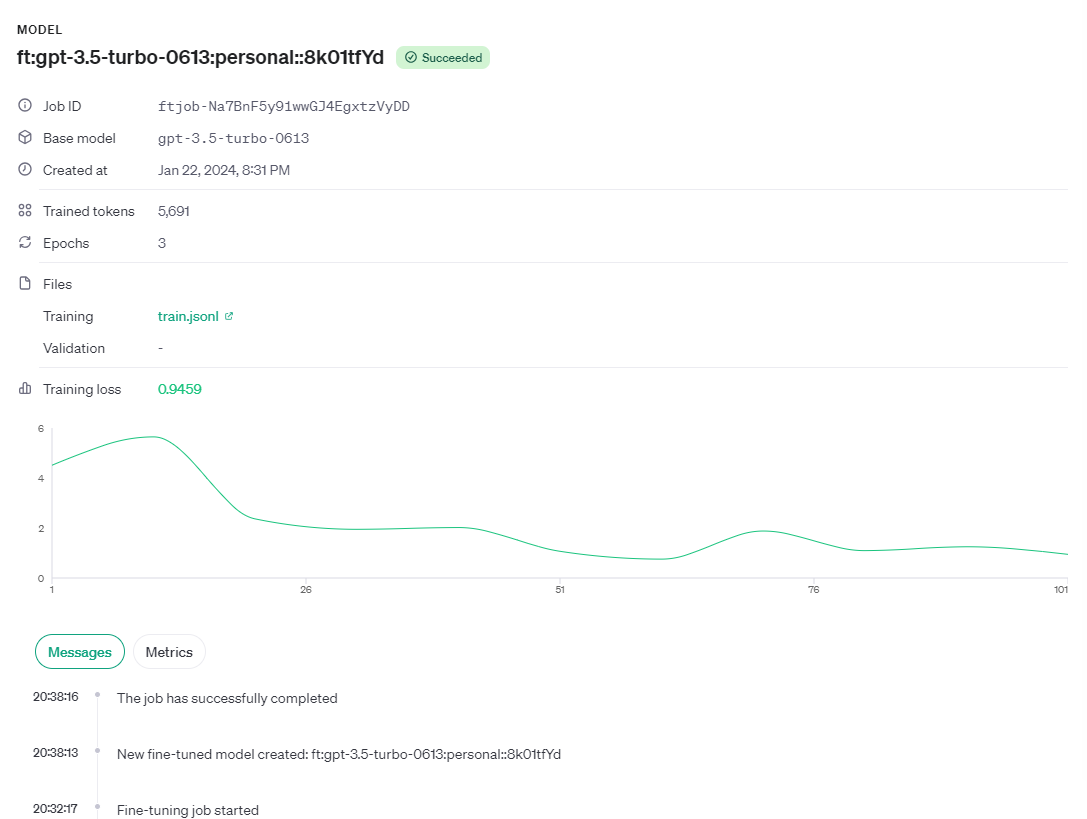
Cuando un trabajo finaliza correctamente, los detalles incluyen el campo fine_tuned_model con el nombre del modelo. Puedes hacer una llamada a la API a ese modelo y obtener una respuesta del modelo que acabamos de ajustar.
from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="ft:gpt-3.5-turbo-0613:personal::8k01tfYd",
  messages=[
    {"role": "system", "content": "You are a teaching assistant for Machine Learning. You should help to user to answer on his question."},
    {"role": "user", "content": "What is a loss function?"}
  ]
)
print(completion.choices[0].message)
Salida:
ChatCompletionMessage(content="To measure how far we falter, it guides our way, our hope's defaulter.", role='assistant', function_call=None, tool_calls=None)Este tutorial te ha guiado por el proceso de ajuste fino de un modelo GPT de OpenAI, un paso avanzado para aprovechar las amplias capacidades de los LLM en aplicaciones de dominio especializado. El ajuste fino permite refinar las respuestas del modelo de lenguaje, haciéndolas más aptas para manejar tareas, estilos o dominios concretos con mayor precisión y eficiencia.
Este tutorial utiliza la API de OpenAI para Python para ajustar un modelo. Si prefieres aprender a hacerlo desde una interfaz sin escribir ni una línea de código, echa un vistazo al tutorial How to Fine Tune GPT 3.5 en Datacamp.
Como GPT no es un modelo de código abierto, el proceso de ajuste fino es bastante simple y se reduce a hacer llamadas a la API. Esto es muy diferente cuando se trata de ajustar modelos de código abierto como llama-2, Mistral, Stable Diffusion, etc. Si te interesa aprender a ajustar distintos modelos de código abierto, puedes consultar estos artículos en DataCamp:
Para más recursos de iniciación sobre ajuste fino de LLM, consulta An Introductory Guide to Fine-Tuning LLMs en Datacamp.
¡Empieza hoy tu camino en IA!
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Abid Ali Awan
9 min
Tutorial
Zoumana Keita
12 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Moez Ali
11 min
Tutorial
Moez Ali
9 min







