Kurs
Arbeiten mit der OpenAI-API
3 Std.
172.6K
OpenAI’s fortschrittlichstes Modell, Generative Pre-trained Transformer 4 (GPT-4), ist im März 2023 erschienen und setzt einen neuen Maßstab für KI-Fähigkeiten. Verfügbar über ChatGPT Plus, die OpenAI API und Microsoft Copilot, überzeugt GPT-4 vor allem durch seine multimodalen Fähigkeiten — etwa mit GPT-4V, das Bilder zusammen mit Text verarbeiten kann und so den Weg für innovative Anwendungen in vielen Bereichen ebnet.
Im Kern basiert der Fortschritt von GPT-4 auf einem Transformer-Framework, das umfassend auf einer großen Vielfalt an Internet- und lizenzierten Daten vortrainiert und mithilfe einer Mischung aus menschlichem Feedback und KI-gestütztem Reinforcement Learning feinabgestimmt wurde. Dieser Ansatz sorgt dafür, dass das Modell besser mit ethischen Standards von Menschen und Richtlinien in Einklang steht.
Auch wenn GPT-4 gegenüber seinem Vorgänger GPT-3 einen deutlichen Sprung macht, übernimmt es einige der bekannten Einschränkungen — ein Hinweis auf die komplexen Herausforderungen großer Sprachmodelle und generativer KI. Ein Teil dieser Herausforderungen lässt sich über Feintuning adressieren, um das es in diesem Tutorial geht. Die Ziele dieses Tutorials sind:
Beachte jedoch, dass GPT-4-Feintuning derzeit nur im experimentellen Zugriff verfügbar ist. Berechtigte Entwickler/innen können über die Fine-Tuning-UI Zugang beantragen. Die hier gezeigten Feintuning-Techniken sind jedoch auf alle GPT-Modelle übertragbar.
Feintuning ist ein fortgeschrittener Prozess, bei dem vortrainierte Modelle (wie GPT-4) für spezifische Aufgaben oder Domänen veredelt werden. Dabei wird auf das breite Basiswissen aufgebaut, das das Modell während des Vortrainings auf diversen Datensätzen erworben hat. Durch die Anpassung von Modellparametern an aufgabenspezifische Daten steigt die Leistungsfähigkeit, und das Modell kann bestimmte Anwendungen präziser und effizienter bearbeiten.
Ein anschauliches Beispiel für die Wirkung von Feintuning ist die Verfeinerung fachlicher Antworten. Ein vortrainiertes Modell liefert etwa eine einfache Erklärung, warum der Himmel blau ist. Durch Feintuning kann diese Antwort um fundierten wissenschaftlichen Kontext erweitert werden — ideal für Anwendungen wie Lernplattformen.
Feintuning-Methoden reichen von Instruction Tuning, bei dem Modelle mit konkreten Beispielen für gewünschte Antworten trainiert werden, bis zu Parameter-Efficient Fine-Tuning (PEFT), das nur einen Teil der Modellparameter aktualisiert, um Rechenressourcen zu sparen und katastrophales Vergessen zu vermeiden.
Im Unterschied dazu verfolgt Retrieval Augmented Generation (RAG) einen anderen Ansatz. RAG kombiniert Elemente aus Retrieval-basierten und generativen Modellen, indem während der Generierung Informationen aus externen Quellen eingebunden werden, um die Qualität der Ausgaben zu verbessern.
Während Feintuning vortrainierte Modelle gezielt für bestimmte Aufgaben optimiert, reichert RAG den Generierungsprozess mit externem Wissen an.
Die Wahl zwischen Feintuning und RAG hängt von den Anforderungen der Anwendung ab — etwa, ob aktuelle Informationen benötigt werden, welche Rechenressourcen verfügbar sind und wie spezialisiert die Aufgabe ist. Feintuning nutzt das breite Wissen vortrainierter Modelle direkt für spezifische Aufgaben, während RAG dynamisch für Relevanz und Genauigkeit der verwendeten Informationen sorgt.
Feintuning von OpenAIs Textgenerierungsmodellen ist eine mächtige Möglichkeit, sie auf spezifische Bedürfnisse zuzuschneiden — es erfordert jedoch Zeit und Ressourcen. Bevor du ins Feintuning gehst, solltest du die Leistung über Prompt Engineering, Prompt Chaining (komplexe Aufgaben in aufeinanderfolgende, einfachere Prompts zerlegen) und Functions ausreizen. Das empfiehlt sich aus mehreren Gründen:
Feintuning lohnt sich besonders in folgenden Szenarien:
Da OpenAIs Modelle proprietär sind, musst du für das Feintuning die Fine-Tuning-API von OpenAI nutzen. Dabei lädst du deine Daten auf die Server von OpenAI hoch, um das Modell zu trainieren.
Aktuell werden über die API für Feintuning nur die folgenden Modelle unterstützt.
GPT-4-Feintuning befindet sich im experimentellen Zugriff. Berechtigte Entwickler/innen können über die Fine-Tuning-UI Zugang beantragen. Unabhängig vom gewählten Modell ändern sich Vorgehen und Code in diesem Tutorial nicht.
Das ist der wichtigste Schritt. Die Qualität eines feinabgestimmten Modells hängt direkt von den Daten ab, mit denen du es trainierst. Für die OpenAI API müssen die Daten im Format jsonl vorliegen.
JSONL ist ein Textformat, bei dem jede Zeile ein eigenes JSON-Objekt ist. So lassen sich große Datensätze zeilenweise effizient verarbeiten. Das Format eignet sich besonders für Daten, die sich in einzelne Einträge gliedern lassen, ohne die Struktur zu verlieren.
Beispiel:
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
Für dieses Tutorial habe ich Beispieldaten mit nur fünf Einträgen erstellt. Die Daten enthalten Fragen zu verschiedenen Machine-Learning-Themen und Antworten im Stil von Shakespeare.
Beispieldaten, die ich für dieses Tutorial erstellt habe:
{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "What is machine learning?"}, {"role": "assistant", "content": "'Tis but the art of teaching machines to think, to learn from data most fine, and decisions to link."}]}

{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "How doth neural networks work?"}, {"role": "assistant", "content": "They're like the brains of yon digital beast, with layers many, and nodes that cease."}]}Der erste Schritt für einen Fine-Tuning-Job mit der OpenAI API ist das Hochladen der Datei. Dafür muss die Python-Bibliothek openai installiert sein.
!pip install openaiMelde dich nun bei platform.openai.com an und generiere ein API-Token:
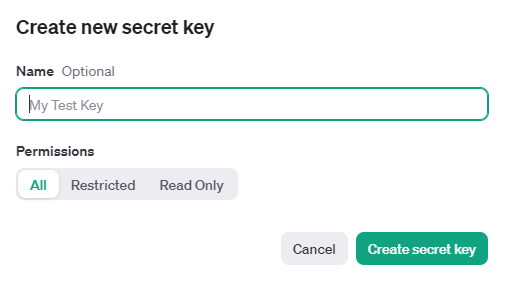
Anschließend kannst du das Token mit der Bibliothek os als Umgebungsvariable setzen.
import os


# Set the OPENAI_API_KEY environment variable
os.environ['OPENAI_API_KEY'] = '...'Deine Trainingsdatei muss im jsonl-Format vorliegen. Nach dem Upload kann die Verarbeitung etwas dauern. Die maximale Dateigröße für Uploads beträgt 1 GB. So lädst du eine Datei auf den OpenAI-Server hoch:
from openai import OpenAI
client = OpenAI()


client.files.create(
  file=open("train.jsonl", "rb"),
  purpose="fine-tune"
)
Ausgabe:
FileObject(id='file-rIua39sJX1O64gzxTYfpvJx7', bytes=11165, created_at=1709499930, filename='train.jsonl', object='file', purpose='fine-tune', status='processed', status_details=None)Nachdem die Datei erfolgreich hochgeladen wurde, erstellst du den Fine-Tuning-Job. training_file ist die ID, die beim Upload der Trainingsdatei von der OpenAI API zurückgegeben wurde. So startest du einen Fine-Tuning-Job:
from openai import OpenAI
client = OpenAI()


client.fine_tuning.jobs.create(
  training_file="file-rIua39sJX1O64gzxTYfpvJx7",
  model="gpt-3.5-turbo" #change to gpt-4-0613 if you have access
)
Weitere Feintuning-Optionen wie validation_file oder Hyperparameter findest du in der API-Dokumentation zum Feintuning.
Die Dauer eines Fine-Tuning-Jobs variiert je nach Modell und Datensatzgröße von Minuten bis Stunden. Mit nur 50 Beispielen in unserer train.jsonl und dem Modell gpt-3.5-turbo war der Job beispielsweise in 7 Minuten erledigt.
Nach Abschluss des Jobs erhältst du außerdem eine E-Mail-Bestätigung.
Neben dem Anlegen eines Fine-Tuning-Jobs kannst du laufende Jobs auflisten, den Status eines bestimmten Jobs abrufen oder einen Job abbrechen.
from openai import OpenAI
client = OpenAI()


# List 10 fine-tuning jobs
client.fine_tuning.jobs.list(limit=10)


# Retrieve the state of a fine-tune
client.fine_tuning.jobs.retrieve("...")


# Cancel a job
client.fine_tuning.jobs.cancel("...")


# List up to 10 events from a fine-tuning job
client.fine_tuning.jobs.list_events(fine_tuning_job_id="...", limit=10)


# Delete a fine-tuned model (must be an owner of the org the model was created in)
client.models.delete("ft:gpt-3.5-turbo:xxx:xxx")\OpenAI stellt zentrale Trainingsmetriken bereit, darunter Training Loss, Token-Genauigkeit im Training, Test Loss und Test-Token-Genauigkeit. Diese Metriken helfen zu überprüfen, ob das Training wie erwartet verläuft — mit sinkendem Loss und steigender Token-Genauigkeit. Während eines aktiven Fine-Tuning-Jobs kannst du diese Metriken in einem Event-Objekt einsehen.
{
    "object": "fine_tuning.job.event",
    "id": "ftjob-Na7BnF5y91wwGJ4EgxtzVyDD",
    "created_at": 1693582679,
    "level": "info",
    "message": "Step 100/100: training loss=0.00",
    "data": {
        "step": 100,
        "train_loss": 1.805623287509661e-5,
        "train_mean_token_accuracy": 1.0
    },
    "type": "metrics"
}
Du kannst diese Informationen auch in der UI einsehen.
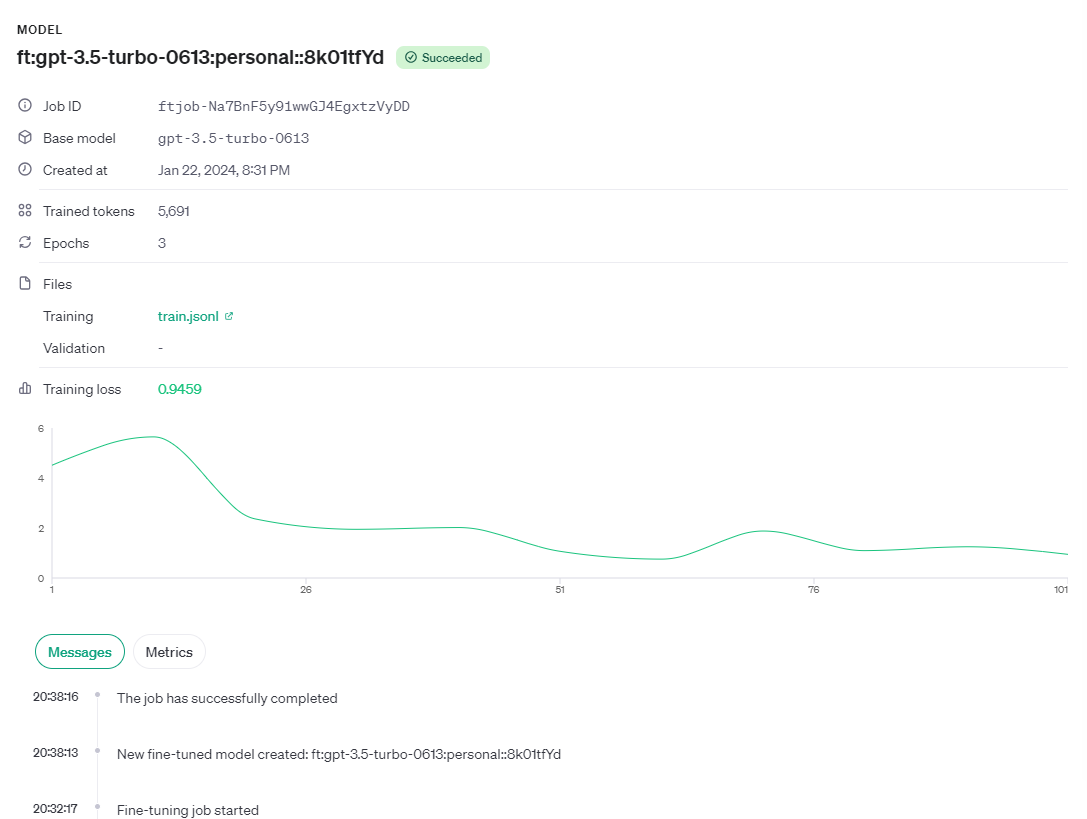
Nach erfolgreichem Abschluss enthält der Job die Eigenschaft fine_tuned_model mit dem Modellnamen. Du kannst dieses Modell per API ansprechen und Antworten vom soeben abgestimmten Modell abrufen.
from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="ft:gpt-3.5-turbo-0613:personal::8k01tfYd",
  messages=[
    {"role": "system", "content": "You are a teaching assistant for Machine Learning. You should help to user to answer on his question."},
    {"role": "user", "content": "What is a loss function?"}
  ]
)
print(completion.choices[0].message)
Ausgabe:
ChatCompletionMessage(content="To measure how far we falter, it guides our way, our hope's defaulter.", role='assistant', function_call=None, tool_calls=None)Dieses Tutorial hat dich Schritt für Schritt durch das Feintuning eines GPT-Modells von OpenAI geführt — ein wichtiger Hebel, um die umfangreichen Fähigkeiten großer Sprachmodelle für spezialisierte Domänen nutzbar zu machen. Feintuning verfeinert die Antworten des Sprachmodells, sodass es spezifische Aufgaben, Stile oder Domänen präziser und effizienter bewältigt.
In diesem Tutorial kam die OpenAI Python API für das Feintuning zum Einsatz. Wenn du dasselbe lieber über eine UI ohne eine einzige Zeile Code lernen möchtest, schau dir das Tutorial How to Fine Tune GPT 3.5 auf Datacamp an.
Da GPT kein Open-Source-Modell ist, ist der Feintuning-Prozess relativ einfach und läuft im Wesentlichen über API-Aufrufe. Ganz anders sieht es beim Feintuning von Open-Source-Modellen wie Llama 2, Mistral, Stable Diffusion usw. aus. Wenn du lernen möchtest, wie du verschiedene Open-Source-Modelle feinabstimmst, lies diese Blogs auf DataCamp:
Weitere Einstiegsressourcen zum Feintuning von LLMs findest du im Anfängerleitfaden für das Feintuning von LLMs auf Datacamp.
Starte heute deine KI-Reise!
Kurs
Kurs
Kurs