Curso
Trabalhar com a API da OpenAI
3 h
172.6K
O modelo mais avançado da OpenAI, o Generative Pre-trained Transformer 4 (GPT-4), lançado em março de 2023, representa um grande salto na inteligência artificial e estabelece um novo patamar para as capacidades de IA. Disponível via ChatGPT Plus, API da OpenAI e Microsoft Copilot, o GPT-4 se destaca por suas habilidades multimodais, principalmente com o GPT-4V, que permite processar imagens junto com texto e abre caminho para aplicações inovadoras em diversas áreas.
No centro dos avanços do GPT-4 está sua arquitetura baseada em transformers, extensivamente pré-treinada em um vasto conjunto de dados da internet e de fontes licenciadas, e ajustada com uma combinação de feedback humano e aprendizado por reforço orientado por IA. Essa abordagem busca alinhar o modelo a padrões éticos e políticas de uso.
Embora o GPT-4 traga melhorias em relação ao seu antecessor, o GPT-3, ele herda algumas limitações, evidenciando os desafios complexos de Large Language Models e IA generativa. Parte desses desafios pode ser tratada com um processo chamado fine-tuning, que é o foco deste tutorial. Os objetivos são:
Vale destacar que o fine-tuning do GPT-4 está, no momento, com acesso experimental, e desenvolvedores elegíveis podem solicitar acesso pela interface de fine-tuning. Dito isso, as técnicas abordadas valem para todos os modelos GPT.
Fine-tuning é um processo avançado que refina modelos pré-treinados (como o GPT-4) para tarefas ou domínios específicos, aproveitando o vasto conhecimento adquirido no treinamento inicial em dados diversos. Isso envolve ajustar os parâmetros do modelo com base em dados específicos da tarefa, elevando seu desempenho e permitindo lidar com aplicações particulares com mais precisão e eficiência.
Um exemplo ilustrativo do impacto do fine-tuning é o aprimoramento de respostas a perguntas especializadas. Por exemplo, um modelo pré-treinado pode oferecer uma explicação básica sobre por que o céu é azul. Com fine-tuning, essa resposta pode ser enriquecida com contexto científico detalhado, tornando-a mais adequada para aplicações como plataformas educacionais.
Métodos de fine-tuning variam desde o instruction fine-tuning, em que os modelos são treinados com exemplos que demonstram as respostas desejadas, até o parameter-efficient fine-tuning (PEFT), que atualiza apenas um subconjunto dos parâmetros do modelo para economizar recursos computacionais e evitar esquecimento catastrófico.
Em contraste, o Retrieval Augmented Generation (RAG) segue outra abordagem. O RAG combina elementos de modelos baseados em recuperação e modelos generativos para melhorar a qualidade do conteúdo gerado, incorporando informações obtidas de fontes externas durante o processo de geração.
Enquanto o fine-tuning foca em otimizar modelos existentes para tarefas específicas, o RAG integra conhecimento externo para enriquecer a geração de conteúdo.
A escolha entre fine-tuning e RAG depende dos requisitos da aplicação, como a necessidade de informações atualizadas, os recursos computacionais disponíveis e o nível de especialização desejado. O fine-tuning oferece um caminho direto para aproveitar a base de conhecimento dos modelos pré-treinados, enquanto o RAG garante dinamismo na relevância e precisão das informações usadas pelo modelo.
Fazer fine-tuning nos modelos de geração de texto da OpenAI é uma forma poderosa de adaptá-los a necessidades específicas, mas exige tempo e recursos significativos. Antes de partir para o fine-tuning, é recomendável extrair o máximo do modelo com prompt engineering, prompt chaining (dividir tarefas complexas em prompts sequenciais mais simples) e uso de functions. Essa abordagem é indicada por vários motivos:
O fine-tuning pode ser especialmente útil nos seguintes cenários:
Devido à natureza proprietária dos modelos da OpenAI, para ajustar qualquer um deles você precisa usar a API de fine-tuning da própria OpenAI. Esse processo envolve enviar seus dados para os servidores da OpenAI para treinar o modelo.
Atualmente, apenas os modelos abaixo têm suporte a fine-tuning via API.
O fine-tuning do GPT-4 está com acesso experimental, e desenvolvedores elegíveis podem solicitar acesso pela interface de fine-tuning. Independentemente do modelo usado, o processo e o código deste tutorial não mudam.
Este é o passo mais importante. A qualidade de um modelo ajustado depende diretamente dos dados que você cria para o fine-tuning. Na API da OpenAI, os dados devem estar no formato jsonl.
O formato JSONL é um arquivo de texto em que cada linha é um objeto JSON independente, ideal para processar grandes conjuntos de dados linha a linha. É especialmente útil quando os dados podem ser divididos em registros individuais sem perder a estrutura.
Exemplo:
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
Para este tutorial, criei um conjunto de exemplos com apenas cinco itens. Os dados trazem perguntas sobre temas de machine learning e respostas no estilo de Shakespeare.
Amostra criada para este tutorial:
{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "What is machine learning?"}, {"role": "assistant", "content": "'Tis but the art of teaching machines to think, to learn from data most fine, and decisions to link."}]}

{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "How doth neural networks work?"}, {"role": "assistant", "content": "They're like the brains of yon digital beast, with layers many, and nodes that cease."}]}O primeiro passo para criar um job de fine-tuning com a API da OpenAI é enviar o arquivo. Para usar essa API, você precisa ter a biblioteca openai instalada em Python.
!pip install openaiAgora acesse sua conta em platform.openai.com e gere um token de API:
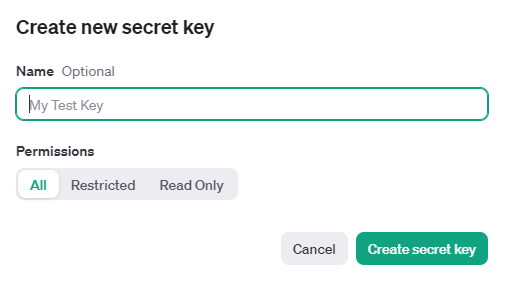
Em seguida, defina o token como variável de ambiente usando a biblioteca os.
import os


# Defina a variável de ambiente OPENAI_API_KEY
os.environ['OPENAI_API_KEY'] = '...'Seu arquivo de treino deve estar no formato jsonl. Após o upload, o processamento pode levar um tempo. O tamanho máximo para upload é de 1 GB. Para enviar um arquivo ao servidor da OpenAI:
from openai import OpenAI
client = OpenAI()


client.files.create(
  file=open("train.jsonl", "rb"),
  purpose="fine-tune"
)
Saída:
FileObject(id='file-rIua39sJX1O64gzxTYfpvJx7', bytes=11165, created_at=1709499930, filename='train.jsonl', object='file', purpose='fine-tune', status='processed', status_details=None)Depois de confirmar que o arquivo foi enviado com sucesso, o próximo passo é criar um job de fine-tuning. O training_file é o ID retornado quando o arquivo foi enviado para a API da OpenAI. Para iniciar um job de fine-tuning:
from openai import OpenAI
client = OpenAI()


client.fine_tuning.jobs.create(
  training_file="file-rIua39sJX1O64gzxTYfpvJx7",
  model="gpt-3.5-turbo" #mude para gpt-4-0613 se você tiver acesso
)
Para configurar ajustes extras, como validation_file ou hiperparâmetros, confira a documentação da API de fine-tuning.
O tempo para concluir um job de fine-tuning varia, indo de minutos a horas, dependendo do modelo e do tamanho do dataset. Por exemplo, com apenas 50 exemplos no nosso train.jsonl e usando o gpt-3.5-turbo, o job terminou em 7 minutos.
Quando o job terminar, você também receberá um e-mail de confirmação.
Além de criar um job, você pode listar os jobs atuais, verificar o status de um job específico ou cancelá-lo.
from openai import OpenAI
client = OpenAI()


# Listar 10 jobs de fine-tuning
client.fine_tuning.jobs.list(limit=10)


# Obter o estado de um job específico
client.fine_tuning.jobs.retrieve("...")


# Cancelar um job
client.fine_tuning.jobs.cancel("...")


# Listar até 10 eventos de um job de fine-tuning
client.fine_tuning.jobs.list_events(fine_tuning_job_id="...", limit=10)


# Excluir um modelo ajustado (é preciso ser owner da org onde o modelo foi criado)
client.models.delete("ft:gpt-3.5-turbo:xxx:xxx")\A OpenAI oferece métricas-chave de treinamento, como training loss, token accuracy no treino, test loss e token accuracy no teste. Essas métricas ajudam a garantir que o treinamento esteja avançando como esperado, com redução de loss e melhora na token accuracy. Você pode visualizar essas métricas em um objeto de evento durante um job ativo.
{
    "object": "fine_tuning.job.event",
    "id": "ftjob-Na7BnF5y91wwGJ4EgxtzVyDD",
    "created_at": 1693582679,
    "level": "info",
    "message": "Step 100/100: training loss=0.00",
    "data": {
        "step": 100,
        "train_loss": 1.805623287509661e-5,
        "train_mean_token_accuracy": 1.0
    },
    "type": "metrics"
}
Você também pode ver essas informações na interface.
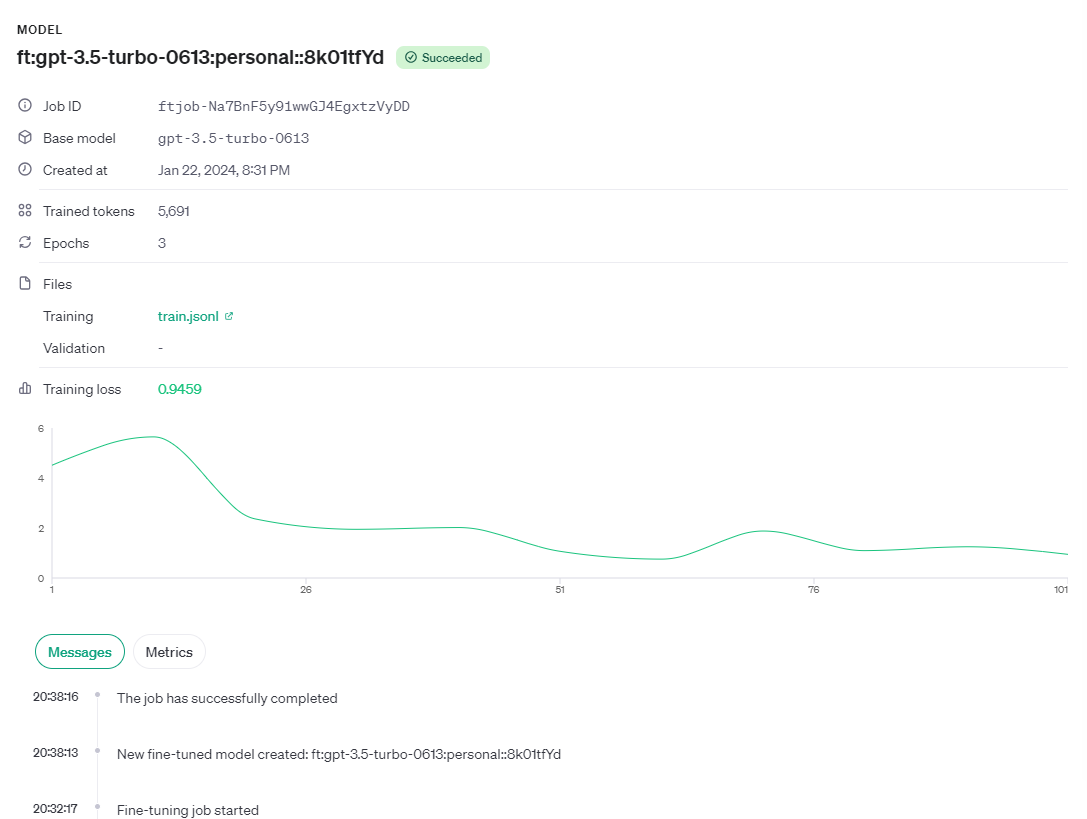
Quando o job termina com sucesso, os detalhes incluem o campo fine_tuned_model, com o nome do modelo. Você pode fazer uma chamada à API para esse modelo e obter a resposta do modelo que acabamos de ajustar.
from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="ft:gpt-3.5-turbo-0613:personal::8k01tfYd",
  messages=[
    {"role": "system", "content": "You are a teaching assistant for Machine Learning. You should help to user to answer on his question."},
    {"role": "user", "content": "What is a loss function?"}
  ]
)
print(completion.choices[0].message)
Saída:
ChatCompletionMessage(content="To measure how far we falter, it guides our way, our hope's defaulter.", role='assistant', function_call=None, tool_calls=None)Este tutorial guiou você pelo processo de fine-tuning do modelo GPT da OpenAI, um passo avançado para aproveitar as amplas capacidades dos LLMs em aplicações de domínio específico. O fine-tuning permite refinar as respostas do modelo de linguagem, tornando-o mais apto a lidar com tarefas, estilos ou domínios específicos com maior precisão e eficiência.
Este tutorial utiliza a OpenAI Python API para ajustar um modelo. Se você prefere aprender a fazer o mesmo pela interface, sem escrever uma linha de código, confira o tutorial How to Fine Tune GPT 3.5 no DataCamp.
Como o GPT não é open source, o processo de fine-tuning é simples e envolve basicamente uma chamada de API. Isso é bem diferente quando falamos de ajustar modelos abertos como Llama 2, Mistral, Stable Diffusion etc. Se você quer aprender a fazer fine-tuning em vários modelos open source, confira estes artigos no DataCamp:
Para recursos introdutórios sobre fine-tuning de LLMs, confira An Introductory Guide to Fine-Tuning LLMs no DataCamp.
Comece sua jornada em IA hoje!
Curso
Curso
Curso
blog
Richie Cotton
7 min
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Moez Ali
11 min
Tutorial
Josep Ferrer
11 min







