
Cours
Concepts de gestion des données
2 h
11.8K
Dans un monde où les décisions sont de plus en plus basées sur les données, les organisations peinent souvent à gérer des informations éparpillées entre équipes et systèmes. Ventes, finance, RH : chaque service dispose de ses propres outils et sources, créant des silos qui compliquent l’obtention d’une vue d’ensemble.
Pour contourner ces difficultés, les data engineers doivent souvent concevoir et maintenir un enchevêtrement complexe de pipelines qui dupliquent, combinent et transforment les données pour les mettre à disposition de chaque service. À mesure que le nombre d’équipes et de sources augmente, cette plomberie devient de plus en plus lourde à déployer et à entretenir, avec à la clé un risque accru de pannes.
Le concept de data fabric a été pensé comme une réponse globale à ces problèmes. Explorons cette approche architecturale pour une gestion intégrée des données.
Pour aller plus loin sur la gestion des données, consultez cet article sur la traçabilité des données.
Le data fabric est une architecture de données étendue qui permet l’intégration et la gestion fluides des données dans des environnements variés. Voyez-le comme un moyen de relier virtuellement des sources disparates, sans multiplier les copies redondantes.
En « tissant » ces sources hétérogènes, un data fabric crée un cadre unifié qui garantit une diffusion cohérente des données, ainsi qu’une gouvernance et une sécurité homogènes, où qu’elles résident.
Contrairement à un pipeline traditionnel, le data fabric ne recopie pas les données de chaque source vers un référentiel central. Il s’appuie plutôt sur des API et la virtualisation pour permettre aux analystes et data scientists d’accéder, depuis un catalogue central, à des données stockées en différents lieux. Résultat : moins d’espace de stockage, puisqu’il n’existe qu’une seule copie de référence.
En outre, en construisant une infrastructure cohérente, le data fabric assure une donnée facilement accessible, bien gouvernée et sécurisée tout au long de son cycle de vie.
La simplicité d’une architecture de type data fabric offre de nombreux avantages aux grandes organisations.
En fournissant une couche d’accès unifiée, le data fabric supprime les silos et facilite l’accès et l’exploitation des données à l’échelle de l’organisation pour les utilisateurs, qu’ils soient analystes ou comptables. En rassemblant tous les jeux de données de l’entreprise dans un même catalogue, vous gagnez en visibilité et en accès.
Bien sûr, cela ne signifie pas que vous devez tout partager avec tout le monde. Vous pouvez — et devez — mettre en place des mécanismes d’authentification et d’autorisations basés sur les rôles pour garantir la sécurité.
Le data fabric améliore souvent la qualité et la cohérence des données. En simplifiant l’arrière-plan des pipelines automatisés et en standardisant les cadres de gouvernance, vous veillez à ce que vos données restent propres, cohérentes et exactes : une condition essentielle pour des décisions fiables.
Découvrez-en plus sur la qualité des données avec ce cours Introduction to Data Quality.
Les principes du data fabric intègrent très tôt des mesures de sécurité robustes et des politiques de gouvernance dans le pipeline, assurant la conformité réglementaire et la protection des informations sensibles. Cette approche globale réduit les risques et renforce la confiance dans les données utilisées. Un système plus simple est aussi plus facile à sécuriser.
Pour en savoir plus, suivez le cours Data Governance Concepts.
Surtout, le data fabric accroît l’agilité décisionnelle. En simplifiant la gestion et en offrant un accès en temps réel à des données fiables, il permet de réagir plus vite aux évolutions et de décider en connaissance de cause.
L’architecture data fabric repose sur trois principes clés : accès unifié, gouvernance standardisée et automatisation.
Un data fabric doit intégrer une couche logique pour un accès unifié aux données. Cette couche abstrait l’infrastructure sous-jacente et fournit une interface homogène d’accès aux données, quelles que soient leurs sources. L’objectif : permettre à toutes les parties prenantes (analystes, data scientists, MLOps, etc.) d’accéder de manière unifiée aux données dont elles ont besoin.
Autre principe : une gouvernance et une sécurité standardisées. Elles garantissent que l’ensemble des actifs de données respecte des protocoles de gouvernance et de sécurité uniformes, renforçant fiabilité et conformité réglementaire dans toute l’organisation.
Enfin, le data fabric s’appuie sur des pipelines de données automatisés en backend pour des mouvements et transformations efficaces. Cette automatisation fluidifie le nettoyage, la préparation et la transformation en temps réel, augmente l’efficacité et réduit les tâches manuelles.
Plusieurs composants essentiels constituent une architecture de data fabric. Passons-en quelques-uns en revue.
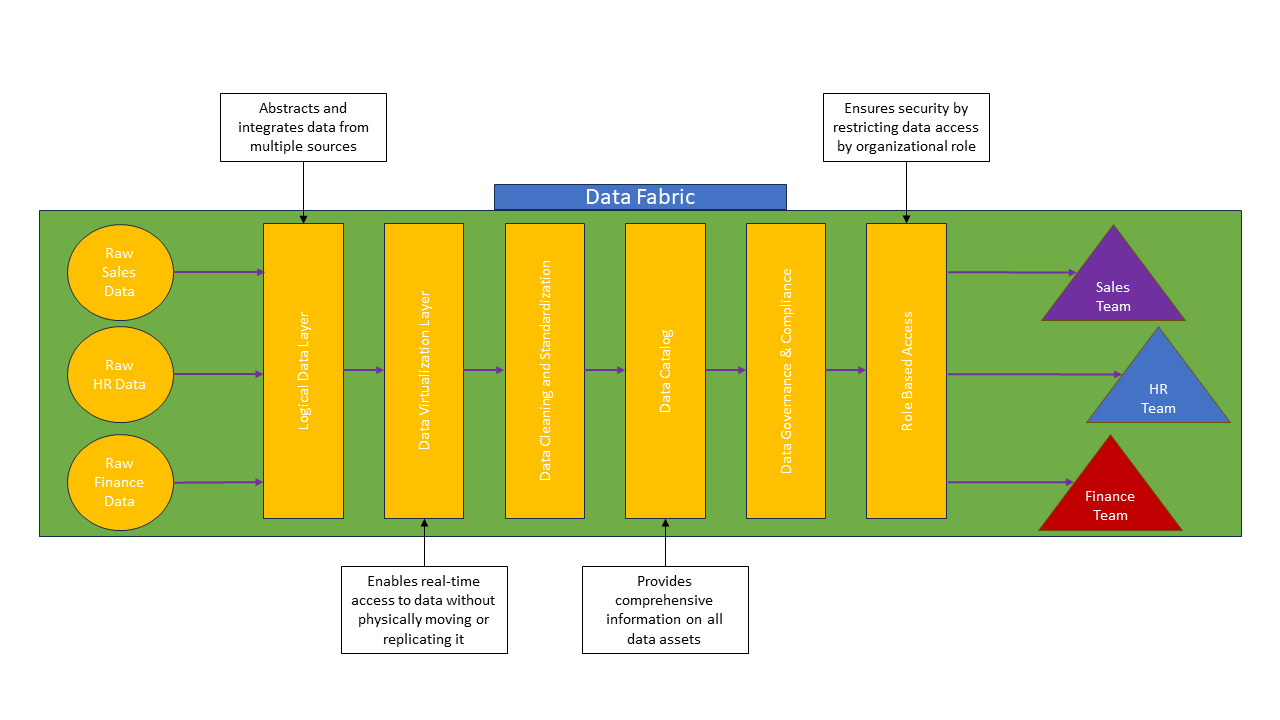
Le catalogue de données est l’un des éléments les plus critiques. C’est le registre central de tous les actifs de données de votre organisation. Il fournit des métadonnées et des informations de traçabilité pour faciliter la découverte et la gestion des données, afin que les utilisateurs trouvent et comprennent facilement les jeux de données dont ils ont besoin.
Autre brique essentielle : les outils d’intégration. Ils permettent la circulation fluide des données entre systèmes et plateformes. Il peut s’agir de plateformes ETL (Extract, Transform, Load), de frameworks d’intégration, de services d’intégration cloud ou de solutions de streaming temps réel. Ces outils rendent les données disponibles où elles sont nécessaires, améliorant l’accessibilité globale.
Les services de transformation jouent un rôle central, comme dans toute solution de pipeline. Ils nettoient, transforment et préparent les données pour l’analyse : nettoyage, normalisation, agrégation, enrichissement, etc.
Le cadre de gouvernance est tout aussi crucial : il garantit qualité, sécurité et conformité via des politiques et procédures couvrant tout le cycle de vie. Il peut inclure la désignation de rôles de data stewardship, la mise en place de contrôles de qualité, l’occultation des informations sensibles, l’application d’autorisations basées sur les rôles et des audits réguliers pour la conformité réglementaire.
L’un des atouts du data fabric est la capacité à standardiser facilement ces protocoles sur l’ensemble de votre paysage de données. Cela préserve l’intégrité et la fiabilité de vos informations.
Dans une architecture de data fabric, ces composants sont étroitement imbriqués pour créer une expérience unifiée. Les données issues de sources disparates sont intégrées, transformées et cataloguées, tandis que les règles de gouvernance sont appliquées de bout en bout pour garantir un environnement sûr et sécurisé.
La gestion des données se construit souvent au fil de la croissance d’une organisation, au gré de nouvelles sources et de nouvelles équipes. Chaque nouvelle source exige un pipeline dédié, et chaque équipe adopte ses outils, ses conventions de nommage et ses propres règles de gouvernance.
Cette approche traditionnelle comporte de nombreuses limites. Passer à un cadre de type data fabric implique de repenser la circulation des données, depuis leurs sources jusqu’aux utilisateurs qui en ont besoin dans toute l’entreprise.
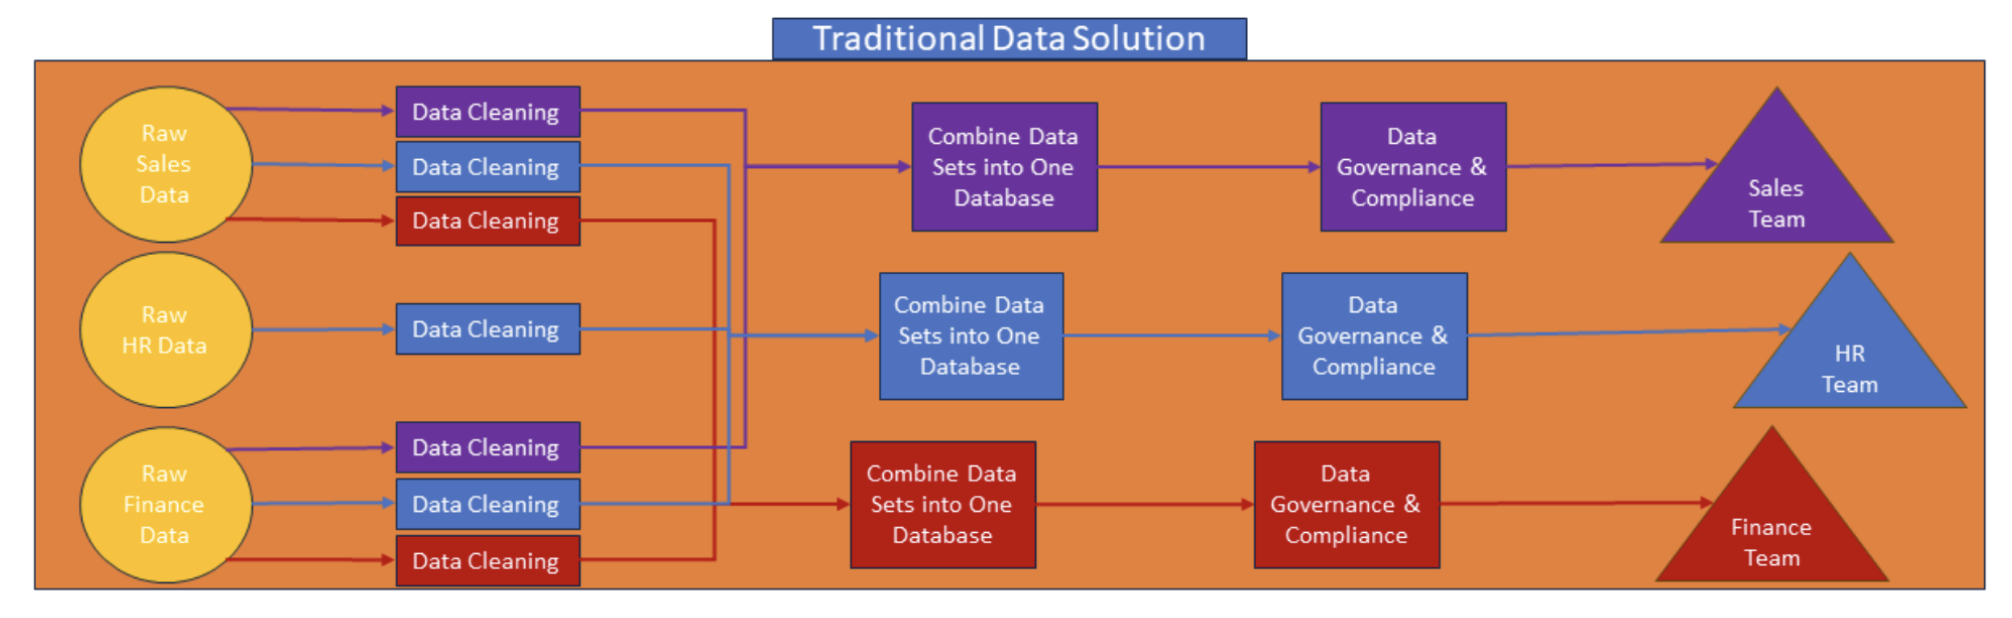
Les approches historiques mènent à une mosaïque de systèmes en silo, avec des dépôts isolés et des intégrations point à point. On obtient une toile complexe de connexions et de pipelines lourds à maintenir.
Dans ce schéma, chaque système peut avoir sa propre base de données, ses transformations et ses contrôles d’accès. Accéder d’un coup à l’ensemble des données pour disposer d’une vue unifiée devient alors ardu.
Cette complexité est inefficace et source d’erreurs. Elle complique aussi le maintien de la qualité et de la cohérence, ce qui dégrade la fiabilité et la confiance dans les données de l’organisation.
Ces systèmes traditionnels se heurtent également à des limites de passage à l’échelle, notamment parce que les multiples copies d’une même donnée saturent le stockage. Ils peinent à s’adapter à l’évolution des besoins. En somme, ces héritages deviennent trop volumineux, épars et redondants pour suivre le rythme de l’innovation.
Le data fabric apporte des avantages majeurs. Il propose une plateforme unifiée qui fédère des sources variées au sein d’un ensemble cohérent. Cette unification simplifie la gestion et améliore l’organisation des données.
Il facilite aussi la gouvernance et la conformité. Parce qu’il consolide l’accès via un catalogue unique, des standards communs peuvent être appliqués à tout votre paysage de données. Des mesures de gouvernance et de sécurité homogènes assurent la conformité avec les réglementations telles que HIPAA et FCRA, réduisant les risques et renforçant la confiance dans vos données.
|
Data fabric |
Gestion traditionnelle des données |
|
|
Scalabilité |
Passe à l’échelle efficacement avec la croissance des données |
Scalabilité limitée à cause des silos |
|
Gouvernance |
Gouvernance et sécurité standardisées |
Gouvernance souvent non uniforme |
|
Sécurité |
Mesures de sécurité centralisées |
Sécurité fragmentée selon les systèmes |
|
Agilité |
Permet des décisions rapides basées sur les données |
Processus décisionnels plus lents |
Le data fabric renforce les capacités data dans de nombreux contextes. Il peut remplacer des systèmes hérités devenus lourds à gérer dans les grandes organisations.
Il peut aussi être déployé dès les débuts d’une entreprise pour mettre en place un programme de données unifié et prévenir les futurs écueils de gestion.
Un cas d’usage important concerne le Master Data Management (MDM). En créant une source de vérité unique pour les données critiques, le data fabric assure une gestion centralisée des données de référence. Cette centralisation est essentielle pour des opérations fiables et efficaces, en garantissant cohérence et exactitude des jeux de données clés. Vous pouvez en lire davantage sur ce modèle ICI.
Pour l’analytics et la business intelligence, le data fabric offre un accès rapide à des données fiables, permettant de décider vite et bien. Il améliore la qualité et la vitesse des analyses en assurant la disponibilité et la fiabilité des données.
Le data fabric facilite aussi la conformité réglementaire. Il permet de standardiser la gouvernance et les protocoles à l’échelle de l’organisation, simplifiant le respect des exigences de confidentialité. Cette cohérence réduit la complexité de la conformité et aide à protéger la réputation de l’entreprise tout en évitant des sanctions coûteuses.
Dans l’univers des données, de nombreux termes se ressemblent. Intéressons-nous à un concept proche du data fabric : le data mesh.
Le data mesh est une autre approche de gestion des données, avec des spécificités propres. Il privilégie l’intégration temporaire de données issues de différentes sources pour des analyses immédiates. Idéal pour des explorations rapides ou des rapports ponctuels, il offre une grande souplesse pour des besoins simples et immédiats.
Contrairement au data fabric, le data mesh encourage la décentralisation et l’autonomie des domaines en matière de gouvernance. Il présente toutefois des limites en termes de qualité et de sécurité. Il n’est pas pensé pour le stockage de long terme ni pour une gestion exhaustive.
Le data fabric propose une approche holistique de la gestion de l’ensemble des données de l’organisation. Il offre une plateforme intégrée couvrant accès, gouvernance, sécurité et intégration. Il convient à une gestion pérenne des données et à une prise de décision continue basée sur les données.
Bien que sa mise en œuvre puisse être complexe et nécessite un choix attentif d’outils compatibles, ses bénéfices en matière d’unification, de gouvernance et d’agilité en font une solution puissante pour de nombreux besoins de gestion des données.
Si vous avez décidé qu’une architecture de type data fabric est pertinente pour votre organisation, vous vous demandez peut-être par où commencer. Voici quelques premières étapes.
La mise en place commence par une évaluation des besoins. Le data fabric n’est pas une solution uniforme : c’est un dispositif sur mesure, adapté aux enjeux spécifiques de votre organisation. D’où l’importance d’analyser votre paysage de données et d’identifier les défis avant la conception.
Les premières étapes consistent à échanger avec les parties prenantes pour comprendre l’infrastructure existante, repérer les irritants et définir les problèmes que vous souhaitez adresser grâce au data fabric.
Ensuite, définissez vos objectifs métiers et les résultats attendus. Cherchez-vous à créer une source de vérité unique ? À réduire les coûts indirects ? À remplacer une infrastructure obsolète ? Des objectifs clairs, alignés sur la stratégie de l’organisation, guideront la conception pour répondre à vos besoins.
Une fois la direction fixée, il faut sélectionner les outils. Le choix peut sembler intimidant, mais il est déterminant.
Vous pouvez opter pour une solution tout-en-un, comme Microsoft Azure Service Fabric ou IBM Cloud Pak. Elles rassemblent les briques nécessaires pour déployer un data fabric, prennent en charge une grande partie du travail et simplifient la facturation avec un seul fournisseur. Consultez cet article sur what Microsoft Fabric is pour une analyse détaillée.
D’autres organisations préféreront une configuration plus personnalisée. Vous pouvez bâtir votre propre data fabric en combinant des outils prêts à l’emploi tels que :
Lors du choix, évaluez la scalabilité, la sécurité et la compatibilité avec votre existant. Assurez-vous que les solutions retenues puissent monter en charge, offrir une sécurité robuste et s’intégrer à vos systèmes actuels.
Pensez aussi à leur pérennité. Certaines technologies récentes peuvent être éphémères ; si l’outil choisi n’est plus supporté, vous devrez opérer des changements majeurs. De même, des solutions trop spécifiques peuvent devenir difficiles à maintenir en cas d’évolution des équipes qui les ont conçues.
Déployer un data fabric exige une gouvernance solide et une stratégie de conduite du changement, surtout si vous migrez depuis une architecture en place depuis longtemps. Une planification minutieuse favorisera une transition réussie à l’échelle de l’organisation.
Il est essentiel d’établir des politiques claires de propriété des données, de contrôle d’accès et de sécurité. Définissez qui est responsable des données à chaque étape de leur cycle de vie, qui peut y accéder et les modifier, et quelles mesures protègent les informations sensibles. Ces règles préservent l’intégrité des données, assurent la conformité et réduisent les risques de brèches.
Précisez aussi les rôles et responsabilités de la gestion des données. Selon votre contexte, il peut s’agir de nommer des data stewards responsables de la qualité, des data custodians en charge du stockage et des accès, ou des comités pour faire respecter la gouvernance. Des rôles nets renforcent la redevabilité.
Enfin, élaborez un plan d’adoption et de formation à l’échelle de l’entreprise. Proposez des sessions ou ateliers de prise en main et mettez à disposition une documentation accessible.
L’adaptation aux nouveaux systèmes prend du temps. Faire preuve de compréhension pendant la transition facilite l’adhésion. Prévoyez un accompagnement continu pour résoudre les problèmes et répondre aux questions pendant et après le basculement.
Comme beaucoup de technologies actuelles, l’avenir du data fabric sera façonné par les avancées en automatisation et en apprentissage automatique. L’intelligence automatisée devrait améliorer l’intégration via des workflows contextuels et des pipelines auto-réparateurs, capables de détecter et d’optimiser les performances en temps réel. Des insights pilotés par l’IA pourraient offrir de l’analytique prédictive et des catalogues intelligents, rendant la gestion plus proactive et efficace.
La blockchain pourrait être intégrée pour fournir une provenance immuable et automatiser certaines tâches de gouvernance via des smart contracts.
Avec la montée de l’edge computing, les data fabrics pourraient orchestrer des traitements décentralisés, entre périphérie et cloud.
Les progrès de l’informatique quantique pourraient introduire un chiffrement résistant au quantique et accélérer des transformations complexes.
Au fil de ces évolutions, le data fabric pourrait devenir un atout stratégique, fondant des opérations intelligentes et data-driven dans tous les secteurs.
Le data fabric incarne une approche transformatrice de la gestion des données. Cette architecture s’attaque aux défis des silos, de la qualité et de la gouvernance. En abaissant les barrières d’accès et en favorisant un environnement unifié, elle soutient la prise de décision basée sur les données à l’échelle des grandes organisations.
Découvrez Responsible AI Data Management et Making Data Governance Fun avec DataCamp. Ou approfondissez le stockage et la gestion des données avec le cours Introduction to Data Warehousing de DataCamp.
Formez-vous à la gestion des données avec ces cours !
Cours
Cours
Cours