
Kurs
Konzepte des Datenmanagements
2 Std.
11.8K
In einer Welt, in der alles datenbasiert ist, kämpfen Unternehmen oft damit, Daten zu verwalten, die über verschiedene Teams und Systeme verteilt sind. Vertrieb, Finanzen, HR — jede Abteilung nutzt womöglich eigene Tools und Datenquellen. Das führt zu Silos, die einen ganzheitlichen Blick erschweren.
Um diese Probleme zu lösen, müssen Data Engineers häufig ein komplexes Geflecht aus Datenpipelines aufbauen und warten, das Daten kopiert, zusammenführt und transformiert, um sie den einzelnen Abteilungen bereitzustellen. Mit wachsender Zahl an Teams und Datenquellen wird diese aufwendige „Verkabelung“ immer schwieriger aufzusetzen und zu betreiben — Ausfälle inklusive.
Das Konzept Data Fabric wurde als ganzheitliche Lösung für genau diese Herausforderungen entwickelt. Schauen wir uns diese Architektur für integriertes Datenmanagement genauer an.
Wenn du mehr über Datenmanagement lernen möchtest, lies diesen Artikel über Data Lineage.
Data Fabric ist eine umfassende Datenarchitektur, die eine nahtlose Integration und Verwaltung von Daten über unterschiedlichste Umgebungen hinweg ermöglicht. Stell es dir als eine virtuelle Verbindung verteilter Datenquellen vor — ohne redundante Kopien.
Indem diese heterogenen Datenquellen „zusammengenäht“ werden, entsteht ein einheitlicher Rahmen, der eine konsistente Bereitstellung, Governance und Sicherheit von Daten gewährleistet — unabhängig davon, wo sie liegen.
Im Gegensatz zu klassischen Datenpipelines kopiert Data Fabric Daten nicht aus verschiedenen Quellen in ein zentrales Repository. Stattdessen nutzt es APIs und Virtualisierung, sodass Data Analysts und Data Scientists über einen zentralen Katalog auf Daten an unterschiedlichen Speicherorten zugreifen können. Das spart Speicherplatz, weil es nur eine Datenkopie gibt.
Gleichzeitig sorgt eine zusammenhängende Dateninfrastruktur dafür, dass Daten über ihren gesamten Lebenszyklus hinweg leicht zugänglich, gut gesteuert und sicher sind.
Die Einfachheit einer Data-Fabric-Architektur bringt großen Unternehmen zahlreiche Vorteile.
Eine einheitliche Zugriffsschicht hebt Datensilos auf und macht es Anwendern wie Analystinnen und Buchhaltern leichter, Daten aus dem gesamten Unternehmen zu finden und zu nutzen. Packst du alle Datensätze deines Unternehmens in einen zentralen Katalog, siehst und erreichst du alles auf einen Blick.
Das heißt natürlich nicht, dass jede Person alle Daten sehen darf. Du kannst — und solltest — weiterhin rollenbasierte Authentifizierung nutzen, um die Sicherheit deines Systems zu gewährleisten.
Data Fabric verbessert häufig die Datenqualität und -konsistenz im gesamten Unternehmen. Durch die Vereinfachung des Backends automatisierter Datenpipelines und die Standardisierung von Governance-Rahmenwerken bleiben deine Daten sauber, konsistent und korrekt — die Grundlage für verlässliche Entscheidungen.
Erfahre mehr über Datenqualität im Kurs Introduction to Data Quality.
Data-Fabric-Prinzipien verankern robuste Sicherheitsmaßnahmen und Governance-Richtlinien früh in der Pipeline. So erfüllst du regulatorische Vorgaben und schützt sensible Informationen. Dieser ganzheitliche Sicherheitsansatz senkt Risiken und stärkt das Vertrauen in die genutzten Daten. Ein einfacheres System lässt sich leichter absichern.
Mehr zum Thema im Kurs Data Governance Concepts.
Am wichtigsten: Data Fabric macht dein Unternehmen agiler bei datenbasierten Entscheidungen. Durch vereinfachtes Datenmanagement und Echtzeitzugriff auf verlässliche Daten könnt ihr schneller auf Veränderungen reagieren und fundierte Entscheidungen treffen.
Der Architekturansatz Data Fabric beruht auf drei Prinzipien: einheitlicher Zugriff, standardisierte Governance und Automatisierung.
Eine Data Fabric sollte eine logische Datenschicht für einheitlichen Datenzugriff enthalten. Diese Schicht abstrahiert die zugrunde liegende Infrastruktur und stellt eine nahtlose, einheitliche Schnittstelle über diverse Quellen bereit. Ziel ist, dass alle, die Daten brauchen (Analysten, Scientists, ML Ops usw.), einheitlich auf alle relevanten Daten zugreifen können.
Ein weiteres Prinzip ist standardisierte Data Governance und Sicherheit. So halten alle Datenbestände deines Unternehmens einheitliche Governance- und Sicherheitsprotokolle ein. Das erhöht Zuverlässigkeit und Compliance.
Zudem setzt Data Fabric im Backend auf automatisierte Datenpipelines für effiziente Übertragung und Transformation. Die Automatisierung beschleunigt das Bewegen, Bereinigen und Transformieren von Daten — bis hin zu Echtzeitverarbeitung — und reduziert manuellen Aufwand.
Eine Data-Fabric-Architektur besteht aus mehreren Schlüsselelementen. Hier sind einige davon.
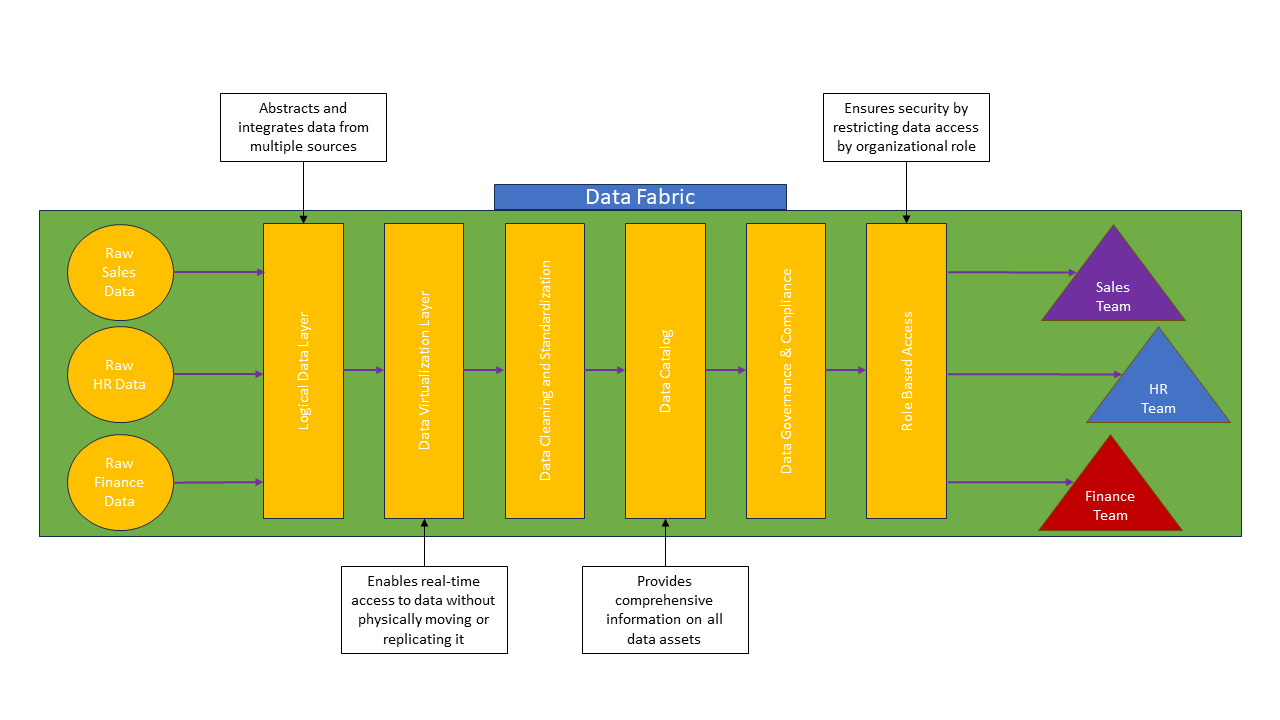
Eines der wichtigsten Elemente ist der Datenkatalog — ein zentrales Verzeichnis aller Datenassets deines Unternehmens. Er liefert Metadaten und Lineage-Informationen für die Datensuche und -verwaltung, sodass Nutzer die benötigten Daten leicht finden und verstehen.
Ebenfalls essenziell sind Datenintegrationstools. Sie ermöglichen den nahtlosen Datentransfer zwischen Systemen und Plattformen. Dazu zählen ETL-Plattformen (Extract, Transform, Load), Integrationsframeworks, cloudbasierte Integrationsdienste und Lösungen für Echtzeit-Streaming. So stehen Daten dort bereit, wo sie gebraucht werden, und die Zugänglichkeit steigt.
Transformationsdienste spielen wie in jeder Pipeline eine zentrale Rolle. Sie bereinigen, transformieren und bereiten Daten für Analysen auf — etwa durch Bereinigung, Normalisierung, Aggregation und Anreicherung.
Das Data-Governance-Rahmenwerk ist ebenso entscheidend. Es stellt Qualität, Sicherheit und Compliance über Richtlinien und Prozesse sicher, die den gesamten Datenlebenszyklus abdecken. Dazu gehören u. a. die Festlegung von Data-Steward-Rollen, Qualitätsprüfungen, das Schwärzen sensibler Informationen, rollenbasierte Zugriffskontrollen und regulatorische Prüfungen.
Ein Vorteil einer Data-Fabric-Architektur ist, dass sich diese Governance-Protokolle leicht über die gesamte Datenlandschaft standardisieren lassen. Das erhöht Integrität und Zuverlässigkeit deiner Daten.
In einer Data-Fabric-Architektur sind all diese Komponenten miteinander verwoben und schaffen ein einheitliches Erlebnis. Daten aus unterschiedlichen Quellen werden integriert, transformiert und katalogisiert. Governance-Protokolle sorgen dabei durchgängig für eine sichere Umgebung.
Datenmanagement entsteht in vielen Organisationen organisch: Das Unternehmen wächst, neue Datenquellen und Teams kommen hinzu. Jede neue Quelle erfordert eine neue Pipeline, und jedes Team bringt eigene Tools, Namenskonventionen und Governance-Protokolle mit.
Dieser traditionelle Ansatz hat viele Grenzen. Der Umstieg auf eine Data-Fabric-Architektur bedeutet, grundlegend neu zu denken, wie Daten von der Quelle zu den Nutzenden gelangen.
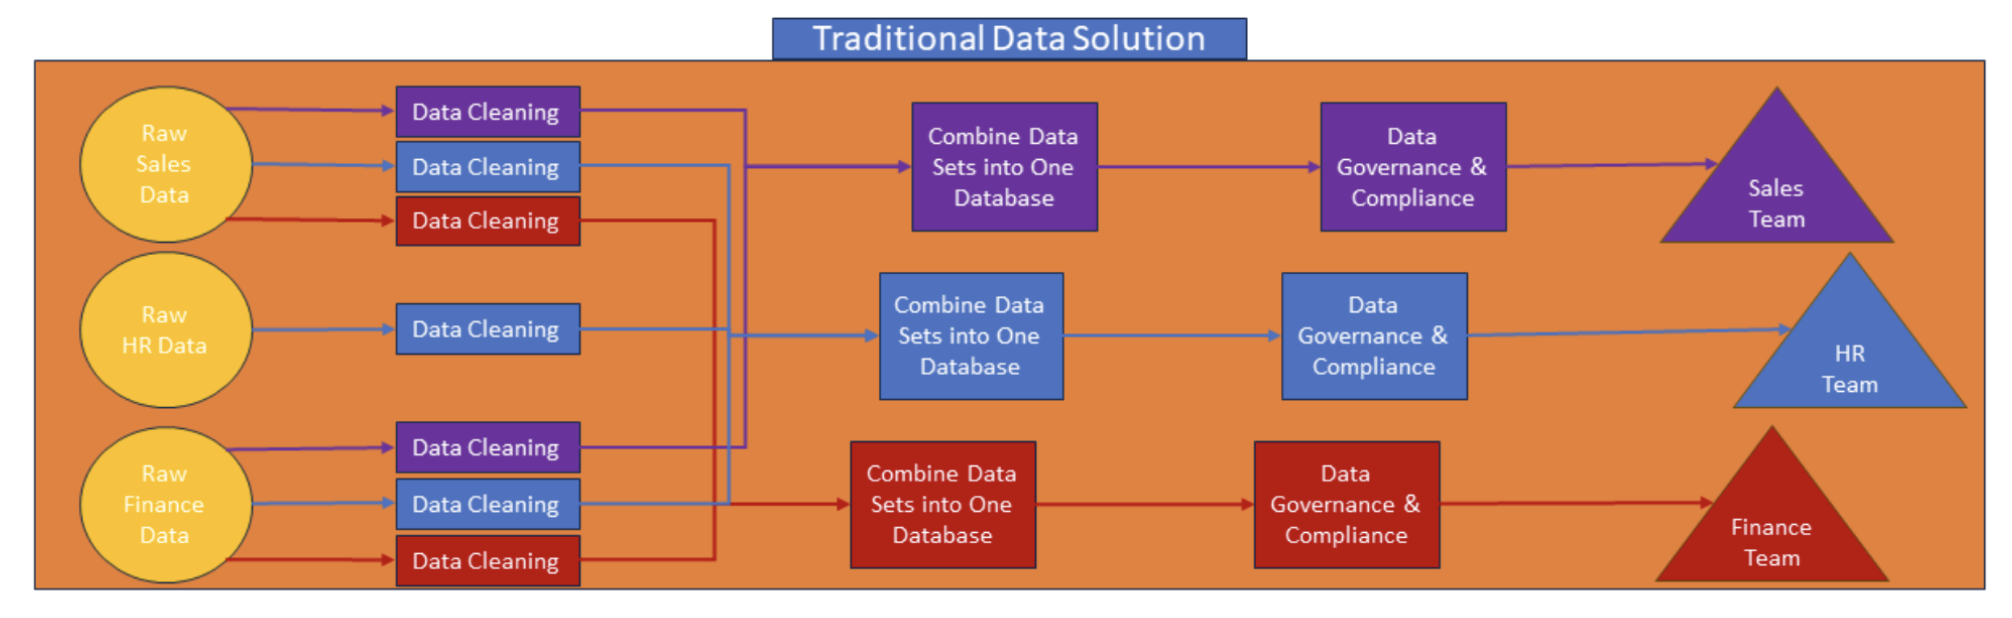
Das hergebrachte Datenmanagement führt zu vielen isolierten Systemen, in denen Daten getrennt verwaltet werden. Oft entstehen Punkt-zu-Punkt-Integrationen, die ein schwer wartbares Netz aus Verbindungen und Pipelines bilden.
Jedes System hat womöglich eigene Datenbanken, Transformationen und Zugriffskontrollen. Das erschwert es, alle Daten auf einmal zu betrachten und einen Gesamtüberblick zu gewinnen.
Diese Komplexität ist ineffizient und fehleranfällig. Zudem wird es schwer, Datenqualität und -konsistenz zu sichern — mit der Folge, dass das Vertrauen in die Unternehmensdaten sinkt.
Traditionelle Systeme skalieren nur begrenzt, auch weil viele Kopien derselben Daten wertvollen Speicher verbrauchen. Sie tun sich schwer, sich an neue Bedarfe anzupassen. Kurz: Legacy-Umgebungen werden mit der Zeit zu groß, zu verstreut und zu redundant, um mit dem Innovationstempo Schritt zu halten.
Data Fabric bietet hier wesentliche Vorteile. Es stellt eine einheitliche Datenplattform für alle Bedarfe bereit, die Daten aus zahlreichen Quellen zu einer konsistenten Plattform zusammenführt. Das vereinfacht das Management und erhöht die Ordnung.
Zudem verbessert Data Fabric Governance und Compliance. Weil das Framework alle Daten in einem Katalog bündelt, lassen sich Standards über die gesamte Landschaft hinweg durchsetzen. Einheitliche Governance- und Sicherheitsmaßnahmen stellen sicher, dass deine Daten regulatorischen Vorgaben wie HIPAA und FCRA entsprechen, Risiken sinken und das Vertrauen steigt.
|
Data Fabric |
Traditionelles Datenmanagement |
|
|
Skalierbarkeit |
Skaliert effizient mit wachsenden Datenmengen |
Begrenzte Skalierung durch Silos |
|
Governance |
Standardisierte Governance und Sicherheit |
Oft fehlende einheitliche Governance |
|
Sicherheit |
Zentralisierte Sicherheitsmaßnahmen |
Zersplitterte Sicherheitsmechanismen |
|
Agilität |
Ermöglicht schnelle, datenbasierte Entscheidungen |
Langsamere Entscheidungsfindung |
Data Fabric stärkt Datenfähigkeiten in vielen Unternehmenskontexten. Es kann Altsysteme ablösen, wenn Datenmanagement in großen Organisationen zu schwerfällig geworden ist.
Ebenso lässt es sich früh im Lebenszyklus eines Unternehmens einsetzen, um ein einheitliches Datenprogramm aufzubauen und spätere Probleme zu vermeiden.
Ein wichtiger Anwendungsfall ist Master Data Management (MDM). Mit einer einzigen „Source of Truth“ für kritische Daten sorgt Data Fabric für zentrale Verwaltung der Stammdaten. Diese Zentralisierung ist entscheidend für verlässliche, effiziente Abläufe und konsistente Schlüsseldaten. Mehr zu diesem Modell liest du HIER.
Für Data Analytics und Business Intelligence bietet Data Fabric schnellen Zugriff auf vertrauenswürdige Daten und befähigt Organisationen, zügig und punktgenau zu entscheiden. Weil Daten verfügbar und zuverlässig sind, steigen Qualität und Tempo der Analysen.
Zudem unterstützt Data Fabric die Einhaltung von Vorschriften. Einheitliche Governance und Protokolle im gesamten Unternehmen erleichtern die Einhaltung von Datenschutzregeln. Diese Konsistenz reduziert die Komplexität der Compliance, schützt den Ruf und vermeidet teure Strafen.
In der Datenwelt gibt es viele ähnlich klingende Begriffe. Betrachten wir einen davon genauer: Data Mesh.
Data Mesh ist ein anderer Ansatz mit eigenen Merkmalen. Im Fokus steht die temporäre Integration von Daten aus verschiedenen Quellen für unmittelbare Analysen. Das macht Data Mesh ideal für schnelle Explorationen und Ad-hoc-Reports — flexibel für einfache, sofortige Bedarfe.
Im Gegensatz zu Data Fabric fördert Data Mesh Dezentralisierung und domänspezifische Autonomie in der Governance. Das bringt jedoch Grenzen mit sich, etwa bei Datenqualität und Sicherheit. Für langfristige Speicherung und ganzheitliches Datenmanagement ist es nicht ausgelegt.
Data Fabric bietet einen ganzheitlichen Ansatz, um alle Unternehmensdaten zu managen. Es stellt eine umfassende, integrierte Plattform für Zugriff, Governance, Sicherheit und Integration bereit. Damit eignet es sich für langfristiges Datenmanagement und kontinuierliche, datenbasierte Entscheidungen.
Die Einführung kann komplex sein und erfordert die sorgfältige Auswahl kompatibler Tools und Technologien. Doch die Vorteile in Bezug auf Vereinheitlichung, Governance und Agilität machen Data Fabric für viele Organisationen zu einer starken Lösung.
Wenn du dich für eine Data-Fabric-Architektur entschieden hast, stellt sich die Frage nach dem Einstieg. Hier sind die ersten Schritte.
Der Startpunkt ist eine Bedarfsanalyse. Data Fabric ist kein One-Size-Fits-All, sondern eine Lösung, die auf die Datenanforderungen deines Unternehmens zugeschnitten wird. Prüfe daher zunächst deine Datenlandschaft und identifiziere Herausforderungen, bevor du die Architektur entwirfst.
Sprich mit Stakeholdern, um die bestehende Infrastruktur zu verstehen, Schmerzpunkte zu erfassen und die Probleme zu bestimmen, die du mit Data Fabric lösen willst.
Definiere anschließend Geschäftsziele und gewünschte Ergebnisse: Willst du eine Single Source of Truth aufbauen? Kosten senken? Veraltete, instabile Infrastruktur ablösen? Klare, auf die Unternehmensziele abgestimmte Zielbilder leiten dich und stellen sicher, dass die Data Fabric deinen Bedarf trifft.
Steht die Richtung fest, wählst du die passenden Werkzeuge. Das kann erst einmal überwältigen, ist aber ein entscheidender Schritt.
Eine Möglichkeit sind All-in-One-Lösungen wie Microsoft’s Azure Service Fabric oder IBM Cloud Pak. Sie liefern alles, was du für eine Data-Fabric-Architektur brauchst, nehmen dir viel Arbeit ab und vereinfachen die Abrechnung — nur ein Produkt statt vieler. Lies auch diesen Artikel zu What Microsoft Fabric is für einen Deep Dive.
Manche Organisationen brauchen oder bevorzugen jedoch ein individuelleres Setup. Du kannst eine eigene Data Fabric mit einer Kombination bewährter Tools aufbauen, etwa:
Achte bei der Auswahl auf Skalierbarkeit, Sicherheit und Kompatibilität mit deiner bestehenden Infrastruktur. Die Lösungen sollten mitwachsen, starke Sicherheit bieten und sich gut integrieren.
Denk auch an die Langlebigkeit. Neue Technologien können kurzlebig sein — wird ein Tool nicht mehr unterstützt, drohen große Umbauten. Ähnlich können maßgeschneiderte Lösungen leiden, wenn sich das Team ändert, das sie entwickelt hat.
Die Einführung einer Data Fabric erfordert robuste Governance- und Change-Management-Strategien — besonders, wenn du lange mit einer anderen Architektur gearbeitet hast. Mit guter Planung gelingt der Umstieg unternehmensweit.
Lege klare Regeln für Datenverantwortung, Zugriffe und Sicherheit fest. Definiere, wer in welcher Phase des Datenlebenszyklus verantwortlich ist, wer welche Rechte hat und welche Schutzmaßnahmen sensible Informationen sichern. So sicherst du Integrität, erfüllst Vorgaben und beugst Datenpannen vor.
Definiere zudem Rollen und Verantwortlichkeiten im Datenmanagement. Je nach Situation können das Data Stewards für Qualität, Data Custodians für Speicherung und Zugriff oder Gremien für die Durchsetzung der Governance sein. Klare Zuständigkeiten schaffen Verbindlichkeit.
Erarbeite außerdem einen Einführungs- und Schulungsplan. Stelle Trainings oder Workshops bereit und sorge für gute Dokumentation, auf die alle zugreifen können.
Menschen brauchen Zeit für neue Systeme. Mit Verständnis für deine Kolleginnen und Kollegen läuft der Wechsel reibungsloser. Rechne mit fortlaufender Unterstützung, um Fragen und Probleme während und kurz nach der Umstellung zu klären.
Wie bei vielen Technologien wird die Zukunft von Data Fabric durch Fortschritte in Automatisierung und Machine Learning geprägt. Automatisierte Intelligenz könnte Integrationen mit kontextsensitiven Workflows und selbstheilenden Pipelines verbessern, die Performance in Echtzeit erkennen und optimieren. KI-gestützte Insights könnten prädiktive Analytik und intelligente Datenkataloge liefern — für proaktiveres, effizienteres Datenmanagement.
Blockchain-Technologie könnte für unveränderliche Herkunftsnachweise (Provenance) sorgen und Governance-Aufgaben per Smart Contracts automatisieren.
Mit dem Wachstum von Edge Computing könnte Data Fabric dezentrale Verarbeitung über Edge-Geräte und Cloud-Dienste hinweg steuern.
Fortschritte im Quantencomputing könnten quantensichere Verschlüsselung bringen und komplexe Transformationen beschleunigen.
Mit dieser Entwicklung wird Data Fabric voraussichtlich zur zentralen Basis für intelligente, datengetriebene Prozesse in vielen Branchen.
Data Fabric steht für einen grundlegenden Wandel im Datenmanagement. Die Architektur adressiert Silos, Qualität und Governance. Indem sie Barrieren abbaut und eine einheitliche Datenumgebung schafft, unterstützt sie datenbasierte Entscheidungen in großen Organisationen.
Lerne mehr über Responsible AI Data Management und Making Data Governance Fun mit DataCamp. Oder tauche tiefer in Speicherung und Management ein mit DataCamps Kurs Introduction to Data Warehousing.
Lerne Datenmanagement mit diesen Kursen!
Kurs
Kurs
Kurs