

Qu’est-ce qu’un transformer ?
Les transformers ont d’abord été développés pour la transduction de séquence, c’est-à-dire la traduction automatique neuronale : ils visent donc tout problème qui transforme une séquence d’entrée en séquence de sortie. D’où leur nom : « Transformers ».
Mais repartons du début.
Une définition simple
Un modèle transformer est un réseau de neurones qui apprend le contexte de données séquentielles et génère de nouvelles données à partir de celles-ci.
Pour le dire simplement :
Un transformer est un type de modèle d’intelligence artificielle qui apprend à comprendre et à générer du texte proche du langage humain en analysant des motifs dans de grandes quantités de textes.
Les transformers représentent l’état de l’art en TAL et constituent l’évolution de l’architecture encodeur-décodeur. Toutefois, là où l’encodeur-décodeur s’appuyait surtout sur des réseaux de neurones récurrents (RNN) pour extraire l’information séquentielle, les transformers n’ont aucune récurrence.
Alors, comment s’y prennent-ils ?
Ils sont conçus pour saisir le contexte et le sens en analysant les relations entre éléments, et s’appuient presque entièrement sur une technique mathématique appelée attention.
Image de l’auteur.
Contexte historique
Les transformers ont été introduits par des chercheurs de Google dans l’article de 2017 "Attention is All You Need". Le code a été publié dans le package Tensor2Tensor de TensorFlow, et le groupe Harvard NLP a proposé un guide annoté en PyTorch. Vous pouvez aussi apprendre à implémenter un Transformer from scratch dans notre tutoriel dédié.
En moins d’un an, BERT de Google et GPT-1 d’OpenAI ont montré qu’un transformer pré-entraîné sur du texte non étiqueté pouvait être affiné pour pratiquement n’importe quelle tâche de langue. GPT-3 a suivi en 2020, et des chercheurs de Stanford ont forgé le terme de « modèles fondamentaux » pour cette nouvelle classe.
Depuis, tout s’accélère : des modèles à poids ouverts comme Llama de Meta (2023), des modèles multimodaux comme GPT-4o (2024), des modèles de raisonnement comme o1 d’OpenAI et DeepSeek-R1 (fin 2024 à début 2025), et des modèles agentiques comme GPT-5 (2025) et GPT-6 Astra (2026). Les conceptions publiques restent toutes des transformers. Pour l’histoire complète, consultez notre histoire des grands modèles de langue.
Le passage des modèles RNN aux transformers
Lors de l’apparition du Transformer, les réseaux de neurones récurrents (RNN) et leur variante LSTM étaient la référence pour les données séquentielles. Ils traitent l’entrée élément par élément, ce qui pose deux problèmes majeurs :
- Entraînement lent : chaque étape attend la précédente, ce qui empêche de tirer parti du parallélisme des GPU.
- Oubli à longue portée : l’information se propage pas à pas ; plus la chaîne est longue, plus elle se dégrade.
Les transformers ont conservé l’idée encodeur-décodeur mais ont remplacé la récurrence par l’attention, ce qui résout ces deux problèmes : chaque mot peut se lier directement à n’importe quel autre, quelle que soit la distance, et toute la séquence est traitée en parallèle.
Voyons maintenant comment fonctionne l’architecture.
Comment fonctionne l’architecture Transformer ?
Conçus à l’origine pour la transduction de séquence ou la traduction automatique neuronale, les transformers excellent à convertir des séquences d’entrée en séquences de sortie. Il s’agit du premier modèle de transduction reposant entièrement sur l’auto-attention pour calculer les représentations de l’entrée et de la sortie, sans RNN alignés sur la séquence ni convolution. Le trait distinctif des transformers est qu’ils conservent le schéma encodeur-décodeur.
Si l’on voit la traduction comme une boîte noire, le Transformer prend une phrase dans une langue, par exemple l’anglais, et renvoie sa traduction en espagnol.
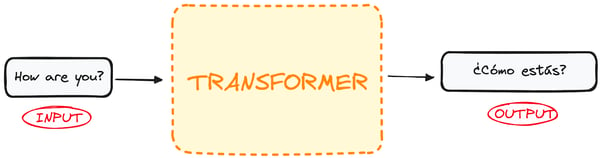
Image de l’auteur.
En y regardant de plus près, cette boîte noire comporte deux grands volets :
- L’encodeur reçoit l’entrée et produit une représentation matricielle de celle-ci. Par exemple, la phrase anglaise « How are you? »
- Le décodeur prend cette représentation encodée et génère itérativement une sortie. Dans notre exemple, la phrase traduite « ¿Cómo estás? »
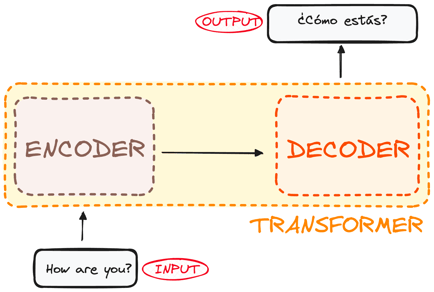
Image de l’auteur. Structure globale encodeur-décodeur.
Cependant, l’encodeur comme le décodeur sont en réalité des piles à multiples couches (même nombre de chaque côté). Tous les encodeurs partagent la même structure : l’entrée traverse chaque couche et passe à la suivante. Tous les décodeurs partagent la même structure et reçoivent l’entrée du dernier encodeur et du décodeur précédent.
L’architecture originale comportait 6 encodeurs et 6 décodeurs, mais on peut répliquer autant de couches que nécessaire. Supposons donc N couches de chaque côté.
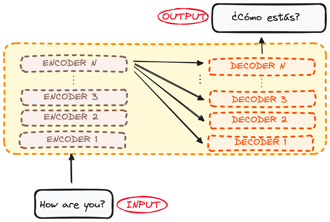
Image de l’auteur. Structure globale encodeur-décodeur. Couches multiples.
Maintenant que nous avons une vue d’ensemble, concentrons-nous sur les encodeurs et les décodeurs pour comprendre leur chaîne de traitement :
Comment fonctionne l’encodeur du Transformer ?
L’encodeur est un composant clé de l’architecture. Sa fonction principale est de transformer les tokens d’entrée en représentations contextualisées. Contrairement aux modèles antérieurs qui traitaient les tokens indépendamment, l’encodeur capture le contexte de chaque token par rapport à toute la séquence.
Sa composition est la suivante :
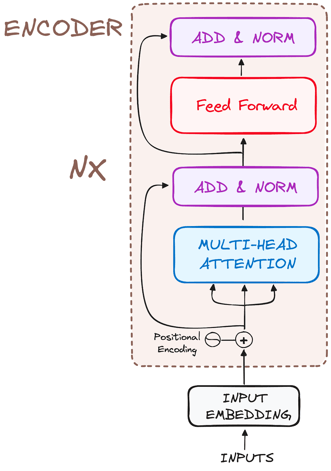
Image de l’auteur. Structure globale des encodeurs.
Décomposons son fonctionnement en étapes essentielles :
Étape 1 : embeddings d’entrée
L’embedding n’a lieu que dans l’encodeur le plus bas. Un tokenizer segmente d’abord le texte en tokens (mots ou morceaux de mots), et chaque token est associé à un vecteur appris appelé embedding. Les tokens de sens proche obtiennent des vecteurs similaires.
Tous les encodeurs reçoivent une liste de vecteurs, chacun de 512 dimensions dans l’article original (dmodel = 512). Dans l’encodeur du bas, ce sont les embeddings de mots ; dans les autres, c’est la sortie de l’encodeur directement en dessous.
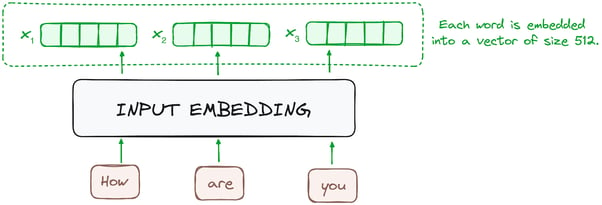
Image de l’auteur. Chaîne de l’encodeur. Embedding d’entrée.
Étape 2 : encodage positionnel
Les transformers n’ayant pas de mécanisme récurrent comme les RNN, ils ajoutent des encodages positionnels aux embeddings d’entrée pour renseigner la position de chaque token dans la séquence. Ils peuvent ainsi comprendre la place de chaque mot dans la phrase.
Pour cela, les chercheurs ont proposé d’utiliser un mélange de fonctions sinus et cosinus afin de créer des vecteurs positionnels, ce qui permet d’appliquer cet encodeur à des phrases de toute longueur.
Dans cette approche, chaque dimension a des fréquences et déphasages propres, avec des valeurs allant de -1 à 1, représentant efficacement chaque position.
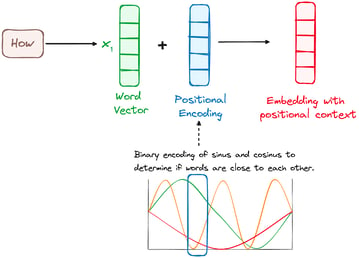
Image de l’auteur. Chaîne de l’encodeur. Encodage positionnel.
Étape 3 : pile de couches d’encodeur
L’encodeur du Transformer est une pile de couches identiques (6 dans le modèle original).
Chaque couche transforme les séquences d’entrée en une représentation continue et abstraite qui capture l’information apprise sur toute la séquence. Elle comprend deux sous-modules :
- Un mécanisme d’attention multi-têtes.
- Un réseau pleinement connecté.
On y ajoute des connexions résiduelles autour de chaque sous-couche, suivies d’une normalisation.
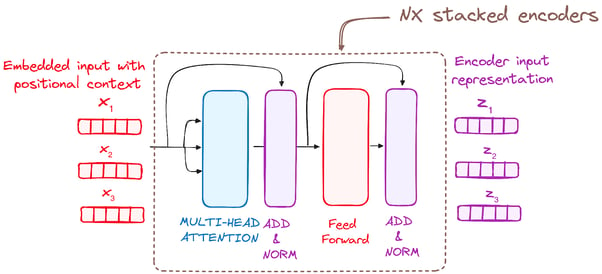
Image de l’auteur. Chaîne de l’encodeur. Pile de couches d’encodeur.
Étape 3.1 : mécanisme d’auto-attention multi-têtes
Dans l’encodeur, l’attention multi-têtes utilise une variante spécifique appelée auto-attention. Elle permet au modèle de relier chaque mot d’entrée aux autres. Par exemple, il peut apprendre à lier « are » à « you ».
Ce mécanisme amène l’encodeur à se concentrer sur des parties différentes de la séquence lors du traitement de chaque token. Il calcule des scores d’attention à partir de :
- Une requête (query), vecteur représentant un mot/token dans le mécanisme d’attention.
- Une clé (key), vecteur correspondant à chaque mot/token de la séquence d’entrée.
- Une valeur (value) associée à chaque clé et utilisée pour construire la sortie de la couche d’attention. Quand la requête et la clé « correspondent » (score élevé), la valeur correspondante est accentuée en sortie.
Ce premier module d’auto-attention permet au modèle de capturer le contexte de toute la séquence. Plutôt qu’une seule attention, on projette linéairement les queries, keys et values h fois. Sur chaque projection, l’attention est calculée en parallèle, produisant une sortie de dimension dv (64 dans l’article d’origine, avec h = 8).
L’architecture détaillée est la suivante :
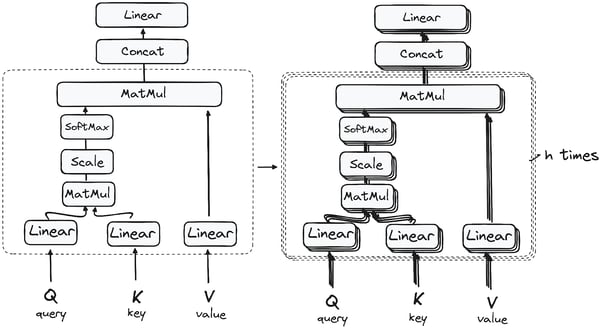
Multiplication matricielle (MatMul) : produit scalaire requête‑clé
Après passage des vecteurs requête, clé et valeur dans une couche linéaire, on effectue une multiplication matricielle (produit scalaire) entre requêtes et clés, ce qui produit une matrice de scores.
Cette matrice définit l’importance que chaque mot doit accorder aux autres. Chaque mot reçoit donc un score par rapport aux autres au même instant. Plus le score est élevé, plus l’attention est forte.
Ce processus met efficacement en correspondance requêtes et clés.
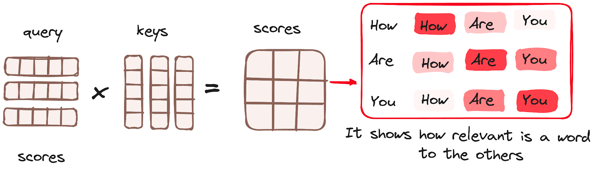
Image de l’auteur. Chaîne de l’encodeur. Attention – multiplication matricielle.
Réduction de l’amplitude des scores d’attention
Les scores sont ensuite réduits en les divisant par la racine carrée de la dimension des vecteurs requête et clé. Cette étape stabilise les gradients, car les multiplications peuvent sinon engendrer des valeurs trop grandes.
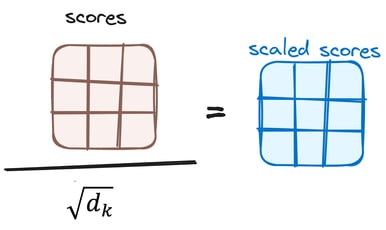
Image de l’auteur. Chaîne de l’encodeur. Réduction des scores d’attention.
Application du softmax aux scores ajustés
On applique ensuite une fonction softmax aux scores ajustés pour obtenir les poids d’attention, des probabilités entre 0 et 1. Le softmax met en avant les scores élevés et atténue les faibles, aidant le modèle à déterminer efficacement quels mots méritent le plus d’attention.
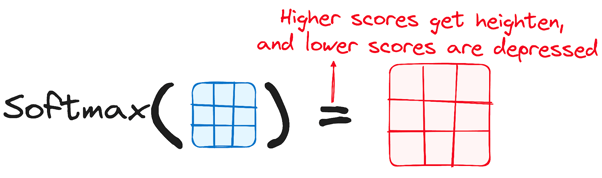
Image de l’auteur. Chaîne de l’encodeur. Scores ajustés par softmax.
Combinaison du résultat du softmax avec le vecteur valeur
Les poids issus du softmax sont multipliés par le vecteur valeur, ce qui produit un vecteur de sortie.
Les mots aux poids élevés dominent le résultat, tandis que ceux proches de 0 contribuent très peu. Enfin, ce vecteur de sortie passe par une couche linéaire pour la suite du traitement.
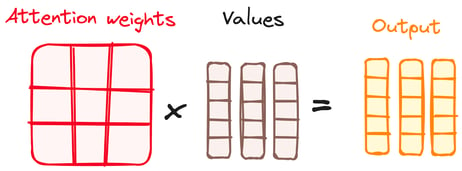
Image de l’auteur. Chaîne de l’encodeur. Combinaison des résultats du softmax avec le vecteur valeur.
On obtient ainsi la sortie du mécanisme d’attention !
Le terme « multi-head » vient du fait que ce processus est exécuté en parallèle plusieurs fois. Avant l’attention, les queries, keys et values sont découpées en h sous-ensembles appelés têtes, et chaque tête effectue les étapes ci-dessus sur sa propre tranche.
Les sorties des têtes sont concaténées puis passées dans une couche linéaire finale. Chaque tête apprenant ses propres projections, elles peuvent capturer des relations différentes, comme l’antécédent d’un pronom ou les mots adjacents.
Pour aller plus loin, consultez notre tutoriel sur l’attention multi-têtes dans les Transformers.
Étape 3.2 : normalisation et connexions résiduelles
Chaque sous-couche d’une couche d’encodeur est suivie d’une normalisation. En outre, la sortie de la sous-couche est ajoutée à son entrée (connexion résiduelle) pour limiter le problème du gradient qui s’annule et permettre des modèles plus profonds. Ce processus est répété après le réseau feed-forward.
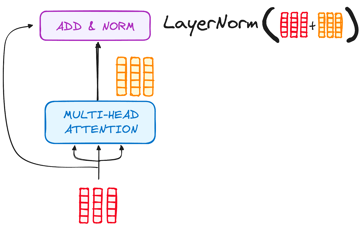
Image de l’auteur. Chaîne de l’encodeur. Normalisation et connexion résiduelle après l’attention multi-têtes.
Étape 3.3 : réseau de neurones feed-forward
La sortie passe ensuite par un réseau feed-forward positionnel : 2 couches linéaires séparées par une activation ReLU, appliquées séparément à chaque token. Dans l’article original, la couche interne a 2 48 dimensions, soit 4 fois la largeur du modèle (512).
Comme pour l’attention, l’entrée du réseau est ajoutée à sa sortie (connexion résiduelle), puis le résultat est normalisé.
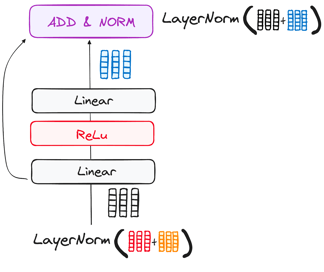
Image de l’auteur. Chaîne de l’encodeur. Sous-couche feed-forward.
Étape 4 : sortie de l’encodeur
La sortie de la dernière couche d’encodeur est un ensemble de vecteurs qui représentent l’entrée avec une riche compréhension contextuelle. Cette sortie sert d’entrée au décodeur.
Ce codage soigné prépare le décodeur et l’aide à se focaliser sur les bons mots de l’entrée au moment du décodage.
Empiler N couches d’encodeur permet à chaque couche de s’appuyer sur les représentations de la précédente. Le modèle original utilisait N = 6 ; BERT-Base en utilise 12 et BERT-Large 24.
Comment fonctionne le décodeur du Transformer ?
Le décodeur génère la séquence de sortie. Ses couches reflètent celles de l’encodeur avec un ajout : chaque couche comporte 2 sous-couches d’attention multi-têtes au lieu d’une, suivies d’un réseau feed-forward, avec connexion résiduelle et normalisation autour de chaque sous-couche.
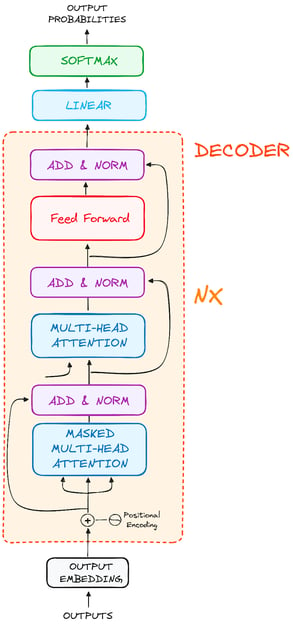
Image de l’auteur. Structure globale des décodeurs.
Ces composants fonctionnent comme dans l’encodeur, avec une nuance : chaque couche d’attention multi-têtes du décodeur a un rôle spécifique.
La fin du processus du décodeur comporte une couche linéaire, jouant le rôle de classifieur, puis un softmax pour calculer les probabilités des différents mots.
Le décodeur est conçu pour générer la sortie en décodant l’information encodée pas à pas.
Il fonctionne en mode auto-régressif : il démarre avec un token de début de séquence et, à chaque pas, prend en entrée les tokens qu’il a déjà générés, ainsi que la sortie de l’encodeur.
Il s’arrête lorsqu’il génère un token de fin de séquence.
Étape 1 : embeddings de sortie
Au démarrage du décodeur, le processus reflète celui de l’encodeur : l’entrée passe d’abord par une couche d’embedding.
Étape 2 : encodage positionnel
Après l’embedding, comme dans l’encodeur, l’entrée passe par la couche d’encodage positionnel afin de produire des embeddings positionnels.
Ces embeddings positionnels alimentent ensuite la première couche d’attention multi-têtes du décodeur, où sont calculés les scores d’attention pour l’entrée du décodeur.
Étape 3 : pile de couches de décodeur
Le décodeur est une pile de couches identiques (6 dans le modèle original). Chaque couche comporte trois sous-composants principaux :
Étape 3.1 : mécanisme d’auto-attention masquée
Semblable à l’auto-attention de l’encodeur, mais avec une différence cruciale : elle empêche les positions de regarder les positions futures, de sorte que chaque mot n’est pas influencé par des tokens à venir.
Par exemple, lors du calcul des scores d’attention pour « Cómo », il est essentiel que ce mot ne voie pas « estás », qui vient plus tard dans la séquence de sortie.
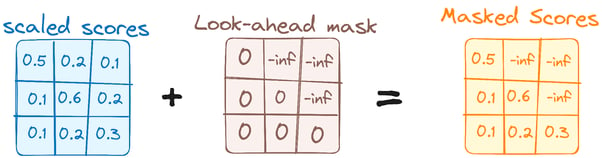
Image de l’auteur. Chaîne du décodeur. Premier masque d’attention multi-têtes.
Ce masquage garantit que la prédiction d’une position ne dépend que des sorties déjà connues aux positions précédentes.
Étape 3.2 : attention encodeur-décodeur (cross-attention)
La seconde sous-couche d’attention relie le décodeur à l’encodeur. Ici, les requêtes viennent de la sortie de l’auto-attention masquée du décodeur, tandis que les clés et valeurs proviennent de la sortie finale de l’encodeur.
Chaque position du décodeur peut ainsi prêter attention à toutes les positions de la phrase d’entrée : lors de la génération de « estás », le décodeur peut se focaliser sur « are you ». Le résultat passe ensuite par la sous-couche feed-forward.
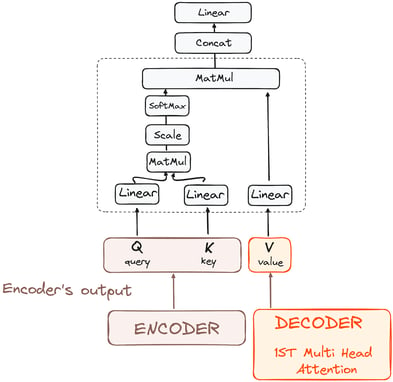
Image de l’auteur. Chaîne du décodeur. Attention encodeur-décodeur.
Étape 3.3 : réseau de neurones feed-forward
Comme dans l’encodeur, chaque couche de décodeur comprend un réseau feed-forward pleinement connecté, appliqué identiquement à chaque position.
Étape 4 : classifieur linéaire et softmax
Le parcours des données se conclut par une couche linéaire finale, jouant le rôle de classifieur.
La taille de ce classifieur correspond au nombre total de classes (taille du vocabulaire). Par exemple, pour 1000 mots distincts, la sortie du classifieur est un vecteur de 1000 éléments.
Cette sortie est ensuite passée à un softmax, qui la transforme en probabilités entre 0 et 1. Le token de probabilité maximale est la meilleure prédiction du prochain mot. Le décodage glouton le sélectionne systématiquement ; la plupart des assistants conversationnels échantillonnent plutôt dans la distribution, avec une température qui contrôle le degré d’aléa.
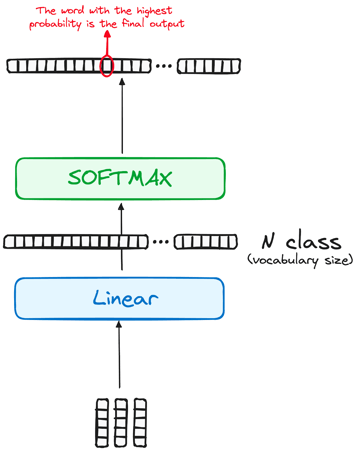
Image de l’auteur. Chaîne du décodeur. Sortie finale du Transformer.
Normalisation et connexions résiduelles
Chaque sous-couche (auto-attention masquée, attention encodeur-décodeur, réseau feed-forward) est suivie d’une normalisation et inclut une connexion résiduelle.
Sortie du décodeur
La sortie de la dernière couche est transformée en séquence prédite, généralement via une couche linéaire puis un softmax pour obtenir des probabilités sur le vocabulaire.
Dans son flux opérationnel, le décodeur réinjecte la sortie fraîchement générée dans ses entrées et poursuit le décodage. Le cycle se répète jusqu’à un token de fin.
Comme l’encodeur, le décodeur est une pile de N couches identiques (6 dans le modèle d’origine), chacune s’appuyant sur la couche inférieure et sur la sortie de l’encodeur. Des piles plus profondes permettent à différentes couches et têtes de capturer des schémas d’attention distincts.
L’architecture finale est la suivante (extraite de l’article original) :
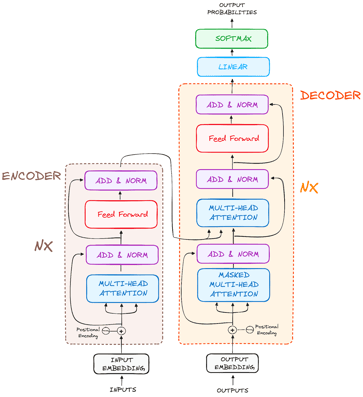
Image de l’auteur. Structure originale des transformers.
Pour mieux comprendre, je vous recommande d’implémenter un Transformer from scratch avec ce tutoriel PyTorch.
Transformers encodeur-seul, décodeur-seul et encodeur-décodeur
Les modèles Transformer se répartissent en 3 familles selon la moitié de l’architecture d’origine qu’ils conservent. Ce choix détermine leur point fort : les encodeurs lisent, les décodeurs écrivent, et les encodeur-décodeurs font correspondre une séquence à une autre.
| Famille | Partie conservée | Attention | Tâche de pré-entraînement | Usages typiques | Exemples |
|---|---|---|---|---|---|
| Encodeur-seul | Pile d’encodeurs | Bidirectionnelle : chaque token voit tous les autres | Compléter des tokens masqués | Classification, embeddings pour la recherche, reconnaissance d’entités nommées | BERT, RoBERTa |
| Décodeur-seul | Pile de décodeurs, sans cross-attention | Causale : chaque token ne voit que les précédents | Prédire le prochain token | Chat, génération de code, agents | GPT-3, Llama, Gemini |
| Encodeur-décodeur | Les deux piles | Encodeur bidirectionnel, décodeur causal, plus cross-attention | Faire correspondre une séquence d’entrée à une séquence de sortie | Traduction, résumé, reconnaissance vocale | Transformer original, T5, Whisper |
La plupart des LLM publiés depuis GPT-3 sont décodeur-seuls. La prédiction du prochain token fonctionne sur tout texte brut, ce qui offre des données d’entraînement abondantes, et un seul modèle peut gérer traduction, résumé et question-réponse en les traitant comme des continuations de texte.
Quels modèles utilisent l’architecture Transformer ?
BERT
BERT (Bidirectional Encoder Representations from Transformers), publié en open source par Google en 2018, est un transformer encodeur-seul. Au lieu de prédire le mot suivant, il a été pré-entraîné à compléter des mots masqués en utilisant le contexte des deux côtés, ce qui l’a rendu plus performant en compréhension que les modèles gauche-à-droite de l’époque.
En comprenant le contexte de part et d’autre d’un mot, BERT a surpassé les modèles précédents sur des tâches comme le question-réponse et la désambiguïsation. Son cœur s’appuie sur les Transformers, reliant dynamiquement chaque entrée et sortie.
BERT a été pré-entraîné sur Wikipedia en anglais et le corpus BooksCorpus, et Google l’a intégré à Search en 2019 pour mieux interpréter les requêtes en langage naturel. Il a lancé une course aux modèles de langue pré-entraînés plus grands.
Pour en savoir plus, consultez notre article qui présente le modèle BERT.
LaMDA
LaMDA (Language Model for Dialogue Applications) est un modèle basé sur les Transformers développé par Google pour les tâches conversationnelles, lancé lors du keynote Google I/O 2021. Il génère des réponses plus naturelles et pertinentes, améliorant les interactions utilisateurs dans diverses applications.
La conçeption de LaMDA lui permet de comprendre et de répondre sur un large éventail de sujets et d’intentions, idéal pour des chatbots, assistants virtuels et autres systèmes d’IA interactifs où la conversation dynamique est essentielle.
Google a ensuite remplacé LaMDA dans Bard par PaLM 2, puis Gemini, mais LaMDA fut l’un des premiers transformers entraînés spécifiquement pour le dialogue.
Si vous souhaitez approfondir LaMDA, consultez notre article sur LaMDA.
GPT et ChatGPT
GPT et ChatGPT, développés par OpenAI, sont des modèles génératifs capables de produire des textes cohérents et pertinents. GPT-1 est sorti en juin 2018, et GPT-3, l’un des plus marquants, en 2020.
Ces modèles excellent dans de nombreuses tâches : création de contenu, conversation, traduction, etc. Leur architecture permet de générer des textes proches de l’écriture humaine, utiles en écriture créative, support client et même assistance au codage. ChatGPT, optimisé pour la conversation, génère des dialogues très naturels, adaptés aux chatbots et assistants virtuels.
OpenAI a cessé de publier des détails d’architecture après GPT-3 (sauf pour ses modèles à poids ouverts gpt-oss), mais la famille s’est agrandie, dernièrement avec GPT-6 Astra en 2026.
Claude
Claude, développé par Anthropic, est une famille d’assistants IA basés sur les Transformers, conçus avec un fort accent sur la sécurité et l’utilité. Claude utilise la Constitutional AI (CAI), une approche d’entraînement guidée par des principes pour produire des réponses utiles, inoffensives et honnêtes.
Claude 3 (2024) a introduit trois niveaux de modèles, Haiku, Sonnet et Opus, offrant différents compromis entre vitesse et capacité. Ils excellent en raisonnement nuancé, suivi d’instructions complexes et maintien du contexte sur de longues conversations (jusqu’à 200 K tokens).
Anthropic a publié de nouvelles générations tous les quelques mois depuis. L’actuelle série Claude 5 comprend Claude Fable 5.1 et Claude Opus 5.5, toutes deux sorties en 2026. Comme OpenAI, Anthropic ne publie pas les détails d’architecture.
Autres variations
Le nombre de modèles transformer a explosé. Le catalogue des transformers de Xavier Amatriain en classe des dizaines selon l’architecture et l’objectif d’entraînement, et le benchmark HELM de Stanford a évalué côte à côte 30 modèles de langue majeurs.
La tendance est à l’open source, avec des plateformes comme le hub de modèles Hugging Face. De nombreux modèles spécialisés ont vu le jour, chacun adapté à des tâches de TAL différentes, illustrant la polyvalence et l’efficacité des Transformers.
Pour en savoir plus sur les modèles fondamentaux, consultez notre article dédié qui présente ce qu’ils sont et les plus utilisés.
Comment les transformers ont-ils évolué depuis 2017 ?
Depuis l’architecture initiale de 2017, les Transformers ont beaucoup évolué pour pallier leurs limites et s’étendre à de nouveaux domaines.
En quoi les LLM modernes diffèrent-ils du Transformer original ?
Les LLM à poids ouverts actuels suivent encore le plan de 2017, mais presque chaque composant a été remplacé par une variante plus stable à entraîner ou moins coûteuse à exécuter. Meta documente la plupart de ces évolutions dans ses articles LLaMA et Llama 3 :
| Composant | Transformer original (2017) | LLM à poids ouverts typique aujourd’hui |
|---|---|---|
| Architecture | Encodeur-décodeur, 6 + 6 couches | Décodeur-seul, de 32 couches (Llama 3 8B) à 126 (Llama 3 405B) |
| Largeur du modèle | 512 | 4 96 (Llama 3 8B) à 16 384 (Llama 3 405B) |
| Information de position | Encodages sinus/cosinus fixes ajoutés aux embeddings | Rotary position embeddings (RoPE) appliqués dans l’attention |
| Normalisation | LayerNorm après chaque sous-couche (post-norm) | RMSNorm avant chaque sous-couche (pre-norm) |
| Activation feed-forward | ReLU | SwiGLU |
| Têtes d’attention | Multi-head attention, 8 têtes | Grouped-query attention : plusieurs têtes de requête partagent 1 tête key-value (8 têtes key-value dans Llama 3) |
| Couche feed-forward | Dense | Dense, ou mixture of experts (Llama 4, DeepSeek-V3) |
Vision Transformers (ViT)
Les Vision Transformers appliquent l’auto-attention aux images en les divisant en patchs traités comme des tokens. Cette approche s’avère très efficace pour la classification, la détection d’objets et la génération d’images, surpassant souvent les CNN classiques sur de grands jeux de données.
Transformers multimodaux
Des modèles récents comme GPT-5, Gemini 3 et Llama 4 traitent plusieurs types d’entrées (texte, images, audio, vidéo) dans une même architecture. Ces transformers multimodaux utilisent des espaces d’embedding unifiés et de la cross-attention pour raisonner simultanément à travers les modalités.
Transformers efficaces
La complexité quadratique de l’auto-attention limite la longueur de contexte. Plusieurs innovations y répondent :
- Flash Attention : calcule une attention exacte par tuiles stockées dans la mémoire rapide du GPU, faisant croître l’usage mémoire linéairement plutôt que quadratiquement
- Rotary Position Embeddings (RoPE) : encode l’information de position via des matrices de rotation, améliorant l’extrapolation vers de plus longues séquences
- Attentions linéaires et creuses : Linformer et Performer approximent l’attention, et Longformer limite la plupart des tokens à une fenêtre locale, ramenant le coût à O(n) pour de très longs documents
- Mixture of experts (MoE) : n’active qu’un sous-ensemble de paramètres par token, permettant des modèles plus grands à coût de calcul similaire
Transformers vs. RNN et CNN
On compare généralement les transformers à deux autres briques de réseaux de neurones : les couches récurrentes (RNN) et les couches convolutionnelles (CNN). Chacune convient à un type de données différent.
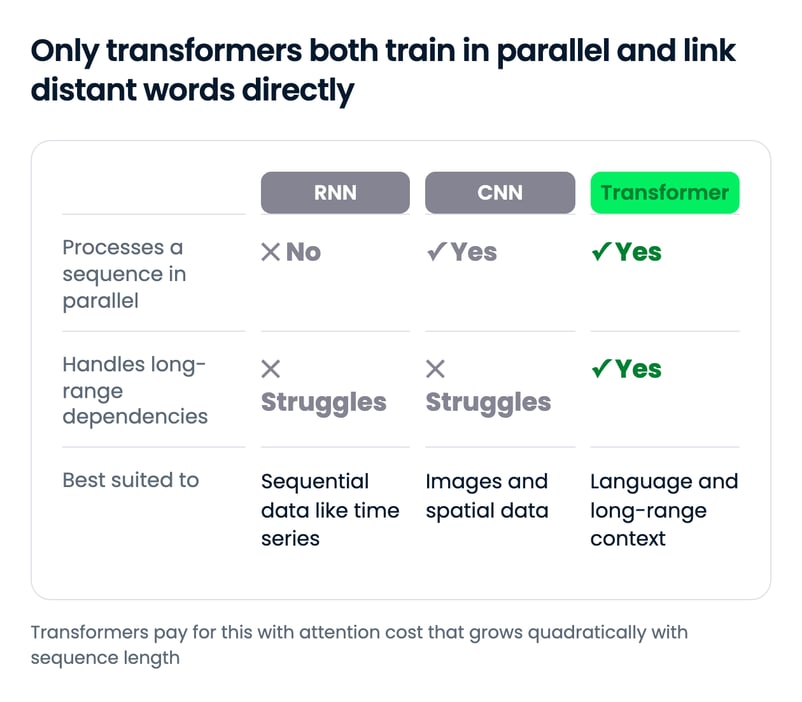
Couches récurrentes
Les couches récurrentes, au cœur des RNN, excellent pour les données séquentielles. Leur force réside dans le traitement séquentiel, crucial pour le langage ou les séries temporelles. La sortie d’une étape est réinjectée comme entrée à l’étape suivante, ce qui permet de mémoriser l’information précédente et de comprendre le contexte.
Mais ce traitement séquentiel implique deux conséquences majeures :
- Un entraînement plus long, car chaque étape dépend de la précédente et limite le parallélisme.
- Des difficultés avec les dépendances à long terme (problème du gradient qui s’atténue), ce qui nuit à l’apprentissage de signaux éloignés dans la séquence.
Les transformers s’en distinguent nettement, car ils sont dépourvus de récurrence. Comme vu plus haut, la couche d’attention résout ces deux problèmes, ce qui en fait l’évolution naturelle des RNN pour les applications de TAL.
Couches convolutionnelles
Les couches convolutionnelles, base des CNN, sont très efficaces pour les données spatiales comme les images.
Elles utilisent des filtres (kernels) qui balaient l’entrée pour en extraire des caractéristiques. La largeur de ces filtres est ajustable, ce qui permet de capter de petits ou grands motifs selon la tâche.
Si les convolutions capturent bien les hiérarchies spatiales, elles peinent avec les dépendances à long terme : elles ne tiennent pas intrinsèquement compte de l’ordre, ce qui les rend moins adaptées aux tâches où l’ordre ou le contexte séquentiel est crucial.
Ainsi, CNN et transformers répondent à des besoins différents : les CNN dominent la vision par ordinateur, tandis que les transformers sont devenus la référence pour les tâches séquentielles complexes, notamment en TAL, grâce à leur capacité à modéliser des dépendances longues.
Limites et inconvénients des transformers
Malgré leur succès, les transformers présentent des limites notables :
- Complexité quadratique : le coût de l’auto-attention est en O(n²) avec la longueur de séquence, ce qui rend les fenêtres de contexte très longues coûteuses
- Besoins mémoire : les grands modèles exigent beaucoup de mémoire GPU, ce qui limite le déploiement
- Besoins en données : ils requièrent généralement des jeux de données massifs pour de bonnes performances
- Hallucination : ils prédisent des tokens probables sans vérifier des faits, et peuvent donc affirmer avec assurance des informations fausses. Les modèles de raisonnement réduisent ce phénomène sans l’éliminer
- Limites d’encodage positionnel : les encodages standard généralisent mal à des longueurs non vues à l’entraînement
La recherche continue d’y répondre par des innovations d’architecture comme Flash Attention, la mixture-of-experts et la génération augmentée par recherche (RAG).
Pour conclure
Un transformer fonctionne en laissant chaque token regarder tous les autres via l’auto-attention, puis en affinant ces représentations au fil d’une pile de couches identiques. Ce choix a rendu l’entraînement parallèle sur GPU et a résolu le problème de mémoire à longue portée qui freinait les RNN.
Ce qui frappe, c’est la stabilité du cœur du modèle. Un LLM de 2026 remplace l’encodage positionnel, la normalisation et les têtes d’attention par des variantes moins coûteuses, mais on y reconnaît toujours le schéma de 2017. La grande question est de savoir si les modèles à espace d’états et les hybrides s’imposeront pour les longs contextes, ou si des noyaux comme FlashAttention maintiendront le coût quadratique à un niveau acceptable.
Pour passer à la pratique, construisez un Transformer avec PyTorch dans notre tutoriel pas à pas, ou partez de modèles préentraînés avec notre introduction aux Transformers et à Hugging Face. Si vous souhaitez aller plus loin, nous recommandons le cours Transformer Models with PyTorch ou le parcours Developing Large Language Models pour une formation complète.
FAQs
Comment fonctionne l’architecture transformer ?
Un transformer découpe le texte en tokens, convertit chaque token en embedding et ajoute une information positionnelle. Une pile de couches applique ensuite l’auto-attention multi-têtes, qui permet à chaque token de pondérer tous les autres, puis un réseau feed-forward, avec connexions résiduelles et normalisation autour de chaque étape. Une dernière couche linéaire et un softmax produisent des probabilités pour le prochain token.
Quelle est la différence entre transformers encodeur-seuls, décodeur-seuls et encodeur-décodeur ?
Les modèles encodeur-seuls comme BERT lisent toute l’entrée de façon bidirectionnelle et conviennent à la classification et à la recherche. Les modèles décodeur-seuls comme GPT et Llama ne voient que les tokens précédents et sont entraînés à prédire le suivant ; c’est l’architecture standard pour les LLM de chat. Les modèles encodeur-décodeur comme T5 et le Transformer original font correspondre une séquence d’entrée à une séquence de sortie, comme en traduction.
Pourquoi les transformers ont-ils remplacé les RNN et LSTM ?
Les RNN et LSTM traitent les tokens un par un, ce qui ralentit l’entraînement sur GPU et laisse l’information s’étioler sur de longues séquences. L’auto-attention relie chaque token directement à tous les autres et traite toute la séquence en parallèle ; les transformers s’entraînent donc plus vite et gèrent mieux les dépendances longues.
ChatGPT est-il un transformer ?
Oui. GPT signifie Generative Pre-trained Transformer, et les modèles GPT derrière ChatGPT sont des transformers décodeur-seuls entraînés à prédire le prochain token. OpenAI ne publie plus de détails d’architecture depuis GPT-3, mais chaque GPT repose sur le design transformer.
Quelles sont les principales limites des transformers ?
Le coût de l’auto-attention croît quadratiquement avec la longueur de séquence, donc les contextes très longs sont gourmands en calcul et en mémoire. Les transformers requièrent aussi de grands jeux de données d’entraînement et peuvent halluciner, affirmant avec assurance des informations fausses. Des techniques comme FlashAttention, la grouped-query attention, la mixture of experts et des hybrides avec des modèles à espace d’états ciblent ces coûts.

Josep est data scientist et chef de projet à l'Office du tourisme de Catalogne, où il utilise les données pour améliorer l'expérience des touristes en Catalogne. Son expertise comprend la gestion du stockage et du traitement des données, associée à des analyses avancées et à la communication efficace des données.
Il est également un éducateur dévoué, enseignant le programme de Master Big Data à l'Université de Navarre, et contribuant régulièrement à des articles perspicaces sur la science des données sur Medium et KDNuggets.
Il est titulaire d'une licence en ingénierie physique de l'université polytechnique de Catalogne et d'une maîtrise en systèmes interactifs intelligents de l'université Pompeu Fabra.
Actuellement, il s'engage avec passion à rendre les technologies liées aux données plus accessibles à un public plus large par le biais de la publication ForCode'Sake sur Medium.





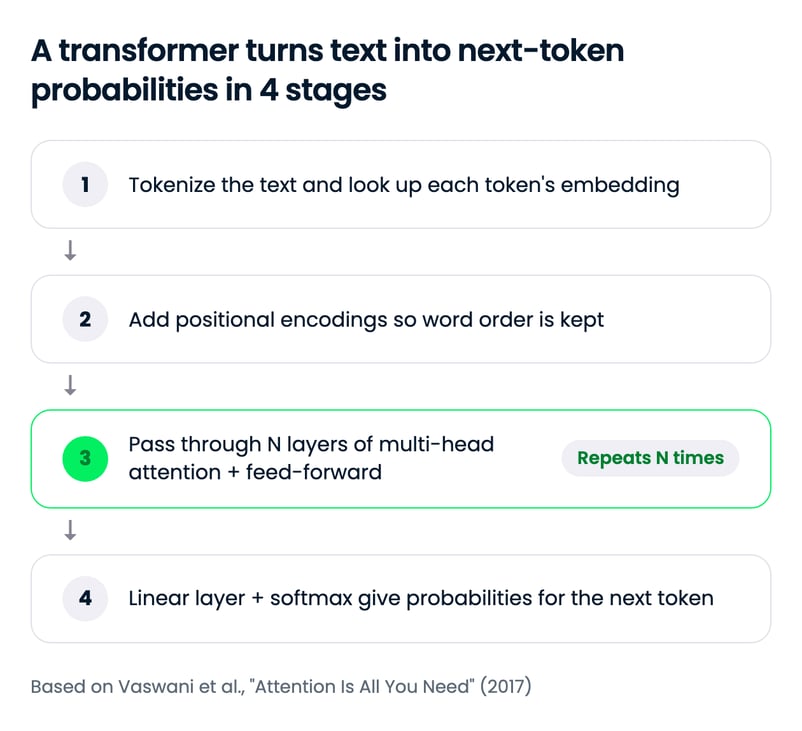
Un transformer est un réseau de neurones qui lit tous les tokens d’une séquence en parallèle et utilise l’auto-attention pour déterminer dans quelle mesure chaque token doit s’appuyer sur tous les autres. Des chercheurs de Google l’ont présenté dans l’article de 2017 « Attention Is All You Need », et il constitue aujourd’hui la base de la plupart des grands modèles de langue (LLM), de GPT et Llama à Gemini.
L’architecture opère en 4 étapes : le texte est découpé en tokens et projeté en embeddings, on ajoute une information positionnelle, puis une pile de couches alterne multi-head self-attention et réseaux feed-forward (chacun encapsulé dans une connexion résiduelle et une normalisation). Enfin, une couche linéaire avec softmax convertit le dernier vecteur en probabilités sur le vocabulaire. Le modèle original associait un encodeur à un décodeur ; la plupart des LLM actuels ne conservent que le décodeur.
Dans ce tutoriel, je passe en revue chaque étape du schéma encodeur‑décodeur d’origine, puis j’explique comment BERT, GPT et les LLM actuels l’ont fait évoluer. Pour l’intuition d’abord, lisez nos explications sur le mécanisme d’attention et l’auto-attention.
En bref