

¿Qué son los transformers?
Los transformers se desarrollaron inicialmente para resolver el problema de la transducción de secuencias, o traducción automática neuronal, es decir, cualquier tarea que transforma una secuencia de entrada en otra de salida. De ahí su nombre: “Transformers”.
Pero empecemos por el principio.
Una definición sencilla
Un modelo transformer es una red neuronal que aprende el contexto de datos secuenciales y genera nuevos datos a partir de él.
En pocas palabras:
Un transformer es un tipo de modelo de inteligencia artificial que aprende a comprender y generar texto similar al humano analizando patrones en grandes cantidades de datos de texto.
Los transformers son el estado del arte actual en PLN y se consideran la evolución de la arquitectura encoder-decoder. Sin embargo, mientras que esta arquitectura se basaba sobre todo en redes neuronales recurrentes (RNN) para extraer información secuencial, los transformers prescinden por completo de la recurrencia.
Entonces, ¿cómo lo hacen?
Están diseñados específicamente para captar el contexto y el significado analizando la relación entre distintos elementos, y dependen casi por completo de una técnica matemática llamada atención para lograrlo.
Imagen del autor.
Contexto histórico
Los transformers fueron presentados por investigadores de Google en el paper de 2017 "Attention is All You Need". El código se publicó en el paquete Tensor2Tensor de TensorFlow, y el grupo de Harvard NLP publicó después una guía anotada del paper en PyTorch. También puedes aprender a implementar un Transformer desde cero en nuestro tutorial aparte.
En menos de un año, BERT de Google y GPT-1 de OpenAI demostraron que un transformer preentrenado en texto sin etiquetar podía ajustarse finamente para casi cualquier tarea de lenguaje. GPT-3 llegó en 2020, y un equipo de Stanford acuñó el término “modelos fundacionales” para esta nueva clase.
Desde entonces, todo se ha acelerado: modelos de pesos abiertos como Llama de Meta (2023), modelos multimodales como GPT-4o (2024), modelos de razonamiento como o1 de OpenAI y DeepSeek-R1 (finales de 2024 a principios de 2025), y modelos agénticos como GPT-5 (2025) y GPT-6 Astra (2026). Los modelos con diseños públicos siguen siendo transformers. Para la historia completa, consulta nuestra historia de los grandes modelos de lenguaje.
El paso de los modelos RNN a los transformers
Cuando se presentó el Transformer, las redes neuronales recurrentes (RNN) y su variante long short-term memory (LSTM) eran la opción por defecto para datos secuenciales. Procesan la entrada elemento a elemento, lo que provoca dos problemas principales:
- Entrenamiento lento: cada paso espera al anterior, así que las RNN no pueden aprovechar el paralelismo para el que están diseñadas las GPU.
- Olvido a larga distancia: la información se transmite paso a paso, y cuanto más larga es la cadena, más probable es que se pierda.
Los transformers conservaron la idea encoder-decoder de las RNN, pero sustituyeron la recurrencia por atención, lo que soluciona ambos problemas: cada palabra puede atender directamente a cualquier otra, por lejana que esté, y toda la secuencia se procesa en paralelo.
Ahora, veamos cómo funcionan los transformers.
¿Cómo funciona la arquitectura Transformer?
Concebidos originalmente para la transducción de secuencias o traducción automática neuronal, los transformers destacan convirtiendo secuencias de entrada en secuencias de salida. Es el primer modelo de transducción que se basa por completo en self-attention para calcular las representaciones de su entrada y salida, sin usar RNN alineadas por secuencia ni convoluciones. La característica central de la arquitectura Transformer es que mantiene el modelo encoder-decoder.
Si pensamos en un Transformer para traducción como una simple caja negra, tomaría una frase en un idioma, inglés por ejemplo, como entrada y devolvería su traducción al español.
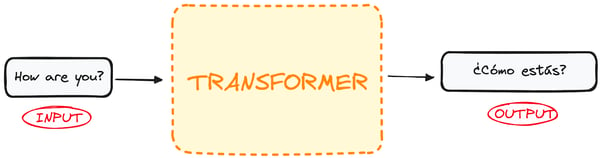
Imagen del autor.
Si profundizamos un poco, vemos que esta caja negra se compone de dos partes principales:
- El encoder recibe nuestra entrada y produce una representación matricial de esa entrada. Por ejemplo, la frase en inglés “How are you?”
- El decoder toma esa representación codificada y genera la salida de forma iterativa. En nuestro ejemplo, la frase traducida “¿Cómo estás?”
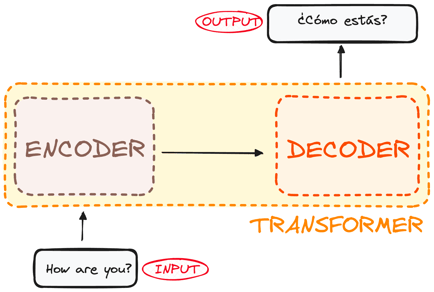
Imagen del autor. Estructura global de encoder-decoder.
Sin embargo, tanto el encoder como el decoder son en realidad una pila con múltiples capas (el mismo número para cada uno). Todos los encoders comparten estructura; la entrada pasa por cada uno y se transmite al siguiente. Todos los decoders comparten también la misma estructura: reciben la salida del último encoder y la del decoder previo.
La arquitectura original constaba de 6 encoders y 6 decoders, pero podemos replicar tantas capas como queramos. Asumamos N capas de cada uno.
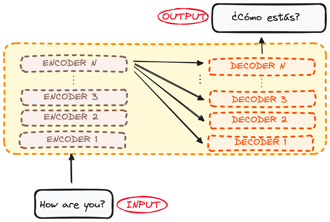
Imagen del autor. Estructura global de encoder-decoder. Múltiples capas.
Con la idea general clara, centrémonos ahora en encoders y decoders para entender mejor su flujo de trabajo:
¿Cómo funciona el encoder del Transformer?
El encoder es un componente fundamental de la arquitectura Transformer. Su función principal es transformar los tokens de entrada en representaciones contextualizadas. A diferencia de modelos anteriores que procesaban tokens de forma independiente, el encoder del Transformer capta el contexto de cada token con respecto a toda la secuencia.
Su composición estructural es la siguiente:
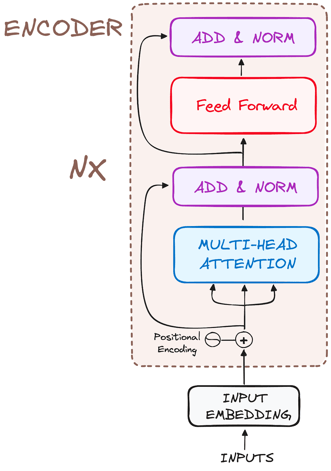
Imagen del autor. Estructura global de los encoders.
Desglosamos su flujo en pasos básicos:
Paso 1: embeddings de entrada
El embedding solo ocurre en el encoder más inferior. Primero, un tokenizador divide el texto en tokens, que son palabras o fragmentos de palabra, y cada token se mapea a un vector aprendido llamado embedding. Los tokens con significados relacionados acaban teniendo vectores similares.
Todos los encoders reciben una lista de vectores, cada uno con 512 dimensiones en el paper original (dmodel = 512). En el encoder inferior, serían los word embeddings; en los demás, sería la salida del encoder inmediatamente anterior.
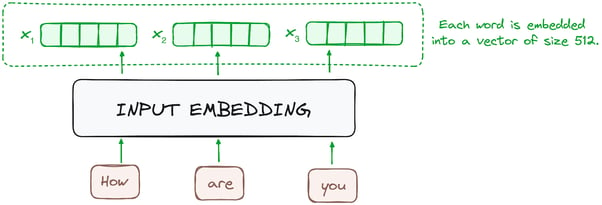
Imagen del autor. Flujo del encoder. Embedding de entrada.
Paso 2: codificación posicional
Como los transformers no tienen un mecanismo de recurrencia como las RNN, utilizan codificaciones posicionales añadidas a los embeddings de entrada para aportar información sobre la posición de cada token en la secuencia. Esto les permite entender la ubicación de cada palabra en la frase.
Para ello, los autores propusieron emplear una combinación de funciones seno y coseno para crear vectores posicionales, lo que permite usar este codificador posicional con frases de cualquier longitud.
En este enfoque, cada dimensión se representa con frecuencias y desfases únicos de la onda, con valores entre -1 y 1, representando eficazmente cada posición.
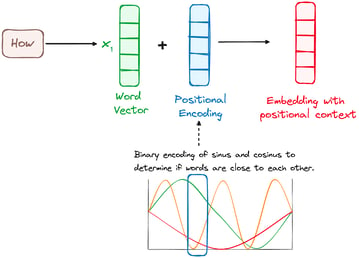
Imagen del autor. Flujo del encoder. Codificación posicional.
Paso 3: pila de capas de encoder
El encoder del Transformer consta de una pila de capas idénticas (6 en el modelo original).
Cada capa transforma las secuencias de entrada en una representación continua y abstracta que recoge la información aprendida de toda la secuencia. Esta capa incluye dos submódulos:
- Un mecanismo de atención multi-cabeza.
- Una red totalmente conectada.
Además, incorpora conexiones residuales alrededor de cada subcapa, seguidas de una normalización por capas.
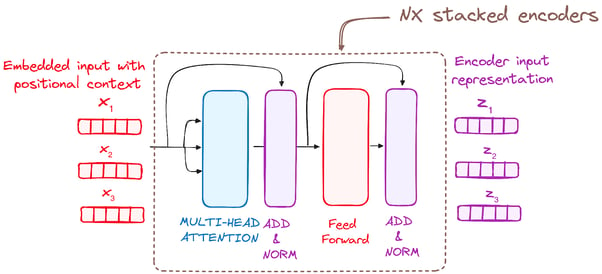
Imagen del autor. Flujo del encoder. Pila de capas del encoder.
Paso 3.1: mecanismo de self-attention multi-cabeza
En el encoder, la atención multi-cabeza utiliza un tipo de atención llamado self-attention. Este enfoque permite que el modelo relacione cada palabra de la entrada con las demás. Por ejemplo, puede aprender a conectar “are” con “you”.
Este mecanismo permite al encoder centrarse en distintas partes de la secuencia de entrada al procesar cada token. Calcula puntuaciones de atención a partir de:
- Una query, vector que representa un token concreto de la secuencia en el mecanismo de atención.
- Una key, también un vector en el mecanismo de atención, correspondiente a cada token de la secuencia.
- Cada value se asocia a una key y se usa para construir la salida de la capa de atención. Cuando una query y una key encajan bien, es decir, tienen una puntuación de atención alta, el value correspondiente se enfatiza en la salida.
Este primer módulo de self-attention permite al modelo capturar información contextual de toda la secuencia. En lugar de realizar una única atención, las queries, keys y values se proyectan linealmente h veces. En cada una de estas versiones proyectadas se ejecuta el mecanismo de atención en paralelo, produciendo cada una una salida de dimensión dv (64 en el paper original, con h = 8).
La arquitectura detallada es la siguiente:
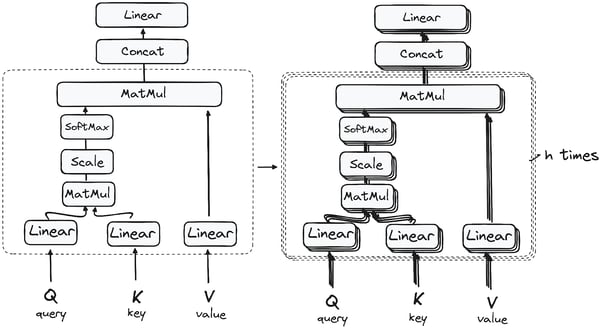
Multiplicación de matrices (MatMul): producto punto de query y key
Tras pasar los vectores de query, key y value por una capa lineal, se realiza un producto punto entre queries y keys, obteniendo una matriz de puntuaciones.
Esta matriz establece el grado de énfasis que debe poner cada palabra en las demás. Así, a cada palabra se le asigna una puntuación respecto a las otras en el mismo paso temporal. Una puntuación más alta implica mayor enfoque.
Este proceso mapea de forma efectiva las queries con sus keys correspondientes.
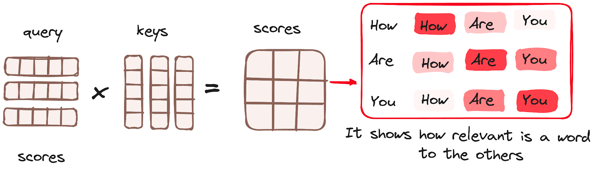
Imagen del autor. Flujo del encoder. Mecanismo de atención - multiplicación de matrices.
Reducir la magnitud de las puntuaciones de atención
Las puntuaciones se escalan dividiéndolas por la raíz cuadrada de la dimensión de las queries y las keys. Este paso estabiliza los gradientes, ya que la multiplicación puede provocar efectos excesivos.
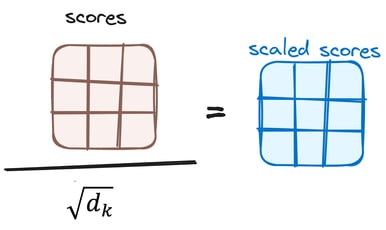
Imagen del autor. Flujo del encoder. Reducción de las puntuaciones de atención.
Aplicar softmax a las puntuaciones ajustadas
A continuación se aplica una función softmax a las puntuaciones ajustadas para obtener los pesos de atención. Esto da como resultado valores de probabilidad entre 0 y 1. El softmax enfatiza las puntuaciones más altas y reduce las bajas, mejorando la capacidad del modelo para decidir a qué palabras prestar más atención.
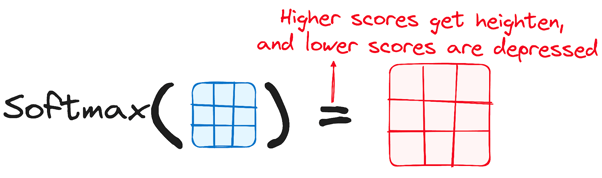
Imagen del autor. Flujo del encoder. Softmax sobre puntuaciones ajustadas.
Combinar los resultados de softmax con el vector value
El siguiente paso multiplica los pesos obtenidos con softmax por el vector value, produciendo un vector de salida.
Las palabras con pesos altos dominan el resultado, mientras que las cercanas a 0 aportan casi nada. Finalmente, este vector pasa por una capa lineal para su procesamiento posterior.
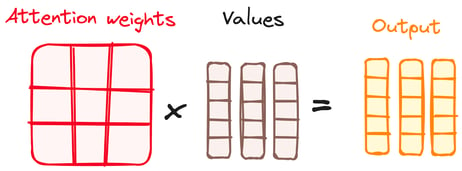
Imagen del autor. Flujo del encoder. Combinación de softmax con el vector value.
¡Y ya tenemos la salida del mecanismo de atención!
La palabra “multi-cabeza” viene de ejecutar este proceso varias veces en paralelo. Antes de la atención, las queries, keys y values se dividen en h subconjuntos más pequeños llamados cabezas, y cada cabeza ejecuta los pasos anteriores en su porción.
Las salidas de las cabezas se concatenan y pasan por una última capa lineal. Como cada cabeza aprende sus propias proyecciones, distintas cabezas pueden capturar relaciones diferentes, como a qué sustantivo se refiere un pronombre o qué palabras están juntas.
Para profundizar en el mecanismo de atención, consulta nuestro tutorial sobre atención multi-cabeza en transformers.
Paso 3.2: normalización y conexiones residuales
Cada subcapa en una capa del encoder va seguida de una normalización. Además, a la salida de cada subcapa se le suma su entrada (conexión residual) para mitigar el problema del gradiente que se desvanece y permitir modelos más profundos. Este proceso se repite también tras la red feed-forward.
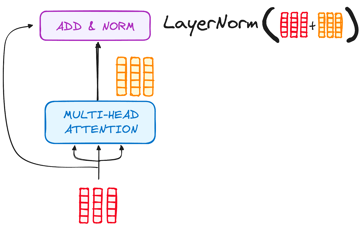
Imagen del autor. Flujo del encoder. Normalización y conexión residual tras la atención multi-cabeza.
Paso 3.3: red neuronal feed-forward
Después, la salida pasa por una red feed-forward aplicada por posición: 2 capas lineales con una activación ReLU entre medias, aplicadas a cada token por separado. En el paper original, la capa interna tiene 2.048 dimensiones, 4 veces el ancho del modelo (512).
Como en la atención, la entrada de la red se suma a su salida (conexión residual) y el resultado se normaliza.
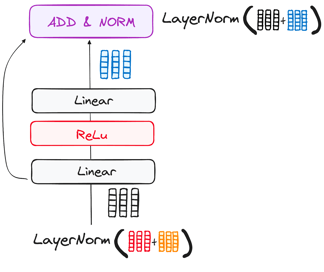
Imagen del autor. Flujo del encoder. Subcapa feed-forward.
Paso 4: salida del encoder
La salida de la última capa del encoder es un conjunto de vectores que representan la secuencia de entrada con un rico entendimiento contextual. Esta salida se usa como entrada para el decoder en un modelo Transformer.
Esta codificación prepara el terreno para el decoder, guiándolo para que preste atención a las palabras adecuadas de la entrada cuando toque decodificar.
Apilar N capas de encoder permite que cada capa construya sobre las representaciones de la inferior. El modelo original usaba N = 6; BERT-Base usa 12 y BERT-Large 24.
¿Cómo funciona el decoder del Transformer?
El decoder genera la secuencia de salida. Sus capas reflejan las del encoder con una adición: cada capa tiene 2 subcapas de atención multi-cabeza en lugar de 1, seguidas de una red feed-forward por posición, con conexión residual y normalización alrededor de cada subcapa.
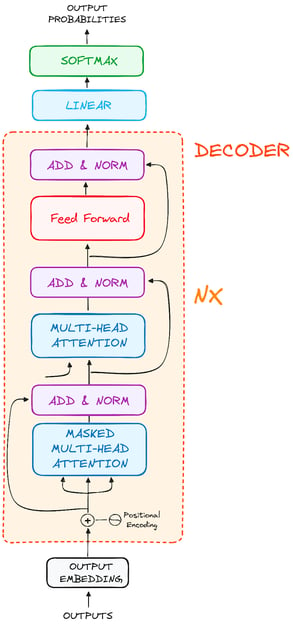
Imagen del autor. Estructura global de los decoders.
Estos componentes funcionan de forma similar a los del encoder, con un matiz: cada capa de atención multi-cabeza del decoder tiene su propia misión.
El proceso del decoder termina con una capa lineal, que actúa como clasificador, rematada con un softmax para calcular las probabilidades de las distintas palabras.
El decoder del Transformer está diseñado específicamente para generar la salida decodificando paso a paso la información codificada.
El decoder funciona de forma autorregresiva: empieza con un token de inicio de secuencia y, en cada paso, toma como entrada los tokens que ha generado hasta el momento junto con la salida del encoder.
Se detiene cuando genera un token de fin de secuencia.
Paso 1: embeddings de salida
Al arrancar el decoder, el proceso refleja al del encoder. La entrada pasa primero por una capa de embeddings.
Paso 2: codificación posicional
Tras el embedding, igual que en el encoder, la entrada pasa por la capa de codificación posicional para obtener embeddings posicionales.
Estos embeddings posicionales entran en la primera capa de atención multi-cabeza del decoder, donde se calculan las puntuaciones de atención para su propia entrada.
Paso 3: pila de capas del decoder
El decoder consta de una pila de capas idénticas (6 en el modelo original). Cada capa tiene tres subcomponentes principales:
Paso 3.1: mecanismo de self-attention enmascarado
Es similar al self-attention del encoder, pero con una diferencia crucial: impide que una posición atienda a posiciones posteriores, lo que significa que cada palabra no se ve influida por tokens futuros.
Por ejemplo, al calcular la atención para la palabra “Cómo”, es importante que “Cómo” no pueda ver “estás”, que aparece después en la secuencia de salida.
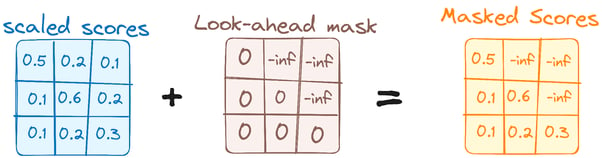
Imagen del autor. Flujo del decoder. Primer enmascaramiento de atención multi-cabeza.
Este enmascaramiento garantiza que las predicciones de una posición solo dependan de salidas conocidas en posiciones anteriores.
Paso 3.2: atención encoder-decoder (cross-attention)
La segunda subcapa de atención conecta el decoder con el encoder. Aquí, las queries provienen de la salida del self-attention enmascarado del decoder, mientras que las keys y los values vienen de la salida final del encoder.
Esto permite que cada posición del decoder atienda a todas las posiciones de la frase de entrada; así, al generar “estás”, el decoder puede centrarse en “are you”. El resultado pasa después por la subcapa feed-forward.
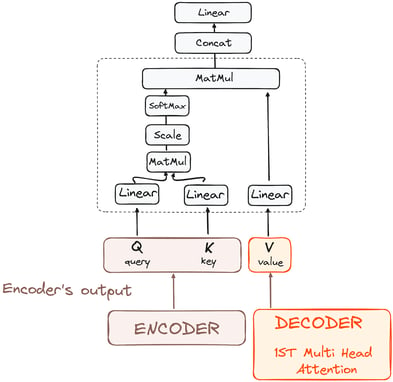
Imagen del autor. Flujo del decoder. Atención encoder-decoder.
Paso 3.3: red neuronal feed-forward
Similar al encoder, cada capa del decoder incluye una red feed-forward totalmente conectada, aplicada a cada posición por separado e idénticamente.
Paso 4: clasificador lineal y softmax
El recorrido de los datos por el modelo termina pasando por una última capa lineal, que funciona como clasificador.
El tamaño de este clasificador corresponde al número total de clases (palabras del vocabulario). Por ejemplo, si hay 1.000 clases, la salida será un vector de 1.000 elementos.
Esta salida pasa por una capa softmax que la convierte en probabilidades entre 0 y 1. El token con mayor probabilidad es la mejor conjetura del modelo para la siguiente palabra. El decodificado codicioso siempre lo elige; la mayoría de chatbots, en cambio, muestrean de la distribución, con una temperatura que controla cuánta aleatoriedad se permite.
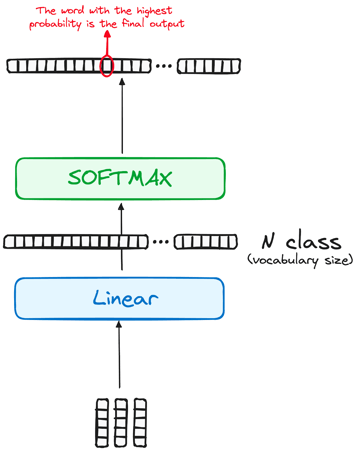
Imagen del autor. Flujo del decoder. Salida final del Transformer.
Normalización y conexiones residuales
Cada subcapa (self-attention enmascarado, atención encoder-decoder, red feed-forward) va seguida de una normalización e incluye una conexión residual alrededor.
Salida del decoder
La salida de la última capa se transforma en una secuencia predicha, normalmente con una capa lineal seguida de softmax para generar probabilidades sobre el vocabulario.
El decoder, en su flujo operativo, incorpora la salida recién generada a su lista creciente de entradas y continúa la decodificación. Este ciclo se repite hasta que el modelo predice un token específico que señala el fin.
Como el encoder, el decoder es una pila de N capas idénticas (6 en el modelo original), que construyen sobre la salida de la capa inferior y la salida del encoder. Pilas más profundas permiten que distintas capas y cabezas capten patrones de atención diferentes.
La arquitectura final es esta (del paper original):
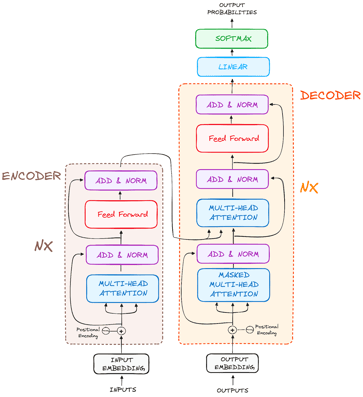
Imagen del autor. Estructura original de los transformers.
Para entender mejor esta arquitectura, te recomiendo aplicar un Transformer desde cero siguiendo este tutorial para construir un transformer con PyTorch.
Transformers solo con encoder, solo con decoder y encoder-decoder
Los modelos Transformer se agrupan en 3 familias, según qué mitad de la arquitectura original conservan. La elección determina para qué es bueno un modelo: los encoders leen, los decoders escriben y los encoder-decoder mapean una secuencia a otra.
| Familia | Qué conserva | Atención | Tarea de preentrenamiento | Usos típicos | Ejemplos |
|---|---|---|---|---|---|
| Solo encoder | Pila de encoders | Bidireccional: cada token ve a todos los tokens | Rellenar tokens enmascarados | Clasificación, embeddings para búsqueda, reconocimiento de entidades | BERT, RoBERTa |
| Solo decoder | Pila de decoders, sin cross-attention | Causal: cada token ve solo los anteriores | Predecir el siguiente token | Chat, generación de código, agentes | GPT-3, Llama, Gemini |
| Encoder-decoder | Ambas pilas | Encoder bidireccional, decoder causal, más cross-attention | Mapear una secuencia de entrada a otra de salida | Traducción, resumen, reconocimiento de voz | Transformer original, T5, Whisper |
La mayoría de LLM publicados desde GPT-3 son solo decoder. La predicción del siguiente token sirve para cualquier texto crudo, así que hay abundancia de datos de entrenamiento, y un único modelo puede manejar traducción, resumen y preguntas-respuestas tratándolos como continuación de texto.
¿Qué modelos usan la arquitectura Transformer?
BERT
BERT (Bidirectional Encoder Representations from Transformers), publicado como código abierto por Google en 2018, es un transformer solo con encoder. En lugar de predecir la siguiente palabra, se preentrenó para rellenar palabras enmascaradas usando el contexto a ambos lados, lo que lo hizo mejor en comprensión que los modelos izquierda-a-derecha de la época.
Al entender el contexto desde todos los lados de una palabra, BERT superó a modelos previos en tareas como preguntas-respuestas y desambiguación. Su núcleo usa transformers, conectando dinámicamente cada elemento de entrada y salida.
BERT se preentrenó en la Wikipedia en inglés y el conjunto BooksCorpus, y Google lo incorporó a Search en 2019 para interpretar mejor las consultas en lenguaje natural. Desató una carrera por construir modelos de lenguaje preentrenados más grandes.
Para saber más sobre BERT, puedes consultar nuestro artículo aparte que introduce el modelo BERT.
LaMDA
LaMDA (Language Model for Dialogue Applications) es un modelo basado en Transformer desarrollado por Google, diseñado específicamente para tareas conversacionales y presentado en el Google I/O de 2021. Está pensado para generar respuestas más naturales y contextuales, mejorando la interacción en múltiples aplicaciones.
El diseño de LaMDA le permite comprender y responder sobre una amplia variedad de temas e intenciones, lo que lo hace ideal para chatbots, asistentes virtuales y otros sistemas de IA interactivos donde la conversación dinámica es clave.
Google sustituyó más tarde LaMDA en su chatbot Bard por PaLM 2 y después por Gemini, pero LaMDA fue uno de los primeros transformers entrenados específicamente para diálogo.
Si te interesa entender mejor LaMDA, puedes profundizar con nuestro artículo sobre LaMDA.
GPT y ChatGPT
GPT y ChatGPT, desarrollados por OpenAI, son modelos generativos avanzados conocidos por producir texto coherente y contextual. GPT-1 fue el primer modelo, lanzado en junio de 2018, y GPT-3, uno de los más influyentes, llegó en 2020.
Estos modelos dominan multitud de tareas, como creación de contenidos, conversación, traducción y más. La arquitectura de GPT le permite generar texto muy similar al humano, útil en redacción creativa, soporte al cliente e incluso ayuda para programar. ChatGPT, una variante optimizada para la conversación, destaca en diálogos naturales, lo que potencia su uso en chatbots y asistentes virtuales.
OpenAI dejó de publicar detalles de arquitectura después de GPT-3 (salvo sus modelos de pesos abiertos gpt-oss), pero la familia ha seguido creciendo, recientemente con GPT-6 Astra en 2026.
Claude
Claude, desarrollado por Anthropic, es una familia de asistentes de IA basados en Transformer con foco en seguridad y utilidad. Claude emplea Constitutional AI (CAI), un enfoque de entrenamiento guiado por principios para producir respuestas útiles, inocuas y honestas.
Claude 3 (2024) introdujo tres niveles de modelo, Haiku, Sonnet y Opus, que equilibran velocidad y capacidad. Destacan en razonamiento matizado, seguimiento de instrucciones complejas y mantenimiento de contexto en conversaciones largas (hasta 200K tokens).
Anthropic ha lanzado nuevas generaciones cada pocos meses desde entonces. La gama Claude 5 actual incluye Claude Fable 5.1 y Claude Opus 5.5, ambas de 2026. Al igual que OpenAI, Anthropic no publica los detalles de su arquitectura.
Otras variantes
El número de modelos transformer ha crecido rápidamente. El catálogo de modelos transformer de Xavier Amatriain clasifica decenas por arquitectura y objetivo de entrenamiento, y el benchmark HELM de Stanford evaluó en paralelo 30 modelos de lenguaje destacados.
Cada vez hay más tendencia a abrir estos modelos, con plataformas como el hub de modelos de Hugging Face a la cabeza. Además, se han desarrollado numerosos modelos basados en Transformer especializados en distintas tareas de PLN, lo que demuestra su versatilidad y eficiencia en aplicaciones diversas.
Puedes saber más sobre los Foundation Models en un artículo aparte, donde explicamos qué son y cuáles se usan más.
¿Cómo han cambiado los transformers desde 2017?
Desde la arquitectura original de 2017, los transformers han evolucionado mucho para superar limitaciones y expandirse a nuevos dominios.
En qué difieren los LLM modernos del Transformer original
Los LLM de pesos abiertos actuales siguen el plano de 2017, pero casi cada componente se ha sustituido por variantes que entrenan con más estabilidad o se ejecutan con menor coste. Meta documenta la mayoría de estos cambios en sus papers de LLaMA y Llama 3:
| Componente | Transformer original (2017) | LLM típico de pesos abiertos hoy |
|---|---|---|
| Arquitectura | Encoder-decoder, 6 + 6 capas | Solo decoder, de 32 capas (Llama 3 8B) a 126 capas (Llama 3 405B) |
| Ancho del modelo | 512 | 4.096 (Llama 3 8B) a 16.384 (Llama 3 405B) |
| Información posicional | Codificaciones seno y coseno fijas añadidas a los embeddings | Rotary position embeddings (RoPE) aplicadas dentro de la atención |
| Normalización | LayerNorm después de cada subcapa (post-norm) | RMSNorm antes de cada subcapa (pre-norm) |
| Activación feed-forward | ReLU | SwiGLU |
| Cabezas de atención | Atención multi-cabeza, 8 cabezas | Grouped-query attention: varias cabezas de query comparten 1 cabeza de key-value (8 key-value heads en Llama 3) |
| Capa feed-forward | Densa | Densa o mixture of experts (Llama 4, DeepSeek-V3) |
Vision Transformers (ViT)
Vision Transformers aplican self-attention a imágenes dividiéndolas en patches y tratando cada patch como un token. Este enfoque es muy eficaz para clasificación, detección y generación de imágenes, y a menudo supera a las CNN tradicionales en datasets grandes.
Transformers multimodales
Modelos modernos como GPT-5, Gemini 3 y Llama 4 procesan varios tipos de entrada (texto, imágenes, audio, vídeo) en una sola arquitectura. Estos transformers multimodales usan espacios de embedding unificados y mecanismos de cross-attention para razonar entre modalidades de forma simultánea.
Transformers eficientes
La complejidad cuadrática de la self-attention limita la longitud de contexto. Varias innovaciones lo abordan:
- Flash Attention: Calcula atención exacta en bloques que caben en la memoria rápida on-chip de la GPU, de modo que el uso de memoria crece linealmente con la secuencia en lugar de cuadráticamente
- Rotary Position Embeddings (RoPE): Codifican la posición con matrices de rotación, facilitando la extrapolación a secuencias más largas
- Atención lineal y dispersa: Linformer y Performer aproximan la atención, y Longformer limita la mayoría de tokens a una ventana local, llevando el coste a O(n) para documentos muy largos
- Mixture of Experts (MoE): Activa solo un subconjunto de parámetros por token, permitiendo modelos mayores con costes similares de cómputo
Transformers vs. RNN y CNN
Los transformers suelen compararse con otros dos bloques de redes neuronales: capas recurrentes (RNN) y capas convolucionales (CNN). Cada uno se adapta a un tipo de datos distinto.
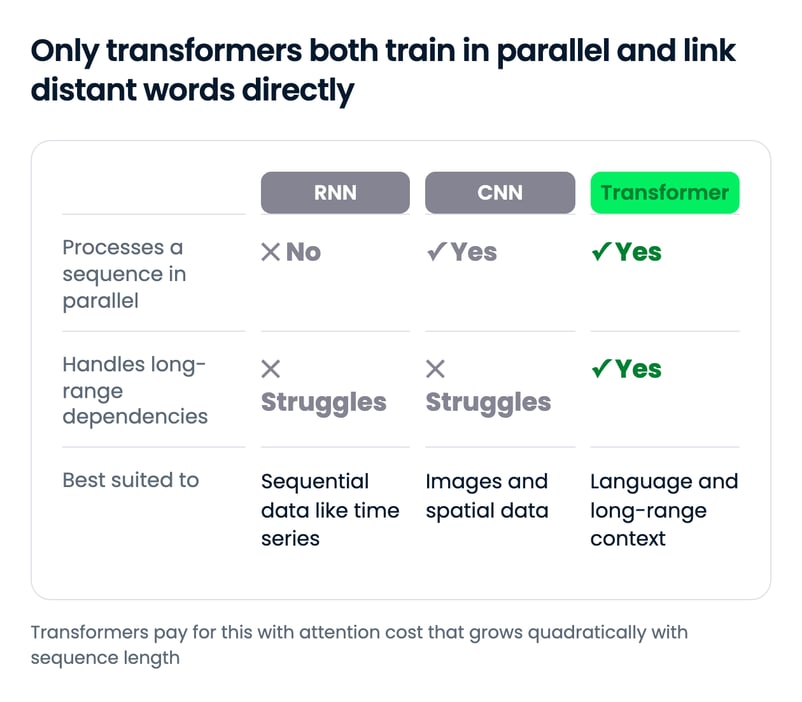
Capas recurrentes
Las capas recurrentes, piedra angular de las RNN, destacan con datos secuenciales. Su fortaleza está en operar de forma secuencial, crucial en tareas como lenguaje o series temporales. La salida del paso anterior vuelve a entrar como entrada en el siguiente. Este bucle permite “recordar” información previa, vital para entender el contexto.
Sin embargo, como ya vimos, este procesamiento secuencial tiene dos implicaciones principales:
- Entrenamientos más largos, ya que cada paso depende del anterior, dificultando el paralelismo.
- Dificultad con dependencias a largo plazo por el problema del gradiente que se desvanece.
Los transformers difieren radicalmente porque carecen de recurrencia. Como vimos, la capa de atención del Transformer aborda ambos problemas, lo que los convierte en la evolución natural de las RNN para aplicaciones de PLN.
Capas convolucionales
Por su parte, las capas convolucionales, base de las CNN, son muy eficientes con datos espaciales como imágenes.
Usan kernels (filtros) que recorren la entrada para extraer rasgos. La anchura de estos kernels se ajusta para centrarse en rasgos más pequeños o grandes según la tarea.
Aunque son excelentes captando jerarquías y patrones espaciales, tienen dificultades con dependencias a largo plazo. No contemplan de forma inherente la información secuencial, por lo que son menos adecuadas para tareas que requieren entender el orden o el contexto.
Por eso las CNN y los transformers se orientan a datos y tareas distintos. Las CNN dominan la visión por su eficiencia con información espacial, mientras que los transformers son la opción preferida para tareas secuenciales complejas, especialmente en PLN, por su capacidad para entender dependencias de largo alcance.
Limitaciones de los transformers
A pesar de su éxito, los transformers tienen limitaciones notables:
- Complejidad cuadrática: La self-attention escala como O(n²) con la longitud de la secuencia, lo que hace caros en cómputo y memoria los contextos largos
- Requisitos de memoria: Los modelos grandes exigen mucha memoria de GPU, lo que limita su despliegue
- Datos de entrenamiento: Suelen necesitar datasets masivos para rendir bien
- Alucinaciones: Predicen tokens probables, no consultan hechos, por lo que pueden afirmar con seguridad información falsa. Los modelos de razonamiento lo reducen pero no lo eliminan
- Limitaciones posicionales: Las codificaciones posicionales estándar generalizan mal a longitudes no vistas en entrenamiento
La investigación sigue abordando estas limitaciones con innovaciones como Flash Attention, mixture-of-experts y generación aumentada con recuperación (RAG).
Reflexiones finales
Un transformer funciona dejando que cada token mire a todos los demás mediante self-attention y refinando esas representaciones con una pila de capas idénticas. Esta decisión de diseño permitió entrenar en paralelo en GPU y resolvió el problema de memoria a largo plazo que frenaba a las RNN.
Lo más llamativo es lo poco que ha cambiado el núcleo. Un LLM de 2026 cambia la codificación posicional, la normalización y las cabezas de atención por variantes más baratas, pero el diagrama de 2017 sigue siendo reconocible. La incógnita es si los modelos de espacio de estados e híbridos dominarán los contextos largos o si kernels como FlashAttention mantendrán asumible el coste cuadrático de la atención.
Para llevarlo a la práctica, construye un Transformer con PyTorch en nuestro tutorial paso a paso, o empieza con modelos preentrenados en nuestra introducción a Transformers y Hugging Face. Si quieres aprender más, te recomiendo el curso Transformer Models with PyTorch o el itinerario Developing Large Language Models para la ruta completa.
FAQs
¿Cómo funciona la arquitectura Transformer?
Un transformer divide el texto en tokens, convierte cada token en un embedding y añade información posicional. Luego, una pila de capas aplica self-attention multi-cabeza, que permite que cada token pese a todos los demás, seguida de una red feed-forward, con conexiones residuales y normalización alrededor de cada paso. Una última capa lineal y un softmax producen probabilidades para el siguiente token.
¿Cuál es la diferencia entre transformers solo encoder, solo decoder y encoder-decoder?
Los modelos solo con encoder como BERT leen toda la entrada de forma bidireccional y son adecuados para clasificación y búsqueda. Los modelos solo con decoder como GPT y Llama solo ven tokens anteriores y se entrenan para predecir el siguiente, por lo que son el diseño estándar para LLM conversacionales. Los modelos encoder-decoder como T5 y el Transformer original mapean una secuencia de entrada a otra de salida, como en traducción.
¿Por qué los transformers sustituyeron a las RNN y LSTM?
Las RNN y LSTM procesan los tokens uno a uno, lo que ralentiza el entrenamiento en GPU y deja que la información se pierda en secuencias largas. La self-attention conecta cada token directamente con los demás y procesa toda la secuencia en paralelo, por lo que los transformers entrenan más rápido y gestionan mejor las dependencias de largo alcance.
¿ChatGPT es un transformer?
Sí. GPT significa Generative Pre-trained Transformer, y los modelos GPT detrás de ChatGPT son transformers solo con decoder entrenados para predecir el siguiente token. OpenAI no publica detalles de arquitectura desde GPT-3, pero todos los GPT se basan en el diseño transformer.
¿Cuáles son las principales limitaciones de los transformers?
El coste de la self-attention crece cuadráticamente con la longitud de la secuencia, así que las ventanas de contexto largas son caras en cómputo y memoria. Los transformers también requieren grandes datasets de entrenamiento y pueden “alucinar”, afirmando con seguridad información falsa. Técnicas como FlashAttention, grouped-query attention, mixture of experts y los híbridos con modelos de espacio de estados atacan estos costes.

Josep es Científico de Datos y Gestor de Proyectos en la Agencia Catalana de Turismo, utilizando datos para mejorar la experiencia de los turistas en Cataluña. Su experiencia incluye la gestión del almacenamiento y procesamiento de datos, junto con la analítica avanzada y la comunicación eficaz de las perspectivas de los datos.
También es un dedicado educador, que imparte clases en el Máster de Big Data de la Universidad de Navarra, y contribuye regularmente con artículos perspicaces sobre ciencia de datos en Medium y KDNuggets.
Es Licenciado en Ingeniería Física por la Universidad Politécnica de Cataluña y Máster en Sistemas Interactivos Inteligentes por la Universidad Pompeu Fabra.
En la actualidad, se dedica con pasión a hacer que las tecnologías relacionadas con los datos sean más accesibles a un público más amplio a través de la publicación de Medium ForCode'Sake.







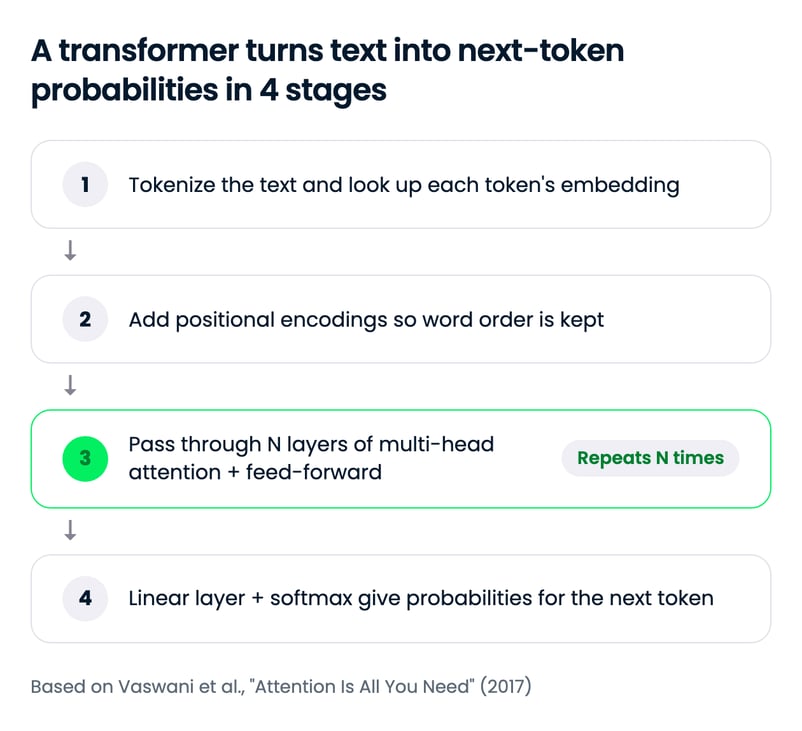
Un transformer es una red neuronal que lee todos los tokens de una secuencia a la vez y usa self-attention para decidir cuánto debe apoyarse cada token en los demás. Investigadores de Google lo presentaron en 2017 en el paper “Attention Is All You Need”, y hoy es la base de casi todos los grandes modelos de lenguaje (LLM), desde GPT y Llama hasta Gemini.
La arquitectura funciona en 4 etapas. El texto se divide en tokens y se mapea a embeddings; se añade información posicional; una pila de capas alterna self-attention multi-cabeza con redes feed-forward (cada una envuelta en una conexión residual y normalización); y una última capa lineal con softmax convierte el vector final en probabilidades sobre el vocabulario. El modelo original emparejaba un encoder con un decoder; la mayoría de LLM actuales conservan solo el decoder.
En este tutorial, recorreré cada etapa del diseño original encoder-decoder y luego mostraré cómo BERT, GPT y los LLM actuales lo han modificado. Si prefieres empezar por la intuición, lee primero nuestras guías sobre el mecanismo de atención y la self-attention.
Resumen