

Was sind Transformer?
Transformer wurden ursprünglich entwickelt, um das Problem der Sequenztransduktion bzw. des Neural Machine Translation zu lösen – also Aufgaben, bei denen eine Eingabesequenz in eine Ausgabesequenz überführt wird. Daher der Name “Transformer”.
Aber fangen wir vorne an.
Eine einfache Definition
Ein Transformer-Modell ist ein neuronales Netz, das den Kontext sequenzieller Daten lernt und daraus neue Daten generiert.
Ganz einfach gesagt:
Ein Transformer ist ein KI-Modell, das durch das Analysieren von Mustern in großen Textmengen lernt, menschenähnlichen Text zu verstehen und zu erzeugen.
Transformer sind der aktuelle State of the Art in NLP und gelten als Weiterentwicklung der Encoder-Decoder-Architektur. Während klassische Encoder-Decoder-Modelle jedoch vor allem auf Rekurrenten Neuronalen Netzen (RNNs) beruhen, verzichten Transformer vollständig auf diese Rekurrenz.
Wie machen sie das?
Sie sind so konstruiert, dass sie Kontext und Bedeutung über die Beziehungen zwischen Elementen erfassen – nahezu vollständig mittels eines mathematischen Verfahrens namens Attention.
Bild: Autor.
Historischer Kontext
Transformer wurden von Google-Forschenden im Paper "Attention is All You Need" (2017) vorgestellt. Der Code erschien in TensorFlows Tensor2Tensor-Paket, die Harvard NLP Group folgte mit einem annotierten Leitfaden in PyTorch. In unserem separaten Tutorial lernst du auch, einen Transformer from scratch zu implementieren.
Binnen eines Jahres zeigten Googles BERT und OpenAIs GPT-1, dass ein auf unlabeled Text vortrainierter Transformer für nahezu jede Sprachaufgabe feinjustiert werden kann. GPT-3 folgte 2020, und Forschende der Stanford University prägten für diese neue Modellklasse den Begriff “Foundation Models”.
Seitdem ging es rasant weiter: Open-Weight-Modelle wie Metas Llama (2023), multimodale Modelle wie GPT-4o (2024), Reasoning-Modelle wie OpenAIs o1 und DeepSeek-R1 (Ende 2024 bis Anfang 2025) sowie agentische Modelle wie GPT-5 (2025) und GPT-6 Astra (2026). Die öffentlich dokumentierten Designs basieren weiterhin auf Transformern. Die ganze Geschichte findest du in unserer Historie der Large Language Models.
Der Wechsel von RNNs zu Transformern
Als der Transformer vorgestellt wurde, waren Recurrent Neural Networks (RNNs) und ihre Variante Long Short-Term Memory (LSTM) die Standardmodelle für Sequenzen. Sie verarbeiten Eingaben Element für Element – mit zwei Hauptproblemen:
- Langsames Training: Jeder Schritt wartet auf den vorherigen, daher lassen sich RNNs nicht gut auf GPUs parallelisieren.
- Vergessen über große Distanzen: Information wandert Schritt für Schritt; je länger die Kette, desto eher geht sie verloren.
Transformer behielten die Encoder-Decoder-Idee der RNNs, ersetzten die Rekurrenz aber durch Attention – und lösten damit beide Probleme: Jedes Wort kann direkt auf jedes andere achten, egal wie weit entfernt, und die gesamte Sequenz wird parallel verarbeitet.
Als Nächstes schauen wir uns an, wie Transformer im Detail arbeiten.
Wie funktioniert die Transformer-Architektur?
Ursprünglich für Sequenztransduktion bzw. Neural Machine Translation entwickelt, glänzen Transformer darin, Eingabesequenzen in Ausgabesequenzen zu überführen. Es ist das erste Transduktionsmodell, das vollständig auf Self-Attention setzt, um Repräsentationen von Ein- und Ausgabe ohne sequenzalignierte RNNs oder Convolutions zu berechnen. Das zentrale Merkmal der Transformer-Architektur ist die Beibehaltung des Encoder-Decoder-Modells.
Als Black Box für Übersetzung betrachtet, nimmt ein Transformer etwa einen englischen Satz als Input und gibt seine spanische Übersetzung aus.
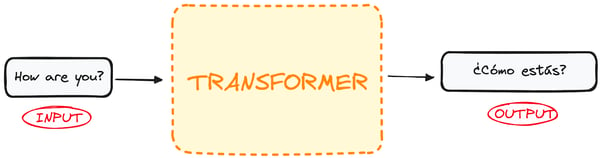
Bild: Autor.
Ein Blick hinein zeigt zwei Hauptkomponenten:
- Der Encoder nimmt den Input auf und erzeugt eine Matrixrepräsentation davon. Zum Beispiel den englischen Satz “How are you?”
- Der Decoder nimmt diese codierte Repräsentation und generiert iterativ den Output. In unserem Beispiel die Übersetzung “¿Cómo estás?”
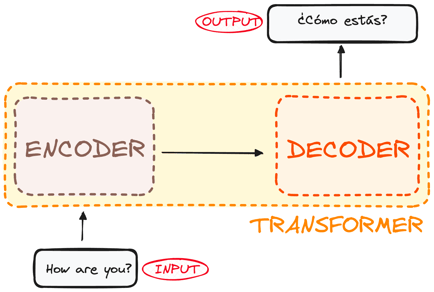
Bild: Autor. Globale Struktur von Encoder-Decoder.
Sowohl Encoder als auch Decoder bestehen tatsächlich aus einem Stapel mehrerer Schichten (mit gleicher Anzahl). Alle Encoder haben die gleiche Struktur; der Input wandert durch jeden von ihnen nach oben. Alle Decoder sind ebenfalls gleich aufgebaut und erhalten Input vom letzten Encoder und vom vorherigen Decoder.
Das Original nutzte 6 Encoder und 6 Decoder, aber wir können so viele Schichten stapeln, wie wir möchten. Nimm also N Schichten je Stapel an.
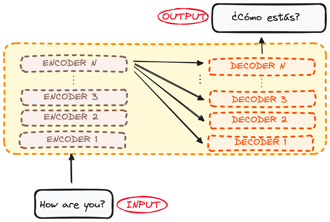
Bild: Autor. Globale Struktur von Encoder-Decoder. Mehrere Schichten.
Mit diesem Überblick fokussieren wir nun Encoder und Decoder, um ihren Ablauf besser zu verstehen:
Wie funktioniert der Transformer-Encoder?
Der Encoder ist ein zentrales Bauteil der Transformer-Architektur. Seine Hauptfunktion ist es, Eingabe-Tokens in kontextualisierte Repräsentationen zu überführen. Anders als frühere Modelle, die Tokens unabhängig behandelten, erfasst der Transformer-Encoder den Kontext jedes Tokens relativ zur gesamten Sequenz.
Seine Struktur setzt sich wie folgt zusammen:
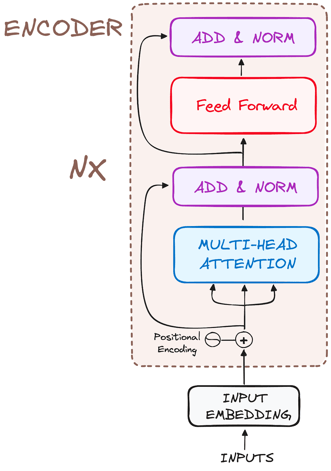
Bild: Autor. Globale Struktur der Encoder.
Zerlegen wir den Ablauf in die Basisschritte:
Schritt 1: Input-Embeddings
Das Embedding passiert nur im untersten Encoder. Zuerst zerlegt ein Tokenizer den Text in Tokens – Wörter oder Wortteile – und jedes Token wird einem gelernten Vektor, einem Embedding, zugeordnet. Tokens mit ähnlicher Bedeutung erhalten ähnliche Vektoren.
Alle Encoder bekommen eine Liste von Vektoren, im Original jeweils 512-dimensional (dmodel = 512). Im unteren Encoder sind das die Wort-Embeddings, in höheren Encodern ist es die Ausgabe des jeweils darunterliegenden Encoders.
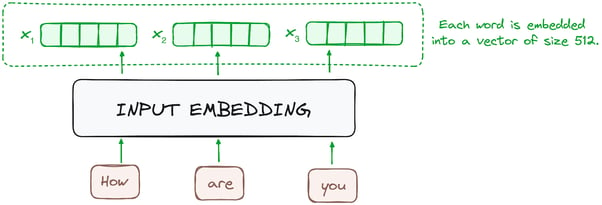
Bild: Autor. Encoder-Ablauf. Input-Embedding.
Schritt 2: Positionale Codierung
Da Transformer – anders als RNNs – keine Rekurrenz besitzen, fügen sie den Eingabe-Embeddings Positionscodierungen hinzu, um die Position jedes Tokens in der Sequenz abbilden zu können. So verstehen sie die Wortreihenfolge im Satz.
Vorgeschlagen wurde eine Kombination verschiedener Sinus- und Kosinusfunktionen zur Erzeugung von Positionsvektoren, sodass sich der Encoder für Sätze beliebiger Länge einsetzen lässt.
Jede Dimension trägt dabei eigene Frequenzen und Phasenlagen; die Werte liegen zwischen -1 und 1 und repräsentieren effektiv jede Position.
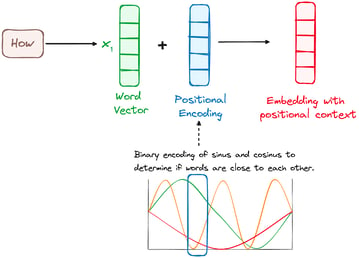
Bild: Autor. Encoder-Ablauf. Positionscodierung.
Schritt 3: Stapel von Encoder-Schichten
Der Transformer-Encoder besteht aus einem Stapel identischer Schichten (6 im Originalmodell).
Die Encoderschicht transformiert die Eingabesequenzen in eine kontinuierliche, abstrakte Repräsentation, die das Gelernte aus der gesamten Sequenz bündelt. Sie umfasst zwei Submodule:
- Ein Multi-Head-Attention-Mechanismus.
- Ein vollständig verbundenes Netzwerk.
Zusätzlich gibt es Residual Connections um jedes Sublayer, gefolgt von Layer-Normalisierung.
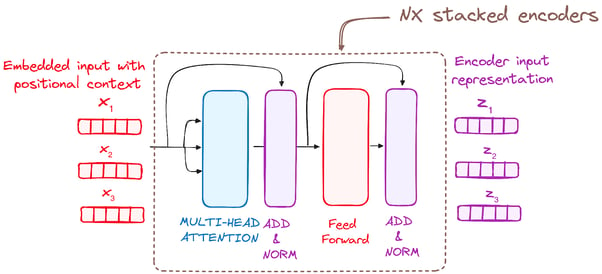
Bild: Autor. Encoder-Ablauf. Stapel von Encoder-Schichten
Schritt 3.1: Multi-Head-Self-Attention
Im Encoder nutzt die Multi-Head-Attention Self-Attention. Sie erlaubt es, jedes Wort im Input mit anderen Wörtern zu verknüpfen. So kann das Modell etwa “are” mit “you” in Beziehung setzen.
Der Mechanismus berechnet Aufmerksamkeitswerte basierend auf:
- Query: ein Vektor, der im Attention-Mechanismus ein bestimmtes Token repräsentiert.
- Key: ebenfalls ein Vektor im Attention-Mechanismus, korrespondierend zu jedem Token im Input.
- Value: dem zum Key gehörenden Vektor, der in die Ausgabe der Attention-Schicht einfließt. Stimmen Query und Key stark überein (hoher Score), wird das zugehörige Value im Output betont.
Dieses erste Self-Attention-Modul erfasst Kontext über die gesamte Sequenz. Statt nur eine Attention auszuführen, werden Queries, Keys und Values h-mal linear projiziert. Auf jeder Projektion wird die Attention parallel berechnet und liefert je einen Output der Dimension dv (64 im Original bei h = 8).
Die Details sehen so aus:
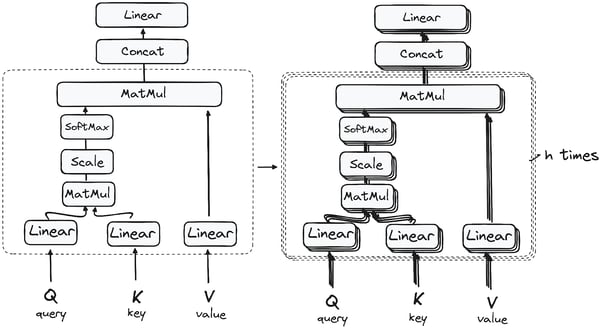
Matrixmultiplikation (MatMul): Skalarprodukt von Query und Key
Nach den linearen Projektionen von Query, Key und Value wird das Skalarprodukt zwischen Queries und Keys berechnet; das ergibt eine Score-Matrix.
Diese Score-Matrix legt fest, wie stark jedes Wort auf andere Wörter achten soll. Jedes Wort bekommt pro Zeitstufe Scores zu allen anderen. Hohe Scores bedeuten mehr Fokus.
So werden Queries effektiv ihren passenden Keys zugeordnet.
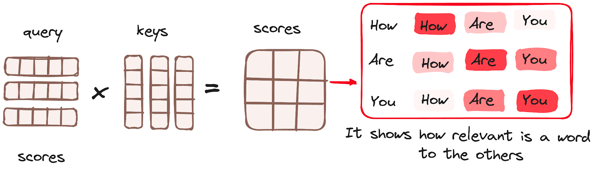
Bild: Autor. Encoder-Ablauf. Attention – Matrixmultiplikation.
Skalieren der Aufmerksamkeitswerte
Anschließend werden die Scores durch die Quadratwurzel der Dimension von Query/Key geteilt. Das stabilisiert die Gradienten, da große Werte sonst zu übermäßigen Effekten führen können.
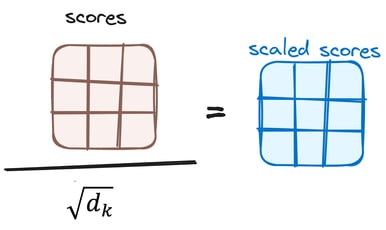
Bild: Autor. Encoder-Ablauf. Reduktion der Attention-Scores.
Softmax auf die angepassten Scores anwenden
Dann wird Softmax auf die angepassten Scores angewandt, um Attention-Gewichte zu erhalten – Wahrscheinlichkeiten zwischen 0 und 1. Softmax hebt hohe Scores hervor und dämpft niedrige, wodurch das Modell besser festlegt, welche Wörter wichtiger sind.
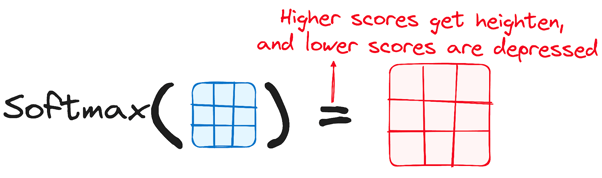
Bild: Autor. Encoder-Ablauf. Softmax der angepassten Scores.
Softmax-Ergebnis mit dem Value-Vektor kombinieren
Die Softmax-Gewichte werden mit den Value-Vektoren multipliziert und ergeben den Output-Vektor.
Wörter mit hohen Gewichten dominieren das Ergebnis, Wörter nahe 0 tragen kaum bei. Anschließend geht der Output in eine lineare Schicht.
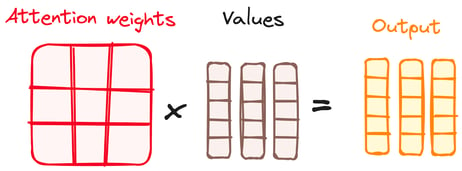
Bild: Autor. Encoder-Ablauf. Softmax-Ergebnis mit Value kombinieren.
Damit liegt der Output der Attention vor.
“Multi-Head” bedeutet, dass dieser Prozess mehrfach parallel läuft. Vor der Attention werden Queries, Keys und Values in h Köpfe (Heads) aufgeteilt; jeder Head führt die Schritte auf seinem Teilvektor aus.
Die Head-Outputs werden konkateniert und durch eine finale lineare Schicht geschickt. Da jeder Head eigene Projektionen lernt, können unterschiedliche Heads verschiedene Beziehungen erfassen – etwa, auf welches Nomen sich ein Pronomen bezieht oder welche Wörter nebeneinander stehen.
Für ein tieferes Verständnis lies unser Tutorial zu Multi-Head-Attention in Transformern.
Schritt 3.2: Normalisierung und Residual Connections
Auf jedes Sublayer in einer Encoderschicht folgt eine Normalisierung. Außerdem wird der Output jedes Sublayers zu seinem Input addiert (Residual Connection), um das Vanishing-Gradient-Problem zu entschärfen und tiefere Modelle zu ermöglichen. Nach dem Feed-forward-Netz passiert dasselbe.
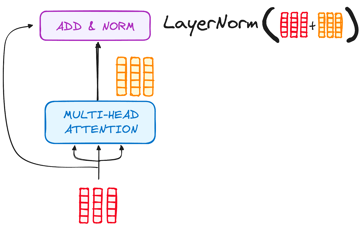
Bild: Autor. Encoder-Ablauf. Normalisierung und Residual nach Multi-Head-Attention.
Schritt 3.3: Feed-forward-Neuronales Netz
Als Nächstes durchläuft der Output ein positionsweises Feed-forward-Netz: zwei lineare Schichten mit einer ReLU-Aktivierung dazwischen, separat auf jedes Token angewandt. Im Original hat die innere Schicht 2.048 Dimensionen, also das Vierfache der Modellbreite 512.
Wie bei der Attention wird der Input des Netzes wieder zum Output addiert (Residual Connection) und das Ergebnis normalisiert.
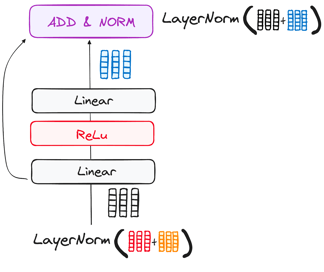
Bild: Autor. Encoder-Ablauf. Feed-forward-Subschicht.
Schritt 4: Encoder-Ausgabe
Die Ausgabe der letzten Encoderschicht ist ein Satz von Vektoren, die die Eingabesequenz mit reichhaltigem Kontextverständnis repräsentieren. Diese Ausgabe dient als Input für den Decoder.
Diese saubere Kodierung weist den Decoder darauf hin, beim Decodieren die richtigen Stellen im Input zu beachten.
N übereinandergestapelte Encoderschichten bauen jeweils auf den Repräsentationen der darunterliegenden auf. Das Original nutzte N = 6; BERT-Base verwendet 12, BERT-Large 24.
Wie funktioniert der Transformer-Decoder?
Der Decoder erzeugt die Ausgabesequenz. Seine Schichten spiegeln die des Encoders mit einer Ergänzung: Jede Schicht besitzt zwei Multi-Head-Attention-Sublayer statt einem, gefolgt von einem positionsweisen Feed-forward-Netz, jeweils mit Residual Connection und Layer-Normalisierung um jedes Sublayer.
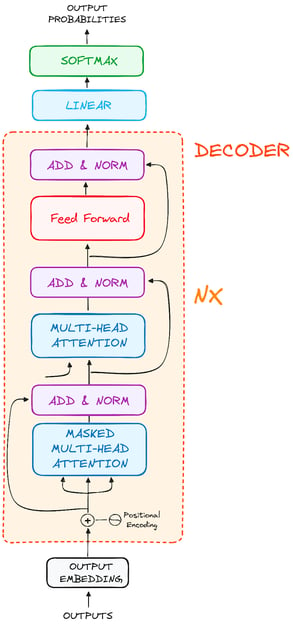
Bild: Autor. Globale Struktur der Decoder.
Die Komponenten funktionieren ähnlich wie im Encoder, mit einem Twist: Jede Multi-Head-Attention im Decoder hat ihre eigene Aufgabe.
Am Ende des Decoders steht eine lineare Schicht als Klassifikator, gefolgt von Softmax, um Wortwahrscheinlichkeiten zu berechnen.
Der Transformer-Decoder ist speziell darauf ausgelegt, die Ausgabe zu erzeugen, indem er die kodierte Information schrittweise dekodiert.
Der Decoder arbeitet autoregressiv: Er startet mit einem Start-of-Sequence-Token und nimmt bei jedem Schritt die bisher generierten Tokens zusammen mit der Encoder-Ausgabe als Input.
Er stoppt, wenn ein End-of-Sequence-Token erzeugt wird.
Schritt 1: Output-Embeddings
Am Anfang des Decoders läuft es wie beim Encoder: Der Input geht zunächst durch eine Embedding-Schicht.
Schritt 2: Positionale Codierung
Nach dem Embedding folgt – wie beim Encoder – die Positionscodierung. Dadurch entstehen positionsspezifische Embeddings.
Diese Positions-Embeddings gehen in die erste Multi-Head-Attention des Decoders, wo die Attention-Scores für den Decoder-Input berechnet werden.
Schritt 3: Stapel von Decoder-Schichten
Der Decoder besteht aus einem Stapel identischer Schichten (6 im Original). Jede Schicht hat drei Hauptkomponenten:
Schritt 3.1: Maskierte Self-Attention
Das ist Self-Attention wie im Encoder, jedoch mit einer entscheidenden Einschränkung: Positionen dürfen nicht auf spätere Positionen achten. Jedes Wort darf also nicht von künftigen Tokens beeinflusst werden.
Wenn etwa die Attention-Scores für “Cómo” berechnet werden, darf “Cómo” keinen Blick auf “estás” werfen, ein späteres Wort der Ausgabesequenz.
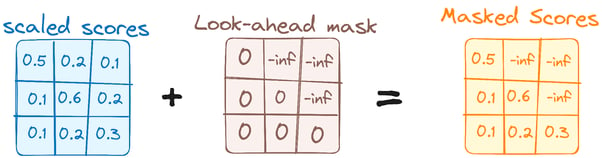
Bild: Autor. Decoder-Ablauf. Erste maskierte Multi-Head-Attention.
Dieses Maskieren stellt sicher, dass Vorhersagen an einer Position nur von bekannten Outputs früherer Positionen abhängen.
Schritt 3.2: Encoder-Decoder-Attention (Cross-Attention)
Das zweite Attention-Sublayer verbindet den Decoder mit dem Encoder. Hier kommen die Queries aus der maskierten Self-Attention des Decoders, Keys und Values aus der finalen Encoder-Ausgabe.
So kann jede Decoder-Position über alle Positionen des Eingabesatzes aufmerksam sein – beim Erzeugen von “estás” kann sich der Decoder etwa auf “are you” fokussieren. Danach folgt das Feed-forward-Sublayer.
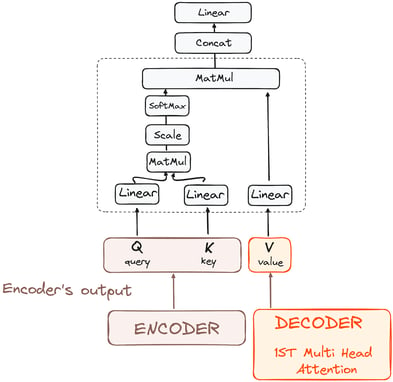
Bild: Autor. Decoder-Ablauf. Encoder-Decoder-Attention.
Schritt 3.3: Feed-forward-Neuronales Netz
Wie im Encoder enthält jede Decoderschicht ein vollständig verbundenes Feed-forward-Netz, positionsweise identisch angewandt.
Schritt 4: Lineare Klassifikation und Softmax
Am Ende durchläuft die Darstellung eine letzte lineare Schicht als Klassifikator.
Deren Größe entspricht der Anzahl der Klassen (Wörter im Vokabular). Bei 1000 Wörtern liefert der Klassifikator z. B. ein Array mit 1000 Elementen.
Darauf folgt Softmax, das die Werte in Wahrscheinlichkeiten zwischen 0 und 1 umwandelt. Das Token mit der höchsten Wahrscheinlichkeit ist die beste Schätzung für das nächste Wort. Greedy Decoding wählt es immer; die meisten Chat-Modelle sampeln stattdessen aus der Verteilung, mit einer Temperatur, die den Zufallsgrad steuert.
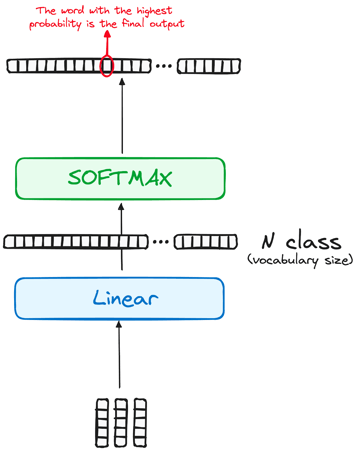
Bild: Autor. Decoder-Ablauf. Finale Ausgabe.
Normalisierung und Residual Connections
Jedes Sublayer (maskierte Self-Attention, Encoder-Decoder-Attention, Feed-forward) wird normalisiert und hat eine Residual Connection.
Decoder-Ausgabe
Die Ausgabe der letzten Schicht wird zu einer vorhergesagten Sequenz transformiert – typischerweise via linearer Schicht und Softmax über dem Vokabular.
Im Betrieb fügt der Decoder die neu generierten Tokens seiner wachsenden Eingabeliste hinzu und dekodiert weiter. Der Zyklus endet, wenn ein spezielles Token das Ende signalisiert.
Wie der Encoder ist auch der Decoder ein Stapel aus N identischen Schichten (6 im Original), die aufeinander sowie auf der Encoder-Ausgabe aufbauen. Größere Tiefe erlaubt es, unterschiedliche Aufmerksamkeitsmuster einzufangen.
Die finale Architektur sieht so aus (aus dem Originalpaper):
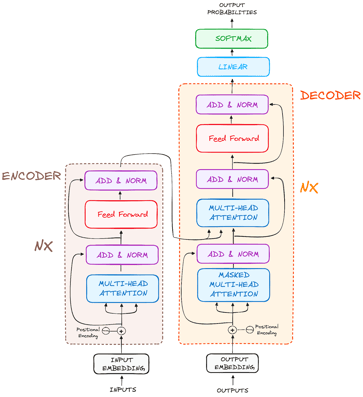
Bild: Autor. Originalstruktur von Transformern.
Um das besser zu verinnerlichen, empfehle ich, einem Transformer mit PyTorch from scratch zu bauen.
Encoder-only, Decoder-only und Encoder-Decoder-Transformer
Transformer-Modelle fallen in drei Familien – je nachdem, welche Hälfte der ursprünglichen Architektur sie behalten. Das entscheidet, worin ein Modell stark ist: Encoder lesen, Decoder schreiben, Encoder-Decoder ordnen Sequenzen einander zu.
| Familie | Behalten | Attention | Pretraining-Aufgabe | Typische Einsätze | Beispiele |
|---|---|---|---|---|---|
| Encoder-only | Encoder-Stapel | Bidirektional: Jedes Token sieht jedes Token | Maskierte Tokens auffüllen | Klassifikation, Such-Embeddings, Named Entity Recognition | BERT, RoBERTa |
| Decoder-only | Decoder-Stapel ohne Cross-Attention | Kausal: Jedes Token sieht nur frühere Tokens | Nächstes Token vorhersagen | Chat, Codegenerierung, Agents | GPT-3, Llama, Gemini |
| Encoder-Decoder | Beide Stapel | Bidirektionaler Encoder, kausaler Decoder, plus Cross-Attention | Eingabesequenz auf Ausgabesequenz abbilden | Übersetzung, Zusammenfassung, Spracherkennung | Originaler Transformer, T5, Whisper |
Die meisten seit GPT-3 veröffentlichten LLMs sind Decoder-only. Next-Token-Prediction funktioniert auf rohem Text, daher ist viel Trainingsdaten verfügbar – und ein einziges Modell kann Übersetzung, Zusammenfassung und Q&A als Textfortsetzung behandeln.
Welche Modelle nutzen die Transformer-Architektur?
BERT
BERT (Bidirectional Encoder Representations from Transformers), 2018 von Google als Open Source veröffentlicht, ist ein Encoder-only-Transformer. Statt das nächste Wort vorherzusagen, wurde es darauf vortrainiert, maskierte Wörter mithilfe des beidseitigen Kontexts zu ergänzen – das machte es stärker im Verstehen als die damaligen links-nach-rechts-Modelle.
Indem BERT Kontext von beiden Seiten eines Wortes nutzt, übertraf es frühere Modelle bei Aufgaben wie Question Answering und dem Verständnis mehrdeutiger Sprache. Sein Kern setzt Transformer ein und verknüpft Ein- und Ausgaben dynamisch.
BERT wurde auf der englischen Wikipedia und dem BooksCorpus vortrainiert, Google integrierte es 2019 in die Suche, um natürliche Anfragen besser zu interpretieren. Es löste einen Wettlauf um größere vortrainierte Sprachmodelle aus.
Mehr zu BERT findest du in unserem separaten Artikel, der das BERT-Modell vorstellt.
LaMDA
LaMDA (Language Model for Dialogue Applications) ist ein Transformer-basiertes Modell von Google, speziell für Konversationsaufgaben entwickelt und auf der Google I/O 2021 vorgestellt. Es soll natürlichere, kontextrelevante Antworten erzeugen und so Interaktionen in vielen Anwendungen verbessern.
Das Design von LaMDA ermöglicht das Verstehen und Beantworten vieler Themen und Nutzerintentionen – ideal für Chatbots, Sprachassistenten und andere interaktive KI-Systeme, in denen dynamischer Dialog entscheidend ist.
Google ersetzte LaMDA später in Bard durch PaLM 2 und dann Gemini, aber LaMDA war eines der ersten speziell auf Dialog trainierten Transformer-Modelle.
Wenn du LaMDA genauer verstehen willst, hilft dir unser Artikel zu LaMDA.
GPT und ChatGPT
GPT und ChatGPT, entwickelt von OpenAI, sind leistungsfähige generative Modelle, die kohärenten, kontextrelevanten Text erzeugen. GPT-1 erschien im Juni 2018; GPT-3 – eines der einflussreichsten Modelle – folgte 2020.
Die Modelle beherrschen viele Aufgaben: Content-Erstellung, Konversation, Übersetzung und mehr. Durch ihre Architektur erzeugt GPT Texte, die menschlichem Schreiben stark ähneln – nützlich für kreatives Schreiben, Support und sogar Coding-Hilfen. ChatGPT, für Konversation optimiert, glänzt mit dialogischer Natürlichkeit – ideal für Chatbots und Assistenten.
OpenAI veröffentlichte seit GPT-3 keine Architekturdetails mehr (außer zu den Open-Weight-gpt-oss-Modellen), aber die Familie wächst weiter – zuletzt mit GPT-6 Astra in 2026.
Claude
Claude, entwickelt von Anthropic, ist eine Familie von Transformer-basierten KI-Assistenten mit Fokus auf Sicherheit und Nützlichkeit. Claude nutzt Constitutional AI (CAI): Das Training wird von Prinzipien geleitet, um hilfreiche, harmlose und ehrliche Antworten zu fördern.
Claude 3 (2024) führte drei Modellstufen ein – Haiku, Sonnet und Opus – mit unterschiedlichen Kompromissen zwischen Speed und Fähigkeiten. Die Modelle sind stark in nuanciertem Reasoning, komplexen Anweisungen und langem Kontext (bis 200K Tokens).
Seitdem bringt Anthropic alle paar Monate neue Generationen. Die aktuelle Claude-5-Reihe umfasst Claude Fable 5.1 und Claude Opus 5.5 (beide 2026). Wie OpenAI veröffentlicht Anthropic keine Architekturdetails.
Weitere Varianten
Die Zahl der Transformer-Modelle ist stark gewachsen. Xavier Amatriains Katalog klassifiziert Dutzende nach Architektur und Trainingsziel; Stanfords HELM-Benchmark verglich 30 prominente Sprachmodelle Seite an Seite.
Der Trend geht zunehmend zu offenen Gewichten; Plattformen wie der Model Hub von Hugging Face führen den Weg. Zudem wurden zahlreiche spezialisierte Transformer-Modelle für diverse NLP-Aufgaben entwickelt – ein Beleg für die Vielseitigkeit und Effizienz der Architektur.
Mehr zu Foundation Models findest du in einem separaten Artikel: Was sie sind und welche am häufigsten genutzt werden.
Wie haben sich Transformer seit 2017 verändert?
Seit der ursprünglichen Architektur von 2017 haben sich Transformer deutlich weiterentwickelt – um Limitierungen zu adressieren und neue Domänen zu erschließen.
So unterscheiden sich moderne LLMs vom ursprünglichen Transformer
Heutige Open-Weight-LLMs folgen noch der Blaupause von 2017, aber fast jede Komponente wurde durch stabilere oder günstigere Varianten ersetzt. Meta dokumentiert vieles davon in den Papern zu LLaMA und Llama 3:
| Komponente | Original-Transformer (2017) | Typisches Open-Weight-LLM heute |
|---|---|---|
| Architektur | Encoder-Decoder, 6 + 6 Schichten | Nur Decoder, 32 Schichten (Llama 3 8B) bis 126 Schichten (Llama 3 405B) |
| Modellbreite | 512 | 4.096 (Llama 3 8B) bis 16.384 (Llama 3 405B) |
| Positionsinformation | Feste Sinus- und Kosinus-Codierungen, addiert zu den Embeddings | Rotary Position Embeddings (RoPE), innerhalb der Attention angewandt |
| Normalisierung | LayerNorm nach jedem Sublayer (Post-Norm) | RMSNorm vor jedem Sublayer (Pre-Norm) |
| Feed-forward-Aktivierung | ReLU | SwiGLU |
| Attention-Heads | Multi-Head-Attention, 8 Heads | Grouped-Query-Attention: mehrere Query-Heads teilen sich 1 Key-Value-Head (8 KV-Heads in Llama 3) |
| Feed-forward-Schicht | Dense | Dense oder Mixture of Experts (Llama 4, DeepSeek-V3) |
Vision Transformer (ViT)
Vision Transformer übertragen Self-Attention auf Bilder, indem sie diese in Patches teilen und jeden Patch wie ein Token behandeln. Das ist sehr effektiv für Bildklassifikation, Objekterkennung und Bildgenerierung und übertrifft auf großen Datensätzen oft klassische CNNs.
Multimodale Transformer
Moderne Modelle wie GPT-5, Gemini 3 und Llama 4 verarbeiten mehrere Eingabetypen (Text, Bilder, Audio, Video) in einer Architektur. Diese multimodalen Transformer nutzen einheitliche Embedding-Räume und Cross-Attention, um gleichzeitig über Modalitäten hinweg zu schlussfolgern.
Effiziente Transformer
Die quadratische Komplexität der Self-Attention begrenzt die Kontextlänge. Mehrere Innovationen begegnen dem:
- Flash Attention: Berechnet exakte Attention in Kacheln, die in den schnellen On-Chip-Speicher der GPU passen; der Speicherbedarf wächst linear statt quadratisch mit der Sequenzlänge
- Rotary Position Embeddings (RoPE): Kodieren Positionen über Rotationsmatrizen und extrapolieren besser auf längere Sequenzen
- Lineare und spärliche Attention: Linformer und Performer approximieren Attention, Longformer begrenzt die meisten Tokens auf ein lokales Fenster – Kosten O(n) für sehr lange Dokumente
- Mixture of Experts (MoE): Aktiviert pro Token nur einen Teil der Parameter – größere Modelle bei ähnlichen Rechenkosten
Transformer vs. RNNs und CNNs
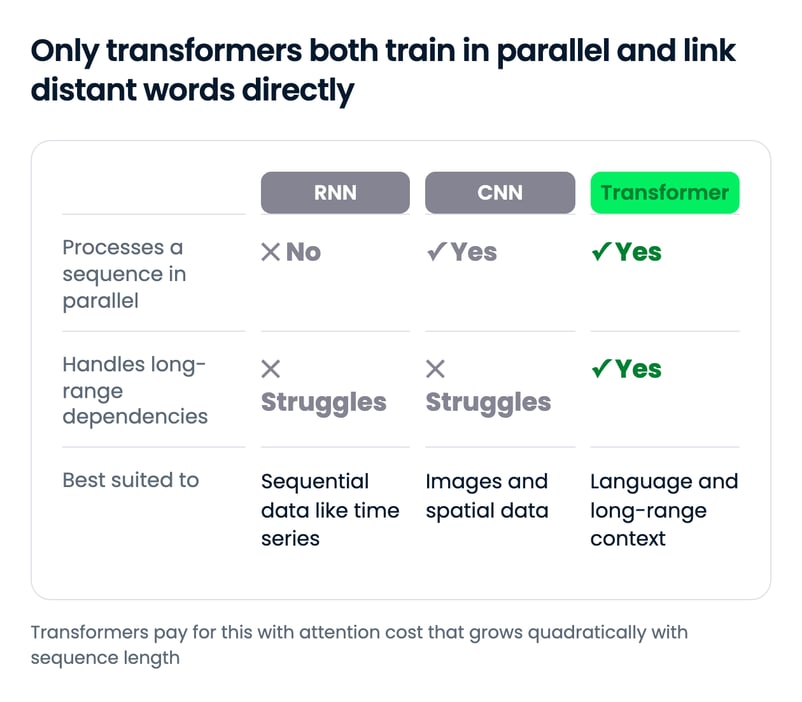
Transformer werden meist mit zwei anderen Bausteinen verglichen: Rekurrenten Schichten (RNNs) und Convolutional Layers (CNNs). Jedes passt zu anderen Datentypen.
Rekurrente Schichten
Rekurrente Schichten, das Herzstück von RNNs, sind stark bei sequenziellen Daten. Ihre Stärke liegt in der sequenziellen Verarbeitung: Der Output eines Schritts fließt als Input in den nächsten. So merkt sich das Netz frühere Informationen – wichtig für Kontextverständnis.
Wie besprochen, hat das zwei Nachteile:
- Längere Trainingszeiten, da jeder Schritt vom vorherigen abhängt – Parallelisierung ist schwierig.
- Probleme mit Langzeitabhängigkeiten durch Vanishing Gradients – weit entfernte Punkte werden schlechter gelernt.
Transformer unterscheiden sich grundlegend, da sie ohne Rekurrenz auskommen. Die Attention-Schicht adressiert beide Probleme und ist die natürliche Weiterentwicklung für NLP.
Convolutional Layers
Convolutional Layers – das Fundament von CNNs – sind extrem effizient für räumliche Daten wie Bilder.
Filter (Kerne) scannen die Eingabe und extrahieren Merkmale. Ihre Breite lässt sich anpassen, um kleine oder große Strukturen zu erfassen.
Sie sind exzellent in hierarchischen, räumlichen Mustern, haben aber Schwierigkeiten mit Langzeitabhängigkeiten und berücksichtigen Reihenfolge nicht inhärent – daher weniger geeignet für Aufgaben, die Sequenzkontext benötigen.
Darum sind CNNs und Transformer für unterschiedliche Daten und Aufgaben optimiert: CNNs dominieren Vision, Transformer sind erste Wahl für komplexe Sequenzen, vor allem in NLP, dank ihres Verständnisses weiter Abhängigkeiten.
Nachteile und Limitierungen von Transformern
Trotz ihres Erfolgs haben Transformer einige Schwächen:
- Quadratische Komplexität: Self-Attention skaliert mit O(n²); sehr große Kontextfenster sind teuer in Compute und Speicher
- Speicherbedarf: Große Modelle benötigen viel GPU-Speicher, was die Bereitstellung einschränkt
- Trainingsdatenbedarf: Starke Leistung erfordert typischerweise riesige Datensätze
- Halluzinationen: Transformer sagen wahrscheinliche Tokens voraus statt Fakten nachzuschlagen – falsche Aussagen können sehr selbstsicher klingen. Reasoning-Modelle reduzieren das, eliminieren es aber nicht
- Limitierte Positionskodierung: Standardverfahren generalisieren schlecht auf Sequenzlängen außerhalb des Trainingsbereichs
Die Forschung adressiert diese Punkte mit Architekturinnovationen wie Flash Attention, Mixture-of-Experts und Retrieval-augmented Generation (RAG).
Fazit
Ein Transformer funktioniert, indem jedes Token via Self-Attention auf jedes andere Token schaut und diese Repräsentationen dann durch einen Stapel identischer Schichten verfeinert. Diese eine Designentscheidung ermöglichte paralleles Training auf GPUs und löste das Langzeitgedächtnisproblem der RNNs.
Bemerkenswert ist, wie wenig sich der Kern verändert hat. Ein LLM von 2026 tauscht Positionskodierung, Normalisierung und Attention-Heads gegen günstigere Varianten, doch das Diagramm von 2017 erkennst du sofort wieder. Offen bleibt, ob State-Space-Modelle und Hybride lange Kontexte übernehmen – oder ob Kernel wie FlashAttention die quadratischen Kosten der Attention tragbar halten.
Um loszulegen, baue in unserem Schritt-für-Schritt-Tutorial einen Transformer mit PyTorch – oder starte mit vortrainierten Modellen in unserer Einführung in Transformer und Hugging Face. Wenn du tiefer einsteigen willst, empfehle ich den Kurs Transformer Models with PyTorch oder den Lernpfad Developing Large Language Models.
FAQs
Wie funktioniert die Transformer-Architektur?
Ein Transformer zerlegt Text in Tokens, wandelt jedes Token in ein Embedding um und fügt Positionsinformationen hinzu. Ein Schichtstapel wendet dann Multi-Head-Self-Attention an – so kann jedes Token alle anderen gewichten – gefolgt von einem Feed-forward-Netz, jeweils mit Residual Connections und Normalisierung. Eine finale lineare Schicht und Softmax erzeugen Wahrscheinlichkeiten für das nächste Token.
Was ist der Unterschied zwischen Encoder-only-, Decoder-only- und Encoder-Decoder-Transformern?
Encoder-only-Modelle wie BERT lesen den gesamten Input bidirektional und eignen sich für Klassifikation und Suche. Decoder-only-Modelle wie GPT und Llama sehen nur frühere Tokens und sind auf Next-Token-Prediction trainiert – der Standard für Chat-LLMs. Encoder-Decoder-Modelle wie T5 und der originale Transformer ordnen eine Eingabesequenz einer Ausgabesequenz zu, z. B. in der Übersetzung.
Warum haben Transformer RNNs und LSTMs verdrängt?
RNNs und LSTMs verarbeiten Tokens nacheinander. Das bremst das Training auf GPUs und lässt Information über lange Distanzen verblassen. Self-Attention verbindet jedes Token direkt mit jedem anderen und verarbeitet die ganze Sequenz parallel – Transformer trainieren schneller und handhaben lange Abhängigkeiten besser.
Ist ChatGPT ein Transformer?
Ja. GPT steht für Generative Pre-trained Transformer. Die GPT-Modelle hinter ChatGPT sind Decoder-only-Transformer, die auf Next-Token-Prediction trainiert sind. OpenAI veröffentlicht seit GPT-3 keine Architekturdetails mehr, aber alle GPT-Modelle basieren auf der Transformer-Architektur.
Was sind die wichtigsten Limitierungen von Transformern?
Die Kosten von Self-Attention wachsen quadratisch mit der Sequenzlänge, daher sind lange Kontextfenster rechen- und speicherintensiv. Transformer benötigen außerdem große Trainingsdatensätze und können halluzinieren – also falsche Informationen selbstbewusst äußern. Verfahren wie FlashAttention, Grouped-Query-Attention, Mixture of Experts und Hybride mit State-Space-Modellen adressieren diese Kosten.

Josep ist Data Scientist und Projektmanager beim katalanischen Fremdenverkehrsamt und nutzt Daten, um die Erfahrungen von Touristen in Katalonien zu verbessern. Sein Fachwissen umfasst das Management von Datenspeicherung und -verarbeitung, gekoppelt mit fortschrittlichen Analysen und der effektiven Kommunikation von Datenerkenntnissen.
Er ist auch ein engagierter Pädagoge, der den Big-Data-Masterstudiengang an der Universität von Navarra unterrichtet und regelmäßig aufschlussreiche Artikel über Datenwissenschaft auf Medium und KDNuggets veröffentlicht.
Er hat einen BS in technischer Physik von der Polytechnischen Universität von Katalonien und einen MS in intelligenten interaktiven Systemen von der Universität Pompeu Fabra.
Derzeit engagiert er sich leidenschaftlich dafür, datenbezogene Technologien durch die Medium-Publikation ForCode'Sake einem breiteren Publikum zugänglich zu machen.


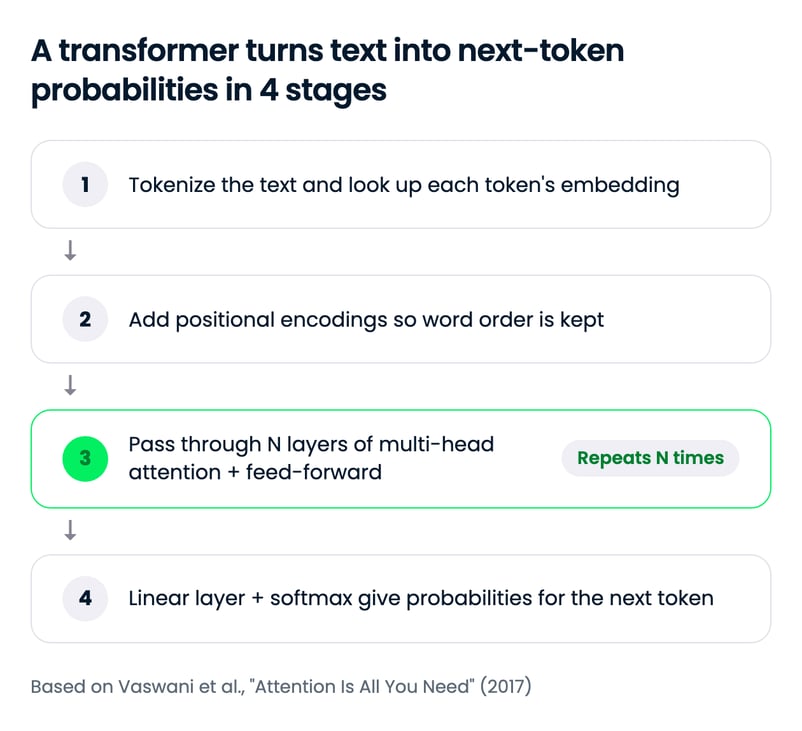
Ein Transformer ist ein neuronales Netz, das alle Tokens einer Sequenz gleichzeitig liest und per Self-Attention entscheidet, in welchem Maß jedes Token auf die anderen Tokens Bezug nimmt. Vorgestellt wurde es 2017 im Google-Paper “Attention Is All You Need”; heute bildet es die Grundlage fast aller Large Language Models (LLMs) – von GPT und Llama bis Gemini.
Die Architektur läuft in 4 Phasen ab. Text wird in Tokens zerlegt und in Embeddings abgebildet, Positionsinformationen werden hinzugefügt, ein Stapel von Schichten wechselt zwischen Multi-Head Self-Attention und Feed-forward-Netzen (jeweils mit Residual Connection und Normalisierung), und eine letzte lineare Schicht mit Softmax wandelt den finalen Vektor in Wahrscheinlichkeiten über dem Vokabular. Das ursprüngliche Modell kombinierte einen Encoder mit einem Decoder; die meisten heutigen LLMs behalten nur den Decoder.
In diesem Tutorial gehe ich Schritt für Schritt durch die Phasen des ursprünglichen Encoder-Decoder-Designs und zeige dann, wie BERT, GPT und heutige LLMs es verändert haben. Wenn du zuerst die Intuition suchst, lies unsere Erklärungen zum Attention-Mechanismus und zur Self-Attention.
TL;DR