

O que são transformers?
Os transformers foram desenvolvidos inicialmente para resolver o problema de transdução de sequências, ou tradução automática neural, ou seja, qualquer tarefa que transforma uma sequência de entrada em uma sequência de saída. Por isso receberam o nome “Transformers”.
Mas vamos começar do começo.
Uma definição simples
Um modelo transformer é uma rede neural que aprende o contexto de dados sequenciais e, a partir disso, gera novos dados.
Em outras palavras:
Um transformer é um tipo de modelo de inteligência artificial que aprende a entender e a gerar texto parecido com o humano analisando padrões em grandes volumes de dados de texto.
Transformers são o estado da arte atual em PLN e são considerados a evolução da arquitetura encoder-decoder. No entanto, enquanto a arquitetura encoder-decoder se apoia principalmente em redes neurais recorrentes (RNNs) para extrair informação sequencial, os transformers não têm nenhuma recorrência.
Então, como eles fazem isso?
Eles foram projetados para compreender contexto e significado analisando as relações entre diferentes elementos e dependem quase inteiramente de uma técnica matemática chamada atenção para conseguir isso.
Imagem do autor.
Contexto histórico
Os transformers foram apresentados por pesquisadores do Google no artigo de 2017 "Attention is All You Need". O código foi lançado no pacote Tensor2Tensor do TensorFlow, e o grupo de NLP de Harvard publicou um guia anotado do paper em PyTorch. Você também pode aprender como implementar um Transformer do zero em nosso tutorial.
Em menos de um ano, o BERT do Google e o GPT-1 da OpenAI mostraram que um transformer pré-treinado em texto não rotulado podia ser ajustado para quase qualquer tarefa de linguagem. O GPT-3 veio em 2020, e pesquisadores de Stanford cunharam o termo “foundation models” para essa nova classe de modelos.
Desde então, tudo acelerou: modelos de pesos abertos como o Llama da Meta (2023), modelos multimodais como o GPT-4o (2024), modelos de raciocínio como o o1 da OpenAI e o DeepSeek-R1 (final de 2024 e início de 2025), e modelos agentivos como o GPT-5 (2025) e o GPT-6 Astra (2026). Os modelos com design público continuam sendo transformers. Para a história completa, veja nossa linha do tempo de grandes modelos de linguagem.
A virada dos modelos RNN para transformers
Quando o Transformer foi apresentado, as redes neurais recorrentes (RNNs) e sua variante long short-term memory (LSTM) eram os modelos preferidos para dados sequenciais. Elas processam a entrada um elemento por vez, o que gera dois problemas principais:
- Treinamento lento: cada passo espera pelo anterior, então RNNs não conseguem usar a computação paralela para a qual as GPUs foram feitas.
- Esquecimento em longas distâncias: a informação é passada passo a passo, e quanto maior a cadeia, maior a chance de se perder.
Os transformers mantiveram a ideia de encoder-decoder das RNNs, mas trocaram a recorrência por atenção, resolvendo os dois problemas: cada palavra pode atender diretamente a qualquer outra, não importa a distância, e a sequência inteira é processada em paralelo.
Agora, vamos ver como os transformers funcionam.
Como funciona a arquitetura Transformer?
Originalmente criada para transdução de sequência ou tradução automática neural, a arquitetura transformer é excelente em converter sequências de entrada em sequências de saída. É o primeiro modelo de transdução a depender inteiramente de self-attention para calcular representações da entrada e da saída, sem usar RNNs alinhadas à sequência ou convolução. A principal característica da arquitetura é manter o modelo encoder-decoder.
Se encararmos um Transformer para tradução de idiomas como uma simples caixa-preta, ele receberia uma frase em um idioma, inglês, por exemplo, como entrada e retornaria sua tradução em espanhol.
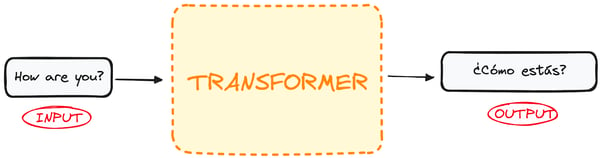
Imagem do autor.
Aprofundando um pouco, vemos que essa caixa-preta tem duas partes principais:
- O encoder recebe a entrada e produz uma representação matricial dessa entrada. Por exemplo, a frase em inglês “How are you?”
- O decoder recebe essa representação codificada e gera a saída iterativamente. No exemplo, a frase traduzida “¿Cómo estás?”
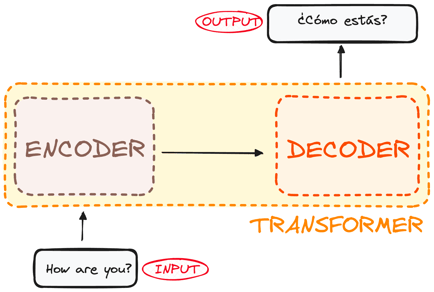
Imagem do autor. Estrutura global de Encoder-Decoder.
Porém, tanto o encoder quanto o decoder são, na verdade, pilhas com múltiplas camadas (mesmo número para cada um). Todos os encoders têm a mesma estrutura; a entrada passa por cada um e segue para o próximo. Todos os decoders também têm a mesma estrutura e recebem a saída do último encoder e do decoder anterior.
A arquitetura original tinha 6 encoders e 6 decoders, mas podemos replicar quantas camadas quisermos. Vamos assumir N camadas de cada.
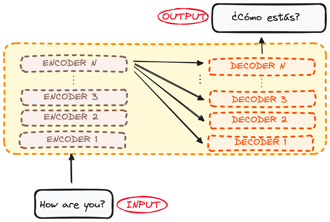
Imagem do autor. Estrutura global de Encoder-Decoder. Múltiplas camadas.
Agora que temos uma ideia geral da arquitetura, vamos focar no funcionamento de encoders e decoders:
Como funciona o encoder do Transformer?
O encoder é um componente fundamental da arquitetura Transformer. Sua função principal é transformar os tokens de entrada em representações contextualizadas. Diferente de modelos anteriores que processavam tokens independentemente, o encoder do Transformer capta o contexto de cada token em relação à sequência inteira.
Sua composição estrutural é a seguinte:
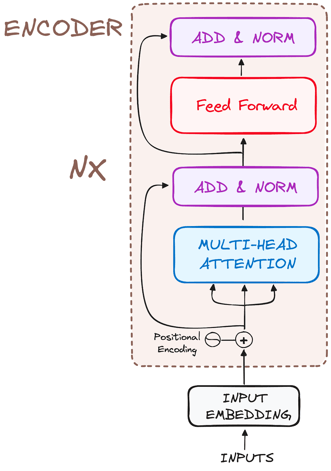
Imagem do autor. Estrutura global dos encoders.
Vamos dividir o fluxo em etapas básicas:
Etapa 1: embeddings de entrada
O embedding acontece apenas no encoder mais inferior. Primeiro, um tokenizador divide o texto em tokens, que são palavras ou partes de palavras, e cada token é mapeado para um vetor aprendido chamado embedding. Tokens com significados relacionados acabam com vetores semelhantes.
Todos os encoders recebem uma lista de vetores, cada um com 512 dimensões no artigo original (dmodel = 512). No encoder inferior, seriam os embeddings das palavras; nos demais, a saída do encoder logo abaixo.
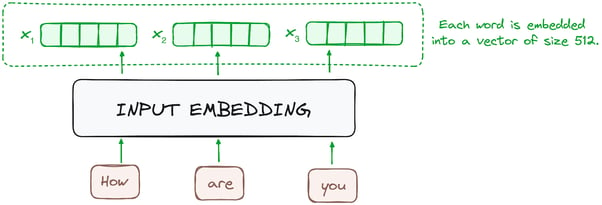
Imagem do autor. Fluxo do encoder. Embedding de entrada.
Etapa 2: codificação posicional
Como os transformers não têm um mecanismo de recorrência como as RNNs, eles usam codificações posicionais somadas aos embeddings de entrada para indicar a posição de cada token na sequência. Isso permite entender a posição de cada palavra na frase.
Para isso, os pesquisadores propuseram usar uma combinação de funções seno e cosseno para criar vetores posicionais, possibilitando aplicar o codificador posicional a frases de qualquer tamanho.
Nessa abordagem, cada dimensão é representada por frequências e defasagens únicas da onda, com valores entre -1 e 1, representando efetivamente cada posição.
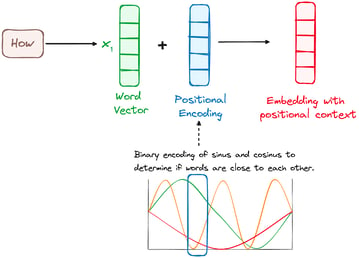
Imagem do autor. Fluxo do encoder. Codificação posicional.
Etapa 3: pilha de camadas do encoder
O encoder do Transformer é composto por uma pilha de camadas idênticas (6 no modelo original).
A camada do encoder transforma todas as sequências de entrada em uma representação contínua e abstrata que captura o que foi aprendido da sequência inteira. Ela tem dois submódulos:
- Um mecanismo de atenção multi-head.
- Uma rede totalmente conectada.
Além disso, incorpora conexões residuais ao redor de cada subcamada, seguidas de normalização.
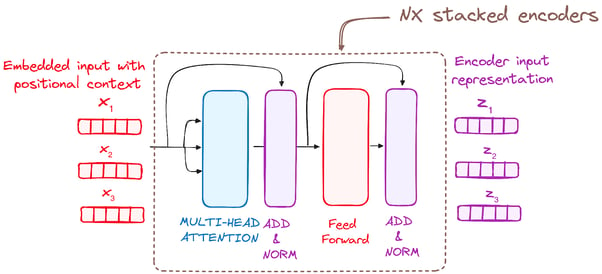
Imagem do autor. Fluxo do encoder. Pilha de camadas do encoder
Etapa 3.1: mecanismo de self-attention multi-head
No encoder, a atenção multi-head usa um mecanismo especializado chamado self-attention. Ele permite que o modelo relacione cada palavra da entrada com as demais. Por exemplo, em um caso, o modelo pode aprender a conectar a palavra “are” a “you”.
Esse mecanismo permite ao encoder focar em diferentes partes da sequência de entrada ao processar cada token. Ele calcula escores de atenção com base em:
- Uma query é um vetor que representa uma palavra ou token específico da sequência de entrada no mecanismo de atenção.
- Uma key também é um vetor no mecanismo de atenção, correspondente a cada palavra ou token da sequência de entrada.
- Cada value está associado a uma key e é usado para construir a saída da camada de atenção. Quando uma query e uma key combinam bem, ou seja, têm um escore de atenção alto, o value correspondente é enfatizado na saída.
Esse primeiro módulo de self-attention permite ao modelo capturar informação contextual da sequência inteira. Em vez de rodar uma única função de atenção, queries, keys e values são projetados linearmente h vezes. Em cada versão projetada de queries, keys e values a atenção é executada em paralelo, produzindo uma saída de dimensão dv (64 no paper original, com h = 8).
A arquitetura detalhada é a seguinte:
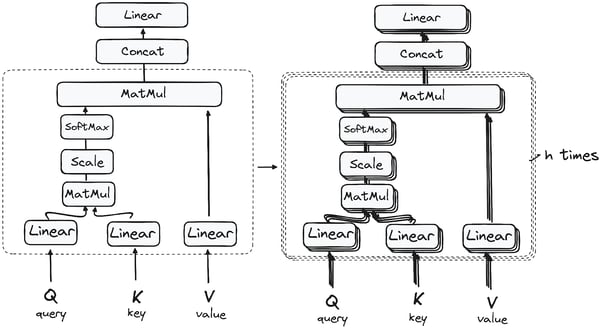
Multiplicação matricial (MatMul): produto escalar de query e key
Depois que os vetores de query, key e value passam por uma camada linear, é feita uma multiplicação matricial (produto escalar) entre queries e keys, gerando uma matriz de escores.
A matriz de escores define o grau de ênfase que cada palavra deve dar às outras. Assim, cada palavra recebe um escore em relação às demais no mesmo passo de tempo. Quanto maior o escore, maior o foco.
Esse processo mapeia efetivamente queries para suas keys correspondentes.
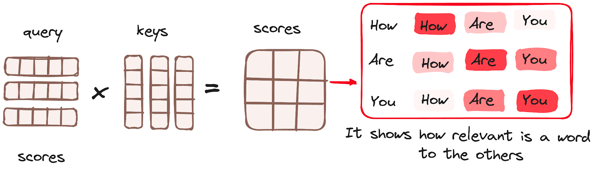
Imagem do autor. Fluxo do encoder. Mecanismo de atenção - multiplicação de matrizes.
Reduzindo a magnitude dos escores de atenção
Em seguida, os escores são reduzidos dividindo-os pela raiz quadrada da dimensão dos vetores de query e key. Isso estabiliza os gradientes, já que as multiplicações podem gerar efeitos exagerados.
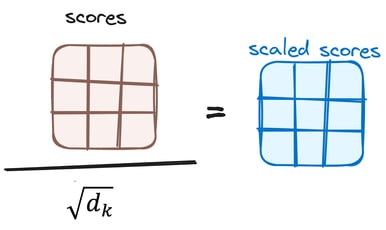
Imagem do autor. Fluxo do encoder. Reduzindo os escores de atenção.
Aplicando softmax aos escores ajustados
Depois, aplica-se a função softmax aos escores ajustados para obter os pesos de atenção. O resultado são probabilidades entre 0 e 1. O softmax enfatiza escores maiores e reduz os menores, ajudando o modelo a decidir com mais eficácia quais palavras merecem mais atenção.
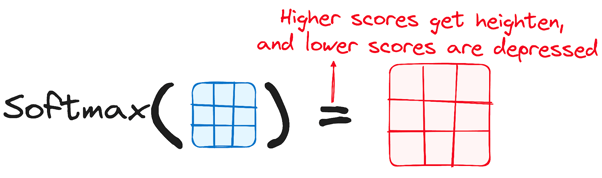
Imagem do autor. Fluxo do encoder. Escores ajustados com softmax.
Combinando o resultado do softmax com o vetor value
Na etapa seguinte, os pesos vindos do softmax são multiplicados pelo vetor value, gerando um vetor de saída.
Palavras com pesos altos dominam o resultado, enquanto pesos próximos de 0 contribuem quase nada. Por fim, esse vetor de saída passa por uma camada linear para processamento adicional.
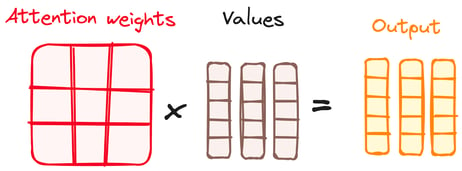
Imagem do autor. Fluxo do encoder. Combinando os resultados do softmax com o vetor value.
E enfim obtemos a saída do mecanismo de atenção!
O termo “multi-head” vem de executar esse processo várias vezes em paralelo. Antes da atenção começar, as queries, keys e values são divididas em h conjuntos menores chamados heads, e cada head roda os passos acima na sua própria fatia.
As saídas das heads são concatenadas e passam por uma camada linear final. Como cada head aprende suas próprias projeções, elas podem capturar relações diferentes, como o substantivo a que um pronome se refere ou quais palavras aparecem lado a lado.
Para se aprofundar no mecanismo de atenção, veja nosso tutorial sobre atenção multi-head em Transformers.
Etapa 3.2: normalização e conexões residuais
Cada subcamada em uma camada do encoder é seguida por uma etapa de normalização. Além disso, a saída de cada subcamada é somada à sua entrada (conexão residual) para mitigar o problema do gradiente que se dissipa, permitindo modelos mais profundos. Esse processo também se repete após a rede neural feed-forward.
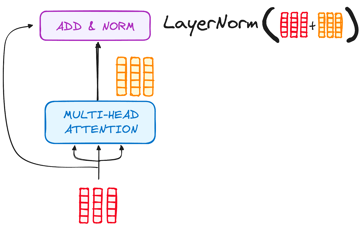
Imagem do autor. Fluxo do encoder. Normalização e conexão residual após a Multi-Head Attention.
Etapa 3.3: rede neural feed-forward
Em seguida, a saída passa por uma rede feed-forward por posição: 2 camadas lineares com uma ativação ReLU entre elas, aplicadas separadamente a cada token. No paper original, a camada interna tem 2.048 dimensões, 4 vezes a largura do modelo (512).
Assim como na atenção, a entrada da rede é somada de volta à sua saída (conexão residual) e o resultado é normalizado.
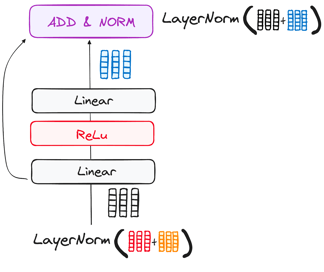
Imagem do autor. Fluxo do encoder. Subcamada feed-forward.
Etapa 4: saída do encoder
A saída da última camada do encoder é um conjunto de vetores, cada um representando a sequência de entrada com entendimento contextual rico. Essa saída alimenta o decoder no modelo Transformer.
Essa codificação cuidadosa prepara o terreno para o decoder, guiando-o a prestar atenção às palavras certas da entrada na hora de decodificar.
Empilhar N camadas de encoder permite que cada uma construa sobre as representações da de baixo. O modelo original usou N = 6; o BERT-Base usa 12 e o BERT-Large 24.
Como funciona o decoder do Transformer?
O decoder gera a sequência de saída. Suas camadas espelham as do encoder, com um acréscimo: cada camada tem 2 subcamadas de atenção multi-head em vez de 1, seguidas de uma rede feed-forward por posição, com conexão residual e normalização ao redor de cada subcamada.
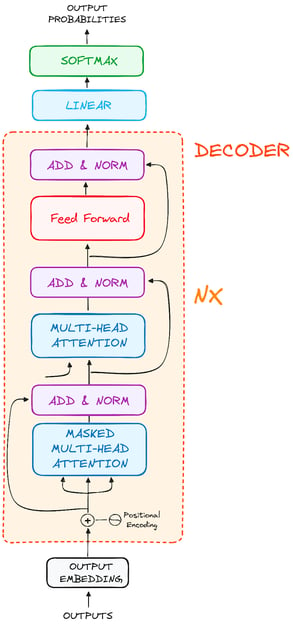
Imagem do autor. Estrutura global dos decoders.
Esses componentes funcionam de forma semelhante aos do encoder, mas com uma diferença: cada camada de atenção multi-head do decoder tem uma missão específica.
O fim do processo do decoder envolve uma camada linear, atuando como classificador, seguida de um softmax para calcular as probabilidades das palavras.
O decoder do Transformer tem uma estrutura projetada para gerar a saída decodificando, passo a passo, a informação codificada.
O decoder opera de forma autorregressiva: começa com um token de início de sequência e, a cada passo, utiliza os tokens já gerados como entrada, junto com a saída do encoder.
Ele para quando gera um token de fim de sequência.
Etapa 1: embeddings de saída
No ponto de partida do decoder, o processo espelha o do encoder. Aqui, a entrada primeiro passa por uma camada de embedding.
Etapa 2: codificação posicional
Após o embedding, novamente como no encoder, a entrada passa pela camada de codificação posicional. Essa etapa produz embeddings posicionais.
Esses embeddings posicionais então entram na primeira camada de atenção multi-head do decoder, onde são calculados os escores de atenção para a própria entrada do decoder.
Etapa 3: pilha de camadas do decoder
O decoder consiste em uma pilha de camadas idênticas (6 no modelo original). Cada camada tem três subcomponentes principais:
Etapa 3.1: mecanismo de self-attention mascarado
É semelhante ao self-attention do encoder, mas com uma diferença crucial: impede que posições atendam a posições futuras, ou seja, cada palavra não é influenciada por tokens que ainda não foram gerados.
Por exemplo, ao calcular os escores de atenção para a palavra “Cómo”, é importante que “Cómo” não enxergue “estás”, que vem depois na sequência de saída.
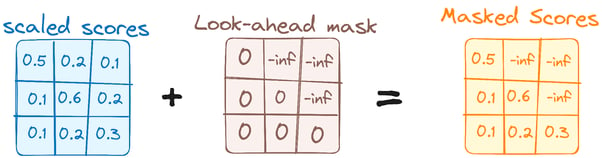
Imagem do autor. Fluxo do decoder. Primeira máscara de atenção multi-head.
Essa máscara garante que as previsões de uma posição dependam apenas das saídas já conhecidas nas posições anteriores.
Etapa 3.2: atenção encoder-decoder (cross-attention)
A segunda subcamada de atenção conecta o decoder ao encoder. Aqui, as queries vêm da saída do self-attention mascarado do decoder, enquanto as keys e values vêm da saída final do encoder.
Isso permite que cada posição no decoder atenda a todas as posições da frase de entrada; assim, ao gerar “estás”, o decoder pode focar em “are you”. O resultado então passa pela subcamada feed-forward.
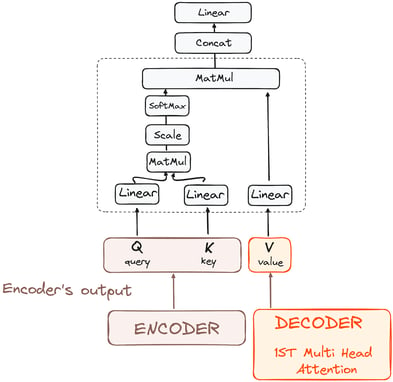
Imagem do autor. Fluxo do decoder. Atenção encoder-decoder.
Etapa 3.3: rede neural feed-forward
Semelhante ao encoder, cada camada do decoder inclui uma rede feed-forward totalmente conectada, aplicada a cada posição separadamente e de forma idêntica.
Etapa 4: classificador linear e softmax
A jornada dos dados no modelo termina em uma camada linear final, que funciona como classificador.
O tamanho desse classificador corresponde ao número total de classes (número de palavras do vocabulário). Por exemplo, com 1000 classes representando 1000 palavras diferentes, a saída será um array com 1000 elementos.
Essa saída passa por uma camada softmax, que a transforma em probabilidades entre 0 e 1. O token com a maior probabilidade é o melhor palpite do modelo para a próxima palavra. A decodificação gananciosa sempre o escolhe; a maioria dos modelos de chat amostra da distribuição, com uma temperatura que controla o grau de aleatoriedade.
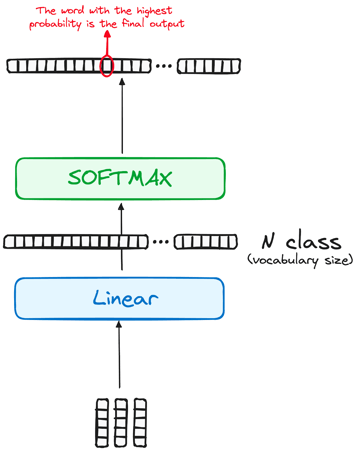
Imagem do autor. Fluxo do decoder. Saída final do Transformer.
Normalização e conexões residuais
Cada subcamada (self-attention mascarado, atenção encoder-decoder, rede feed-forward) é seguida por normalização e inclui uma conexão residual ao seu redor.
Saída do decoder
A saída da última camada é transformada em uma sequência prevista, normalmente por uma camada linear seguida de softmax para gerar probabilidades sobre o vocabulário.
No fluxo operacional, o decoder incorpora a saída recém-gerada à sua lista crescente de entradas e continua decodificando. Esse ciclo se repete até o modelo prever um token específico que sinaliza o fim.
Assim como o encoder, o decoder é uma pilha de N camadas idênticas (6 no modelo original), cada uma construindo sobre a saída da de baixo e sobre a saída do encoder. Pilhas mais profundas permitem que diferentes camadas e heads captem padrões de atenção distintos.
A arquitetura final fica assim (do paper original):
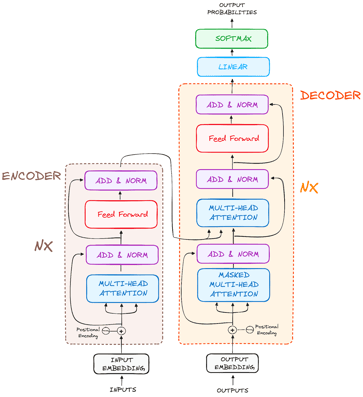
Imagem do autor. Estrutura original dos transformers.
Para entender melhor essa arquitetura, recomendo implementar um Transformer do zero seguindo este tutorial para construir um transformer com PyTorch.
Transformers só com encoder, só com decoder e encoder-decoder
Modelos Transformer se dividem em 3 famílias, dependendo de qual metade da arquitetura original mantêm. A escolha define no que o modelo é bom: encoders leem, decoders escrevem, e encoder-decoders mapeiam uma sequência em outra.
| Família | O que mantém | Atenção | Tarefa de pré-treinamento | Usos típicos | Exemplos |
|---|---|---|---|---|---|
| Apenas encoder | Pilha de encoders | Bidirecional: todo token vê todos os tokens | Preencher tokens mascarados | Classificação, embeddings para busca, reconhecimento de entidades nomeadas | BERT, RoBERTa |
| Apenas decoder | Pilha de decoders, sem cross-attention | Causal: cada token vê apenas tokens anteriores | Prever o próximo token | Chat, geração de código, agentes | GPT-3, Llama, Gemini |
| Encoder-decoder | Ambas as pilhas | Encoder bidirecional, decoder causal, mais cross-attention | Mapear uma sequência de entrada em uma de saída | Tradução, sumarização, reconhecimento de fala | Transformer original, T5, Whisper |
A maioria dos LLMs lançados desde o GPT-3 é apenas decoder. A previsão do próximo token funciona com qualquer texto bruto, então há muito dado para treino, e um único modelo consegue fazer tradução, sumarização e perguntas e respostas tratando tudo como continuação de texto.
Quais modelos usam a arquitetura Transformer?
BERT
BERT (Bidirectional Encoder Representations from Transformers), lançado como open source pelo Google em 2018, é um transformer só com encoder. Em vez de prever a próxima palavra, ele foi pré-treinado para preencher palavras mascaradas usando o contexto dos dois lados, o que o tornou mais forte em tarefas de compreensão do que os modelos esquerda-para-direita da época.
Ao entender o contexto de todos os lados de uma palavra, o BERT superou modelos anteriores em tarefas como perguntas e respostas e entendimento de linguagem ambígua. Seu núcleo usa Transformers, conectando cada elemento de entrada e saída dinamicamente.
O BERT foi pré-treinado na Wikipedia em inglês e no BooksCorpus, e o Google o adicionou ao Search em 2019 para interpretar melhor consultas em linguagem natural. Ele deu início a uma corrida por modelos de linguagem pré-treinados maiores.
Para saber mais sobre o BERT, confira nosso artigo que apresenta o modelo BERT.
LaMDA
LaMDA (Language Model for Dialogue Applications) é um modelo baseado em Transformer desenvolvido pelo Google, projetado especificamente para conversação e lançado durante o keynote do Google I/O de 2021. Ele foi criado para gerar respostas mais naturais e contextuais, melhorando interações em várias aplicações.
O design do LaMDA permite entender e responder a uma ampla gama de tópicos e intenções, tornando-o ideal para chatbots, assistentes virtuais e outros sistemas de IA interativos em que uma conversa dinâmica é essencial.
Depois, o Google substituiu o LaMDA no Bard pelo PaLM 2 e depois pelo Gemini, mas o LaMDA foi um dos primeiros transformers treinados especificamente para diálogo.
Se você quer se aprofundar nos modelos LaMDA, confira nosso artigo sobre o LaMDA.
GPT e ChatGPT
GPT e ChatGPT, desenvolvidos pela OpenAI, são modelos generativos avançados conhecidos por produzir texto coerente e contextual. O GPT-1 foi lançado em junho de 2018, e o GPT-3, um dos mais impactantes, chegou em 2020.
Esses modelos dominam várias tarefas, incluindo criação de conteúdo, conversa, tradução e muito mais. A arquitetura do GPT permite gerar textos muito próximos da escrita humana, úteis em escrita criativa, suporte ao cliente e até assistência a código. O ChatGPT, uma variante otimizada para conversas, se destaca ao gerar diálogos naturais, ampliando seu uso em chatbots e assistentes virtuais.
A OpenAI parou de publicar detalhes de arquitetura após o GPT-3 (exceto seus modelos de pesos abertos gpt-oss), mas a família segue crescendo, mais recentemente com o GPT-6 Astra em 2026.
Claude
Claude, desenvolvido pela Anthropic, é uma família de assistentes de IA baseados em Transformer com foco em segurança e utilidade. O Claude usa Constitutional AI (CAI), uma abordagem de treinamento em que o modelo é guiado por princípios para produzir respostas úteis, inofensivas e honestas.
O Claude 3 (lançado em 2024) apresentou três níveis de modelo, Haiku, Sonnet e Opus, oferecendo diferentes equilíbrios entre velocidade e capacidade. Eles se destacam em raciocínio sutil, seguir instruções complexas e manter contexto em conversas longas (até 200K tokens).
A Anthropic vem lançando novas gerações a cada poucos meses desde então. A linha atual Claude 5 inclui o Claude Fable 5.1 e o Claude Opus 5.5, ambos de 2026. Assim como a OpenAI, a Anthropic não publica detalhes de arquitetura.
Outras variações
O número de modelos transformer cresceu rapidamente. O catálogo de modelos transformer do Xavier Amatriain classifica dezenas deles por arquitetura e objetivo de treino, e o benchmark HELM de Stanford avaliou 30 modelos de linguagem lado a lado.
Há uma tendência crescente de tornar esses modelos open source, com plataformas como o hub de modelos da Hugging Face liderando o movimento. Além disso, inúmeros modelos baseados em Transformer foram desenvolvidos, cada um especializado em diferentes tarefas de PLN, mostrando a versatilidade e eficiência do modelo em aplicações diversas.
Você pode aprender mais sobre os Foundation Models em um artigo separado, que explica o que são e quais são os mais usados.
Como os transformers mudaram desde 2017?
Desde a arquitetura original de 2017, os transformers evoluíram bastante para contornar limitações e expandir para novos domínios.
Como os LLMs modernos diferem do Transformer original
Os LLMs de pesos abertos atuais ainda seguem o projeto de 2017, mas quase todo componente foi trocado por uma variante que treina de forma mais estável ou roda mais barato. A Meta documenta a maioria dessas mudanças nos papers do LLaMA e do Llama 3:
| Componente | Transformer original (2017) | LLM típico de pesos abertos hoje |
|---|---|---|
| Arquitetura | Encoder-decoder, 6 + 6 camadas | Apenas decoder, de 32 camadas (Llama 3 8B) a 126 camadas (Llama 3 405B) |
| Largura do modelo | 512 | 4.096 (Llama 3 8B) a 16.384 (Llama 3 405B) |
| Informação posicional | Codificações seno e cosseno fixas somadas aos embeddings | Rotary position embeddings (RoPE) aplicados dentro da atenção |
| Normalização | LayerNorm após cada subcamada (pós-norm) | RMSNorm antes de cada subcamada (pré-norm) |
| Ativação no feed-forward | ReLU | SwiGLU |
| Heads de atenção | Atenção multi-head, 8 heads | Grouped-query attention: várias heads de query compartilham 1 head de key-value (8 heads de key-value no Llama 3) |
| Camada feed-forward | Densa | Densa ou mixture of experts (Llama 4, DeepSeek-V3) |
Vision Transformers (ViT)
Vision Transformers aplicam self-attention a imagens dividindo-as em patches e tratando cada patch como um token. Essa abordagem se mostrou muito eficaz para classificação, detecção e geração de imagens, muitas vezes superando CNNs tradicionais em grandes datasets.
Transformers multimodais
Modelos modernos como GPT-5, Gemini 3 e Llama 4 processam múltiplos tipos de entrada (texto, imagens, áudio, vídeo) em uma única arquitetura. Esses transformers multimodais usam espaços de embedding unificados e mecanismos de cross-attention para raciocinar simultaneamente entre modalidades.
Transformers eficientes
A complexidade quadrática da self-attention limita o tamanho do contexto. Várias inovações atacam isso:
- Flash Attention: Calcula atenção exata em blocos que cabem na memória rápida on-chip da GPU, fazendo o uso de memória crescer linearmente com o tamanho da sequência em vez de quadraticamente
- Rotary Position Embeddings (RoPE): Codificam posição via matrizes de rotação, permitindo melhor extrapolação para sequências mais longas
- Atenção linear e esparsa: Linformer e Performer aproximam a atenção, e o Longformer limita a maioria dos tokens a uma janela local, reduzindo o custo para O(n) em documentos muito longos
- Mixture of Experts (MoE): Ativa apenas um subconjunto de parâmetros por token, permitindo modelos maiores com custos de computação similares
Transformers vs. RNNs e CNNs
Transformers costumam ser comparados com outros dois blocos de redes neurais: camadas recorrentes (RNNs) e camadas convolucionais (CNNs). Cada um se adapta melhor a um tipo de dado.
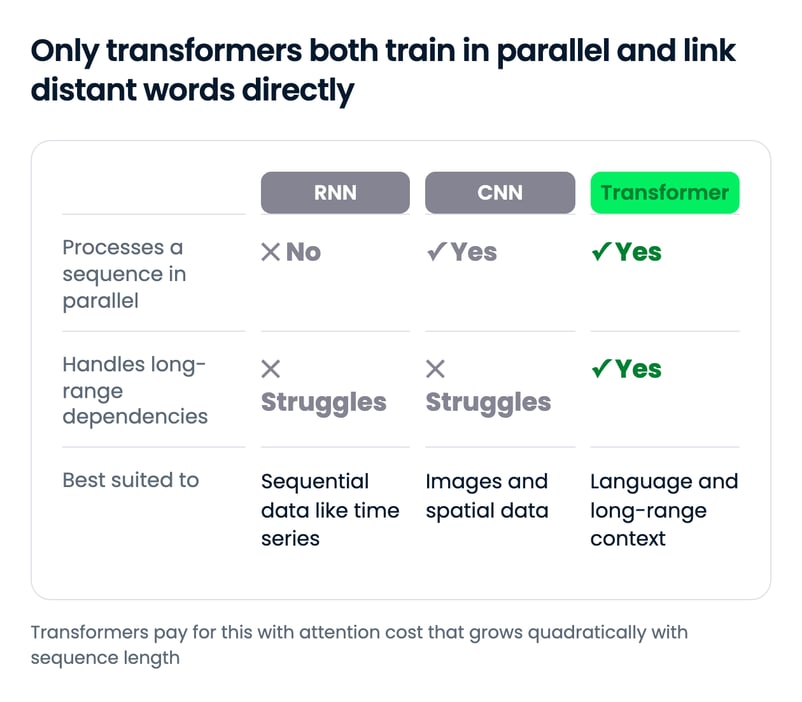
Camadas recorrentes
Camadas recorrentes, base das redes neurais recorrentes (RNNs), são ótimas para dados sequenciais. Sua força está em operar passo a passo, crucial em tarefas como processamento de linguagem e séries temporais. Numa camada recorrente, a saída do passo anterior volta como entrada do próximo. Esse looping permite lembrar informações anteriores, vitais para entender contexto.
Porém, como já discutimos, esse processamento sequencial traz duas implicações principais:
- Treinos mais longos, já que cada passo depende do anterior, dificultando o paralelismo.
- Dificuldade com dependências de longo prazo devido ao problema do gradiente que se dissipa, reduzindo a eficácia para aprender de pontos distantes na sequência.
Transformers diferem bastante das arquiteturas com camadas recorrentes porque não têm recorrência. Como vimos, a camada de atenção do Transformer resolve ambos os problemas, tornando-o a evolução natural das RNNs para aplicações de PLN.
Camadas convolucionais
Já as camadas convolucionais, base das CNNs, são conhecidas pela eficiência em dados espaciais como imagens.
Essas camadas usam kernels (filtros) que varrem a entrada para extrair características. A largura dos kernels pode ser ajustada, permitindo focar em padrões menores ou maiores, conforme a tarefa.
Embora sejam excelentes em capturar hierarquias e padrões espaciais, enfrentam desafios com dependências de longo prazo. Elas não consideram, por natureza, a informação sequencial, sendo menos indicadas para tarefas que exigem entender ordem ou contexto.
Por isso, CNNs e transformers são adequados a dados e tarefas diferentes. CNNs dominam visão computacional por processarem bem informação espacial, enquanto transformers são a escolha para tarefas sequenciais complexas, especialmente em PLN, por entenderem dependências de longo alcance.
Limitações e desvantagens dos transformers
Apesar do sucesso, transformers têm limitações notáveis:
- Complexidade quadrática: A self-attention escala como O(n²) com o tamanho da sequência, tornando janelas de contexto muito longas caras em computação
- Exigência de memória: Modelos grandes requerem muita memória de GPU, limitando a implantação
- Necessidade de muitos dados: Em geral, precisam de datasets massivos para bom desempenho
- Alucinação: Preveem tokens prováveis em vez de consultar fatos, podendo afirmar informações falsas com confiança. Modelos de raciocínio reduzem isso, mas não eliminam
- Limitações da codificação posicional: Codificações padrão têm dificuldade para generalizar a comprimentos não vistos no treino
A pesquisa segue atacando essas limitações com inovações como Flash Attention, mixture-of-experts e retrieval-augmented generation (RAG).
Considerações finais
Um transformer funciona deixando cada token “olhar” para todos os outros via self-attention e depois refinando essas representações com uma pilha de camadas idênticas. Essa decisão de design permitiu treinar em paralelo em GPUs e resolveu o problema de memória de longo alcance que segurava as RNNs.
O que mais me chama atenção é o quão pouco o núcleo mudou. Um LLM de 2026 troca a codificação posicional, a normalização e as heads de atenção por variantes mais baratas, mas você ainda reconheceria o diagrama de 2017 nele. A dúvida em aberto é se modelos de estado espacial e híbridos vão dominar contextos longos, ou se kernels como o FlashAttention manterão o custo quadrático da atenção viável.
Para colocar isso em prática, construa um Transformer com PyTorch no nosso passo a passo, ou comece com modelos pré-treinados na nossa introdução a Transformers e Hugging Face. Se quiser ir além, recomendo o curso Transformer Models with PyTorch ou a trilha Developing Large Language Models para o caminho completo.
FAQs
Como funciona a arquitetura transformer?
Um transformer divide o texto em tokens, transforma cada token em um embedding e adiciona informação posicional. Uma pilha de camadas aplica self-attention multi-head, que permite que cada token pese todos os outros, seguida de uma rede feed-forward, com conexões residuais e normalização em cada etapa. Uma camada linear final e um softmax produzem as probabilidades do próximo token.
Qual é a diferença entre transformers só com encoder, só com decoder e encoder-decoder?
Modelos só com encoder, como o BERT, leem toda a entrada de forma bidirecional e são adequados para classificação e busca. Modelos só com decoder, como GPT e Llama, veem apenas tokens anteriores e são treinados para prever o próximo, o que os torna o padrão para LLMs de chat. Modelos encoder-decoder, como o T5 e o Transformer original, mapeiam uma sequência de entrada para uma de saída, como na tradução.
Por que os transformers substituíram RNNs e LSTMs?
RNNs e LSTMs processam tokens um a um, o que torna o treino lento em GPUs e faz a informação se perder ao longo de sequências longas. A self-attention conecta cada token diretamente a todos os outros e processa a sequência inteira em paralelo, então transformers treinam mais rápido e lidam melhor com dependências de longo alcance.
O ChatGPT é um transformer?
Sim. GPT significa Generative Pre-trained Transformer, e os modelos GPT por trás do ChatGPT são transformers só com decoder treinados para prever o próximo token. A OpenAI não publica detalhes de arquitetura desde o GPT-3, mas todo GPT é baseado no design transformer.
Quais são as principais limitações dos transformers?
O custo da self-attention cresce quadraticamente com o comprimento da sequência, então janelas de contexto longas exigem muita computação e memória. Transformers também precisam de grandes conjuntos de treino e podem alucinar, afirmando falsidades com confiança. Técnicas como FlashAttention, grouped-query attention, mixture of experts e híbridos com state space models miram esses custos.

Josep é cientista de dados e gerente de projetos no Conselho de Turismo da Catalunha, usando dados para melhorar a experiência dos turistas na Catalunha. Sua experiência inclui o gerenciamento de armazenamento e processamento de dados, juntamente com análises avançadas e a comunicação eficaz de insights de dados.
Ele também é um educador dedicado, lecionando no programa de mestrado em Big Data da Universidade de Navarra e contribuindo regularmente com artigos perspicazes sobre ciência de dados para o Medium e o KDNuggets.
Ele é bacharel em Engenharia Física pela Universidade Politécnica da Catalunha e mestre em Sistemas Interativos Inteligentes pela Universidade Pompeu Fabra.
Atualmente, ele está empenhado em tornar as tecnologias relacionadas a dados mais acessíveis a um público mais amplo por meio da publicação ForCode'Sake no Medium.






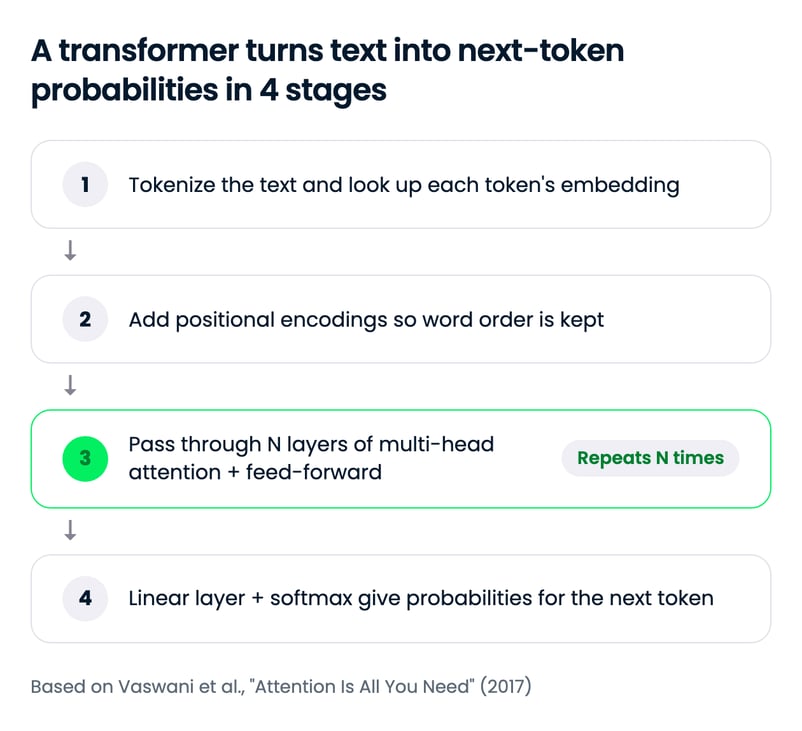
Um transformer é uma rede neural que lê todos os tokens de uma sequência de uma só vez e usa self-attention para decidir quanto cada token deve se apoiar em todos os outros tokens. Pesquisadores do Google o apresentaram no artigo de 2017 “Attention Is All You Need”, e hoje ele é a base de quase todo large language model (LLM), de GPT e Llama a Gemini.
A arquitetura funciona em 4 etapas. O texto é dividido em tokens e mapeado para embeddings, adiciona-se informação posicional, um conjunto de camadas alterna self-attention multi-head com redes feed-forward (cada uma envolvida por conexão residual e normalização), e uma última camada linear com softmax transforma o último vetor em probabilidades sobre o vocabulário. O modelo original combinava um encoder com um decoder; a maioria dos LLMs atuais mantém apenas o decoder.
Neste tutorial, vou passar por cada etapa do design original de encoder-decoder e depois mostrar como BERT, GPT e os LLMs atuais o modificaram. Se você prefere começar pela intuição, leia nossos explicadores sobre o mecanismo de atenção e self-attention.
Resumo