
Cours
Travailler avec Hugging Face
2 h
38.3K
Dans le domaine en pleine effervescence de l’intelligence artificielle (IA) et de l’apprentissage automatique (ML), la classification d’images s’impose comme une tâche fondamentale alimentant un large éventail d’applications, des systèmes de reconnaissance faciale aux diagnostics d’imagerie médicale.
Parmi les nombreuses solutions et bibliothèques à la disposition des data scientists et praticiens de l’IA, Hugging Face occupe une place de choix, en particulier pour le traitement du langage naturel (NLP) et, de plus en plus, pour des tâches de vision par ordinateur comme la classification d’images.
Cet article couvre l’essentiel de l’utilisation de Hugging Face pour la classification d’images : comprendre les bases de la classification, préparer vos données, entraîner votre modèle, le déployer sur le hub Hugging Face, puis interagir avec le modèle déployé via l’API et l’interface Hugging Face.
Que vous débutiez ou que vous soyez déjà confirmé, ce guide vous donnera les clés pour tirer parti de Hugging Face dans vos projets de classification d’images.
Cette section revient sur les bases de la classification d’images et les atouts de Hugging Face.
La classification d’images consiste à affecter chaque image à l’une des catégories prédéfinies.
Cette tâche s’appuie sur des algorithmes qui analysent le contenu visuel d’une image et prédisent sa catégorie à partir des motifs appris sur l’ensemble d’entraînement. Les modèles de deep learning, en particulier les réseaux de neurones convolutifs (CNN), sont devenus la référence grâce à leur capacité à capter les motifs pertinents dans les données visuelles.
Pour en savoir plus sur les CNN, notre article Introduction aux réseaux de neurones convolutifs (CNN) propose un guide complet pour comprendre ces modèles, leur impact sur l’analyse d’images et des stratégies clés pour limiter le surapprentissage et rendre les CNN plus robustes dans les applications de deep learning.
Par ailleurs, l’article Classification en apprentissage automatique : une introduction détaille pas à pas ce qu’est la classification en ML, ses usages et plusieurs exemples d’algorithmes de classification.
Hugging Face offre un écosystème ML complet, avec des interfaces simples d’usage, un vaste référentiel de modèles préentraînés et une documentation soignée.
Par rapport à d’autres plateformes, Hugging Face présente plusieurs avantages pour la classification d’images :
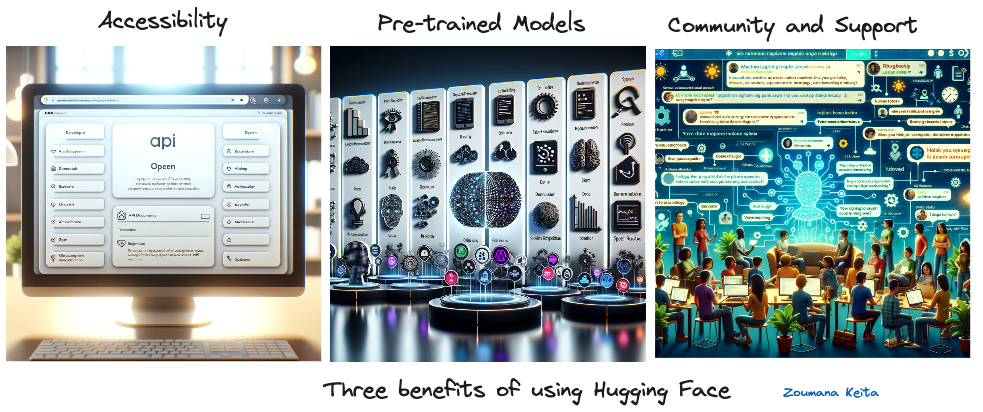
Trois avantages de Hugging Face (image générée avec GPT-4)
En outre, Hugging Face facilite le déploiement sur les principales plateformes cloud comme AWS, Azure et Google Cloud Platform, avec plusieurs modes d’inférence.
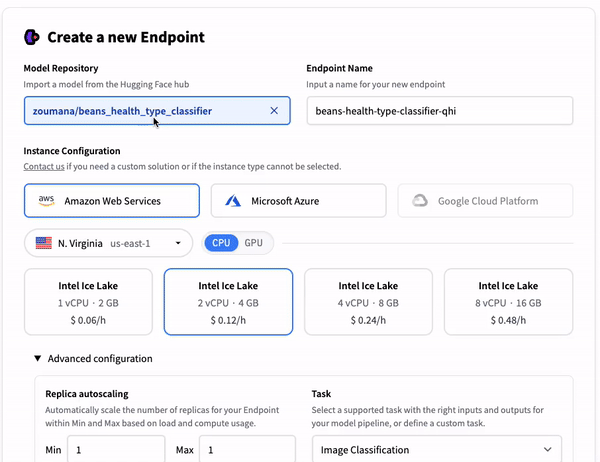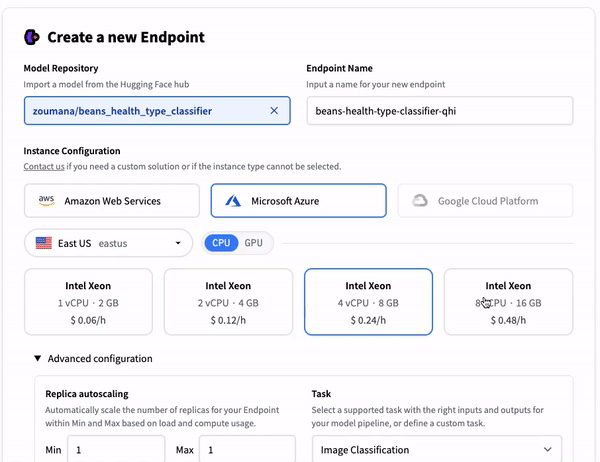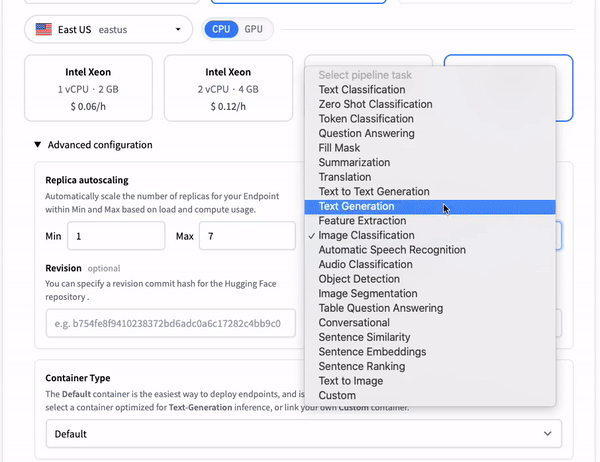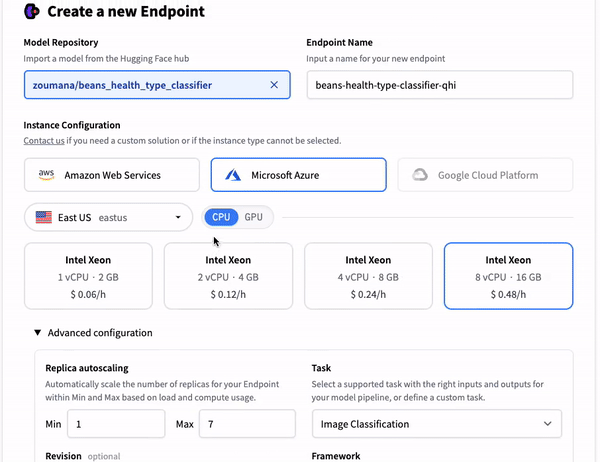
Options de déploiement sur les plateformes cloud
La tâche principale abordée ici est la classification d’images, et nous utiliserons le jeu de données "beans" de Hugging Face pour l’exemple. Après le chargement, nous réaliserons quelques visualisations avant de passer au prétraitement en vue de l’entraînement.
Le notebook contenant le code est disponible pour vous permettre de suivre dans Google Colab.
Les extraits de code de cet article s’inspirent largement du site officiel de Hugging Face.
Plusieurs bibliothèques sont mobilisées dans cet article, chacune avec un rôle précis. Certaines nécessitent une installation préalable. Elles s’installent avec le gestionnaire de paquets Python « pip » comme suit :
%%bash
pip -q install datasets
pip -q install transformers=='4.29.0'
pip -q install tensorflow=='2.15' # At least this tensorflow version is required to use the "evaluate module"
pip -q install evaluate
pip -q install --upgrade accelerate
Il est recommandé de redémarrer le noyau après l’installation. Une fois l’installation réussie, importez les bibliothèques nécessaires avec les instructions from et import :
import torch
import torchvision
import numpy as np
import evaluate
from datasets import load_dataset
from huggingface_hub import notebook_login
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from transformers import DefaultDataCollator
from transformers import AutoImageProcessor
from torchvision.transforms import RandomResizedCrop, Compose, Normalize, ToTensor
from transformers import AutoModelForImageClassification, TrainingArguments, Trainer
import matplotlib.pyplot as pltLe chargement des données depuis Hugging Face est simple avec la fonction load_dataset.
beans_train = load_dataset("beans", split="train")beans est le nom du jeu de données utilisé.train correspond au sous-ensemble utilisé de l’ensemble complet.Une fois les données chargées, on peut en consulter les caractéristiques en affichant simplement le nom de la variable ci-dessus.
print(beans_train)Ce qui donne le résultat ci-dessous :
Dataset({
    features: ['image_file_path', 'image', 'labels'],
    num_rows: 1034
})
Le jeu compte 1034 images au total, et chaque image possède trois champs :
image_path : le chemin vers l’image.image : un objet PIL représentant l’image de la feuille de haricot.labels : l’étiquette de l’image, pouvant prendre l’une des trois valeurs suivantes :La fonction utilitaire ci-dessous facilite la visualisation d’un certain nombre d’images aléatoires, en affichant le type correct associé à chaque étiquette (0, 1, 2).
labels_names = {
   0: "angular_leaf_spot",
   1: "bean_rust",
   2: "healthy",
}

def display_random_images(dataset, num_images=4):

   num_rows = 2
   num_cols = np.ceil(num_images / num_rows).astype(int)

   plt.figure(figsize=(num_cols * 3, num_rows * 3))
   indices = np.random.choice(range(len(dataset)), size=num_images, replace=False)

   for i, idx in enumerate(indices, 1):
       idx = int(idx)
       image = dataset[idx]['image']
       label = dataset[idx]['labels']
       label_name = labels_names.get(label, "Unknown")

       plt.subplot(num_rows, num_cols, i)
       plt.imshow(image)
       plt.title(f"{label_name} ({label})")
       plt.axis('off')

   plt.tight_layout()
   plt.show()
En bref, la fonction display_random_images sélectionne un sous-ensemble aléatoire d’images d’un jeu donné et les affiche en grille, chacune annotée par sa classe (par exemple : "angular_leaf_spot", "bean_rust", "healthy").
Elle organise dynamiquement les images sur deux lignes et calcule le nombre de colonnes nécessaires selon le total à afficher, sans doublon, en joignant le nom d’étiquette et sa valeur numérique.
Nous pouvons ensuite afficher six images aléatoires comme suit :
display_random_images(beans_train, num_images=6)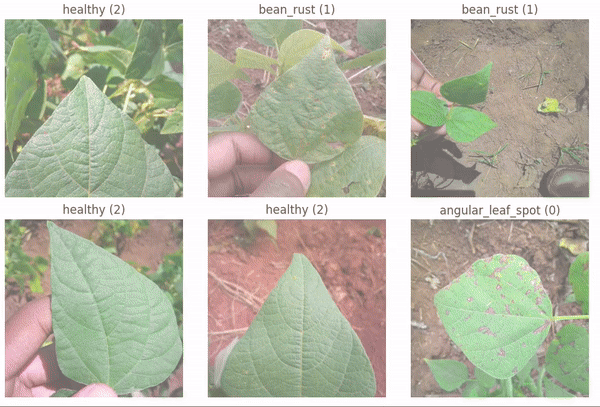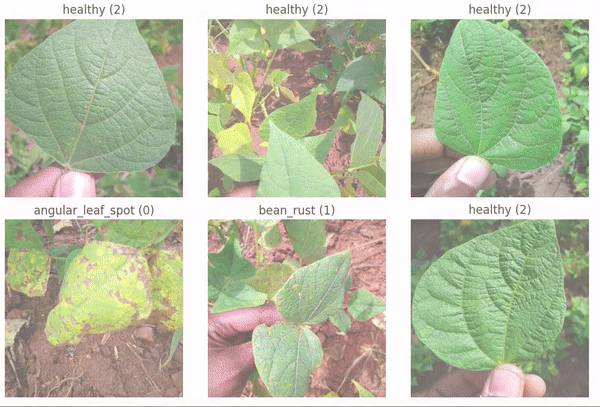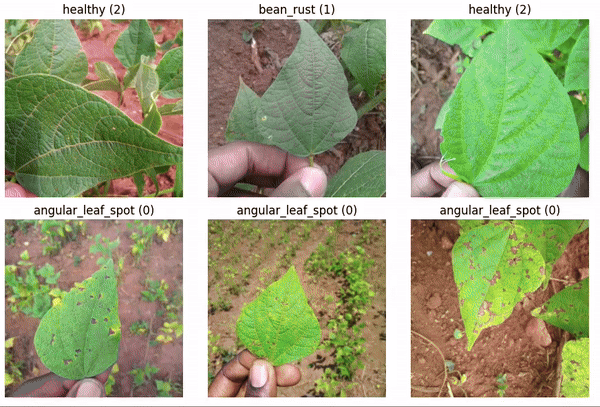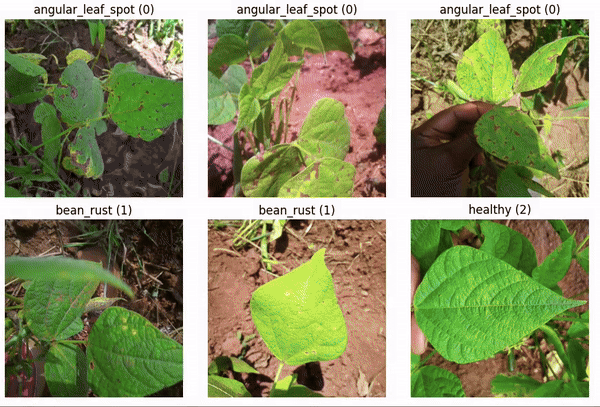
Six images aléatoires du jeu de données
Avant l’entraînement, il est essentiel d’appliquer un prétraitement adapté pour rendre les données compatibles avec le modèle.
On commence par scinder le jeu d’origine en apprentissage et validation, respectivement 80 % et 20 %, via la fonction train_test_split.
beans_train = beans_train.train_test_split(test_size=0.2)Ensuite, nous créons deux dictionnaires : label2id et id2label. Ils sont indispensables pour convertir les noms d’étiquettes lisibles par l’humain en identifiants numériques exploitables par la machine, et inversement.
Ce mécanisme facilite l’entraînement et l’interprétation des prédictions du modèle final.
labels = beans_train["train"].features["labels"].names
label2id, id2label = dict(), dict()

for i, label in enumerate(labels):
   label2id[label] = str(i)
   id2label[str(i)] = label
Voici le contenu de la variable id2label :
print(id2label){'0': 'angular_leaf_spot', '1': 'bean_rust', '2': 'healthy'}Notre classifieur s’appuie sur le modèle préentraîné Vision Transformer (ViT) de Hugging Face.
Ce modèle a été introduit dans l’article An Image is Worth 16x16 words: Transformers for Image Recognition at Scale. Il marque la première application réussie de l’architecture transformer à la reconnaissance d’images, entraînée sur ImageNet.
Le code suivant détaille les étapes pour charger le modèle préentraîné, prétraiter les données selon ses exigences, et réaliser les opérations intermédiaires garantissant que les images sont correctement préparées pour l’affinage et l’évaluation.
checkpoint = "google/vit-base-patch16-224-in21k"
image_processor = AutoImageProcessor.from_pretrained(checkpoint)

normalize = Normalize(mean=image_processor.image_mean,
                  	std=image_processor.image_std)

size = (
	image_processor.size["shortest_edge"]
	if "shortest_edge" in image_processor.size
	else (image_processor.size["height"], image_processor.size["width"])
)

_transforms = Compose([RandomResizedCrop(size), ToTensor(), normalize])

def transforms(examples):

	examples["pixel_values"] = [_transforms(img.convert("RGB")) for img in examples["image"]]
	del examples["image"]
	return examples

beans_transformed = beans_train.with_transform(transforms)

data_collator = DefaultDataCollator()
Explications du code ci-dessus :
google/vit-base-patch16-224-in21k ;_transforms) : recadrage aléatoire redimensionné, conversion en tenseur, normalisation ;beans_train avec cette fonction pour le préparer à l’entraînement ;Pour l’évaluation, nous utiliserons la précision (accuracy) comme métrique, implémentée par la fonction utilitaire suivante.
accuracy = evaluate.load("accuracy")
def compute_metrics(eval_pred):
   predictions, labels = eval_pred
   predictions = np.argmax(predictions, axis=1)

   return accuracy.compute(predictions=predictions,
references=labels)Avant l’entraînement, nous définissons le modèle effectif en nous appuyant sur le préentraîné via la fonction .from_pretrained :
model = AutoModelForImageClassification.from_pretrained(
   checkpoint,
   num_labels=len(labels),
   id2label=id2label,
   label2id=label2id,
)L’étape suivante consiste à configurer et initialiser l’environnement d’entraînement du modèle.
Ce paramétrage inclut les hyperparamètres nécessaires pour l’entraînement, l’évaluation et l’optimisation.
Mais avant cela, connectez-vous à votre compte Hugging Face avec vos identifiants, comme indiqué ci-dessous :
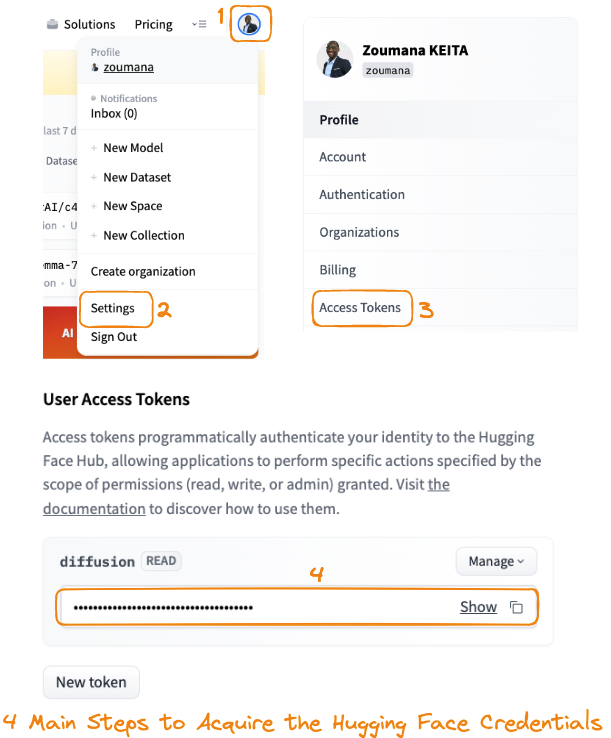
Étapes principales pour obtenir les identifiants Hugging Face
En vous connectant, vous pourrez téléverser et partager vos modèles avec la communauté. Lancez ensuite l’authentification avec la fonction notebook_login.
notebook_login()Lorsque vous y êtes invité, fournissez le jeton de connexion copié à l’étape 4 du guide.
Après une connexion réussie, le message suivant s’affiche :
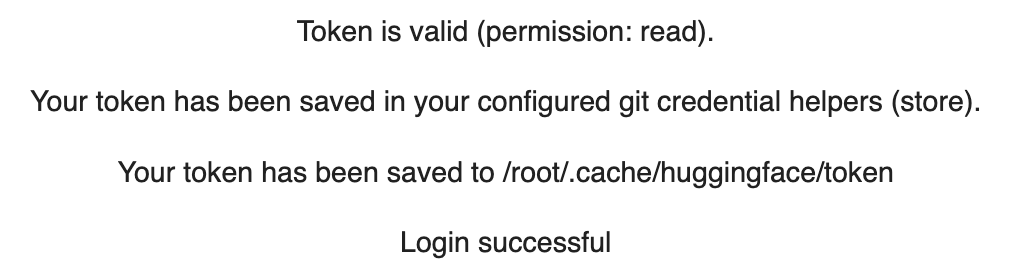
Voici le code de configuration et d’initialisation :
training_args = TrainingArguments(
	output_dir="./beans_health_type_classifier",
	remove_unused_columns=False,
	evaluation_strategy="epoch",
	save_strategy="epoch",
	learning_rate=5e-5,
	per_device_train_batch_size=16,
	gradient_accumulation_steps=4,
	per_device_eval_batch_size=16,
	num_train_epochs=3,
	warmup_ratio=0.1,
	logging_steps=10,
	load_best_model_at_end=True,
	metric_for_best_model="accuracy"
)

trainer = Trainer(
	model=model,
	args=training_args,
	data_collator=data_collator,
	train_dataset=beans_transformed["train"],
	eval_dataset=beans_transformed["test"],
	tokenizer=image_processor,
	compute_metrics=compute_metrics,
)
TrainingArguments est configuré avec des paramètres clés : répertoire de sortie, stratégie d’évaluation et de sauvegarde par époque, taux d’apprentissage, tailles de batch, accumulation de gradients, nombre d’époques, warmup, journalisation, chargement du meilleur modèle (selon la métrique de précision).Trainer est initialisé avec le modèle, les arguments d’entraînement, le data collator, les jeux d’entraînement et d’évaluation, le processeur d’images (tokenizer ici) et la fonction de calcul des métriques.Vient ensuite la phase d’apprentissage, via la fonction .train.
trainer.train()Cet entraînement particulier a produit les métriques suivantes :
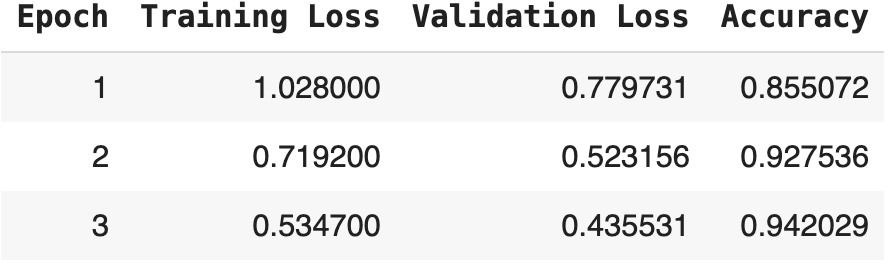
Résultats d’entraînement du modèle sur trois époques
Le tableau montre la progression sur trois époques sur le jeu "beans", avec trois indicateurs : perte d’entraînement, perte de validation et précision.
Lors de la première authentification au portail Hugging Face, le mode de connexion était en lecture seule. Pour pousser le modèle sur le hub, il faut générer des identifiants avec droit d’écriture.
Connectez-vous de nouveau via la fonction notebook_login avec ces nouveaux identifiants.
notebook_login()Le téléversement du modèle se fait avec la fonction push_to_hub :
trainer.model.push_to_hub("zoumana/beans_health_type_classifier")Le modèle est alors publié sur le hub, où l’on peut consulter ses propriétés principales.
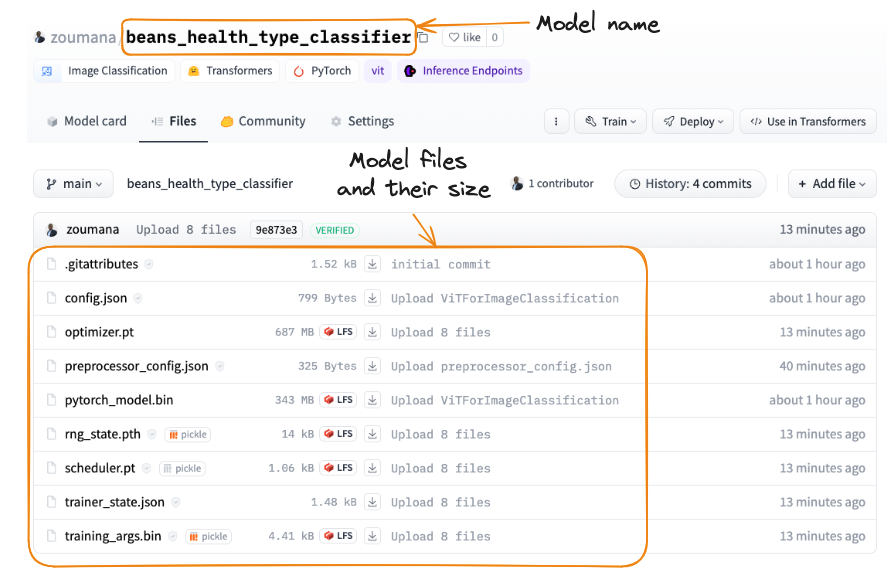
Modèle poussé sur Hugging Face
Une fois partagé, le modèle peut être intégré dans des applications via une API REST, ou utilisé directement depuis le portail Hugging Face. Développeurs et chercheurs peuvent aussi le charger via la bibliothèque Transformers.
Nous couvrons ici trois principales façons d’utiliser le modèle.
Depuis le portail, il suffit de téléverser une image pour obtenir les prédictions du modèle, comme illustré ci-dessous.
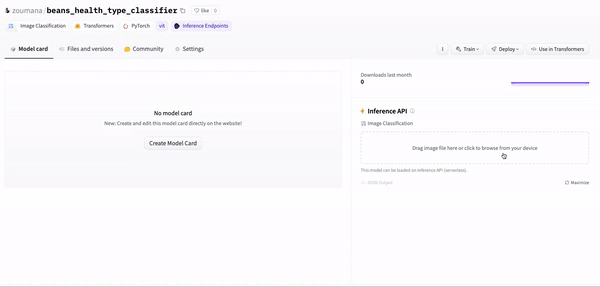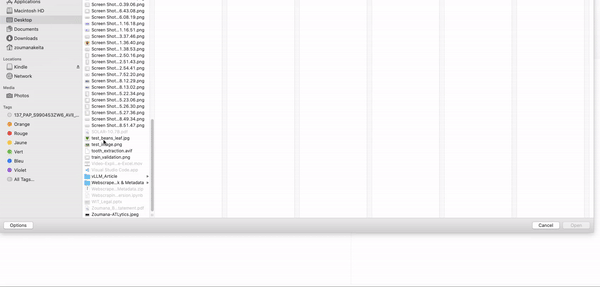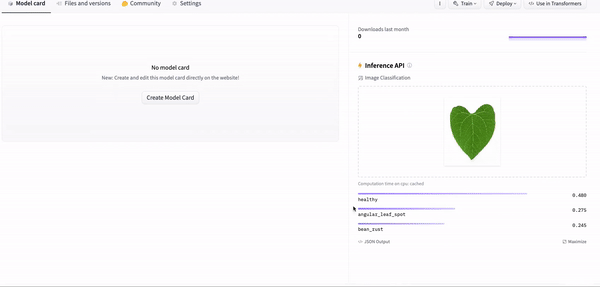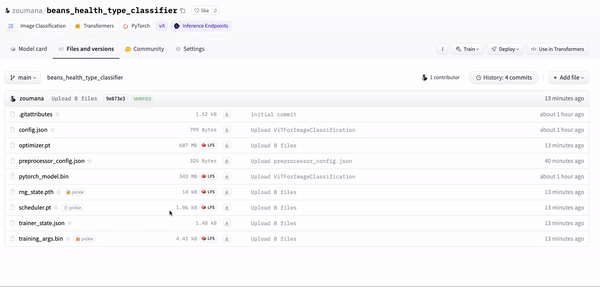
Utilisation du modèle depuis le portail Hugging Face
En cliquant sur l’icône « Use in Transformers », le code d’exemple est fourni automatiquement :
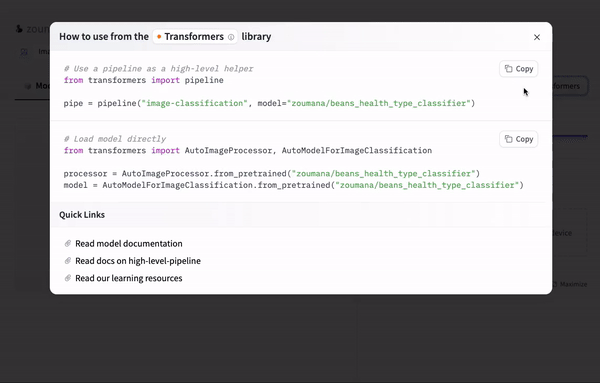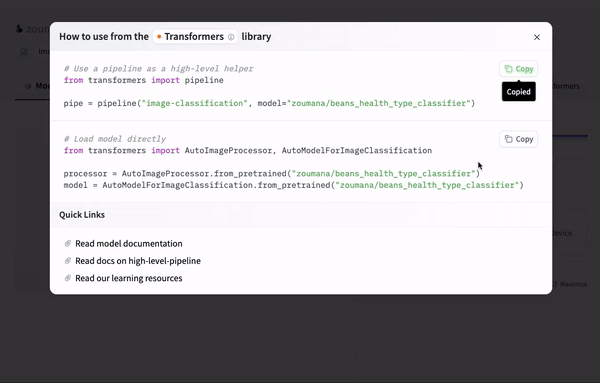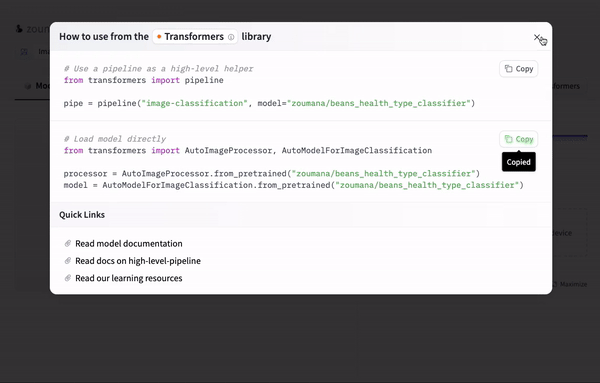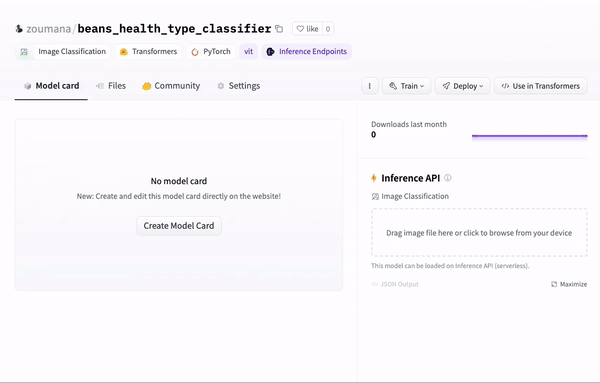
Utiliser le modèle avec Transformers
Enfin, on peut exposer le modèle en API REST grâce à la chaîne de connexion fournie automatiquement sur le portail après avoir cliqué sur « Deploy > Inference API (serverless) ».
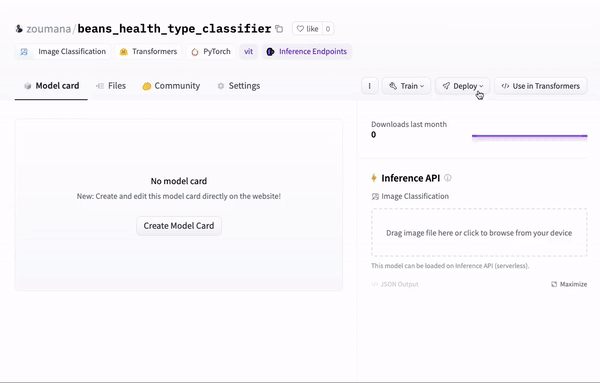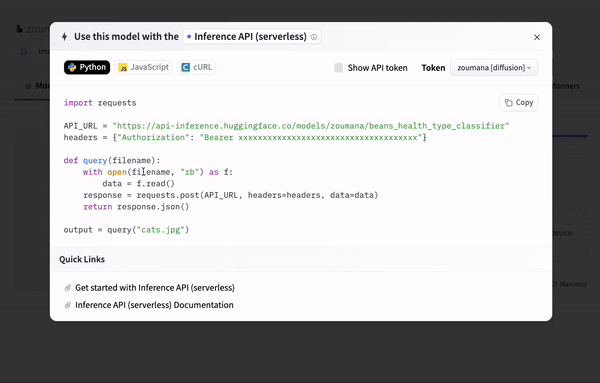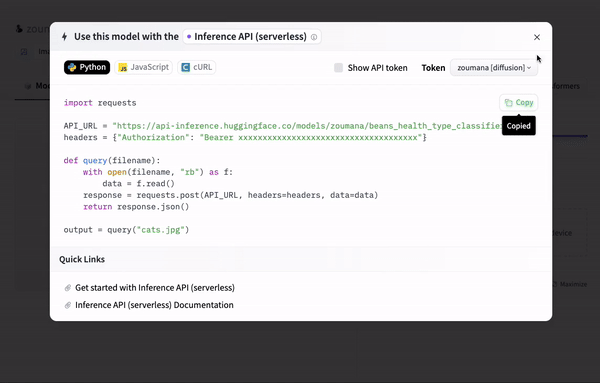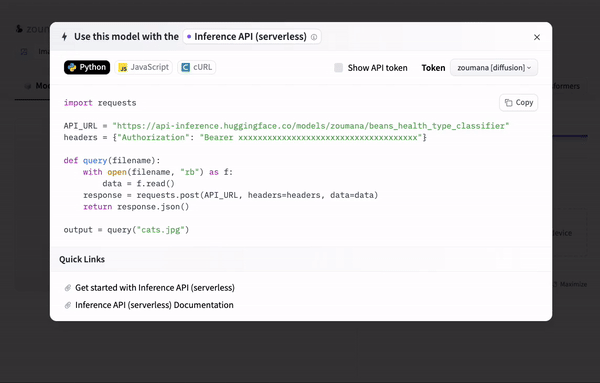
Utilisation d’un point de terminaison API
L’extrait de code montré dans l’animation précédente est reproduit ci-dessous et permet d’obtenir des prédictions pour une image donnée.
L’image utilisée est la même que celle présentée lors de la démonstration sur le portail Hugging Face.
Veillez à remplacer les « xxx » par vos valeurs réelles.
import requests

API_URL = "https://api-inference.huggingface.co/models/zoumana/beans_health_type_classifier"
headers = {"Authorization": "Bearer xxxxxxxxxxxxxxxxx"}

def query(filename):
   with open(filename, "rb") as f:
       data = f.read()
   response = requests.post(API_URL, headers=headers, data=data)
   return response.json()
Nous récupérons ensuite la réponse du modèle à l’aide de la fonction query.
output = query("./inference_images/test_beans_leaf.jpg")Le résultat final est une réponse JSON (voir ci-dessous). L’étiquette prédite correspond à celle ayant la probabilité la plus élevée ; ici, il s’agit de healthy, exactement comme sur le portail Hugging Face.
print(output)[
{'label': 'healthy', 'score': 0.4799719452857971},
{'label': 'angular_leaf_spot', 'score': 0.27489492297172546},
{'label': 'bean_rust', 'score': 0.2451331913471222}
]Cet article vous a proposé un guide complet pour réaliser des tâches de classification d’images avec Hugging Face.
Nous avons commencé par les fondamentaux et montré pourquoi Hugging Face est une excellente option grâce à sa vaste collection de modèles et à sa communauté engagée.
Nous avons ensuite vu comment préparer les images pour l’entraînement, afin de respecter les prérequis de l’affinage.
Nous avons enfin détaillé l’affinage d’un modèle avec Hugging Face, le choix d’un modèle préentraîné adapté, et trois stratégies d’intégration pour l’utiliser en production.
Le champ de l’IA évolue vite, et chaque étape ouvre de nouvelles opportunités. Pour approfondir, notamment sur la classification d’images et au-delà, voici quelques ressources utiles :
Ce guide vise à aider chacun à lancer ses propres projets de classification d’images avec Hugging Face, qu’il soit débutant, intermédiaire ou confirmé.
Commencez votre parcours IA dès aujourd’hui !
Cours
Cours
Cursus