
Cours
Concepts des grands modèles de langage (LLM)
2 h
109.8K
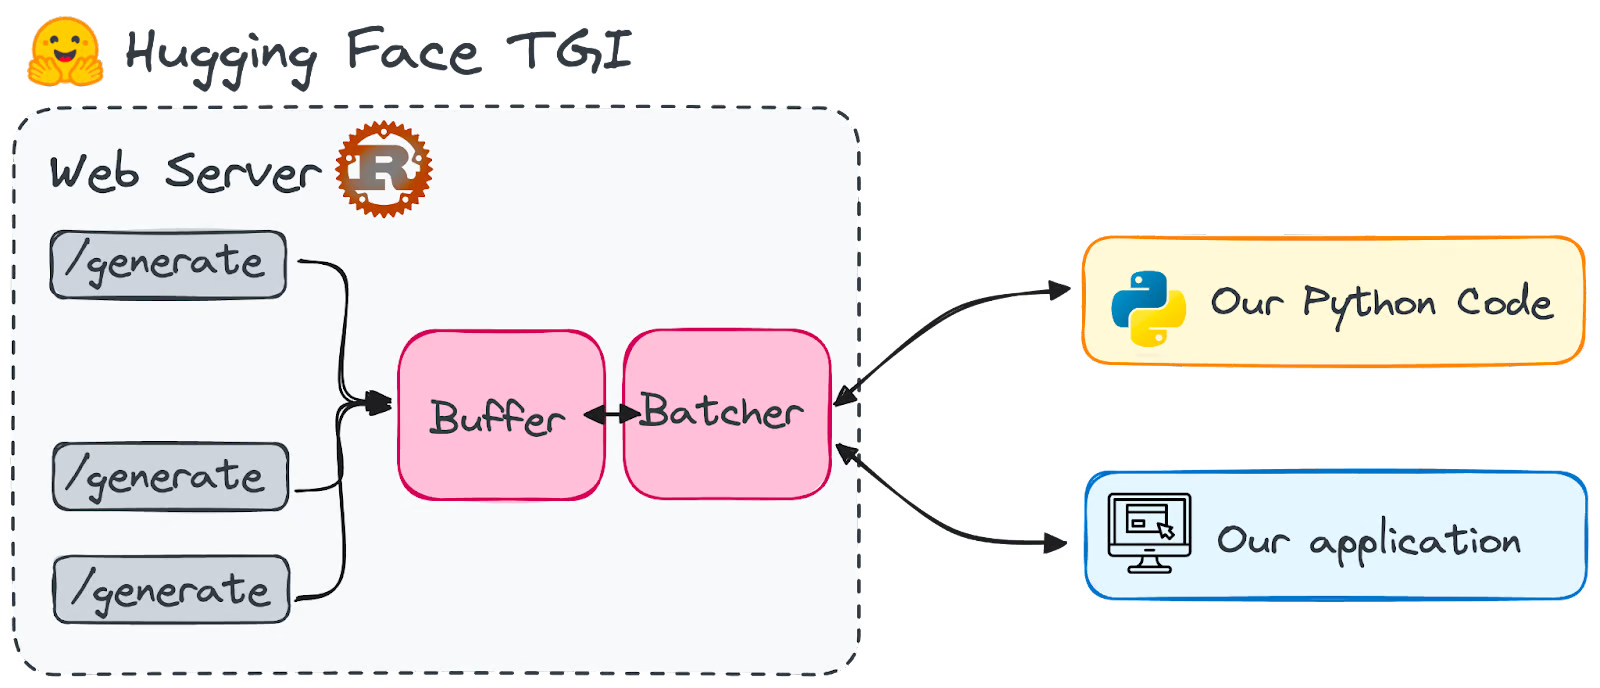
Image de l’auteur
Dans le domaine en plein essor de l’intelligence artificielle, les grands modèles de langage se sont imposés comme les acteurs majeurs des dernières avancées.
La génération de texte est devenue une capacité décisive, transformant la façon dont les machines comprennent et produisent un texte proche du langage humain. Cette popularité a donné naissance à de multiples outils pour fluidifier et faciliter le travail avec les LLM.
La multiplication rapide des grands modèles de langage (LLM), avec de nouveaux modèles qui apparaissent presque chaque semaine, a entraîné en parallèle une explosion des options d’hébergement pour cette technologie. Dans cet écosystème foisonnant, le Text Generation Inference (TGI) de Hugging Face se distingue particulièrement, car il permet d’exécuter un LLM comme un service sur votre machine locale.
En clair, il nous offre un point de terminaison pour interroger notre modèle.
Ce guide explique pourquoi Hugging Face TGI change la donne et comment l’exploiter pour créer des modèles d’IA capables de générer des textes de plus en plus difficiles à distinguer de ceux écrits par des humains.
Hugging Face Text Generation Inference, ou TGI, est un framework écrit en Rust et en Python pour déployer et servir des grands modèles de langage. C’est une boîte à outils prête pour la production pour le déploiement et la mise à disposition de LLM.
Hugging Face le développe et le distribue sous la licence HFOILv1.0, qui autorise un usage commercial à condition que l’outil soit auxiliaire au produit ou service proposé, et non son composant principal. Les principaux défis qu’il adresse sont :
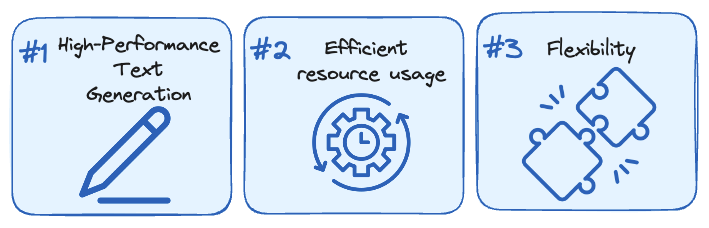
Image de l’auteur.
Hugging Face a optimisé certaines architectures de LLM pour qu’elles s’exécutent plus rapidement avec TGI. Cela inclut des modèles populaires comme LLaMA, Falcon7B et Mistral. La liste complète figure dans leur documentation.
Hugging Face est devenu la référence pour concevoir des IA à capacités de langage naturel. C’est le lieu où se rassemblent les modèles open source majeurs, en faisant une plaque tournante pour l’innovation en NLP. Jusqu’à récemment, la plupart de ces modèles étaient trop lourds pour être utilisés directement en local ; il fallait s’appuyer sur des services cloud.
Avec les avancées récentes en quantification comme QLoRa et GPTQ, certains LLM sont devenus exploitables sur nos machines du quotidien — y compris nos ordinateurs portables.
Hugging Face TGI a été conçu précisément pour fournir des LLM « as a service » sur nos machines locales. L’idée principale : éviter la lourdeur du démarrage d’un LLM.
Pour supprimer les temps morts, mieux vaut garder le modèle prêt en arrière‑plan, afin de répondre au quart de tour. Sinon, vous subissez une longue attente à chaque prompt. Imaginez disposer d’un endpoint avec une sélection des meilleurs modèles de langage, prêts à générer du texte à la demande.
Ce qui m’a séduit avec TGI, c’est sa simplicité. Aujourd’hui, TGI est prêt à l’emploi avec plusieurs architectures de modèles optimisées, ce qui permet de les déployer en un rien de temps.
Et ce n’est pas que théorique : TGI propulse déjà plusieurs projets en production. Par exemple :
Image de l’auteur. Logos de Hugging Chat (gauche) et OpenAssistant (droite)
Il y a toutefois une limite importante : TGI n’est pas encore compatible avec les Mac à GPU ARM, y compris les séries M1 et ultérieures.
Commençons par mettre en place notre point de terminaison TGI.
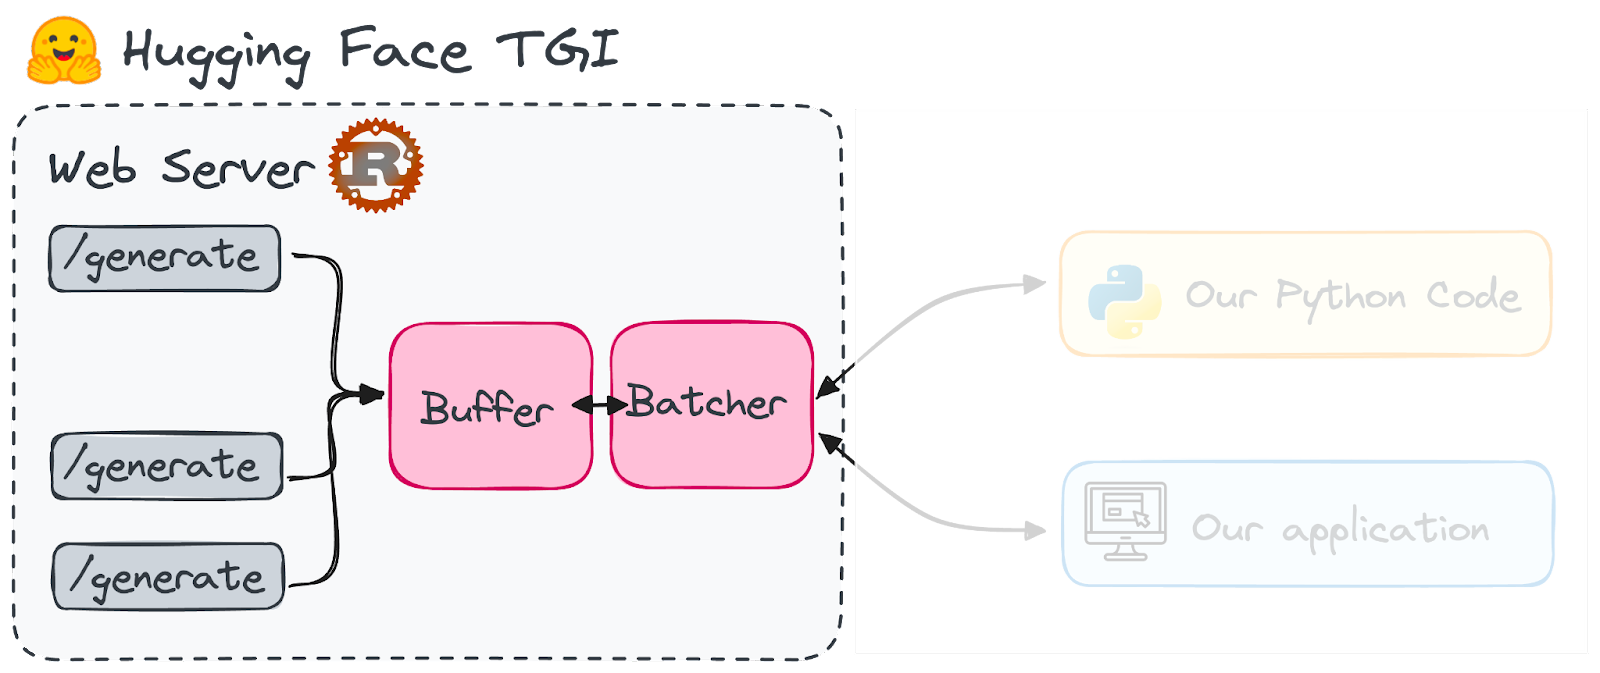
Image de l’auteur.
Pour installer et lancer TGI en local, vous devez d’abord installer Rust puis créer un environnement virtuel Python avec au moins Python 3.9, par exemple avec conda :
#Installing Rust
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh


#Creating a python virtual environment
conda create -n text-generation-inference python=3.9
conda activate text-generation-inference
Il est également nécessaire d’installer Protoc. Hugging Face recommande la version 21.12 pour une compatibilité optimale. Notez que vous aurez besoin des droits sudo pour procéder à cette installation.
PROTOC_ZIP=protoc-21.12-linux-x86_64.zip
curl -OL https://github.com/protocolbuffers/protobuf/releases/download/v21.12/$PROTOC_ZIP
sudo unzip -o $PROTOC_ZIP -d /usr/local bin/protoc
sudo unzip -o $PROTOC_ZIP -d /usr/local 'include/*'
rm -f $PROTOC_ZIP
Je commence par l’installation depuis zéro, qui n’est pas totalement triviale. Si vous rencontrez des problèmes, vous pouvez ignorer cette première partie et utiliser directement une image Docker, ce qui est plus simple. Nous verrons les deux scénarios.
Une fois les prérequis en place, vous pouvez configurer TGI. Commencez par cloner le dépôt GitHub :
git clone https://github.com/huggingface/text-generation-inference.gitEnsuite, placez‑vous dans le dossier TGI sur votre machine locale et installez‑le avec les commandes suivantes :
cd text-generation-inference/
BUILD_EXTENSIONS=False make install
Voyons maintenant comment utiliser TGI, avec et sans Docker. J’utiliserai le modèle Falcon‑7B, disponible sous licence Apache 2.0.
L’installation a créé une nouvelle commande, « text-generation-launcher », qui démarre le serveur TGI. Pour activer un point de terminaison avec le modèle Falcon‑7B, exécutez simplement :
text-generation-launcher --model-id tiiuae/falcon-7b-instruct --num-shard 1 --port 8080 --quantize bitsandbytesSignification des paramètres :
Assurez‑vous que Docker est installé et en cours d’exécution sur votre ordinateur. Si vous débutez, ce tutoriel Docker pour la data science vous donnera les bases.
Rappel : TGI n’est pas compatible avec les Mac équipés de processeurs MX. Vous pouvez consulter toutes les images TGI disponibles dans le référentiel des packages TGI sur GitHub. Si votre appareil est compatible, Docker devrait trouver l’image appropriée.
Les paramètres sont très proches de ceux de text-generation-launcher. Si vous n’utilisez qu’un seul GPU, remplacez "all" par "0".
volume=$PWD/data
sudo docker run --gpus all --shm-size 1g -p 8080:80 -v $volume:/data ghcr.io/huggingface/text-generation-inference:0.9 --model-id tiiuae/falcon-7b-instruct --num-shard 1  --quantize bitsandbytes
Veillez à laisser l’image Docker active pendant toute la durée d’utilisation du serveur.
Vous disposez de plusieurs options pour intégrer le serveur Text Generation Inference (TGI) à vos applications. Une fois lancé, vous pouvez interagir via une requête POST vers l’endpoint /generate pour récupérer les résultats.
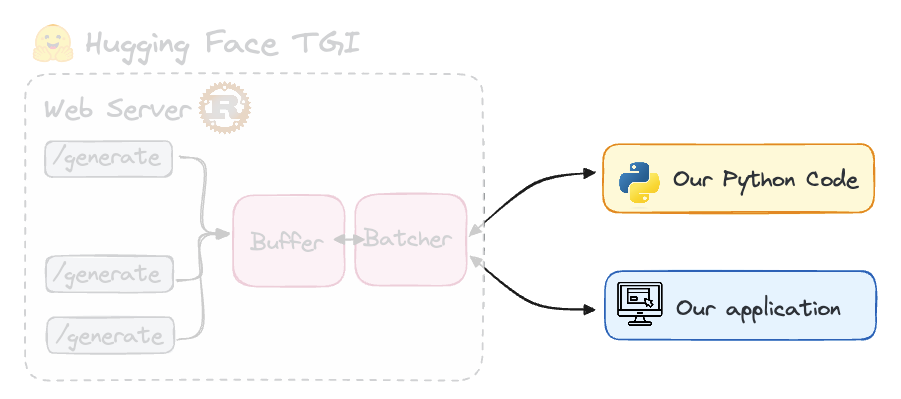
Image de l’auteur.
Si vous préférez que TGI diffuse les tokens en continu, utilisez plutôt l’endpoint de streaming, comme nous le verrons dans la section suivante. Vous pouvez effectuer ces requêtes avec l’outil de votre choix : curl, Python ou TypeScript. Pour interroger le modèle servi par TGI avec un script Python, installez la bibliothèque text-generation avec la commande pip suivante :
pip install text-generationUne fois le serveur TGI démarré, instanciez InferenceClient() avec l’URL de l’endpoint qui sert le modèle. Vous pouvez ensuite appeler text_generation() pour interroger l’endpoint depuis Python.
from text_generation import Client
client = Client("http://127.0.0.1:8080")
client.text_generation(prompt="Your prompt here!")
Pour activer le streaming avec InferenceClient, il suffit de définir stream=True. Vous recevrez alors les tokens en temps réel au fur et à mesure de leur génération côté serveur. Exemple :
for token in client.text_generation("Your prompt here!", max_new_tokens=12, stream=True):
print(token)N’oubliez pas que vous travaillez avec le modèle déployé sur votre endpoint — dans notre cas, Falcon‑7B. Avec TGI, nous créons un endpoint actif qui nous permet d’obtenir des réponses du LLM de notre choix.
Concrètement, en Python, nous pouvons envoyer directement des prompts au LLM via le client hébergé sur notre machine locale, accessible via le port 8080. Le script Python correspondant ressemble à ceci :
from text_generation import Client
client = Client("http://127.0.0.1:8080")
print(client.generate("Translate the following sentence into spanish: 'What does Large Language Model mean?'", max_new_tokens=500).generated_text)
Nous obtiendrons ainsi une réponse du modèle sans avoir à l’installer dans notre environnement. À la place de Python, nous pouvons interroger le LLM avec CURL, comme dans l’exemple suivant :
curl 127.0.0.1:8080/generate \
    -X POST \
    -d '{"inputs":"Code in Javascript a function to remove all spaces in a string and then print the string twice.","parameters":{"max_new_tokens":500}}' \
    -H 'Content-Type: application/json'
Après quelques tests, TGI se révèle très rapide. Avec Falcon‑7B (limite de 500 tokens), la réponse arrive en quelques secondes. En revanche, l’inférence « classique » (via la bibliothèque transformers) prend environ 30 secondes.
Depuis la version 1.4.0, TGI propose une API compatible avec l’API Chat Completion d’OpenAI. Cette nouvelle Messages API facilite la transition des clients et utilisateurs des modèles OpenAI vers des LLM open source. Elle est conçue pour une intégration directe avec les bibliothèques clientes d’OpenAI ou avec des outils tiers comme LangChain ou LlamaIndex.
La prise en charge des Messages par TGI garantit que ses endpoints d’inférence sont pleinement compatibles avec l’API OpenAI Chat Completion. Ainsi, vous pouvez remplacer sans effort vos scripts existants qui utilisent des modèles OpenAI par des LLM ouverts hébergés sur des endpoints TGI.
Cette mise à jour simplifie le passage à l’open source et donne immédiatement accès à de nombreux avantages, notamment :
Voici un exemple d’intégration de TGI au protocole OpenAI Chat Completion :
from openai import OpenAI

# initialize the client but point it to TGI
client = OpenAI(
    base_url="<ENDPOINT_URL>" + "/v1/",  # replace with your endpoint url
    api_key="<HF_API_TOKEN>",  # replace with your token
)
chat_completion = client.chat.completions.create(
    model="tgi",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Why is open-source software important?"},
    ],
    stream=True,
    max_tokens=500
)

# iterate and print stream
for message in chat_completion:
    print(message.choices[0].delta.content, end="")
Comme vous le voyez, la bibliothèque openai peut pointer vers notre ENDPOINT et notre mot de passe Hugging Face. Pour aller plus loin, consultez la documentation de Hugging Face TGI.
Avant de vous lancer dans Hugging Face TGI, vous devez déjà connaître les grands modèles de langage. Familiarisez‑vous avec des notions clés comme la tokenisation, les mécanismes d’attention et l’architecture Transformer. Ces bases sont essentielles pour personnaliser les modèles et affiner la génération de texte.
Apprenez à préparer et optimiser les modèles selon vos besoins : choisir le bon modèle, personnaliser les tokenizer et appliquer des techniques pour améliorer les performances sans sacrifier la qualité.
Assurez‑vous de bien comprendre le fonctionnement de Hugging Face et l’utilisation de son Hub pour le développement NLP. Un bon tutoriel d’introduction : An Introduction to Using Transformers and Hugging Face.
Le fine‑tuning est également un concept à maîtriser, car la plupart du temps les modèles doivent être adaptés à des objectifs précis. Vous pouvez apprendre à réaliser un fine‑tuning avec An Introductory Guide to Fine-Tuning LLMs
Explorez différentes stratégies de génération de texte, comme la recherche gloutonne (greedy search), la recherche par faisceaux (beam search) et l’échantillonnage top‑k. Chacune a ses avantages et limites, qui influent sur la cohérence, la créativité et la pertinence du texte généré.
La boîte à outils TGI de Hugging Face permet à chacun d’explorer la génération de texte par l’IA. Elle offre un moyen simple de déployer et d’héberger des LLM pour des applications NLP avancées nécessitant un langage naturel.
Si l’auto‑hébergement de grands modèles assure maîtrise des données et des coûts, il demande un matériel puissant. Toutefois, les dernières avancées permettent déjà d’exécuter des modèles plus compacts directement sur nos machines locales.
Si vous souhaitez progresser dans le domaine des LLM, je vous encourage vivement à suivre des tutoriels plus avancés. Commencez par le cours LLM Concepts de DataCamp, qui couvre de nombreuses méthodologies d’entraînement et les dernières recherches.
Autres ressources utiles :
Commencez votre parcours IA dès aujourd’hui !
Cours
Cours
Cursus