

प्रतिगमन के लिए confidence interval का bootstrapping
Linear regression, सांख्यिकीय मॉडलिंग का आधारस्तंभ, एक या एकाधिक स्वतंत्र चर और एक आश्रित चर के बीच संबंध को दर्शाने के लिए उपयोग होता है। प्रतिगमन मॉडलों के साथ काम करते समय, हमारे अनुमानों के आसपास की अनिश्चितता का आकलन करना सामान्य है। इसका एक तरीका linear regression के confidence interval निकालना है, जो उस दायरे को दर्शाते हैं जिसमें वास्तविक पैरामीटर, जैसे कि माध्य, आने की संभावना होती है। यहाँ, हम bootstrapping से confidence interval बनाएँगे, और सामान्य अनुमापन विधि (normal approximation method), जिसे Wald confidence interval भी कहते हैं, से भी अंतराल बनाएँगे।
Linear regression के संदर्भ में, bootstrap resampling में डेटासेट से यादृच्छिक रूप से सैम्पल लेकर कई bootstrap नमूने बनाना शामिल है। फिर हम हर नमूने पर एक प्रतिगमन मॉडल फ़िट करते हैं। अंततः, हम इन नमूनों में मॉडल गुणांकों (coefficients) के वितरण का उपयोग करके confidence interval का अनुमान लगाते हैं। निम्नलिखित कोड में, हम tidymodels पैकेज के bootstraps() फ़ंक्शन का उपयोग करके अपने डेटासेट पर bootstrap resampling करते हैं। फिर हम intercept और weight गुणांक के लिए bootstrap पुन:नमूनों में आने वाले मानों की सीमा दिखाने हेतु histogram बनाते हैं।
boots <- bootstraps(fish_df, times = 250, apparent = TRUE)fit_lm_on_bootstrap <- function(split) { lm(Height ~ sqrt_Weight, analysis(split))}boot_models <- boots %>% dplyr::mutate(model = map(splits, fit_lm_on_bootstrap), coef_info = map(model, tidy))boot_coefs <- boot_models %>% unnest(coef_info)percentile_intervals <- int_pctl(boot_models, coef_info)ggplot(boot_coefs, aes(estimate)) + geom_histogram(bins = 30) + facet_wrap( ~ term, scales = "free") + labs(title="fish", subtitle = "Height ~ Square Root of Weight") + labs(caption = "95% confidence interval parameter estimates, intercept + estimate") + geom_vline(aes(xintercept = .lower), data = percentile_intervals, col = '#528fad') + geom_vline(aes(xintercept = .upper), data = percentile_intervals, col = '#528fad')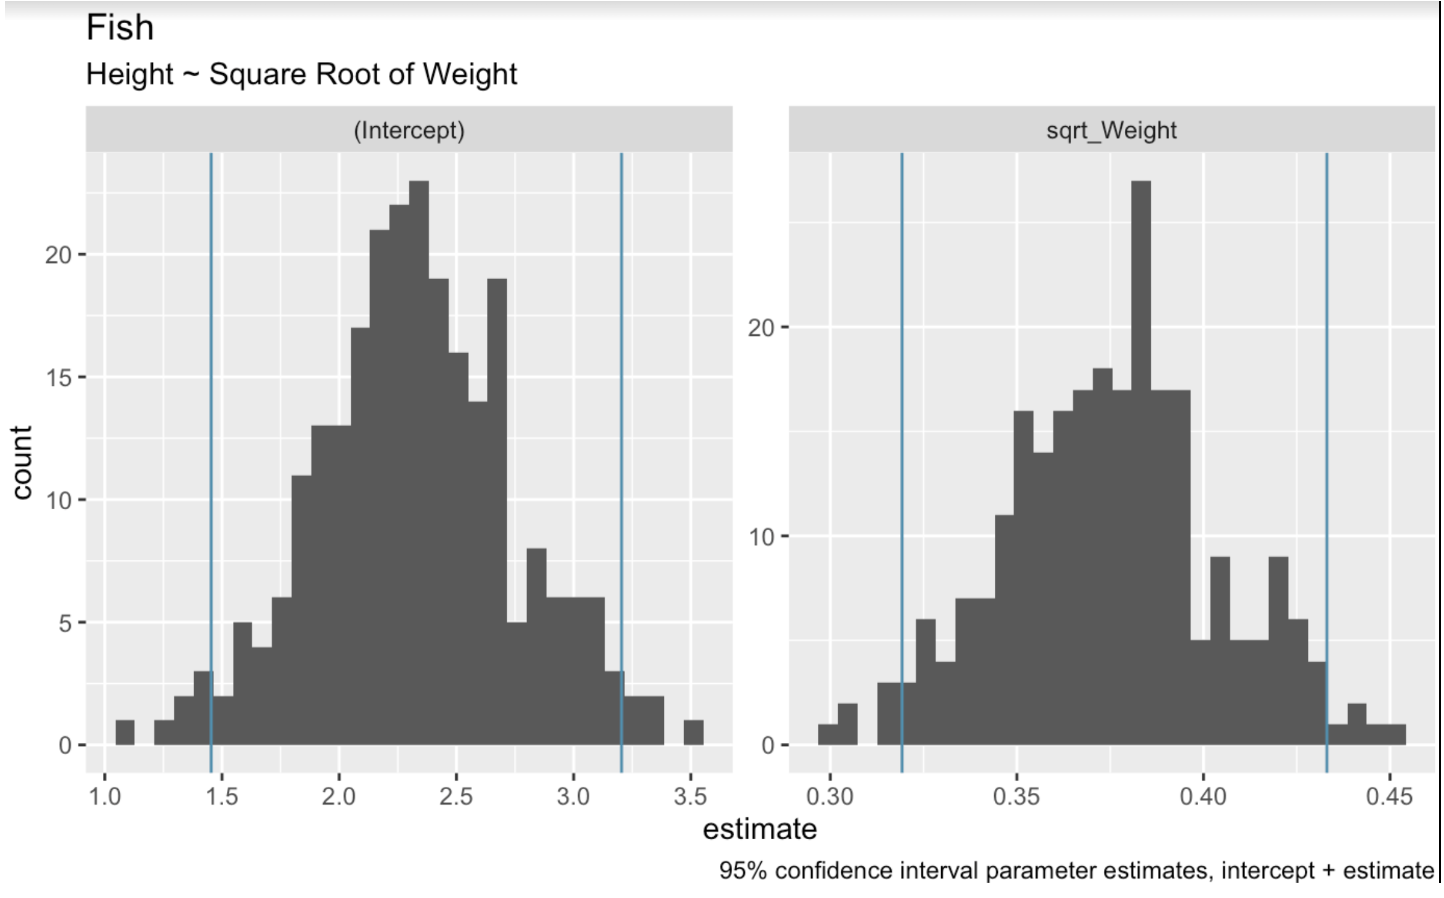
रैखिक मॉडल के bootstrapped गुणांक। चित्र: लेखक द्वारा।
जब हम संभावित प्रतिगमन रेखाओं का ग्राफ बनाते हैं, तो 95% अंतराल पाने के लिए हम दोनों सिरों पर सबसे चरम रेखाओं को काट देते हैं। int_pctl() फ़ंक्शन यह काम आसान बना देता है।
boot_aug <- boot_models %>% sample_n(50) %>% mutate(augmented = map(model, augment)) %>% unnest(augmented)boots <- bootstraps(fish_df, times = 250, apparent = TRUE)fit_lm_on_bootstrap <- function(split) { lm(Height ~ sqrt_Weight, analysis(split))}boot_models <- boots %>% dplyr::mutate(model = map(splits, fit_lm_on_bootstrap), coef_info = map(model, tidy))boot_coefs <- boot_models %>% unnest(coef_info)percentile_intervals <- int_pctl(boot_models, coef_info)boot_aug <- boot_models %>% sample_n(50) %>% mutate(augmented = map(model, augment)) %>% unnest(augmented)अंतिम चरण के रूप में, आइए अब अधिक सैद्धान्तिक, closed-form समीकरणों से उत्पन्न होने वाले confidence interval बनाएँ। हम अपने linear model ऑब्जेक्ट के summary() को कॉल करके पैरामीटर पा सकते हैं।
linear_model <- lm(Height ~ sqrt(Weight), fish_df)summary(linear_model)Call:lm(formula = Height ~ sqrt(Weight), data = fish_df)Residuals: Min 1Q Median 3Q Max-7.7425 -1.3611 -0.5628 2.2606 5.0131Coefficients: Estimate Std. Error t value Pr(>|t|)(Intercept) 2.31506 0.43636 5.305 3.77e-07 ***sqrt(Weight) 0.37569 0.02186 17.183 < 2e-16 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 2.533 on 157 degrees of freedomMultiple R-squared: 0.6529, Adjusted R-squared: 0.6506F-statistic: 295.3 on 1 and 157 DF, p-value: < 2.2e-16यहाँ, sqrt_Weight चर के लिए अनुमानित गुणांक 0.37569 है। sqrt_Weight के लिए standard error 0.02186 है। degrees of freedom 157 हैं (जो हमारे 159 अवलोकनों में से दो अनुमानित पैरामीटर घटाने पर मिलते हैं)। और 95% दो-छोर (two-tailed) confidence interval के लिए t-मूल्य 1.975189 है। यह अंतिम संख्या हमें qt() फ़ंक्शन से मिलती है: qt(0.975, 157)। नीचे के विज़ुअलाइज़ेशन में, नीली रेखाएँ bootstrapped रैखिक प्रतिगमन रेखाएँ हैं, और लाल बिंदीदार रेखाएँ सामान्य विश्लेषणात्मक सूत्र से उत्पन्न confidence interval दर्शाती हैं।
# Wald confidence interval(CI_upper <- 0.37569 + 1.975 * 0.02186)(CI_lower <- 0.37569 - 1.975 * 0.02186)(CI_intercept_upper <- 2.31506 + 1.975 * 0.43636)(CI_intercept_lower <- 2.31506 - 1.975 * 0.43636)ggplot(boot_aug, aes(sqrt_Weight, Height)) + geom_line(aes(y = .fitted, group = id), alpha = .3, col = '#528fad') + geom_point(alpha = 0.005) + labs(title="fish", subtitle = "Height ~ Weight") + labs(caption = "linear regression bootstrap resampling") + geom_abline(intercept = 1.453249, slope = 0.4188635, linetype = "dashed", color = "#e76254") + geom_abline(intercept = 3.176871, slope = 0.3325165, linetype = "dashed", color = "#e76254")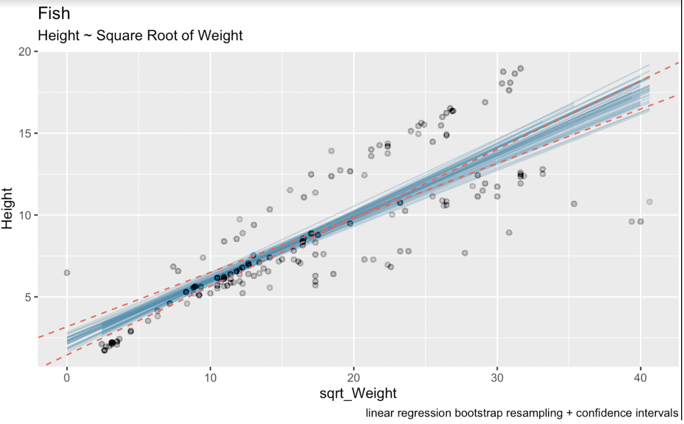
Confidence interval सहित bootstrapped रैखिक प्रतिगमन। चित्र: लेखक द्वारा।
यहाँ हम स्पष्ट रूप से देख सकते हैं कि bootstrapping resampling की प्रक्रिया ने हमारे अनुमान में थोड़ी अधिक अनिश्चितता जोड़ी है। इसका कारण यह है कि linear regression गुणांकों के अंतराल सैद्धान्तिक सूत्रों से निकाले गए थे जो त्रुटियों के वितरण और estimator के गुणों पर आधारित मान्यताओं पर टिके होते हैं—जैसे सामान्यता (normality) और स्थिर विचरण।
दूसरी ओर, bootstrap resampling वितरण-मुक्त (distribution-free) है, यानी यह आधारभूत डेटा-वितरण के बारे में न्यूनतम मान्यताएँ करता है। इसके बजाय, यह देखे गए डेटा से पुन:नमूना लेकर सीधे वांछित सांख्यिकीय मान के sampling distribution का अनुमान लगाता है। नतीजतन, जब पारंपरिक विधियों की मान्यताएँ भंग होती हैं या छोटे नमूना आकार से निपटना पड़ता है—जैसे हमारे Fish Market डेटासेट में 159 अवलोकन—तो bootstrap confidence interval अधिक robust और भरोसेमंद हो सकते हैं।
Parametric बनाम Non-Parametric Bootstrapping
Parametric bootstrapping में डेटा के आधारभूत वितरण के बारे में मान्यताएँ बनाई जाती हैं और उन्हीं के आधार पर पुन:नमूने उत्पन्न किए जाते हैं। जब आपको डेटा-वितरण के बारे में पूर्व-ज्ञान या सशक्त मान्यताएँ हों, तब यह विधि उपयोगी होती है। ऐसी सैम्पलिंग की कल्पना करें जिसका वितरण सामान्य न हो, लेकिन सैम्पलिंग के पीछे का विचार बेहतर समझा गया हो, ताकि आप जनसंख्या के पैरामीटर से एक वितरण बना सकें।
इसके विपरीत, non-parametric bootstrapping डेटा-वितरण के बारे में कोई मान्यता नहीं बनाता। यह देखे गए डेटा से प्रतिस्थापन सहित सीधे पुन:नमूना लेता है, जिससे यह तब विशेष रूप से मूल्यवान बनता है जब वास्तविक वितरण अज्ञात हो या परिभाषित करना कठिन हो। ऊपर के उदाहरण में, हमने non-parametric bootstrapping का उपयोग किया। दोनों विधियाँ standard error और confidence interval जैसे आँकड़ों का अनुमान लगाने देती हैं। हालाँकि, वास्तविक दुनिया के डेटासेट—खासकर छोटे या जटिल नमूनों—में non-parametric bootstrapping अधिक लचीला होता है और व्यवहार में अधिक प्रयुक्त होता है।
Forecasting में Bootstrapping
समय-श्रृंखला पूर्वानुमान (time series forecasting) में, bootstrapping का उपयोग ऐतिहासिक डेटा का पुन:नमूना लेकर भविष्य के पूर्वानुमान उत्पन्न करने में किया जा सकता है, जिससे एकल बिंदु-आकलन के बजाय संभावित परिणामों का वितरण मिलता है। यह संभावित भविष्य परिदृश्यों की सीमा को मॉडल करने और पूर्वानुमानों के लिए confidence interval बनाने में मदद करता है। Bootstrapping समय-श्रृंखला मॉडलों में bagging जैसे ensemble तरीकों की भी नींव है, जो कई मॉडलों को संयोजित करके overfitting घटा सकते हैं और समग्र सटीकता सुधार सकते हैं। हमारा Forecasting in R आपको समय-पूर्वानुमान में resampling करना सिखाएगा, चाहे आप ARIMA forecasting उपयोग करें या कोई अन्य विधि।
अंतिम विचार
आशा है कि यदि पहले नहीं, तो अब आप bootstrapping की सराहना करने लगे होंगे। जैसा कि हमने देखा, bootstrapping सांख्यिकी और मशीन लर्निंग—दोनों में—एक शक्तिशाली औज़ार है, और यह आधारभूत डेटा के बारे में कड़ी मान्यताओं की आवश्यकता के बिना सांख्यिकीय मापों की परिवर्तनशीलता और विश्वास का आकलन करने का रोचक तरीका प्रस्तुत करता है।
हमारा Machine Learning Scientist in Python करियर ट्रैक शुरू करने पर विचार करें और वितरण प्रकारों व जटिल डेटासेट्स के साथ काम करने में निपुण बनें। हमारा Statistical Inference in R स्किल ट्रैक भी एक उत्कृष्ट विकल्प है, जो hypothesis testing, randomization, और अनिश्चितता मापन पर केंद्रित है।

लेखक
Josef Waples
मैं एक डेटा साइंस संपादक हूँ और वैज्ञानिक पत्रिकाओं में प्रकाशित शोध लेखों में योगदान दे चुका/चुकी हूँ। मुझे विशेष रूप से रैखिक बीजगणित, सांख्यिकी, R, और इसी तरह के विषयों में रुचि है।
इस लेख में, हम सांख्यिकी और मशीन लर्निंग की एक महत्वपूर्ण तकनीक bootstrapping की पड़ताल करेंगे। Bootstrapping का नाम वाक्यांश ‘pulling yourself up by your bootstraps’ से आता है, क्योंकि यह सांख्यिकीय तकनीक कम संसाधनों से बहुत कुछ करने की क्षमता देती है। Bootstrapping के साथ, आप किसी भी आकार या रूप के वितरण से पुन:नमूनों (resamples) का नया वितरण बना सकते हैं और इस नए वितरण से वास्तविक प्रायिकता वितरण का सन्निकटन कर सकते हैं। इसी कारण, bootstrapping नमूना अनुमानों के लिए bias, variance, confidence interval, और prediction error जैसी शुद्धता की मापों को निर्धारित करने का विशेष रूप से प्रभावी तरीका है।
शुरू करने से पहले, यदि आप डेटा साइंस में रुचि रखते हैं, तो डेटा साइंस और सांख्यिकी पर ये DataCamp पाठ्यक्रम देखें, जैसे हमारा Statistical Inference in R स्किल ट्रैक और हमारा Foundations of Inference in Python पाठ्यक्रम।
Bootstrapping और अन्य Resampling विधियाँ
आइए resampling विधियों के बीच bootstrapping को सही संदर्भ में रखें। भले ही resampling के अलग-अलग प्रकार हों, उन सबमें एक महत्वपूर्ण बात समान होती है: वे सैम्पलिंग प्रक्रिया की नकल करते हैं। हम resampling इसलिए उपयोग करते हैं क्योंकि लक्षित जनसंख्या से बार-बार नए नमूने लेना व्यावहारिक नहीं होता, और resampling एक तरह का शॉर्टकट है।
उदाहरण के लिए, जब हम अपनी लक्षित जनसंख्या के बारे में कुछ समझना चाहते हैं, तो हम एक सर्वे चलाने और हज़ार प्रतिक्रियाओं की आशा करने पर विचार कर सकते हैं। लेकिन कोई भी एक ही सर्वे को लक्षित जनसंख्या में हज़ार बार नहीं चलाएगा। इसी व्यावहारिक सीमा के कारण हम resampling विधि का उपयोग करते हैं ताकि अपने नमूने से standard error जैसे आँकड़े उत्पन्न कर सकें।
Resampling विधियों के प्रकार
Resampling की चार मुख्य विधियाँ हैं। इनका उल्लेख इसलिए उपयोगी है क्योंकि ये सांख्यिकीय नवाचार और सुधार के साझा इतिहास से जुड़ी हैं। खास तौर पर, bootstrapping को jackknife विधि के विस्तार, संशोधन या सुधार के रूप में विकसित किया गया है।
Jackknife बनाम Bootstrap विधि
Jackknife पर विशेष रूप से बात करना उपयोगी है क्योंकि यह bootstrapping का पूर्ववर्ती है, और bootstrapping को jackknife के विस्तार और सुधार के रूप में पेश किया गया था—ऐसे समय में जब 1950 के दशक में कंप्यूटर के पास करीब एक किलोबाइट मेमोरी होती थी।
Jackknife एक leave-one-out resampling विधि है जो रुचिकर सांख्यिकीय मान की गणना करती है; यह क्रमिक/पुनरावृत्त रूप से ऐसा करती है जब तक कि हर अवलोकन एक बार हटा न दिया जाए। Jackknife में पुन:नमूनों की संख्या अवलोकनों की संख्या तक सीमित होती है, और मुख्यतः इसी कारण छोटे नमूना आकार के साथ इसका प्रदर्शन कुछ कमजोर हो सकता है। Jackknife डेटा के प्रकारों के संदर्भ में भी कुछ सीमित है। दूसरी ओर, bootstrap के विपरीत, jackknife हर बार पुनरुत्पादन योग्य (reproducible) होता है।
Bootstrapping के उपयोग
Bootstrapping के सांख्यिकी और मशीन लर्निंग—दोनों में—विस्तृत उपयोग हैं। इसका एक आम उपयोग तब होता है जब आधारभूत वितरण अज्ञात हो या नमूना आकार छोटे हों, तब confidence interval का अनुमान लगाना। इस क्षमता के कारण, जब परंपरागत पैरामीट्रिक विधियाँ उपयुक्त नहीं होतीं, bootstrapping विशेष रूप से मूल्यवान बन जाता है।
इसके अलावा, bootstrapping का उपयोग अक्सर hypothesis testing और मॉडल वैधता में किया जाता है, जहाँ यह मॉडल की भविष्यवाणियों की मजबूती का मूल्यांकन करने में मदद करता है। मशीन लर्निंग में, bootstrapping लोकप्रिय ensemble विधि bagging की नींव है, जिसका उपयोग random forests जैसे मॉडलों में variance को घटाकर सटीकता बढ़ाने के लिए किया जाता है।
Bootstrap Resampling कैसे करें
Bootstrapping को प्रदर्शित करने के लिए, हमें R जैसी प्रोग्रामिंग भाषा की ज़रूरत होगी क्योंकि यह हमें कई पुन:नमूनित डेटासेट बनाने देती है; प्रोग्रामिंग परिवेश के बिना यह प्रक्रिया मैन्युअल रूप से करने के लिए बहुत समय लेने वाली और जटिल होगी। इस लेख में, हम Kaggle के Fish Market डेटासेट का उपयोग करके किसी वितरण और एक रैखिक प्रतिगमन (linear regression) के confidence interval को bootstrap करेंगे।
प्रतिस्थापन सहित और बिना प्रतिस्थापन सैम्पलिंग
Bootstrapping पर जाने से पहले, प्रतिस्थापन सहित सैम्पलिंग की धारणा से परिचित होना उपयोगी है। यहाँ base R का
sample()फ़ंक्शन कम से कम दो तर्क लेता है जिन्हें कॉल में स्पष्ट रूप से सेट करना होता है:xऔरsize।xयह तय करता है कि हम किन मानों की सूची/सीमा से नमूना ले रहे हैं औरsizeनमूने का आकार तय करता है। एक अतिरिक्त तर्कreplaceभी अक्सर स्पष्ट रूप से सेट किया जाता है। अन्यथा, डिफ़ॉल्ट रूप सेreplace = FALSEरहता है।Bootstrapping प्रतिस्थापन के साथ सैम्पलिंग है। जब हम प्रतिस्थापन सहित सैम्पलिंग करते हैं, तो हर ड्रॉ के बाद मान को वापस रख दिया जाता है। इसलिए प्रत्येक ड्रॉ उससे पहले आए मान से स्वतंत्र होता है। बिना प्रतिस्थापन सैम्पलिंग में हम मानों को वापस नहीं रखते, इसलिए एक बार चयनित मान दोबारा नहीं चुना जा सकता; अतः दो सैम्पल मान स्वतंत्र नहीं होते, और एक ड्रॉ का परिणाम अगले ड्रॉ की संभावनाओं को प्रभावित करता है। इसका परिणाम यह है कि जब तक हम
replace = TRUEन दें, हम इनपुट वेक्टर के आकार से बड़ा सैम्पल नहीं ले सकते। Bootstrapping में यह समस्या नहीं आती, और हम अपने मूल से कहीं बड़ा bootstrapped पुन:नमूनित डेटासेट बना सकते हैं।किसी वितरण के लिए confidence interval का bootstrapping
अब अपना डेटासेट डाउनलोड करें और
read.csv()फ़ंक्शन का उपयोग करके इसे Downloads फ़ोल्डर से RStudio में पढ़ें।शुरुआत में, वितरण देखने के लिए मछलियों के वज़न के वर्गमूल का histogram बनाएँ। जैसा कि हम देख सकते हैं, यह वितरण सामान्य या Gaussian वितरण से काफी अलग है। यदि कुछ कहा जाए तो यह कुछ हद तक द्विशृंगी (bimodal) प्रतीत होता है।
मछलियों के वज़न का histogram। चित्र: लेखक द्वारा।
हम R में
tidymodelsलाइब्रेरी केinferपैकेज का उपयोग करके bootstrap कर सकते हैं। इस तालिका को कंसोल पर प्रिंट करने से हर replicate के लिए वांछित सांख्यिकीय मानों का data frame मिलता है। जब हम इन replicates का नया वितरण बनाते हैं, तो यह वितरण सामान्य (normal) होगा, जिससे हम confidence interval बना सकते हैं।