
कोर्स
Introduction to Regression in R
4 घंटा
78.8K
यदि मैं एक ऐसी चीज़ की सिफारिश कर सकूँ जिसे गहराई से सीखना आपको एक बेहतर डेटा विश्लेषक या डेटा वैज्ञानिक बना दे, तो वह होगी regression. और regression सीखने का एक अहम हिस्सा है यह समझना कि heteroscedasticity वास्तव में क्या है।
इस लेख में, हम heteroscedasticity की घटना को देखेंगे, जानेंगे कि यह क्यों महत्वपूर्ण है, इसे कैसे पहचाना जाए, और इसे संबोधित करने के कदम क्या हैं। मैं व्यापक रहूँगा पर तेज़ी से आगे बढ़ूँगा। तो, चाहे आप एक अनुभवी विश्लेषक हों या अभी शुरुआत कर रहे हों, मुझे उम्मीद है कि यहाँ आपको कुछ दिलचस्प और उपयोगी मिलेगा। अधिक जानकारी के लिए और विशेषज्ञ बनने की राह पर चलने के लिए, हमारा Intro to Regression in R कोर्स या हमारा Intro to Regression in Python लें। यदि आपको त्वरित पुनरावृत्ति चाहिए, तो मेरे पास simple linear regression पर एक ट्यूटोरियल भी है।
तो heteroscedasticity आखिर है क्या? उदाहरण देखने से पहले तकनीकी परिभाषाएँ स्पष्ट कर लेते हैं। यदि यह शब्द बोलने में कठिन लगता है, तो आप सरलता से “असमान वैरिएंस” कह सकते हैं और बात समझ आ जाएगी।
Heteroscedasticity उस स्थिति को संदर्भित करता है जिसमें आश्रित चर की परिवर्तनीयता, स्वतंत्र चर के मानों की श्रेणी में, समान नहीं होती। या, मॉडल-निर्माण पर अधिक केंद्रित परिभाषा में, heteroscedasticity तब होता है जब अवशेषों का फैलाव या प्रकीर्णन स्थिर नहीं होता, जैसा कि हम कभी-कभी regression या time series जैसे मॉडलों में देखते हैं।
किसी अर्थ में, मुझे दूसरी परिभाषा अधिक पसंद है क्योंकि यह हमें याद दिलाती है कि heteroscedasticity वास्तव में सांख्यिकीय मॉडलिंग का एक सामान्य पहलू (हालाँकि एक आम समस्या भी) है। लेकिन स्पष्ट रहे, जबकि heteroscedasticity पर सबसे अधिक चर्चा regression जैसे मॉडलों के संदर्भ में होती है, यह मॉडल विनिर्देशन की विशेषता भी हो सकती है या स्वयं डेटा का गुण भी।
आइए R का उपयोग करके कुछ उदाहरण देखते हैं और एक क्षेत्र चुनते हैं—जैसे, घरेलू वित्त। For starters, मैं वह क्लासिक फ़नल या फैन आकार दिखाऊँगा जो मुझे व्यक्तिगत रूप से असमान वैरिएंस के बारे में सोचते समय सबसे पहले याद आता है।
Heteroscedasticity का यह संस्करण, उदाहरण के लिए, आय बनाम खर्च के डेटा में हो सकता है: कम-आय वाले परिवारों का मासिक खर्च अक्सर किराया और भोजन जैसी आवश्यकताओं पर केंद्रित और अपेक्षाकृत स्थिर होता है, जिससे निम्न परिवर्तनीयता मिलती है; दूसरी ओर, उच्च-आय वाले परिवारों में खर्च में अधिक विविधता हो सकती है क्योंकि उच्च-आय वाले कुछ घर महंगी वैकल्पिक खरीद जैसे छुट्टियाँ या लग्ज़री आइटम चुनते हैं, जबकि अन्य बचत करते हैं। तो, इस उदाहरण में, जैसे-जैसे आय बढ़ती है, मासिक खर्च में परिवर्तनीयता भी बढ़ती है, इसलिए फैन आकार बनता है।
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)y_inverse_funnel <- x + rnorm(length(x), mean = 0, sd = (1 / x) * 20)y_cyclical <- x + rnorm(length(x), mean = 0, sd = 10 * abs(sin(x / 5)))heteroscedasticity_data <- data.frame(x, y_funnel, y_inverse_funnel, y_cyclical)library(ggplot2)ggplot(heteroscedasticity_data, aes(x = x, y = y_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Funnel Shape", x = "X Values", y = "Y Values" )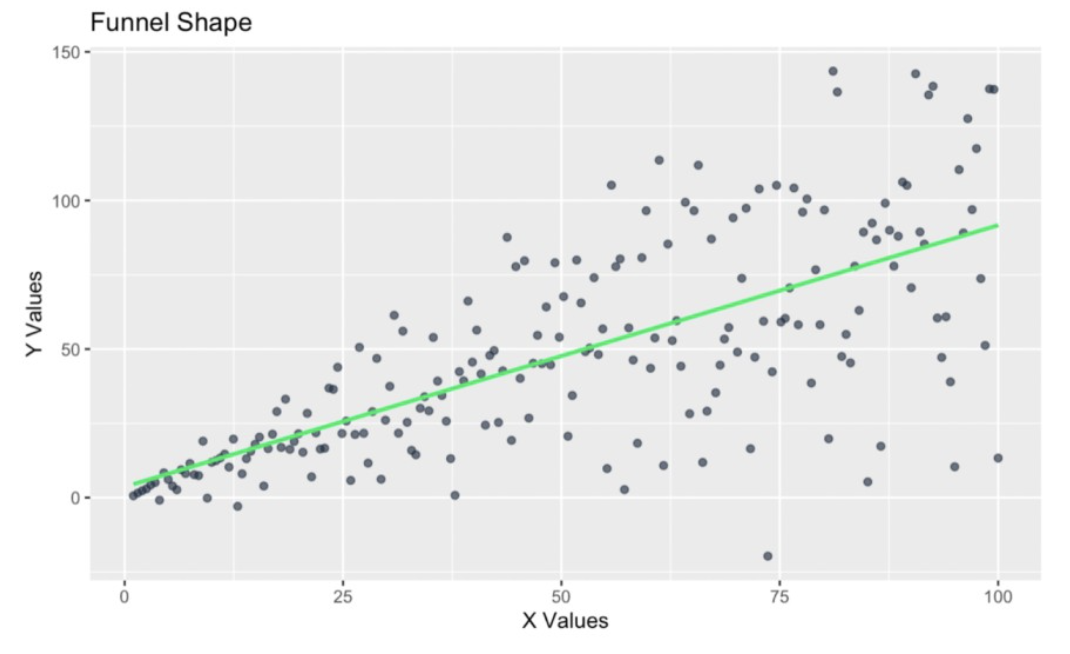
अवशेषों में फ़नल-आकार। चित्र: लेखक
आइए एक और उदाहरण आज़माएँ, यह भी घरेलू वित्त के क्षेत्र में। कल्पना करें कि अब हम एक regression मॉडल बना रहे हैं जो बचत की परिवर्तनीयता को घर के सदस्यों की आयु के साथ दिखाता है।
हमें संदेह है कि यह डेटा heteroscedasticity दिखाएगा क्योंकि कम उम्र के घरों में अनियमित आय (जैसे गिग वर्क और इंटर्नशिप) या अप्रत्याशित खर्च (जैसे छात्र ऋण या परिवार की शुरुआत) के कारण बचत में उच्च परिवर्तनीयता हो सकती है। लेकिन जैसे-जैसे घरों की उम्र बढ़ती है और वित्तीय रूप से स्थिरता आती है, बचत का व्यवहार अधिक सुसंगत हो जाता है, जिससे एक उल्टे फ़नल का आकार बनता है जहाँ आयु के साथ परिवर्तनीयता घटती है।
ggplot(heteroscedasticity_data, aes(x = x, y = y_inverse_funnel)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Inverse Funnel Shape", x = "X Values", y = "Y Values" )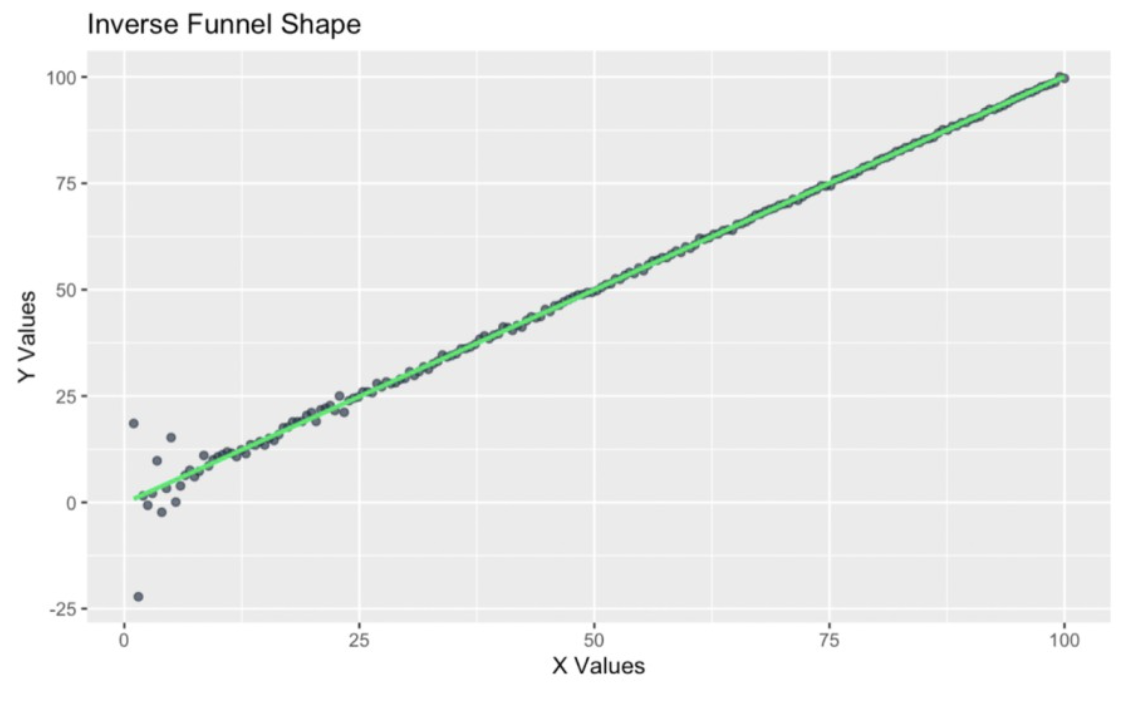
अवशेषों में उल्टा फ़नल-आकार। चित्र: लेखक
आइए घरेलू आय के साथ अंतिम उदाहरण देखें। यहाँ, हम चक्रीय वैरिएंस देख रहे हैं, विशेष रूप से ऋतुओं के अनुसार खर्च की परिवर्तनीयता। आप इस तरह का पैटर्न पहचान सकते हैं यदि आपने हमारे लोकप्रिय Forecasting in R जैसे किसी forecasting कोर्स में हिस्सा लिया है।
हम जानते हैं कि घरेलू खर्च अक्सर वर्ष भर चक्रीय रूप से उतार-चढ़ाव करता है। उदाहरण के लिए, अवकाश सीज़न में वैरिएंस बढ़ सकता है क्योंकि हम उपहार खरीदते हैं या परिवार से मिलने यात्रा करते हैं, और कम छुट्टियों वाले अन्य महीनों—शायद मार्च या सितंबर—में वैरिएंस घट जाता है। निम्नलिखित ग्राफ heteroscedasticity दिखाता है, पर अधिक जटिल तरीके से, जहाँ यह विभिन्न अवधियों में बढ़ता-घटता है।
ggplot(heteroscedasticity_data, aes(x = x, y = y_cyclical)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs( title = "Cyclical Pattern", x = "X Values", y = "Y Values" )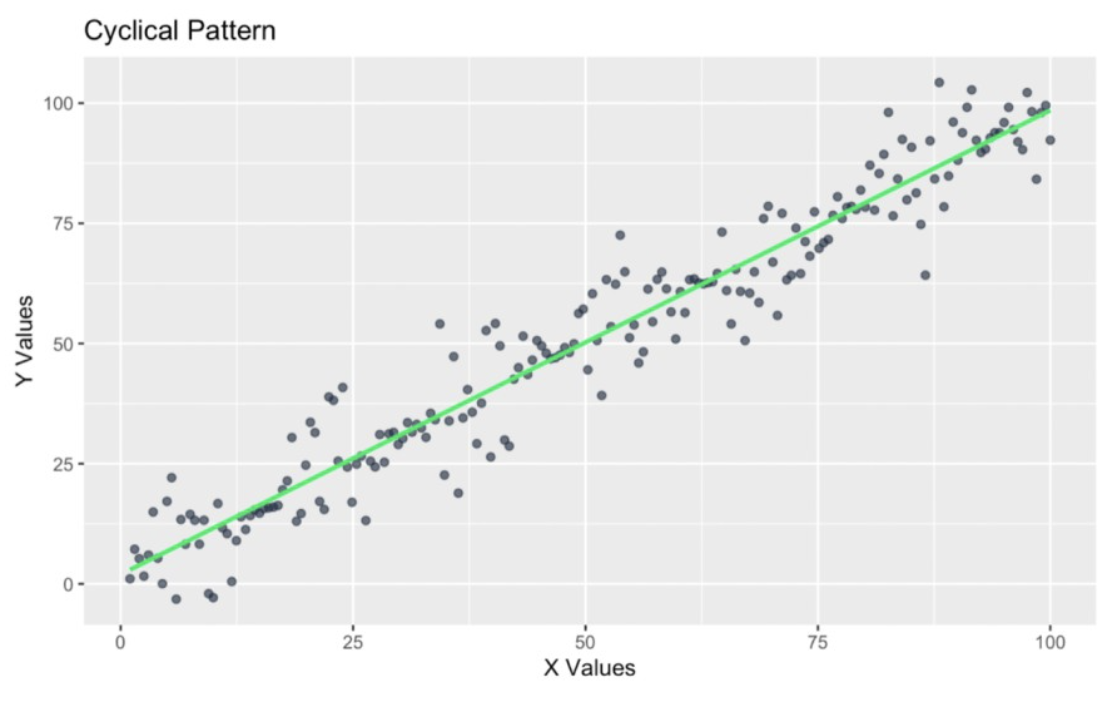
अवशेषों में चक्रीय पैटर्न। चित्र: लेखक
तो, जैसा कि आप देख सकते हैं, heteroscedasticity कई रूप ले सकता है। अब देखते हैं कि यह सब क्यों मायने रखता है।
मैं यह कहने का साहस करूँगा कि सामान्यतः, heteroscedasticity के बारे में कुछ समझे बिना आप regression सही ढंग से नहीं कर सकते, क्योंकि heteroscedasticity बहुत आम है और हमारे नतीजों को काफी हद तक विकृत कर सकता है।
शायद इसी वजह से homoscedasticity—जो heteroscedasticity का विपरीत है—वास्तव में regression मॉडल की मुख्य धारणाओं में से एक है, साथ ही linearity, independence of errors, normality of residuals, और absence of multicollinearity के साथ।
ये regression धारणाएँ इसलिए मायने रखती हैं क्योंकि ये सुनिश्चित करने में मदद करती हैं कि हमारे मॉडल की भविष्यवाणियाँ और निष्कर्ष सार्थक हों। जब ये धारणाएँ टूटती हैं, तो हमारे आकलनों की विश्वसनीयता—जिनमें standard errors और confidence intervals शामिल हैं—कमज़ोर हो सकती है, और हमारे hypothesis tests कम मान्य होते हैं।
Heteroscedasticity यूँ ही नहीं आ जाती। इसकी जड़ें अक्सर इस बात में होती हैं कि डेटा कैसे एकत्र किया गया या कैसे रूपांतरित किया गया। आइए डेटा रूपांतरण से जुड़े मुद्दे और डेटा संग्रह से जुड़े मुद्दे—दोनों देखें।
कभी-कभी, डेटा तैयार करने के लिए उठाए गए कदम ही heteroscedasticity ला देते हैं। मेरा इशारा अनुचित स्केलिंग या nonlinear रूपांतरणों की ओर है, जो अनचाही परिवर्तनीयता पैदा कर सकते हैं।
इसे समझने के लिए कल्पना करें कि हम किसी अपार्टमेंट के आकार और उसके मासिक किराए के बीच संबंध का अध्ययन कर रहे हैं। सामान्यतः, हम आकार और किराए के बीच एक रैखिक संबंध की अपेक्षा कर सकते हैं क्योंकि बड़े अपार्टमेंट का किराया अधिक होता है, और वैरिएंस आवश्यक नहीं कि आकार के साथ बढ़े, क्योंकि संबंध (हो भी सकता है) समानुपाती। यह कुछ इस प्रकार दिख सकता है:
set.seed(1024)size <- runif(1000, 500, 2000) # Random sizes between 500 and 2000 sq ftrent <- 20 * size + rnorm(100, mean = 0, sd = 5000) # Linear relation with added noiseunequal_variance_df <- data.frame(size = size, rent = rent)ggplot(unequal_variance_df, aes(x = size, y = rent)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent", x = "Size (sq ft)", y = "Rent")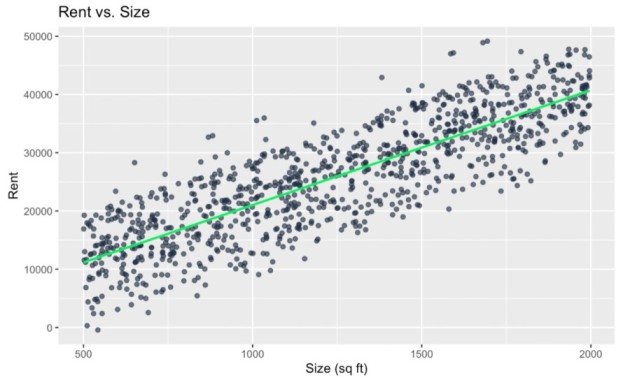
कोई heteroscedasticity नहीं। चित्र: लेखक
यदि हम किराए को आकार से स्केल करके "प्रति वर्ग फुट किराया" निकालते हैं, तो हम एक नया मीट्रिक बनाते हैं। यदि हम फिर प्रति वर्ग फुट किराए की भविष्यवाणी किराए से करने की कोशिश करें, तो दिख सकता है कि यह रूपांतरण heteroscedasticity पैदा करता है या बढ़ाता है। स्पष्ट कर दूँ, सामान्यतः, मैं मानता हूँ कि यह अच्छा विचार नहीं है—स्वतंत्र चर को आश्रित चर से भाग देना—क्योंकि हम ऐसी स्थिति बनाते हैं जहाँ y पहले से x से प्रभावित है और हम एक spurious correlation बना रहे हैं। तो, मैं मानता हूँ कि इससे वैचारिक और सांख्यिकीय चुनौतियाँ पैदा होती हैं। लेकिन (थोड़ा साथ दें) मैं यहाँ बिंदु समझाने के लिए इसे उदाहरण के रूप में ले रहा हूँ:
unequal_variance_df$rent_per_sqft <- unequal_variance_df$rent / unequal_variance_df$sizeggplot(unequal_variance_df, aes(x = size, y = rent_per_sqft)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size vs. Rent per Square Foot", x = "Size (sq ft)", y = "Rent per Sq Ft")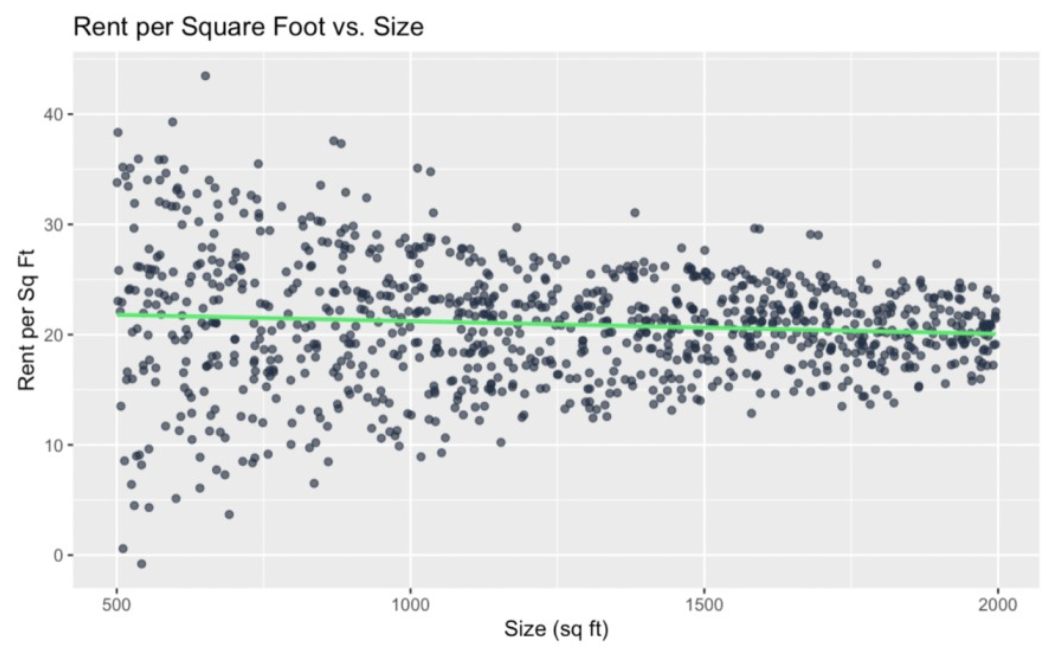
फंक्शनल निर्भरता के कारण उत्पन्न heteroscedasticity। चित्र: लेखक
हम देखते हैं कि इस ग्राफ में फ़नल आकार है जहाँ जैसे-जैसे आकार बढ़ता है, प्रति वर्ग फुट किराए की परिवर्तनीयता घटती है। यानी, हमने शून्य से heteroscedasticity बना दी। एक और उदाहरण के लिए, हम दोनों चरों का वर्ग कर सकते हैं:
unequal_variance_df$size_squared <- unequal_variance_df$size^2ggplot(unequal_variance_df, aes(x = size ^ 2, y = rent ^ 2)) + geom_point(color = '#203147', alpha = 0.7) + geom_smooth(method = "lm", color = '#01ef63', se = FALSE) + labs(title = "Size Squared vs. Rent Squared", x = "Size Squared", y = "Rent Squared")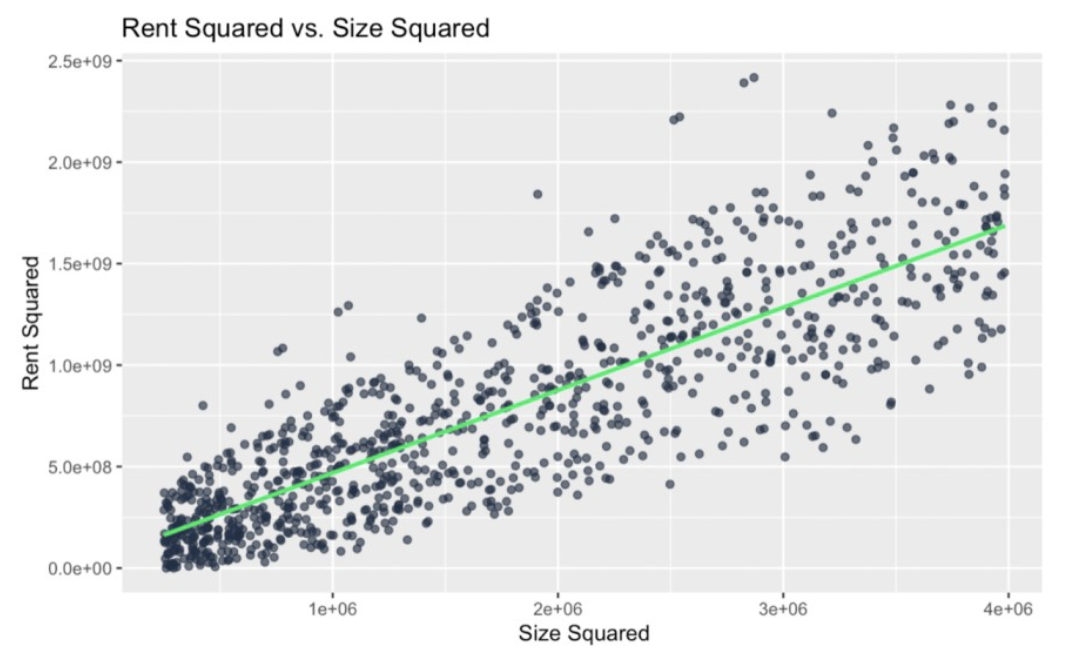
स्क्वेरिंग के परिणामस्वरूप उत्पन्न heteroscedasticity। चित्र: लेखक
फिर से, हमने वहाँ heteroscedasticity बना दी जहाँ पहले नहीं थी, क्योंकि हमने ज़िद करके x और y, दोनों का वर्ग कर दिया। कुछ संदर्भों में यह ठीक होता, पर यहाँ मुझे संदेह था कि दोनों चरों का वर्ग करने से heteroscedasticity बनेगी, क्योंकि रूपांतरण, मानों के बढ़ने पर वैरिएंस के अंतरों को और बढ़ा देता है।
यह दूसरा उदाहरण भी थोड़ा बनावटी है क्योंकि हमें ऐसा मॉडल बनाना ही नहीं चाहिए। हम ऐसा मॉडल इसलिए नहीं बनाते क्योंकि इसे बिना वजह समझना कठिन होगा। लेकिन, वास्तविक दुनिया के मॉडलिंग वर्कफ़्लो में, जो रूपांतरण अनजाने में heteroscedasticity पैदा करते हैं, वे अधिक सूक्ष्म हो सकते हैं। यदि प्रक्रिया में कई चरण हों, तो आप इसे नज़रअंदाज़ कर सकते हैं।
और सटीक रूप से, इस मामले में, heteroscedasticity feature engineering में ratios के कारण हुई है। "प्रति वर्ग फुट किराया" जैसे ratio वास्तव में feature engineering में आम हैं। हालाँकि, यदि विशेष रूप से हर (denominator) अवलोकनों में काफ़ी बदलता है, तो ये चर heteroscedasticity ला सकते हैं। variance को स्थिर करने या संबंधों को रैखिक करने के लिए लघुगणक (log) या घातीय (exponential) रूपांतरण भी अक्सर उपयोग किए जाते हैं। हालाँकि, इन्हें असंगत रूप से लागू करना उल्टा पड़ सकता है। मान लीजिए आपके पास ऐसा मॉडल है जहाँ आप आय पर log-रूपांतरण करते हैं, लेकिन संबंधित सुविधाओं जैसे व्यय को समायोजित करने में विफल रहते हैं। इस तरह का बेमेल heteroscedasticity का एक आम स्रोत है, इसलिए सुनिश्चित करें कि सब कुछ संरेखित हो ताकि आप झूठी गतिशीलताएँ उत्पन्न न करें।
Heteroscedasticity असंगत डेटा संग्रह प्रथाओं से भी उत्पन्न हो सकती है। उदाहरण के लिए, अध्ययन के बीच में माप उपकरण बदल देना heteroscedasticity ला सकता है। किसी अध्ययन में अलग-अलग आकार के समूह और इस प्रकार अलग-अलग नमूना आकार होना भी heteroscedasticity बना सकता है। एक ही दृष्टिकोण पर टिके रहना मायने रखता है।
Heteroscedasticity की पहचान करना इसे संबोधित करने की पहली सीढ़ी है, और सौभाग्य से, इसमें मदद के लिए दृश्य और सांख्यिकीय दोनों उपकरण मौजूद हैं।
स्कैटर प्लॉट आपके डेटा में वे पैटर्न दिखा सकते हैं जो heteroscedasticity उजागर करने में सहायक हों। मुझे इसके लिए fitted values बनाम residuals प्लॉट पसंद है। ध्यान दें, अवशेषों का histogram या residual q-q plot heteroscedasticity का पता लगाने के लिए पर्याप्त नहीं है, क्योंकि ये दोनों प्लॉट वास्तव में normality जाँचने के लिए सर्वश्रेष्ठ हैं।
y_funnel <- x + rnorm(length(x), mean = 0, sd = x * 0.5)heteroscedasticity_data <- data.frame(x, y_funnel)unequal_variance_model <- lm(y_funnel ~ x, heteroscedasticity_data)fitted_values_vs_residuals <- ggplot(data = unequal_variance_model, aes(x = .fitted, y = .resid)) + geom_point(color = '#203147') + geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) + xlab("fitted values") + ylab("residuals") + labs(title = "Heteroscedasticity Data") + labs(subtitle = "Fitted Values vs Residuals")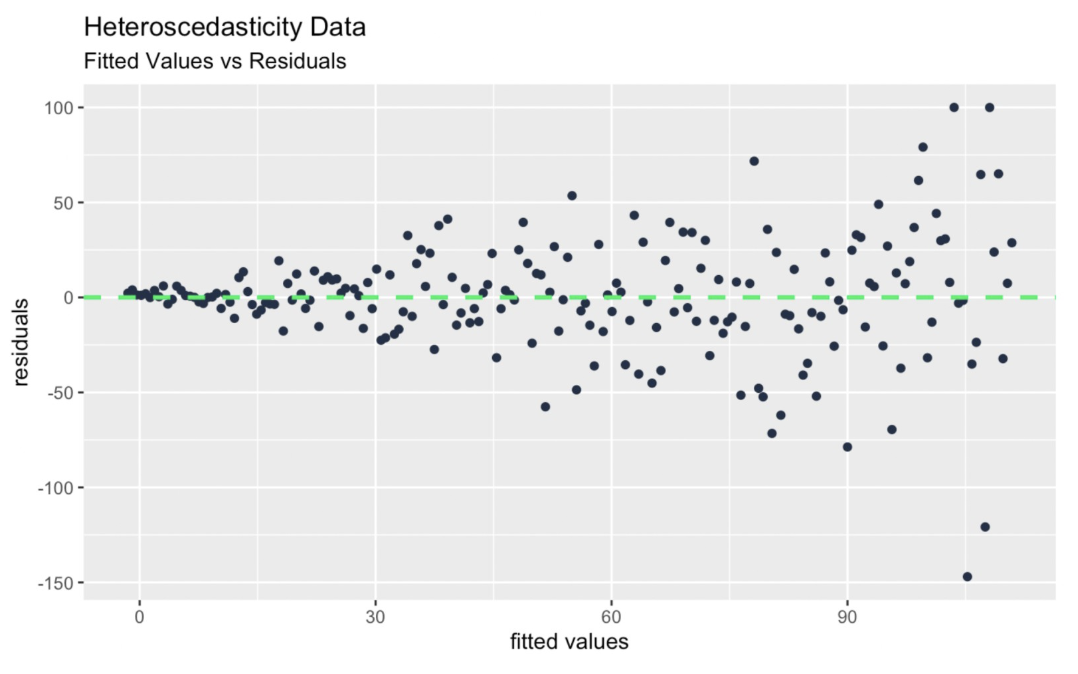 Fitted values बनाम residuals का नैदानिक प्लॉट। चित्र: लेखक
जैसे Breusch-Pagan परीक्षण जैसे सांख्यिकीय परीक्षण अधिक मात्रात्मक दृष्टिकोण प्रदान करते हैं। Breusch-Pagan मॉडल से प्राप्त वर्ग अवशेषों और प्रेडिक्टर्स के बीच संबंध देखकर काम करता है। परीक्षण करने के लिए, हम अपना मॉडल फिट करते हैं और lmtest लाइब्रेरी के bptest() फ़ंक्शन का उपयोग करते हैं। जान लें कि यह परीक्षण अवशेषों की normality मानता है।
library(lmtest)model <- lm(rent ~ size, data = unequal_variance_df)bp_test <- bptest(model)print(bp_test)एक बार जब आपने heteroscedasticity की पहचान कर ली, अगला कदम है इसे आज़माए हुए तरीकों से सुलझाना।
सरल रूपांतरण, जैसे logarithms लगाना, अक्सर heteroscedasticity को घटा या समाप्त कर सकते हैं। पहले, हमने बिना असमान वैरिएंस वाले मॉडल पर रूपांतरण लगाए और समस्याएँ पैदा कीं, लेकिन स्वाभाविक रूप से उल्टा वर्कफ़्लो अधिक होता है: हम logarithms, square roots, या reciprocals जैसे रूपांतरणों का उपयोग बड़े मानों को संकुचित और छोटे मानों को विस्तृत करने के लिए करते हैं। उदाहरण के तौर पर, यदि आकार के साथ किराया घातीय रूप से बढ़ता, तो किराए का log लेना उस घातीय वृद्धि को समतल कर देता और संबंध को (शायद) समान वैरिएंस के साथ रैखिक बना देता।
साथ ही, मैं यह इंगित करना चाहता हूँ कि डेटा प्रेप करते समय, हम अक्सर skewness ठीक करने के बारे में सोचते हैं। उदाहरण के लिए, यदि हमारे पास दाएँ-तरफ़ा skewed डेटा है, तो हम डेटा को Gaussian बनाने के लिए square root रूपांतरण का उपयोग कर सकते हैं। लेकिन जो हम उतना नहीं सराहते, वह यह है कि skewed डेटा में बड़े मानों में अक्सर अधिक परिवर्तनीयता भी होती है, जो homoscedasticity की धारणाओं का भी उल्लंघन है।
जब रूपांतरण पर्याप्त न हों, तो weighted least squares (WLS) जैसी मज़बूत regression विधियाँ मदद कर सकती हैं। Weighted least squares यहाँ विशेष रूप से रोचक है क्योंकि यह heteroscedasticity और outliers जैसी डेटा समस्याओं को संभालने के लिए डिज़ाइन किया गया है। विशेष रूप से, WLS अवलोकनों को उनके वैरिएंस के आधार पर वज़न देता है, जिससे अधिक परिवर्तनीयता वाले डेटा बिंदुओं के प्रभाव को कम किया जा सके, और इस तरह हमें अधिक स्थिर आकलन मिलें। ध्यान रहे, WLS में हम मानते हैं कि वज़न अच्छी तरह ज्ञात या अच्छी तरह आंके गए हैं।
Heteroscedasticity को नज़रअंदाज़ करना भले ही हानिरहित लगे, पर यह समस्याएँ पैदा कर सकता है।
Heteroscedasticity इस बात को विकृत कर सकती है कि कोई मॉडल फीचर्स के महत्व की व्याख्या कैसे करता है। उदाहरण के लिए, किसी खर्च मॉडल में, यदि आय जैसे फीचर्स उच्च परिवर्तनीयता वाले समूहों—जैसे उच्च-आय वाले घरों जिनके वैकल्पिक ख़र्च होते हैं—से जुड़े हों, तो वे अधिक महत्वपूर्ण प्रतीत हो सकते हैं। यह गलत चित्रण हमें कम विश्वसनीय प्रेडिक्टर्स पर ज़रूरत से ज्यादा ज़ोर देने और अधिक सुसंगत प्रेडिक्टर्स को कम आंकने की ओर ले जा सकता है, जिससे मॉडल की उपयोगिता प्रभावित होती है।
यदि आप समान वैरिएंस मान रहे हैं और यह धारणा पूरी नहीं होती, तो heteroscedasticity t-test या F-test जैसे आम सांख्यिकीय परीक्षणों के उपयोग को अमान्य कर सकती है। असमान वैरिएंस time-series डेटा में भी परेशान करता है, जहाँ परिवर्तनीयता के पैटर्न समय के साथ विकसित होते हैं, जिससे मौसमी रुझानों का विश्लेषण करते समय भ्रम होता है। Heteroscedasticity-consistent standard errors (HCSE) अधिक विश्वसनीय सांख्यिकीय अनुमान सक्षम करने में सहायक हो सकते हैं।
इस लेख में, हमने वह स्थिति देखी है जहाँ किसी मॉडल में स्वतंत्र चर के स्तरों के पार अवशेषों का वैरिएंस स्थिर नहीं होता। यहाँ, मैं एक संबंधित विचार पर संक्षेप में बात करना चाहता हूँ, जो है समूह-स्तरीय वैरिएंस विषमता, जो पूर्वनिर्धारित समूहों में परिवर्तनीयता को संदर्भित करती है—जो मॉडल धारणाओं से बँधा सांख्यिकीय मुद्दा कम और डेटा का एक वर्णनात्मक अवलोकन अधिक है।
मैं अंतिम उदाहरण के साथ दिखाऊँगा। यहाँ, मैं सर्वे डेटा का सिमुलेशन उपयोग कर रहा हूँ। मैं ऐसा परिदृश्य मान रहा हूँ जहाँ आय डेटा दो अलग-अलग तरीकों से एकत्र किया गया है: सर्वे और प्रशासनिक अभिलेख। इन तरीकों की सटीकता के स्तर अलग हो सकते हैं (क्या सर्वे कुख्यात नहीं हैं?). हम देख सकते हैं कि प्रत्येक समूह के भीतर परिवर्तन की मात्रा सुसंगत नहीं है, जो ANOVA जैसी किसी चीज़ के साथ समस्या हो सकती है।
set.seed(1024)income_admin <- rnorm(500, mean = 50000, sd = 2000) spending_admin <- income_admin * 0.3 + rnorm(500, mean = 0, sd = 1000)income_survey <- rnorm(500, mean = 50000, sd = 8000) # Same mean, higher SDspending_survey <- income_survey * 0.3 + rnorm(500, mean = 0, sd = 5000)income <- c(income_admin, income_survey)spending <- c(spending_admin, spending_survey)method <- rep(c("Administrative Records", "Survey"), each = 500)survey_and_admin_data <- data.frame(income = income, spending = spending, method = method) # Plot the datacustom_colors <- c("Administrative Records" ='#01ef63', "Survey" = '#203147')ggplot(survey_and_admin_data, aes(x = income, y = spending, color = method)) + geom_point(alpha = 0.7) + labs( title = "Variability in Data Collection", x = "Income", y = "Spending")+ scale_color_manual(values = custom_colors)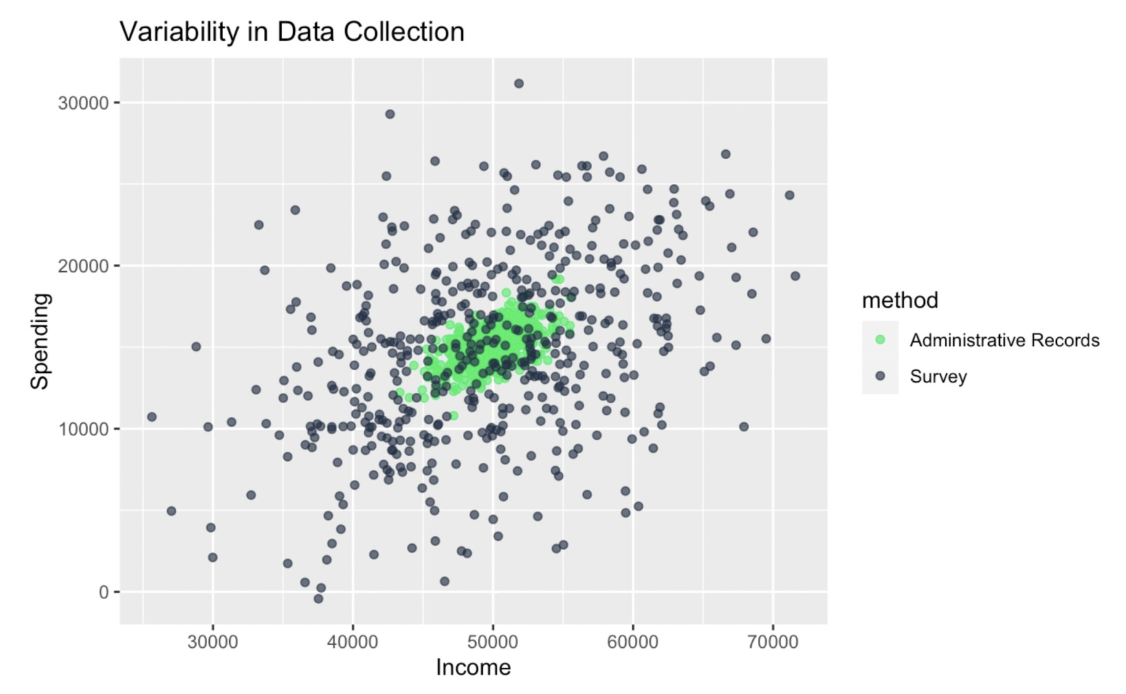
समूह-स्तरीय वैरिएंस विषमता। चित्र: लेखक
Heteroscedasticity को संबोधित करना केवल आपके regression मॉडल को बेहतर बनाने के बारे में नहीं है। यह सुनिश्चित करने के बारे में है कि आपका काम जाँच-परख में खरा उतरे। सीखना जारी रखने और विशेषज्ञ बनने के लिए हमारा Statistical Inference in R ट्रैक और Foundations of Inference in R कोर्स लें। मुझे यह भी लगता है कि हमारा Statistician in R ट्रैक सीखने और करियर विकास—दोनों के लिए एक और बेहतरीन विकल्प है।
DataCamp के साथ Regression सीखें
कोर्स
कोर्स
कोर्स