कोर्स
R में प्रोडक्ट डिमांड फोरकास्टिंग
4 घंटा
9.5K
डिमांड कर्व उपभोक्ता व्यवहार और मूल्य निर्धारण रणनीतियों को समझने के लिए सबसे रोचक और उपयोगी टूल्स में से एक है। इसे आमतौर पर किसी वस्तु या सेवा की कीमत और बिकने वाली मात्रा के बीच संबंध का विश्लेषण करने के लिए इस्तेमाल किया जाता है, हालांकि अन्य संदर्भों में यह बाजार की गतिशीलता का विश्लेषण करने या राजस्व के परिणामों का पूर्वानुमान लगाने के लिए भी उपयोगी हो सकता है।
इस लेख में, हम डिमांड कर्व के बारे में विस्तार से जानेंगे। हम इसकी परिभाषात्मक विशेषताओं और संबंधित शब्दों का अन्वेषण करेंगे। आगे चलकर, मैं यह भी दिखाऊँगा कि डिमांड कर्व को कैसे बढ़ाया जा सकता है ताकि लाभ को अधिकतम करने वाली इष्टतम कीमत निकाली जा सके—यह एक उपयोगी अनुप्रयुक्त बीजगणित की तकनीक है जिससे एक प्रारम्भिक ऑप्टिमाइज़ेशन विधि बनती है, जो मेरे अपने काम में सहायक रही है।
इन तरीकों का पालन करके, मैं आश्वस्त करता हूँ कि आप न केवल मूल्य निर्धारण रणनीतियों पर निर्णय लेने में सक्षम होंगे, बल्कि इन विधियों को स्पष्ट रूप से इस तरह प्रस्तुत भी कर सकेंगे जो भविष्य की परियोजनाओं के लिए ढाँचा प्रदान करे। जबकि मैं इस लेख में R और SQL का उपयोग करूँगा, यह जान लें कि आप यही तरीके अन्य प्रमुख टूल्स, जैसे Excel, Python, Tableau, और Power BI, के साथ भी अपना सकते हैं। अंत में, मैं कहना चाहता हूँ कि सच में मूल्य निर्धारण विशेषज्ञ बनने के लिए, मैं हमारे पाठ्यक्रम Forecasting Product Demand in R की दृढ़ता से सिफारिश करता हूँ।
डिमांड कर्व मूल्य निर्धारण रणनीति और व्यापक रूप से अर्थशास्त्र की एक बुनियादी अवधारणा है। यह किसी वस्तु या सेवा की कीमत और उपभोक्ताओं द्वारा माँगी गई मात्रा के बीच संबंध को दर्शाने का एक प्रभावशाली दृश्य तरीका है। डिमांड कर्व के मुख्य घटकों में एक अक्ष पर कीमत और दूसरे पर माँगी गई मात्रा होती है। यहाँ एक उदाहरण है:
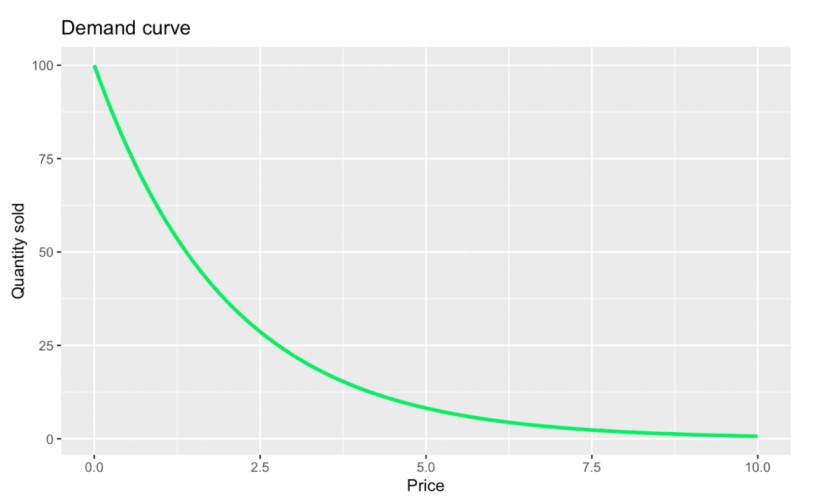
डिमांड कर्व का एक मूलभूत आकार। चित्र: लेखक द्वारा।
ऊपर दिए गए ग्राफ़ में, आप पहली नज़र में कुछ हद तक स्पष्ट बात देखेंगे: कीमत और बिकने वाली मात्रा का एक व्युत्क्रम संबंध है। औपचारिक रूप से, हम कह सकते हैं कि डिमांड कर्व का संबंध मांग के नियम से है, जो कहता है कि, अन्य सभी बातें समान रहने पर, जैसे-जैसे किसी उत्पाद की कीमत घटती है, माँगी गई मात्रा बढ़ती है। कभी-कभी, इसी विचार को कीमत और मात्रा संबंध भी कहा जाता है, जिसका अर्थ है कि किसी उत्पाद की कीमत सीधे इस बात को प्रभावित करती है कि उपभोक्ता कितना खरीदने को तैयार हैं।
हालाँकि, इस विशेष ग्राफ़ में एक कम स्पष्ट बात भी है: जब कीमत कम होती है तो बिकने वाली मात्रा अधिक तेजी से गिरती है और जब कीमत अधिक होती है तो कर्व समतल हो जाता है। यहाँ का वक्रता अन्य अवधारणाओं से संबंधित है, जैसे बदलती लोच और सीमान्त उपयोगिता में कमी, जिन पर मैं अगले अनुभाग में बात करूँगा।
कीमत और माँगी गई मात्रा के व्युत्क्रम संबंध से उभरने वाली एक प्रमुख अवधारणा है मांग की मूल्य लोच, जो मापती है कि कीमत में बदलाव के प्रति माँगी गई मात्रा कितनी संवेदनशील है। औपचारिक रूप से, लोच अक्सर इस प्रकार गणना की जाती है:

यदि कीमत में अपेक्षाकृत छोटा परिवर्तन माँगी गई मात्रा में बड़े परिवर्तन की ओर ले जाए तो कहा जाता है कि उत्पाद की लोचदार मांग है। हाई-एंड इलेक्ट्रॉनिक्स या डिज़ाइनर हैंडबैग की मांग उनकी कीमत में थोड़ा भी इज़ाफा होने पर तेज़ी से गिर सकती है, क्योंकि उपभोक्ता उनके विकल्प ढूँढ सकते हैं।
यदि कीमत में बड़े बदलाव के बावजूद माँगी गई मात्रा में अपेक्षाकृत छोटा परिवर्तन हो, तो कहा जाता है कि उत्पाद की अलोचदार मांग है। पेट्रोल या दवा जैसी आवश्यक वस्तुएँ क्लासिक उदाहरण हैं। कीमत बढ़ने पर भी उपभोक्ता लगभग उतनी ही मात्रा खरीदने को बाध्य होते हैं क्योंकि इनके विकल्प उपलब्ध नहीं होते।
हालाँकि मैंने डिमांड कर्व का एक उदाहरण दिखाया, यह जान लें कि यह बाजार, उत्पाद और उपभोक्ता वरीयताओं की अंतर्निहित विशेषताओं पर निर्भर करते हुए कई अलग-अलग रूप ले सकता है। यह हमेशा नीचे की ओर ढलान वाला होता है, लेकिन इस संबंध को किसी एक ही गणितीय आकार का पालन करना आवश्यक नहीं है।
रैखिक डिमांड कर्व में कीमत और मात्रा के बीच परिवर्तन की दर स्थिर होती है। ये सरल बाजार परिदृश्यों में सामान्य होते हैं। इन्हें सीधी रेखा द्वारा दर्शाया जाता है।
जैसा कि हमने देखा, डिमांड कर्व हमेशा एकदम सीधी रेखा के रूप में नहीं बनता क्योंकि कीमत और मात्रा के बीच का संबंध अक्सर सरल एक-से-एक रैखिक फलन से ठीक तरह प्रदर्शित नहीं होता। इसके कई कारण हैं, जिनका मैंने पहले उल्लेख करना शुरू किया था:
व्यवहार में, गैर-रैखिक डिमांड कर्व अधिक यथार्थवादी हो सकते हैं क्योंकि वे परिवर्तन की परिवर्ती दर को बेहतर दर्शाते हैं। आखिरकार, वास्तविक दुनिया का डेटा अव्यवस्थित होता है और उपभोक्ता व्यवहार जटिल। यह कहा जा सकता है कि गैर-रैखिक कर्व को रैखिकीकरण करने के तरीके अक्सर मौजूद होते हैं, जैसा कि मैं आगे दिखाऊँगा।
हम उपभोक्ता और बाजार स्तर पर मांग में अंतर की तुलना भी कर सकते हैं। एक व्यक्तिगत डिमांड कर्व किसी एक उपभोक्ता के लिए उत्पाद की कीमत और माँगी गई मात्रा के बीच संबंध को दर्शाता है। यह व्यक्तिगत वरीयताओं और भुगतान करने की इच्छा को प्रतिबिंबित करता है।
एक बाजार डिमांड कर्व किसी बाजार में सभी उपभोक्ताओं की मांग को जोड़ता है। यह व्यक्तिगत डिमांड कर्व का समुच्चय है और हर मूल्य स्तर पर कुल माँगी गई मात्रा दिखाता है। अपनी बनावट के कारण, बाजार डिमांड कर्व का उपयोग व्यवसाय बाजार क्षमता का आकलन करने के लिए करते हैं।
यदि आप डिमांड कर्व का अध्ययन कर रहे हैं, तो आपने सप्लाई कर्व के बारे में भी सुना होगा। मूल रूप से, सप्लाई कर्व और डिमांड कर्व एक ही सिक्के के दो पहलू हैं। जहाँ डिमांड कर्व यह दिखाता है कि अलग-अलग कीमतों पर उपभोक्ता कितना खरीदना चाहते हैं, वहीं सप्लाई कर्व दर्शाता है कि उन्हीं कीमतों पर उत्पादक कितना बेचना चाहते हैं।
अब, यदि आप एक ही चार्ट पर डिमांड कर्व और सप्लाई कर्व दोनों प्लॉट करें, तो आपको एक बिंदु मिलेगा जहाँ वे एक-दूसरे को काटते हैं। इन कर्व्स के प्रतिच्छेदन को समतुल्य बिंदु कहा जाता है, जिसे बाजार की कीमत और मात्रा निर्धारित करने वाला माना जाता है। तो, जब मांग, आपूर्ति से ज्यादा होती है, तो कीमतें बढ़ने की प्रवृत्ति होती है, जो उत्पादकों को अधिक उत्पादन के लिए प्रोत्साहित करती है। लेकिन जब आपूर्ति, मांग से अधिक हो जाती है, तो कीमतें घटती हैं, जो अधिक खरीद को प्रोत्साहित करती हैं।
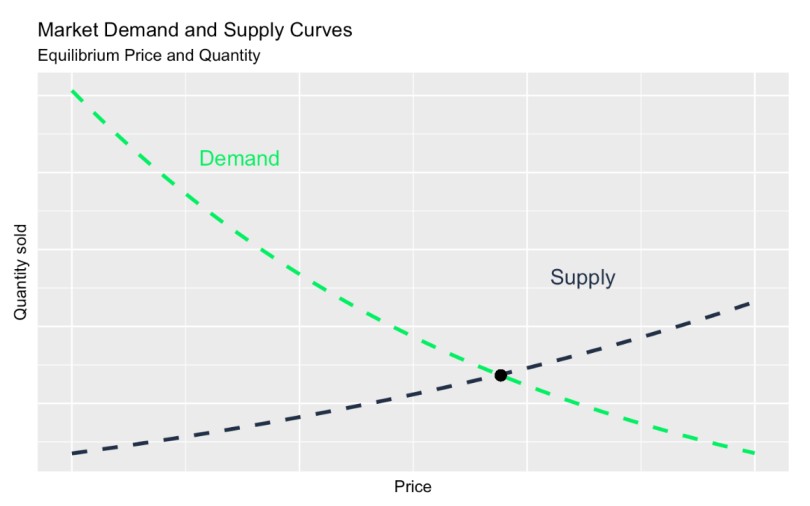
डिमांड कर्व बनाम सप्लाई कर्व। चित्र: लेखक द्वारा।
व्यापारिक निर्णय लेने के लिए डिमांड कर्व का उपयोग करने के कई तरीके हैं। यहाँ, मैं आपको एक विशिष्ट तरीका दिखाऊँगा जिससे हम डिमांड कर्व को उपयोगी बना सकते हैं: हम अपने डेटा से एक डिमांड कर्व और एक डिमांड मॉडल दोनों बनाएँगे, जिसके लिए हम क्वाड्रेटिक रिग्रेशन तकनीक का उपयोग करेंगे। मैं दिखाऊँगा कि आप इस तकनीक का उपयोग R और SQL दोनों में कैसे कर सकते हैं, और इसे इंटरैक्टिव Power BI या Tableau डैशबोर्ड्स में भी प्रयोग कर सकते हैं।
आगे बढ़ने से पहले, मैं कहना चाहता हूँ कि यदि आप यह पढ़ रहे हैं और सोचते हैं कि आप एक साथ पूरी टीम—जैसे व्यवसाय विश्लेषकों या डेटा वैज्ञानिकों के विभाग—को अपस्किल करना चाहते हैं, तो DataCamp for Business मदद के लिए मौजूद है। हम आपकी टीम को आपके विशिष्ट व्यावसायिक संदर्भ में सहायक कौशल और तकनीकें बनाने में सहायता करेंगे। भारी-भरकम डेटा विश्लेषण परियोजनाएँ अक्सर कई योगदानकर्ताओं की आवश्यकता रखती हैं—तो और जानकारी के लिए हमारी DataCamp टीम से संपर्क करें।
आइए R का उपयोग करके एक डिमांड कर्व बनाएँ और उसका विश्लेषण करें। डेटासेट का सिमुलेशन करने के लिए, मैंने शोर के साथ एक एक्सपोनेंशियल डिके-टाइप कर्व बनाया है। विचार यह है कि प्रत्येक डेटा बिंदु एक कार डीलरशिप के साप्ताहिक बिक्री को दर्शाता है, जहाँ डीलरशिप अलग-अलग ऑफ़र देती है और एक ही प्रकार की कार के लिए विभिन्न मूल्य स्तरों को आज़माती है ताकि बिक्री बढ़ाई जा सके।
# Load necessary library
library(tidyverse)
# Define parameters for the exponential decay
a <- 100 # Initial value
b <- 0.5 # Decay rate
# Define a realistic price range
price <- seq(10000, 40000, length.out = 200) # Price from $10,000 to $40,000
# Calculate the exponential decay
y <- a * exp(-b * (price / 10000)) # Adjust decay rate to match price scaling
# Add mixed noise (additive + slight proportional)
set.seed(42) # For reproducibility
additive_noise <- rnorm(length(y), mean = 0, sd = 1) # Constant additive noise
proportional_noise <- rnorm(length(y), mean = 0, sd = 0.05 * y) # Small proportional noise
y_noisy <- y + additive_noise + proportional_noise
# Ensure no negative values (optional, as sales can't be negative)
y_noisy[y_noisy < 0] <- 0.01
# Combine price and noisy y into a data frame
demand_curve_data <- data.frame(
price = price,
quantity_sold = y_noisy
)
# Clean and prepare the data
demand_curve_data <- demand_curve_data %>%
mutate(quantity_sold = round(quantity_sold, 0)) %>%
filter(quantity_sold != 0)
# Plot the noisy exponential decay
ggplot(demand_curve_data, aes(x = price, y = quantity_sold)) +
geom_point(color = '#203147', alpha = 0.6) +
geom_line(
aes(y = a * exp(-b * (price / 10000))),
color = '#01ef63',
size = 1.2,
linetype = "dashed"
) +
labs(
title = "Cars Sold",
subtitle = "Demand Curve (Cars Sold)",
x = "Price ($)",
y = "Quantity Sold"
) +
scale_x_continuous(labels = scales::dollar_format()) # Format x-axis as dollars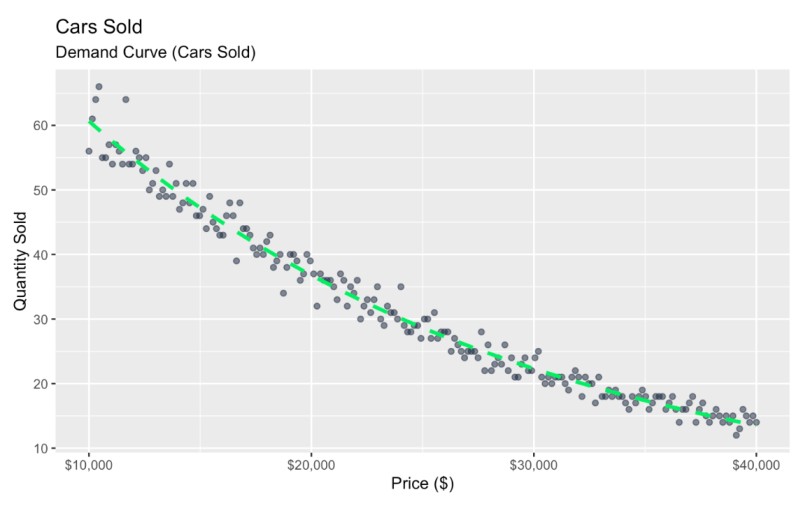 शोर के साथ डिमांड कर्व। चित्र: लेखक द्वारा
यहाँ, मैंने कीमत और बिकने वाली मात्रा के बीच संबंध का ग्राफ बनाया है, और प्राकृतिक भिन्नता को दर्शाने के लिए स्कैटरप्लॉट पॉइंट्स का उपयोग किया है, जो कई अलग-अलग कारणों से हो सकती है।
इस ग्राफ़ को पढ़ते हुए, हम देखते हैं कि जैसे-जैसे कीमत बढ़ती है, बिक्री घटती है, और यह संबंध कुछ मूल्य श्रेणियों में अधिक संवेदनशील है। लेकिन, आप डेटा से क्या करना चाहते हैं, इस पर निर्भर करते हुए, यह सामान्य समझ किसी व्यावहारिक व्यावसायिक निर्णय के लिए पर्याप्त नहीं हो सकती। मेरे अनुभव में, प्रबंधक अक्सर एक मानक-निर्देशात्मक अंतर्दृष्टि देखना चाहते हैं जो एक दबाव वाले व्यावसायिक प्रश्न का ठोस उत्तर दे। ऐसा एक प्रश्न है: वह कौन-सी कार कीमत है जो वास्तव में कुल राजस्व को अधिकतम करती है?
हम ग्राफ़ देखकर कुछ अनुमान लगाने से शुरू कर सकते हैं।
अब आपको महसूस होने लगा होगा कि कुल राजस्व को अधिकतम करने वाली कीमत कहीं बीच में है। वैचारिक रूप से यह समझ आता है: हम अपेक्षा करते हैं कि बहुत कम कीमतें उच्च मात्रा की बिक्री देंगी लेकिन अपेक्षाकृत कम राजस्व, जबकि बहुत अधिक कीमतें बहुत कम बिक्री देंगी और फिर भी अपेक्षाकृत कम राजस्व। लेकिन कहीं न कहीं बीच में एक इष्टतम कीमत अवश्य होगी जो राजस्व को अधिकतम करती है।
अब, ग्राफ़ पर अनुमान लगाने के बजाय, एक बेहतर, अधिक कुशल और ठोस तरीका सीखते हैं जिससे कुल राजस्व को अधिकतम किया जा सके। हम एक प्रारंभिक ऑप्टिमाइज़ेशन समस्या हल करके इष्टतम कीमत निकाल सकते हैं। हम पहले एक रैखिक मॉडल बनाएँगे, फिर उस मॉडल को एक पराबोला (parabola) में बदलेंगे, और उच्चतम बिंदु ढूँढेंगे।
हमारा पहला कदम संबंध को रैखिकीकरण करना है। चूँकि मैंने यह सब एक एक्सपोनेंशियल डिके फलन से निर्मित किया है, मुझे पता है कि इसे माँगी गई मात्रा का लघुगणक लेने से अच्छे से रैखिकीकृत किया जा सकता है। सरलता के लिए, हेटेरोस्केडैस्टिसिटी को नज़रअंदाज़ करते हैं।
# Create a linearized version of the data
demand_curve_data$log_quantity_sold <- log(demand_curve_data$quantity_sold)

# Plot the linearized relationship
ggplot(demand_curve_data, aes(x = price, y = log_quantity_sold)) +
  geom_point(color = '#203147', alpha = 0.6) +
  geom_smooth(method = "lm", color = '#01ef63', se = FALSE) +
  labs(
    title = "Cars Sold",
    subtitle = "Demand Curve (Log Quantity Sold)",
    x = "Price ($)",
    y = "Log of Quantity Sold"
  ) +
  scale_x_continuous(labels = scales::dollar_format())  # Format x-axis as dollars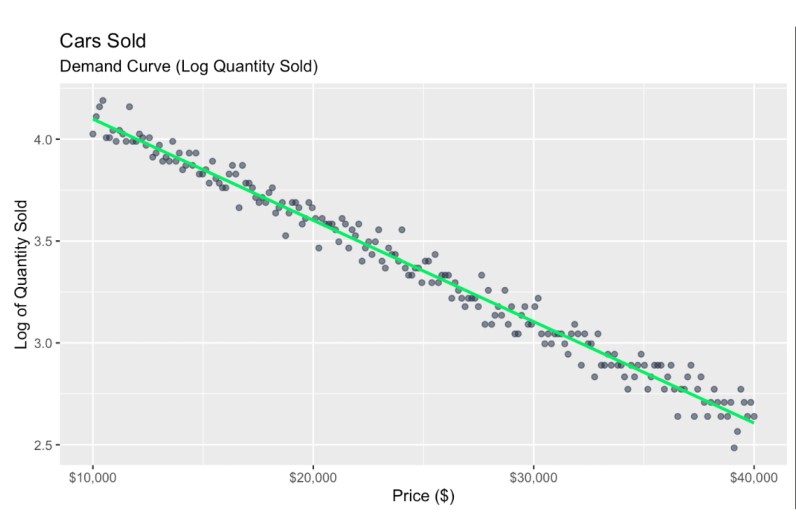
रूपांतरित डिमांड कर्व। चित्र: लेखक द्वारा
अब, हम revenue नाम का एक नया चर बना सकते हैं जिसे price गुणा log_quantity_sold के रूप में परिभाषित किया गया है। ध्यान दें, हम lm() फ़ंक्शन का उपयोग करके एक रैखिक मॉडल ऑब्जेक्ट बनाते हैं क्योंकि हम मॉडल गुणांकों से संबंधित संख्याओं तक पहुँचना चाहते हैं।
अगले चरण में, हम अपने रैखिक मॉडल समीकरण को अपने सूत्र में डालते हैं। यदि हमारे पास कोई लॉग-ट्रांसफॉर्म न होता:
तो इसका मतलब होता कि हमारा समीकरण: revenue = price * quantity_sold अब revenue = price * (b0 + b1 * price) के रूप में लिखा जा सकता है।
फिर, हम पदों का वितरण करते। जैसे हम x(1-x) में पदों का वितरण करके x - x2 बनाते हैं, वैसे ही हम अपना समीकरण revenue = b0 * Price + b1 * price2 के रूप में लिखते।
ध्यान दें कि अब हमारे पास revenue एक ऐसे समीकरण से परिभाषित होगा जिसमें price का वर्ग है। यही वास्तव में मुख्य हिस्सा है क्योंकि price को वर्ग के रूप में ग्राफ़ करके हमने एक अधिकतमकृत फलन बना लिया है।
हालाँकि, क्योंकि हमारे पास लॉग-ट्रांसफॉर्म है, हमें लॉग-रैखिक मॉडल का घातांकीय बैक-ट्रांसफ़ॉर्म करना होगा।
इसका अर्थ है कि हमारा समीकरण: revenue = price * log_quantity_sold अब revenue = price * eb0 + b1 * price के रूप में लिखा जाएगा।
हम चाहें तो अब इस समीकरण को एक नए रूप में फैक्टर कर सकते हैं: revenue=price * eb0 * eb1⋅price. लेकिन यह विशेष समीकरण रैखिक या बहुपद समीकरण की तरह उसी तरह से वितरित नहीं होता क्योंकि घातांकीय फलन मानक बीजगणितीय पदों की तरह पदों को अलग या वितरित करने की अनुमति नहीं देता।
खैर, आगे बढ़ते हैं:
# Fit a linear model to the log-transformed quantity sold
model <- lm(log_quantity_sold ~ price, data = demand_curve_data)

# Create a revenue model based on the linear model coefficients
revenue_model_data <- demand_curve_data %>%
  mutate(
    revenue_model = price * exp(coef(model)[1] + coef(model)[2] * price)  # Modeled revenue
  )

# Plot the revenue model
ggplot(revenue_model_data, aes(x = price, y = revenue_model)) +
  geom_point(color = '#203147', alpha = 0.6) +  # Actual revenue points
  geom_line(color = '#01ef63', size = 1.2) +    # Revenue model line
  labs(
    title = "Car Sales",
    subtitle = "Revenue Model",
    x = "Price ($)",
    y = "Revenue ($)"
  ) +
  scale_y_continuous(labels = scales::dollar_format()) +  # Format y-axis as dollars
  theme_minimal() +  # Apply a minimal theme for aesthetics
  theme(
    text = element_text(family = "Arial", size = 12),
    plot.title = element_text(face = "bold", size = 16),
    plot.subtitle = element_text(size = 14)
  )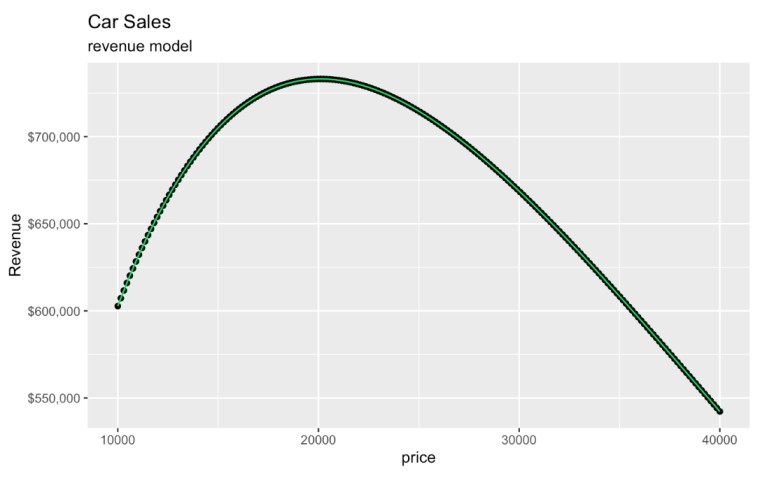
डिमांड कर्व से निर्मित राजस्व मॉडल। चित्र: लेखक द्वारा।
दिलचस्प बात यह है कि मूल मॉडल ने log_quantity_sold का उपयोग किया था, फिर भी जो ग्राफ़ हमने बनाया है वह पूरी तरह price और revenue के मूल पैमानों पर है। लॉग-ट्रांसफॉर्म केवल अंतर्निहित मॉडल को प्रभावित करता है, और e से बैक-ट्रांसफॉर्म ने हमारे ग्राफ़ को मूल पैमाने पर लौटा दिया है, जिससे इसे समझना आसान रहता है।
अब, हमारा अंतिम मुख्य बिंदु यह है: पराबोला के शीर्ष पर जहाँ अवकलज शून्य होता है, वही सैद्धांतिक कीमत होगी जो राजस्व को अधिकतम करती है।
हमें याद हो सकता है कि 3x² + 2x जैसे समीकरण का अवकलज हम घातांक से गुणा करके 6x + 2 पाते हैं। यही तर्क यहाँ भी लागू होता है, लेकिन फिर से याद रखें, इस उदाहरण में हमें राजस्व फलन बनाने से पहले अपने लॉग किए हुए मानों का बैक-ट्रांसफॉर्म करना है। राजस्व का अधिकतम ढूँढने से पहले मूल पैमाने पर लौटकर, हमें यकीन होता है कि हम वास्तविक राजस्व को अधिकतम करने वाली कीमत ढूँढ रहे हैं, न कि किसी रूपांतरित मीट्रिक को। तो अंतरकरण के लिए यह सही राजस्व फलन है: revenue = price * e(b0 + b1 * price).
आइए इसे करके देखें। यहाँ, मैं रैखिक मॉडल के गुणांक लेता हूँ। फिर मैं एक राजस्व फलन परिभाषित करता हूँ। अंत में, मैं इष्टतम कीमत की गणना करता हूँ और संबंधित अपेक्षित कुल राजस्व के बारे में जानता हूँ।
# Model coefficients
b0 <- 4.596 # Intercept
b1 <- -4.974e-05 # Slope for price

# Define the revenue function
revenue <- function(P, b0, b1) {
  P * exp(b0 + b1 * P)
}

# Calculate the optimal price (analytical solution from dR/dP = 0) - shortcut code here
(optimal_price <- -1 / b1)

# Calculate maximum revenue
(max_revenue <- revenue(optimal_price, b0, b1))
[1] 20104.54
[1] 732853.5आपने ध्यान दिया होगा कि इष्टतम कीमत के लिए मेरे पास एक कोड की पंक्ति थी जिसका संदर्भ में ठीक से समझाया नहीं गया था। मैं इस हिस्से की बात कर रहा हूँ: (optimal_price <- -1 / b1)। आइए एक मिनट लें यह समझाने के लिए कि मैंने यह कैसे निकाला कि इष्टतम कीमत ढाल का ऋणात्मक व्युत्क्रम है।
सबसे पहले, हमें कलन में उत्पाद नियम (product rule) को याद रखना है, जो कहता है कि यदि x का फलन f(x) = u(x) गुणा v(x) है, तो अवकलज f'(x) पहले के अवकलज गुणा दूसरे, फिर पहले गुणा दूसरे के अवकलज के योग के बराबर होता है।
# the product rule in calculus
f(x) = u(x) * v(x)
f'(x) = u'(x) * v(x) + u(x) * v'(x)
यह रहा फिर से हमारा समीकरण और उसका अवकलज:
# our equation:
revenue = price * e^(b0 + b1 * price)

# the derivative of our equation
derivative = 1 * e^(b0 + b1 * price) + price * b1 * e^(b0 + b1 * price)
मुझे पता है कि यहाँ price का अवकलज 1 है क्योंकि हम उसी का अवकलज निकाल रहे हैं। "कीमत बदलने पर कीमत कितनी बदलती है?" खैर, यह एक-से-एक संबंध है।
दूसरी तरफ, e(b0 + b1 * price) का अवकलज 2x2 जैसे सरल फलन की तरह साफ़-सुथरा नहीं है, जिसका अवकलज 4x होता है।
जिस अभिव्यक्ति पर हम काम कर रहे हैं, उसका घातांक एक बहुपद है। तरकीब यह है कि सभी पदों को ध्यान से देखें: शुरुआत के लिए,
b0 एक एकल मान है, इसलिए उसका अवकलज शून्य है
price का अवकलज 1 है, जैसा कि हमने संभाल लिया।
b1 स्केलिंग फ़ैक्टर है, इसलिए हम उस संख्या को आगे रखते हैं, और नियम के अनुसार बहुपदीय घातांक को वही रहने देते हैं।
तो e(b0 + b1 * price) का अवकलज b1 * e(b0 + b1 * price) होगा। इसे चेन रूल कहा जाता है, जैसा कि मैं यहाँ दिखा रहा हूँ:
# the chain rule in calculus
f(x) = x^g(x)
f'(x) = g'(x) * x^g(x)
अंत में, थोड़ा फैक्टरिंग करना है।
बीजगणित हमें बताता है कि ये समान हैं:
A + B * A = A(1+B)और जब मैं अपने अवकलज को ध्यान से देखता हूँ, तो मुझे A और B का हिस्सा दिखता है:
"A" है e(b0 + b1 * price) और "B" है price * b1। तो मैं इसे फैक्टर कर सकता हूँ
e^(b0 + b1 * price) + price * b1 * e^(b0 + b1 * price)इस रूप में:
e^(b0 + b1 * price)(1 + price * b1)अंततः, मुझे इस अवकलज को शून्य के बराबर रखना है ताकि वह जगह मिले जहाँ ढलान ऊपर जाना बंद कर नीचे जाना शुरू करती है—यानी पराबोला का शीर्ष।
e^(b0 + b1 * price)(1 + price * b1) = 0एक अंतिम तरकीब के रूप में, मुझे पता है कि जब A * B शून्य के बराबर होता है, तो या तो A या B (या दोनों) शून्य होने चाहिए। लेकिन सुविधाजनक रूप से, मुझे पता है कि e(b0 + b1 * price) कभी शून्य नहीं हो सकता क्योंकि यह एक घातांक है। यदि यह धनात्मक हो, तो संख्या बड़ी होगी; यदि घातांक 0 हो, तो परिणाम 1 होगा; यदि घातांक ऋणात्मक हो, तो परिणाम छोटा भिन्न होगा। इसलिए मैं शून्य के लिए हल करते समय इस आधे हिस्से को छोड़ सकता हूँ।
अब मुझे केवल पदों को इधर-उधर करना है और price के लिए हल करना है।
(1 + b1 * price) = 0
b1 * price = -1
price = - 1 / b1
यही तरह से मैंने -1 / b1 निकाला, जिसे हमने अपने R कोड की कस्टम-बिल्ट फ़ंक्शन में रखा।
अब, जहाँ हम थे, वहीं से आगे बढ़ते हुए, हम इष्टतम कीमत को ग्राफ़ कर सकते हैं और उससे जुड़ा राजस्व देख सकते हैं।
इष्टतम कीमत $20,104.54 है, जो कुल मिलाकर लगभग $732,853.50 के अपेक्षित राजस्व को जन्म देती है। मैं 'लगभग' इसलिए कह रहा हूँ क्योंकि, यदि आप गणित जाँचें, तो हम 36.45 कारों की बिक्री मान रहे हैं, जबकि आधी कार बेचना संभव नहीं।
ggplot(revenue_model_data, aes(x = price, y = revenue_model)) +
geom_point() + geom_line(color = '#01ef63') +
ggtitle("Car Sales") + labs(subtitle = "revenue model") +
ylab("Revenue") +
scale_y_continuous(labels = scales::dollar_format()) +
geom_vline(xintercept = optimal_price, linetype = "dashed", color = '#203147') +
geom_point(aes(x = optimal_price, y = max_revenue), color = '#203147', size = 3) 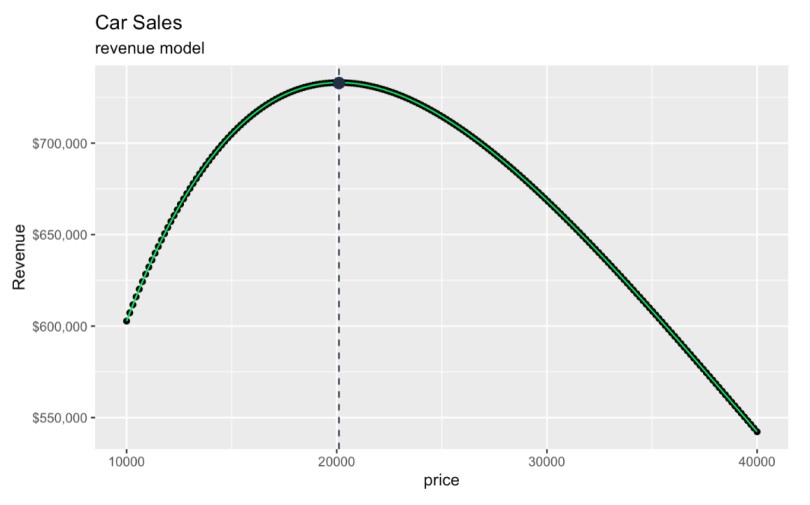 राजस्व को अधिकतम करने वाली कीमत ढूँढना। चित्र: लेखक द्वारा।
किसी अन्य वर्कफ़्लो में, हम इन विचारों को राजस्व के बजाय लाभ पर विचार करने के लिए भी बढ़ा सकते हैं। मैं यहाँ पूरा विवरण नहीं करूँगा, लेकिन ऐसा करने के लिए, यह जान लें कि हम profit = revenue - cost मान सकते हैं, जहाँ cost को quantity * unit cost माना जाता है। यदि यूनिट कॉस्ट स्थिर है और मात्रा को 1 - price जैसी अभिव्यक्ति से बदला जा सकता है, तो हमें फिर से एक उल्टा पराबोला मिलता है।
यदि आप यह सीखने में रुचि रखते हैं कि मशीन लर्निंग में कलन और अवकलज कैसे शामिल होते हैं, तो हमारा Introduction to Deep Learning with PyTorch कोर्स आज़माएँ, जो gradient descent को हाइपरपैरामीटर ट्यूनिंग के संदर्भ में विस्तार से समझाता है। संदर्भ अलग है, लेकिन आप कुछ समान सोच लागू कर सकते हैं। जैसा कि आप देख रहे हैं, ऑप्टिमाइजेशन अपने अलग-अलग रूपों में डेटा साइंस की एक प्रमुख कौशल है, और अभ्यास सहायक होता है।
यदि आपने अर्थशास्त्र पढ़ा है, तो आप इस पराबोला को लैफ़र कर्व जैसा पहचान सकते हैं, जो कर दरों के सरकारी कर राजस्व को कैसे प्रभावित करने को दर्शाने वाली एक कुछ विवादास्पद अवधारणा है।
मैं डिमांड कर्व पर इस रूपांतरण और लैफ़र कर्व दोनों को "दर के विरुद्ध अधिकतम" प्रकार की समस्याएँ मानूँगा, लेकिन लैफ़र कर्व कराधान के लिए विशिष्ट है: x-अक्ष कर दर (0% से 100%) का प्रतिनिधित्व करेगा, और y-अक्ष कुल कर राजस्व का। वैचारिक रूप से, लैफ़र कर्व भी उल्टा-U आकार का होता है क्योंकि ऊपरी सिरे पर, हम मानते हैं कि यदि कर दर बहुत अधिक हो, तो कोई राजस्व नहीं होगा क्योंकि व्यक्तियों या व्यवसायों के लिए टैक्सेबल गतिविधियों में संलग्न होने की कोई प्रोत्साहन नहीं बचेगा। अर्थशास्त्रियों के बीच उस 'प्रोत्साहन' हिस्से पर असहमति हो सकती है।
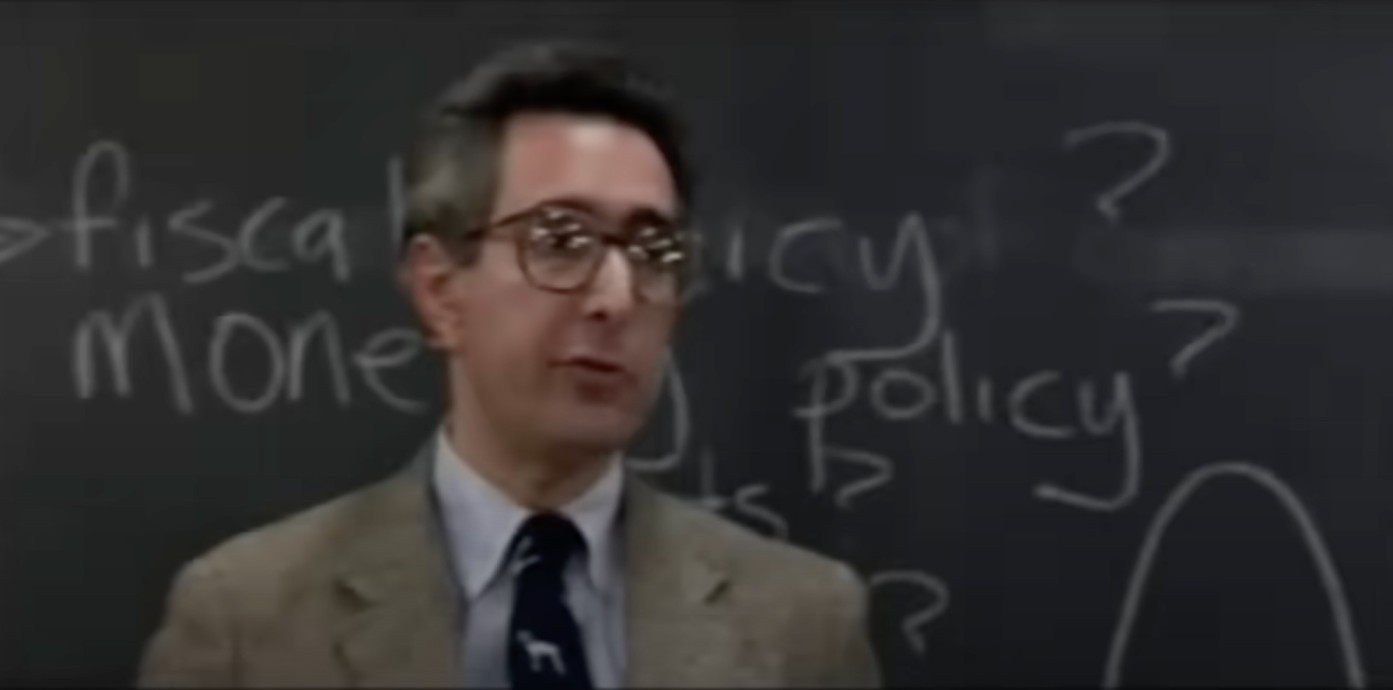
फेरिस ब्यूलर'स डे ऑफ में लैफ़र कर्व। स्रोत: YouTube
अब जबकि हमने अवधारणा समझ ली है, मैं एक SQL स्क्रिप्ट भी साझा करना चाहता हूँ जो वही काम करेगी। यह फ़ंक्शन quantity_sold बनाम price पर रिग्रेशन करेगा। फिर यह आपको रिग्रेशन गुणांकों के आधार पर राजस्व को अधिकतम करने के लिए इष्टतम कीमत खोजने और संबंधित अधिकतम राजस्व निर्धारित करने की सुविधा देगा।
मेरा मानना है कि निम्नलिखित स्क्रिप्ट Power BI या Tableau में डायनेमिक डैशबोर्ड बनाते समय खास तौर पर उपयोगी होगी क्योंकि आपको वास्तविक-समय डेटा अपडेट मिलेंगे और कुछ भी ऑफ़लाइन लेने की आवश्यकता नहीं होगी।
आप यह भी देखेंगे कि मैंने SQL एग्रीगेट फ़ंक्शंस का उपयोग करके रिग्रेशन गुणांक खोजने के लिए मैन्युअल तरीका अपनाया है, क्योंकि अधिकांश SQL डायलैक्ट में ऐसे विशेष रिग्रेशन फ़ंक्शंस नहीं होते जिन्हें आप उपयोग कर सकें। आपको यह जानकर आश्चर्य हो सकता है कि साधारण रैखिक प्रतिगमन SQL में अच्छा काम करता है क्योंकि सिंपल लीनियर रिग्रेशन के मॉडल गुणांक x और y के बीच सहसंबंध, मानक विचलन और औसत के रूप में व्यक्त किए जा सकते हैं।
-- SQL script to perform linear regression on log(quantity_sold) vs price,
-- calculate the optimal price to maximize revenue, and determine the maximum revenue.
WITH regression_data AS (
  SELECT
    COUNT(*) AS N,
    SUM(price) AS sum_x,
    SUM(LOG(quantity_sold)) AS sum_y,
    SUM(price * LOG(quantity_sold)) AS sum_xy,
    SUM(price * price) AS sum_x2,
    SUM(LOG(quantity_sold) * LOG(quantity_sold)) AS sum_y2
  FROM sales_data
),
regression_coefficients AS (
  SELECT
    N,
    sum_x,
    sum_y,
    sum_xy,
    sum_x2,
    sum_y2,
    (N * sum_xy - sum_x * sum_y) / (N * sum_x2 - sum_x * sum_x) AS slope,
    (sum_y - ((N * sum_xy - sum_x * sum_y) / (N * sum_x2 - sum_x * sum_x)) * sum_x) / N AS intercept
  FROM regression_data
),
optimal_price AS (
  SELECT
    slope,
    intercept,
    (-1 / slope) AS optimal_P
  FROM regression_coefficients
),
max_revenue AS (
  SELECT
    optimal_P,
    slope,
    intercept,
    optimal_P * EXP(intercept + slope * optimal_P) AS max_R
  FROM optimal_price
)
SELECT
  optimal_P AS Optimal_Price,
  max_R AS Maximum_Revenue
FROM max_revenue;
Optimal_Price | Maximum_Revenue
------------- | ----------------
20104.32 | 402082.58कृपया ध्यान दें कि प्रयुक्त SQL डायलैक्ट के आधार पर दी गई SQL स्क्रिप्ट में समायोजन की आवश्यकता हो सकती है, क्योंकि सिन्टैक्स भिन्न हो सकता है। साथ ही, समस्या निवारण उद्देश्यों के लिए, मैं यह सुनिश्चित करूँगा कि आपकी सेल्स डेटा टेबल में price और quantity_sold दोनों के लिए मान्य और धनात्मक मान हों, क्योंकि ऋणात्मक या शून्य मान त्रुटियों का कारण बन सकते हैं।
इसके अलावा, यदि आप R खंड की तरह कोई लॉग-ट्रांसफॉर्म शामिल करना चाहते हैं, तो आप ऐसा कर सकते हैं, लेकिन आपके डायलैक्ट के अनुसार नेचुरल लॉगरिद्म फ़ंक्शन का नाम अलग हो सकता है—या तो LN या LOG। DuckDB में LN और LOG वास्तव में अलग हैं: LN प्राकृतिक लघुगणक e है, जबकि LOG बेस 10 है। यदि आप SQL में कीमत और बिक्री के बीच संबंध का विश्लेषण करने के लिए डिमांड कर्व बनाना चाहते हैं, तो मेरा Analyzing Product Demand in SQL कोड-अलॉन्ग देखें। अंत में, मैं कहूँगा कि एक विश्लेषक के रूप में अपनी SQL दक्षता बढ़ाने के लिए, आपको Associate Data Analyst in SQL करियर ट्रैक का अन्वेषण करना चाहिए, ताकि आप एक पूर्ण टूलकिट विकसित कर सकें।
DataCamp के साथ डेटा एनालिसिस और डेटा साइंस सीखें
कोर्स
कोर्स
कोर्स