मुख्य सामग्री पर जाएं

डेटा मॉडलिंग समझें: तकनीकें, उदाहरण, और सर्वोत्तम प्रथाएँ

जानें कि डेटा मॉडलिंग कैसे डेटा को कुशल भंडारण, प्रबंधन, और विश्लेषण के लिए व्यवस्थित और संरचित करने में मदद करती है।
अपडेट किया गया 25 सित॰ 2026  · 9 मि॰ पढ़ें

AI के साथ खोजें

ChatGPTClaudePerplexity

जब मैंने पहली बार डेटा मॉडलिंग देखी, तो यह डेटाबेस के साथ काम करने का एक और तकनीकी कदम लगा। लेकिन जैसे-जैसे मैंने इसे समझा, मुझे एहसास हुआ कि डेटा को सुव्यवस्थित, आसानी से सुलभ और विश्लेषण-योग्य बनाने के लिए यह कितना आवश्यक है। एक ठोस डेटा मॉडल के बिना, सबसे शक्तिशाली डेटाबेस भी प्रबंधन में कठिन हो सकते हैं, जिससे अक्षमियाँ और असंगतियाँ पैदा होती हैं।

चाहे आप शुरुआत से डेटाबेस डिज़ाइन कर रहे हों या किसी मौजूदा सिस्टम को बेहतर बना रहे हों, डेटा मॉडलिंग को समझना आपके लिए डेटा को उपयोगी बनाने की कुंजी है।

इस पोस्ट में, हम बुनियादी डेटा मॉडलिंग तकनीकों, सर्वोत्तम प्रथाओं, और वास्तविक दुनिया के उदाहरणों की पड़ताल करेंगे ताकि आप प्रभावी मॉडल बना सकें!

डेटा मॉडलिंग क्या है?

डेटा मॉडलिंग एक विस्तृत प्रक्रिया है जिसमें डेटा और उसके संबंधों का एक दृश्य प्रतिनिधित्व बनाया जाता है। यह इस बात का खाका (ब्लूप्रिंट) होता है कि डेटा कैसे संरचित, संग्रहीत और एक्सेस किया जाएगा ताकि डेटा प्रबंधन में निरंतरता और स्पष्टता सुनिश्चित हो सके। 

डेटा तत्त्वों और उनके संबंधों को परिभाषित करने से टीमें सूचना को इस तरह व्यवस्थित कर पाती हैं कि भंडारण, पुनर्प्राप्ति, और विश्लेषण कुशलतापूर्वक हो—जिससे प्रदर्शन और निर्णय-निर्धारण दोनों में सुधार होता है।

डेटा मॉडलों के प्रकार

डेटा मॉडलों के तीन मुख्य प्रकार होते हैं। आइए इस अनुभाग में इन्हें समझते हैं।

कॉन्सेप्चुअल डेटा मॉडल 

कॉन्सेप्चुअल मॉडल डेटा का उच्च-स्तरीय दृश्य प्रदान करता है। यह मॉडल प्रमुख व्यावसायिक इकाइयों (जैसे, ग्राहक, उत्पाद, और ऑर्डर) और उनके संबंधों को परिभाषित करता है, बिना तकनीकी विवरणों में जाए। 

लॉजिकल डेटा मॉडल

लॉजिकल मॉडल यह परिभाषित करता है कि डेटा कैसे संरचित होगा। यह मॉडल डेटा के संगठन पर केंद्रित रहता है, किसी विशिष्ट डेटाबेस या तकनीक से बँधा नहीं होता। इसमें डेटा के गुणों, संबंधों, और बाधाओं के बारे में विस्तृत जानकारी शामिल होती है, जो व्यावसायिक आवश्यकताओं और डेटा के भौतिक कार्यान्वयन के बीच सेतु का काम करती है।

फिजिकल डेटा मॉडल

फिजिकल डेटा मॉडल यह दर्शाता है कि वास्तव में डेटा को डेटाबेस में कैसे संग्रहीत किया जाता है। यह मॉडल विशिष्ट टेबल संरचनाएँ, इंडेक्स, और स्टोरेज तंत्र को परिभाषित करता है, ताकि प्रदर्शन अनुकूलित हो और डेटा अखंडता सुनिश्चित हो। यह लॉजिकल डिज़ाइन को ऐसे प्रारूप में बदलता है जो डेटाबेस सिस्टम के लिए उपयुक्त हो।

डेटा मॉडलिंग तकनीकें

डेटा मॉडलिंग एक जैसा समाधान नहीं है। डेटा की जटिलता और लक्ष्यों के आधार पर अलग-अलग तकनीकों का प्रयोग किया जाता है। इस अनुभाग में, हम कुछ लोकप्रिय डेटा मॉडलिंग तरीकों की चर्चा करेंगे। 

एंटिटी-रिलेशनशिप (ER) मॉडलिंग

ER मॉडलिंग डेटा को प्रस्तुत करने की सबसे आम तकनीकों में से एक है। यह तीन प्रमुख तत्त्वों को परिभाषित करने पर केंद्रित होती है: 

  • एंटिटीज़ (सिस्टम के भीतर वस्तुएँ या चीज़ें)
  • रिलेशनशिप्स (ये एंटिटीज़ एक-दूसरे के साथ कैसे अंतःक्रिया करती हैं)
  • एट्रिब्यूट्स (एंटिटीज़ के गुण)

ER मॉडल डेटा की संरचना को स्पष्ट, दृश्य रूप में प्रस्तुत करता है, ताकि अलग-अलग डेटा बिंदुओं के बीच संबंध मैप किए जा सकें।

उदाहरण: ई-कॉमर्स स्टोर

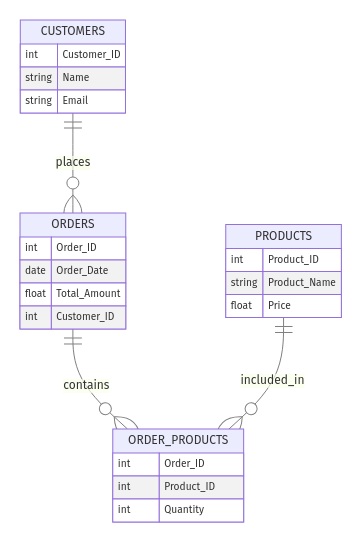
एक ऑनलाइन स्टोर पर विचार करें। आपके पास निम्नलिखित एंटिटीज़ हो सकती हैं:

  • Customers (जैसे एट्रिब्यूट्स: Customer_ID, Name, और Email)
  • Orders (सहित Order_ID, Order_Date, Total_Amount)
  • Products (सहित Product_ID, Product_Name, Price)

रिलेशनशिप्स इस प्रकार हो सकती हैं:

  • "Customers place Orders" (वन-टू-मैनी)
  • "Orders contain Products" (मैनी-टू-मैनी)

ER इस तरह दिखता है:

Example ER model for e-commerce store.

ई-कॉमर्स स्टोर के लिए ER मॉडल का उदाहरण। छवि: लेखक

डायमेंशनल मॉडलिंग

डायमेंशनल मॉडलिंग का व्यापक उपयोग डेटा वेयरहाउसिंग और एनालिटिक्स में होता है, जहाँ डेटा को अक्सर फैक्ट्स और डायमेंशंस के रूप में दर्शाया जाता है। यह तकनीक जटिल डेटा को स्टार या स्नोफ्लेक स्कीमा में व्यवस्थित करके सरल बनाती है, जिससे क्वेरी और रिपोर्टिंग कुशल हो जाती है।

उदाहरण: सेल्स रिपोर्टिंग

मान लीजिए आपको बिक्री डेटा का विश्लेषण करना है। आप इसे इस प्रकार संरचित करेंगे:

  • फैक्ट टेबल:
    • Sales (लेन-देन डेटा संग्रहीत करता है, जैसे Sales_ID, Revenue, Quantity_Sold)
  • डायमेंशन टेबल्स:
    • Time (जैसे, Date, Month, Year)
    • Product (जैसे, Product_ID, Category, Brand)
    • Customer (जैसे, Customer_ID, Location, Segment)

स्टार स्कीमा में, Sales फैक्ट टेबल सीधे डायमेंशन टेबल्स से जुड़ती है, जिससे विश्लेषक ऐसे रिपोर्ट कुशलता से बना सकते हैं जैसे प्रति माह कुल राजस्व या श्रेणी के अनुसार सबसे अधिक बिकने वाले उत्पाद। स्कीमा इस तरह दिखता है:
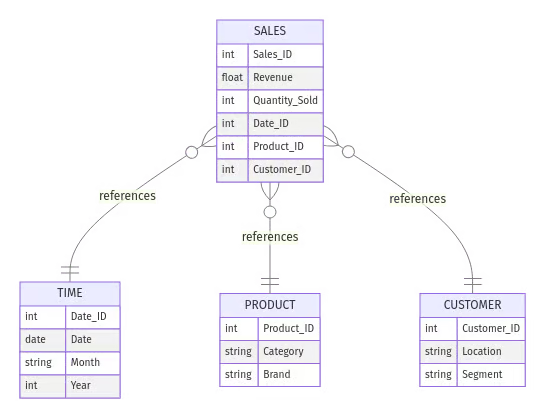
Example star schema for sales reporting.

सेल्स रिपोर्टिंग के लिए स्टार स्कीमा का उदाहरण। छवि: लेखक

💡 डायमेंशनल डेटा मॉडलिंग में और गहराई से जाना चाहते हैं? हमारा Star Schema बनाम Snowflake Schema गाइड देखें ताकि समझ सकें कि सर्वोत्तम प्रदर्शन के लिए किसे कब उपयोग करना है।

ऑब्जेक्ट-ओरिएंटेड मॉडलिंग

ऑब्जेक्ट-ओरिएंटेड मॉडलिंग का उपयोग जटिल प्रणालियों को दर्शाने के लिए किया जाता है, जहाँ डेटा और उस पर काम करने वाले फ़ंक्शंस को ऑब्जेक्ट्स के रूप में संकुलित (encapsulate) किया जाता है। यह तकनीक ऐसी अनुप्रयोगों के मॉडलिंग में उपयोगी है जिनमें जटिल, परस्पर संबंधित डेटा और व्यवहार होते हैं—विशेषकर सॉफ्टवेयर इंजीनियरिंग और प्रोग्रामिंग में।

उदाहरण: लाइब्रेरी मैनेजमेंट सिस्टम

मान लीजिए आप एक लाइब्रेरी मैनेजमेंट सिस्टम डिज़ाइन कर रहे हैं। आप इस तरह ऑब्जेक्ट्स परिभाषित कर सकते हैं:

  • Book (Title, Author, ISBN, Status)
  • Member (Name, Membership_ID, Checked_Out_Books)
  • Librarian (Name, Employee_ID, Role)

प्रत्येक ऑब्जेक्ट में एट्रिब्यूट्स (डेटा फ़ील्ड) और मेथड्स (फ़ंक्शंस) दोनों शामिल होते हैं। उदाहरण के लिए, एक Book ऑब्जेक्ट में .check_out() नामक मेथड हो सकता है जो उधार दिए जाने पर पुस्तक की स्थिति अपडेट करता है।

यह तरीका विशेष रूप से Java और Python जैसी ऑब्जेक्ट-ओरिएंटेड प्रोग्रामिंग (OOP) भाषाओं में लाभदायक है, जहाँ डेटा मॉडल्स को सीधे क्लासेस और ऑब्जेक्ट्स से मैप किया जा सकता है।
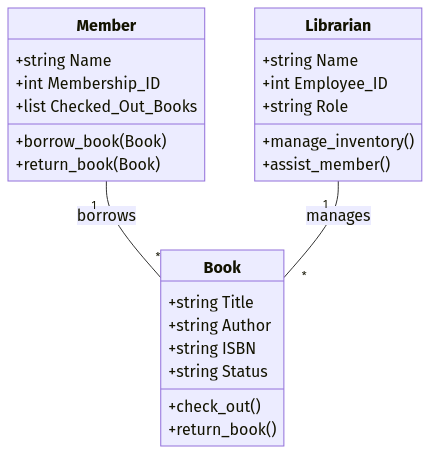
Example of the object-oriented data model.

ऑब्जेक्ट-ओरिएंटेड डेटा मॉडल का उदाहरण। छवि: लेखक

💡 Python में ऑब्जेक्ट-ओरिएंटेड प्रोग्रामिंग लागू करना सीखना चाहते हैं? देखें DataCamp का Object-Oriented Programming in Python कोर्स ताकि वास्तविक प्रोजेक्ट्स में OOP कॉन्सेप्ट्स में महारत हासिल कर सकें।

NoSQL और डॉक्युमेंट-आधारित मॉडलिंग

NoSQL और डॉक्युमेंट-आधारित मॉडलिंग तकनीकें लचीले, स्कीमा-रहित डेटाबेस के लिए बनाई गई हैं। 

यह तकनीक तब उपयोग की जाती है जब डेटा संरचनाएँ कम कठोर हों या समय के साथ विकसित होती हों। ये मॉडल बिना पूर्वनिर्धारित स्कीमा के JSON डॉक्युमेंट्स जैसे असंरचित या अर्ध-संरचित डेटा को संग्रहीत और प्रबंधित करने की अनुमति देते हैं।

जैसे MongoDB जैसे NoSQL डेटाबेस में, डॉक्युमेंट-आधारित मॉडल डेटा को डॉक्युमेंट्स के कलेक्शंस में व्यवस्थित करता है, जहाँ प्रत्येक डॉक्युमेंट की संरचना अनोखी हो सकती है। यह लचीलापन तेज़ इटरेशन और स्केलिंग की अनुमति देता है, खासकर बिग डेटा वातावरण में या ऐसे अनुप्रयोगों में जिनमें उच्च गति डेटा एक्सेस की आवश्यकता होती है।

उदाहरण: MongoDB में यूज़र प्रोफाइल संग्रहीत करना

रिलेशनल डेटाबेस में, यूज़र प्रोफाइल कई टेबल्स में संग्रहीत हो सकते हैं। लेकिन MongoDB जैसे NoSQL डॉक्युमेंट-आधारित मॉडल में, किसी यूज़र का डेटा एक ही JSON-जैसे डॉक्युमेंट में संग्रहीत किया जा सकता है:

{
  "user_id": 123,
  "name": "Alice Smith",
  "email": "alice@example.com",
  "address": {
    "street": "123 Main St",
    "city": "New York",
    "zip": "10001"
  },
  "purchases": [
    { "product_id": 101, "price": 19.99 },
    { "product_id": 202, "price": 49.99 }
  ]
}

डेटा मॉडलों का डेटा मॉडलिंग तकनीकों से मिलान

प्रत्येक डेटा मॉडलिंग तकनीक, उच्च-स्तरीय योजना से लेकर भौतिक कार्यान्वयन तक, डेटाबेस डिज़ाइन के अलग-अलग चरणों के साथ संरेखित होती है। लेख के शुरुआत में देखे गए प्रकारों के साथ उनका संबंध इस प्रकार है:

  • कॉन्सेप्चुअल डेटा मॉडल → एंटिटी-रिलेशनशिप (ER) मॉडलिंग
    • तकनीकी विवरणों के बिना उच्च-स्तरीय व्यावसायिक इकाइयों और संबंधों को परिभाषित करता है।
    • उदाहरण: एक ER डायग्राम जो दिखाता है कि Customers, Orders, और Products कैसे संबंधित हैं।
  • लॉजिकल डेटा मॉडल → ER, डायमेंशनल, और ऑब्जेक्ट-ओरिएंटेड मॉडलिंग
    • स्टोरेज पर ध्यान दिए बिना डेटा संरचना, एट्रिब्यूट्स, और बाधाएँ निर्दिष्ट करता है।
    • उदाहरण: एक स्टार स्कीमा जो Sales फैक्ट टेबल और Time, Product, तथा Customer जैसी डायमेंशन टेबल्स को दर्शाता है।
  • फिजिकल डेटा मॉडल → डायमेंशनल, ऑब्जेक्ट-ओरिएंटेड, और NoSQL मॉडलिंग
    • दर्शाता है कि डेटा को डेटाबेस में भौतिक रूप से कैसे संग्रहीत और अनुकूलित किया जाता है।
    • उदाहरण: MongoDB में यूज़र प्रोफाइल को लचीले JSON ऑब्जेक्ट्स के रूप में संग्रहीत करना या PostgreSQL में एक अनुकूलित रिलेशनल स्कीमा।

डेटा मॉडलिंग के लिए सर्वोत्तम प्रथाएँ

एक प्रभावी डेटा मॉडल बनाना केवल सही दृष्टिकोण चुनने के बारे में नहीं है—यह उन सर्वोत्तम प्रथाओं का पालन करने के बारे में है जो आपके मॉडल को स्केलेबल, कुशल और व्यावसायिक आवश्यकताओं के अनुरूप बनाए रखें। एक अच्छी तरह से डिज़ाइन किया गया मॉडल पुनरावृत्ति (redundancy), प्रदर्शन बाधाओं, और भविष्य के बदलावों के अनुरूप ढलने में कठिनाई जैसी आम समस्याओं से बचाता है।

नीचे, हम प्रमुख सर्वोत्तम प्रथाओं पर बात करेंगे जो लंबे समय तक उपयोगिता और प्रदर्शन का समर्थन करने वाले डेटा मॉडल बनाने में मदद करती हैं।

शुरू में नॉर्मलाइज़ करें, ज़रूरत पर डीनॉर्मलाइज़ करें

नॉर्मलाइज़ेशन डेटा मॉडलिंग का मूलभूत सिद्धांत है। यह डेटा को इस तरह व्यवस्थित करता है कि पुनरावृत्ति न्यूनतम हो और इसे छोटे, तार्किक रूप से संबंधित टेबल्स में संरचित करके निरंतरता सुनिश्चित की जा सके। यह प्रक्रिया विसंगतियों और असंगतियों की संभावनाओं को कम करती है, जिससे डेटा का प्रबंधन और अपडेट करना आसान हो जाता है।

उदाहरण: कस्टमर डेटाबेस का नॉर्मलाइज़ेशन

कस्टमर और ऑर्डर विवरण एक बड़ी टेबल में रखने के बजाय:

Order_ID

Customer_Name

Customer_Email

Product

Price

101

Alice Smith

alice@email.com

Laptop

1200

102

Alice Smith

alice@email.com

Mouse

25

आप ग्राहकों और ऑर्डर्स को दो संबंधित टेबल्स में अलग करके नॉर्मलाइज़ करते हैं:

  • Customers(Customer_ID, Name, Email)
  • Orders(Order_ID, Customer_ID, Product, Price)

यह अनावश्यक ग्राहक डेटा से बचाता है, जिससे अपडेट करना आसान हो जाता है। 

हालाँकि, रिपोर्टिंग और एनालिटिक्स के लिए, क्वेरी प्रदर्शन को अनुकूलित करने हेतु डीनॉर्मलाइज़ेशन आवश्यक हो सकता है। टेबल्स के बीच कई जॉइन्स करने के बजाय, पहले से एग्रीगेट की गई डीनॉर्मलाइज़्ड टेबल क्वेरीज़ को तेज़ कर सकती है। 

यह जानना महत्वपूर्ण है कि किस तकनीक को कब लागू करना है!

💡हमारा विस्तृत ट्यूटोरियल देखें Normalization in SQL ताकि समझ सकें कि नॉर्मलाइज़ेशन डेटा अखंडता में कैसे सुधार करता है और प्रदर्शन को अनुकूलित करता है।

अपने डेटा मॉडल को भविष्य के लिए सक्षम बनाना

जैसे-जैसे व्यवसाय विकसित होते हैं, वैसे-वैसे उनकी डेटा आवश्यकताएँ भी बदलती हैं। एक फ्यूचर-प्रूफ डेटा मॉडल का मतलब है ऐसा मॉडल बनाना जो लचीला और स्केलेबल हो, नए डेटा स्रोतों और बदलती माँगों को सँभालने के लिए तैयार हो। 

संभावित वृद्धि और भविष्य के तकनीकी विकासों पर विचार करने से आप महँगे पुनर्निर्माणों का पूर्वानुमान लगाकर उनसे बच सकते हैं। शुरुआत से ही स्केलेबिलिटी, मॉड्यूलैरिटी, और मेंटेनबिलिटी के लिए निर्माण करना सुनिश्चित करता है कि मॉडल बदलते परिवेश के अनुरूप ढल सके और समय के साथ मूल्य प्रदान करता रहे।

उदाहरण: ई-कॉमर्स डेटाबेस में स्केलेबिलिटी की योजना बनाना

कल्पना करें कि आप एक ऑनलाइन स्टोर के लिए डेटाबेस डिज़ाइन कर रहे हैं। शुरू में आप केवल घरेलू ऑर्डर्स को ट्रैक करते हैं, पर बाद में वैश्विक विस्तार करते हैं। यदि आपका स्कीमा केवल एक ही मुद्रा का समर्थन करता है, तो बाद में बड़े बदलावों की ज़रूरत पड़ेगी।

  • सिर्फ Price कॉलम के बजाय, Currency_Code और Exchange_Rate फ़ील्ड्स शामिल करें।
  • ऐसा लचीला स्कीमा उपयोग करें जो डेटाबेस को पुनर्संरचित किए बिना नए एट्रिब्यूट्स जोड़ने दे।

अपने मॉडल को भविष्य के लिए सक्षम बनाने के अन्य तरीके:

  • वितरित प्रणालियों में स्केलेबिलिटी के लिए ऑटो-इन्क्रीमेंटेड IDs की बजाय UUIDs का उपयोग करें।
  • NoSQL डेटाबेस में स्कीमा इवोल्यूशन पर विचार करें, जहाँ डॉक्युमेंट्स में समय के साथ बदलने वाले वैकल्पिक फ़ील्ड्स हो सकते हैं।

डेटा गुणवत्ता और स्थिरता सुनिश्चित करें

डेटा मॉडल उतना ही अच्छा है जितना अच्छा उसमें मौजूद डेटा। मजबूत डेटा गवर्नेंस और मान्यकरण तकनीकों को लागू करना मॉडल में डेटा की गुणवत्ता और स्थिरता बनाए रखने के लिए महत्वपूर्ण है। 

डेटा वैलिडेशन सुनिश्चित करता है कि सही प्रकार का डेटा दर्ज हो और वह विशिष्ट नियमों का पालन करे—जिससे त्रुटियाँ कम हों और व्यावसायिक अंतर्दृष्टियों की विश्वसनीयता बढ़े। यह डेटा मॉडल की अखंडता को बनाए रखता है और सुनिश्चित करता है कि निर्णय-निर्माता सटीक अंतर्दृष्टि के लिए उस पर भरोसा कर सकें।

उदाहरण: प्रोडक्ट लिस्टिंग्स के लिए डेटा वैलिडेशन का उपयोग

एक ऑनलाइन स्टोर में असंगत उत्पाद विवरण रिपोर्टिंग त्रुटियों का कारण बन सकते हैं। इसे रोकने के लिए:

  • अनुमत मान लागू करने के लिए CHECK कंस्ट्रेंट्स का उपयोग करें (जैसे, Stock_Quantity >= 0)।
  • रेफ़रेंशियल इंटीग्रिटी सुनिश्चित करने के लिए फ़ॉरेन कीज़ लागू करें।
  • रिपोर्टिंग पर प्रभाव डालने से पहले असंगतियों को पकड़ने के लिए टूल्स के साथ डेटा वैलिडेशन को स्वचालित करें।

💡मेरा Great Expectations ट्यूटोरियल देखें और सीखें कि Python का उपयोग करके डेटा वैलिडेशन को कैसे स्वचालित करें और अपनी डेटा पाइपलाइनों में स्थिरता सुनिश्चित करें।

व्यावसायिक आवश्यकताओं पर ध्यान दें

एक अच्छी तरह से डिज़ाइन किया गया डेटा मॉडल सीधे व्यावसायिक लक्ष्यों का समर्थन करना चाहिए। स्कीमा बनाने से पहले, स्टेकहोल्डर्स के साथ मिलकर यह परिभाषित करें:

  • उन्हें कौन-सी अंतर्दृष्टियाँ चाहिए?
  • डेटा को कैसे एक्सेस और अपडेट किया जाएगा?
  • कौन-से प्रदर्शन संबंधी समझौते स्वीकार्य हैं?

उदाहरण: तेज़ अंतर्दृष्टि के लिए रिटेल डैशबोर्ड का अनुकूलन

एक रिटेल कंपनी रीयल-टाइम में बिक्री रुझानों को ट्रैक करना चाहती है। कई जॉइन्स वाले पूर्णतः नॉर्मलाइज़्ड स्कीमा का उपयोग करने के बजाय, आप एक डीनॉर्मलाइज़्ड रिपोर्टिंग टेबल डिज़ाइन कर सकते हैं जो दैनिक बिक्री को पहले से एग्रीगेट कर दे, जिससे डैशबोर्ड क्वेरीज़ काफी तेज़ हो जाएँ।

व्यवसाय-अनुरूप डेटा मॉडल:

  • रीयल-टाइम डेटा तेज़ लेन-देन के लिए OLTP (Online Transaction Processing) सिस्टम में संग्रहीत होता है।
  • एग्रीगेटेड बिक्री रिपोर्ट्स विश्लेषण के लिए OLAP (Online Analytical Processing) डेटाबेस में संग्रहीत होती हैं।

💡हमारा OLTP बनाम OLAP गाइड एक्सप्लोर करें ताकि समझ सकें कि कब लेन-देन के लिए और कब रिपोर्टिंग के लिए अनुकूलन करना है।

डेटा मॉडल को व्यावसायिक आवश्यकताओं के अनुरूप बनाकर, आप अनावश्यक जटिलता से बचते हैं और सुनिश्चित करते हैं कि स्टेकहोल्डर्स को प्रदर्शन समस्याओं के बिना आवश्यक अंतर्दृष्टि मिलें।

निष्कर्ष

यदि आप डेटा को प्रभावी ढंग से संरचित, प्रबंधित, और अनुकूलित करना चाहते हैं, तो सही डेटा मॉडलिंग तकनीकों को समझना और लागू करना आवश्यक है। जैसा कि हमने देखा, मॉडलिंग दृष्टिकोण का चुनाव व्यावसायिक लक्ष्यों, डेटा की जटिलता, और सिस्टम आवश्यकताओं पर निर्भर करता है।

डेटा मॉडलिंग, डेटा वेयरहाउसिंग, और डेटाबेस डिज़ाइन की समझ को गहरा करने के लिए, मैं इन संसाधनों को देखने की अनुशंसा करता/करती हूँ:

  • The Data Warehouse Toolkit – राल्फ किम्बल द्वारा डायमेंशनल मॉडलिंग की एक बुनियादी गाइड, जो डेटा वेयरहाउस डिज़ाइन की सर्वोत्तम प्रथाओं को कवर करती है।
  • Introduction to Data Modeling in Snowflake – Snowflake में स्केलेबल डेटा मॉडल डिज़ाइन करना सीखें।
  • Data Warehousing Concepts – डायमेंशनल मॉडलिंग और ETL प्रक्रियाओं सहित कोर डेटा वेयरहाउसिंग सिद्धांतों को समझें।
  • Database Design – दक्षता, स्थिरता, और स्केलेबिलिटी सुनिश्चित करने के लिए डेटाबेस स्ट्रक्चरिंग तकनीकों में महारत हासिल करें।

Kurtis Pykes 's photo
Author
Kurtis Pykes
LinkedIn
विषय
डेटा इंजीनियरिंग
डेटा विश्लेषण

इन कोर्सेस के साथ डेटा इंजीनियरिंग के बारे में और जानें!

कोर्स

डेटा इंजीनियरिंग को समझना

2 घंटा
375K
जानें कि डेटा इंजीनियर वह आधार कैसे तैयार करते हैं जो डेटा विज्ञान को संभव बनाता है। कोई कोडिंग शामिल नहीं!
विवरण देखेंRight Arrow
पाठ्यक्रम शुरू करें
और देखेंRight Arrow