

PySpark क्या है?
PySpark, Apache Spark के लिए Python API है। आपका Python कोड वे ट्रांसफॉर्मेशन बताता है जो आप चाहते हैं, और Spark का इंजन, जो Java Virtual Machine (JVM) पर चलता है, उन्हें प्लान करता है और क्लस्टर भर में चलाता है। आपको Scala या Java लिखे बिना Spark का डिस्ट्रिब्यूटेड एक्ज़ीक्यूशन मिल जाता है।
डेटा साइंटिस्ट PySpark का उपयोग बड़े डेटासेट साफ़ और एग्रीगेट करने के लिए करते हैं, डेटा इंजीनियर ETL पाइपलाइनों के लिए, और दोनों pyspark.ml का उपयोग उन डेटा पर मॉडल ट्रेन करने के लिए करते हैं जो एक मशीन में फिट नहीं होते। यदि आपका अधिकतर काम आज pandas में होता है, तो DataFrame API आपको परिचित लगेगा।
pandas की बजाय PySpark कब इस्तेमाल करें
जब डेटा एक अकेली मशीन से बड़ा हो जाता है, तब PySpark का लाभ मिलता है; उससे नीचे, pandas आम तौर पर तेज़ है क्योंकि उसमें JVM स्टार्टअप या टास्क शेड्यूलिंग का ओवरहेड नहीं होता।
| फ़ीचर | pandas | PySpark |
|---|---|---|
| डेटा आकार | एक मशीन की RAM तक सीमित | क्लस्टर की सम्मिलित मेमोरी और डिस्क तक सीमित |
| एक्ज़ीक्यूशन | ईगर, ज़्यादातर सिंगल कोर | लेज़ी, कोर या मशीनों में समानांतर |
| स्टार्टअप ओवरहेड | कुछ नहीं | JVM और SparkSession शुरू होने में कुछ सेकंड |
| स्ट्रीमिंग डेटा | सपोर्टेड नहीं | Structured Streaming |
| मशीन लर्निंग | scikit-learn इकोसिस्टम | pyspark.ml (डिस्ट्रिब्यूटेड) |
| फॉल्ट टॉलरेंस | नहीं; क्रैश होने पर काम खो जाता है | खोए हुए पार्टिशन उनकी लिनिएज से फिर से कंप्यूट होते हैं |
मेरा thumb rule: यदि डेटा मेमोरी में आराम से फिट होता है और जॉब एक लैपटॉप पर चलता है, तो pandas पर बने रहें। PySpark पर तब जाएँ जब आप मेमोरी एरर्स से जूझ रहे हों, या जॉब अंततः क्लस्टर या Databricks जैसे प्लेटफ़ॉर्म पर चलना हो।
PySpark कैसे इंस्टॉल करें
PySpark, PyPI से एक pip कमांड से इंस्टॉल हो जाता है, जो Spark रनटाइम पैक करता है, इसलिए लोकल काम के लिए अलग Spark या Hadoop डाउनलोड की ज़रूरत नहीं। इसे चलाने से पहले दो प्रीरिक्विज़िट देखें।
प्रीरिक्विज़िट
आधिकारिक इंस्टॉलेशन गाइड के अनुसार, PySpark 4.3 के लिए चाहिए:
- Python 3.11 या बाद का। PySpark 4.3 ने Python 3.10 का सपोर्ट हटा दिया; यदि आपको नया वर्ज़न चाहिए, तो हमारा Python सेटअप गाइड देखें।
- Java 17 या बाद का (Spark 4.3 Java 17, 21, और 25 पर चलता है) और
JAVA_HOMEenvironment variable उसी की ओर पॉइंट करे। हमारे Java इंस्टॉल करने के गाइड में हर ऑपरेटिंग सिस्टम के स्टेप्स हैं।
आप दोनों को टर्मिनल से चेक कर सकते हैं:
python3 --version # Python 3.11 or later
java -version # openjdk version "17" or laterयदि आप DataLab या Databricks में काम करते हैं, तो PySpark पहले से इंस्टॉल है, और आप सीधे डेटासेट पर जा सकते हैं।
pip से PySpark इंस्टॉल करना
मैं वर्चुअल एन्वायरनमेंट की सलाह देता हूँ ताकि PySpark की डिपेंडेंसियाँ दूसरे प्रोजेक्ट्स से न टकराएँ:
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0Windows पर python3 की जगह python उपयोग करें, और एन्वायरनमेंट को pyspark-env\Scripts\activate से एक्टिवेट करें। [sql] extra pandas, PyArrow, और NumPy जोड़ता है, जिन्हें PySpark toPandas() और pandas UDFs के लिए उपयोग करता है। मैं pandas<3 पिन करता हूँ क्योंकि PySpark 4.3 यह चेतावनी देता है कि वह अभी pandas 3.0 को पूरी तरह सपोर्ट नहीं करता।
पहली बार रन फेल होने के दो मुख्य कारण:
JAVA_GATEWAY_EXITEDया "Unable to locate a Java Runtime": Java गायब है याJAVA_HOMEसेट नहीं है।PYTHON_VERSION_MISMATCH: Spark के वर्कर प्रोसेस ने आपके स्क्रिप्ट से अलग Python पकड़ लिया।PYSPARK_PYTHONको अपने एन्वायरनमेंट के इंटरप्रेटर पर सेट करें, उदाहरण के लिएexport PYSPARK_PYTHON=$(which python)।
ऑपरेटिंग सिस्टम-विशिष्ट स्टेप्स, जिनमें Windows भी शामिल है, के लिए हमारा PySpark इंस्टॉलेशन गाइड देखें।
डेटासेट लाना
उदाहरणों में UK-आधारित एक ऑनलाइन रिटेलर के 541,909 ट्रांज़ैक्शंस का ई-कॉमर्स डेटासेट उपयोग होता है, जो दिसंबर 2010 से दिसंबर 2011 तक फैला है। हर रो एक इनवॉइस की एक प्रोडक्ट लाइन है, 8 कॉलम्स के साथ:
InvoiceNo: इनवॉइस नंबर (जो "C" से शुरू होते हैं वे कैंसलेशन हैं)StockCodeऔरDescription: प्रोडक्ट कोड और नामQuantityऔरUnitPrice: खरीदी गई यूनिट्स और प्रति यूनिट कीमत, पाउंड स्टर्लिंग मेंInvoiceDate: खरीद की तारीख और समयCustomerID: ग्राहक पहचानकर्ता (कुछ पंक्तियों में गुम)Country: ग्राहक का देश
आप इसे datacamp_ecommerce.csv के रूप में DataLab डेटासेट पेज से डाउनलोड कर सकते हैं। यह UCI Machine Learning Repository का Online Retail डेटासेट है, इसलिए आप सार्वजनिक स्रोत से भी वही फ़ाइल बना सकते हैं (इसके लिए pip install openpyxl चाहिए):
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Match the DataLab file's date format, e.g. 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)23 MB की Excel फ़ाइल पढ़ने में लगभग एक मिनट लगता है। CSV को उसी फ़ोल्डर में सेव करें जहाँ से आप बाकी कोड चलाएँगे।
SparkSession बनाना
SparkSession हर PySpark प्रोग्राम का एंट्री पॉइंट है: यह आपके Python कोड को Spark इंजन से जोड़ता है और DataFrames बनाता है। आप प्रति एप्लिकेशन एक सेशन बिल्डर पैटर्न से बनाते हैं:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate() चल रहे सेशन को वापस देता है यदि एक मौजूद है, इसलिए नोटबुक में इसे दो बार कॉल करना सुरक्षित है। सादे Python प्रोसेस से लॉन्च करने पर, Spark लोकल मोड (local[*]) में चलता है, आपकी मशीन के हर CPU कोर को वर्कर की तरह उपयोग करता है, और जॉब्स देखने के लिए Spark UI http://localhost:4040 पर सर्व करता है। काम हो जाने पर, spark.stop() संसाधन छोड़ देता है।
ई-कॉमर्स डेटासेट लोड करना
सेशन चल रहा है, तो हम CSV को एक DataFrame में पढ़ सकते हैं। मैं inferSchema=True की बजाय एक स्पष्ट schema पास करता हूँ, क्योंकि infer करने से Spark सिर्फ कॉलम टाइप्स का अनुमान लगाने के लिए फ़ाइल को एक बार और स्कैन करता है:
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)उस स्निपेट की दो बातें मायने रखती हैं:
escape='"'उन प्रोडक्ट नामों को संभालता है जिनमें डबल्ड कोट्स आते हैं, जैसेRECORD FRAME 7"" SINGLE SIZE। Spark का डिफॉल्ट एस्केप कैरेक्टर बैकस्लैश है।- डेट पैटर्न
M/d/yy H:mm12/1/10 8:26जैसी वैल्यू से मेल खाता है। Spark 4.0 से, ANSI SQL मोड डिफॉल्ट रूप से ऑन है, इसलिएto_timestamp()किसी वैल्यू पर जो पैटर्न से मेल नहीं खाती,CANNOT_PARSE_TIMESTAMPएरर उठाता है। यदि आप बुरी पंक्तियों के लिएNULLचाहें, तोF.try_to_timestamp()उपयोग करें।
पहली पंक्तियाँ देखने और उन्हें गिनने के लिए:
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909और पढ़ने के विकल्पों के लिए, जैसे कई फ़ाइलें, डिलिमिटर्स, और करप्ट रिकॉर्ड्स, हमारा PySpark read CSV ट्यूटोरियल देखें।
RDDs बनाम DataFrames
RDDs और DataFrames PySpark में डिस्ट्रिब्यूटेड डेटा रिप्रेज़ेंट करने के दो तरीके हैं, और लगभग सारे नए कोड के लिए DataFrames सही चुनाव हैं।
| एब्स्ट्रैक्शन | क्या है | कब उपयोग करें |
|---|---|---|
| RDD (Resilient Distributed Dataset) | लो-लेवल, इम्यूटेबल कलेक्शन मनचाहे Python ऑब्जेक्ट्स का, पार्टिशनों में बँटा हुआ | अनस्ट्रक्चर्ड डेटा, या जब पार्टिशनिंग पर सूक्ष्म नियंत्रण चाहिए |
| DataFrame | डिस्ट्रिब्यूटेड टेबल नामित, टाइप्ड कॉलम्स के साथ, pandas DataFrame जैसी | एनालिसिस, SQL क्वेरी, ETL, और मशीन लर्निंग |
यही एग्रीगेशन—प्रति देश कुल मात्रा—दोनों तरीकों से:
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD: आप Python फ़ंक्शंस से लॉजिक लिखते हैं
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame: आप परिणाम घोषित करते हैं, और Spark इसे कंप्यूट करने की योजना बनाता है
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+RDD वर्ज़न आपका lambda Python वर्कर प्रोसेस में चलाता है। DataFrame वर्ज़न Spark के Catalyst optimizer से होकर जाता है, जो क्वेरी को एक कुशल प्लान में फिर से लिखता है जो JVM के अंदर चलता है, इसलिए बिना किसी ट्यूनिंग के DataFrame कोड आम तौर पर तेज़ होता है। इस ट्यूटोरियल का बाकी हिस्सा DataFrames का उपयोग करता है।
लेज़ी इवैल्यूएशन: ट्रांसफॉर्मेशन बनाम एक्शन
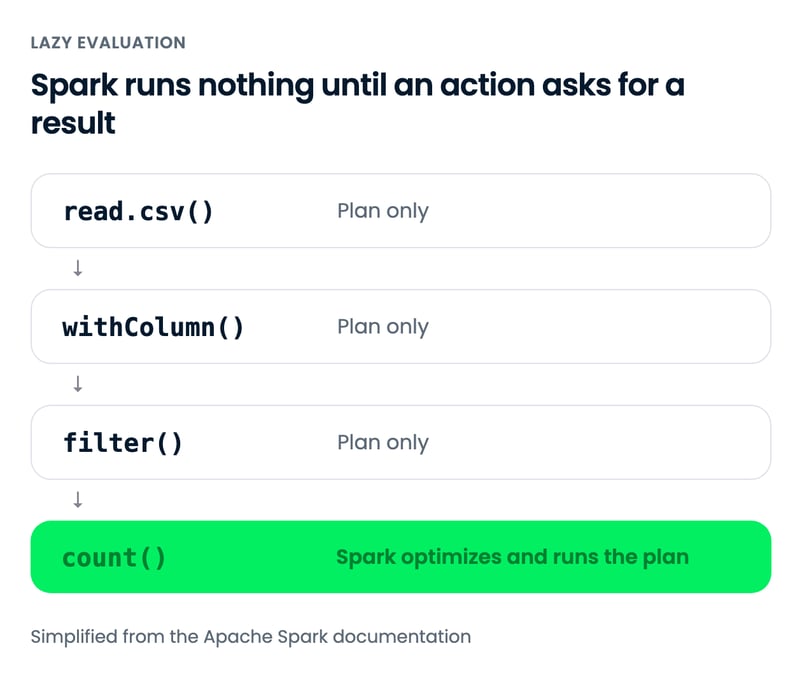
लेज़ी इवैल्यूएशन का मतलब है कि Spark किसी ट्रांसफॉर्मेशन को कॉल करते ही नहीं चलाता; वह स्टेप को एक प्लान में रिकॉर्ड करता है और तभी पूरा प्लान चलाता है जब कोई एक्शन परिणाम माँगता है।
| ट्रांसफॉर्मेशन | एक्शन | |
|---|---|---|
| क्या करते हैं | एक नया DataFrame वर्णित करते हैं | परिणाम लौटाते हैं या डेटा लिखते हैं |
| कब चलते हैं | कभी खुद से नहीं | तुरंत, हर पेंडिंग ट्रांसफॉर्मेशन को ट्रिगर करते हुए |
| उदाहरण | select(), filter(), withColumn(), groupBy(), join() | show(), count(), collect(), toPandas(), write |
नीचे दिया गया फ़िल्टर तुरंत लौट आता है, भले ही डेटासेट में आधे मिलियन से अधिक रो हों, क्योंकि अभी तक कुछ पढ़ा ही नहीं गया। count() कॉल ही जॉब लॉन्च करता है:
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # transformation: no job yet
print(uk_orders.count()) # action: Spark reads the file now495478एक्शन तक इंतज़ार करने से Spark एक साथ पूरी चेन को ऑप्टिमाइज़ कर सकता है। explain() वह फिजिकल प्लान प्रिंट करता है जो उसने चुना (यहाँ संक्षिप्त):
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...PushedFilters एंट्री दिखाती है कि Spark ने country फ़िल्टर को फ़ाइल स्कैन के भीतर धकेल दिया, ताकि दूसरी देशों की पंक्तियाँ CSV पढ़ते समय ही गिर जाएँ। एक व्यावहारिक परिणाम: किसी ट्रांसफॉर्मेशन के अंदर डेटा एरर, जैसे ANSI मोड में पार्स न होने वाली डेट, अक्सर अगले एक्शन के समय ही सतह पर आती है, कुछ लाइनों बाद।
आम DataFrame ऑपरेशंस
अधिकतर PySpark कोड पाँच DataFrame ऑपरेशंस की चेन होता है: select(), filter(), withColumn(), groupBy(), और join()। हर एक नया DataFrame लौटाता है, इसलिए आप उन्हें किसी भी क्रम में चेन कर सकते हैं।
select() से कॉलम चुनना
select() केवल वे कॉलम वाली DataFrame लौटाता है जिन्हें आप नाम दें:
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rowsfilter() से पंक्तियाँ फ़िल्टर करना
filter() वे पंक्तियाँ रखता है जो शर्त से मेल खाती हैं। यह डेटासेट बिक्री को कैंसलेशन (इनवॉइस नंबर "C" से शुरू), निगेटिव क्वांटिटी, और बिना ग्राहक वाली पंक्तियों के साथ मिलाता है, इसलिए मैं सिर्फ वैध बिक्री रखूँगा:
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884शर्तों को & (और), | (या), और ~ (नॉट) से जोड़ें, और हर एक को कोष्ठक में रखें, क्योंकि अन्यथा Python का ऑपरेटर प्रीसीडेंस & को > से पहले इवैल्यूएट करेगा। हमारा PySpark filter ट्यूटोरियल और पैटर्न कवर करता है।
withColumn() से कॉलम जोड़ना
withColumn() एक कॉलम जोड़ता है, या उसी नाम के कॉलम को बदलता है। यहाँ यह हर लाइन का वैल्यू निकालता है:
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rowsकंडीशनल कॉलम्स के लिए F.when() के साथ हमारा PySpark withColumn() ट्यूटोरियल देखें।
groupBy() और agg() से एग्रीगेट करना
groupBy() एक या अधिक कॉलम से पंक्तियाँ समूहित करता है, और agg() प्रति समूह एक या अधिक समरियाँ निकालता है। कौन से देश सबसे अधिक राजस्व लाते हैं?
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rowsUK का दबदबा है, जैसा कि UK रिटेलर से अपेक्षित है। अधिक दिलचस्प पंक्तियाँ Netherlands और Ireland (EIRE के रूप में सूचीबद्ध) हैं: 9 और 3 ग्राहक, Germany के 94 से अधिक खर्च करते हैं, जो थोक खरीदारों का संकेत देता है।
ध्यान दें कि मैं functions मॉड्यूल को F नाम से इम्पोर्ट करता हूँ, from pyspark.sql.functions import * की बजाय, जो Python के बिल्ट-इन sum(), min(), और max() को शैडो कर देता है। PySpark 4.0 से, वह वाइल्डकार्ड इम्पोर्ट पुराने camelCase नाम countDistinct को भी अब एक्सपोज़ नहीं करता।
हमारा PySpark groupBy ट्यूटोरियल एग्रीगेशंस में और गहराई से जाता है।
join() से DataFrames जोड़ना
join() साझा की पर दो DataFrames को जोड़ता है। हर देश को एक रीजन से लेबल करने के लिए, मैं एक छोटा लुकअप टेबल जॉइन करूँगा जो जान-बूझकर Australia को छोड़ता है:
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rowsलेफ्ट जॉइन बाएँ DataFrame की हर पंक्ति रखता है और मिसिंग मैचेज़ को NULL से भरता है, इसीलिए Australia नतीजे में रहता है। इनर जॉइन (how="inner", डिफॉल्ट) इसे गिरा देता। हमारा PySpark joins ट्यूटोरियल सभी जॉइन टाइप्स और उनके परफॉर्मेंस की तुलना करता है।
PySpark में Spark SQL
Spark SQL आपको किसी DataFrame को अस्थायी व्यू के रूप में रजिस्टर करके स्टैंडर्ड SQL से क्वेरी करने देता है। यह क्वेरी groupBy सेक्शन की country revenue टेबल को दोहराती है:
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+दोनों वर्ज़न एक ही ऑप्टिमाइज़्ड प्लान में कंपाइल होते हैं, इसलिए कोई भी तेज़ नहीं है। मैं SQL का उपयोग तब करता हूँ जब लंबी एग्रीगेशन लिखनी हो जिसे एनालिस्ट पढ़ेंगे, और DataFrame API तब जब मुझे क्वेरी के आसपास Python लॉजिक चाहिए, जैसे लूप में फ़िल्टर बनाना। spark.sql() एक DataFrame लौटाता है, इसलिए आप दोनों को मिलाकर चला सकते हैं।
अस्थायी व्यू SparkSession के रुकने तक रहता है।
PySpark के साथ मशीन लर्निंग: K-Means उदाहरण
PySpark का pyspark.ml मॉड्यूल DataFrames पर मॉडल ट्रेन करता है, और एक Pipeline फीचर प्रिपरेशन और मॉडल को एक ऑब्जेक्ट में चेन कर देता है जिसे आप फिट और रीउस कर सकते हैं। इसे दिखाने के लिए, मैं रीसेंसी, फ़्रीक्वेंसी, और मानीटरी वैल्यू (RFM) पर K-Means क्लस्टरिंग से रिटेलर के ग्राहकों का सेगमेंटेशन करूँगा—एक मानक मार्केटिंग सेगमेंटेशन:
- Recency: ग्राहक की आखिरी खरीद के बाद से बीते दिन
- Frequency: अलग-अलग इनवॉइस की संख्या
- Monetary: कुल खर्च राशि
groupBy() से RFM फीचर्स बनाना
साफ़ किए हुए sales_only DataFrame पर एक groupBy() से तीनों फीचर्स बनते हैं। Recency डेटा में आखिरी इनवॉइस के अगले दिन से मापी जाती है:
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+मानीटरी कॉलम देखें: लगभग £2,054 का औसत, उससे चार गुना से अधिक का स्टैन्डर्ड डेविएशन, और £280,000 से ऊपर का अधिकतम। K-Means यूक्लिडियन डिस्टेंस नापता है, इसलिए कुछ बड़े खर्च करने वाले क्लस्टर्स पर हावी हो जाएँगे। हर फीचर का लॉग लेना पहले उस लंबी टेल को कंप्रेस कर देता है।
Pipeline में स्केलिंग और क्लस्टरिंग
Pipeline में 3 स्टेज हैं: VectorAssembler फीचर्स को उस सिंगल वेक्टर कॉलम में पैक करता है जिसकी pyspark.ml मॉडेल्स को अपेक्षा होती है, StandardScaler उन्हें एक ही स्केल पर लाता है, और KMeans क्लस्टर करता है। मैं k = 2 से 6 तक फिट करता हूँ और हर मॉडल को सिलोएट स्कोर से स्कोर करता हूँ, जो -1 से 1 तक होता है, और अधिक का मतलब बेहतर-अलग क्लस्टर्स:
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache() rfm_log को मेमोरी में रखता है, क्योंकि लूप में हर फिट और इवैल्यूएशन इसे दोबारा पढ़ते हैं; इसके बिना, Spark हर फिट पर CSV से RFM टेबल फिर से कंप्यूट करता।
k चुनना और सेगमेंट पढ़ना
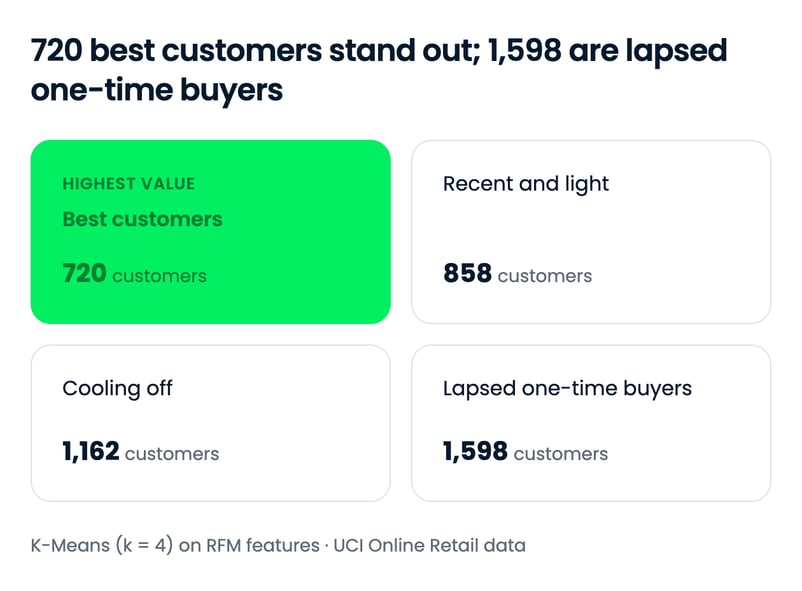
सिलोएट स्कोर k = 2 पर पीक करता है, लेकिन 2 सेगमेंट ज़्यादातर सक्रिय ग्राहकों को लैप्स्ड वालों से अलग करते हैं, जिससे मार्केटिंग टीम को बहुत कुछ नहीं मिलता। k = 4 का स्कोर k = 3 जैसा ही है और यह सक्रिय ग्राहकों को बड़े खर्च वालों और नए लोगों में बाँट देता है, इसलिए मैं इसे उपयोग करूँगा और हर क्लस्टर का प्रोफाइल करूँगा:
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+ये चार सेगमेंट साफ़ पढ़ते हैं:
- क्लस्टर 1, सर्वश्रेष्ठ ग्राहक (720): औसतन पिछले 2 हफ्तों के भीतर खरीदा, लगभग 14 ऑर्डर्स और प्रति ग्राहक £8,000 से अधिक खर्च। रिटेंशन और लॉयल्टी ऑफ़र यहाँ जाएँ।
- क्लस्टर 3, हालिया और हल्के (858): पिछले 3 हफ्तों में सक्रिय लेकिन केवल लगभग 2 ऑर्डर्स। कई संभवतः नए ग्राहक हैं, जिन्हें दूसरे और तीसरे ऑर्डर की ओर पोषित करना सार्थक होगा।
- क्लस्टर 2, ठंडे पड़ते हुए (1,162): मध्यम खर्च, लेकिन उनकी आखिरी खरीद से लगभग 11 हफ्ते। यहाँ विन-बैक कैंपेन के सबसे अच्छे आसार हैं।
- क्लस्टर 0, लैप्स्ड वन-टाइम खरीदार (1,598): ज़्यादातर एक ही ऑर्डर, लगभग £326, करीब 6 महीने पहले। सबसे बड़ा समूह और सबसे कम मूल्यवान।
क्लस्टर नंबर मनमाने लेबल होते हैं, और अलग seed उन्हें फिर क्रमित कर सकता है, इसलिए नाम देने से पहले हमेशा क्लस्टर्स का प्रोफाइल करें। K-Means अपने सेंट्रॉयड कैसे चुनता है, यह सीखने के लिए हमारा k-means क्लस्टरिंग का परिचय देखें, और pyspark.ml API रेफ़रेंस हर मॉडल और ट्रांसफॉर्मर सूचीबद्ध करता है। हमारा Machine Learning with PySpark कोर्स क्लासिफ़िकेशन, रिग्रेशन, और Pipelines के साथ मॉडल ट्यूनिंग कवर करता है।
अंतिम विचार
PySpark कुछ विचारों पर आता है: शुरुआत के लिए एक SparkSession, लगभग हर चीज़ के लिए DataFrames, लेज़ी ट्रांसफॉर्मेशन जो तभी चलते हैं जब किसी एक्शन को परिणाम चाहिए, और हर क्वेरी को Python या SQL में लिखने का चुनाव। इस ट्यूटोरियल की हर चीज़ लैपटॉप पर लोकल मोड में चली, और वही कोड बिना बदले क्लस्टर पर चलता है।
541,909-रो वाली फ़ाइल को क्लस्टर की ज़रूरत नहीं, और pandas इसे संभाल लेता। यह जान-बूझकर किया गया था, क्योंकि बड़े डेटा पर जो आदतें मायने रखती हैं (स्पष्ट स्कीमा, शुरुआती फ़िल्टरिंग, जिस चीज़ का पुन: उपयोग करें उसे कैश करना, और explain() चेक करना) वे ऐसे डेटा पर बनाना आसान है जिसे आप देख-परख सकें।
यहाँ से, आपके लक्ष्य के आधार पर ये सबसे अच्छे अगले कदम हैं:
- DataFrame API अभ्यास करें: Introduction to PySpark
- गंदे वास्तविक-जीवन डेटा तैयार करें: Cleaning Data with PySpark
- सिंटैक्स हाथ में रखें: हमारा PySpark चीट शीट
- जॉब इंटरव्यू की तैयारी करें: Top PySpark interview questions
यदि आप आगे बढ़ने के इच्छुक हैं, तो मैं हमारा Big Data with PySpark ट्रैक सुझाता हूँ, जो क्रम में डेटा मैनेजमेंट, फीचर इंजीनियरिंग, मशीन लर्निंग पाइपलाइंस, और रिकमेंडेशन इंजन कवर करता है। टीमों के लिए, DataCamp for Business डेटा इंजीनियरिंग भूमिकाओं के लिए लर्निंग पाथ्स देता है।
PySpark FAQs
PySpark सीखने के लिए प्रीरिक्विज़िट क्या हैं?
PySpark 4.3 के लिए Python 3.11 या बाद का और Java 17 या बाद का चाहिए (Spark 4.3 Java 17, 21, और 25 पर चलता है), और JAVA_HOME आपके Java इंस्टॉलेशन की ओर पॉइंट करना चाहिए। आपको बेसिक Python में सहज होना चाहिए; pandas DataFrames का अनुभव मदद करता है, क्योंकि PySpark DataFrame API समान विचारों का उपयोग करता है। डिस्ट्रिब्यूटेड सिस्टम्स का पहले से कोई अनुभव आवश्यक नहीं है।
क्या PySpark, pandas से तेज़ है?
छोटे डेटा पर नहीं। pandas इन-प्रोसेस चलता है और कोई स्टार्टअप कॉस्ट नहीं है, जबकि PySpark JVM शुरू करने और टास्क शेड्यूल करने में कुछ सेकंड लगाता है, इसलिए जो डेटा आराम से मेमोरी में फिट होता है उस पर आमतौर पर pandas तेज़ होता है। जब काम एक मशीन की मेमोरी या CPU से बड़ा हो जाता है, PySpark तेज़ है क्योंकि वह पार्टिशनों को कोरों या क्लस्टर नोड्स में समानांतर प्रोसेस करता है।
PySpark में RDDs और DataFrames में क्या अंतर है?
RDD (Resilient Distributed Dataset) PySpark की लो-लेवल संरचना है: मनचाहे Python ऑब्जेक्ट्स का डिस्ट्रिब्यूटेड कलेक्शन जिसे आप अपने फ़ंक्शंस से प्रोसेस करते हैं। DataFrame डेटा को नामित, टाइप्ड कॉलम्स में ऑर्गनाइज़ करता है, pandas DataFrame की तरह, और Spark का Catalyst optimizer DataFrame क्वेरियों को कुशल एक्ज़ीक्यूशन प्लान में बदल देता है। लगभग सारे नए कोड के लिए DataFrames का उपयोग करें, और RDDs को अनस्ट्रक्चर्ड डेटा या पार्टिशनिंग पर सूक्ष्म नियंत्रण के लिए रखें।
मैं Jupyter Notebook में PySpark कैसे चलाऊँ?
Java 17 या बाद का इंस्टॉल करें, फिर जिस एन्वायरनमेंट में आपका नोटबुक चलता है उसमें pip install "pyspark[sql]" चलाएँ। पहले सेल में SparkSession बनाएँ:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()यदि आप लोकल सेटअप छोड़ना चाहें, तो DataLab और Databricks नोटबुक्स PySpark के साथ पहले से आते हैं।
मुझे pandas की बजाय PySpark कब उपयोग करना चाहिए?
PySpark का उपयोग तब करें जब आपका डेटा एक मशीन की मेमोरी में फिट नहीं होता, जब कोई जॉब क्लस्टर या Databricks जैसे प्लेटफ़ॉर्म पर चलना है, या जब आप ऐसी पाइपलाइंस बना रहे हैं जो लैपटॉप से आगे बढ़ेंगी। मेमोरी में फिट होने वाले डेटा पर खोजपरक विश्लेषण के लिए pandas सरल है और तुरंत शुरू हो जाता है। लोकल रूप से लिखा PySpark कोड बिना बदले क्लस्टर पर चलता है, इसलिए यदि स्केल-अप की संभावना है तो इसके साथ शुरू करना समझ में आता है।
PySpark में लेज़ी इवैल्यूएशन क्या है?
लेज़ी इवैल्यूएशन का मतलब है कि PySpark filter() या withColumn() जैसे ट्रांसफॉर्मेशन को कॉल करने पर नहीं चलाता। वह उन्हें एक प्लान में रिकॉर्ड करता है और केवल तब चलाता है जब कोई एक्शन, जैसे count(), show(), या write, परिणाम चाहता है। इंतज़ार करने से Spark पूरी चेन को ऑप्टिमाइज़ कर सकता है, उदाहरण के लिए फ़िल्टर्स को फ़ाइल स्कैन में पुश करके।
मैं PySpark में SQL क्वेरियाँ कैसे चलाऊँ?
किसी DataFrame को df.createOrReplaceTempView("sales") से अस्थायी व्यू के रूप में रजिस्टर करें, फिर spark.sql("SELECT ... FROM sales") से उसे क्वेरी करें। परिणाम एक साधारण DataFrame होता है, इसलिए आप SQL और DataFrame कोड को स्वतंत्र रूप से मिला सकते हैं। दोनों एक ही ऑप्टिमाइज़्ड प्लान में कंपाइल होते हैं, इसलिए कोई भी तेज़ नहीं है।
क्या PySpark चलाने के लिए Hadoop चाहिए?
नहीं। pip install pyspark Spark रनटाइम को बंडल करता है, जो आपकी मशीन पर लोकल मोड में Hadoop के बिना चलता है। आपको Hadoop कंपोनेंट्स केवल तब चाहिए जब आप HDFS से पढ़ते हैं या Spark को YARN क्लस्टर पर चलाते हैं।
नताशा एक डेटा कंसल्टेंट हैं जो डेटा साइंस और मार्केटिंग के संगम पर काम करती हैं। उनका मानना है कि समझदारी से इस्तेमाल किया गया डेटा व्यक्तियों और संगठनों के लिए असाधारण विकास को प्रेरित कर सकता है। एक स्व-अध्ययनित डेटा प्रोफेशनल के रूप में, नताशा ऐसे लेख लिखना पसंद करती हैं जो अन्य डेटा साइंस अभ्यर्थियों को इस उद्योग में प्रवेश करने में मदद करें। उनके निजी ब्लॉग और बाहरी प्रकाशनों पर प्रकाशित लेख औसतन 200 हजार मासिक दृश्य प्राप्त करते हैं।
PySpark, Apache Spark के लिए Python API है। आप Python में DataFrame कोड या SQL लिखते हैं, और Spark आपके लैपटॉप के हर CPU कोर या क्लस्टर की हर मशीन में काम बाँट देता है। मैं इसका सहारा तब लेता हूँ जब डेटा सेट pandas में आराम से फिट नहीं होता, या जब वही जॉब बिना दोबारा लिखे बाद में क्लस्टर पर चलना होता है।
इस PySpark ट्यूटोरियल में, मैं PySpark 4.3 इंस्टॉल करूँगा, एक SparkSession बनाऊँगा, और वे दो अवधारणाएँ समझाऊँगा जो अधिकतर नए उपयोगकर्ताओं को उलझाती हैं: RDDs बनाम DataFrames, और लेज़ी इवैल्यूएशन। फिर हम 541,909-रो वाली एक ई-कॉमर्स डेटासेट पर वे ऑपरेशंस करेंगे जो आप रोज़ करते हैं (select, filter, groupBy, join, और Spark SQL), और अंत में
pyspark.mlPipeline API से बना एक K-Means कस्टमर सेगमेंटेशन मॉडल करेंगे।यदि आप इस ट्यूटोरियल के साथ गाइडेड अभ्यास चाहते हैं, हमारा Introduction to PySpark कोर्स यही सामग्री कवर करता है। लंबी लर्निंग योजना के लिए हमारा गाइड देखें How to Learn PySpark From Scratch।
TL;DR
pip install "pyspark[sql]"से इंस्टॉल करें; PySpark 4.3 के लिए Python 3.11+ और Java 17+ चाहिए।SparkSessionसे शुरू होता है, और DataFrames (RDDs नहीं) डिफॉल्ट API हैं।count()याshow()जैसी किसी एक्शन तक कुछ नहीं चलता।pyspark.mlPipelines फीचर प्रिपरेशन और K-Means जैसे मॉडलों को एक ही ऑब्जेक्ट में जोड़ते हैं।Apache Spark क्या है?
Apache Spark डिस्ट्रिब्यूटेड डेटा प्रोसेसिंग के लिए एक ओपन-सोर्स इंजन है। यह डेटासेट को पार्टिशनों में बाँटता है, उन्हें क्लस्टर में समानांतर रूप से प्रोसेस करता है, और स्टेप्स के बीच इंटरमीडिएट परिणामों को डिस्क पर लिखने के बजाय मेमोरी में रखता है।
यही इन-मेemory डिज़ाइन मुख्य कारण है कि Spark ने अधिकतर बैच वर्कलोड्स के लिए Hadoop MapReduce की जगह ले ली (हम दोनों की तुलना करते हैं Hadoop vs Spark में)। Spark की शुरुआत 2009 में UC Berkeley के AMPLab में हुई, 2014 में यह Apache का टॉप-लेवल प्रोजेक्ट बना, और 30 अक्टूबर, 2026 को 4.3 वर्ज़न तक पहुँचा।
एक इंजन, अपनी बिल्ट-इन लाइब्रेरीज़ के ज़रिए कई वर्कलोड्स को कवर करता है:
pyspark.ml) डिस्ट्रिब्यूटेड मशीन लर्निंग के लिएड्राइवर, क्लस्टर मैनेजर, और एग्जीक्यूटर्स काम कैसे बाँटते हैं, इसे नज़दीक से देखने के लिए हमारा Apache Spark आर्किटेक्चर गाइड देखें।