
लार्ज लैंग्वेज मॉडल्स (LLMs) फ्रेमवर्क
GPT-4 और बाद में GPT-4o के आने के साथ, लार्ज लैंग्वेज मॉडल्स बनाने और आधुनिक AI की पूरी क्षमता को साकार करने की दौड़ शुरू हो चुकी है। बुद्धिमान AI ऐप्लिकेशन बनाने के लिए LLMs को वेक्टर डेटाबेस और इंटीग्रेशन फ्रेमवर्क की आवश्यकता होती है।
1. Qdrant
Qdrant एक ओपन-सोर्स वेक्टर सिमिलैरिटी सर्च इंजन और वेक्टर डेटाबेस है, जो सुविधाजनक API के साथ प्रोडक्शन-रेडी सेवा प्रदान करता है, जिससे आप वेक्टर एम्बेडिंग्स को स्टोर, सर्च और मैनेज कर सकते हैं।
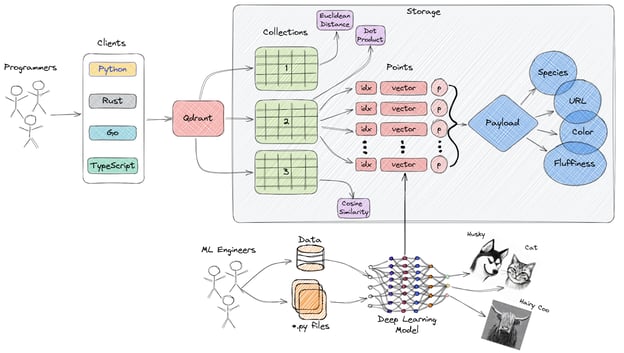
Qdrant की आर्किटेक्चर का उच्च-स्तरीय अवलोकन
मुख्य विशेषताएँ:
- आसान-से-उपयोग API: यह आसान Python API देता है और डेवलपर्स को कई प्रोग्रामिंग भाषाओं में क्लाइंट लाइब्रेरी जनरेट करने की सुविधा भी देता है।
- तेज़ और सटीक: यह Approximate Nearest Neighbor Search के लिए HNSW एल्गोरिथ्म के अनोखे कस्टम संशोधन का उपयोग करता है, जो सटीकता से समझौता किए बिना अत्याधुनिक सर्च स्पीड प्रदान करता है।
- समृद्ध डेटा प्रकार: Qdrant विभिन्न प्रकार के डेटा और क्वेरी कंडीशंस को सपोर्ट करता है, जिनमें स्ट्रिंग मैचिंग, संख्यात्मक रेंज, जियो-लोकेशन्स आदि शामिल हैं।
- डिस्ट्रिब्यूटेड: यह क्लाउड-नेटिव है और हॉरिज़ोंटली स्केल कर सकता है, जिससे किसी भी डेटा वॉल्यूम के लिए उपयुक्त कंप्यूट संसाधन उपयोग करना संभव होता है।
- कुशल: Qdrant पूरी तरह Rust में विकसित है, जो प्रदर्शन और संसाधन दक्षता के लिए जाना जाता है।
शीर्ष वेक्टर डेटाबेस के बारे में जानने के लिए पढ़ें The 5 Best Vector Databases | A List With Examples।
2. LangChain
LangChain लैंग्वेज मॉडल्स द्वारा संचालित ऐप्लिकेशन विकसित करने के लिए एक बहुमुखी और शक्तिशाली फ्रेमवर्क है। यह डेवलपर्स को संदर्भ-सचेत और तर्क-आधारित ऐप्लिकेशनों के निर्माण, डिप्लॉयमेंट, और मॉनिटरिंग में सक्षम बनाने के लिए कई कॉम्पोनेंट्स प्रदान करता है।
फ्रेमवर्क में 4 मुख्य कॉम्पोनेंट्स शामिल हैं:
- LangChain लाइब्रेरीज़: Python और JavaScript लाइब्रेरीज़ ऐसे इंटरफेसेज़ और इंटीग्रेशंस देती हैं, जो संदर्भ-सचेत तर्कशील ऐप्लिकेशन विकसित करने में मदद करते हैं।
- LangChain टेम्पलेट्स: आसानी से डिप्लॉय होने वाली रेफ़रेंस आर्किटेक्चर्स का संग्रह, जो अनेक कार्यों को कवर करता है और प्री-बिल्ट समाधान प्रदान करता है।
- LangServe: यह लाइब्रेरी डेवलपर्स को LangChain चेन को REST API के रूप में डिप्लॉय करने देती है।
- LangSmith: एक प्लेटफ़ॉर्म जो किसी भी LLM फ्रेमवर्क पर बनी चेन को डिबग, टेस्ट, मूल्यांकन, और मॉनिटर करने में सक्षम बनाता है।
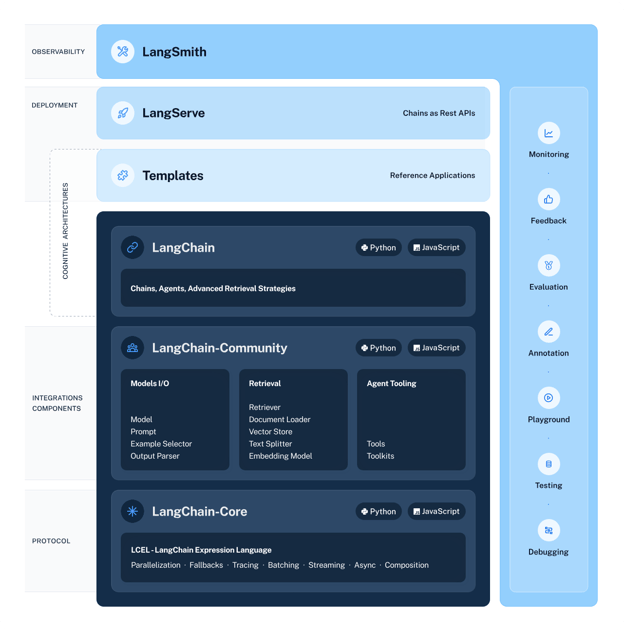
LangChain इकोसिस्टम
How to Build LLM Applications with LangChain सीखें और लार्ज लैंग्वेज मॉडल्स की अनछुई क्षमता का अन्वेषण करें।
एक्सपेरिमेंट ट्रैकिंग और मॉडल मेटाडेटा मैनेजमेंट टूल्स
ये टूल्स आपको मॉडल मेटाडेटा मैनेज करने और एक्सपेरिमेंट ट्रैकिंग में मदद करते हैं:
3. MLFlow
MLflow एक ओपन-सोर्स टूल है जो मशीन लर्निंग लाइफसाइकल के मुख्य हिस्सों को मैनेज करने में मदद करता है। इसे आमतौर पर एक्सपेरिमेंट ट्रैकिंग के लिए उपयोग किया जाता है, लेकिन आप इसे पुनरुत्पादन, डिप्लॉयमेंट, और मॉडल रजिस्ट्री के लिए भी उपयोग कर सकते हैं। आप CLI, Python, R, Java, और REST API का उपयोग करके मशीन लर्निंग एक्सपेरिमेंट्स और मॉडल मेटाडेटा मैनेज कर सकते हैं।
MLflow की चार मुख्य फंक्शंस हैं:
- MLflow tracking: कोड, डेटा, कॉन्फ़िगरेशन, और परिणामों को स्टोर और एक्सेस करना।
- MLflow projects: दोहराने योग्य (reproducible) तरीके से डेटा साइंस सोर्स को पैकेज करना।
- MLflow models: मशीन लर्निंग मॉडलों को विभिन्न सर्विंग एनवायरनमेंट्स में डिप्लॉय और मैनेज करना।
- MLflow model registry: एक केंद्रीय मॉडल स्टोर जो वर्ज़निंग, स्टेज ट्रांज़िशन, एनोटेशंस, और मशीन लर्निंग मॉडलों का प्रबंधन प्रदान करता है।
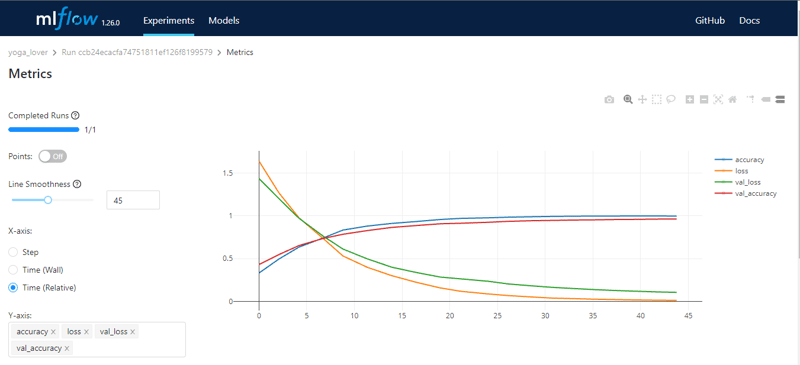
चित्र: लेखक द्वारा
4. Comet ML
Comet ML मशीन लर्निंग मॉडल्स और एक्सपेरिमेंट्स को ट्रैक, तुलना, व्याख्या, और ऑप्टिमाइज़ करने का प्लेटफ़ॉर्म है। आप इसे किसी भी मशीन लर्निंग लाइब्रेरी के साथ उपयोग कर सकते हैं, जैसे Scikit-learn, Pytorch, TensorFlow, और HuggingFace।
Comet ML व्यक्तियों, टीमों, एंटरप्राइजेज, और अकादमिक जगत के लिए है। यह किसी को भी एक्सपेरिमेंट्स को आसानी से विज़ुअलाइज़ और तुलना करने देता है। इसके अलावा, यह इमेज, ऑडियो, टेक्स्ट, और टैब्युलर डेटा से सैंपल्स को विज़ुअलाइज़ करने में सक्षम बनाता है।
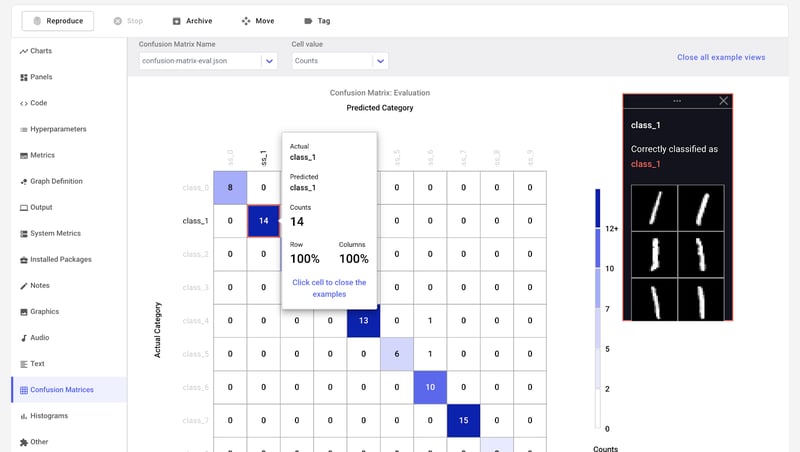
चित्र: Comet ML
5. Weights & Biases
Weights & Biases एक्सपेरिमेंट ट्रैकिंग, डेटा और मॉडल वर्ज़निंग, हाइपरपैरामीटर ऑप्टिमाइज़ेशन, और मॉडल मैनेजमेंट के लिए एक ML प्लेटफ़ॉर्म है। इसके अलावा, आप इसका उपयोग आर्टिफैक्ट्स (डेटासेट्स, मॉडल्स, डिपेंडेंसीज़, पाइपलाइन्स, और परिणाम) लॉग करने और डेटासेट्स (ऑडियो, विज़ुअल, टेक्स्ट, और टैब्युलर) को विज़ुअलाइज़ करने के लिए कर सकते हैं।
Weights & Biases में मशीन लर्निंग एक्सपेरिमेंट्स के लिए उपयोगकर्ता-अनुकूल केंद्रीय डैशबोर्ड है। Comet ML की तरह, आप इसे Fastai, Keras, PyTorch, Hugging face, Yolov5, Spacy, और कई अन्य ML लाइब्रेरीज़ के साथ इंटीग्रेट कर सकते हैं। हमारे introduction to Weights & BIases को एक अलग लेख में देखें।

Gif: Weights & Biases
नोट: आप एक्सपेरिमेंट ट्रैकिंग और ML मेटाडेटा मैनेजमेंट के लिए TensorBoard, Pachyderm, DagsHub, और DVC Studio का भी उपयोग कर सकते हैं।
ऑर्केस्ट्रेशन और वर्कफ़्लो पाइपलाइन्स MLOps टूल्स
ये टूल्स डेटा साइंस प्रोजेक्ट्स बनाने और मशीन लर्निंग वर्कफ़्लोज़ को मैनेज करने में मदद करते हैं:
6. Prefect
Prefect ऐप्लिकेशनों के भीतर और उनके बीच वर्कफ़्लोज़ को मॉनिटर, कॉर्डिनेट, और ऑर्केस्ट्रेट करने के लिए एक आधुनिक डेटा स्टैक है। यह एंड-टू-एंड मशीन लर्निंग पाइपलाइन्स के लिए बनाया गया ओपन-सोर्स, लाइटवेट टूल है।
आप डेटाबेस के लिए Prefect Orion UI या Prefect Cloud में से किसी का भी उपयोग कर सकते हैं।
- Prefect Orion UI एक ओपन-सोर्स, लोकली होस्टेड ऑर्केस्ट्रेशन इंजन और API सर्वर है। यह लोकल Prefect Orion इंस्टेंस और वर्कफ़्लोज़ पर इनसाइट्स देता है।
- Prefect Cloud फ्लोज़, फ्लो रन, और डिप्लॉयमेंट्स को विज़ुअलाइज़ करने के लिए होस्टेड सेवा है। साथ ही, आप अकाउंट्स, वर्कस्पेस, और टीम सहयोग मैनेज कर सकते हैं।
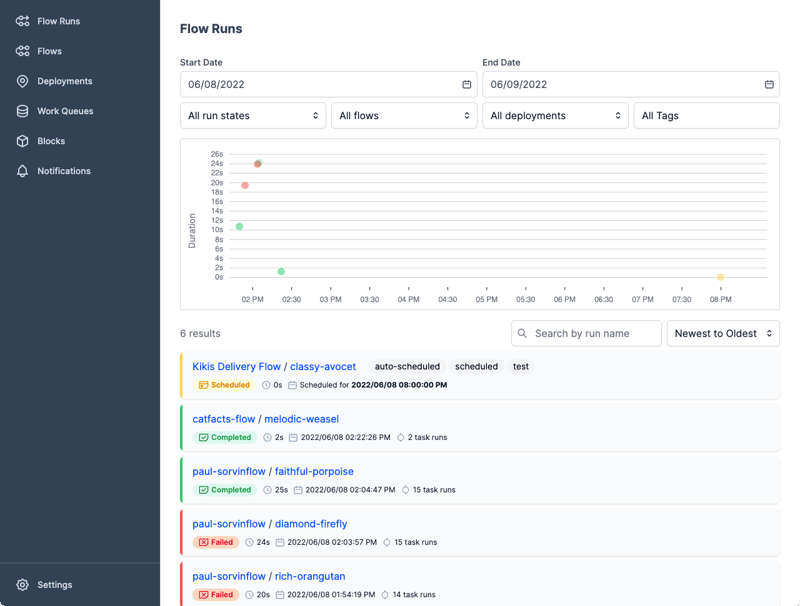
चित्र: Prefect
7. Metaflow
Metaflow डेटा साइंस और मशीन लर्निंग प्रोजेक्ट्स के लिए एक शक्तिशाली, परखा हुआ वर्कफ़्लो मैनेजमेंट टूल है। इसे डेटा वैज्ञानिकों के लिए इस तरह बनाया गया है कि वे MLOps इंजीनियरिंग की चिंता किए बिना मॉडल बनाने पर फोकस कर सकें।
Metaflow के साथ, आप वर्कफ़्लो डिज़ाइन कर सकते हैं, उसे स्केल पर चला सकते हैं, और प्रोडक्शन में मॉडल डिप्लॉय कर सकते हैं। यह मशीन लर्निंग एक्सपेरिमेंट्स और डेटा को अपने आप ट्रैक और वर्ज़न करता है। साथ ही, आप नोटबुक में परिणामों को विज़ुअलाइज़ कर सकते हैं।
Metaflow मल्टीपल क्लाउड्स (AWS, GCP, और Azure सहित) और विभिन्न मशीन लर्निंग Python पैकेजेज़ (जैसे Scikit-learn और Tensorflow) के साथ काम करता है, और R भाषा के लिए भी API उपलब्ध है।
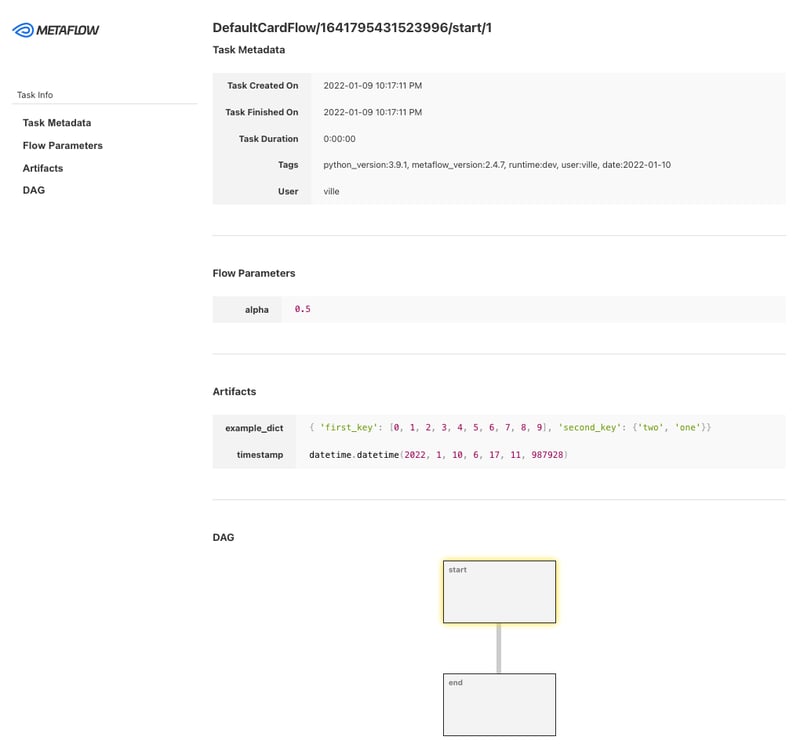
चित्र: Metaflow
8. Kedro
Kedro Python आधारित वर्कफ़्लो ऑर्केस्ट्रेशन टूल है। आप इसका उपयोग पुनरुत्पादन योग्य, मेंटेन करने योग्य, और मॉड्यूलर डेटा साइंस प्रोजेक्ट्स बनाने के लिए कर सकते हैं। यह मशीन लर्निंग में सॉफ़्टवेयर इंजीनियरिंग की अवधारणाओं, जैसे मॉड्यूलैरिटी, सेपरेशन ऑफ कंसर्न्स, और वर्ज़निंग, को सम्मिलित करता है।
Kedro के साथ, आप:
- डिपेंडेंसीज़ और कॉन्फ़िगरेशन सेटअप करें।
- डेटा सेटअप करें।
- पाइपलाइन्स बनाएं, विज़ुअलाइज़ करें, और चलाएं।
- लॉगिंग और एक्सपेरिमेंट ट्रैकिंग करें।
- सिंगल या डिस्ट्रिब्यूटेड मशीन पर डिप्लॉय करें।
- मेंटेनेबल डेटा साइंस कोड बनाएं।
- मॉड्यूलर, पुन: प्रयोज्य कोड बनाएं।
- प्रोजेक्ट्स पर टीममेट्स के साथ सहयोग करें।

Gif: Kedro
नोट: आप ऑर्केस्ट्रेशन और वर्कफ़्लो पाइपलाइन्स के लिए Kubeflow और DVC का भी उपयोग कर सकते हैं।
डेटा और पाइपलाइन वर्ज़निंग टूल्स
इन MLOps टूल्स से आप डेटा और पाइपलाइन वर्ज़निंग से जुड़े कार्य मैनेज कर सकते हैं:
9. Pachyderm
Pachyderm Kubernetes पर डेटा वर्ज़निंग, लीनिएज, और एंड-टू-एंड पाइपलाइन्स के साथ डेटा ट्रांसफ़ॉर्मेशन को स्वचालित करता है। आप किसी भी डेटा (इमेजेज़, लॉग्स, वीडियो, CSVs), किसी भी भाषा (Python, R, SQL, C/C++), और किसी भी स्केल (पेटाबाइट्स डेटा, हज़ारों जॉब्स) के साथ इंटीग्रेट कर सकते हैं।
कम्युनिटी एडिशन ओपन-सोर्स है और छोटे टीम के लिए है। उन्नत फ़ीचर्स चाहने वाले संगठन और टीमें एंटरप्राइज़ एडिशन चुन सकते हैं।
Git की तरह ही, आप समान सिंटैक्स का उपयोग करके अपने डेटा को वर्ज़न कर सकते हैं। Pachyderm में, ऑब्जेक्ट का सबसे ऊँचा स्तर Repository है, और आप Commit, Branches, File, History, और Provenance का उपयोग करके डेटासेट को ट्रैक और वर्ज़न कर सकते हैं।
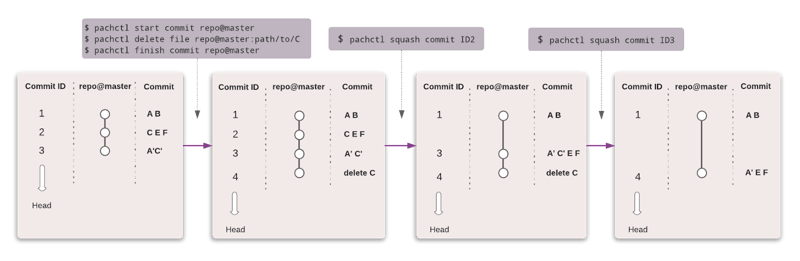
चित्र: Pachyderm
10. Data Version Control (DVC)
Data Version Control मशीन लर्निंग प्रोजेक्ट्स के लिए एक ओपन-सोर्स और लोकप्रिय टूल है। यह Git के साथ सहजता से काम करता है और कोड, डेटा, मॉडल, मेटाडेटा, और पाइपलाइन वर्ज़निंग प्रदान करता है।
DVC केवल डेटा ट्रैकिंग और वर्ज़निंग टूल भर नहीं है।
आप इसका उपयोग कर सकते हैं:
- एक्सपेरिमेंट ट्रैकिंग (मॉडल मेट्रिक्स, पैरामीटर्स, वर्ज़निंग)।
- मशीन लर्निंग पाइपलाइन्स बनाना, विज़ुअलाइज़ करना, और चलाना।
- डिप्लॉयमेंट और सहयोग के लिए वर्कफ़्लो।
- रीप्रोड्यूसिबिलिटी।
- डेटा और मॉडल रजिस्ट्री।
- CML का उपयोग करके मशीन लर्निंग के लिए निरंतर इंटीग्रेशन और डिप्लॉयमेंट।
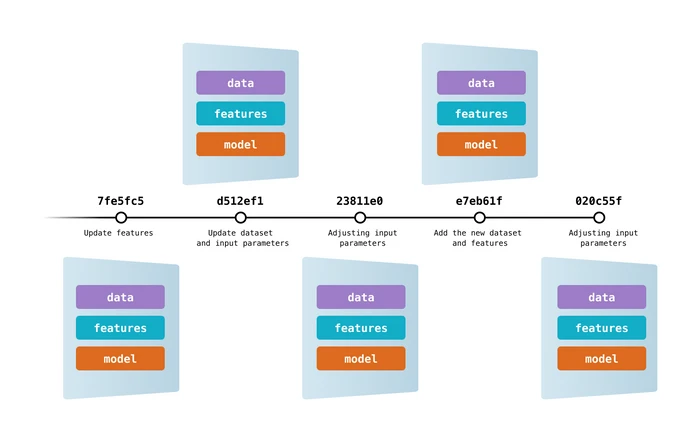
चित्र: DVC
नोट: DagsHub का उपयोग डेटा और पाइपलाइन वर्ज़निंग के लिए भी किया जा सकता है।
11. LakeFS
LakeFS एक ओपन-सोर्स, स्केलेबल डेटा वर्ज़न कंट्रोल टूल है जो ऑब्जेक्ट स्टोरेज के लिए Git-जैसा वर्ज़न कंट्रोल इंटरफ़ेस प्रदान करता है, जिससे यूज़र्स अपने डेटा लेक्स को उसी तरह मैनेज कर सकते हैं जैसे वे अपने कोड को करते हैं। LakeFS के साथ, यूज़र्स एग्जाबाइट स्केल पर डेटा को वर्ज़न कंट्रोल कर सकते हैं, जो बड़े डेटा लेक्स को मैनेज करने के लिए अत्यधिक स्केलेबल समाधान है।
अतिरिक्त क्षमताएँ:
- किसी भी स्टोरेज सेवा पर ब्रांच, कमिट, और मर्ज जैसी Git ऑपरेशंस करें
- जीरो-कॉपी ब्रांचिंग के साथ तेज़ डेवलपमेंट, जिससे बिना रुकावट एक्सपेरिमेंटेशन और आसान सहयोग संभव हो
- स्वच्छ वर्कफ़्लोज़ सुनिश्चित करने के लिए CI/CD वर्कफ़्लोज़ हेतु प्री-कमिट और मर्ज हुक्स का उपयोग करें
- रिवर्ट क्षमता के साथ डेटा समस्याओं से तेज़ रिकवरी के लिए रेज़िलिएंट प्लेटफ़ॉर्म।
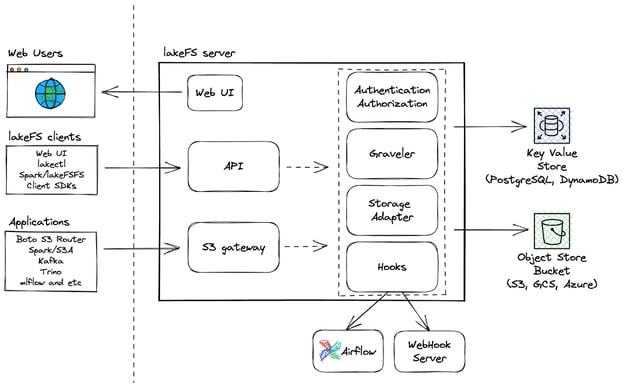
LakeFS आर्किटेक्चर
फ़ीचर स्टोर्स
फ़ीचर स्टोर्स, फीचर्स (प्रोसेस्ड डेटा एट्रिब्यूट्स जो मशीन लर्निंग मॉडलों के प्रशिक्षण में उपयोग होते हैं) को स्टोर, वर्ज़न, मैनेज, और सर्व करने के लिए केंद्रीकृत रिपॉज़िटरी होते हैं—प्रोडक्शन में भी और ट्रेनिंग के लिए भी।
12. Feast
Feast एक ओपन-सोर्स फीचर स्टोर है जो मशीन लर्निंग टीमों को रियल-टाइम मॉडल्स को प्रोडक्शन में लाने और ऐसा फीचर प्लेटफ़ॉर्म बनाने में मदद करता है जो इंजीनियर्स और डेटा साइंटिस्ट्स के बीच सहयोग को बढ़ावा देता है।
मुख्य विशेषताएँ:
- ऑफ़लाइन स्टोर, लो-लेटेंसी ऑनलाइन स्टोर, और फीचर सर्वर को मैनेज करें ताकि ट्रेनिंग और सर्विंग—दोनों के लिए फीचर्स की निरंतर उपलब्धता सुनिश्चित हो।
- सटीक पॉइंट-इन-टाइम फीचर सेट बनाकर डेटा लीकेज से बचें, जिससे डेटा साइंटिस्ट्स को त्रुटिपूर्ण डेटासेट जॉइनिंग से मुक्ति मिलती है।
- एक एकल एक्सेस लेयर रखकर ML को डेटा इन्फ्रास्ट्रक्चर से डिकपल करें।
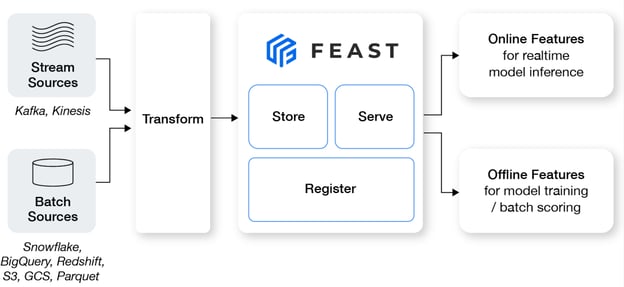
चित्र: Feast
13. Featureform
Featureform एक वर्चुअल फीचर स्टोर है जो डेटा साइंटिस्ट्स को अपने ML मॉडल के फीचर्स को परिभाषित, मैनेज, और सर्व करने में सक्षम बनाता है। यह डेटा साइंस टीमों को सहयोग बढ़ाने, एक्सपेरिमेंटेशन व्यवस्थित करने, डिप्लॉयमेंट को आसान बनाने, विश्वसनीयता बढ़ाने, और अनुपालन बनाए रखने में मदद कर सकता है।
मुख्य विशेषताएँ:
- टीम में फीचर्स को शेयर, पुन: उपयोग, और समझकर सहयोग बढ़ाएँ।
- जब आपका फीचर डिप्लॉयमेंट के लिए तैयार हो जाए, तो Featureform आपकी डेटा इन्फ्रास्ट्रक्चर को ऑर्केस्ट्रेट करके इसे प्रोडक्शन-रेडी बना देगा।
- सिस्टम यह सुनिश्चित करता है कि कोई भी फीचर, लेबल, या ट्रेनिंग सेट संशोधित न किए जा सकें, जिससे विश्वसनीयता बढ़ती है।
- बिल्ट-इन रोल-आधारित एक्सेस कंट्रोल, ऑडिट लॉग्स, और डायनामिक सर्विंग रूल्स के साथ, Featureform सीधे आपकी कंप्लायंस लॉजिक को लागू कर सकता है।
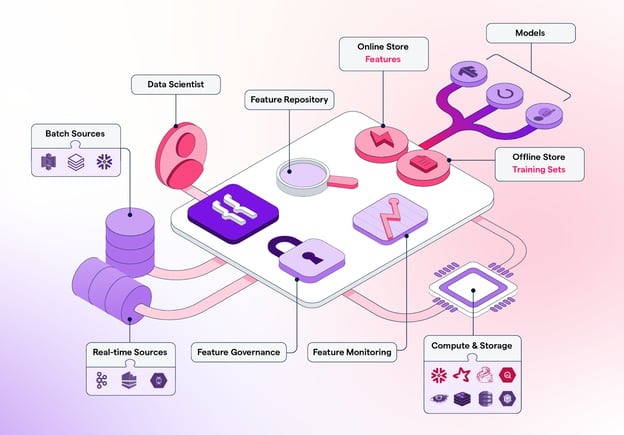
चित्र: Featureform
मॉडल टेस्टिंग
इन MLOps टूल्स के साथ, आप मॉडल क्वालिटी का परीक्षण कर सकते हैं और मशीन लर्निंग मॉडलों की विश्वसनीयता, मजबूती, और शुद्धता सुनिश्चित कर सकते हैं:
14. Deepchecks ML Models Testing
Deepchecks एक ओपन-सोर्स समाधान है जो आपकी सभी ML वैलिडेशन ज़रूरतों को पूरा करता है, यह सुनिश्चित करते हुए कि आपके डेटा और मॉडल रिसर्च से लेकर प्रोडक्शन तक भली-भांति टेस्ट किए गए हैं। यह विभिन्न कॉम्पोनेंट्स के माध्यम से आपके डेटा और मॉडलों को वैलिडेट करने का समग्र दृष्टिकोण प्रदान करता है।
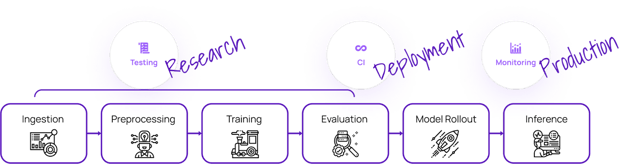
चित्र: Deepchecks
Deepchecks तीन कॉम्पोनेंट्स से बना है:
- Deepchecks testing: टैब्युलर, नैचुरल लैंग्वेज प्रोसेसिंग, और कंप्यूटर विज़न वैलिडेशन के लिए कस्टम चेक्स और सूट बनाने देता है।
- CI & testing management: टीम के साथ सहयोग और टेस्ट परिणामों को प्रभावी ढंग से मैनेज करने के लिए CI & Testing Management प्रदान करता है।
- Deepchecks monitoring: प्रोडक्शन में मॉडलों को ट्रैक और वैलिडेट करता है।
15. TruEra
TruEra एक उन्नत प्लेटफ़ॉर्म है जिसे ऑटोमेटेड टेस्टिंग, एक्सप्लेनेबिलिटी, और रूट कॉज़ एनालिसिस के माध्यम से मॉडल क्वालिटी और परफॉर्मेंस को बढ़ाने के लिए डिज़ाइन किया गया है। यह मॉडलों को ऑप्टिमाइज़ और डिबग करने, विश्व-स्तरीय एक्सप्लेनेबिलिटी हासिल करने, और आपके ML टेक स्टैक में आसानी से इंटीग्रेट होने के लिए विभिन्न फीचर्स प्रदान करता है।
मुख्य विशेषताएँ:
- मॉडल टेस्टिंग और डिबगिंग फीचर आपको डेवलपमेंट और प्रोडक्शन के दौरान मॉडल क्वालिटी बेहतर करने देता है।
- यह परफॉर्मेंस, स्थिरता, और फ़ेयरनेस सुनिश्चित करने के लिए स्वचालित और व्यवस्थित परीक्षण कर सकता है।
- यह मॉडल वर्ज़न्स के विकास को समझता है, जिससे तेज़ और प्रभावी मॉडल डेवलपमेंट के लिए इनसाइट्स मिलते हैं।
- पहचानें और चिन्हित करें कि कौन-से विशिष्ट फीचर्स मॉडल बायस में योगदान दे रहे हैं।
- TruEra को आपकी मौजूदा इन्फ्रास्ट्रक्चर और वर्कफ़्लो में बिना किसी झंझट के आसानी से इंटीग्रेट किया जा सकता है।
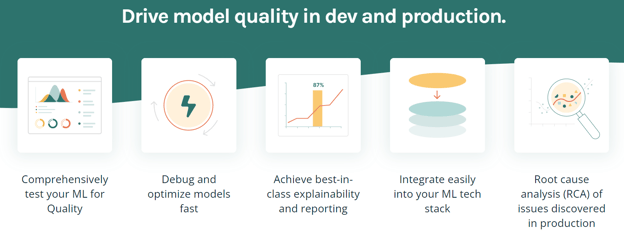
चित्र: TruEra
मॉडल डिप्लॉयमेंट और सर्विंग टूल्स
मॉडल डिप्लॉय करने के मामले में, ये MLOps टूल्स बेहद मददगार हो सकते हैं:
16. Kubeflow
Kubeflow Kubernetes पर मशीन लर्निंग मॉडल डिप्लॉयमेंट को सरल, पोर्टेबल, और स्केलेबल बनाता है। आप इसका उपयोग डेटा तैयारी, मॉडल प्रशिक्षण, मॉडल ऑप्टिमाइज़ेशन, प्रेडिक्शन सर्विंग, और प्रोडक्शन में मॉडल परफॉर्मेंस मॉनिटर करने के लिए कर सकते हैं। आप मशीन लर्निंग वर्कफ़्लो को लोकली, ऑन-प्रिमाइसेस, या क्लाउड में डिप्लॉय कर सकते हैं। संक्षेप में, यह डेटा साइंस टीमों के लिए Kubernetes को आसान बनाता है।
मुख्य विशेषताएँ:
- इंटरैक्टिव UI के साथ केंद्रीय डैशबोर्ड।
- रीप्रोड्यूसिबिलिटी और सुव्यवस्था के लिए मशीन लर्निंग पाइपलाइन्स।
- JupyterLab, RStudio, और Visual Studio Code के लिए नैटिव सपोर्ट।
- हाइपरपैरामीटर ट्यूनिंग और न्यूरल आर्किटेक्चर सर्च।
- Tensorflow, Pytorch, PaddlePaddle, MXNet, और XGboost के लिए ट्रेनिंग जॉब्स।
- जॉब शेड्यूलिंग।
- एडमिनिस्ट्रेटर्स के लिए मल्टी-यूज़र आइसोलेशन।
- सभी प्रमुख क्लाउड प्रदाताओं के साथ काम करता है।
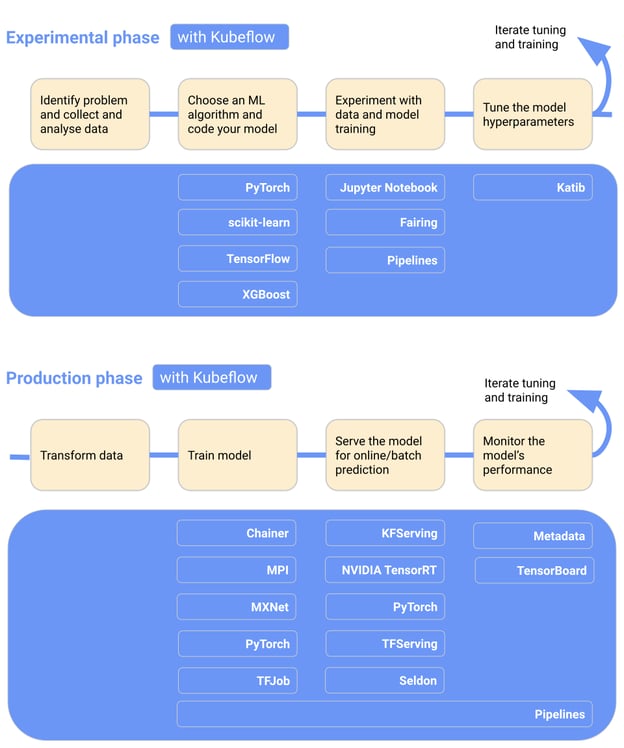
चित्र: Kubeflow
10. BentoML
BentoML मशीन लर्निंग ऐप्लिकेशनों को तेज़ी और आसानी से शिप करना संभव बनाता है। यह प्रोडक्शन में APIs को डिप्लॉय और मेंटेन करने के लिए Python-प्रथम टूल है। यह पैरेलल इन्फ़रेंस और एडैप्टिव बैचिंग चलाकर तथा हार्डवेयर एक्सेलरेशन देकर शक्तिशाली ऑप्टिमाइज़ेशन के साथ स्केल करता है।
BentoML का इंटरैक्टिव केंद्रीकृत डैशबोर्ड, मॉडल डिप्लॉयमेंट के दौरान ऑर्गनाइज़ और मॉनिटर करना आसान बनाता है। सबसे अच्छी बात यह है कि यह Keras, ONNX, LightGBM, Pytorch, और Scikit-learn जैसे हर प्रकार के मशीन लर्निंग फ्रेमवर्क के साथ काम करता है। संक्षेप में, BentoML मॉडल डिप्लॉयमेंट, सर्विंग, और मॉनिटरिंग के लिए एक संपूर्ण समाधान प्रदान करता है।
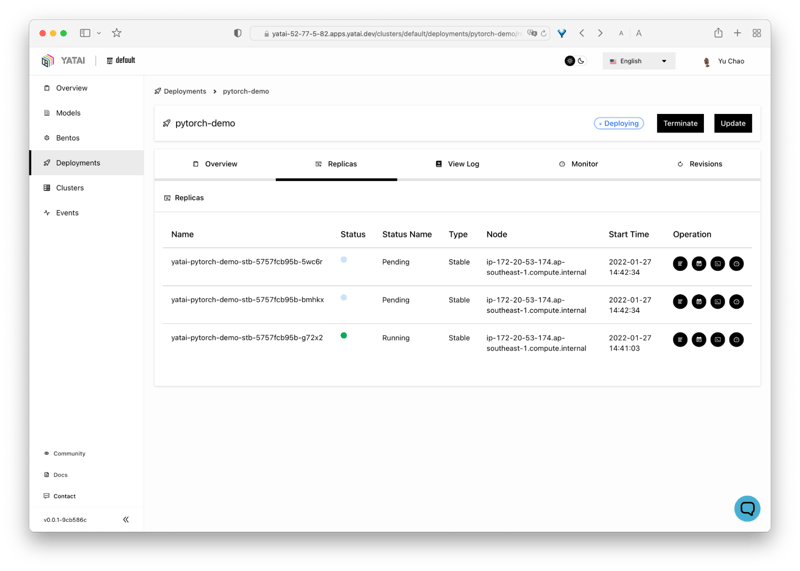
चित्र: BentoML
18. Hugging Face Inference Endpoints
Hugging Face Inference Endpoints Hugging Face द्वारा प्रदान की गई क्लाउड-आधारित सेवा है—एक ऑल-इन-वन ML प्लेटफ़ॉर्म जो यूज़र्स को मॉडल्स, डेटासेट्स, और डेमोज़ को ट्रेन, होस्ट, और शेयर करने में सक्षम बनाता है। ये एंडपॉइंट्स यूज़र्स को अपने प्रशिक्षित मशीन लर्निंग मॉडलों को, आवश्यक इन्फ्रास्ट्रक्चर सेटअप और मैनेज किए बिना, इन्फ़रेंस के लिए डिप्लॉय करने में मदद करने के लिए डिज़ाइन किए गए हैं।
मुख्य विशेषताएँ:
- आपकी ज़रूरत के अनुसार लागत प्रति CPU core/घंटा $0.06 और प्रति GPU/घंटा $0.6 तक कम रखें।
- कुछ सेकंड में आसानी से डिप्लॉय करें।
- पूरी तरह मैनेज्ड और ऑटोस्केल।
- Hugging Face इकोसिस्टम का हिस्सा।
- एंटरप्राइज़-स्तरीय सुरक्षा।
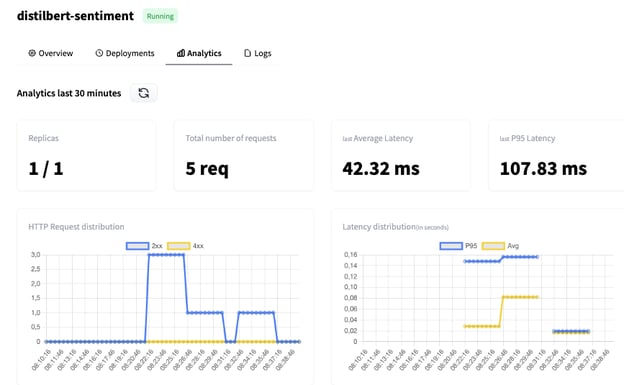
चित्र: Hugging Face
नोट: आप मॉडल डिप्लॉयमेंट और सर्विंग के लिए MLflow और AWS sagemaker का भी उपयोग कर सकते हैं।
प्रोडक्शन में मॉडल मॉनिटरिंग के ML Ops टूल्स
चाहे आपका ML मॉडल डेवलपमेंट, वैलिडेशन में हो या प्रोडक्शन में डिप्लॉय हो, ये टूल्स विभिन्न कारकों की मॉनिटरिंग में मदद कर सकते हैं:
19. Evidently
Evidently AI डेवलपमेंट, वैलिडेशन, और प्रोडक्शन के दौरान ML मॉडलों की मॉनिटरिंग के लिए एक ओपन-सोर्स Python लाइब्रेरी है। यह डेटा और मॉडल क्वालिटी, डेटा ड्रिफ्ट, टार्गेट ड्रिफ्ट, तथा रिग्रेशन और क्लासिफिकेशन परफॉर्मेंस की जांच करता है।
Evidently के तीन मुख्य कॉम्पोनेंट्स हैं:
- Tests (बैच मॉडल चेक्स): स्ट्रक्चर्ड डेटा और मॉडल क्वालिटी चेक्स करने के लिए।
- Reports (इंटरैक्टिव डैशबोर्ड): इंटरैक्टिव डेटा ड्रिफ्ट, मॉडल परफॉर्मेंस, और टार्गेट विज़ुअलाइज़ेशन।
- Monitors (रीयल-टाइम मॉनिटरिंग): डिप्लॉय ML सर्विस से डेटा और मॉडल मेट्रिक्स मॉनिटर करता है।
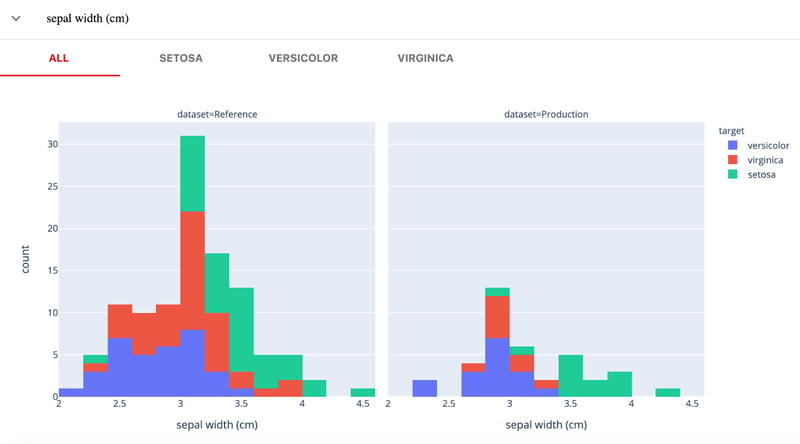
चित्र: Evidently
20. Fiddler
Fiddler AI एक ML मॉडल मॉनिटरिंग टूल है, जिसकी UI उपयोग में आसान और स्पष्ट है। यह आपको प्रेडिक्शंस की व्याख्या और डिबग करने, पूरे डेटासेट के लिए मॉडल व्यवहार का विश्लेषण करने, बड़े पैमाने पर मशीन लर्निंग मॉडलों को डिप्लॉय करने, और मॉडल परफॉर्मेंस मॉनिटर करने देता है।
ML मॉनिटरिंग के लिए Fiddler AI की मुख्य विशेषताएँ:
- परफॉर्मेंस मॉनिटरिंग: डेटा ड्रिफ्टिंग का गहन विज़ुअलाइज़ेशन—कब और कैसे ड्रिफ्ट हो रहा है।
- डेटा इंटीग्रिटी: मॉडल प्रशिक्षण के लिए गलत डेटा फ़ीड करने से बचें।
- आउटलायर्स ट्रैकिंग: यूनिवेरिएट और मल्टिवेरिएट आउटलायर्स दिखाता है।
- सर्विस मेट्रिक्स: ML सर्विस ऑपरेशंस पर बेसिक इनसाइट्स दिखाता है।
- अलर्ट्स: प्रोडक्शन में समस्याओं की चेतावनी देने के लिए किसी मॉडल या मॉडल्स के समूह के लिए अलर्ट सेट करें।
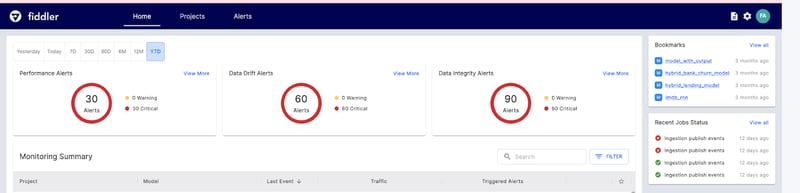
चित्र: Fiddler
रनटाइम इंजन
रनटाइम इंजन का काम मॉडल को लोड करना, इनपुट डेटा का प्रीप्रोसेसिंग करना, इन्फ़रेंस चलाना, और परिणाम क्लाइंट ऐप्लिकेशन को लौटाना है।
21. Ray
Ray AI और Python ऐप्लिकेशनों को स्केल करने के लिए बनाया गया एक बहुमुखी फ्रेमवर्क है, जो डेवलपर्स के लिए अपने मशीन लर्निंग प्रोजेक्ट्स को मैनेज और ऑप्टिमाइज़ करना आसान बनाता है।
प्लेटफ़ॉर्म में दो मुख्य कॉम्पोनेंट्स होते हैं: एक कोर डिस्ट्रिब्यूटेड रनटाइम और ML कंप्यूट को सरल बनाने के लिए तैयार की गई AI लाइब्रेरीज़ का सेट।
Ray Core सीमित लेकिन बुनियादी एलिमेंट्स का सेट प्रदान करता है, जिनका उपयोग डिस्ट्रिब्यूटेड ऐप्लिकेशनों के निर्माण और विस्तार के लिए किया जा सकता है।
- Tasks ऐसी फ़ंक्शंस हैं जिनकी कोई स्टेट नहीं होती और वे क्लस्टर के भीतर निष्पादित होती हैं।
- Actors स्टेटफुल वर्कर प्रोसेसेज़ हैं जो क्लस्टर के भीतर बनाए जाते हैं।
- Objects अपरिवर्तनीय वैल्यूज़ हैं जिन्हें क्लस्टर के किसी भी कॉम्पोनेंट द्वारा एक्सेस किया जा सकता है।
Ray स्केलेबल डेटासेट्स, डिस्ट्रिब्यूटेड ट्रेनिंग, हाइपरपैरामीटर ट्यूनिंग, रिइनफोर्समेंट लर्निंग, और स्केलेबल व प्रोग्रामेबल सर्विंग के लिए AI लाइब्रेरीज़ भी प्रदान करता है।
निम्न उदाहरण एक Gradient Boosting Classifier मॉडल के प्रशिक्षण और सर्विंग को दर्शाता है।
import requests
from starlette.requests import Request
from typing import Dict
from sklearn.datasets import load_iris
from sklearn.ensemble import GradientBoostingClassifier
from ray import serve
# Train model.
iris_dataset = load_iris()
model = GradientBoostingClassifier()
model.fit(iris_dataset["data"], iris_dataset["target"])
@serve.deployment
class BoostingModel:
def __init__(self, model):
self.model = model
self.label_list = iris_dataset["target_names"].tolist()
async def __call__(self, request: Request) -> Dict:
payload = (await request.json())["vector"]
print(f"Received http request with data {payload}")
prediction = self.model.predict([payload])[0]
human_name = self.label_list[prediction]
return {"result": human_name}
# Deploy model.
serve.run(BoostingModel.bind(model), route_prefix="/iris")22. Nuclio
Nuclio एक शक्तिशाली फ्रेमवर्क है जो डेटा, I/O, और कंप्यूट-इंटेंसिव वर्कलोड्स पर केंद्रित है। इसे सर्वरलेस रूप से डिज़ाइन किया गया है, यानी आपको सर्वर्स मैनेज करने की चिंता नहीं करनी पड़ती। Nuclio, Jupyter और Kubeflow जैसे लोकप्रिय डेटा साइंस टूल्स के साथ अच्छी तरह इंटीग्रेटेड है। यह डेटा और स्ट्रीमिंग सोर्सेज़ की एक विस्तृत श्रृंखला को सपोर्ट करता है और CPUs तथा GPUs पर निष्पादित किया जा सकता है।
मुख्य विशेषताएँ:
- वास्तविक-समय प्रोसेसिंग के लिए न्यूनतम CPU/GPU और I/O संसाधन आवश्यक, साथ ही अधिकतम पैरेललिज़्म।
- विविध डेटा सोर्सेज़ और ML फ्रेमवर्क्स के साथ इंटीग्रेशन।
- डेटा-पाथ एक्सेलरेशन के साथ स्टेटफुल फ़ंक्शंस प्रदान करता है
- हर तरह के डिवाइसेज़ और क्लाउड प्लेटफ़ॉर्म्स—खासकर लो-पावर डिवाइसेज़—पर पोर्टेबिलिटी।
- एंटरप्राइज़ के लिए डिज़ाइन किया गया।
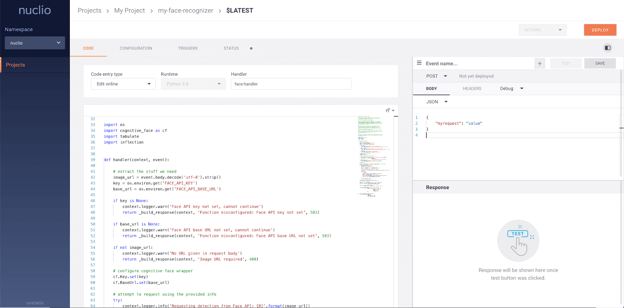
चित्र: Nuclio
एंड-टू-एंड MLOps प्लेटफ़ॉर्म्स
यदि आप एक संपूर्ण MLOps टूल की तलाश में हैं जो पूरे प्रोसेस में मदद कर सके, तो यहाँ कुछ बेहतरीन विकल्प हैं:
23. AWS SageMaker
Amazon Web Services SageMaker MLOps के लिए वन-स्टॉप समाधान है। आप मॉडल डेवलपमेंट को ट्रेन और तेज़ कर सकते हैं, एक्सपेरिमेंट्स को ट्रैक और वर्ज़न कर सकते हैं, ML आर्टिफैक्ट्स कैटलॉग कर सकते हैं, CI/CD ML पाइपलाइन्स इंटीग्रेट कर सकते हैं, और मॉडलों को प्रोडक्शन में निर्बाध रूप से डिप्लॉय, सर्व, और मॉनिटर कर सकते हैं।
मुख्य विशेषताएँ:
- डेटा साइंस टीमों के लिए सहयोगी वातावरण।
- ML ट्रेनिंग वर्कफ़्लोज़ को ऑटोमेट करें।
- प्रोडक्शन में मॉडलों को डिप्लॉय और मैनेज करें।
- मॉडल वर्ज़न्स को ट्रैक और मेंटेन करें।
- ऑटोमेटिक इंटीग्रेशन और डिप्लॉयमेंट के लिए CI/CD।
- क्वालिटी बनाए रखने के लिए निरंतर मॉनिटरिंग और रिट्रेनिंग।
- लागत और प्रदर्शन का अनुकूलन।
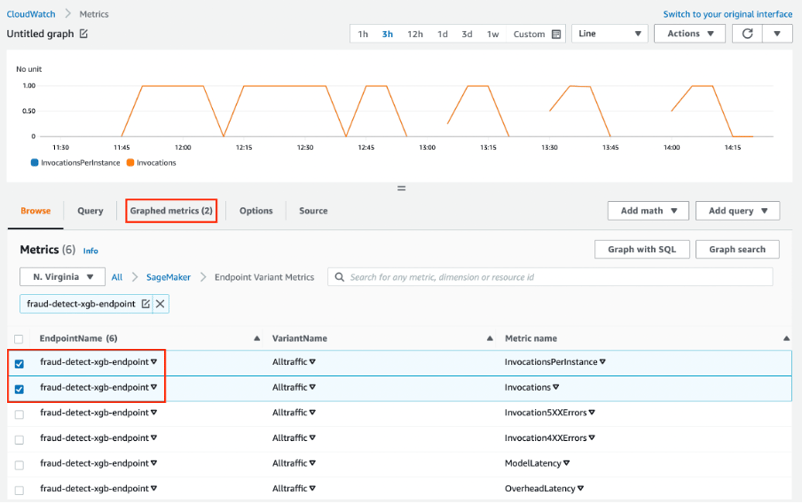
चित्र: Amazon SageMaker
24. DagsHub
DagsHub मशीन लर्निंग समुदाय के लिए बनाया गया एक प्लेटफ़ॉर्म है जो डेटा, मॉडल्स, एक्सपेरिमेंट्स, ML पाइपलाइन्स, और कोड को ट्रैक और वर्ज़न करने देता है। यह आपकी टीम को मशीन लर्निंग प्रोजेक्ट्स बनाने, रिव्यू करने, और साझा करने में सक्षम बनाता है।
सरल शब्दों में, यह मशीन लर्निंग के लिए GitHub जैसा है, और आपको एंड-टू-एंड मशीन लर्निंग प्रोसेस को ऑप्टिमाइज़ करने के लिए कई टूल्स मिलते हैं।
मुख्य विशेषताएँ:
- आपके ML प्रोजेक्ट्स के लिए Git और DVC रिपॉज़िटरी।
- एक्सपेरिमेंट ट्रैकिंग के लिए DagsHub लॉगर और MLflow इंस्टेंस।
- Label Studio इंस्टेंस का उपयोग करके डेटासेट एनोटेशन।
- Jupyter नोटबुक्स, कोड, डेटासेट्स, और इमेजेज़ का डिफ़।
- फ़ाइल, कोड की लाइन, या डेटासेट पर कमेंट करने की क्षमता।
- GitHub विकी की तरह प्रोजेक्ट के लिए रिपोर्ट बनाएं।
- ML पाइपलाइन विज़ुअलाइज़ेशन।
- रीप्रोड्यूसिबल परिणाम।
- मॉडल ट्रेनिंग और डिप्लॉयमेंट के लिए CI/CD चलाना।
- डेटा मर्जिंग।
- GitHub, Google Colab, DVC, Jenkins, एक्सटर्नल स्टोरेज, वेबहुक्स, और New Relic के साथ इंटीग्रेशन।
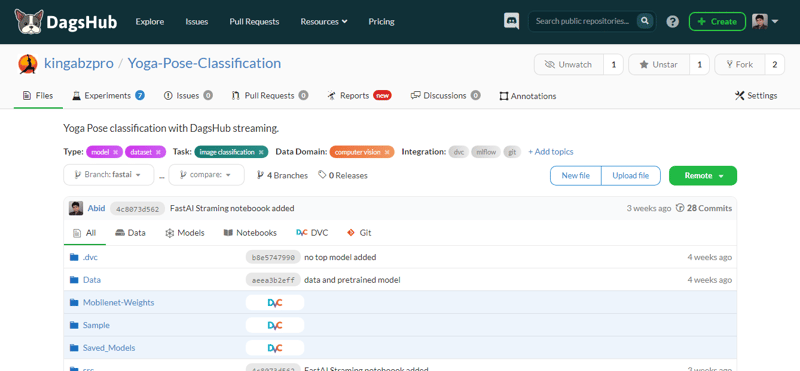
चित्र: लेखक द्वारा
25. Iguazio MLOps Platform
Iguazio MLOps Platform एक एंड-टू-एंड MLOps प्लेटफ़ॉर्म है जो संगठनों को डेटा संग्रह और तैयारी से लेकर ट्रेनिंग, डिप्लॉयमेंट, और प्रोडक्शन में मॉनिटरिंग तक, मशीन लर्निंग पाइपलाइन को ऑटोमेट करने में सक्षम बनाता है। यह एक ओपन (MLRun) और मैनेज्ड प्लेटफ़ॉर्म प्रदान करता है।
Iguazio MLOps Platform का एक प्रमुख अंतर इसकी डिप्लॉयमेंट विकल्पों में लचीलापन है। यूज़र्स कहीं भी—किसी भी क्लाउड, हाइब्रिड, या ऑन-प्रिमाइसेस एनवायरनमेंट में—AI ऐप्लिकेशंस डिप्लॉय कर सकते हैं। यह विशेष रूप से स्वास्थ्य सेवा और वित्त जैसे उद्योगों के लिए महत्वपूर्ण है, जहाँ डेटा गोपनीयता चिंताओं के कारण ऑन-प्रिमाइसेस डिप्लॉयमेंट आवश्यक हो सकता है।
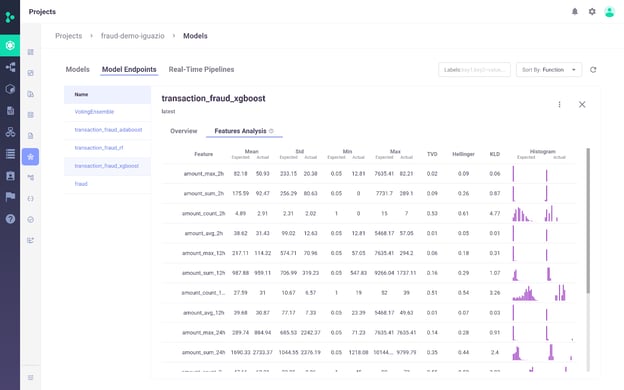
चित्र: Iguazio MLOps Platform
मुख्य विशेषताएँ:
- प्लेटफ़ॉर्म यूज़र्स को किसी भी स्रोत से डेटा इन्गेस्ट करने और इंटीग्रेटेड फीचर स्टोर का उपयोग करके पुन: प्रयोज्य ऑनलाइन और ऑफ़लाइन फीचर्स बनाने की अनुमति देता है।
- स्वचालित ट्रैकिंग, डेटा वर्ज़निंग, और निरंतर इंटीग्रेशन व डिप्लॉयमेंट के साथ स्केलेबल सर्वरलेस का उपयोग करके मॉडलों को निरंतर ट्रेन और इवैल्यूएट करने का समर्थन करता है।
- कुछ क्लिक में मॉडलों को प्रोडक्शन में आसानी से डिप्लॉय करें, मॉडल परफॉर्मेंस को लगातार मॉनिटर करें और मॉडल ड्रिफ्ट को कम करें।
- प्लेटफ़ॉर्म, रियल-टाइम प्रोडक्शन में मॉडल्स को मैनेज, गवर्न, और मॉनिटर करने के लिए एक सरल डैशबोर्ड के साथ आता है।
MLOps टूल्स का अवलोकन
यहाँ एक तुलना तालिका दी गई है ताकि आप इन टूल्स का साथ-साथ मूल्यांकन कर सकें और अपने प्रोजेक्ट्स के लिए सर्वश्रेष्ठ चुन सकें:
| टूल | मुख्य कार्यक्षमता | समर्थित फ्रेमवर्क | डिप्लॉयमेंट विकल्प |
|---|---|---|---|
| Qdrant | वेक्टर सिमिलैरिटी सर्च और डेटाबेस मैनेजमेंट | Python, अनेक भाषाएँ | क्लाउड-नेटिव, हॉरिज़ोंटली स्केलेबल |
| LangChain | लैंग्वेज मॉडल्स से ऐप्लिकेशन विकसित करना | Python, JavaScript | REST API, टेम्पलेट्स |
| MLFlow | एक्सपेरिमेंट ट्रैकिंग, मॉडल रजिस्ट्री, डिप्लॉयमेंट | Python, R, Java, REST API | लोकल, क्लाउड |
| Comet ML | एक्सपेरिमेंट ट्रैकिंग और ऑप्टिमाइज़ेशन | Scikit-learn, PyTorch, TensorFlow, HuggingFace | लोकल, क्लाउड |
| Weights & Biases | एक्सपेरिमेंट ट्रैकिंग, डेटा और मॉडल वर्ज़निंग | Fastai, Keras, PyTorch, HuggingFace, Yolov5, Spacy | लोकल, क्लाउड |
| Prefect | वर्कफ़्लो ऑर्केस्ट्रेशन और मॉनिटरिंग | Python | लोकल (Orion UI), क्लाउड |
| Metaflow | डेटा साइंस के लिए वर्कफ़्लो मैनेजमेंट | Scikit-learn, TensorFlow, Python, R | AWS, GCP, Azure, लोकल |
| Kedro | वर्कफ़्लो ऑर्केस्ट्रेशन, रीप्रोड्यूसिबिलिटी | Python | लोकल, डिस्ट्रिब्यूटेड |
| Pachyderm | डेटा ट्रांसफ़ॉर्मेशन, वर्ज़निंग, और लीनिएज | कोई भी भाषा | Kubernetes |
| DVC | डेटा और पाइपलाइन वर्ज़निंग | Git, Python | लोकल, क्लाउड |
| LakeFS | डेटा लेक्स के लिए Git-जैसा वर्ज़न कंट्रोल | कोई भी स्टोरेज सेवा | लोकल, क्लाउड |
| Feast | ML मॉडलों के लिए केंद्रीय फीचर स्टोर | Python | लोकल, क्लाउड |
| Featureform | ML मॉडलों के लिए वर्चुअल फीचर स्टोर | Python | लोकल, क्लाउड |
| Deepchecks | ML मॉडल टेस्टिंग और वैलिडेशन | Python | लोकल, क्लाउड |
| TruEra | मॉडल क्वालिटी और परफॉर्मेंस टेस्टिंग | Python | लोकल, क्लाउड |
| Kubeflow | ML मॉडल डिप्लॉयमेंट और ऑर्केस्ट्रेशन | TensorFlow, PyTorch, PaddlePaddle, MXNet, XGboost | Kubernetes, क्लाउड |
| BentoML | मॉडल डिप्लॉयमेंट और API मैनेजमेंट | Keras, ONNX, LightGBM, PyTorch, Scikit-learn | लोकल, क्लाउड |
| Hugging Face | इन्फ़रेंस और मॉडल डिप्लॉयमेंट | कोई भी मॉडल | क्लाउड |
| Evidently | डेटा और टार्गेट ड्रिफ्ट के लिए ML मॉडलों की मॉनिटरिंग | Python | लोकल, क्लाउड |
| Fiddler | ML मॉडल मॉनिटरिंग और डिबगिंग | Python | लोकल, क्लाउड |
| Ray | AI और Python ऐप्लिकेशनों को स्केल करें | Python | लोकल, क्लाउड |
| Nuclio | डेटा और कंप्यूट-इंटेंसिव वर्कलोड्स के लिए सर्वरलेस फ्रेमवर्क | Jupyter, Kubeflow | क्लाउड, ऑन-प्रिमाइसेस |
| AWS SageMaker | एंड-टू-एंड ML लाइफसाइकल मैनेजमेंट | Python, R, Java, TensorFlow, PyTorch | AWS क्लाउड |
| DagsHub | ML प्रोजेक्ट्स के लिए वर्ज़निंग और सहयोग | Git, DVC, MLflow | लोकल, क्लाउड |
| Iguazio | ML पाइपलाइन्स का एंड-टू-एंड ऑटोमेशन | Python, MLRun | क्लाउड, हाइब्रिड, ऑन-प्रिमाइसेस |
निष्कर्ष
हम ऐसे समय में हैं जब MLOps उद्योग में उछाल है। हर सप्ताह आप नई प्रगति, नए स्टार्टअप्स, और नए टूल्स को देखते हैं जो नोटबुक्स को प्रोडक्शन-रेडी ऐप्लिकेशनों में बदलने की बुनियादी समस्या को हल करने के लिए लॉन्च होते हैं। मौजूदा टूल्स भी अपना दायरा बढ़ा रहे हैं और नए फ़ीचर्स इंटीग्रेट कर रहे हैं ताकि वे सुपर MLOps टूल्स बन सकें।
इस ब्लॉग में, हमने MLOps प्रक्रिया के विभिन्न चरणों के लिए बेहतरीन MLOps टूल्स के बारे में सीखा। ये टूल्स आपको एक्सपेरिमेंटेशन, डेवलपमेंट, डिप्लॉयमेंट, और मॉनिटरिंग चरणों के दौरान मदद करेंगे।
यदि आप मशीन लर्निंग में नए हैं और मशीन लर्निंग साइंटिस्ट के रूप में नौकरी पाने के लिए आवश्यक कौशल में महारत हासिल करना चाहते हैं, तो हमारा Machine Learning Scientist with Python करियर ट्रैक आज़माएँ।
यदि आप प्रोफेशनल हैं और मानक MLOps प्रैक्टिसेज़ के बारे में अधिक सीखना चाहते हैं, तो हमारा लेख MLOps Best Practices and How to Apply Them पढ़ें और हमारा MLOps Fundamentals स्किल ट्रैक देखें।
MLOps टूल्स FAQs
MLOps टूल्स क्या हैं?
MLOps टूल्स, ML इकोसिस्टम को मानकीकृत, सरल, और सुव्यवस्थित करने में मदद करते हैं। ये टूल्स एक्सपेरिमेंट ट्रैकिंग, मॉडल मेटाडेटा मैनेजमेंट, ऑर्केस्ट्रेशन, मॉडल ऑप्टिमाइज़ेशन, वर्कफ़्लो वर्ज़निंग, मॉडल डिप्लॉयमेंट और सर्विंग, तथा प्रोडक्शन में मॉडल मॉनिटरिंग के लिए उपयोग होते हैं।
एक MLOps इंजीनियर के लिए किन कौशलों की आवश्यकता होती है?
- क्लाउड समाधानों को इम्प्लिमेंट करने की क्षमता।
- Docker और Kubernetes का अनुभव।
- एक्सपेरिमेंट ट्रैकिंग और वर्कफ़्लो वर्ज़निंग का उपयोग करके क्वालिटी एश्योरेंस का अनुभव।
- MLOps पाइपलाइन्स बनाने की क्षमता।
- Linux ऑपरेटिंग सिस्टम से परिचित।
- PyTorch, Tensorflow, और TFX जैसे ML फ्रेमवर्क्स का अनुभव।
- DevOps और सॉफ़्टवेयर डेवलपमेंट का अनुभव।
- यूनिट और इंटीग्रेशन टेस्टिंग, डेटा और मॉडल वैलिडेशन, और पोस्ट-डिप्लॉयमेंट मॉनिटरिंग का अनुभव।
MLOps के लिए कौन-सा क्लाउड सबसे अच्छा है?
AWS, GCP, और Azure मशीन लर्निंग लाइफसाइकल के लिए कई टूल्स प्रदान करते हैं। ये सभी MLOps के लिए एंड-टू-एंड समाधान देते हैं। लोकप्रियता और मार्केट शेयर के लिहाज़ से AWS आगे है। यह मॉडल ट्रेनिंग, सर्विंग, और मॉनिटरिंग के लिए आसान समाधान भी प्रदान करता है।
क्या MLOps सीखना आसान है?
यह आपके पूर्व अनुभव पर निर्भर करता है। MLOps में महारत हासिल करने के लिए आपको मशीन लर्निंग और सॉफ़्टवेयर डेवलपमेंट लाइफ साइकिल—दोनों सीखने की ज़रूरत है। प्रोग्रामिंग भाषाओं में मजबूत दक्षता के अलावा, आपको कई MLOps टूल्स सीखने होंगे। DevOps इंजीनियर्स के लिए MLOps सीखना अपेक्षाकृत आसान होता है, क्योंकि अधिकांश टूल्स और रणनीतियाँ सॉफ़्टवेयर डेवलपमेंट द्वारा संचालित होती हैं।
क्या Kubeflow, MLflow से बेहतर है?
यह उपयोग के मामले पर निर्भर करता है। Kubeflow पुनरुत्पादन क्षमता (reproducibility) उच्च स्तर पर देता है क्योंकि यह ऑर्केस्ट्रेशन मैनेज करता है।
- Kubeflow आमतौर पर बड़े पैमाने पर जटिल ML सिस्टम्स को डिप्लॉय और मैनेज करने के लिए उपयोग होता है।
- MLFlow आमतौर पर ML एक्सपेरिमेंट ट्रैकिंग तथा मॉडल मेटाडेटा को स्टोर और मैनेज करने के लिए उपयोग होता है।
MLOps, DevOps से कैसे अलग है?
दोनों सॉफ़्टवेयर विकास रणनीतियाँ हैं। DevOps बड़े पैमाने पर सॉफ़्टवेयर सिस्टम्स के विकास और प्रबंधन पर केंद्रित है, जबकि MLOps प्रोडक्शन में मशीन लर्निंग मॉडलों के डिप्लॉयमेंट और मेंटेनेंस पर केंद्रित है।
- DevOps: निरंतर इंटीग्रेशन (CI) और निरंतर डिलीवरी (CD)।
- MLOps: निरंतर इंटीग्रेशन, निरंतर डिलीवरी, निरंतर ट्रेनिंग, और निरंतर मॉनिटरिंग।
MLOps टूल्स मौजूदा डेटा साइंस वर्कफ़्लोज़ के साथ कैसे इंटीग्रेट होते हैं?
MLOps टूल्स मौजूदा डेटा साइंस वर्कफ़्लोज़ के साथ सहजता से इंटीग्रेट होने के लिए डिज़ाइन किए गए हैं। ये आम तौर पर विभिन्न डेटा साइंस टूल्स और प्लेटफ़ॉर्म्स को सपोर्ट करते हैं, इंटीग्रेशन के लिए APIs प्रदान करते हैं, और लोकप्रिय डेटा साइंस वातावरणों के लिए प्लगइन्स या एक्सटेंशन्स ऑफ़र करते हैं। यह इंटीग्रेशन डेटा साइंटिस्ट्स को अपने मौजूदा वर्कफ़्लोज़ बनाए रखने में सक्षम बनाता है, जबकि बेहतर स्केलेबिलिटी, रीप्रोड्यूसिबिलिटी, और डिप्लॉयमेंट दक्षता के लिए MLOps के फ़ायदों का लाभ उठाया जा सके।
क्या MLOps टूल्स मॉडल एक्सप्लेनेबिलिटी और फ़ेयरनेस में मदद कर सकते हैं?
हाँ, कई MLOps टूल्स में मॉडल एक्सप्लेनेबिलिटी और फ़ेयरनेस को बेहतर बनाने के फ़ीचर्स होते हैं। वे मॉडल इंटरप्रिटेशन, बायस डिटेक्शन, और फ़ेयरनेस मेट्रिक्स जैसी सुविधाएँ प्रदान करते हैं, जो यह समझने और सुधारने में मदद करती हैं कि मॉडल फैसले कैसे लेते हैं। यह ज़िम्मेदार AI डिप्लॉय करने और रेगुलेटरी मानकों के अनुपालन को बनाए रखने के लिए अत्यंत महत्वपूर्ण है।
क्या मैं MLOps सर्टिफ़िकेशन ले सकता/सकती हूँ?
MLOps-विशिष्ट प्रमाणपत्र अभी विकसित हो रहे हैं, लेकिन कई मशीन लर्निंग और डेटा साइंस केंद्रित सर्टिफ़िकेशंस हैं जो MLOps कौशल को कवर करते हैं। हमारा MLOps सर्टिफ़िकेशंस गाइड ब्रेकडाउन के लिए पढ़ें।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
जैसा कि हम अपने लेख Getting Started with MLOps में बताते हैं, MLOps, DevOps की बुनियाद पर टिका है—वह सॉफ़्टवेयर विकास रणनीति जो एंटरप्राइज़ ऐप्लिकेशनों को कुशलता से लिखने, डिप्लॉय करने और चलाने में मदद करती है।
यह बड़े पैमाने पर मशीन लर्निंग प्रोजेक्ट्स को मैनेज करने का एक दृष्टिकोण है। MLOps विकास, संचालन, और डेटा साइंस टीमों के बीच सहयोग को बेहतर बनाता है। नतीजतन, आपको तेज़ मॉडल डिप्लॉयमेंट, टीम की उत्पादकता में वृद्धि, जोखिम और लागत में कमी, तथा प्रोडक्शन में निरंतर मॉडल मॉनिटरिंग मिलती है।
हमारे ब्लॉग The Past, Present, and Future of MLOps को पढ़कर जानें कि MLOps क्यों महत्वपूर्ण है और यह किन समस्याओं को हल करने का लक्ष्य रखता है।
इस पोस्ट में, हम मॉडल डेवलपमेंट, डिप्लॉयमेंट, और मॉनिटरिंग के लिए बेहतरीन MLOps टूल्स के बारे में जानेंगे जो मशीन लर्निंग इकोसिस्टम को मानकीकृत, सरल, और सुव्यवस्थित करते हैं। MLOps Fundamentals की ठोस शुरुआत के लिए हमारा स्किल ट्रैक देखें।