
PySpark क्या है?
PySpark दो शक्तिशाली तकनीकों: Python और Apache Spark का संयोजन है।
Python सॉफ़्टवेयर डेवलपमेंट में, खासकर डेटा साइंस और मशीन लर्निंग के लिए सबसे अधिक इस्तेमाल होने वाली प्रोग्रामिंग भाषाओं में से एक है, मुख्यतः इसकी सरल और सीधी-सादी सिंटैक्स के कारण।
दूसरी ओर, Apache Spark एक ऐसा फ़्रेमवर्क है जो असंरचित डेटा की बड़ी मात्रा को संभाल सकता है। Spark को Scala का उपयोग करके बनाया गया था, जो हमें उस पर अधिक नियंत्रण देता है। लेकिन डेटा प्रैक्टिशनर्स के बीच Scala लोकप्रिय भाषा नहीं है। इसलिए, इस अंतर को पाटने के लिए PySpark बनाया गया।
PySpark Spark के साथ इंटरेक्ट करने के लिए एक API और उपयोगकर्ता-अनुकूल इंटरफ़ेस प्रदान करता है। यह Python की सरलता और लचीलापन इस्तेमाल करके बिग डेटा प्रोसेसिंग को व्यापक दर्शकों के लिए सुलभ बनाता है।
PySpark को लोकप्रिय क्या बनाता है?
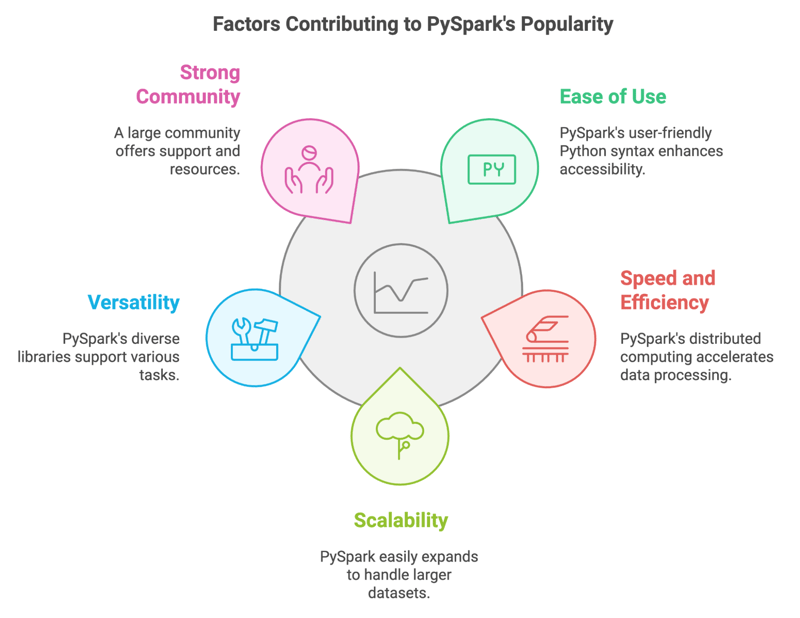
हाल के वर्षों में, PySpark बड़े पैमाने का डेटा प्रोसेस करने वाले डेटा प्रैक्टिशनर्स के लिए एक महत्वपूर्ण टूल बन गया है। इसकी लोकप्रियता को कई प्रमुख कारणों से समझाया जा सकता है:
- आसान उपयोग: PySpark Python की परिचित सिंटैक्स का उपयोग करता है, जिससे यह हमारे जैसे डेटा प्रैक्टिशनर्स के लिए अधिक सुलभ हो जाता है।
- गति और दक्षता: मशीनों के क्लस्टर्स में कंप्यूटेशन वितरित करके, PySpark विशाल डेटा सेट को उच्च गति पर संभालता है।
- स्केलेबिलिटी: PySpark बढ़ती डेटा वॉल्यूम के अनुसार ढल जाता है, जिससे हम अधिक कंप्यूटिंग संसाधन जोड़कर अपने एप्लिकेशन स्केल कर सकते हैं।
- बहुउद्देशीयता: यह डेटा मैनिपुलेशन से लेकर मशीन लर्निंग तक विभिन्न कार्यों के लिए व्यापक लाइब्रेरी इकोसिस्टम प्रदान करता है।
- मजबूत समुदाय: समस्याओं और चुनौतियों का सामना करने पर हम एक बड़े और सक्रिय समुदाय से सहायता और संसाधनों पर भरोसा कर सकते हैं।
PySpark हमें मौजूदा Python कौशल और लाइब्रेरी का लाभ उठाने की सुविधा भी देता है। हम इसे आसानी से Pandas और Scikit-learn जैसे लोकप्रिय टूल्स के साथ एकीकृत कर सकते हैं, और यह हमें विभिन्न डेटा स्रोतों का उपयोग करने देता है।
PySpark की मुख्य विशेषताएँ
PySpark खास तौर पर बिग डेटा और मशीन लर्निंग डेवलपमेंट्स के लिए बनाया गया था। लेकिन कौन-सी विशेषताएँ इसे विशाल डेटा संभालने के लिए शक्तिशाली टूल बनाती हैं? आइए उन पर नज़र डालते हैं:
- Resilient distributed datasets (RDDs): ये PySpark के पीछे की मूलभूत डेटा संरचनाएँ हैं। इनके कारण डेटा ट्रांसफ़ॉर्मेशन, फ़िल्टरिंग और एग्रीगेशन पैरलल में किए जा सकते हैं।
- DataFrames और SQL: PySpark में DataFrames, RDDs के ऊपर बनी उच्च-स्तरीय एब्स्ट्रैक्शन हैं। हम Spark SQL और क्वेरीज़ के साथ इन्हें डेटा मैनिपुलेशन और विश्लेषण के लिए इस्तेमाल कर सकते हैं।
- मशीन लर्निंग लाइब्रेरीज़: PySpark की MLlib लाइब्रेरी का उपयोग करके, हम वर्गीकरण और रिग्रेशन जैसे कार्यों के लिए स्केलेबल मशीन लर्निंग मॉडल बना और उपयोग कर सकते हैं।
- विभिन्न डेटा फ़ॉर्मैट का समर्थन: PySpark CSV, JSON, Parquet, और Avro जैसे विभिन्न फ़ॉर्मैट में डेटा पढ़ने, लिखने और प्रोसेस करने के लिए लाइब्रेरी और APIs प्रदान करता है।
- फ़ॉल्ट टॉलरेंस: PySpark प्रत्येक RDD का ट्रैक रखता है। यदि निष्पादन के दौरान कोई नोड विफल हो जाता है, तो PySpark उस ट्रैकिंग सूचना का उपयोग करके खोई हुई RDD पार्टीशन को पुनर्निर्मित कर देता है। इस तरह डेटा लॉस का जोखिम कम रहता है।
- इन-मेमोरी प्रोसेसिंग: PySpark इंटरमीडिएट डेटा को मेमोरी में स्टोर करता है, जिससे डिस्क ऑपरेशंस की आवश्यकता कम होती है और डेटा प्रोसेसिंग प्रदर्शन बेहतर होता है।
- स्ट्रीमिंग और रीयल-टाइम प्रोसेसिंग: हम Spark Streaming कॉम्पोनेंट का उपयोग करके रीयल-टाइम डेटा स्ट्रीम प्रोसेस कर सकते हैं और लगभग रीयल-टाइम एनालिटिक्स कर सकते हैं।
PySpark सीखना इतना उपयोगी क्यों है?
डेटा की मात्रा लगातार बढ़ रही है। आज, डेटा रैंगलिंग, डेटा विश्लेषण और मशीन लर्निंग कार्यों में बड़े पैमाने का डेटा शामिल होता है। हमें ऐसे शक्तिशाली टूल्स की ज़रूरत है जो इस डेटा को दक्षता और समय पर प्रोसेस कर सकें। PySpark उन्हीं टूल्स में से एक है।
PySpark के कई अनुप्रयोग हैं
हम पहले ही PySpark की खूबियों का ज़िक्र कर चुके हैं, पर अब कुछ खास उदाहरण देखते हैं जहाँ आप इन्हें उपयोग कर सकते हैं:
- डेटा ETL. PySpark की कुशल डेटा क्लीनिंग और ट्रांसफ़ॉर्मेशन क्षमता मैन्युफैक्चरिंग और लॉजिस्टिक्स में सेंसर डेटा और प्रोडक्शन लॉग्स को प्रोसेस करने के लिए उपयोग होती है।
- मशीन लर्निंग. MLlib लाइब्रेरी का उपयोग ई-कॉमर्स में पर्सनलाइज़्ड रिकमेंडेशन्स, कस्टमर सेगमेंटेशन और सेल्स फोरकास्टिंग के लिए मॉडल विकसित व डिप्लॉय करने में किया जाता है।
- ग्राफ प्रोसेसिंग. PySpark के GraphFrames का उपयोग सोशल नेटवर्क का विश्लेषण करने और उपयोगकर्ताओं के बीच रिश्तों को समझने में होता है।
- स्ट्रीम प्रोसेसिंग. PySpark का Structured Streaming API वित्तीय लेन-देन को रीयल-टाइम में प्रोसेस करके धोखाधड़ी का पता लगाने में सक्षम बनाता है।
- SQL डेटा प्रोसेसिंग. PySpark का SQL इंटरफ़ेस हेल्थकेयर शोधकर्ताओं और विश्लेषकों के लिए बड़े जीनोमिक डेटा सेट्स पर क्वेरी और विश्लेषण करना आसान बनाता है।
PySpark कौशल की मांग है
डेटा साइंस और मशीन लर्निंग के उभार और उपलब्ध डेटा में बढ़ोतरी के साथ, डेटा मैनिपुलेशन कौशल वाले पेशेवरों की भारी मांग है। The State of Data & AI Literacy Report 2024 के अनुसार, 80% नेता डेटा विश्लेषण और मैनिपुलेशन कौशल को महत्व देते हैं।
PySpark सीखना व्यापक करियर अवसर खोल सकता है। Indeed पर 800 से अधिक जॉब लिस्टिंग, डेटा इंजीनियर से लेकर डेटा साइंटिस्ट तक, डेटा-संबंधित नौकरियों में PySpark दक्षता की मांग को दर्शाती हैं।
2026 में शून्य से PySpark कैसे सीखें
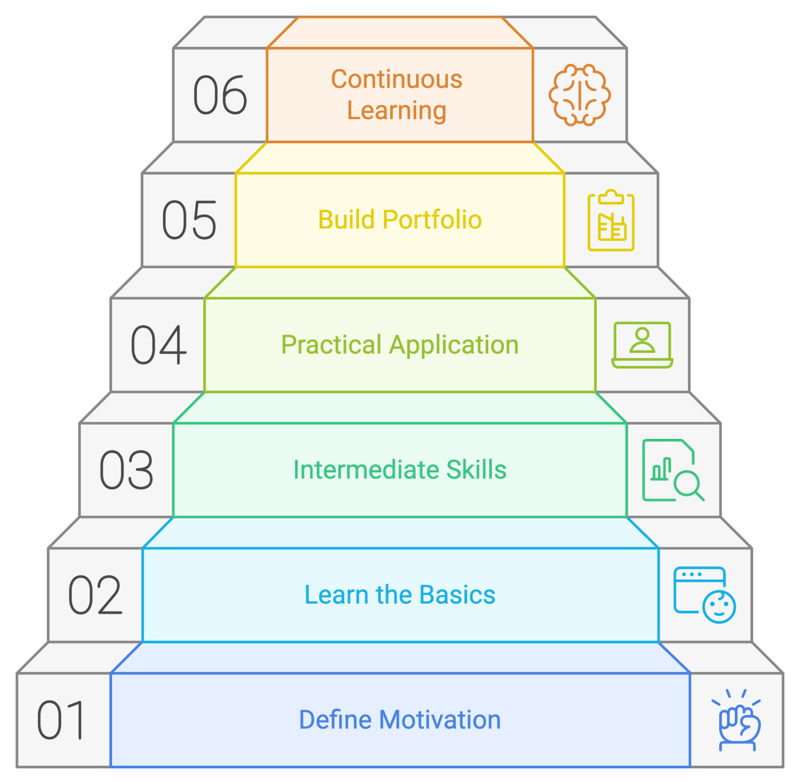
यदि आप PySpark को व्यवस्थित रूप से सीखते हैं, तो सफलता की संभावना अधिक होती है। आइए कुछ सिद्धांतों पर ध्यान दें जिन्हें आप अपनी लर्निंग यात्रा में अपना सकते हैं।
1. समझें कि आप PySpark क्यों सीख रहे हैं
तकनीकी विवरण सीखने से पहले, PySpark सीखने की अपनी प्रेरणा तय करें। खुद से पूछें:
- मेरे करियर लक्ष्य क्या हैं?
- क्या PySpark वह कौशल है जिसकी आपको मौजूदा भूमिका में आगे बढ़ने या मनचाही नौकरी पाने के लिए ज़रूरत है?
- यदि आप PySpark में महारत हासिल कर लें, तो आप किन अवसरों के खुलने की उम्मीद कर रहे हैं?
- मैं कौन-सी समस्याएँ सुलझाने की कोशिश कर रहा/रही हूँ?
- क्या आप ऐसे बड़े डेटा सेट प्रोसेस करने में संघर्ष कर रहे हैं जिन्हें आपके वर्तमान टूल्स संभाल नहीं पाते?
- क्या आपको जटिल डेटा ट्रांसफ़ॉर्मेशन करने या उन्नत मशीन-लर्निंग मॉडल बनाने की ज़रूरत है?
- मुझे किसमें रुचि है?
- क्या स्केलेबल डेटा पाइपलाइन्स बनाना आपको रोमांचित करता है?
- क्या आपको बिग डेटा और उससे इनसाइट्स निकालने की क्षमता में रुचि है?
- क्या मेरे दिमाग में कोई विशेष प्रोजेक्ट है जिसके लिए PySpark की क्षमताओं की ज़रूरत है?
- क्या आप किसी पर्सनल प्रोजेक्ट पर काम कर रहे हैं जिसमें बड़े पैमाने पर डेटा प्रोसेसिंग या विश्लेषण शामिल है?
- क्या आपकी कंपनी को किसी आगामी प्रोजेक्ट में PySpark विशेषज्ञता की ज़रूरत है?
2. PySpark की बुनियादी बातें से शुरुआत करें
अपने लक्ष्यों की पहचान करने के बाद, PySpark की बुनियादी अवधारणाओं में महारत हासिल करें और समझें कि वे कैसे काम करती हैं।
Python की बुनियाद
क्योंकि PySpark Python पर आधारित है, PySpark का उपयोग करने से पहले आपको Python से परिचित होना चाहिए। आपको वेरिएबल्स और फ़ंक्शन्स के साथ काम करने में सहज होना चाहिए। साथ ही, Pandas जैसी डेटा मैनिपुलेशन लाइब्रेरी से परिचित होना अच्छा विचार है। DataCamp का Introduction to Python कोर्स और Data Manipulation with Pandas आपको जल्दी गति पकड़ने में मदद कर सकते हैं।
PySpark इंस्टॉल करना और बेसिक्स सीखना
PySpark का उपयोग शुरू करने के लिए आपको इसे इंस्टॉल करने की ज़रूरत है। आप pip या Conda से PySpark डाउनलोड कर सकते हैं, आधिकारिक वेबसाइट से मैन्युअल रूप से डाउनलोड कर सकते हैं, या DataLab के साथ अपने ब्राउज़र में PySpark से शुरुआत कर सकते हैं।
यदि आप PySpark सेटअप करने की पूरी व्याख्या चाहते हैं, तो Windows, Mac और Linux पर PySpark कैसे इंस्टॉल करें पर यह गाइड देखें।
PySpark DataFrames
पहली अवधारणा जो आपको सीखनी चाहिए, वह है PySpark DataFrames कैसे काम करते हैं। वे PySpark के तेज़ और कुशल काम करने के मुख्य कारणों में से एक हैं। समझें कि उन्हें कैसे बनाया, ट्रांसफ़ॉर्म (मैप और फ़िल्टर) और मैनिपुलेट किया जाता है। PySpark के साथ काम शुरू कैसे करें पर ट्यूटोरियल इन अवधारणाओं में आपकी मदद करेगा।
3. मध्यवर्ती PySpark कौशल में महारत हासिल करें
एक बार जब आप बेसिक्स में सहज हो जाएँ, तो मध्यवर्ती PySpark कौशल की खोज करने का समय है।
Spark SQL
PySpark का एक बड़ा फायदा यह है कि यह SQL-जैसी क्वेरीज़ के जरिए DataFrames को पढ़ने और मैनिपुलेट करने, एग्रीगेशन करने और विंडो फ़ंक्शन्स का उपयोग करने की क्षमता देता है। पर्दे के पीछे, PySpark Spark SQL का उपयोग करता है। Python में Spark SQL का यह परिचय इस कौशल में मदद कर सकता है।
डेटा रैंगलिंग और ट्रांसफ़ॉर्मेशन
डेटा के साथ काम करना, उसे साफ़ करने, ट्रांसफ़ॉर्म करने और विश्लेषण के लिए तैयार करने में दक्ष होना शामिल है। इसमें मिसिंग वैल्यू हैंडल करना, विभिन्न डेटा टाइप्स को मैनेज करना और PySpark का उपयोग करके एग्रीगेशन करना शामिल है। व्यावहारिक अनुभव पाने और इन कौशलों में महारत हासिल करने के लिए DataCamp का Cleaning Data with PySpark करें।
MLlib के साथ मशीन लर्निंग
PySpark को उसकी MLlib लाइब्रेरी की बदौलत मशीन लर्निंग मॉडल विकसित और डिप्लॉय करने के लिए भी इस्तेमाल किया जा सकता है। आपको इस लाइब्रेरी का उपयोग करके फ़ीचर इंजीनियरिंग, मॉडल इवैल्युएशन और हाइपरपैरामीटर ट्यूनिंग करना सीखना चाहिए। DataCamp का Machine Learning with PySpark कोर्स एक व्यापक परिचय प्रदान करता है।
4. करके PySpark सीखें
PySpark का उपयोग करते हुए कोर्स लेना और अभ्यास प्रश्न हल करना तकनीक से परिचित होने का बेहतरीन तरीका है। हालाँकि, PySpark में प्रवीण बनने के लिए, आपको वास्तविक-जीवन के प्रोजेक्ट्स जैसी चुनौतीपूर्ण और कौशल-विकास समस्याएँ सुलझानी होंगी। आप सरल डेटा विश्लेषण कार्यों से शुरुआत कर सकते हैं और धीरे-धीरे अधिक जटिल चुनौतियों की ओर बढ़ सकते हैं।
अपनी कौशल का अभ्यास करने के कुछ तरीके यहाँ हैं:
- वेबिनार और कोड-अलॉन्ग में भाग लें. आगामी DataCamp वेबिनार और ऑनलाइन इवेंट देखें, जहाँ आप PySpark ट्यूटोरियल और कोड उदाहरणों के साथ फ़ॉलो कर सकते हैं। इससे आपकी अवधारणाएँ मज़बूत होंगी और कोडिंग पैटर्न से परिचित होंगे।
- स्वतंत्र प्रोजेक्ट विकसित करें. ऐसे डेटा सेट पहचानें जो आपको रुचिकर लगते हैं और उन पर अपने PySpark कौशल लागू करें। यह सोशल मीडिया ट्रेंड्स का विश्लेषण करने से लेकर वित्तीय बाज़ार डेटा की पड़ताल तक कुछ भी हो सकता है।
- ओपन-सोर्स प्रोजेक्ट्स में योगदान दें. GitHub जैसे प्लेटफ़ॉर्म पर PySpark प्रोजेक्ट्स में योगदान देकर सहयोग और वास्तविक-जीवन प्रोजेक्ट्स पर काम करने का अनुभव पाएँ।
- पर्सनल ब्लॉग बनाएं. अपने PySpark प्रोजेक्ट लिखें, अपने इनसाइट्स साझा करें, और एक व्यक्तिगत ब्लॉग बनाकर PySpark समुदाय में योगदान दें।
5. प्रोजेक्ट्स का पोर्टफोलियो बनाएं
जैसे-जैसे आप अपनी PySpark लर्निंग यात्रा में आगे बढ़ेंगे, आप विभिन्न प्रोजेक्ट पूरे करेंगे। अपनी PySpark कौशल और अनुभव संभावित नियोक्ताओं को दिखाने के लिए, आपको इन्हें एक पोर्टफोलियो में संकलित करना चाहिए। यह पोर्टफोलियो आपके कौशल और रुचियों को दर्शाए और उस करियर या उद्योग के अनुरूप हो, जिसमें आपकी रुचि है।
अपने प्रोजेक्ट्स को मौलिक रखने की कोशिश करें और अपनी समस्या-समाधान क्षमता प्रदर्शित करें। ऐसे प्रोजेक्ट शामिल करें जो PySpark के विभिन्न पहलुओं—जैसे डेटा रैंगलिंग, मशीन लर्निंग और डेटा विज़ुअलाइज़ेशन—में आपकी दक्षता दिखाएँ। अपने प्रोजेक्ट्स को डॉक्युमेंट करें, जिसमें संदर्भ, कार्यप्रणाली, कोड और परिणाम शामिल हों। आप DataLab का उपयोग कर सकते हैं, जो एक ऑनलाइन IDE है जहाँ आप कोड लिख सकते हैं, सहयोगात्मक रूप से डेटा का विश्लेषण कर सकते हैं और अपने इनसाइट्स साझा कर सकते हैं।
यहाँ दो PySpark प्रोजेक्ट हैं जिन पर आप काम कर सकते हैं:
6. खुद को लगातार चुनौती दें
PySpark सीखना एक सतत यात्रा है। तकनीक लगातार विकसित होती रहती है, और नई विशेषताएँ व अनुप्रयोग नियमित रूप से विकसित होते हैं। PySpark भी इससे अलग नहीं है।
एक बार जब आप मूलभूत बातों में महारत हासिल कर लें, तो परफ़ॉर्मेंस ऑप्टिमाइज़ेशन या GraphX जैसे अधिक चुनौतीपूर्ण कार्यों और प्रोजेक्ट्स की तलाश करें। अपने लक्ष्यों पर ध्यान केंद्रित करें और उन क्षेत्रों में विशेषज्ञता विकसित करें जो आपके करियर लक्ष्यों और रुचियों से मेल खाते हैं।
नई प्रगति से अपडेट रहें और उन्हें अपने मौजूदा प्रोजेक्ट्स में लागू करना सीखें। अभ्यास करते रहें, नई चुनौतियाँ और अवसर खोजें, और गलतियाँ करने को सीखने के एक तरीके के रूप में अपनाएँ।
आइए PySpark की सफल लर्निंग प्लान के लिए उठाए जा सकने वाले कदमों का पुनरावलोकन करें:
एक उदाहरण PySpark लर्निंग प्लान
भले ही हर व्यक्ति का सीखने का अपना तरीका होता है, कोई नया टूल सीखने के लिए एक प्लान या गाइड होना हमेशा अच्छा विचार है। हमने एक संभावित लर्निंग प्लान बनाया है जो बताता है कि यदि आप PySpark के साथ अभी शुरुआत कर रहे हैं, तो अपना समय और प्रयास कहाँ केंद्रित करें।
महीना 1: PySpark की बुनियाद
- मुख्य सिद्धांत. PySpark इंस्टॉल करें और इसकी सिंटैक्स एक्सप्लोर करें। Apache Spark की मुख्य अवधारणाएँ, इसकी आर्किटेक्चर और यह वितरित डेटा प्रोसेसिंग कैसे सक्षम करता है, समझें।
- PySpark बेसिक्स. अपना PySpark एनवायरनमेंट सेट करना, SparkContext और SparkSession बनाना सीखें, और RDDs और DataFrames जैसी बुनियादी डेटा संरचनाएँ एक्सप्लोर करें।
- डेटा मैनिपुलेशन. फ़िल्टरिंग, सॉर्टिंग, ग्रुपिंग, एग्रीगेटिंग और जॉइनिंग सहित डेटा मैनिपुलेशन के लिए आवश्यक PySpark ऑपरेशंस में महारत हासिल करें। आप Cleaning Orders with PySpark प्रोजेक्ट पूरा कर सकते हैं।
महीना 2: डेटा विश्लेषण और SQL के लिए PySpark
- विभिन्न डेटा फ़ॉर्मैट के साथ काम करना: PySpark का उपयोग करके CSV, JSON, Parquet और Avro सहित विभिन्न फ़ॉर्मैट में डेटा पढ़ना और लिखना सीखें।
- Spark SQL. Spark SQL का उपयोग करके परिचित SQL सिंटैक्स के साथ डेटा पर क्वेरी और विश्लेषण करना सीखें। DataFrames, Datasets और SQL फ़ंक्शन्स जैसी अवधारणाएँ एक्सप्लोर करें।
- डेटा विज़ुअलाइज़ेशन और फ़ीचर इंजीनियरिंग: PySpark में Matplotlib और Seaborn जैसी लाइब्रेरी की मदद से डेटा विज़ुअलाइज़ेशन तकनीकें एक्सप्लोर करें ताकि अपने डेटा से इनसाइट्स मिलें। Feature Engineering with PySpark कोर्स लेकर डेटा रैंगलिंग और फ़ीचर इंजीनियरिंग करना सीखें।
महीना 3-4: मशीन लर्निंग और एडवांस्ड टॉपिक्स के लिए PySpark
- MLlib परिचय: मशीन लर्निंग के लिए PySpark की MLlib लाइब्रेरी से शुरुआत करें। वर्गीकरण, रिग्रेशन और क्लस्टरिंग के बुनियादी एल्गोरिद्म एक्सप्लोर करें। आप Machine Learning with PySpark कोर्स का उपयोग कर सकते हैं।
- ML पाइपलाइन्स बनाना. PySpark में मशीन लर्निंग पाइपलाइन्स बनाना और डिप्लॉय करना सीखें ताकि मॉडल ट्रेनिंग और इवैल्युएशन कुशलता से हो सके।
- एक प्रोजेक्ट विकसित करें. Demand Forecasting Model विकसित करने पर काम करें।
- एडवांस्ड कॉन्सेप्ट्स. डेटा पार्टिशनिंग, कैशिंग और परफॉर्मेंस ट्यूनिंग सहित PySpark एप्लिकेशन को ऑप्टिमाइज़ करने की तकनीकें एक्सप्लोर करें।
PySpark सीखने के पाँच सुझाव
मेरा अंदाज़ा है कि अब आप PySpark सीखने के लिए तैयार हैं और अभ्यास के लिए किसी बड़े डेटा सेट पर हाथ आज़माना चाहते हैं। लेकिन उससे पहले, मैं कुछ सुझाव रौशन करना चाहता हूँ जो आपको PySpark में दक्षता पाने के रास्ते पर मदद करेंगे।
1. दायरा सीमित रखें
PySpark एक ऐसा टूल है जिसके कई अलग-अलग अनुप्रयोग हो सकते हैं। ध्यान बनाए रखने और लक्ष्य हासिल करने के लिए, आपको अपनी रुचि का क्षेत्र पहचानना चाहिए। क्या आप डेटा विश्लेषण, डेटा इंजीनियरिंग या मशीन लर्निंग पर फोकस करना चाहते हैं? फ़ोकस्ड अप्रोच आपके चुने हुए रास्ते के लिए PySpark के सबसे प्रासंगिक पहलुओं और ज्ञान को हासिल करने में मदद करती है।
2. बार-बार और लगातार अभ्यास करें
किसी भी नए कौशल में महारत के लिए निरंतरता ज़रूरी है। आपको PySpark के अभ्यास के लिए समर्पित समय निकालना चाहिए। हर दिन थोड़ा-सा समय भी पर्याप्त है। आपको रोज़ जटिल अवधारणाओं से जूझने की ज़रूरत नहीं है। आपने जो सीखा है उसे रिव्यू करें या किसी सरल अभ्यास को रिफ़ैक्टर करने के लिए फिर से देखें। नियमित अभ्यास आपकी अवधारणाओं को मज़बूत करेगा और उन्हें लागू करने में आत्मविश्वास बढ़ाएगा।
3. वास्तविक प्रोजेक्ट्स पर काम करें
यह सबसे अहम सुझावों में से एक है, और आप इसे इस गाइड में कई बार पढ़ेंगे। अभ्यास प्रश्न आत्मविश्वास बढ़ाने के लिए अच्छे हैं। हालाँकि, अपनी PySpark कौशल को वास्तविक-जीवन के प्रोजेक्ट्स पर लागू करना ही आपको उत्कृष्ट बनाता है। ऐसे डेटा सेट खोजें जो आपको रुचिकर लगें और PySpark का उपयोग करके उनका विश्लेषण करें, इनसाइट्स निकालें और समस्याएँ सुलझाएँ।
सरल प्रोजेक्ट्स और प्रश्नों से शुरुआत करें और धीरे-धीरे अधिक जटिल पर जाएँ। यह इतना सरल हो सकता है कि किसी वास्तविक डेटा सेट को पढ़ना और साफ़ करना, एक जटिल क्वेरी लिखकर एग्रीगेशन करना और किसी घर की कीमत का अनुमान लगाना।
4. किसी समुदाय से जुड़ें
अक्सर सहयोगी रूप से सीखना अधिक प्रभावी होता है। अपने अनुभव साझा करना और दूसरों से सीखना आपकी प्रगति तेज कर सकता है और मूल्यवान इनसाइट्स दे सकता है।
ज्ञान, विचार और प्रश्नों का आदान-प्रदान करने के लिए, आप PySpark से संबंधित समूहों में शामिल हो सकते हैं, और मीट-अप व कॉन्फ़्रेंस अटेंड कर सकते हैं। Databricks Community, जो Spark के निर्माताओं द्वारा स्थापित कंपनी है, में एक सक्रिय फ़ोरम है जहाँ आप PySpark पर चर्चा कर सकते हैं और प्रश्न पूछ सकते हैं। इसके अलावा, Databricks द्वारा आयोजित Spark Summit सबसे बड़ा Spark सम्मेलन है।
5. गलतियाँ करें
अन्य किसी भी तकनीक की तरह, PySpark सीखना एक आवर्तक प्रक्रिया है। और अपनी गलतियों से सीखना इस प्रक्रिया का एक आवश्यक हिस्सा है। प्रयोग करने, अलग-अलग अप्रोच आज़माने और अपनी त्रुटियों से सीखने से न डरें। डेटा एग्रीगेट करने के लिए अलग-अलग फ़ंक्शन्स और विकल्प आज़माएँ, सबक्वेरी या नेस्टेड क्वेरी करें, और PySpark की तेज़ प्रतिक्रिया देखें।
PySpark सीखने के सर्वोत्तम तरीके
आइए PySpark सीखने के कुछ प्रभावी तरीकों को कवर करें।
ऑनलाइन कोर्स लें
ऑनलाइन कोर्स आपको अपनी गति से PySpark सीखने का बेहतरीन तरीका देते हैं। DataCamp सभी स्तरों के लिए PySpark कोर्स प्रदान करता है, जो मिलकर Big Data with PySpark ट्रैक बनाते हैं। ये कोर्स आरंभी अवधारणाओं से लेकर मशीन लर्निंग विषयों तक को कवर करते हैं और हैंड्स-ऑन अभ्यासों के साथ डिज़ाइन किए गए हैं।
DataCamp पर कुछ PySpark-संबंधित कोर्स ये हैं:
- Feature Engineering with PySpark
- Machine Learning with PySpark
- Building Recommendation Engines with PySpark
- Big Data Fundamentals with PySpark
ऑनलाइन ट्यूटोरियल फ़ॉलो करें
ट्यूटोरियल PySpark सीखने का एक और अच्छा तरीका हैं, खासकर यदि आप इस तकनीक में नए हैं। इनमें चरण-दर-चरण निर्देश होते हैं कि विशिष्ट कार्य कैसे करें या कुछ अवधारणाएँ कैसे समझें। शुरुआत के लिए, ये ट्यूटोरियल देखें:
PySpark चीट शीट्स देखें
जब आपको PySpark विषयों पर त्वरित संदर्भ गाइड चाहिए हो, चीट शीट्स उपयोगी रहती हैं। यहाँ दो काम की चीट शीट्स हैं:
PySpark प्रोजेक्ट्स पूरा करें
PySpark सीखने के लिए हैंड्स-ऑन अभ्यास आवश्यक है। प्रोजेक्ट पूरे करते समय चुनौतियों का सामना करना आपको सीखी हुई सभी कौशल लागू करने देगा। जैसे-जैसे आप अधिक जटिल कार्य लेने लगेंगे, मनचाहे नतीजे पाने के लिए आपको समाधान ढूँढने और नए विकल्पों पर रिसर्च करने की ज़रूरत होगी, जिससे आपकी PySpark विशेषज्ञता बढ़ेगी।
DataCamp पर काम करने के लिए PySpark प्रोजेक्ट देखें। ये आपको PySpark का लाभ उठाते हुए डेटा मैनिपुलेशन और मशीन लर्निंग मॉडल बनाने की कौशल लागू करने देते हैं:
किताबों के ज़रिये PySpark जानें
किताबें PySpark सीखने का उत्कृष्ट स्रोत हैं। ये विशेषज्ञों से गहन ज्ञान और अंतर्दृष्टि देती हैं, साथ में कोड स्निपेट्स और व्याख्याएँ भी। PySpark पर कुछ लोकप्रिय किताबें ये हैं:
- Learning PySpark 2nd Edition, Jules S. Damji
- PySpark Cookbook, Denny Lee
- The Spark for Python Developers
PySpark में करियर
PySpark कौशल की मांग कई डेटा-संबंधित भूमिकाओं—डेटा एनालिस्ट से लेकर बिग डेटा इंजीनियर तक—में बढ़ी है। यदि आप इंटरव्यू की तैयारी कर रहे हैं, तो इन PySpark इंटरव्यू प्रश्नों पर विचार करें
बिग डेटा इंजीनियर
एक बिग डेटा इंजीनियर के रूप में, आप बिग डेटा समाधानों के आर्किटेक्ट होते हैं—बड़े डेटा सेट को संभालने वाला इन्फ्रास्ट्रक्चर डिज़ाइन, निर्माण और मेंटेन करते हैं। आप स्केलेबल डेटा पाइपलाइन्स बनाने के लिए PySpark पर निर्भर होंगे, ताकि डेटा इन्गेशन, प्रोसेसिंग और स्टोरेज कुशलतापूर्वक हो।
आपको डिस्ट्रीब्यूटेड कंप्यूटिंग और क्लाउड प्लेटफ़ॉर्म की मज़बूत समझ, तथा डेटा वेयरहाउसिंग और ETL प्रक्रियाओं में विशेषज्ञता की आवश्यकता होगी।
- मुख्य कौशल:
- Python और PySpark, Java, और Scala में प्रवीणता
- डेटा स्ट्रक्चर्स और एल्गोरिद्म की समझ
- SQL और NoSQL दोनों में दक्षता
- ETL प्रक्रियाओं और डेटा पाइपलाइन बिल्डिंग में विशेषज्ञता
- डिस्ट्रीब्यूटेड सिस्टम्स की समझ
- उपयोग किए जाने वाले प्रमुख टूल्स:
- Apache Spark, Hadoop इकोसिस्टम
- डेटा वेयरहाउसिंग टूल्स (जैसे Snowflake, Redshift, या BigQuery)
- क्लाउड प्लेटफ़ॉर्म (जैसे AWS, GCP, Databricks)
- वर्कफ़्लो ऑर्केस्ट्रेशन टूल्स (जैसे Apache Airflow, Apache Kafka)
डेटा साइंटिस्ट
डेटा साइंटिस्ट के रूप में, आप डेटा रैंगलिंग और मैनिपुलेशन के लिए PySpark की क्षमताएँ इस्तेमाल करेंगे और मशीन लर्निंग मॉडल विकसित व डिप्लॉय करेंगे। आपका सांख्यिकी ज्ञान और प्रोग्रामिंग कौशल निर्णय-निर्माण प्रक्रिया में योगदान करने वाले मॉडल विकसित करने में सहायक होगा।
- मुख्य कौशल:
- Python, PySpark, और SQL का गहन ज्ञान
- मशीन लर्निंग और AI अवधारणाओं की समझ
- सांख्यिकीय विश्लेषण, मात्रात्मक एनालिटिक्स और प्रेडिक्टिव मॉडलिंग में दक्षता
- डेटा विज़ुअलाइज़ेशन और रिपोर्टिंग तकनीकें
- प्रभावी संचार और प्रेज़ेंटेशन कौशल
- उपयोग किए जाने वाले प्रमुख टूल्स:
- डेटा विश्लेषण टूल्स (उदा., pandas, NumPy)
- मशीन लर्निंग लाइब्रेरीज़ (उदा., Scikit-learn)
- डेटा विज़ुअलाइज़ेशन टूल्स (उदा., Matplotlib, Tableau)
- बिग डेटा फ़्रेमवर्क (उदा., Airflow, Spark)
- कमांड लाइन टूल्स (उदा., Git, Bash)
मशीन लर्निंग इंजीनियर
मशीन लर्निंग इंजीनियर के रूप में, आप PySpark का उपयोग डेटा तैयार करने, मशीन लर्निंग मॉडल बनाने, उन्हें ट्रेन करने और डिप्लॉय करने के लिए करेंगे।
- मुख्य कौशल:
- Python, PySpark, और SQL में प्रवीणता
- मशीन लर्निंग एल्गोरिद्म की गहरी समझ
- डीप लर्निंग फ़्रेमवर्क का ज्ञान
- डेटा स्ट्रक्चर्स, डेटा मॉडलिंग और सॉफ़्टवेयर आर्किटेक्चर की समझ
- उपयोग किए जाने वाले प्रमुख टूल्स:
- मशीन लर्निंग लाइब्रेरीज़ और एल्गोरिद्म (उदा., Scikit-learn, TensorFlow)
- डेटा साइंस लाइब्रेरीज़ (उदा., Pandas, NumPy)
- क्लाउड प्लेटफ़ॉर्म (उदा., AWS, Google Cloud Platform)
- वर्शन कंट्रोल सिस्टम्स (उदा., Git)
- डीप लर्निंग फ़्रेमवर्क (उदा., TensorFlow, Keras, PyTorch)
डेटा एनालिस्ट
डेटा एनालिस्ट के रूप में, आप PySpark का उपयोग बड़े डेटा सेट को एक्सप्लोर और विश्लेषित करने, रुझान पहचानने और अपनी खोजों को रिपोर्ट्स व विज़ुअलाइज़ेशन के माध्यम से संप्रेषित करने में करेंगे।
- मुख्य कौशल:
- Python, PySpark, और SQL में प्रवीणता
- सांख्यिकीय विश्लेषण का गहन ज्ञान
- बिज़नेस इंटेलिजेंस टूल्स (उदा., Tableau, Power BI) का अनुभव
- डेटा कलेक्शन और डेटा क्लीनिंग तकनीकों की समझ
- उपयोग किए जाने वाले प्रमुख टूल्स:
- डेटा विश्लेषण टूल्स (उदा., pandas, NumPy)
- बिज़नेस इंटेलिजेंस टूल्स (उदा., Tableau, Power BI)
- SQL डेटाबेस (उदा., MySQL, PostgreSQL)
|
भूमिका |
आप क्या करते हैं |
आपके मुख्य कौशल |
आपके टूल्स |
|
Big Data Engineer |
बड़े डेटा सेट को संभालने वाले इन्फ्रास्ट्रक्चर को डिज़ाइन, बनाता और मेंटेन करता/करती है। |
Python, PySpark, Java, और Scala, डेटा स्ट्रक्चर्स, SQL और NoSQL, ETL, डिस्ट्रीब्यूटेड सिस्टम्स |
Apache Spark, Hadoop, डेटा वेयरहाउसिंग टूल्स, क्लाउड प्लेटफ़ॉर्म, वर्कफ़्लो ऑर्केस्ट्रेशन टूल्स |
|
Data Scientist |
छिपे हुए पैटर्न ढूँढता/ढूँढती है और डेटा से मूल्यवान इनसाइट्स निकालता/निकालती है। सांख्यिकीय ज्ञान और प्रोग्रामिंग कौशल लागू करके ऐसे मॉडल बनाता/बनाती है जो निर्णय-निर्माण में सहायक हों। |
Python, PySpark, SQL, मशीन लर्निंग, AI अवधारणाएँ, सांख्यिकीय विश्लेषण, प्रेडिक्टिव मॉडलिंग, डेटा विज़ुअलाइज़ेशन, प्रभावी संचार |
Pandas, NumPy, Scikit-learn, Keras, Matplotlib, plotly, Airflow, Spark, Git |
|
Machine Learning Engineer |
कंपनी के डेटा का उपयोग कर भविष्यवाणी करने हेतु मशीन लर्निंग सिस्टम्स को डिज़ाइन, विकसित और डिप्लॉय करता/करती है. |
Python, PySpark, और SQL, मशीन लर्निंग एल्गोरिद्म, डीप लर्निंग, डेटा स्ट्रक्चर्स, डेटा मॉडलिंग, और सॉफ़्टवेयर आर्किटेक्चर |
Scikit-learn, TensorFlow, Keras, PyTorch, Pandas, NumPy, AWS, Google Cloud Platform, Git |
|
Data Analyst |
कच्चे डेटा और क्रियाशील बिज़नेस इनसाइट्स के बीच पुल का काम करता/करती है। रिपोर्ट्स और विज़ुअलाइज़ेशन के ज़रिये निष्कर्ष संप्रेषित करता/करती है। |
Python, PySpark, और SQL, सांख्यिकीय विश्लेषण, डेटा विज़ुअलाइज़ेशन, डेटा कलेक्शन और डेटा क्लीनिंग तकनीकें |
Pandas, NumPy, Tableau, PowerBI, MySQL, PostgreSQL. |
ऐसी नौकरी कैसे खोजें जिसमें PySpark का उपयोग होता हो या PySpark में हो
PySpark का उपयोग करने वाले करियर की शुरुआत में डिग्री एक बड़ा सहारा हो सकती है, पर यह एकमात्र रास्ता नहीं है। आजकल, बढ़ती संख्या में पेशेवर वैकल्पिक मार्गों से, जिनमें अन्य क्षेत्रों से संक्रमण भी शामिल है, डेटा-संबंधित भूमिकाओं में आ रहे हैं। समर्पण, निरंतर सीखने और सक्रिय दृष्टिकोण के साथ, आप PySpark का उपयोग करने वाली अपनी मनचाही नौकरी हासिल कर सकते हैं।
क्षेत्र के बारे में सीखते रहें
PySpark में नवीनतम विकास से अपडेट रहें। सोशल मीडिया पर PySpark से जुड़े प्रभावशाली पेशेवरों को फ़ॉलो करें, PySpark-संबंधित ब्लॉग पढ़ें और पॉडकास्ट सुनें।
PySpark का विकास Matei Zaharia द्वारा किया गया था, जो Databricks के CTO भी हैं—एक प्लेटफ़ॉर्म जो Apache Spark के ऊपर बना है। आपको ट्रेंडिंग विषयों, उभरती तकनीकों और PySpark की भविष्य दिशा पर इनसाइट्स मिलेंगी।
आपको उद्योग इवेंट्स भी देखने चाहिए, चाहे वे DataCamp पर वेबिनार, डेटा साइंस और AI कॉन्फ़्रेंस हों, या नेटवर्किंग इवेंट्स।
एक पोर्टफोलियो बनाएं
आपको अन्य उम्मीदवारों से अलग दिखना होगा। ऐसा करने का एक अच्छा तरीका है एक मज़बूत पोर्टफोलियो बनाना जो आपके कौशल और पूरे किए गए प्रोजेक्ट्स को प्रदर्शित करे। वास्तविक-जीवन की चुनौतियों को एड्रेस करके आप हायरिंग मैनेजर्स पर अच्छा प्रभाव डाल सकते हैं।
आपके पोर्टफोलियो में विविध प्रोजेक्ट होने चाहिए जो PySpark में आपकी विशेषज्ञता और उसके विभिन्न अनुप्रयोगों को दर्शाएँ। इस गाइड को देखें कि उत्कृष्ट डेटा साइंस पोर्टफोलियो कैसे तैयार करें।
प्रभावी रिज़्यूमे तैयार करें
हाल के वर्षों में डेटा साइंस और डेटा-संबंधित भूमिकाओं में ट्रांज़िशन करने वालों की संख्या बढ़ी है। हायरिंग मैनेजर्स को सैकड़ों रिज़्यूमे की समीक्षा करनी पड़ती है और बेहतरीन उम्मीदवारों की पहचान करनी पड़ती है। साथ ही, कई बार आपका रिज़्यूमे Applicant Tracking Systems (ATS) से होकर गुजरता है—स्वचालित सॉफ़्टवेयर सिस्टम्स जो कई कंपनियाँ रिज़्यूमे की समीक्षा करने और विशिष्ट मानदंडों को न पूरा करने वाले रिज़्यूमे को हटाने के लिए उपयोग करती हैं। इसलिए, आपको एक बेहतरीन रिज़्यूमे बनाना चाहिए जो ATS और रिक्रूटर्स—दोनों को प्रभावित करे।
इंटरव्यू की तैयारी करें
यदि हायरिंग मैनेजर का ध्यान आप पर जाता है या आपका प्रभावी रिज़्यूमे चयन प्रक्रिया से गुजरता है, तो आपको अगला कदम तकनीकी इंटरव्यू की तैयारी करनी चाहिए। तैयार रहने के लिए, PySpark इंटरव्यू के शीर्ष पूछे जाने वाले प्रश्न पर यह लेख देखें।
निष्कर्ष
PySpark सीखना बेहतर अवसरों और करियर परिणामों के लिए दरवाज़े खोल सकता है। PySpark सीखने का रास्ता फलदायी है, लेकिन इसमें निरंतरता और हैंड्स-ऑन अभ्यास की आवश्यकता होती है। इस टूल का उपयोग करके प्रयोग करना और चुनौतियाँ सुलझाना आपके सीखने की गति बढ़ा सकता है और नौकरी ढूँढते समय दिखाने के लिए वास्तविक-जीवन के उदाहरण मुहैया करा सकता है।
FAQs
PySpark की मुख्य विशेषताएँ क्या हैं?
PySpark Spark का लाभ उठाने के लिए उपयोगकर्ता-अनुकूल Python API प्रदान करता है, जो बड़े डेटा सेट्स के लिए गति, स्केलेबिलिटी और SQL, मशीन लर्निंग तथा स्ट्रीम प्रोसेसिंग का समर्थन सक्षम करता है।
PySpark कौशलों की मांग क्यों बढ़ रही है?
बिग डेटा प्रोसेसिंग और मशीन लर्निंग के लिए PySpark की उपयोग-सहजता, स्केलेबिलिटी और बहुउद्देशीयता इन कौशलों की बढ़ती मांग को बढ़ा रही है।
PySpark सीखने के लिए किन प्रमुख बिंदुओं पर विचार करें?
Python की बुनियाद, Spark के मुख्य सिद्धांत और डेटा मैनिपुलेशन तकनीकों पर ध्यान दें, और Spark SQL तथा MLlib जैसे उन्नत विषय एक्सप्लोर करें।
PySpark सीखने के कुछ तरीके क्या हैं?
ऑनलाइन कोर्स लें और ट्यूटोरियल फ़ॉलो करें, वास्तविक-जीवन के डेटा सेट्स पर काम करें, चीट शीट्स का उपयोग करें, और किताबों के माध्यम से PySpark जानें।
PySpark का उपयोग करने वाली कुछ भूमिकाएँ क्या हैं?
PySpark का उपयोग करने वाली कुछ भूमिकाएँ हैं: बिग डेटा इंजीनियर, मशीन लर्निंग इंजीनियर, डेटा साइंटिस्ट, और डेटा एनालिस्ट।

लेखक
Maria Eugenia Inzaugarat
अनुमान है कि रोज़ाना करीब 328.77 मिलियन टेराबाइट डेटा बनता है। हर क्लिक और खरीद से डेटा पैदा होता है, जिसे सही टूल्स के साथ अर्थपूर्ण इनसाइट्स और पूर्वानुमानों में बदला जा सकता है।
हालाँकि, इतने बड़े पैमाने के डेटा को प्रोसेस करने के लिए हमें एक हाई-परफॉर्मेंस लाइब्रेरी की आवश्यकता होती है। यही पर PySpark काम आता है।
इस गाइड में, हम शून्य से PySpark सीखने के तरीके तलाशेंगे। मैं आपकी एक लर्निंग प्लान बनाने में मदद करूँगा, इसे प्रभावी ढंग से सीखने के लिए अपने बेहतरीन सुझाव साझा करूँगा, और ऐसे उपयोगी संसाधन दूँगा जो PySpark की मांग वाली भूमिकाएँ ढूँढने में सहायक हों।