
डेटा इंजीनियरिंग में DAGs क्यों महत्वपूर्ण हैं
एक डेटा इंजीनियर या डेटा इंजीनियरिंग कार्य करने वाले व्यक्ति के रूप में, आप अक्सर जटिल डेटा पाइपलाइन बनाने की चुनौती का सामना करते हैं, जिनमें चरणों का निष्पादन आवश्यक होता है और हर चरण पिछले पर निर्भर होता है। यहीं पर DAGs काम आते हैं!
क्योंकि वे कार्यों को नोड्स और निर्भरताओं को एजेस के रूप में प्रस्तुत कर सकते हैं, DAGs एक तार्किक निष्पादन क्रम लागू करते हैं, यह सुनिश्चित करते हुए कि निर्भरताओं के आधार पर कार्य क्रमवार चलें। इससे कार्यों को गलत क्रम में चलाने से होने वाली त्रुटियाँ और असंगतियाँ रोकी जाती हैं। साथ ही, यदि कोई चरण विफल हो जाए, तो DAGs प्रभावित कार्यों की पहचान कर उन्हें दोबारा चला सकते हैं, जिससे समय और श्रम की बचत होती है।
यदि आप डेटा पाइपलाइन बनाना नए हैं या अपनी बुनियाद मजबूत करना चाहते हैं, तो Understanding Data Engineering कोर्स एक बेहतरीन शुरुआती बिंदु है।
DAGs का ए-साइक्लिक स्वभाव उन्हें डेटा पाइपलाइनों के लिए आदर्श बनाता है। वे सुनिश्चित करते हैं कि कार्य अनंत लूप या रिकर्सिव निर्भरताओं के बिना चलें, जो सिस्टम अस्थिरता का कारण बन सकती हैं।
आइए एक सरल डेटा पाइपलाइन का उदाहरण देखते हैं:
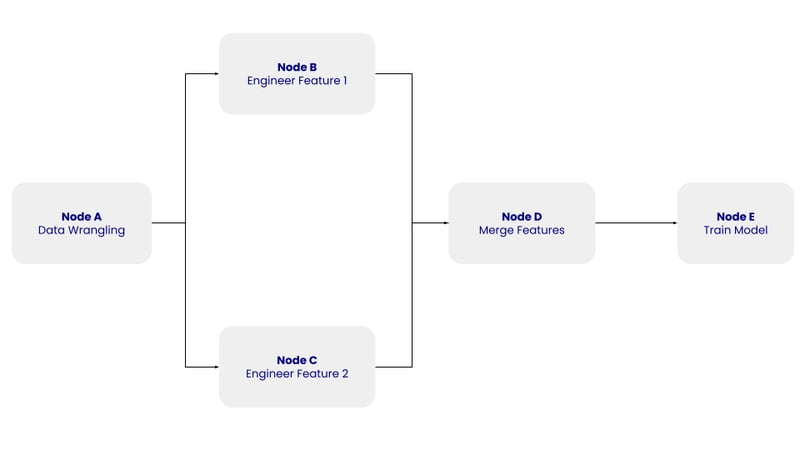 A, B, C, D और E नोड्स तथा उनकी निर्भरताओं वाला इस सरल DAG की संरचना। लेखक द्वारा छवि।
उपरोक्त DAG में, नोड A डेटा रैंगलिंग चरण का प्रतिनिधित्व करता है, जिसमें डेटा की सफाई और पूर्व-संसाधन शामिल है। नोड B और C फीचर इंजीनियरिंग के चरण हैं, जहाँ साफ किए गए डेटा को स्वतंत्र रूप से दो फीचर्स में बदला जाता है। नोड D में फीचर्स का मर्ज करना शामिल है। अंत में, नोड E मॉडल प्रशिक्षण चरण का प्रतिनिधित्व करता है, जहाँ एक मशीन लर्निंग मॉडल परिवर्तित डेटा पर प्रशिक्षित किया जाता है।
DAG कार्यों के अंदर क्या होता है, इसकी परवाह नहीं करता—वह केवल इस क्रम की परवाह करता है जिसमें उन्हें निष्पादित किया जाना चाहिए।
इसके अलावा, DAGs आपको स्वचालित, स्केलेबल डेटा वर्कफ़्लो बनाने में सक्षम बनाते हैं, विशेषकर वितरित प्रणालियों और क्लाउड परिवेशों में। वे जटिल डेटा प्रोसेसिंग कार्यों को छोटे, स्वतंत्र, प्रबंधनीय उप-कार्यों में विभाजित करते हैं, जिससे समानांतर निष्पादन और संसाधनों का कुशल उपयोग संभव होता है। बड़े डेटासेट और जटिल पाइपलाइनों के साथ काम करते समय यह स्केलेबिलिटी विशेष रूप से महत्वपूर्ण है, क्योंकि यह किफायती डेटा प्रोसेसिंग सक्षम करती है।
अंततः, DAGs किसी भी डेटा पाइपलाइन का दृश्य प्रतिनिधित्व प्रदान कर सकते हैं, जो आपको वर्कफ़्लो को समझने और संप्रेषित करने में मदद करता है। यह दृश्य स्पष्टता अन्य टीम सदस्यों या गैर-तकनीकी हितधारकों के साथ सहयोग करते समय महत्वपूर्ण होती है। यदि आप डेटा के फ्लो और कार्यों के बीच निर्भरताओं को समझ सकते हैं, तो मुद्दों की पहचान और सुधार करना, संसाधनों का सर्वोत्तम उपयोग करना, और पाइपलाइन सुधारों पर सूचित निर्णय लेना आसान हो जाता है।
Python में ETL और ELT पर कोर्स डेटा पाइपलाइनों को बनाने और अनुकूलित करने का व्यावहारिक अभ्यास करने के लिए एक उत्कृष्ट संसाधन है।
डेटा इंजीनियरिंग में DAGs के सामान्य उपयोग
DAGs को व्यापक रूप से अपनाया गया है और डेटा इंजीनियरिंग में इनके विभिन्न अनुप्रयोग हैं। पिछले खंड में हमने उनमें से कुछ पर चर्चा की। अब, आइए उन्हें थोड़ा विस्तार से देखें।
ETL पाइपलाइन
DAGs का सबसे सामान्य उपयोग Extract, Transform, and Load (ETL) प्रक्रियाओं का ऑर्केस्ट्रेशन है। ETL पाइपलाइन में विभिन्न स्रोतों से डेटा निकालना, उसे उपयुक्त प्रारूप में बदलना और किसी लक्षित सिस्टम में लोड करना शामिल होता है।
उदाहरण के लिए, Apache Airflow और Luigi जैसे टूल्स DAGs का उपयोग करके ETL पाइपलाइनों का कुशलता से ऑर्केस्ट्रेशन करते हैं। एक व्यावहारिक उपयोग मामला CRM सिस्टम से डेटा एकीकृत करना, उसे आपके व्यावसायिक आवश्यकताओं के अनुरूप बदलना, और एनालिटिक्स के लिए उसे Snowflake डेटा वेयरहाउस में लोड करना हो सकता है।
आप अपने ETL प्रक्रियाओं में कार्यों के रनटाइम्स की निगरानी और लॉगिंग के लिए भी DAGs का लाभ उठा सकते हैं। इससे बॉटलनेक्स या ऐसे कार्यों की पहचान करने में मदद मिलती है जिन्हें अनुकूलन की आवश्यकता है।
जटिल वर्कफ़्लो ऑर्केस्ट्रेशन
DAGs उन जटिल डेटा वर्कफ़्लोज़ को प्रबंधित करने के लिए भी उत्कृष्ट हैं जिनमें कई कार्य और निर्भरताएँ शामिल होती हैं। उदाहरण के लिए, किसी मशीन लर्निंग वर्कफ़्लो में फीचर इंजीनियरिंग, मॉडल प्रशिक्षण और मॉडल परिनियोजन जैसे कार्य शामिल हो सकते हैं।
उदाहरण के तौर पर, Apache Airflow में एक DAG फीचर सिलेक्शन स्क्रिप्ट चलाएगा और केवल फीचर्स के प्रोसेस होने के बाद ही मॉडल प्रशिक्षण ट्रिगर करेगा, जिससे निर्भरताओं का प्रबंधन और पुनरुत्पादन सुनिश्चित होता है।
डेटा प्रोसेसिंग पाइपलाइन
DAGs का व्यापक उपयोग डेटा प्रोसेसिंग पाइपलाइनों में किया जाता है, जहाँ वे कई स्रोतों से डेटा के फ्लो का प्रबंधन करते हैं और उसे उपयोगी अंतर्दृष्टियों में बदलते हैं। उदाहरण के लिए, Apache Spark में एक DAG किसी वेबसाइट के क्लिकस्ट्रीम डेटा को प्रोसेस कर सकता है, सेशन अवधि की गणना के लिए एग्रीगेशन कर सकता है और इन अंतर्दृष्टियों को किसी डैशबोर्ड में भेज सकता है।
Spark में DAGs उपयोगकर्ताओं द्वारा स्पष्ट रूप से परिभाषित नहीं किए जाते, बल्कि ट्रांसफ़ॉर्मेशन के निष्पादन को अनुकूलित करने के लिए फ़्रेमवर्क के भीतर आंतरिक रूप से बनाए जाते हैं।
मशीन लर्निंग पाइपलाइन
मशीन लर्निंग में, DAGs वर्कफ़्लोज़ की आवर्तक और मॉड्यूलर प्रकृति को संभालने में मदद करते हैं। ये आपको विभिन्न प्रीप्रोसेसिंग चरणों, एल्गोरिथ्म और हाइपरपैरामीटर के साथ प्रयोग करते हुए पाइपलाइन को व्यवस्थित रखने की सुविधा देते हैं।
Kubeflow Pipelines और MLflow जैसे टूल्स DAGs का उपयोग मशीन लर्निंग वर्कफ़्लोज़ को प्रबंधित करने के लिए करते हैं, जिससे बिना रुकावट प्रयोग और परिनियोजन संभव होता है। उदाहरण के लिए, आप डेटा ड्रिफ्ट का पता चलने पर ट्रिगर होने वाली री-ट्रेनिंग पाइपलाइनों के लिए DAGs का उपयोग कर सकते हैं, ताकि समय के साथ आपके मॉडल सटीक और प्रासंगिक बने रहें।
डेटा इंजीनियरिंग में DAGs प्रबंधित करने के लोकप्रिय टूल्स
DAGs को प्रभावी ढंग से प्रबंधित और ऑर्केस्ट्रेट करने में मदद करने वाले कई टूल्स उपलब्ध हैं। आइए कुछ लोकप्रिय विकल्पों को देखें:
Apache Airflow
Apache Airflow वर्कफ़्लो बनाने, शेड्यूल करने और मॉनिटर करने के लिए व्यापक रूप से इस्तेमाल होने वाला प्लेटफ़ॉर्म है। यह जटिल डेटा पाइपलाइनों को DAGs के रूप में परिभाषित करने में उत्कृष्ट है। Airflow इन DAGs को विज़ुअलाइज़ और प्रबंधित करने के लिए एक उपयोगकर्ता-अनुकूल इंटरफ़ेस प्रदान करता है, जिससे डेटा वर्कफ़्लो को समझना और उनका ट्रबलशूट करना आसान हो जाता है। इसकी लचीलापन और स्केलेबिलिटी ने इसे कई डेटा इंजीनियरिंग टीमों की पसंद बना दिया है।
Prefect
Prefect एक आधुनिक ऑर्केस्ट्रेशन टूल है जो डेटा वर्कफ़्लोज़ के निर्माण और प्रबंधन को सरल बनाता है। यह DAGs को परिभाषित करने के लिए Python-आधारित API प्रदान करता है, जिससे मौजूदा Python कोड के साथ एकीकरण आसान हो जाता है। Prefect विश्वसनीयता और अवलोकनीयता को प्राथमिकता देता है, और ऑटोमैटिक रिट्राइज़, बैकफिल्स और मज़बूत मॉनिटरिंग जैसी सुविधाएँ प्रदान करता है।
Dask
Dask Python के लिए एक पैरेलल कम्प्यूटिंग लाइब्रेरी है जो वितरित डेटा वर्कफ़्लोज़ को प्रबंधित करती है। यह कई कोर या मशीनों में गणनाओं को पैरेललाइज़ कर सकता है, जिससे यह बड़े पैमाने पर डेटा प्रोसेसिंग कार्यों के लिए उपयुक्त बनता है। Dask कार्यों को अनुसूचित और समन्वित करने के लिए DAG-आधारित निष्पादन मॉडल का उपयोग करता है, जिससे संसाधनों का कुशल उपयोग सुनिश्चित होता है।
Kubeflow Pipelines
Kubeflow Pipelines स्केलेबल मशीन लर्निंग वर्कफ़्लोज़ के निर्माण और परिनियोजन के लिए एक ओपन-सोर्स प्लेटफ़ॉर्म है। यह डेटा प्रीप्रोसेसिंग से लेकर मॉडल परिनियोजन तक एंड-टू-एंड वर्कफ़्लो को DAGs द्वारा परिभाषित करता है। Kubernetes के साथ इसका घनिष्ठ एकीकरण इसे क्लाउड परिवेश में वर्कफ़्लोज़ चलाने के लिए एक सशक्त विकल्प बनाता है। Kubeflow वर्कफ़्लोज़ के प्रबंधन और मॉनिटरिंग के लिए एक दृश्य इंटरफ़ेस भी प्रदान करता है, जो पारदर्शिता और नियंत्रण देता है।
Dagster
Dagster आधुनिक डेटा वर्कफ़्लोज़ के लिए डिज़ाइन किया गया एक ऑर्केस्ट्रेशन प्लेटफ़ॉर्म है। यह मॉड्युलैरिटी और टाइप सेफ़्टी पर ज़ोर देता है, जिससे DAGs का परीक्षण और रखरखाव आसान हो जाता है। Dagster, Apache Spark, Snowflake और dbt जैसे लोकप्रिय टूल्स के साथ एकीकृत होता है, जिससे यह विविध तकनीकों वाली डेटा इंजीनियरिंग टीमों के लिए उत्कृष्ट विकल्प बनता है।
हैंड्स-ऑन उदाहरण: Apache Airflow में एक बेसिक DAG बनाना
Apache Airflow सेटअप करना
DAG बनाने से पहले, आपको Apache Airflow सेटअप करना होगा। आप इसे Docker से या pip जैसे पैकेज मैनेजर के ज़रिये इंस्टॉल कर सकते हैं:
pip install apache-airflowइंस्टॉल होने के बाद, आपको Airflow वेब सर्वर और शेड्यूलर को कॉन्फ़िगर करना होगा। इसमें डेटाबेस कनेक्शनों को सेटअप और इनिशियलाइज़ करना तथा वेब सर्वर शुरू करना शामिल है:
airflow db init
airflow webserver --port 8080एक सरल DAG परिभाषित करना
Airflow सेटअप हो जाने पर, आप अपना DAG बना सकते हैं। आप Python का उपयोग करके DAG और उसके कार्यों को इस प्रकार परिभाषित कर सकते हैं:
from airflow import DAG
from airflow.operators.bash import BashOperator
from datetime import datetime
with DAG(
'simple_dag',
start_date=datetime(2023, 1, 1),
schedule_interval=None,
catchup=False
) as dag:
task1 = BashOperator(
task_id='task_1',
bash_command='echo "Hello, World!"'
)
task2 = BashOperator(
task_id='task_2',
bash_command='echo "This is task 2"'
)
task1 >> task2इस उदाहरण में, सरल DAG में दो कार्य हैं: task_1 और task_2। >> ऑपरेटर कार्यों के बीच निर्भरता सेट करता है, यह सुनिश्चित करते हुए कि task_2 केवल task_1 के पूर्ण होने के बाद ही चले।
DAG चलाना और मॉनिटर करना
एक बार आपका DAG परिभाषित होकर Airflow में डिप्लॉय हो जाए, तो आप वेब इंटरफ़ेस के माध्यम से इसके साथ इंटरैक्ट कर सकते हैं।
DAGs दो तरीकों में से किसी एक में चलेंगे:
- आप इसे मैन्युअली या API के माध्यम से ट्रिगर कर सकते हैं
- आप एक शेड्यूल परिभाषित कर सकते हैं। DAGs के लिए शेड्यूल आवश्यक नहीं है, लेकिन
scheduleआर्ग्युमेंट के ज़रिये एक परिभाषित करना बहुत सामान्य है।
हर बार जब आप किसी DAG को चलाते हैं, तो उस DAG का एक नया इंस्टेंस, जिसे DAG रन कहा जाता है, बनता है। एक ही DAG के लिए DAG Runs समानांतर में चल सकते हैं, और प्रत्येक का एक परिभाषित डेटा इंटरवल होता है, जो उस अवधि की पहचान करता है जिस पर कार्यों को संचालित होना चाहिए।
ट्रिगर करने के बाद, आप DAG व्यू में इसकी प्रगति की निगरानी कर सकते हैं, जो वर्कफ़्लो का दृश्य प्रतिनिधित्व प्रदान करता है।
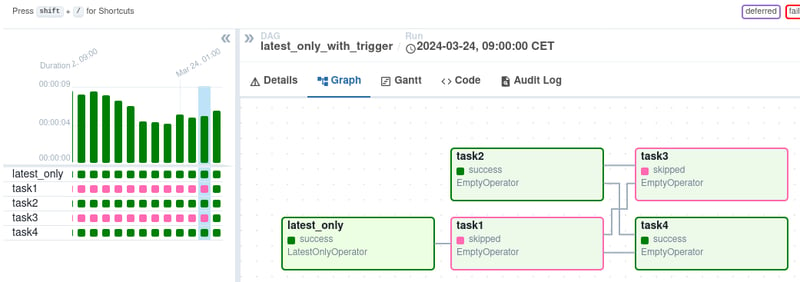 Airflow इंटरफ़ेस पर DAG व्यू। छवि स्रोत: Airflow
Graph व्यू किसी विशिष्ट DAG रन का विस्तृत दृश्य देता है, जिसमें कार्यों की निर्भरताएँ और निष्पादन समय दिखते हैं। Task Instances व्यू व्यक्तिगत कार्यों के बारे में सूक्ष्म जानकारी प्रदान करता है, जिसमें उनकी स्थिति, प्रारंभ और समाप्ति समय, और लॉग्स शामिल हैं। आप त्रुटियों का निवारण करने और विफलताओं के मूल कारण को समझने के लिए टास्क लॉग्स की जाँच कर सकते हैं। Task Instances व्यू कार्य अवधि भी दिखाता है, जो संभावित प्रदर्शन समस्याओं की पहचान में मदद करता है।
निष्कर्ष
DAGs डेटा इंजीनियरिंग में एक बुनियादी अवधारणा हैं, जो जटिल वर्कफ़्लोज़ को दर्शाने का दृश्य और संरचित तरीका प्रदान करते हैं। नोड्स, एजेस और निर्भरताओं को समझना आपको डेटा पाइपलाइनों को कुशलतापूर्वक डिज़ाइन और प्रबंधित करने में मदद करता है।
DAGs का व्यापक उपयोग ETL प्रक्रियाओं के ऑर्केस्ट्रेशन, डेटा प्रोसेसिंग पाइपलाइनों के प्रबंधन और मशीन लर्निंग वर्कफ़्लोज़ के स्वचालन में होता है। आप Apache Airflow, Prefect और Dask जैसे टूल्स का उपयोग करके प्रभावी रूप से DAGs बना और प्रबंधित कर सकते हैं। ये टूल्स उपयोगकर्ता-अनुकूल इंटरफ़ेस, शेड्यूलिंग क्षमताएँ और उन्नत मॉनिटरिंग, त्रुटि-प्रबंधन तथा स्केलिंग सुविधाएँ प्रदान करते हैं।
हैंड्स-ऑन अनुभव पाने के लिए, Python में Airflow पर यह प्रारंभिक कोर्स आपको प्रभावी ढंग से DAGs बनाना और प्रबंधित करना सिखा सकता है। डेटा इंजीनियरिंग की अवधारणाओं और वर्कफ़्लोज़ की व्यापक समझ के लिए, Understanding Data Engineering कोर्स एक उत्कृष्ट नींव प्रदान करता है!
FAQs
DAG और फ़्लोचार्ट में क्या अंतर है?
हालाँकि DAGs और फ़्लोचार्ट दोनों प्रक्रियाओं को विज़ुअलाइज़ करते हैं:
- DAGs कार्य-निर्भरताओं और निष्पादन क्रम पर केंद्रित होते हैं, और आमतौर पर संगणनात्मक वर्कफ़्लोज़ में उपयोग किए जाते हैं।
- फ़्लोचार्ट निर्णय-निर्माण प्रक्रियाओं और लॉजिक का व्यापक दृश्य प्रतिनिधित्व देते हैं, जो केवल कार्य-निर्भरताओं तक सीमित नहीं होता।
क्या DAGs रीयल-टाइम डेटा वर्कफ़्लोज़ संभाल सकते हैं?
हाँ, Apache Airflow और Prefect जैसे कई टूल्स वास्तविक-समय या लगभग वास्तविक-समय डेटा वर्कफ़्लोज़ का समर्थन करते हैं। उदाहरण के लिए, Airflow के सेंसर डेटा के आगमन की निगरानी कर वर्कफ़्लो ट्रिगर कर सकते हैं, जबकि Prefect वास्तविक-समय ट्रिगर्स के आधार पर डायनेमिक टास्क निष्पादन की सुविधा देता है।
DAGs के साथ कुछ सामान्य चुनौतियाँ क्या हैं?
सामान्य चुनौतियाँ शामिल हैं:
- जटिलता का प्रबंधन: कई कार्यों वाले बड़े वर्कफ़्लोज़ को डिबग और मेंटेन करना कठिन हो सकता है।
- प्रदर्शन बाधाएँ: ठीक से अनुकूलित न किए गए DAGs कार्य निष्पादन में देरी का कारण बन सकते हैं।
- टूल-विशिष्ट सीखने की वक्र: Airflow या Prefect जैसे टूल्स में महारत हासिल करने में समय और अभ्यास लग सकता है।
वर्कफ़्लोज़ में DAGs त्रुटि-प्रबंधन कैसे सुधारते हैं?
DAGs बेहतर त्रुटि-प्रबंधन सुनिश्चित करते हैं, जैसे कि:
- निर्भरताओं को ट्रैक करना ताकि कार्य विफलताओं के मूल कारण की पहचान हो सके।
- पूरे वर्कफ़्लो को दोबारा चलाए बिना विशिष्ट विफल कार्यों का आंशिक पुन: चलन संभव करना।
- Airflow और Prefect जैसे टूल्स में उपलब्ध मॉनिटरिंग सुविधाएँ, जो विस्तृत लॉग्स और त्रुटि सूचनाएँ प्रदान करती हैं।
वर्कफ़्लो ऑर्केस्ट्रेशन के लिए DAGs के विकल्प क्या हैं?
जहाँ DAGs लोकप्रिय विकल्प हैं, वहीं इवेंट-ड्रिवन आर्किटेक्चर या स्टेट मशीनों जैसे अन्य मॉडल भी वर्कफ़्लो प्रबंधित कर सकते हैं। हालाँकि, ये विकल्प विशेषकर जटिल पाइपलाइनों के लिए, DAGs द्वारा प्रदान की जाने वाली स्पष्टता और निर्भरता प्रबंधन क्षमताओं से वंचित हो सकते हैं।

लेखक
Maria Eugenia Inzaugarat
डेटा वर्कफ़्लो और पाइपलाइनों में अक्सर यह सुनिश्चित करने के लिए सटीक समन्वय की आवश्यकता होती है कि कार्य सही क्रम में निष्पादित हों। Directed Acyclic Graph (DAG) इन वर्कफ़्लो को कुशलतापूर्वक प्रबंधित करने और त्रुटियों से बचने का एक शक्तिशाली साधन है।
इस लेख में, हम DAGs और डेटा इंजीनियरिंग में उनकी महत्त्वपूर्णता को समझेंगे, उनके कुछ उपयोगों की समीक्षा करेंगे, और Airflow के साथ एक व्यावहारिक उदाहरण के ज़रिये उन्हें इस्तेमाल करना सीखेंगे।
DAG क्या है?
यह समझने के लिए कि DAG क्या है, पहले कुछ प्रमुख अवधारणाएँ परिभाषित करें। कंप्यूटर विज्ञान में, ग्राफ एक नॉन-लीनियर डेटा स्ट्रक्चर है जो नोड्स और एजेस से मिलकर बना होता है। नोड्स व्यक्तिगत एंटिटी या ऑब्जेक्ट का प्रतिनिधित्व करते हैं, जबकि एजेस इन नोड्स को जोड़ते हैं और उनके बीच संबंधों या कनेक्शनों को दर्शाते हैं।
एक डायरेक्टेड ग्राफ में, एजेस की एक विशिष्ट दिशा होती है, जो नोड्स के बीच एकतरफ़ा संबंध को दर्शाती है। इसका मतलब है कि यदि नोड A से नोड B तक कोई एज है, तो यह A से B तक कनेक्शन को दर्शाता है, पर आवश्यक नहीं कि B से A तक भी हो।
डायरेक्टेड ग्राफ का दृश्य स्पष्टीकरण। छवि स्रोत: Astronomer
एक पाथ निर्देशित एजेस से जुड़े नोड्स का क्रम होता है। यह किसी विशिष्ट नोड से शुरू होता है और एजेस की दिशा का अनुसरण करते हुए दूसरे नोड तक पहुँचता है। जब तक एजेस की दिशा का पालन किया जाता है, पाथ की लंबाई एक नोड से लेकर कई नोड्स की श्रृंखला तक कुछ भी हो सकती है।
अब जब हमारे पास कुछ बुनियादी परिभाषाएँ हैं, तो देखें कि DAG क्या है: DAG एक ऐसा डायरेक्टेड ग्राफ है जिसमें कोई निर्देशित साइकिल नहीं होती; हर नोड एक विशिष्ट कार्य का प्रतिनिधित्व करता है और हर एज उनके बीच निर्भरता को दर्शाता है।
DAGs की सबसे महत्वपूर्ण बात यह है कि वे ए-साइक्लिक होते हैं—अर्थात एक नोड से शुरू करने के बाद आप केवल आगे बढ़ सकते हैं, कभी पिछले नोड पर नहीं लौटते। इससे यह सुनिश्चित होता है कि कार्य क्रम में निष्पादित हों और अनंत लूप न बनें। DAGs अक्सर पदानुक्रमित संरचना रखते हैं, जहाँ कार्य स्तरों या परतों में व्यवस्थित होते हैं। उच्च स्तर के कार्य सामान्यतः निचले स्तर के कार्यों के पूर्ण होने पर निर्भर होते हैं।